在深度学习工程中,最隐蔽、最难排查的 Bug 往往藏在卷积、注意力或损失函数之间看似平淡无奇的 reshape、view、transpose、permute、squeeze 和 repeat 调用里。
想象一个常见的训练事故:你在复现一篇 Vision Transformer 或多模态大模型论文时,将形状为 (batch, channels, height, width) 的特征图重排为序列张量。你随手写下了 x.view(b, -1, c),代码顺利跑通,输出的 shape、dtype 和 device 分毫不差,Loss 也在缓慢下降,但最终的验证集精度始终比论文低 5 个百分点。排查数周后你才惊觉:由于少了前置的 permute(0, 2, 3, 1),直接 view 把不同空间位置与不同通道的浮点数强行交错揉成了一团——因为元素总数乘积恰好相等,PyTorch 和 NumPy 全程保持静默,连一个 Warning 都没有报。
Alex Rogozhnikov 发表在 ICLR 2022(Oral)的代表作 Einops: Clear and Reliable Tensor Manipulations with Einstein-like Notation,正是为了从根源上终结这类“形状合法但结构碎裂”的静默灾难。Einops 没有发明任何新的数学算子,也没有编写一行 C++/CUDA 底层 Kernel,却成为了现代深度学习代码库(从 PyTorch、HuggingFace 到各类大模型源码)事实上的张量操作标准语言。
深入研读 ICLR 2022 论文与 einops(v0.8.2)源码可以发现,它的成功建立在四条高度凝练的设计哲学之上:
- 将隐式位置契约升维为显式轴语义声明(Declarative Axis Semantics over Positional Index Arithmetic):拒绝使用脱离上下文的整数下标(如
permute(0, 2, 3, 1))和充满歧义的-1占位符,强制将“输入各维叫什么、输出各维怎么排、复合维度按什么次序拆合”编码进同一行字符串 Pattern(如'b c h w -> b (h w) c')。每一处调用既是维度变换指令,也是一道自带上下文的运行时结构断言。 - 用三原语集合不变量锁死元素守恒与增减边界(Set Invariants Separating
rearrange,reduce, andrepeat):刻意不设计大包大揽的单一transform()接口,而是依据左右基本轴集合 与 的严格关系切分出三个正交原语——rearrange(,双射重排与元素守恒)、reduce(,显式消轴归约)与repeat(,显式增轴复制)。原本在 NumPy/PyTorch 中碎片化的十余种异构 API 由此收拢为统一的集合代数模型。 - 静态结构配方编译与运行时形状解算分离(Two-Stage Compilation from
ParsedExpressiontoTransformRecipe):为了消除字符串解析在高频训练循环中的 Python 开销,Einops 将执行拆解为两阶段编译并配以双层 LRU 缓存:第一阶段仅根据 Pattern 字符串与输入秩ndim静态编译出与具体 Batch 大小无关的TransformRecipe;第二阶段结合输入shape解算未知轴因子,并通过代数化简将其坍缩为最多五步的后端基础原语流水线(reshape -> transpose -> reduce -> add_axes -> reshape)。 - 零核心依赖的最小后端契约与编译图穿透(Zero-Dependency Lazy Dispatch & Graph Compiler Penetration):通过检查
sys.modules实现惰性后端加载(get_backend),仅用AbstractBackend的 9 个最小方法抹平 NumPy、PyTorch、JAX、TensorFlow、Apple MLX 等十余个框架的 API 差异;同时通过SymInt符号维度传递与torch._dynamo.allow_in_graph白名单,确保高层字符串 DSL 能够被现代 JIT 编译器(如torch.compile)无损穿透并完成底层算子融合。
本文将沿着**“ICLR 2022 论文设计推导”与“einops v0.8.2 编译器源码实现”**双线展开,完整剖析 Einstein-like Pattern 语法机制、经典深度学习模型重构案例、两阶段 Recipe 编译器源码、内存视图(View vs Copy)物理条件以及生产级测试规范。
1. 为什么位置下标 API 是静默 Bug 的温床?
1.1 位置编号 API 与裸 reshape 的结构盲区
在 NumPy、PyTorch、TensorFlow 等主流张量库中,多维数组的传统操作界面建立在整数位置下标(0, 1, 2, ...)之上:
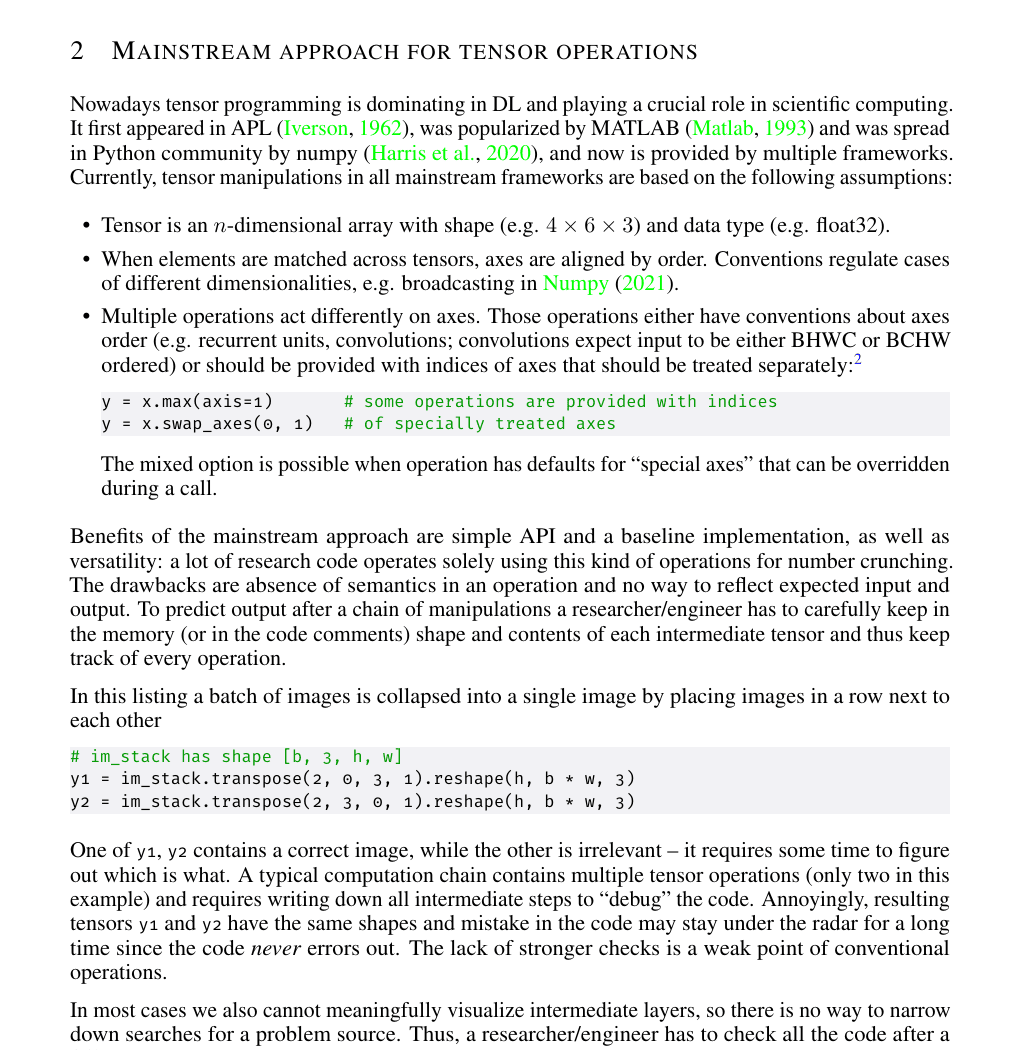
这套面向机器内存布局的接口虽然对底层 C/C++ 实现极其直接,但在表达复杂网络结构变换时,却把所有维度的业务语义丢给了程序员的大脑。看一个论文开篇给出的经典对比:假设输入图像批次 x 的形状是 (b, c, h, w),现在我们需要把每个样本的高置顶、并将批次 b 与宽度 w 合并为 (h, b * w, c)。对比下面两行原生代码:
# 两行代码的输出 shape 均为 (h, b * w, c),且全程不报任何错误!
y1 = x.transpose(2, 0, 3, 1).reshape(h, b * w, c)
y2 = x.transpose(2, 3, 0, 1).reshape(h, b * w, c)
这两行代码在运行时都能顺利通过,输出的 shape 完全相同,但其中一行已经把图像的空间结构彻底撕碎了!论文用一组极其直观的视觉实验(对标注了 "einops" 字样的图像张量执行不同的 reshape 与转置序列)展示了这种静默损坏的后果:
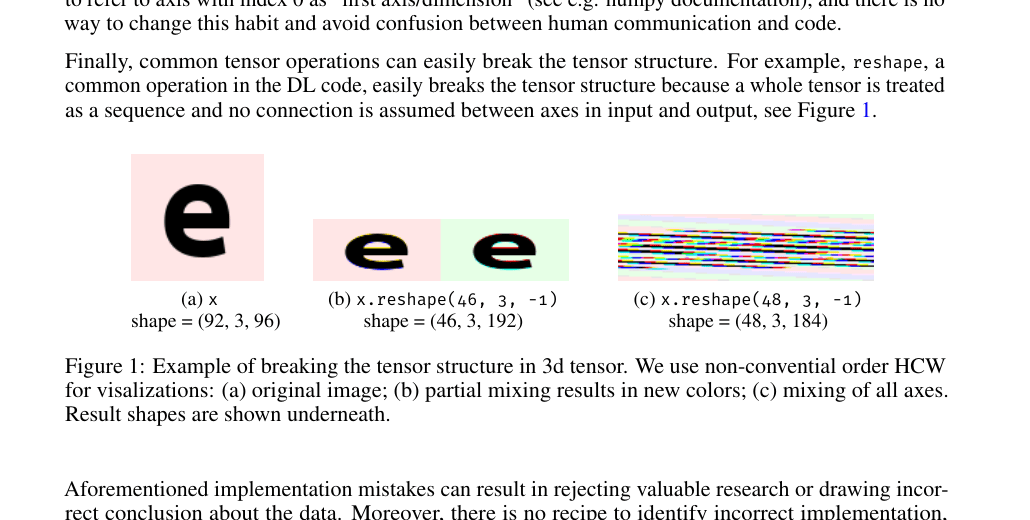
为什么裸 reshape / view 如此危险?因为从数学上看,给定输入形状 与目标形状 ,位置 API 的 reshape 只校验总元素个数守恒:
只要等式成立,它就直接按底层内存的线性字节流重新切分步长(Stride),根本不管新维度 究竟是由哪几个旧维度按什么顺序拼出来的。在工程实践中,许多团队试图靠写代码注释来补救:
# x: [batch, heads, seq, dim]
x = x.permute(0, 2, 1, 3).contiguous().view(batch, seq, -1)
但注释无法参与运行时校验:如果上游模块重构后传进来的张量变成了 [batch, seq, heads, dim],这行代码依然会静默跑通(甚至当 heads == seq 时连形状都不会变),把 seq 和 heads 彻底搞反!
1.2 Einops 的五项语言设计目标与核心术语边界
为了把注释里的意图变成可执行的程序契约,Einops 确立了 Pattern Language 的五项核心设计准则:
| 设计准则 | 解决的传统痛点 | 在 Einops 中的具体体现 |
|---|---|---|
| Semantic Information(语义内聚) | 下标 0, 2, 1, 3 脱离上下文,需翻阅多层调用确认维度含义 | 直接用 batch、heads、seq、dim 等业务标识符就地声明输入与输出 |
| Runtime Checks(运行时契约校验) | view(b, -1, c) 在维度错位或无法整除时缺乏精细断言 | 自动校验输入输出 Rank、基本轴集合守恒、已知维度匹配与复合轴整除关系 |
| Strictly Determined Result(结果唯一确定) | 多步 reshape + transpose 的中间状态难以心算 | 给定输入形状、Pattern 与显式轴长,输出形状与元素线性排列顺序唯一确定 |
| Uniformity(表达统一性) | squeeze、stack、concat、tile、repeat 各自有一套怪异参数 | 全部收拢为 rearrange、reduce、repeat(以及后续扩展的 pack / einsum) |
| Framework Independence(跨框架一致) | NumPy 用 transpose(axes),PyTorch 用 permute(*dims),API 割裂 | 同一条 Pattern 在 NumPy、PyTorch、JAX、TensorFlow、MLX 上行为 100% 一致 |
在深入语法之前,先厘清三个基础概念边界:
- 关于“Tensor”的语境:在微分几何与物理学中,张量(Tensor)要求满足严格的坐标变换协变/逆变法则;而在深度学习工程与本文中,Tensor 指代携带
shape、dtype、device与自动微分图的多维数组(-dimensional array)。 - 与爱因斯坦求和约定(Einstein Summation)的渊源:经典的爱因斯坦求和约定()通过重复下标表达张量缩并;Einops 借鉴了它“用命名轴符号替代位置下标来描述张量变换关系”的核心思想,并将其泛化到了任意维度重排、分块池化与广播复制上。
- 能力演进脉络:ICLR 2022 论文奠定了
rearrange、reduce、repeat三大原语、两阶段 Recipe 编译器与EinMix层;在此之后,社区版本陆续演进出多字符einsum(v0.5)、异构秩打包pack / unpack(v0.6)、Python Array API 与torch.compile适配(v0.7)以及tinygrad/ AppleMLX后端支持(v0.8.2)。
2. Einstein-like Pattern 语法体系与三原语集合不变量
2.1 命名轴、复合轴分解与 C-order 线性排列公式
一条标准的 Einops Pattern 由左侧输入轴表达式、箭头 -> 和右侧输出轴表达式三部分构成:
from einops import rearrange

# 输入形状: (batch=8, channel=3, height=32, width=32)
# 输出形状: (batch=8, height=32, width=32, channel=3)
y = rearrange(x, 'batch channel height width -> batch height width channel')在表达式中,空格是物理维度(Axis)的分隔符:箭头左侧有几个由空格分隔的项,就代表断言输入张量是几维(Rank);每个合法的 Python 变量名代表一个不可再分的基本轴(Elementary Axis);而圆括号 (...) 则用于将多个基本轴合成为一个物理维度——称为复合轴(Composite Axis),或者将一个输入物理维度拆解为多个基本轴:
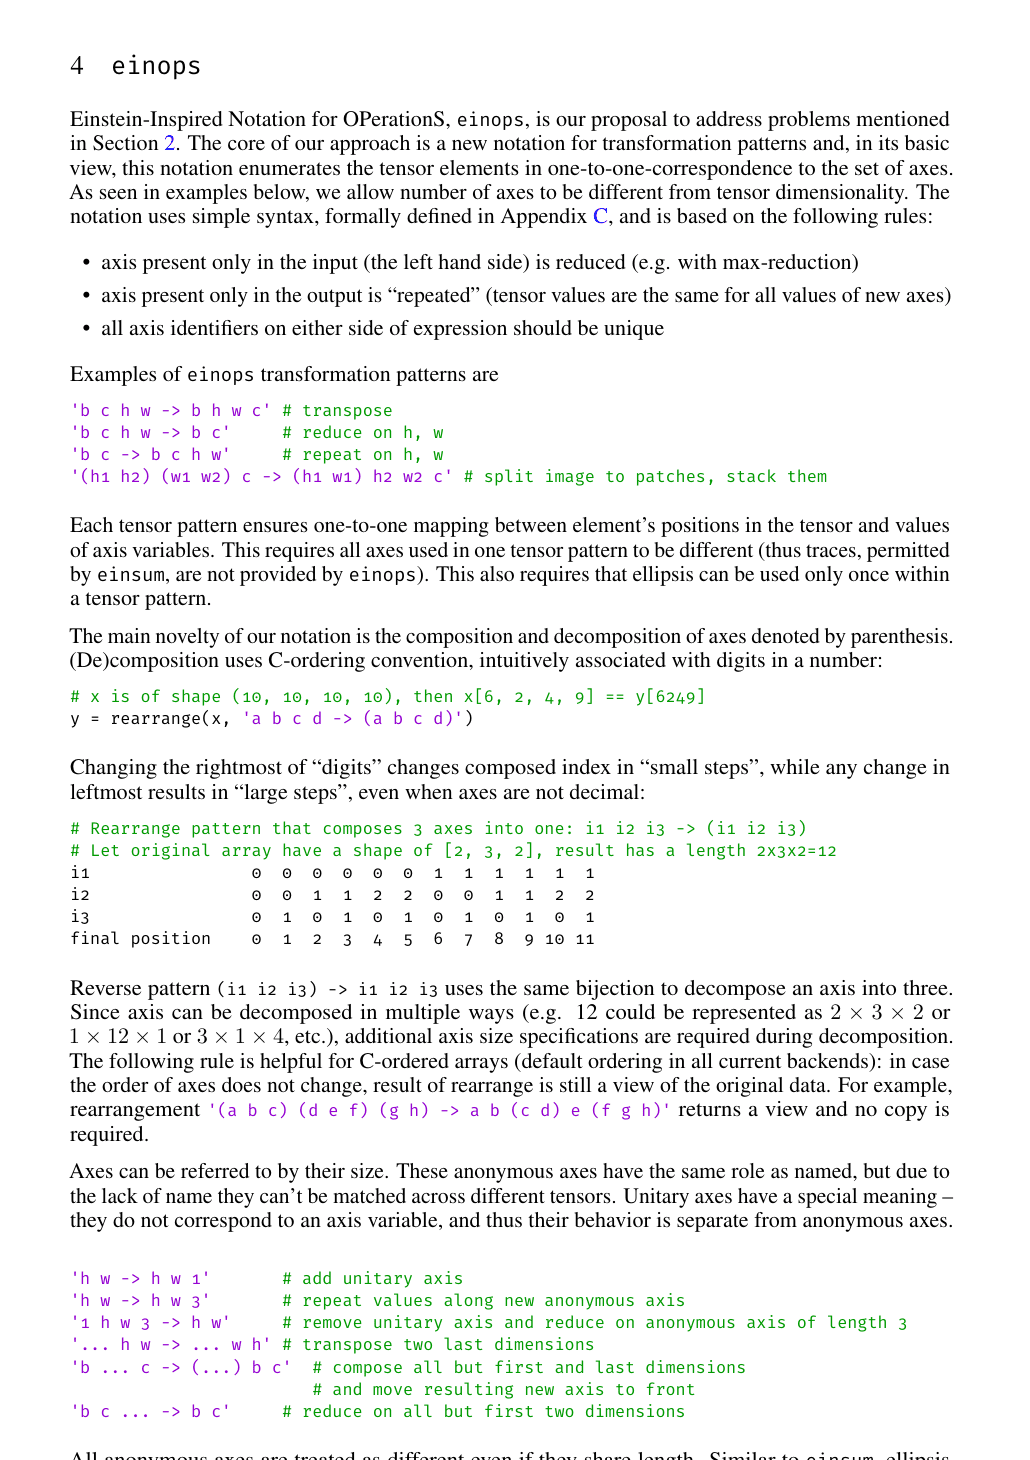
理解复合轴 (axis1 axis2 axis3) 的核心钥匙是 C-order(行优先词典序,最右侧的基本轴变化最快)。设三个基本轴的当前坐标分别为 ,对应轴长分别为 ,当它们在圆括号内合成为单一物理维度时,合成后的线性下标 严格遵循如下双射公式:
这个公式揭示了两个极其关键的工程事实:
- 括号内的轴顺序直接决定内存交错布局:在
rearrange(images, 'b c h w -> b (h w) c')中,(h w)表示w在内层变化最快(即按图像行从左到右扫描);如果写成(w h),虽然输出形状依然是(b, h*w, c),但底层变成了按列从上到下扫描! - 拆轴(Axis Decomposition)必须满足唯一可解性与整除性:当圆括号出现在箭头左侧(如
'b (h w) c -> b h w c')时,意味着要把长度为 的单一序列维拆成两个基本轴h和w。由于一个方程 有无穷多组因子解(、、),Einops 强制要求每个输入复合轴中最多只能有 1 个未知长度的基本轴,其余基本轴必须通过关键字参数显式给定:
# x.shape == (8, 196, 768),显式传入 h=14 后,编译器唯一解出 w = 196 // 14 = 14
grid = rearrange(x, 'b (h w) c -> b h w c', h=14)
一旦传入的 h=15 无法整除 196(),或者漏传了 h 导致存在两个未知数,Einops 会在执行底层算子前当场抛出 EinopsError。
2.2 整数匿名轴、单位轴(1 / ())与省略号 ... 多态
除了命名标识符,Einops 语法还设计了三类特殊语法糖来处理常量拆轴、维度挤压(Squeeze/Unsqueeze)与可变秩多态:
- 整数匿名轴(Anonymous Axis,大于 1 的整数字面量):当你只需要把某个维度按固定常数拆开(例如把融合计算的 QKV 投影维按常数
3拆开),又不想专门起一个轴名再写一遍qkv=3时,可以直接在 Pattern 里写数字3:# 直接将通道维按常数 3 拆至首维: (b, n, 3*d) -> (3, b, n, d) q, k, v = rearrange(qkv, 'b n (3 d) -> 3 b n d') - 单位轴(Singleton Axis,数字
1或空括号()):在复合轴乘法中,乘以 不会改变元素个数。因此,任何长度为 1 的物理维度本质上都是“包含 0 个基本轴的空复合轴()”。这让squeeze和unsqueeze自然成为了rearrange的特例:# 等价于 unsqueeze:在首尾插入长度为 1 的物理维度 (h, w) -> (1, h, w, 1) y = rearrange(x, 'h w -> 1 h w 1') # 等价于带安全断言的 squeeze(0):若第 0 维实际长度不为 1,立即报错拦截! y = rearrange(x, '() h w -> h w') - 省略号
...(Ellipsis,可变秩多态):当编写通用工具函数,希望同时兼容(h, w)、(b, h, w)乃至(b, t, v, h, w)等任意前置批次维度时,可以用...匹配零个或多个未命名的维度:# 保持前置所有批次维度原封不动,仅合并末尾的 heads 与 dim y = rearrange(x, '... heads dim -> ... (heads dim)')
2.3 三大核心原语的集合不变量与十余种算子大一统
为什么 Einops 要把接口拆成 rearrange、reduce、repeat 三个函数?
这是它最精妙的防呆设计。设箭头左侧的基本轴集合为 ,右侧的基本轴集合为 (不含长度为 1 的单位轴)。三个函数在编译器入口处分别锁死了三条互斥的基本轴集合不变量(Set Invariants):
| 核心原语 | 基本轴集合不变量 | 物理与代数语义 | 编译器自动拦截的典型人为失误 |
|---|---|---|---|
rearrange | 元素双射重排(总数严格守恒,仅改变视图布局或坐标映射) | 拦截拼写错误(如把 height 拼成 heigth)或意外漏写某个维度 | |
reduce | 沿消去轴集合 聚合归约(池化、求均值/最值) | 拦截在归约时误引入左侧不存在的新轴,或忘记消去池化窗口轴 | |
repeat | 沿新增轴集合 复制扩展(广播、Tile、Interleave) | 强制要求调用方为每一个新增轴 显式传入长度参数 |
有了这三条集合不变量,原本在 NumPy 和 PyTorch 中散乱不堪的十几种操作(transpose、reshape、flatten、squeeze、expand_dims、stack、concatenate、split、max/mean、repeat、tile),全部被收编进了同一套自解释的声明式语法中:
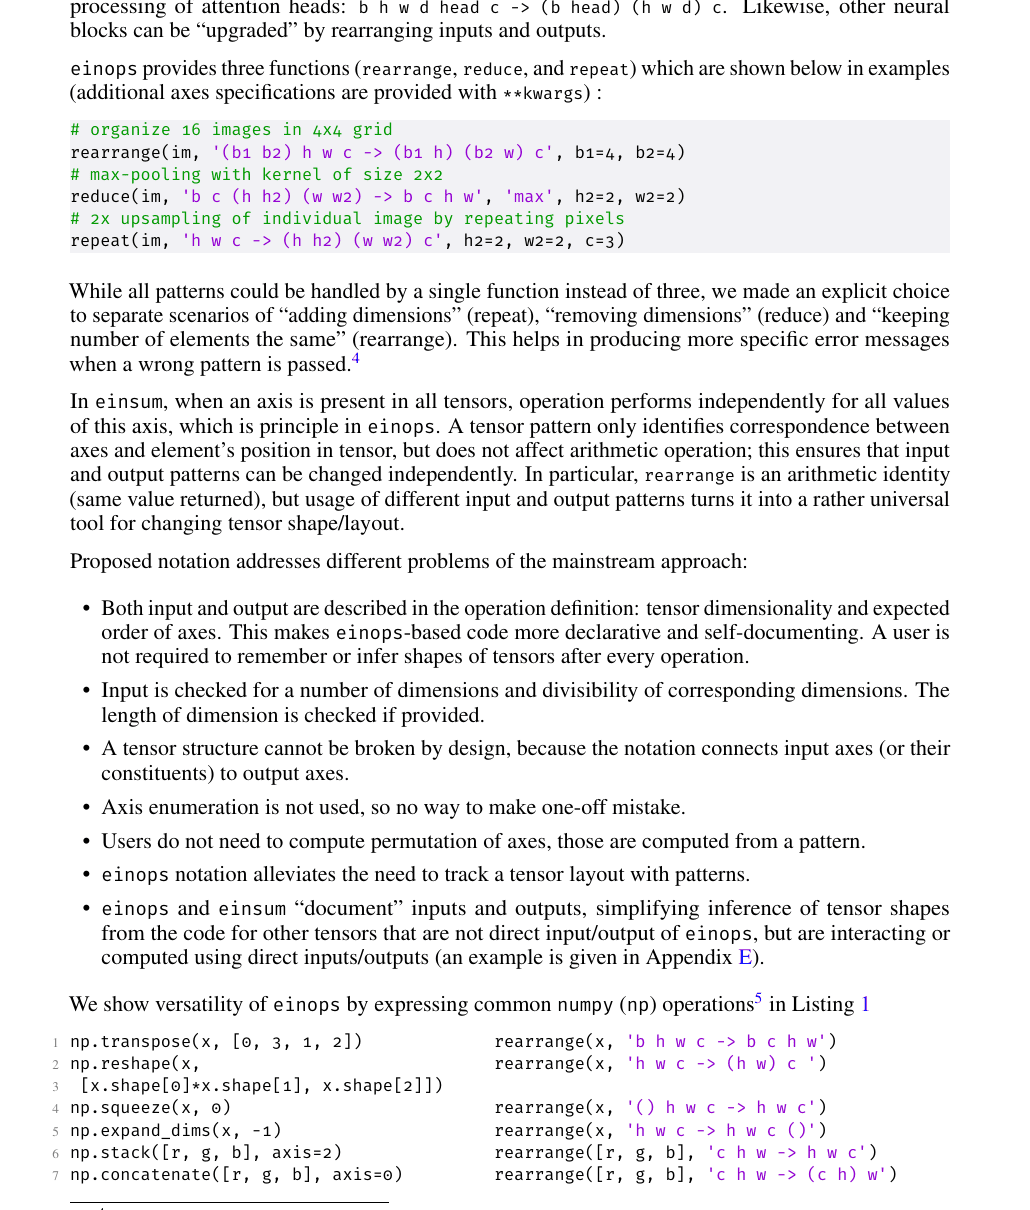
3. 核心原语全景实战与神经网络层集成
3.1 rearrange、reduce 与 repeat 的高阶工程用法
在日常编写深度学习模型时,掌握以下三组惯用法(Idioms)能直接砍掉 80% 的胶水代码:
第一组:rearrange 接收张量列表,单步完成 stack / concat + permute。
当函数的第一个参数传入 list[Tensor] 时,rearrange 会自动把列表本身视作左侧的第 0 个逻辑基本轴!这意味着你不再需要先判断调 torch.stack 还是 torch.cat,只需看这个列表轴在右侧是独立成轴(对应 stack)还是并入其他括号(对应 concat):
# 1) 列表轴 views 独立保留 -> 等价于 stack 后再交换维度: 4 个 (b, c, h, w) -> (b, 4, c, h, w)
multi_view = rearrange([x1, x2, x3, x4], 'views b c h w -> b views c h w')

# 2) 列表轴 views 并入通道括号 (views c) -> 等价于沿通道维 concat: 4 个 (b, c, h, w) -> (b, 4*c, h, w)
concat_channels = rearrange([x1, x2, x3, x4], 'views b c h w -> b (views c) h w')第二组:reduce 结合复合轴拆解,一行实现任意空间窗口池化与组内归一化统计。
给定归约算子 (或任意形如 Callable[[Tensor, tuple[int, ...]], Tensor] 的自定义归约函数),reduce 会先按左侧括号拆出局部窗口轴,再将右侧未出现的窗口轴一次性聚合消去:
from einops import reduce

# 1) 全局平均池化 (Global Average Pooling): 消去 h 和 w,(b, c, h, w) -> (b, c)
gap = reduce(x, 'b c h w -> b c', 'mean')

# 2) 2x2 步长为 2 的最大池化 (MaxPool2d): 将高宽拆为网格 (h, w) 与核窗口 (kh, kw),消去 (kh, kw)
max_pooled = reduce(x, 'b c (h kh) (w kw) -> b c h w', 'max', kh=2, kw=2)

# 3) GroupNorm / InstanceNorm 组内均值统计:用 1 保留空间与组内通道单位轴,便于后续直接广播相减
group_mean = reduce(
    x,
    'b (groups group_c) h w -> b (groups 1) 1 1',
    'mean',
    groups=32,
)第三组:repeat 用圆括号内的左右次序彻底终结 repeat_interleave 与 tile 的混淆。
在原生 PyTorch/NumPy 中,要把序列 [a, b, c] 变成 [a, a, b, b, c, c](元素级原地重复)还是 [a, b, c, a, b, c](整体序列循环平铺),需要分别查文档找 repeat_interleave 和 tile。而在 Einops 中,这完全由新增轴 r 在圆括号 (w r) 还是 (r w) 中的 C-order 位置决定:
from einops import repeat

# 1) 新增轴 r 在右侧 (w r),r 变化最快 -> 每个元素原地连续重复 r 次: [a, a, b, b, c, c]
interleaved = repeat(x, 'h w -> h (w r)', r=2)

# 2) 新增轴 r 在左侧 (r w),w 变化最快 -> 整段序列整体平铺 r 遍: [a, b, c, a, b, c]
tiled = repeat(x, 'h w -> h (r w)', r=2)

# 3) 2x 最近邻图像上采样 (Nearest-Neighbor Upsampling): 高和宽方向同时原地重复 2 次
upsampled = repeat(img, 'b c h w -> b c (h 2) (w 2)')
3.2 pack / unpack 与多字符 einsum:面向多模态与复杂缩并的扩展
随着多模态大模型(VLM)与复杂注意力机制的普及,einops 在后续版本中补齐了两块关键拼图:
1. pack 与 unpack(异构 Rank 张量的可逆序列打包)。
在多模态 Transformer 中,输入往往是一组维度数量(Rank)各不相同的张量:全局分类向量 cls_token 形状为 (b, c),2D 视觉特征图 image_grid 形状为 (b, h, w, c),音频或文本序列 text_tokens 形状为 (b, t, c)。如果手写代码,你必须先分别把它们 reshape 成 3D,记录各自的长度,调 torch.cat 拼起来,跑完 Attention 后再手算切片下标 [:, 1:1+h*w, :] 拆回去。
pack 引入了星号通配符 *,专门匹配“除首尾共享轴(如 b 和 c)之外的任意个中间维度”,自动将每个张量的中间维度展平并沿序列维拼接(总长度 ),同时返回记录了各张量原始中间形状的元数据列表 packed_shapes:
from einops import pack, unpack

# 输入形状分别为: (b, c), (b, h, w, c), (b, t, c)
# pack 自动计算出 packed_shapes = [(), (h, w), (t,)],并输出统一序列 (b, 1 + h*w + t, c)
sequence, packed_shapes = pack([cls_token, image_grid, text_tokens], 'b * c')

# 统一送入标准 Transformer 层做跨模态自注意力交互
sequence = transformer_block(sequence)

# 前向结束后,直接传入同批次生成的 packed_shapes,一行无损还原各自的 2D / 4D / 3D 形状!
cls_out, image_out, text_out = unpack(sequence, packed_shapes, 'b * c')
2. einops.einsum(告别单字母猜谜的张量缩并)。
原生 torch.einsum('bqhd,bkhd->bhqk', q, k) 强制要求每个轴只能用一个英文字母表示,当张量有五六个维度时,满屏的 ijklmno 极易写串位置。einops.einsum 允许直接使用完整的单词轴名,并将 Pattern 字符串统一放在参数列表末尾:
from einops import einsum

# 1) 多头注意力 QK^T 缩并: s_{b,h,q,k} = \sum_d q_{b,q,h,d} \cdot k_{b,k,h,d}
scores = einsum(
    q, k,
    'batch query head dim, batch key head dim -> batch head query key',
)

# 2) 支持省略号多态的批量矩阵映射与方阵求迹 (Trace)
projected = einsum(weight, x, 'out_dim in_dim, ... in_dim -> ... out_dim')
matrix_trace = einsum(square_mat, 'idx idx ->')
3.3 Rearrange / Reduce 模块封装与 EinMix 参数化轴线性层
当你使用 nn.Sequential 构建网络,或者希望设计类似 MLP-Mixer 那样需要在特定维度(如空间 Token 维或分组通道维)上执行参数化线性投影的模块时,可以直接调用 einops.layers 与自带可学习权重的 EinMix 层:
from torch import nn
from einops.layers.torch import Rearrange, Reduce, EinMix

# 1) 将维度重排与池化直接嵌入 nn.Sequential
patch_embed = nn.Sequential(
    Rearrange('b c (h ph) (w pw) -> b (h w) (ph pw c)', ph=16, pw=16),
    nn.LayerNorm(16 * 16 * 3),
    nn.Linear(16 * 16 * 3, 768),
)

# 2) 使用 EinMix 一行实现 MLP-Mixer 的跨 Token 空间混合层 (无需手写 transpose + Linear + transpose)
token_mixer = EinMix(
    'b tokens channels -> b mixed_tokens channels',
    weight_shape='tokens mixed_tokens',
    bias_shape='mixed_tokens',
    tokens=196,
    mixed_tokens=196,
)
查看 einops/layers/_einmix.py 源码可以看到,EinMix 在 __init__ 阶段会自动根据 weight_shape 和 bias_shape 包含的轴,利用扇入度(Fan-in)完成均匀分布权重初始化,并将前向计算预编译为“前置 rearrange 拆轴 → 底层单字母 einsum 权重缩并 → 后置 rearrange 合轴 + 广播偏置”的三步高效管线。
4. 经典深度学习架构重构 Case Studies
4.1 视觉特征重排:Vision Permutator 与 ShuffleNet 通道混洗
论文正文展示的第一个重构案例是 Vision Permutator。该架构的核心思想是分别沿着图像的高度(Height)方向和宽度(Width)方向对分段通道特征做线性混合。在原始作者的开源代码中,为了完成这两个方向的投影,不得不编写两段充满魔术下标 permute 与 reshape 的冗长代码;而在 Einops 重构版中,高度混合与宽度混合呈现出了完美的数学对称性——两者的唯一区别仅仅是把 Pattern 中的 h 和 w 互换位置:
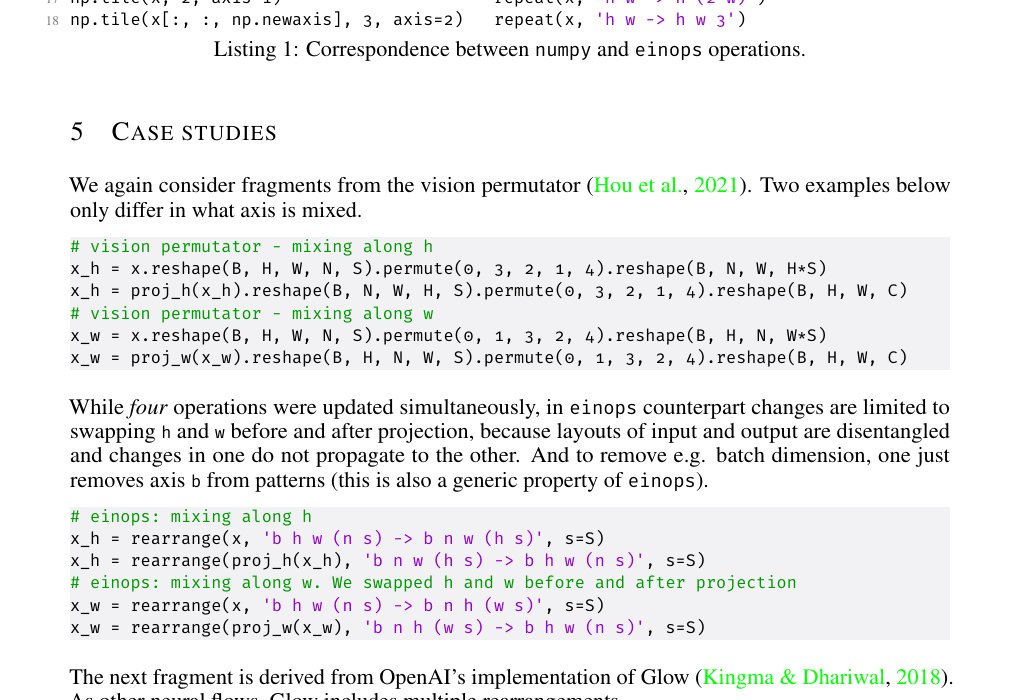
# 沿高度方向 (h) 混合分段特征: 将 h 并入线性层作用的最后一维 (h s)
x_h = rearrange(x, 'b h w (n s) -> b n w (h s)', s=s)
x_h = rearrange(proj_h(x_h), 'b n w (h s) -> b h w (n s)', s=s)

# 沿宽度方向 (w) 混合分段特征: 仅需交换上面两行中的 h 与 w
x_w = rearrange(x, 'b h w (n s) -> b n h (w s)', s=s)
x_w = rearrange(proj_w(x_w), 'b n h (w s) -> b h w (n s)', s=s)
另一个极具代表性的视觉算子是 ShuffleNet 的通道混洗(Channel Shuffle)。为了打破分组卷积(Group Convolution)各组之间的信息壁垒,ShuffleNet 需要把通道维 C 拆成 groups × channels_per_group 矩阵,转置后再展平回 C。对比原生 PyTorch 的 4 行位置操作与 Einops 的单行声明:
# 原生 PyTorch 写法:需手动计算整除、记忆维度下标 1 和 2,并显式处理 contiguous
batch, channels, height, width = x.shape
x_old = x.view(batch, groups, channels // groups, height, width)
x_old = x_old.transpose(1, 2).contiguous().view(batch, channels, height, width)

# Einops 写法:将 (groups channels_per_group) 翻转为 (channels_per_group groups),意图一目了然
x_new = rearrange(
    x,
    'b (groups c_per_group) h w -> b (c_per_group groups) h w',
    groups=groups,
)
4.2 可逆空间变换:Glow Squeeze、PixelShuffle 与 ViT Patchify 的 C-Order 陷阱
在生成流模型(如 Glow)、超分辨率上采样(Sub-pixel Convolution / PixelShuffle)以及 Vision Transformer(ViT)中,最核心的结构操作是空间网格与通道/序列之间的无损可逆映射。
看论文中 Glow 模型的 squeeze(Space-to-Depth)与 unsqueeze(Depth-to-Space)对比。在传统写法中,正向与逆向的 transpose 置换数组分别是 (0, 1, 4, 2, 5, 3) 和 (0, 3, 4, 1, 5, 2),肉眼根本无法判断这两个数组是否互为逆排列;而在 Einops 中,逆变换永远等于把正向 Pattern 箭头左右两侧的字符串直接对调:
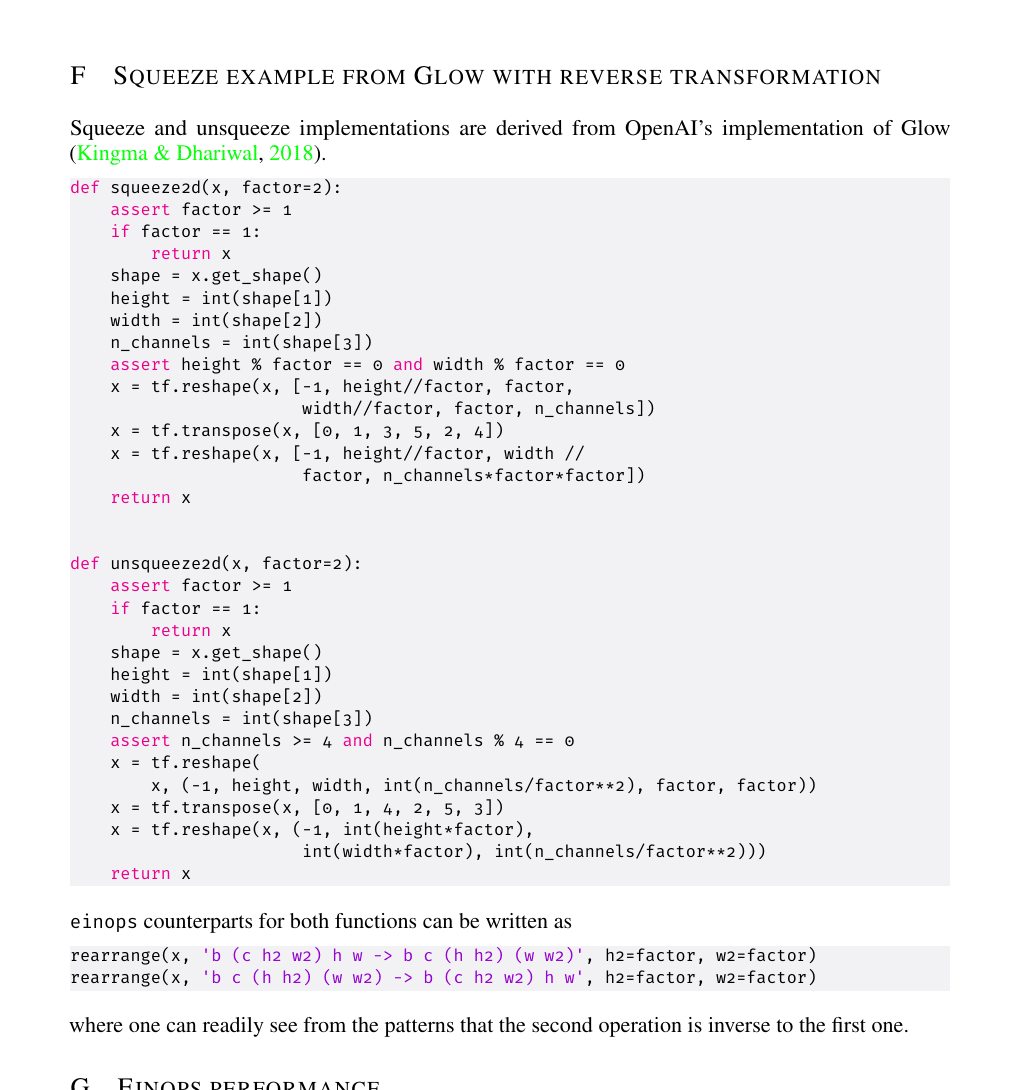
def space_to_depth(x, factor=2):
    # 正向:把 2x2 空间子块 (fh, fw) 折叠进通道维
    return rearrange(x, 'b c (h fh) (w fw) -> b (c fh fw) h w', fh=factor, fw=factor)

def depth_to_space(y, factor=2):
    # 逆向:直接将箭头左右两侧对调,100% 保证代数可逆!
    return rearrange(y, 'b (c fh fw) h w -> b c (h fh) (w fw)', fh=factor, fw=factor)
同样的可逆对称性也直接应用于 ViT 的图像分块(Patchify / Unpatchify):
# Patchify: (b, 3, 224, 224) -> (b, 14*14, 16*16*3) = (b, 196, 768)
patches = rearrange(
    images,
    'b c (grid_h patch_h) (grid_w patch_w) -> b (grid_h grid_w) (patch_h patch_w c)',
    patch_h=16, patch_w=16,
)

# Unpatchify: 交换箭头两侧,将生成的 Patch 序列无损拼回完整图像
restored = rearrange(
    patches,
    'b (grid_h grid_w) (patch_h patch_w c) -> b c (grid_h patch_h) (grid_w patch_w)',
    grid_h=14, grid_w=14, patch_h=16, patch_w=16, c=3,
)
工程避坑指南(C-order 权重错位陷阱):在加载开源预训练 ViT 或 MAE 权重时,请务必核对最后一个括号里写的是 (patch_h patch_w c) 还是 (c patch_h patch_w)!两者的乘积都是 ,但前者对应 [R0, G0, B0, R1, G1, B1, ...] 的像素交错排列,后者对应 [R0, R1, ..., G0, G1, ..., B0, B1, ...] 的通道平面排列。如果与预训练权重的线性投影层(nn.Linear(768, dim))顺序不一致,模型不报任何错,但提取出的视觉特征会彻底失真。
4.3 Multi-Head Attention 全链路重构
论文附录对比了标准多头注意力(Multi-Head Attention)的原生写法与 Einops 重构版:
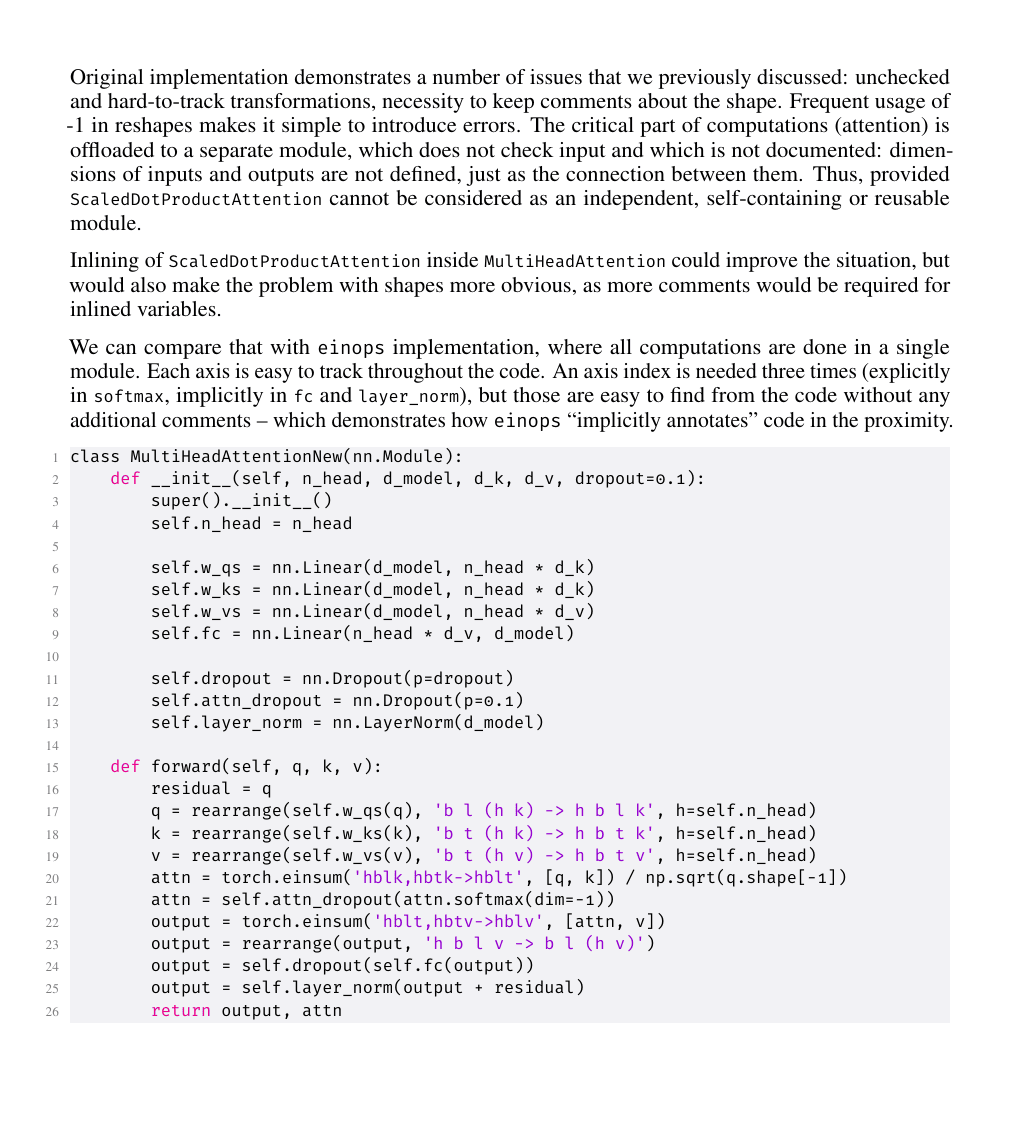
结合 rearrange 与 einsum,多头注意力的“拆头 → 缩放点积 → Softmax → 聚合 Value → 并头”五步曲可以直接写成像数学公式一样清晰的自解释代码:
from einops import einsum, rearrange

# 1) 拆头:将融合通道维拆解为显式的 head 与 dim 轴
q = rearrange(q, 'b query (head dim) -> b head query dim', head=heads)
k = rearrange(k, 'b key   (head dim) -> b head key   dim', head=heads)
v = rearrange(v, 'b key   (head dim) -> b head key   dim', head=heads)

# 2) 沿 dim 轴点积缩并,得到注意力矩阵 (b, head, query, key)
scores = einsum(q, k, 'b head query dim, b head key dim -> b head query key') / (q.shape[-1] ** 0.5)
attn = scores.softmax(dim=-1)

# 3) 沿 key 轴加权聚合 Value,并将 head 与 dim 重新合并回特征维
out = einsum(attn, v, 'b head query key, b head key dim -> b head query dim')
out = rearrange(out, 'b head query dim -> b query (head dim)')
5. 编译器源码精读(上):从 ParsedExpression 到 TransformRecipe
为什么一句简单的字符串 'b c (h kh) (w kw) -> b h w c' 能够处理任意维度的拆分、置换、池化与广播?打开 einops v0.8.2 源码,你会发现它的核心其实是一个不折不扣的微型张量结构编译器。
无论是 rearrange、reduce 还是 repeat,在 einops/einops.py 中最终都汇聚到同一条两阶段编译与执行管线(其中 rearrange 和 repeat 只是将 operation 分别设为 'rearrange' 和 'repeat' 后复用通用管线):
用户调用: reduce(x, 'b c (h kh) (w kw) -> b h w c', 'mean', kh=2, kw=2)
  │
  ├─► Stage 0: get_backend(x) ──► 识别框架后端 (如 TorchBackend),获取输入秩 ndim = 4
  │
  ├─► Stage 1 [静态编译,一级 LRU 缓存 (maxsize=256)]:
  │     _prepare_transformation_recipe(pattern, operation='mean', axes_names=('kh','kw'), ndim=4)
  │       ├── ParsedExpression(left) & ParsedExpression(right) 词法扫描与括号语法树解析
  │       ├── 校验集合不变量 (A_R ⊂ A_L) 与单复合轴最多 1 个未知因子约束
  │       └── 产出与具体图像分辨率无关的静态配方 TransformRecipe
  │
  ├─► Stage 2 [运行时形状解算,二级 LRU 缓存 (maxsize=1024)]:
  │     _reconstruct_from_shape(recipe, shape=(8, 64, 32, 32), axes_dims=(2, 2))
  │       ├── 解出全部 6 个基本轴长度: b=8, c=64, h=16, kh=2, w=16, kw=2
  │       └── 代数化简产出五步算子参数: (init_shapes, axes_reordering, reduced_axes, added_axes, final_shapes)
  │
  └─► Stage 3 [后端原语执行]:
        _apply_recipe(backend, x, ...) ──► 依次调用 backend.reshape / transpose / reduce
5.1 词法解析器 ParsedExpression 与 AnonymousAxis 身份比较技巧
管线的第一站是位于 einops/parsing.py 的 ParsedExpression 类。它对箭头左、右两侧的字符串分别执行单趟扫描,提取出两个最关键的结构:
identifiers:当前侧出现的所有基本轴集合;composition:一个二维嵌套列表list[list[Axis]],外层列表的每个元素对应张量的一个物理维度,内层列表记录该物理维度由哪几个基本轴按 C-order 顺序合成(空列表[]代表数字1或()单位轴)。
例如,解析左侧字符串 'b c (h kh) (w kw)' 时,ParsedExpression 产出的 composition 为:
left.composition = [
    ['b'],          # 第 0 维:单一基本轴 b
    ['c'],          # 第 1 维:单一基本轴 c
    ['h', 'kh'],    # 第 2 维:复合轴 (h kh)
    ['w', 'kw'],    # 第 3 维:复合轴 (w kw)
]在这里,parsing.py 藏着一个非常精巧的面向对象技巧:当用户在 Pattern 中写下大于 1 的匿名数字(例如 reduce(x, 'b (h 2) (w 2) -> b h w', 'max') 中的两个 2)时,如果直接用整数 2 或字符串 '2' 存入 composition,解析器就会误以为左边的两个 2 是同一个轴名(从而触发“单侧不允许重复轴名”报错)!
为了解决这个问题,ParsedExpression 每遇到一个大于 1 的整数,就会实例化一个独立的 AnonymousAxis("2") 对象。由于 AnonymousAxis 类故意不重写 __eq__ 方法(默认使用 Python 对象内存地址 id 做相等判断),因此左侧的两个 AnonymousAxis("2") 在集合 identifiers 中是两个完全不相等的独立基本轴,各自拥有固定长度 2,既避免了命名冲突,又防止了左右两侧碰巧相同的数字被错误配对转置!
5.2 _prepare_transformation_recipe 与静态 TransformRecipe 编译推演
拿到左右两个 ParsedExpression 后,einops/einops.py 中的 _prepare_transformation_recipe() 开始编译静态配方 TransformRecipe。
为了让你彻底看懂编译器内部做了什么,我们直接用刚才的 2×2 平均池化并转置 NHWC 的例子——reduce(x, 'b c (h kh) (w kw) -> b h w c', 'mean', kh=2, kw=2),一步步推演 TransformRecipe 的生成过程:
- 给左侧基本轴分配内部连续编号:
扫描左侧
['b'], ['c'], ['h', 'kh'], ['w', 'kw'],共有 6 个基本轴,按出现顺序编号为:0: b,1: c,2: h,3: kh,4: w,5: kw
- 划分已知轴(Known)与未知轴(Unknown):
因为调用方传入了关键字参数
axes_names=('kh', 'kw'),所以在静态编译期,轴3 (kh)和轴5 (kw)是已知轴,其余0 (b),1 (c),2 (h),4 (w)是待从输入x.shape中推导的未知轴。编译器据此生成input_composition_known_unknown:- 物理维 0 (
b):known=[], unknown=[0] - 物理维 1 (
c):known=[], unknown=[1] - 物理维 2 (
(h kh)):known=[3], unknown=[2](仅 1 个未知数2,合法!) - 物理维 3 (
(w kw)):known=[5], unknown=[4](仅 1 个未知数4,合法!)
- 物理维 0 (
- 计算基本轴置换数组
axes_permutation与归约分界点first_reduced_axis: 编译器观察右侧表达式'b h w c',发现需要保留的基本轴按输出顺序是[0 (b), 2 (h), 4 (w), 1 (c)];而被消去(需要做mean归约)的基本轴是[3 (kh), 5 (kw)]。 编译器将“保留轴”排在前面,“待归约轴”统一排到尾部,得到:axes_permutation = [0, 2, 4, 1, 3, 5]first_reduced_axis = 4(意味着置换后的第 4、5 号维度将被一次性reduce消掉!)
- 记录最终输出合并规则
output_composite_axes: 归约消掉尾部两个轴后,剩下的 4 个轴刚好一一对应右侧的'b h w c',故output_composite_axes = [[0], [1], [2], [3]]。
将上述结果汇总,就是 TransformRecipe 的七个核心静态属性:
TransformRecipe 属性 | 物理含义 | 本例编译出的具体值 |
|---|---|---|
elementary_axes_lengths | 各基本轴的静态已知长度或未知占位符 | [Unknown, Unknown, Unknown, Arg(kh), Unknown, Arg(kw)] |
axis_name2elementary_axis | 关键字参数名到基本轴编号的映射 | {'kh': 3, 'kw': 5} |
input_composition_known_unknown | 每个输入物理维度的 (已知轴列表, 未知轴列表) | [([], [0]), ([], [1]), ([3], [2]), ([5], [4])] |
axes_permutation | 将拆开后的基本轴重排为“输出序 + 尾部归约序” | [0, 2, 4, 1, 3, 5] |
first_reduced_axis | 置换后尾部待归约轴的起始下标 | 4(对应置换后的 kh 与 kw) |
added_axes | repeat 新增广播轴的目标位置映射 | {}(本例非 repeat) |
output_composite_axes | 归约/广播后,各输出物理维度包含的轴下标 | [[0], [1], [2], [3]] |
5.3 运行时 Shape 方程求解、代数化简与五步标准流水线
进入 Stage 2,当一个真实形状为 x.shape = (8, 64, 32, 32) 且参数为 kh=2, kw=2 的张量到达 _reconstruct_from_shape_uncached() 时,求解器对每个输入物理维 (长度为 )计算已知轴乘积 :
- 对于物理维 2(),已知轴
3 (kh)长度为 ,校验 通过,解出未知轴2 (h)的长度 ; - 同理解出全部 6 个基本轴的真实长度为
[8, 64, 16, 2, 16, 2]。
随后,_apply_recipe() 将解算出的参数送入五步标准后端执行流水线:
def _apply_recipe(backend, tensor, reduction_type, axes_dims):
    init_shapes, axes_reordering, reduced_axes, added_axes, final_shapes, n_axes_w_added = (
        _reconstruct_from_shape(recipe, backend.shape(tensor), axes_dims)
    )
    if init_shapes is not None:                       # Step 1. 初次 reshape:把输入复合轴拆成基本轴
        tensor = backend.reshape(tensor, init_shapes)
    if axes_reordering is not None:                   # Step 2. transpose:按目标顺序重排,并把归约轴移到末尾
        tensor = backend.transpose(tensor, axes_reordering)
    if len(reduced_axes) > 0:                         # Step 3. reduce:一次性对尾部待消去轴执行归约
        tensor = _reduce_axes(tensor, reduction_type=reduction_type, reduced_axes=reduced_axes, backend=backend)
    if len(added_axes) > 0:                           # Step 4. add_axes:插入单位轴并 expand/tile 广播 (repeat)
        tensor = backend.add_axes(tensor, n_axes=n_axes_w_added, pos2len=added_axes)
    if final_shapes is not None:                      # Step 5. 最终 reshape:将基本轴合并为目标输出复合轴
        tensor = backend.reshape(tensor, final_shapes)
return tensor不仅如此,编译器在产出这五步参数时还内置了代数化简优化:
- 在刚才的例子里,Step 3 对尾部第
(4, 5)维执行完mean归约后,张量形状已经直接变成了(8, 16, 16, 64),恰好等于目标输出形状!因此编译器自动将final_shapes设为None,直接省去了 Step 5 的多余reshape! - 再比如当你调用
rearrange(x, 'a b c d -> (a b) (c d)')时,由于相邻基本轴的相对次序完全没有改变,编译器会自动将相邻同序轴合并,把init_shapes和axes_reordering全部化简为None,整条流水线直接坍缩为单次backend.reshape!
6. 编译器源码精读(下):两级缓存、惰性多后端分发与 torch.compile 穿透
6.1 两级 @lru_cache 与解析开销基准实测
既然 Einops 内部有词法扫描、集合校验与整数方程求解,在训练循环中每秒调用上万次会不会拖慢 GPU?
答案藏在 einops/einops.py 的两级 @functools.lru_cache 设计中:
- 一级 Recipe 缓存(
@functools.lru_cache(256),修饰_prepare_transformation_recipe):缓存键为(pattern, operation, axes_names_tuple, ndim)。同一个 Pattern 字符串在整个训练生命周期中只会被解析和编译一次。 - 二级 Shape 计划缓存(
@functools.lru_cache(1024),修饰_reconstruct_from_shape):缓存键为(recipe, shape_tuple, axes_dims_tuple)。在固定输入形状的训练 Step 中,连基本的整除校验和五元组构造都会直接查表跳过,瞬间直达底层的backend.reshape / transpose!
论文附录专门在极小的 NumPy 数组上测试了缓存机制的加速比,并统计了对流行视觉模型库的代码行数压缩效果:
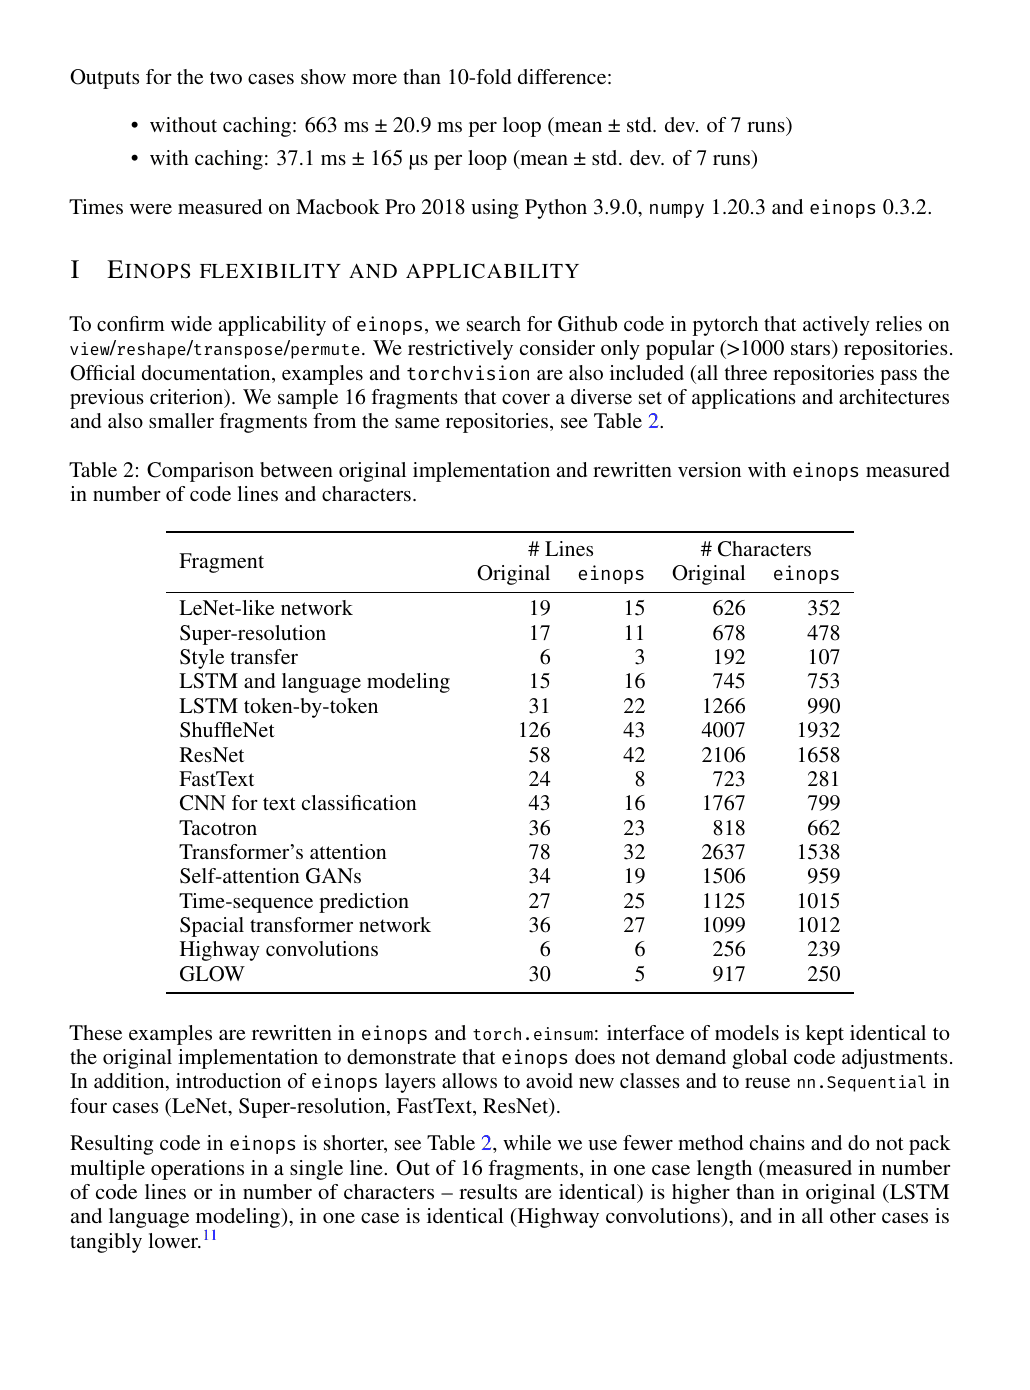
实验表明,在刻意构造 10,000 个互不相同的 Pattern 强行击穿缓存时,10,000 次调用耗时 663 ms;而在符合真实训练场景的缓存命中状态下,10,000 次调用仅耗时 37.1 ms(单次调度开销仅约 3.7 微秒,加速近 18 倍)。
6.2 零核心依赖的秘密:sys.modules 惰性分发与 AbstractBackend
为什么 pip install einops 可以在不安装任何深度学习框架的情况下秒级完成,却能在运行时无缝操作 PyTorch、JAX、TensorFlow、CuPy、Paddle、tinygrad 和 Apple MLX 的张量?
打开 einops/_backends.py,核心机制浓缩在 get_backend(tensor) 函数中:
_type2backend: Dict[type, AbstractBackend] = {}

def get_backend(tensor) -> AbstractBackend:
    _type = type(tensor)
    result = _type2backend.get(_type, None)
    if result is not None:
        return result

    for framework_name, backend in list(_loaded_backends.items()):
        if backend.is_appropriate_type(tensor):
            _type2backend[_type] = result = backend
            return result

    # 仅遍历那些 framework_name 已经存在于 sys.modules 中的 AbstractBackend 子类!
    for BackendSubclass in AbstractBackend.__subclasses__():
        if BackendSubclass.framework_name in sys.modules:
            backend = BackendSubclass()
            _loaded_backends[BackendSubclass.framework_name] = backend
            if backend.is_appropriate_type(tensor):
                _type2backend[_type] = result = backend
                return result
这段不到 25 行的分发器解决了三个棘手的系统问题:
- 零启动拖累:绝不在
import einops时主动import torch或import tensorflow,只有当用户自己的代码已经导入了某个框架(从而出现在sys.modules中)时,才按需实例化对应的后端适配器; - 热路径 查表:首次识别出
torch.Tensor后,直接将torch.Tensor -> TorchBackend缓存在_type2backend字典中,后续千万次调用只需一次指针哈希查找; - 最小契约隔离:面对各大框架五花八门的 API 命名(如下图所示),
AbstractBackend仅要求子类实现shape、reshape、transpose、reduce、add_axes、stack_on_zeroth_dimension、concat、einsum等 9 个最小方法,新增一个框架后端(如v0.8.2新增的MLXBackend)只需短短几十行代码。
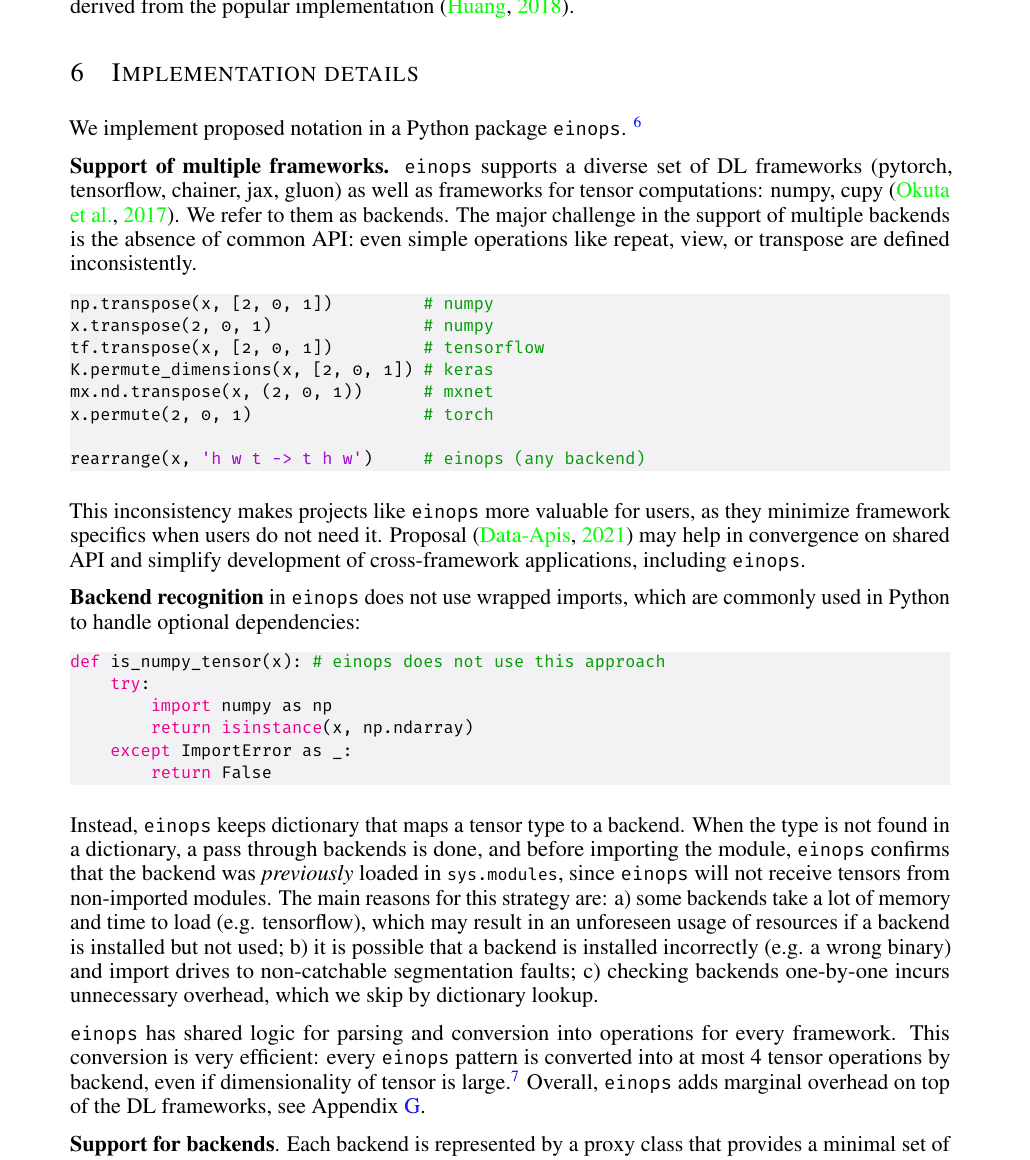
此外,针对遵循 Python Array API Standard(提供 __array_namespace__() 接口)的现代数组库,einops 还提供了 einops.array_api 模块,直接通过标准命名空间调用 xp.reshape、xp.permute_dims 与 xp.broadcast_to。
6.3 PyTorch 图编译器适配:torch.compile、TorchDynamo 与 SymInt
在 PyTorch 2.x 时代,工程师最关心的是:在模型里写 rearrange 会不会导致 torch.compile 发生计算图断裂(Graph Break)?
答案是不会。打开 einops/_torch_specific.py,可以看到 Einops 针对 PyTorch 的两代编译器做了专门适配:
- 针对
torch.compile(TorchDynamo)的穿透适配:在 PyTorch 2.0 ~ 2.7 中,allow_ops_in_compiled_graph()会自动将rearrange、reduce、repeat、einsum、pack、unpack注册进torch._dynamo.allow_in_graph;而在 PyTorch 2.8+ 中,由于 Dynamo 字节码追踪器已经原生支持追踪@lru_cache与内部字典操作,Dynamo 可以直接穿透整条_apply_recipe管线,将最终生成的tensor.reshape与tensor.permute捕获进 FX Graph,交由后端的 TorchInductor 自动与前后的矩阵乘或激活函数做算子融合(Kernel Fusion)! - 针对动态形状
torch.SymInt的算术兼容:当开启torch.compile(dynamic=True)时,tensor.shape中的动态批次或序列维度会由普通 Pythonint变为符号整数SymInt。在_reconstruct_from_shape_uncached()中,源码通过isinstance(length, int)区分静态常数与符号维度:对符号维度跳过仅限常数的取模断言,直接构造符号整除表达式length // known_product,确保动态 Shape 计算图完整不断裂。
7. 物理内存布局(View vs Copy)、能力边界与生态横向对比
7.1 什么时候返回零拷贝 View?什么时候触发物理 Copy?
高频算子调优中常有人问:“rearrange 究竟是零拷贝视图(View)还是会发生物理内存复制(Copy)?”
这取决于底层张量的步长连续性条件(Stride Contiguity)。在 PyTorch 中,一个形状为 、步长为 的张量,两个相邻维度 和 能够免拷贝合并为一个维度的充要条件是:
我们用 x = torch.randn(2, 3, 4, 5)(标准 NCHW 连续张量,初始步长为 (60, 20, 5, 1))测试三种最常见的 rearrange 模式,底层的内存行为一目了然:
| 调用表达式 | 编译器生成的底层算子序列 | 输出张量的 Stride | 是否发生物理内存拷贝? |
|---|---|---|---|
rearrange(x, 'b c h w -> b h w c') | x.permute(0, 2, 3, 1) | (60, 5, 1, 20) | 零拷贝(View):仅交换元数据中的 shape 与 stride 下标 |
rearrange(x, 'b c h w -> b c (h w)') | x.reshape(2, 3, 20) | (60, 20, 1) | 零拷贝(View):因 ,相邻维直接合并 |
rearrange(x, 'b c h w -> b (h w) c') | x.permute(0, 2, 3, 1).reshape(2, 20, 3) | (60, 1, 20) | 零拷贝(View):转置后 h 与 w 的步长为 5 和 1,依然满足 ! |
rearrange(x, 'b c h w -> b h (w c)') | x.permute(0, 2, 3, 1).reshape(2, 4, 15) | (60, 15, 1) | 触发物理 Copy:转置后 w 与 c 的步长为 1 和 20,不满足连续条件,reshape 自动分配新内存 |
论文在 Multi-Head Attention、Vision Permutator 与 Glow Unsqueeze 三个模块上对比了手写原生 PyTorch 代码与 Einops 重构版在 CPU / GPU 及 JIT 编译下的实测吞吐:
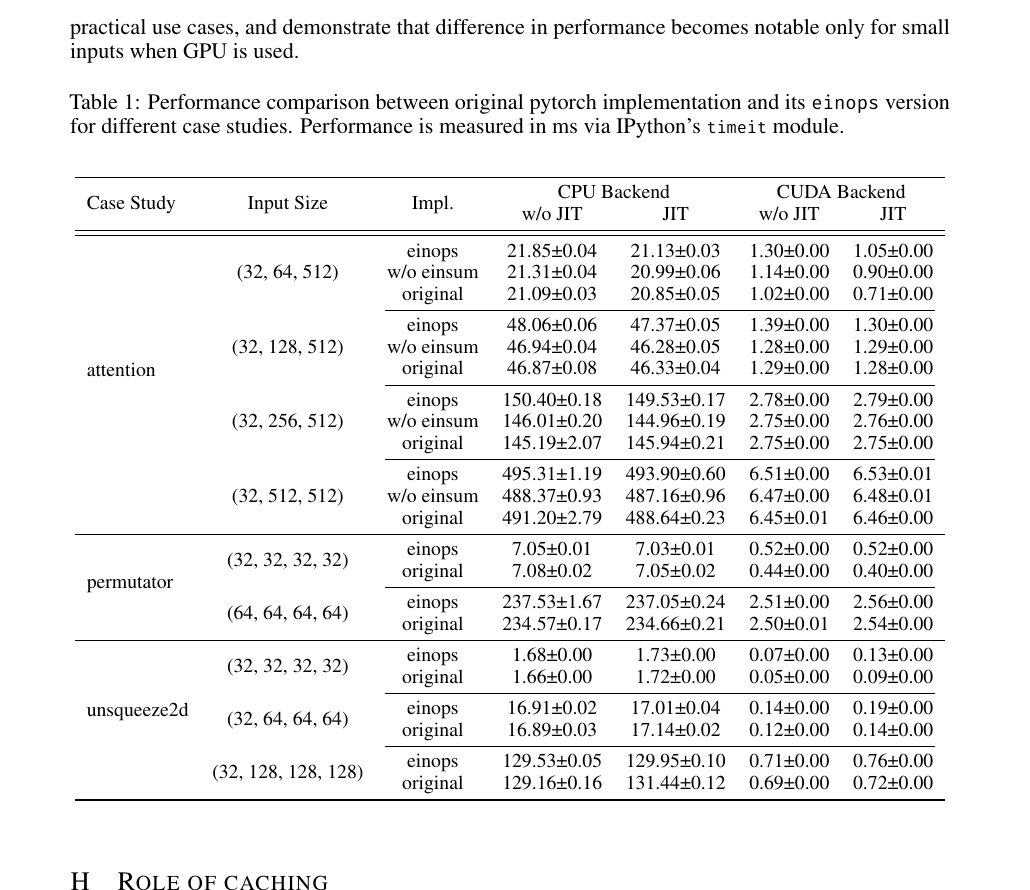
可以看到,在正常训练批次规模下,由于两级缓存消除了 Python 解析开销,且底层生成的 reshape / permute 序列与手写代码完全一致,Einops 重构版与原生手写代码处于同一性能水平。
7.2 运行时检查的真实边界:能拦截什么,不能拦截什么?
把 Einops 用出生产级可靠性,关键在于清楚它的运行时契约能拦住什么,以及绝对拦不住什么:
| 错误类型 | Einops 能否自动拦截? | 典型场景与物理原因 |
|---|---|---|
| 输入维度数(Rank)不符 | 能拦截 | 输入是 3D (b, n, c) 却调用 'b c h w -> ...',当场报维度数不匹配 |
| 基本轴集合丢失或凭空多出 | 能拦截 | rearrange 漏写了某个轴,或 repeat 忘了传新增轴长度,编译期直接报错 |
| 复合轴长度无法整除 | 能拦截 | 含 [CLS] 的 197 个 Token 传入 'b (h w) c -> b h w c', h=14,因 报错 |
| 两个等长轴(如 )写反 | 不能拦截 | 当图像是正方形 时,把 (h w) 写成 (w h),所有乘积与整除均合法,静默通过 |
| 调用点把上游张量的轴语义写反 | 不能拦截 | 上游传过来的是 NHWC,调用者却在左侧声明为 'b c h w -> ...',只要数值碰巧能整除就会按错误语义执行 |
| 跨函数边界的轴标签漂移 | 不能拦截 | 函数 A 返回 (b, tokens, c),函数 B 入口误以为是 (b, heads, c),Einops 不在 Tensor 对象上持久化存储轴名 |
7.3 与 jaxtyping、xarray 及 einx 的生态互补关系
针对上面提到的“跨函数边界缺乏静态检查(Stringly Typed)”问题,如果将 Einops 放回整个 Python 张量编程生态坐标系中,就能看清它与其他工具的黄金搭档关系:
| 方案 / 工具 | 作用位置 | 核心解决的问题 | 与 Einops 的协作或取舍关系 |
|---|---|---|---|
原生位置 API (x.T, x.mean(-1)) | 算子内部 | 极简的单步维度操作 | 2 维矩阵转置 x.T 或单轴求均值保留原生写法即可;涉及拆轴/合轴/多步转置时切换为 Einops |
jaxtyping + beartype | 函数签名边界 | 用类型注解声明函数入参与返回值的形状契约(如 Float[Tensor, "b t c"]) | 最佳互补搭档:用 jaxtyping 守住函数进出口边界,用 einops 实现函数体内部的结构变换 |
xarray / NamedTensor | 数据对象生命周期 | 将轴名作为元数据持久化绑定在数组对象上 | 适合地球科学、金融表格分析;在深度学习密集算子链中维护对象元数据侵入性过高 |
einx (ICLR 2026) | 算子内部 | 将 Einstein 语法进一步泛化到逐元素加减广播、Gather 索引与 vmap | 表达力更激进,而 Einops 刻意保持极小、正交的原语集以换取零心智负担与高稳定性 |
8. 生产级测试规范:用“互质非对称形状 + arange”揪出潜伏 Bug
既然当 或 时,写反两个等长维度不会触发任何形状异常,那我们在做模型重构和编写单元测试时,该如何 100% 揪出所有维度错位 Bug?
最有效的工程铁律是:在单元测试中,永远使用两两互不相同的素数(如 2, 3, 5, 7, 11)作为各基本轴的长度,并填充严格递增序列 np.arange 验证元素级排列等价性与正逆 Round-Trip 可逆性!
下面是一套可直接复制到项目 pytest 测试套件中的完整验证矩阵:
import numpy as np
import pytest
from einops import EinopsError, einsum, pack, rearrange, reduce, repeat, unpack

def test_einops_structural_invariants_and_roundtrip():
    # 1) 使用两两互质的轴长 (b=2, c=3, h=5, w=7) + arange,确保任何两轴写反都会导致数值断言失败
    x = np.arange(2 * 3 * 5 * 7).reshape(2, 3, 5, 7)
    np.testing.assert_array_equal(rearrange(x, 'b c h w -> b h w c'), x.transpose(0, 2, 3, 1))
    np.testing.assert_array_equal(reduce(x, 'b c h w -> b c', 'sum'), x.sum(axis=(2, 3)))
    np.testing.assert_array_equal(
        repeat(x, 'b c h w -> b copies c h w', copies=11),
        np.repeat(x[:, None], 11, axis=1),
    )

    # 2) 使用非对称网格 (h=3 != w=2, ph=5 != pw=7) 验证 Patchify / Unpatchify 的严格可逆性
    images = np.arange(2 * 3 * (3 * 5) * (2 * 7)).reshape(2, 3, 15, 14)
    patches = rearrange(images, 'b c (h ph) (w pw) -> b (h w) (ph pw c)', ph=5, pw=7)
    restored = rearrange(patches, 'b (h w) (ph pw c) -> b c (h ph) (w pw)', h=3, w=2, ph=5, pw=7, c=3)
    np.testing.assert_array_equal(restored, images)

    # 3) 验证异构 Rank 的 pack / unpack 无损还原与多字符 einsum 缩并精度
    inputs = [np.zeros((2, 5)), np.ones((2, 3, 5)), np.full((2, 4, 7, 5), 2.0)]
    packed, ps = pack(inputs, 'b * c')
    for before, after in zip(inputs, unpack(packed, ps, 'b * c')):
        np.testing.assert_array_equal(before, after)

    q = np.random.default_rng(0).normal(size=(2, 5, 3, 7))
    k = np.random.default_rng(1).normal(size=(2, 11, 3, 7))
    np.testing.assert_allclose(
        einsum(q, k, 'batch query head dim, batch key head dim -> batch head query key'),
        np.einsum('bqhd,bkhd->bhqk', q, k),
    )

    # 4) 验证破坏整除契约时精准抛出 EinopsError
    with pytest.raises(EinopsError):
        rearrange(np.zeros((2, 197, 8)), 'b (h w) c -> b h w c', h=14)
9. 总结
回看 Einops 从一篇讨论“如何写好 reshape”的 ICLR 2022 Oral 论文,成长为全行业深度学习基础设施的历程,它最深刻的启示在于对软件工程抽象边界的极致克制:
语义显式化 :用 'b c (h kh) (w kw) -> b h w c' 消灭魔术下标与过期的形状注释
契约集合化 :用 A_L 与 A_R 的集合关系切分 rearrange / reduce / repeat,在入口拦截维度丢失
编译两级化 :用静态 TransformRecipe + 动态 Shape 求解 + 双层 LRU 缓存,实现微秒级调度
后端最小化 :用 9 个 AbstractBackend 原语 + sys.modules 惰性加载,零依赖打通十余个计算框架
正如作者 Alex Rogozhnikov 所强调的:张量的形状(Shape)与轴变换关系本身就是一等公民级别的程序语义,绝不应该只留在易过期的注释、晦涩的位置下标和程序员脆弱的短期记忆里。
参考资料
- Alex Rogozhnikov, Einops: Clear and Reliable Tensor Manipulations with Einstein-like Notation (ICLR 2022 Oral)
- Einops Official Documentation & Tutorials
arogozhnikov/einopsGitHub Repository (v0.8.2, commit8e911db)- Alex Rogozhnikov, Retrospective thoughts on einops, 2023
- Python Array API Standard
- einx: Universal Tensor Operations in Einstein-Inspired Notation (ICLR 2026)
comments