大语言模型的上下文窗口已经从几千 Token 扩张到了数十万乃至百万 Token,但这并没有让持续运行的 AI Agent 自动拥有可靠的长期记忆。
想象一个陪伴用户数月的个人助理或企业级客服 Agent:用户在 1 月份聊到自己住在巴黎、在 Acme 公司担任后端工程师;3 月份顺口提了一句“我上周搬到柏林了”;6 月份又发来一条 CRM 工单事件,显示其账号对应的企业套餐已从标准版升级为企业版。如果粗暴地把几个月来的几十万字历史对话和 JSON 事件全量塞进 Prompt,不仅每次请求的首字延迟(TTFT)飙升到二三十秒、Token 账单爆炸,更致命的是——当历史记录里同时躺着“住在巴黎”和“搬到柏林”两条相反的陈述时,注意力被海量噪音稀释的模型很容易发生时空错乱,拿过期事实回答当前问题。
反过来,如果照搬静态文档的向量 RAG 或 Microsoft GraphRAG 呢?静态知识图谱默认“语料是一次性导入的客观真理”:一旦新消息推翻了旧状态,缺乏时间维度建模的图谱要么把新旧两条冲突边并排挂在节点上,要么需要耗费巨资对整张图重跑社区聚类与全局摘要。
面对这一核心痛点,Zep AI 团队在论文 Zep: A Temporal Knowledge Graph Architecture for Agent Memory 中提出了动态时态知识图谱引擎 Graphiti。在平均历史长度达 115K Tokens 的 LongMemEval 基准上,基于 Graphiti 构建的 Zep 记忆服务将每次送入模型的上下文体积从 115k 压缩至 1.6k Tokens(缩减率达 98.6%),端到端响应延迟从约 30 秒压低至 2.58~3.20 秒(下降约 90%),同时将 GPT-4o 的跨会话记忆问答准确率从 60.2% 拉升至 71.2%。
透过论文推导与 Graphiti v0.29.2 开源代码,这套架构最核心的工程巧思可以提炼为四条设计哲学:
- 三层解耦的记忆图:用原始 Episode 无损溯源,用语义层与社区层加速导航(Three-Tier Memory Graph with Non-Lossy Provenance):递归文本摘要最怕一旦漏掉某个细节就永远无法找回。Graphiti 将记忆图拆成原始事件层(Episode Subgraph)、语义实体层(Semantic Entity Subgraph)与高阶社区层(Community Subgraph),并用双向溯源边锁死关联——上层实体和社区负责提炼关系与全局背景,底层 Episode 永远保留一字不改的原始输入。
- 双时态事实生命周期:区分“现实何时发生”与“系统何时得知”,用有效期闭合替代物理删除(Bitemporal Edge Lifecycle):用户在现实中搬家的时间(Valid Time)和三天后在聊天里告诉 Agent 的时间(Transaction Time)往往不一致。Graphiti 为每条事实边维护四个时间戳,当新事件推翻旧状态时,通过闭合旧边的有效时间窗口将其平滑转为历史归档,从而同时支持“当前状态查询”、“历史时点回溯”与“系统认知审计”。
- 局部邻域消歧与增量图维护:拒绝全图重算,把每次写入开销收敛在局部子图(Localized Incremental Maintenance):流式记忆系统承受不起每次来一条消息就扫描全图。无论是用“向量 + 全文检索”召回候选节点做实体消歧,还是把事实去重与矛盾检测严格限制在“同一对源/目标实体之间的已有边集合”内,抑或是用邻居多数投票动态更新社区归属,本质上都是为了把单次写入复杂度锁定在局部常数级。
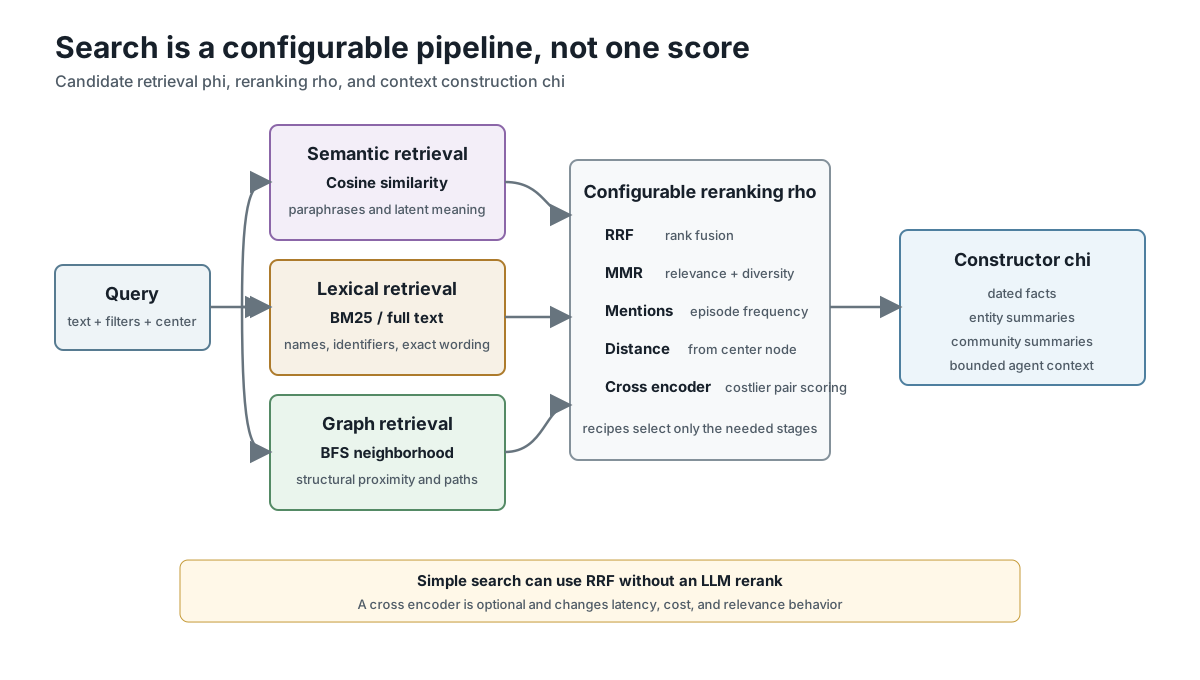
- 查询路径去 LLM 化:多路检索 + 轻量级重排 + 线性模板拼装,守住毫秒级在线延迟(Fast Hybrid Retrieval without LLM-in-the-Loop):把繁重的 LLM 抽取与消歧留在异步写入阶段,而在用户发起查询的在线关键路径上,纯粹组合余弦相似度、BM25 全文检索与图广度优先遍历(BFS),配合 RRF、MMR、图距离或轻量级 Cross Encoder 毫秒级合成最终上下文。
1. 为什么传统方案撑不起 Agent 长期记忆?问题拆解与生态位边界
1.1 长上下文、静态向量 RAG 与递归摘要的三大软肋
在工程上,“把历史存下来”只算完成了日志收集;真正的 Agent 长期记忆必须同时解决状态演化、跨会话关联与低延迟召回。审视现有的三类常见替代方案,可以清楚看到各自的失效边界:
| 记忆方案 | 核心工作机制 | 面对流式动态事件时的根本缺陷 |
|---|---|---|
| 全量长上下文(Full-Context Window) | 将历史会话与业务事件原封不动拼接进 Prompt | 成本与 Prefill 延迟随时间线性发散;历史过长引发“大海捞针”注意力退化;新旧矛盾陈述并存时模型只能盲猜哪条有效 |
| 静态文档向量 RAG(Naive Chunk RAG) | 将对话切块嵌入,查询时取 Top- 相似片段 | 向量距离无法表达时间先后与状态覆写(“喜欢拿铁”和“戒了咖啡改喝茶”会被同时高分召回);跨多段对话的实体关系链完全断裂 |
| 递归摘要记忆(Recursive Summarization) | 每隔几轮用 LLM 将历史对话压缩成一段总结 | 不可逆的信息有损坍缩:摘要器无法预知三个月后用户会问哪个边角料细节,早期漏掉的日期或否定词永久丢失,且多轮摘要会逐级放大幻觉 |
真正棘手的记忆难题是“承认某条事实曾经正确,但现在已经失效”。比如客户去年签约的是基础版,今年升级成了旗舰版——如果用户问“我现在有哪些权限?”,系统必须只用旗舰版事实作答;但如果财务审计问“去年 10 月这位客户是什么套餐?”,系统又必须能精准调出当年那条已归档的历史记录。这正是将时态知识图谱(Temporal Knowledge Graph)引入 Agent 记忆的直接动因。
1.2 Graphiti 开源引擎、论文 Zep 服务与商业产品的架构边界
在深入源码之前,有必要厘清生态中经常出现的三个名称:
- 开源引擎 Graphiti(Apache-2.0,当前稳定基线
v0.29.2):负责动态时态知识图谱构建、双时态事实维护与混合检索的核心 Python 库,支持插拔 Neo4j、FalkorDB、Amazon Neptune 等图数据库驱动与多种大模型供应商,并提供可选的 MCP Server 与 FastAPI 封装。 - 论文评测的 Zep 系统:论文实验中所测量的端到端记忆服务,其内核正是 Graphiti 图引擎,外层配合了云端异步摄取队列与上下文组装服务。
- 商业托管产品 Zep Context Lake:面向企业级生产的托管平台,在 Graphiti 思想之上叠加了专有存储优化、多租户基础设施与 SLA 保障。
理解这一分层,就能明白 Graphiti 在技术栈中的准确位置:它处在“上游业务事件流(对话、工单、JSON)”与“下游大模型 Prompt 上下文”之间,是一个持续将非结构化事件流编译为双时态结构化记忆,并在查询时按需逆向合成为精简文本上下文的记忆中间件。
2. 核心设计哲学一:三层解耦的记忆图与非损失证据溯源
2.1 有向多图形式化与三层子图拓扑
论文将整张记忆图定义为带关联函数的有向多图(Directed Multigraph):
其中 是节点集合, 是边集合, 是指派每条有向边源节点与目标节点的关联函数(Incidence Function)。之所以必须是多图(允许同一对节点之间存在多条同向边),是因为那两个实体之间不仅可能存在多种业务关系,哪怕是同一种关系(如用户多次变更居住城市或多次购买同一商品),在不同时间段也会沉淀为多条具有独立时间戳的事实边。
在此基础上,Graphiti 将 从下往上划分为三个各司其职、又通过跨层边紧密咬合的子图:
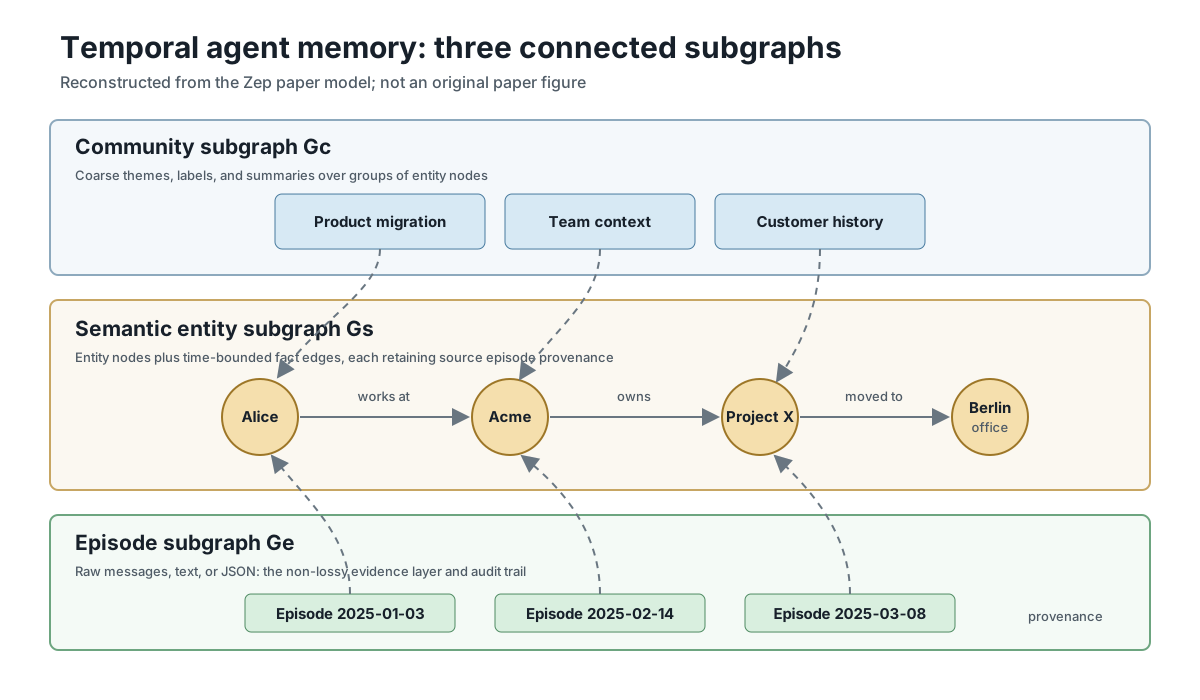
观察上图的拓扑连接,为什么一定要拆成这三层?因为“保留原始证据保真度”、“支持细粒度关系计算”与“提供宏观全局背景”这三件事,需要的图粒度完全不同:
2.2 原始事件子图(Episode Subgraph):为什么叫“非损失(Non-Lossy)”记忆?
位于最底层的 保存所有进入系统的原始事件节点(EpisodicNode)。在论文中,输入事件支持三种形态:对话消息(message)、自由文本(text)和结构化业务数据(json);到了 v0.29.2 源码中,还新增了允许直接注入确定性三元组的 fact_triple 以及自定义 metadata。每一个 Episode 节点都记录了原始正文、来源描述、分区标识 group_id,以及极其关键的事件参考时间 reference_time(即该事件在现实中发生的时间,严格区别于写库时间)。
很多读者初看论文会好奇:既然已经用大模型抽出了实体和事实,为什么还要在图数据库里存一份原始 Episode 节点并连上双向边?这带来了三个不可替代的工程收益:
- 打破“错误抽取不可逆”的死局:大模型的抽取并非 100% 准确。如果只留抽取出的三元组而扔掉原文,一旦模型把一句话理解反了,错误就成了永久的既定事实。保留 并用溯源边连接 ,意味着任何时候发现抽取有误、或者更新了领域 Ontology 与更强的基座模型,都可以直接从 Episode 节点重放(Replay)重建上层语义图。
- 细粒度原文回退:当用户询问“他当时原话是怎么评价那个方案的?”时,高度浓缩的实体摘要和三元组不足以还原语气与细节,检索器可以顺着溯源边直接把原始 Episode 捞出来拼进上下文。
- 支持多来源交叉印证:在
EntityEdge(事实边)上维护了一个episodes: list[str]数组,记录所有印证该事实的 Episode UUID。一条被 10 次不同对话反复提及的核心偏好,与仅在闲聊中顺嘴提过一次的信息,在后续重排时拥有截然不同的证据权重。
2.3 语义实体子图与社区摘要子图:从局部关系到全局脉络
中间层的 语义实体子图(Semantic Entity Subgraph, )承载从 Episode 中提炼出的结构化知识:
- 实体节点(
EntityNode):代表人物、组织、地点、产品、工单等核心对象,保存实体名称、类型标签、1024 维名称/概念 Embedding,以及一段汇总了该实体核心背景的动态summary。 - 事实边(
EntityEdge):连接源实体与目标实体,除关系谓词name(如WORKS_AT)外,还包含一句自然语言事实描述fact(如"Alice works at Acme Corp as a Staff Engineer")、1024 维事实 Embedding 以及四维双时态时间戳。这种“谓词 + 自然语言事实句”的混合设计非常务实:既能用图遍历走关系,又避免了传统本体论把复杂修饰语切得支离破碎的弊端。
最顶层的 社区子图(Community Subgraph, )则专门解决“只见树木、不见森林”的问题。当用户问出“帮我总结一下过去半年围绕 Atlas 迁移项目发生的所有关键进展”时,单靠检索几条零散的事实边无法拼出完整全局图景。为此,Graphiti 在 之上运行 标签传播算法(Label Propagation Algorithm, LPA)——这是一种无需预先指定聚类数量、直接顺着图的高密度连边把紧密关联的实体聚合成社区(CommunityNode)的图算法,随后调用 LLM 基于社区内成员实体的摘要生成整个社区的主题名称与高层综述。
更重要的是,面对持续写入的流式事件,Microsoft GraphRAG 那种动辄重跑全图 Leiden 聚类的做法成本太高。Graphiti 为社区层设计了**“局部多数投票增量扩展 + 周期性全量刷新”的双轨机制:每当新实体节点 被写入 时,系统直接查看它刚连上的所有一跳邻居节点所属的社区,将该实体直接归入邻居占多数的那个现有社区**(Majority Community),并仅触发该单一社区的摘要增量更新;只有当累积变化达到一定规模时,才在后台低峰期运行一次全图 LPA 刷新以消除长期增量带来的聚类漂移。
3. 核心设计哲学二:双时态边模型与局部增量知识维护
3.1 四维双时态模型:Valid Time 与 Transaction Time 如何各司其职?
为什么普通数据库里的一个 created_at 加一个 updated_at 搞不定 Agent 记忆?
因为现实世界存在信息传递延迟与事后回溯修正。设想用户在 2025 年 2 月 1 日从巴黎搬到了柏林,直到 2 月 10 日才在聊天里告诉 Agent:“我月初搬来柏林了”;到了 6 月 1 日用户又搬去罗马,并在 6 月 5 日告知系统。在这段历程中,实际上存在两条完全独立的时间轴:
- 事件有效时间轴(Valid Time, ):该事实在客观物理世界中何时开始成立()、何时终止失效();
- 系统事务时间轴(Transaction Time, ):该事实在Agent 记忆系统内部何时被创建入库()、何时因收到新冲突证据而被系统判定归档()。
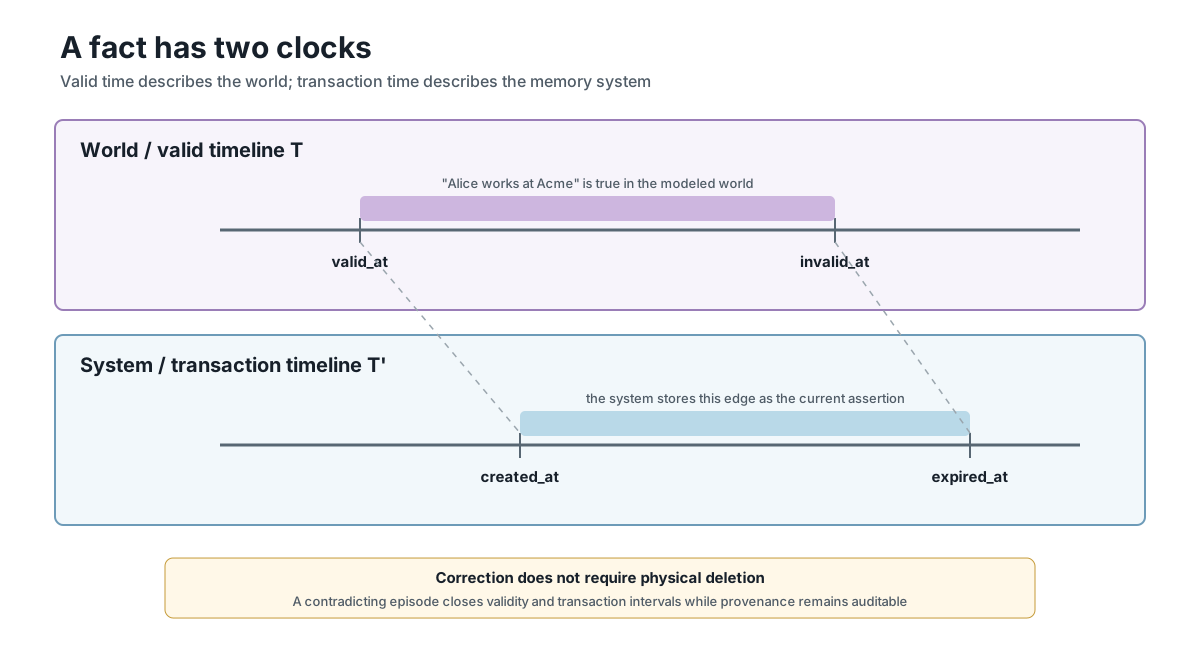
对照上图以及源码 edges.py 中的 EntityEdge 定义,这四个时间戳加上 Episode 的基准时间 reference_time,让记忆系统能够精确回答四类完全不同的时间拷问:
| 时间追问类型 | 业务场景举例 | 记忆图上的时间戳判定条件 |
|---|---|---|
| 1. 当前有效状态查询 | “用户现在住在哪座城市?” | 筛选 invalid_at IS NULL 且 expired_at IS NULL 的活动边(命中“罗马”) |
| 2. 现实历史时点回溯 | “2025 年 2 月 3 日那天,用户实际住在哪里?” | 在有效时间轴 上检查 valid_at <= 2025-02-03 < invalid_at(命中“柏林”,尽管系统到 2 月 10 日才得知此事) |
| 3. 系统历史认知审计 | “为什么 Agent 在 2 月 8 日给用户推荐了巴黎的餐厅?” | 在事务时间轴 上检查 created_at <= 2025-02-08 < expired_at(还原出 2 月 8 日当时系统还没收到搬家消息,认知仍停留在“巴黎”) |
| 4. 迟到乱序事件插入 | 7 月份补录一份 4 月份签署的补充协议 | 以协议签署日作为 reference_time 推导 valid_at,以 7 月补录时刻作为 created_at,精准嵌入历史时间线而不破坏现有最新状态 |
为了从自然语言里的相对时间词(如“上周三”、“明年一季度”、“三个月前”)推算出准确的 与 ,Graphiti 在抽取时会将当前 Episode 的 reference_time 作为时间锚点一并喂给大模型;而对于像“Alice 喜欢喝手冲咖啡”这类没有明确起止日期的长期习惯或静态事实,源码则保持区间端点为 None(开放区间),绝不强行编造伪精确日期。
3.2 增量抽取、混合候选消歧与端点约束下的矛盾失效
当一条新消息进入系统时,怎样在不扫描全图的前提下,完成从文本到双时态图的增量更新?我们顺着论文与源码 graphiti_core/utils/maintenance/ 拆解这条四步流水线:
第一步:带滑动上下文窗口与反思的实体抽取(Entity Extraction with Reflection)。 在日常对话中,单条消息充斥着代词和省略。比如用户只发了一句:“她同意下周接手那个迁移项目了。” 如果只看这一句话,任何模型都猜不出“她”是谁、“那个项目”叫什么。为此,Graphiti 在抽取当前 Episode 时,会自动拉取同一分区下前 条历史 Episode 作为上下文窗口,同时注入当前发言人(Speaker Entity),并在首次抽取后执行一轮自我反思(Reflection Prompt)检查是否有遗漏的关键实体。
第二步:向量 + 全文双路召回候选,交由 LLM 拍板实体消歧(Entity Resolution)。
抽出了临时实体节点(比如文本里写了 Acme)后,怎么知道图里是不是已经有了一个叫 Acme Corp. 的老节点?
- 如果拿新实体跟图里十万个老节点逐个调 LLM 比对,成本直接爆炸;
- 如果只按 Embedding 余弦相似度卡一个固定阈值(比如
> 0.92就合并),遇到缩写(IBMvsInternational Business Machines)容易漏合并,遇到编号相近的不同工单(INC-101vsINC-102)又极易误合并! Graphiti 的解法是“双路低成本粗召回 + LLM 局部精消歧”:先用新实体的 1024 维 Embedding 算余弦相似度,同时用实体名称跑 BM25 全文检索,在毫秒级时间内从图库捞出极少数最像的候选节点;随后把新实体与这几个候选节点的名称、上下文和已有summary打包进同一个 Prompt,让大模型综合语境判断是复用已有节点 UUID 还是新建节点,并顺手将新信息增量融合进实体的summary中。
第三步:收敛在“同一实体对”内部的事实抽取与去重。
实体节点完成消歧定型后,系统提取实体之间的事实边。紧接着要做事实去重与冲突检测——这里体现了极佳的复杂度控制:一条连接 的新事实,只可能与图中原本就已经连接在 这一对端点之间的旧边发生重复或直接矛盾! 因此,系统只需查询源节点与目标节点在 (u, v) 集合内的已有边(通常只有寥寥几条),彻底避开了全图事实扫描。
第四步:语义矛盾判定与非破坏性时态失效(Edge Invalidation)。
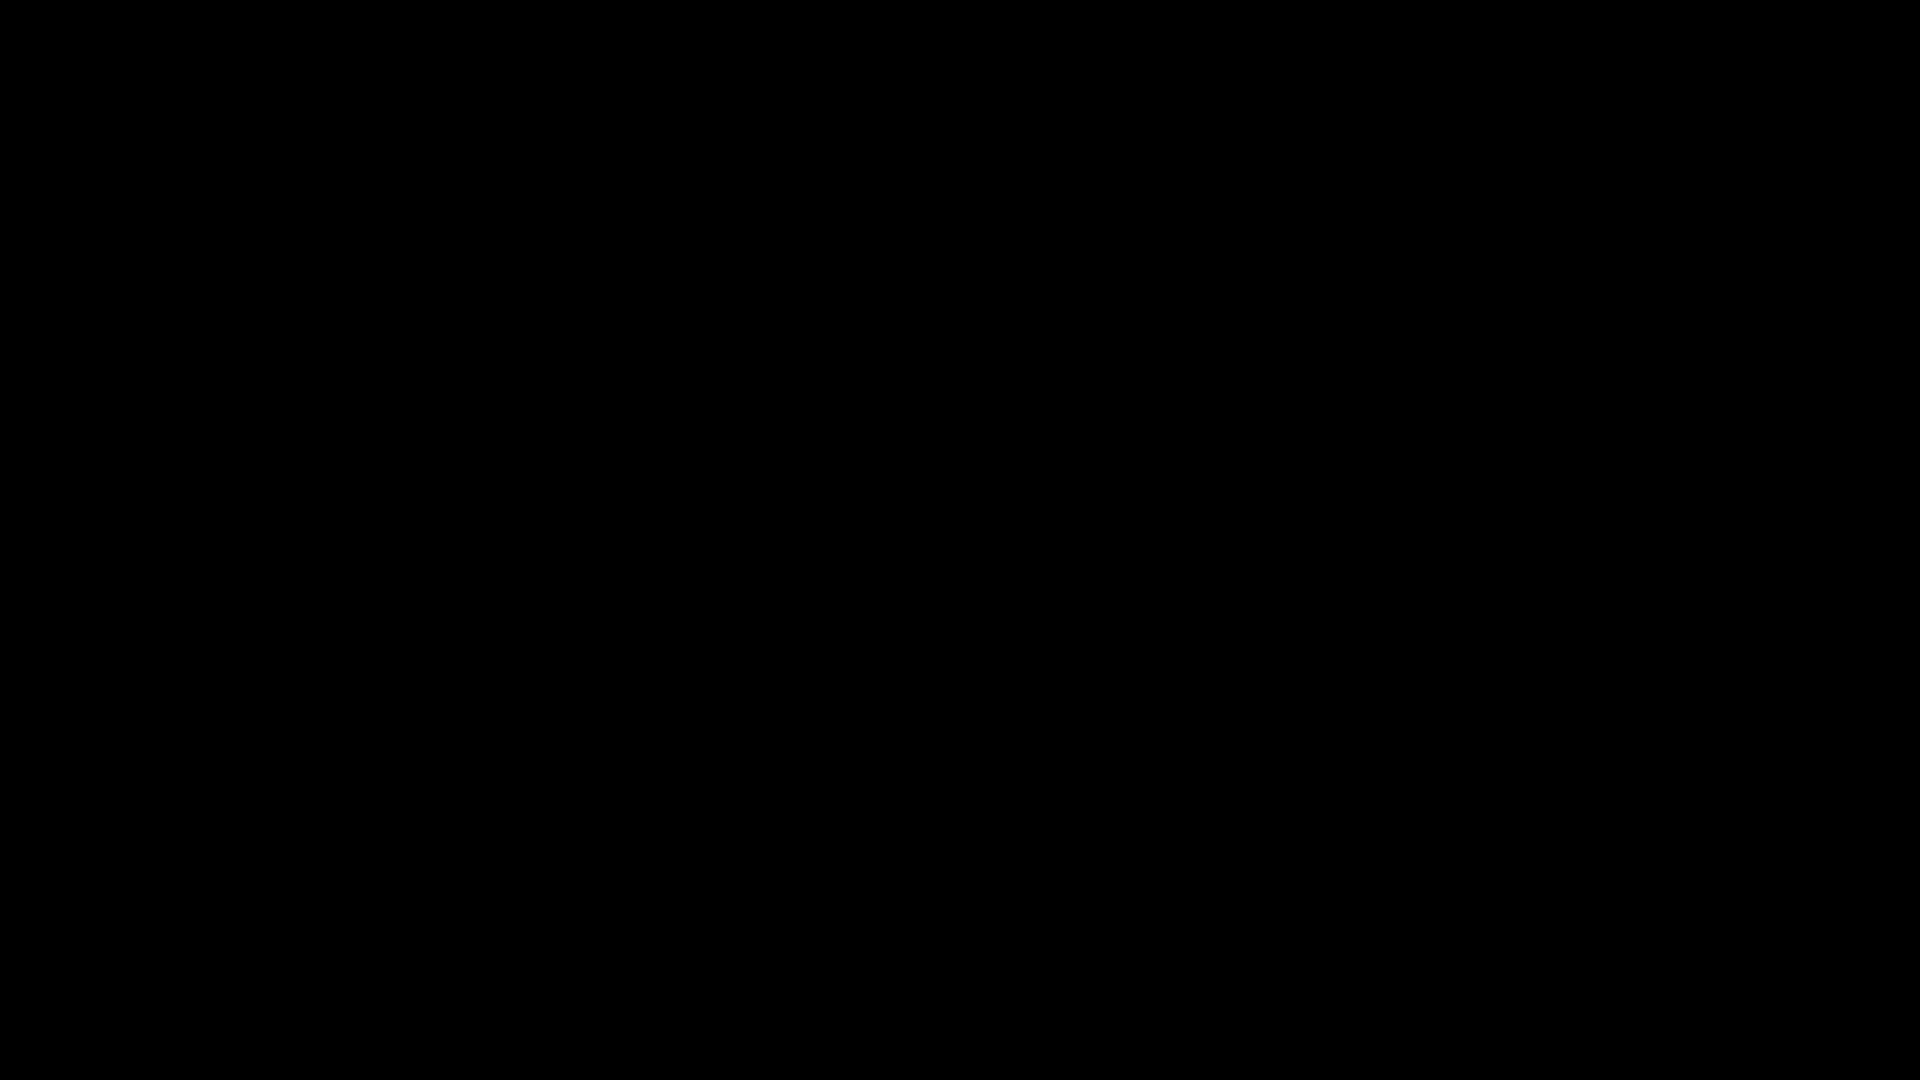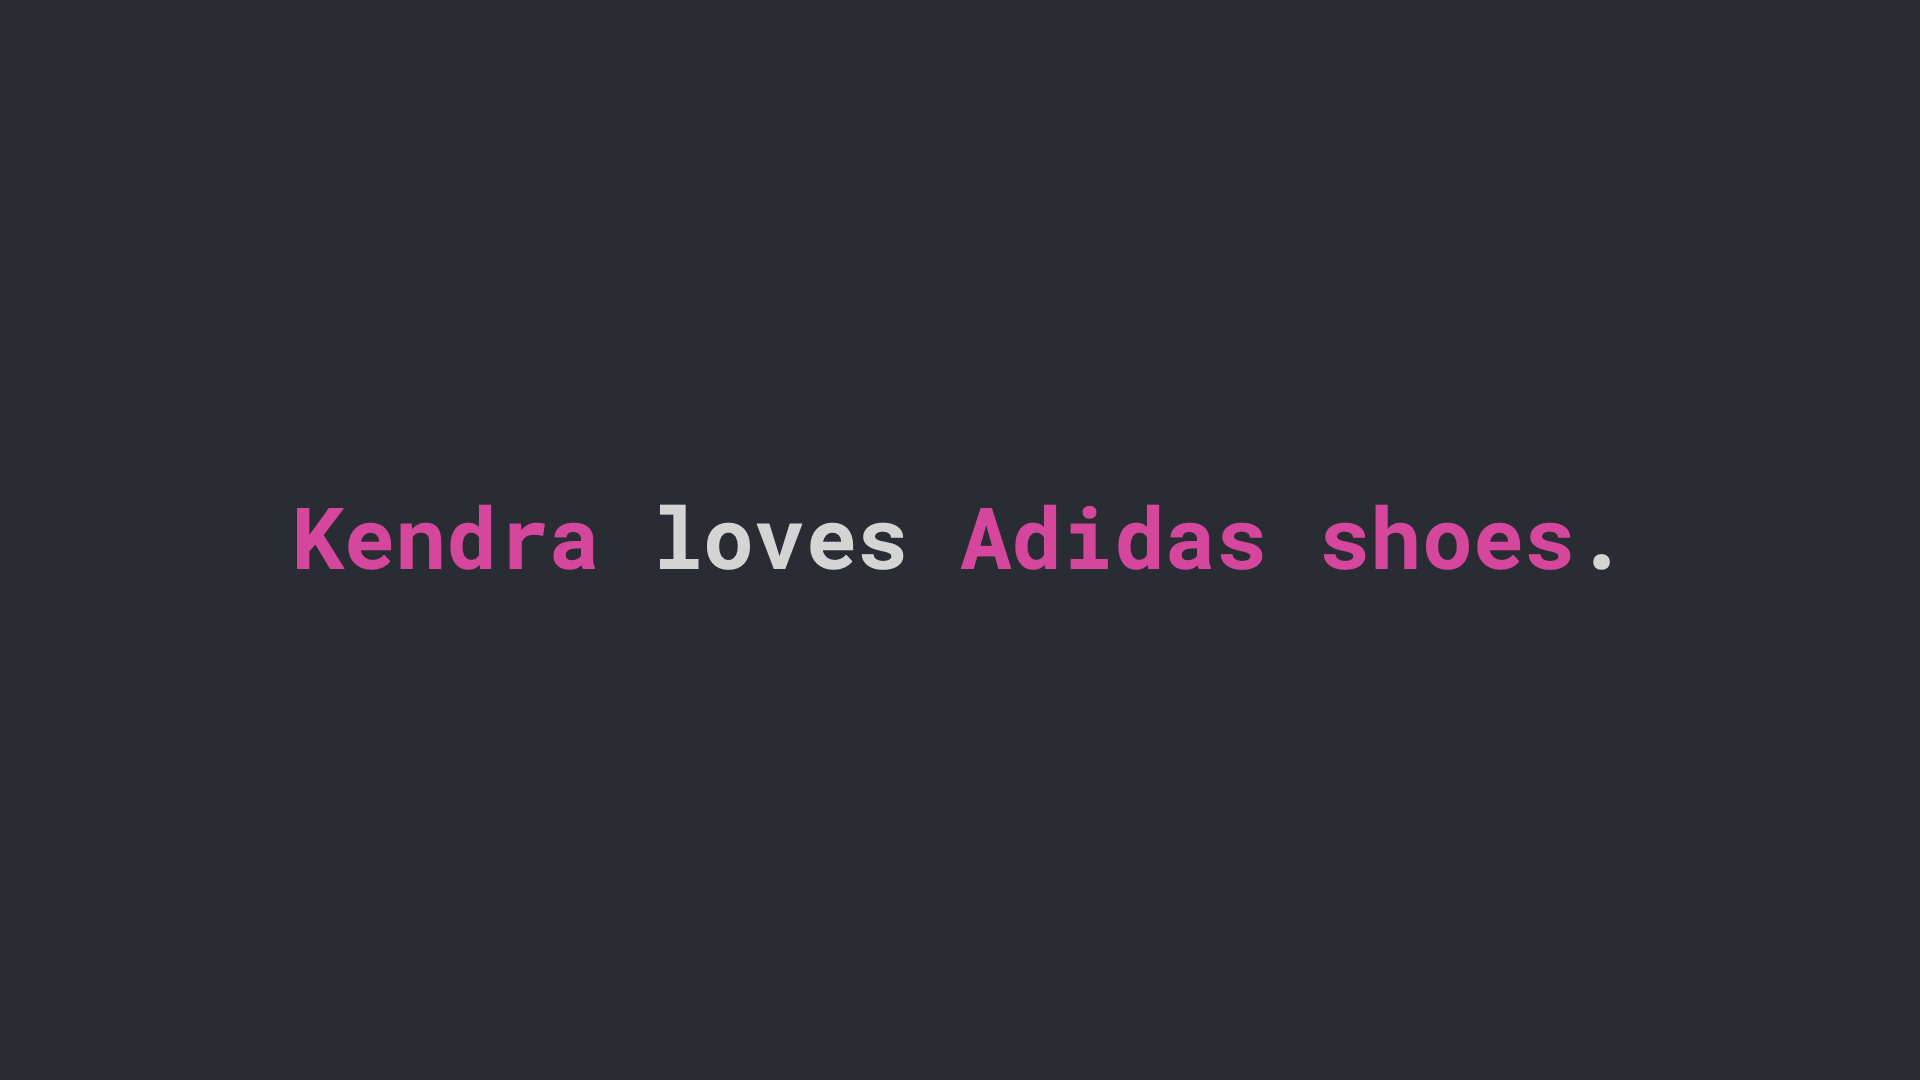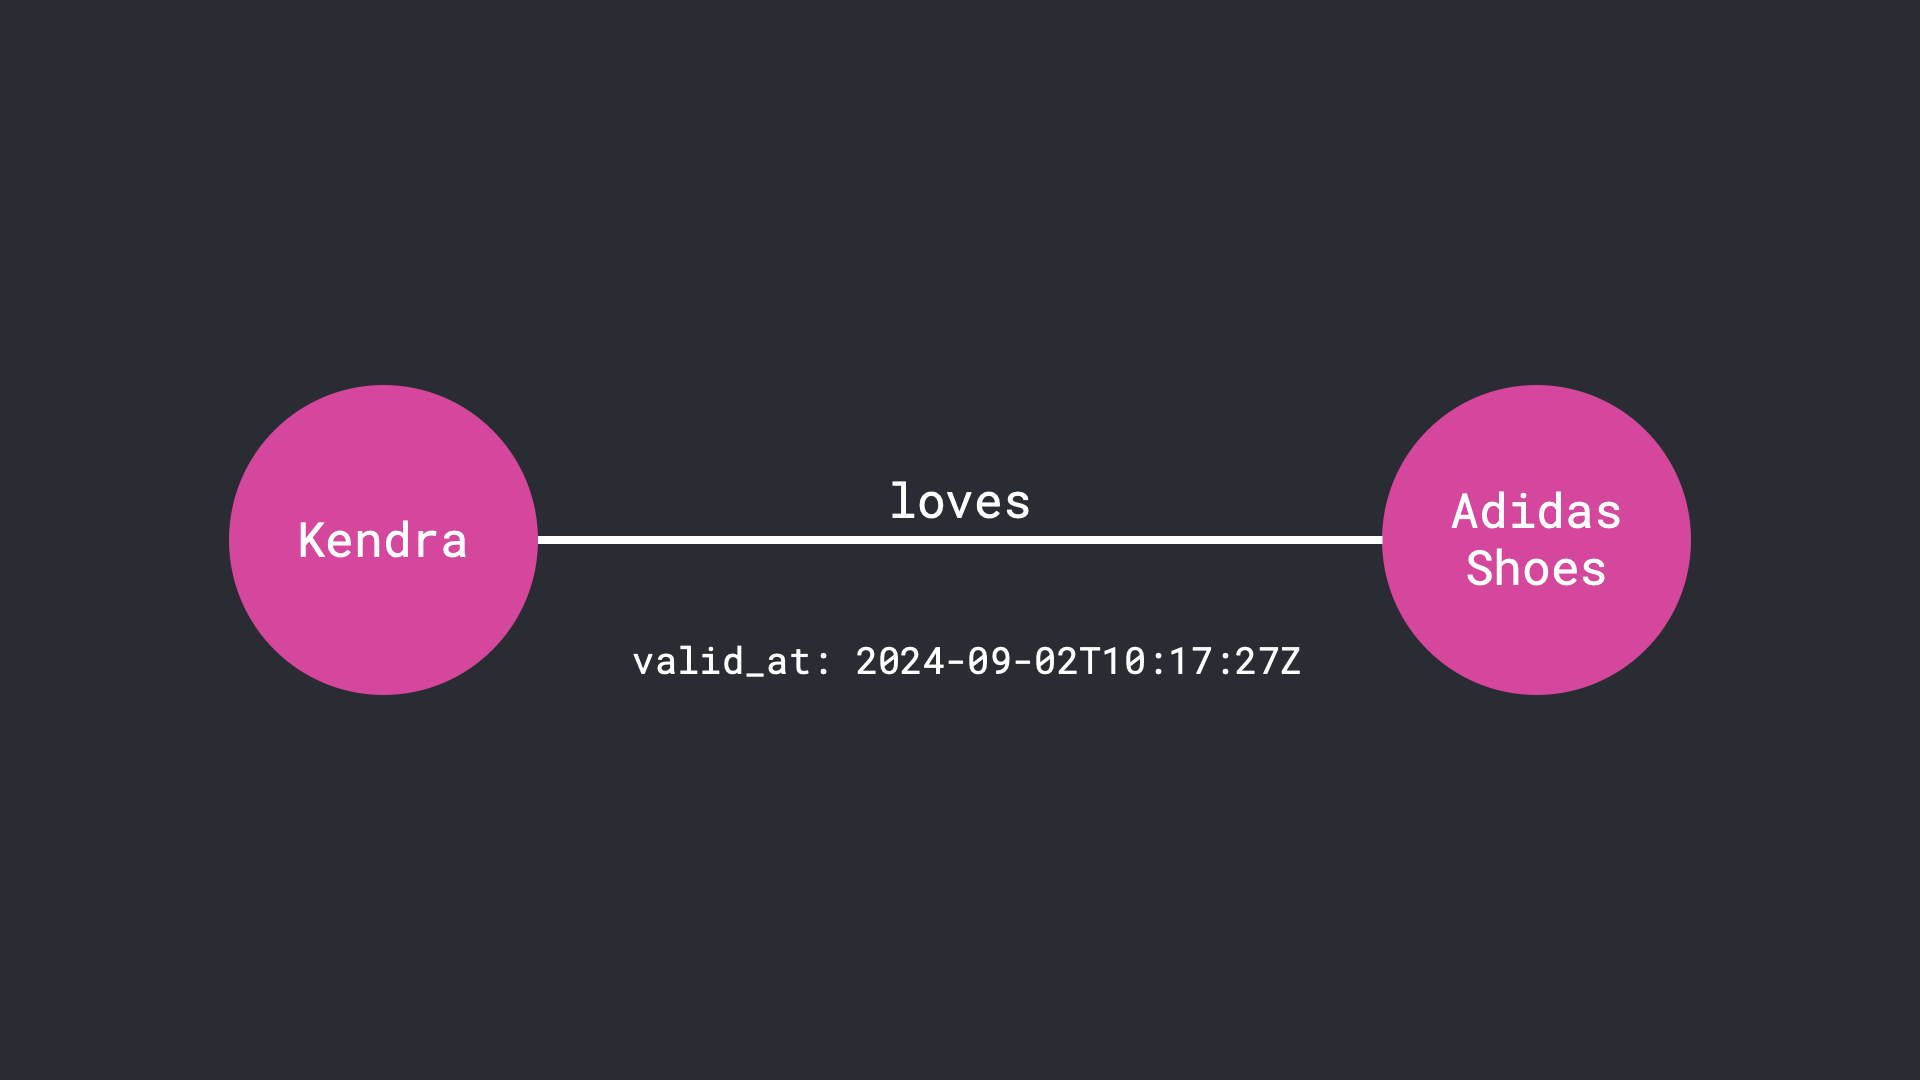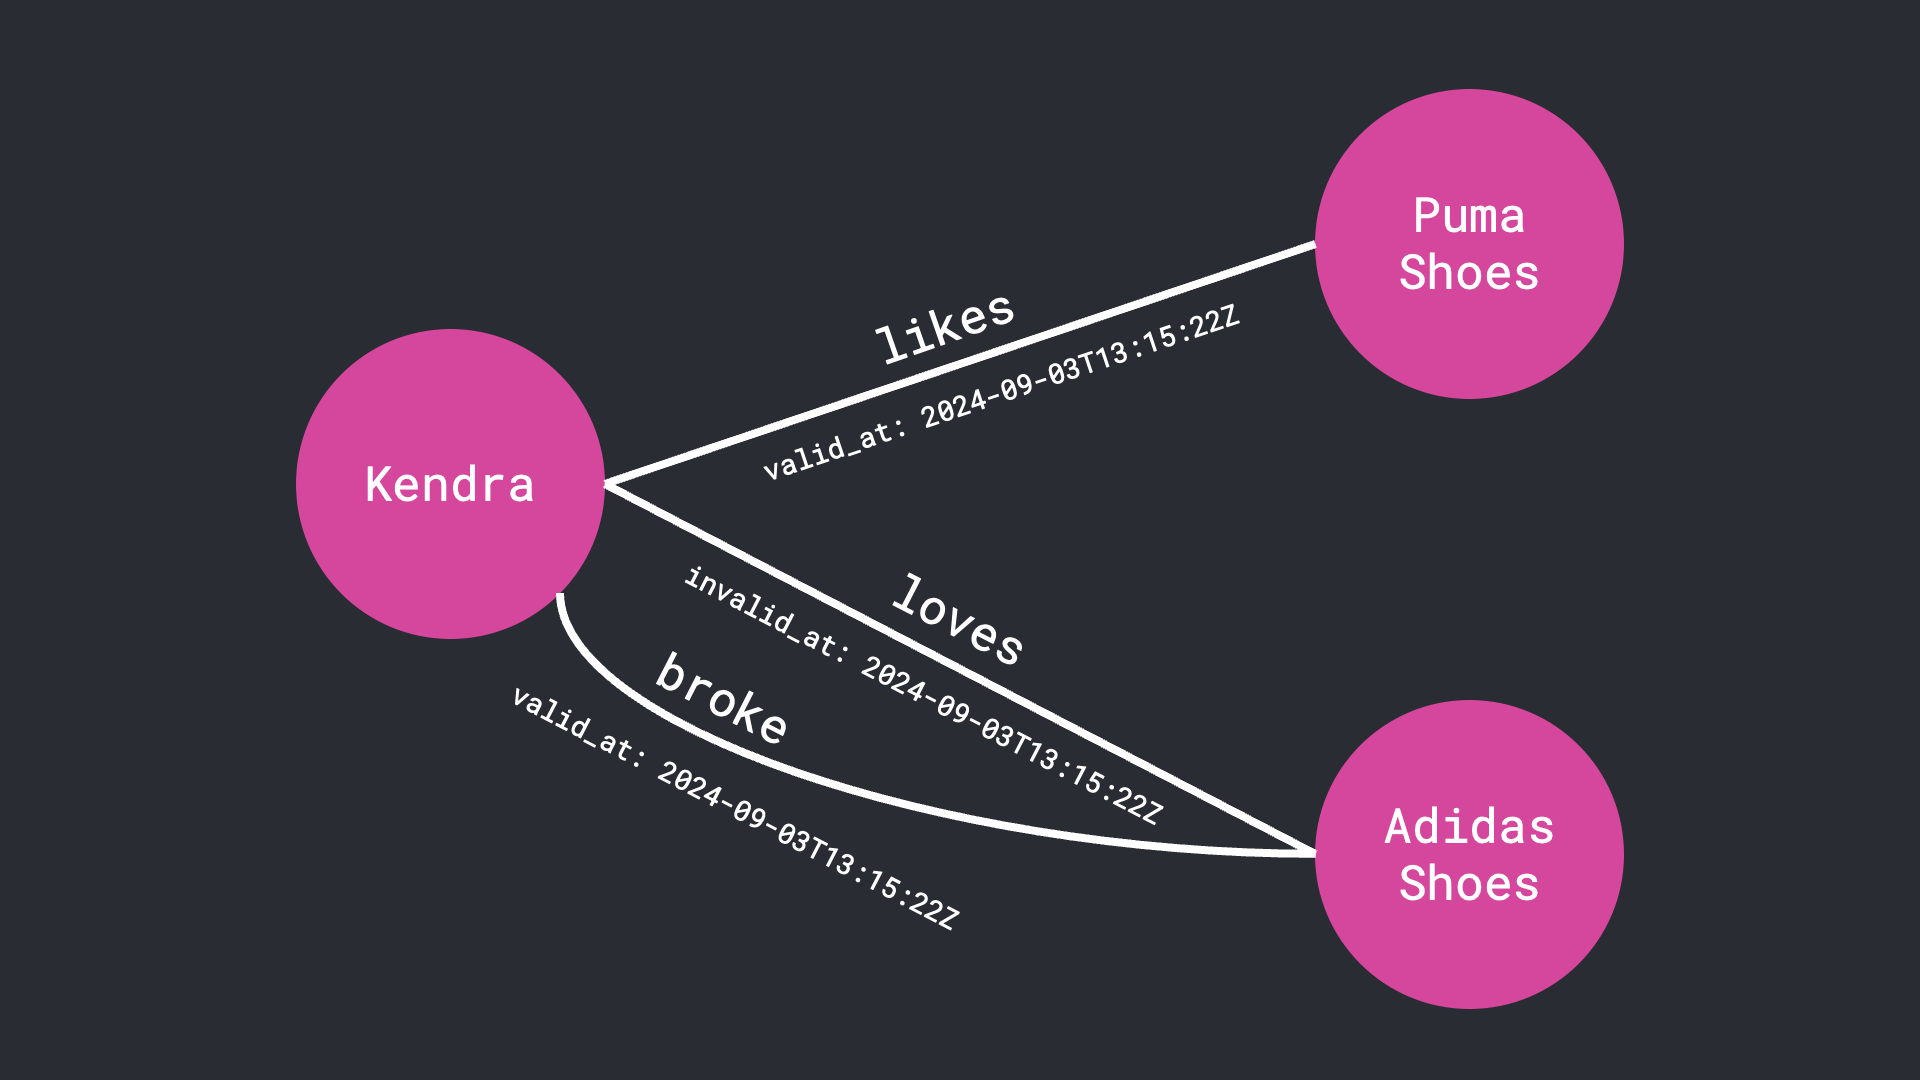
当把新事实 (例如 "Alice 跳槽去了 Beta Inc",生效于 )与关联端点的现有活动边 ("Alice 在 Acme 工作")放在一起比对时,LLM 会判断新事实是否在语义上推翻或取代了旧事实。一旦判定构成矛盾且旧边的 invalid_at 尚未关闭,系统拒绝执行物理 DELETE 删掉旧边,转而执行一条非破坏性的时态闭合更新:
一行赋值,既让旧事实退出了“当前有效视图”,又把“这段关系从何时持续到何时、因哪次写入而终结”完整封存在了历史图谱里。
4. 核心设计哲学三:去 LLM 化的毫秒级混合检索与上下文拼装
在写入侧用足大模型能力把图维护好之后,到了用户实时提问的读取侧,设计目标立刻切换为:快、准、省 Token。论文将整个在线检索过程形式化为三个算子的复合函数:
其中 是用户查询字符串, 是多路候选召回器(Search), 是跨模态重排器(Reranker), 是线性上下文构造器(Constructor),最终输出一段直接塞进 Agent Prompt 的高密度文本 。整条查询链路完全不需要调用缓慢的生成式大模型,从而把检索耗时稳定控制在百毫秒级。
4.1 为什么候选召回必须“余弦 + BM25 + 图 BFS”三路齐发?
在 阶段,系统针对 EntityEdge(事实边)、EntityNode(实体节点)与 CommunityNode(社区节点)并行发起三路互补检索:
- 余弦相似度语义检索():在 1024 维向量空间捕捉语义改写。例如用户问“他平时爱喝什么?”,向量检索能轻松命中
"Alice prefers decaf oat latte"。 - Lucene / BM25 全文检索:弥补稠密向量的词面盲区。当查询包含精确的工单编号
TICKET-8848、生僻人名、API 错误码或专有型号时,BM25 倒排索引能一击必中。 - 以锚点为中心的图广度优先遍历(Breadth-First Search, BFS):前两路检索本质上还是在找“跟问题长得像的单条边或单个点”。但在多跳关系问题中,某条关键事实在字面上可能跟问题毫无重合,仅仅因为它连在问题主角的邻居节点上才变得重要!因此,Graphiti 会从前两路锁定的核心实体(或调用方显式指定的
center_node_uuid)出发,在图上向外扩展 跳 BFS 邻域,把结构上紧密相连的周边事实一并收入候选池。
4.2 五种重排策略(Rerankers)的取舍与适用边界
三路召回捞上来的候选对象,有的带着余弦相似度(),有的带着无上界的 BM25 分数,有的只带着 BFS 图跳数()。怎么把这些不同量纲的候选排出一份统一的 Top- 名单?
Graphiti 在 阶段提供了五种各具所长的重排武器(源码实现在 graphiti_core/search/):
| 重排策略 | 核心数学形式或排序依据 | 最擅长解决什么问题? | 潜在短板与使用注意 |
|---|---|---|---|
| 1. 倒数排名融合(RRF) | 无需调参即可无量纲融合语义、BM25 与 BFS 名次,同时被多路命中的候选自动置顶 | 只看排名不看内容本身,无法识别 top- 内部的语义重复 | |
| 2. 最大边缘相关(MMR) | 在保证查询相关性的同时惩罚与已选集合过度相似的项,消除近义事实刷屏 | 若多样性权重 设得过高,可能把关键补充事实挤出前排 | |
| 3. 来源提及频次(Episode Mentions) | 按支撑该事实的 len(edge.episodes) 降序排列 | 优先凸显在多场会话中被反复验证、长期稳定的用户核心画像 | 刚发生但极其关键的状态变更(Mention 数为 1)排名靠后 |
| 4. 中心节点图距离(Node Distance) | 按候选对象到指定 center_node 的最短图路径跳数排序 | 适合强主体围绕型查询(如“关于当前正在接待的这位客户,最重要的事实有哪些?”) | 强依赖中心节点选取得准,且需防范高度数 Hub 节点引入噪音 |
| 5. 交叉编码器精排(Cross Encoder) | 将 成对输入 BGE-M3 等 Reranker 打分 | 细粒度语义相关性判别能力最强,能精准识别否定词与条件匹配 | 计算开销与候选数量线性成正比,延迟高于纯代数融合(RRF/MMR) |
4.3 线性上下文构造器:如何把图结构重新喂给 LLM?
选出 Top- 的事实边、实体节点与社区节点后,最后一步 是将它们拼装成大模型一眼就能看懂的 Prompt 文本。
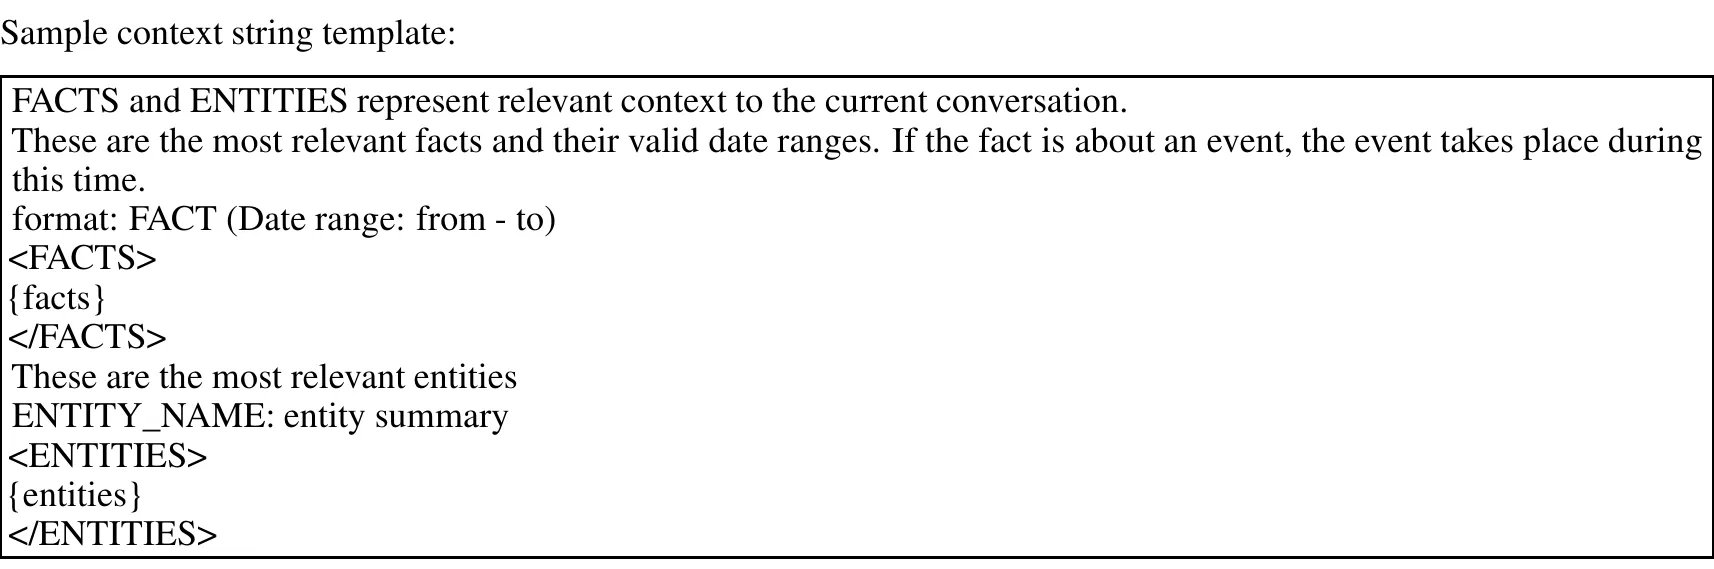
看上方论文给出的标准上下文模板,它的格式设计极其讲究:
- 在
<FACTS>区块中,每一条事实后面都紧跟着显式的有效日期区间(Date range: t_valid - t_invalid)(若仍有效则写present)。这样无需任何复杂的图形符号,生成模型只要顺着读一行自然语言,就能同时看清**“发生了什么事”以及“这件事从哪天到哪天有效”**,遇到历史变迁问题时可以轻松按时间线串联作答。 - 在
<ENTITIES>(及可选的社区区块)中,则附上相关核心实体的名称与聚合摘要entity_summary,为零散的事实边补齐人物背景与全局上下文。
5. Graphiti v0.29.2 源码深挖:从 add_episode() 到多后端驱动
打开固定基线 Graphiti v0.29.2 的核心目录 graphiti_core/,可以看到整个引擎是如何把论文思想落成高内聚的工程代码的。
5.1 Graphiti 依赖注入与 add_episode() 写入主链
在主入口 graphiti_core/graphiti.py 中,Graphiti 类的构造函数通过依赖注入接收五大核心组件:graph_driver(图数据库驱动)、llm_client(结构化抽取大模型客户端)、embedder(向量嵌入器)、cross_encoder(精排器)与 tracer(遥测追踪器)。
当我们调用最核心的 add_episode() 写入一条新事件时,源码内部按如下异步流水线严格推进:
add_episode(name, episode_body, source_description, reference_time, source, group_id, ...)
  -> 1. retrieve_episodes()             # 拉取同 group_id 下最近 n 条历史 Episode 作为共指消解上下文
  -> 2. EpisodicNode(...)               # 创建或加载当前原始事件节点
  -> 3. extract_nodes()                 # 调用 LLM 从当前事件+上下文窗口抽取候选 EntityNode(含 Reflection)
  -> 4. resolve_extracted_nodes()       # 向量+全文双路召回已有节点,LLM 消歧合并 UUID 并更新实体 Summary
  -> 5. extract_edges()                 # 在已消歧的实体间抽取候选 EntityEdge 及相对有效时间
  -> 6. resolve_extracted_edges()       # 在同一实体对 (u, v) 的已有边集合内执行去重、合并 episodes 列表与矛盾失效判定
  -> 7. embed & save nodes/edges        # 批量生成节点与边的 1024 维 Embedding,持久化写入图库并建立 Episodic 溯源边
  -> 8. update_communities() [可选]      # 按邻居多数投票将新实体并入现有社区并刷新社区摘要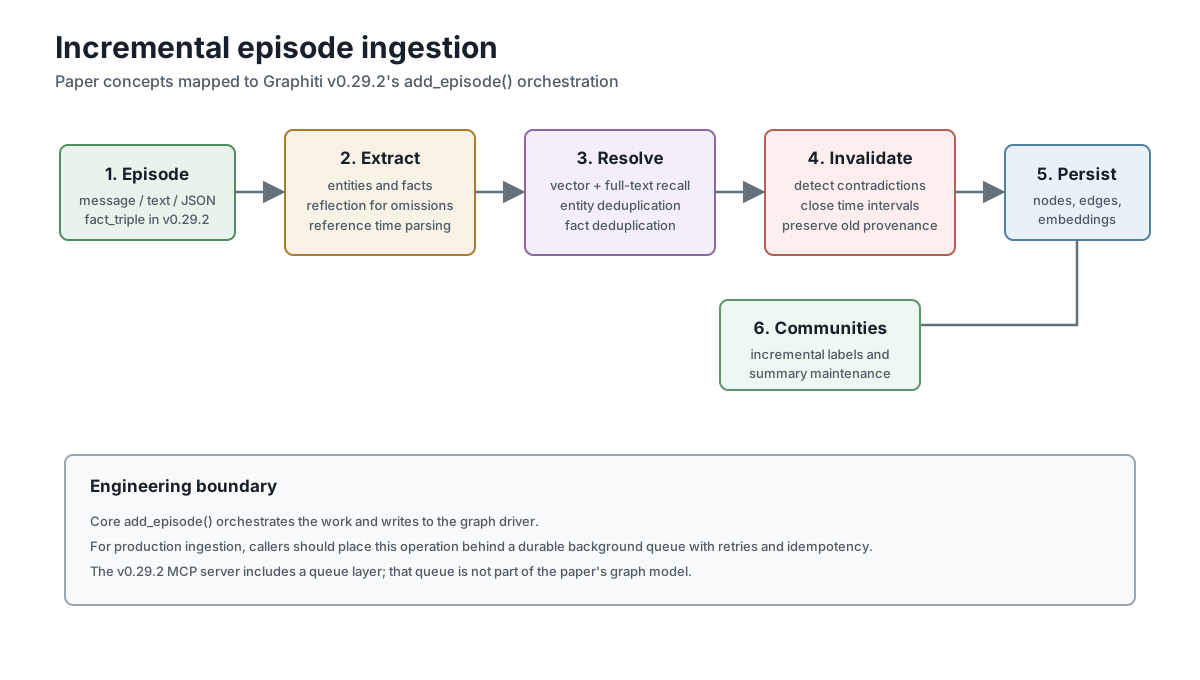
细读这段主链路,有三个非常关键的工程实现细节值得注意:
- 为什么单条 Episode 内部必须保持阶段串行? 因为第 5 步抽事实边的源/目标端点 UUID,完全依赖第 4 步实体消歧的结果;而第 6 步判断哪条旧边该设置
invalid_at失效,又依赖第 5 步抽出的新事实及其生效时间。为了防止高并发写入时两条前后脚到达的关联消息发生竞态冲突(比如两条消息同时创建同一个新实体),生产环境中通常按group_id将写入任务投递到后台有序异步队列(如仓库mcp_server/内置的按group_id串行化的异步任务队列,或外部 Celery/Kafka 分区队列)中消费。 - 自定义 Pydantic Ontology 强类型扩展:在论文里,实体属性和关系主要是自由文本;而在
v0.29.2的ontology_utils/中,开发者可以直接传入自定义的 PydanticBaseModel字典(entity_types与edge_types)以及excluded_entity_types:
class Customer(BaseModel):
    customer_id: str
    tier: str | None = None

class SupportTicket(BaseModel):
    ticket_id: str
    severity: str | None = None
源码会自动将这些 Pydantic 模型的字段 Schema 注入抽取 Prompt 的 JSON Schema 约束中,让大模型在开放抽取的同时,稳定填好业务系统必需的结构化字段(并自动拒绝将核心字段写入保留属性名)。
3. 批量导入 add_episode_bulk() 与三元组直写 add_triplet():针对初次上线需要导入几万条历史工单或已有知识库的场景,逐条调 add_episode() 往返太慢。v0.29.2 专门提供了批处理通道 add_episode_bulk(),以及绕过自然语言抽取、直接把上游可信的 (source_node, edge, target_node) 写进双时态图的 add_triplet()(对应 EpisodeType.fact_triple)。
5.2 SagaNode、预置检索配方(Search Recipes)与多图后端抽象
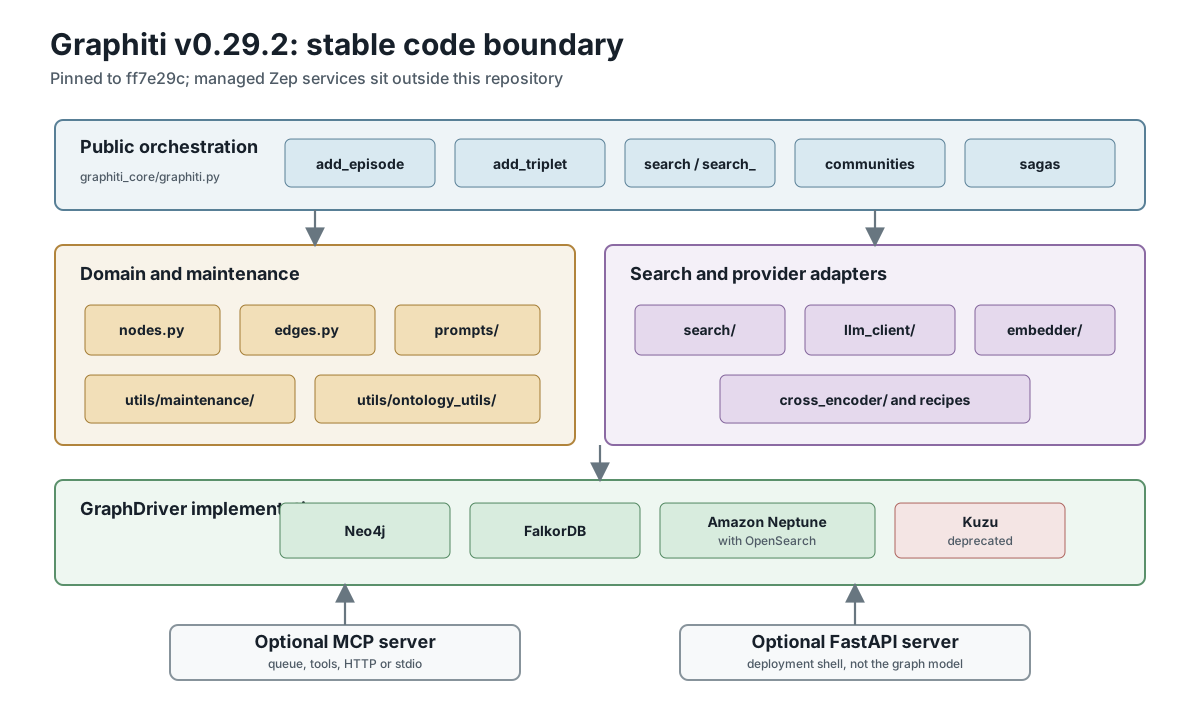
除了论文原有的三层节点外,我们在 nodes.py 中还能看到 v0.29.2 新增的第 4 类节点——SagaNode。它与 CommunityNode 的分工非常巧妙:
CommunityNode(空间拓扑上的聚类):回答“哪些人物、公司和产品在关系网里经常绑在一起”;SagaNode(时间叙事线上的串联):通过 chronology 边把属于同一场长周期业务过程(例如一次持续两周的线上故障排查、一个季度的销售跟单全流程)的多个 Episode 按时间顺序串成一条故事线,并支持调用summarize_saga()生成过程复盘摘要。
在检索端,search_config_recipes.py 将前文第 4 节的多种检索器与重排器预先组装成了十余套开箱即用的 SearchConfig 配方(例如 COMBINED_HYBRID_SEARCH_RRF、COMBINED_HYBRID_SEARCH_MMR、COMBINED_HYBRID_SEARCH_CROSS_ENCODER、EDGE_HYBRID_SEARCH_NODE_DISTANCE 等)。调用者既可以用一行 await graphiti.search(query, center_node_uuid=...) 走默认混合检索,也可以调用底层 await graphiti.search_(query, config=..., search_filter=...) 同时拿回匹配的边、节点、Episode 与社区对象。
而在存储与模型适配层,graphiti_core/driver/ 通过统一的 GraphDriver 抽象屏蔽了不同图数据库的方言差异——目前主力支持 Neo4j、FalkorDB 以及 Amazon Neptune + OpenSearch(早期实验性的 Kuzu 驱动已在 v0.29.2 标记为 deprecated);同时在检索过滤器 search_filters.py 中对所有属性名、标签与时间条件做了严格的的参数化绑定与字符校验,从驱动底层杜绝了把用户输入拼进 Cypher 语句引发的查询注入风险。
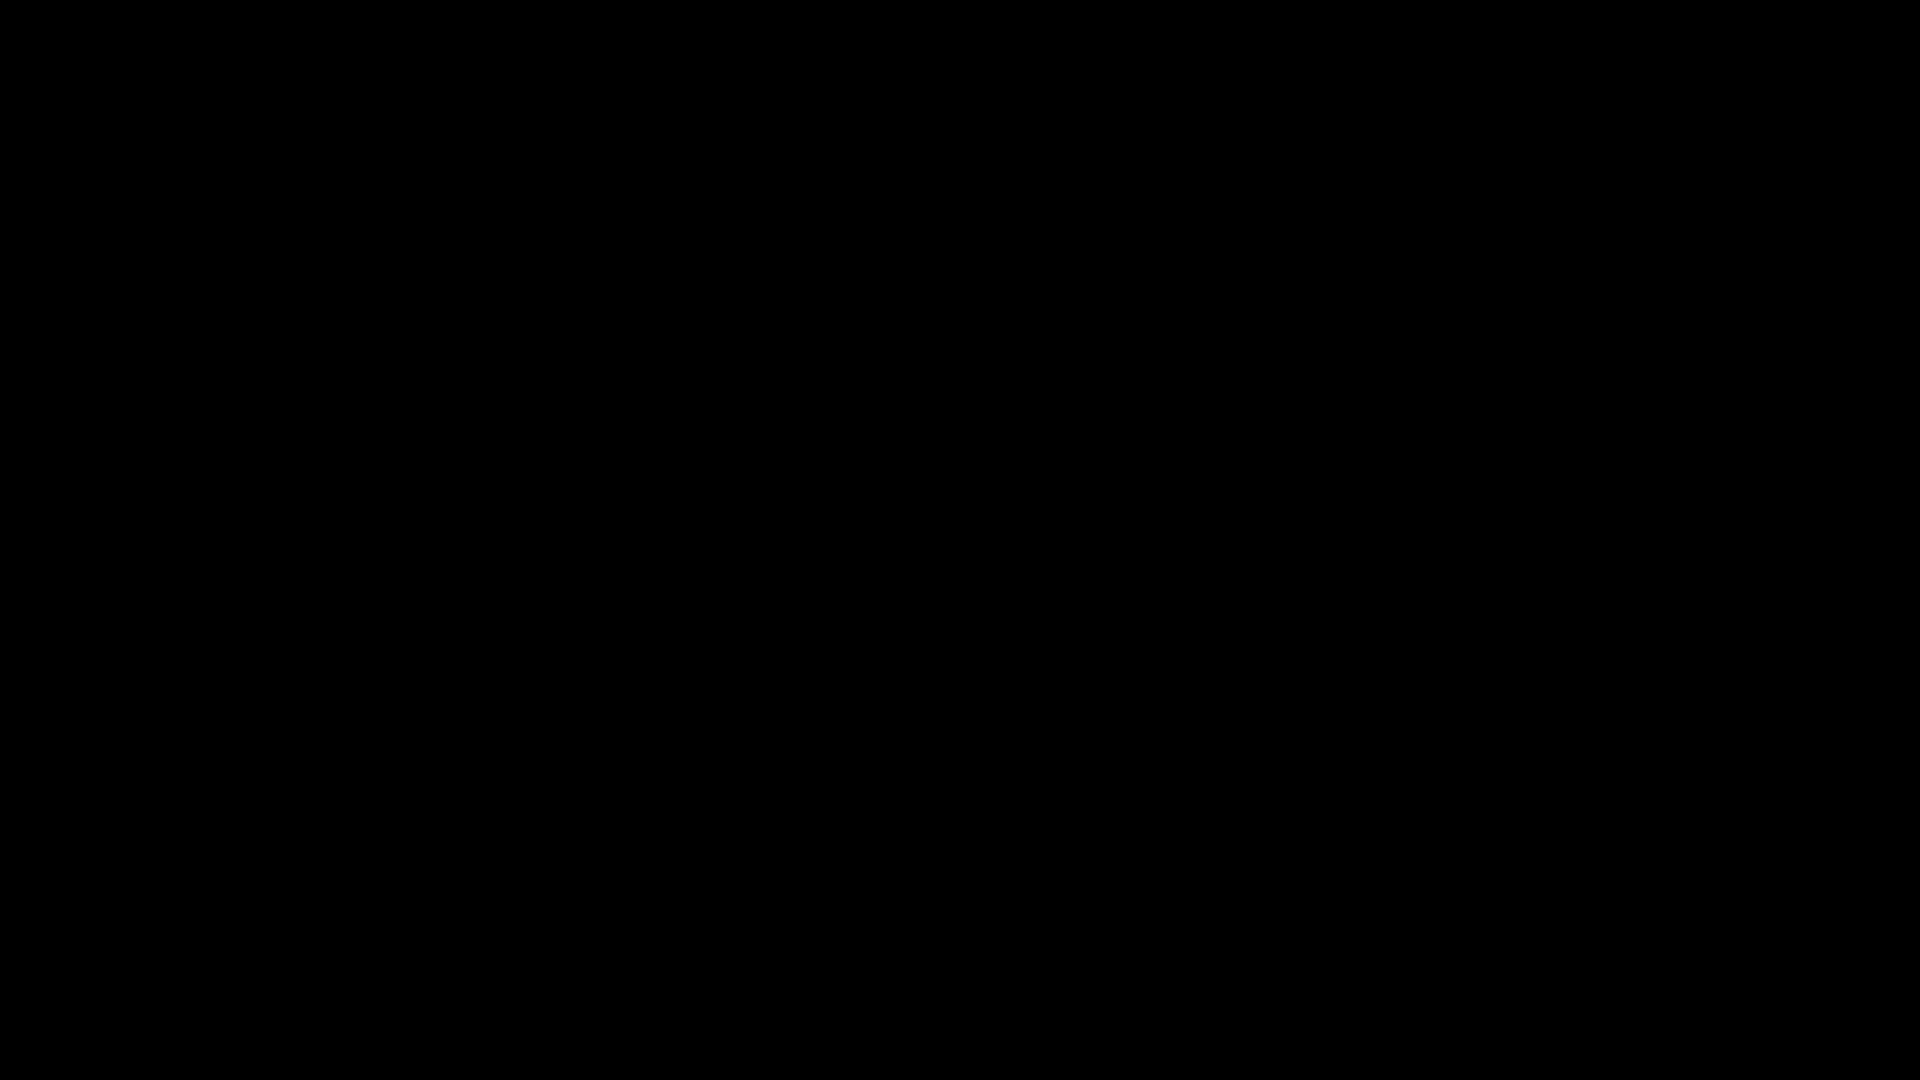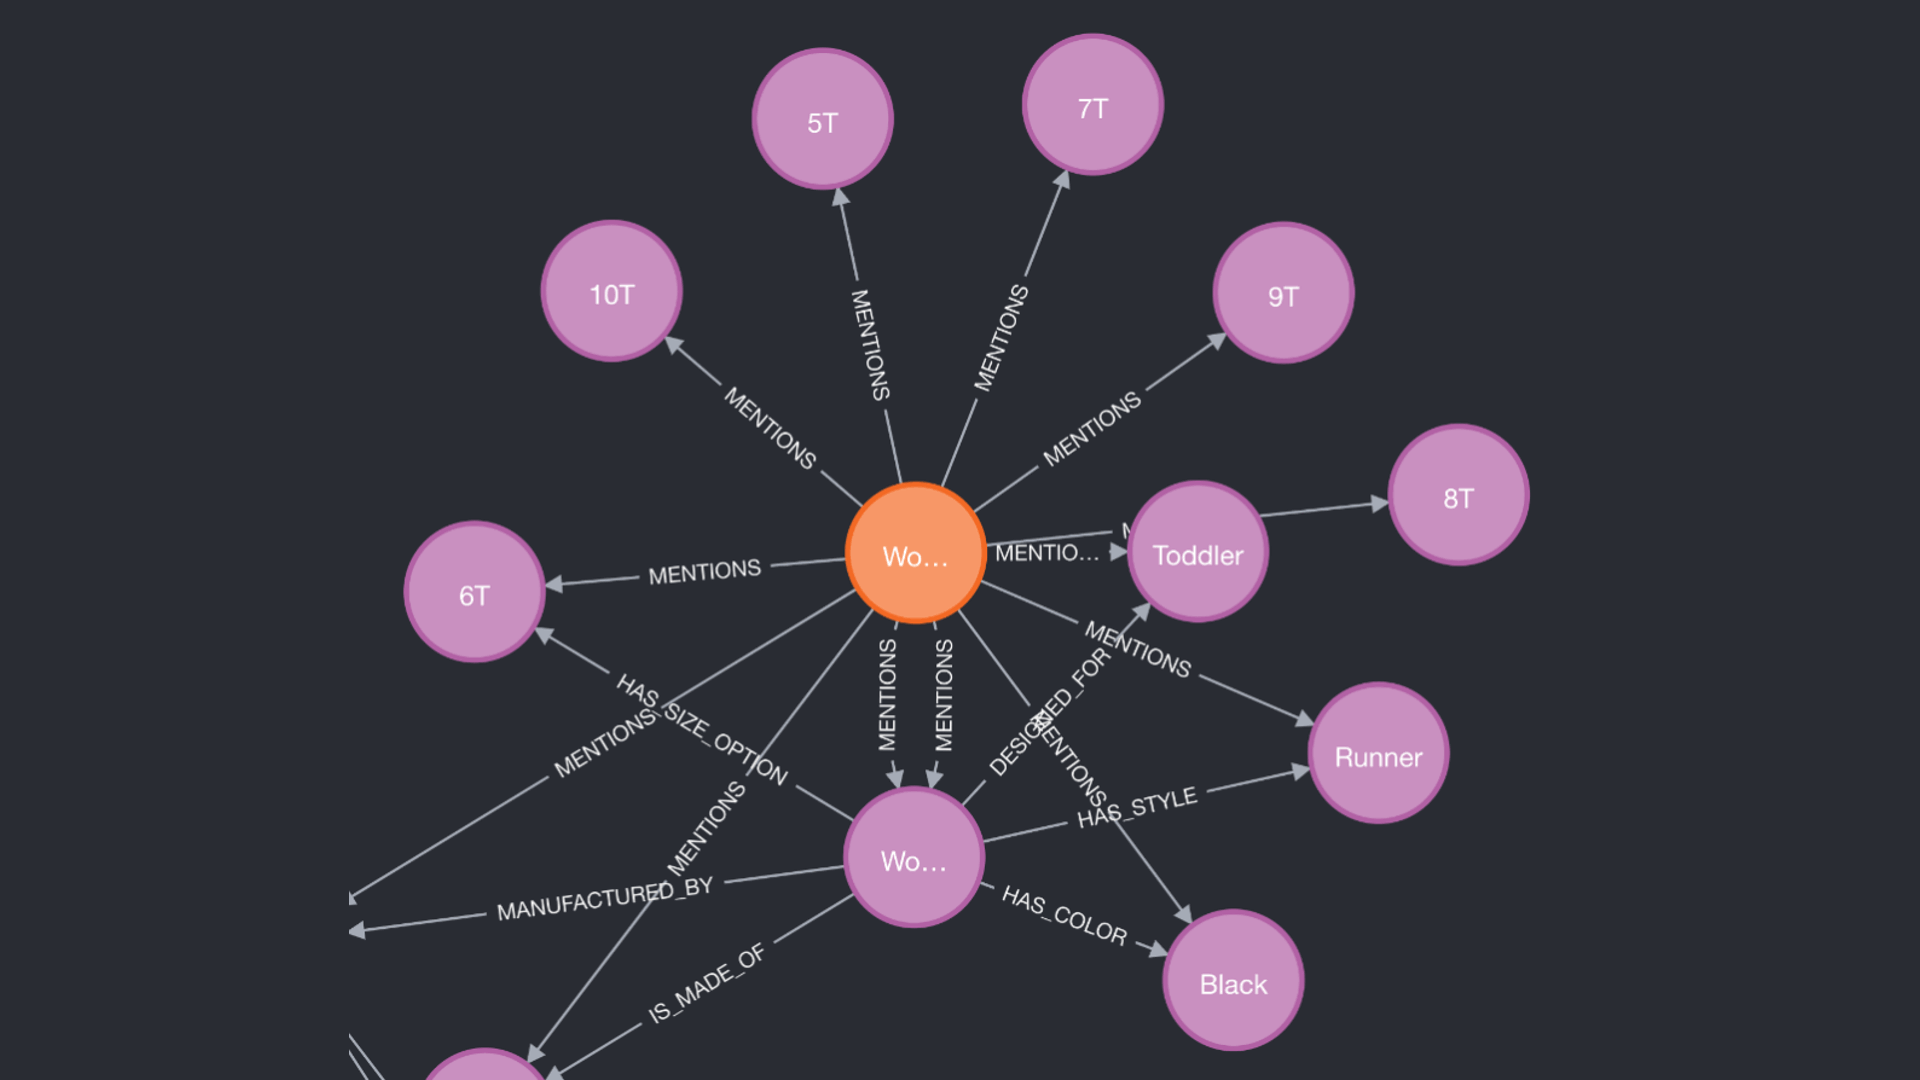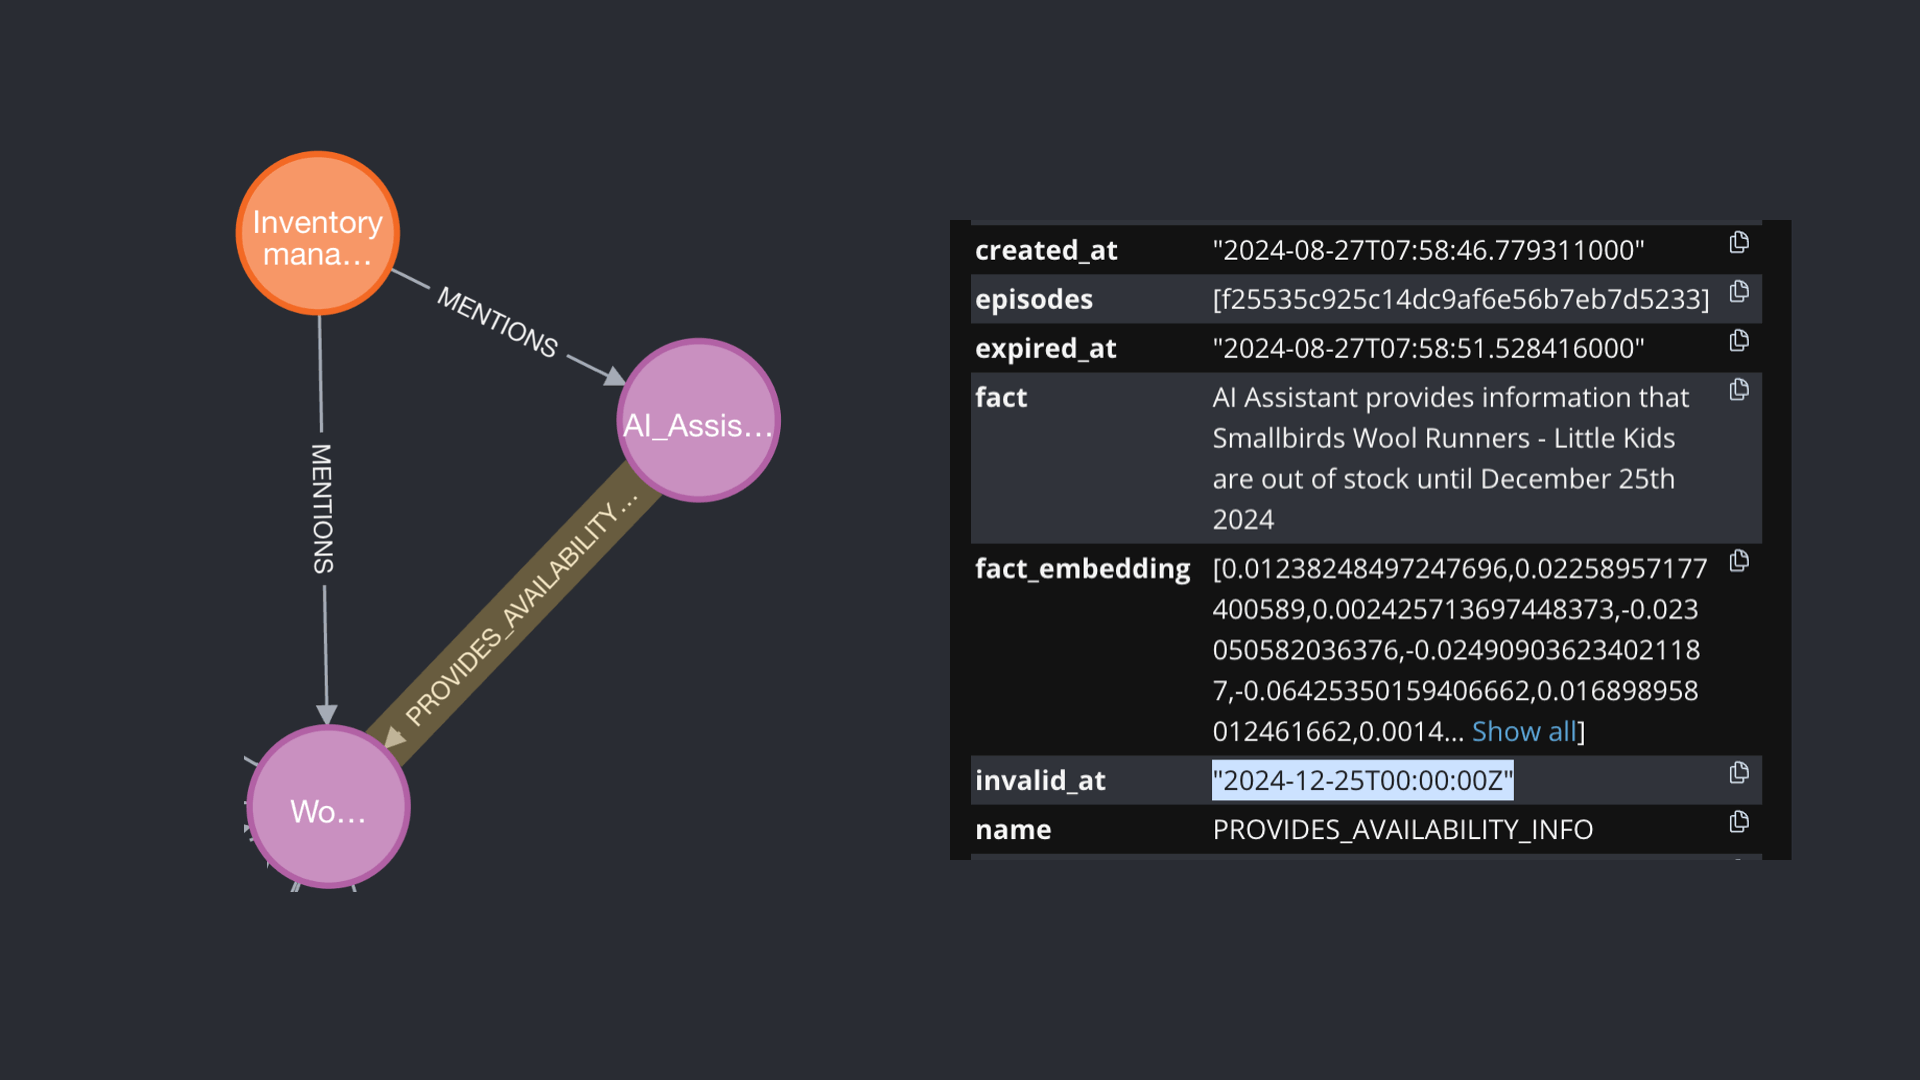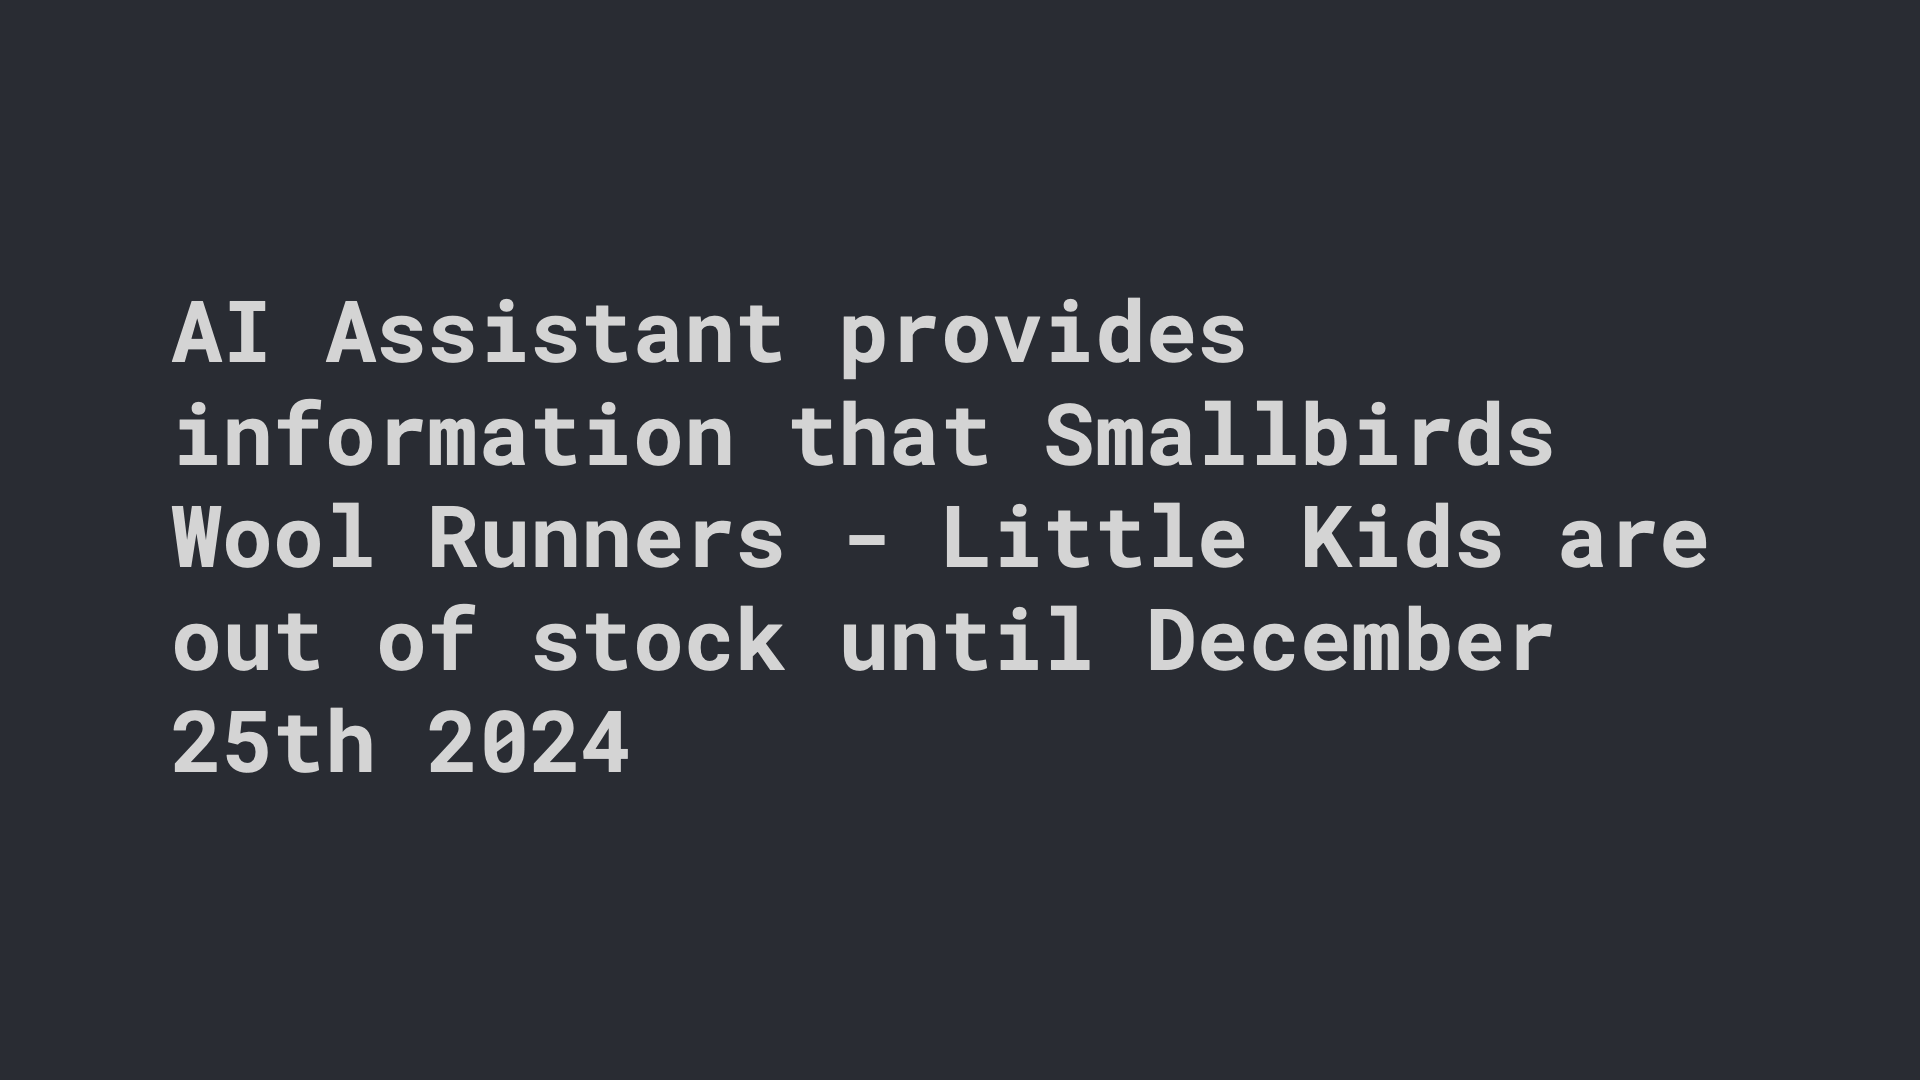
6. 实验复盘:DMR 与 LongMemEval 的收益、延迟与回退归因
论文在两套复杂度截然不同的长期记忆基准上检验了系统表现(实验统一使用 gpt-4o-mini-2024-07-18 构建图谱,BGE-M3 负责 Embedding 与重排,生成端分别测试 gpt-4-turbo、gpt-4o-mini 与 gpt-4o)。
6.1 DMR 基准:为什么 60 条消息的短会话测不出图记忆的真正实力?
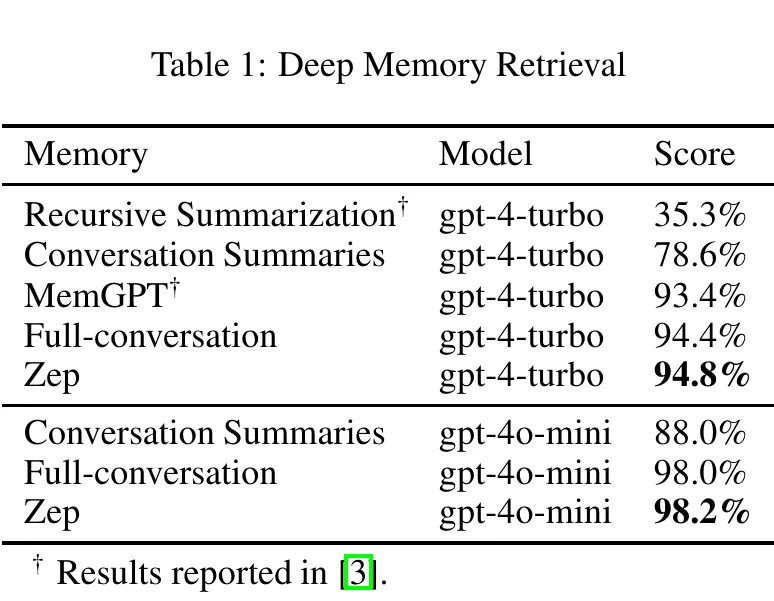
先看上方 Table 1 的 Deep Memory Retrieval(DMR)实验结果:
- 传统的递归摘要(Recursive Summarization)只能拿到惨淡的
35.3%,会话级摘要(Conversation Summaries)也停留在78.6%(gpt-4-turbo)和88.0%(gpt-4o-mini),再次证明“只存文本摘要”会丢掉大量问答细节; - Zep 在
gpt-4-turbo上拿到94.8%(超过 MemGPT 的93.4%),在gpt-4o-mini上拿到98.2%。
但如果我们客观对比表中紧挨着的 Full-conversation(把整场对话原封不动塞进窗口),会发现 Zep 相比全量上下文其实只高了微弱的 0.4 和 0.2 个百分点(94.8% vs 94.4%,98.2% vs 98.0%)。为什么在 DMR 上拉不开差距?因为 DMR 数据集的每段对话只有区区 60 条简短消息,总长不过几千 Token,现代大模型直接全量通读毫不费力,且题目大多是简单的单点事实复述,缺乏复杂的跨月状态变更。因此,DMR 只证明了 Graphiti 的图抽取没有丢失信息,真正大考还在后面。
6.2 LongMemEval 总体表现:压缩 98.6% 上下文,为什么准确率反而涨了 11 个点?
为了贴近真实企业级 Agent 的运行环境,论文引入了 LongMemEval(oracle 之外的完整历史集 LongMemEval_s):每段多会话历史平均长达 115,000 Tokens,跨越漫长的时间跨度并包含大量日常寒暄噪音与状态更新。
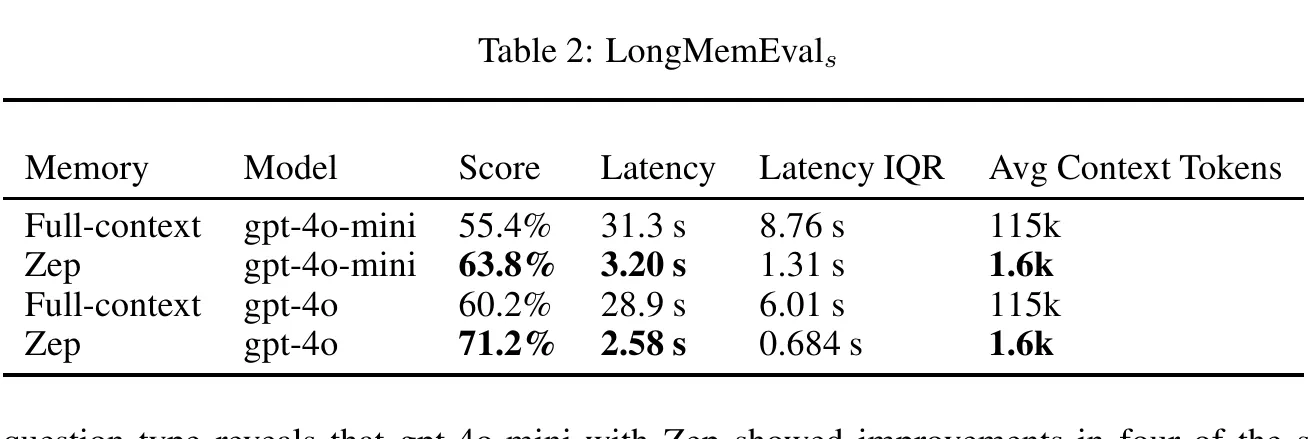
看上方 Table 2 的核心对比数字,Zep 在质量、延迟和成本三个维度同时实现了突破:
- 上下文体积削减
98.6%:Full-context 每次提问都要硬塞115kTokens,而 Zep 通过混合检索与模板拼装,平均只需送入1.6kTokens: - 准确率显著反超全量上下文:在
gpt-4o-mini上,准确率从55.4%跃升至63.8%(绝对提升+8.4个百分点,相对提升 );在gpt-4o上,准确率从60.2%跃升至71.2%(绝对提升+11.0个百分点,相对提升 )。为什么给模型看的东西少了 98.6%,模型反而答得更准了?因为 115K 原文里 99% 都是干扰注意力的无关闲聊与早已失效的过期状态,Graphiti 帮模型提前完成了“去噪 + 双时态有效期对齐”,把大海捞针变成了看着标准答案清单填空。 - 端到端响应延迟骤降
90%:由于省去了对 115K 超长 Prompt 的 GPU Prefill 计算,端到端问答延迟在gpt-4o-mini上从31.3 s降至3.20 s,在gpt-4o上从28.9 s降至2.58 s,四分位距(Latency IQR)也同步缩小了一个数量级。
从系统经济账的角度看,这种架构本质上是“把在线读取时的重复 Prefill 成本,前移转化为离线写入时的一次性构图成本”。系统的全生命周期总成本满足:
当一段记忆入库后会被后续几十上百次会话反复检索复用(即查询次数 较大)时,115k -> 1.6k 省下的海量在线 Token 费用会远远覆盖掉写入期的抽取开销。
6.3 六大题型拆解:哪些任务暴涨,为什么 single-session-assistant 会回退?
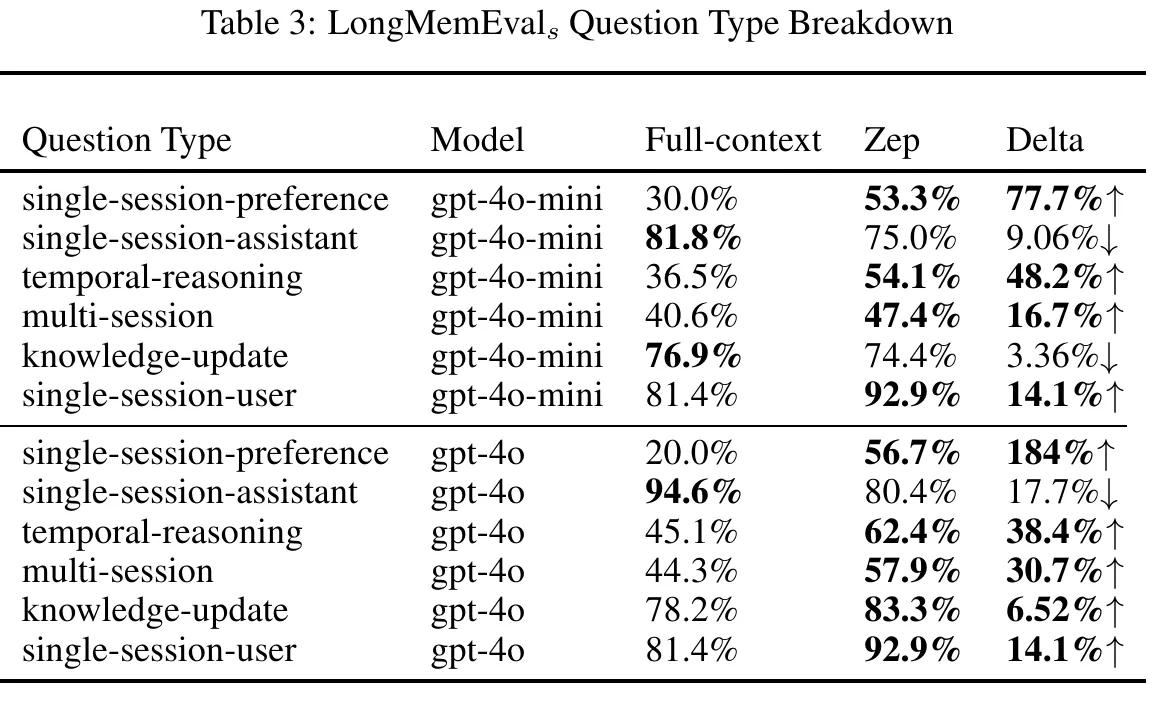
更有价值的工程洞察藏在上方 Table 3 的分题型拆解里。如果逐行对比六类子任务在 gpt-4o-mini 与 gpt-4o 上的涨跌,我们会看到一幅非常真实的技术权衡图景:
- 暴涨的主场题型:
single-session-preference(隐性偏好归纳):在gpt-4o上从20.0%暴涨至56.7%(绝对提升+36.7 pp,相对增幅达183.5%),在mini上也从30.0%涨到53.3%。用户在长对话里流露的偏好往往散落在字里行间,全量上下文极易漏看,而 Graphiti 的实体summary与事实边把这些偏好集中提炼到了台面上。temporal-reasoning(时态推理):两个模型分别从36.5% -> 54.1%(+17.6 pp)和45.1% -> 62.4%(+17.3 pp)。这直接归功于<FACTS>模板中显式附带的valid_at - invalid_at时间区间。multi-session(跨多场会话综合)与single-session-user(用户自身事实):在gpt-4o上分别取得+13.6 pp(44.3% -> 57.9%)和+11.5 pp(81.4% -> 92.9%)的稳健增长。
- 出现回退的软肋题型:
single-session-assistant(询问 Assistant 自身过去说过的话):在gpt-4o-mini上从81.8%跌至75.0%(-6.8 pp),在gpt-4o上更是从94.6%跌至80.4%(-14.2 pp)!同时knowledge-update在mini上也有-2.5 pp的小幅回退(在更擅长理解时间区间的gpt-4o上则正向提升+5.1 pp)。
为什么询问“Assistant 之前给过什么建议或说过什么具体内容”时,图记忆反而打不过全量上下文?
原因直指三元组抽取的本质局限:Graphiti 的抽取 Prompt 天然围绕“用户(User)及其关联的外部实体状态”构建关系边;当 Assistant 在某一轮输出了一大段长篇大论的方案建议、代码列表或散文式分析时,将其拆成零碎的 (Entity)-[Fact]->(Entity) 三元组会丢失大量篇章结构与原话细节。这也给生产系统设计提了一个醒:当意图识别发现用户正在追问“你刚才/上次给我写的方案里第 3 条是什么”时,检索层应当直接顺着 provenance 拉出对应的原始 EpisodicNode 原文,避免仅向模型投喂零散的三元组事实边。
7. 生产工程落地:并发挑战、安全边界与横向生态坐标
7.1 把 Graphiti 推向生产的四大工程挑战
将双时态记忆图从论文实验搬进高并发生产环境,架构师必须在代码外围处理好四个棘手问题:
- 错误消歧的滚雪球效应(Error Cascading in Entity Resolution):如果 LLM 在第 4 步消歧时不小心把两个同名但不同人的客户“张伟”合并到了同一个
EntityNodeUUID 上,后续两人的家庭住址、订单状态和偏好就会混在同一个节点和同一段summary里互相污染,且后续每轮消歧都会拿这段被污染的summary当依据。因此,对于拥有明确业务主键(如user_id、account_id、ticket_id)的对象,工程上应优先通过确定性唯一键或add_triplet()锚定节点,只把模糊的 LLM 消歧留给对话中提及的外部非结构化实体。 - 只增不减的“历史边膨胀”(Temporal Graph Bloat):因为双时态模型采用“闭合
invalid_at与expired_at替代物理删除”的策略,随着 Agent 运行一年半载,核心用户节点周围会挂满成百上千条已失效的历史边。这不仅会拖慢第 6 步事实去重时的候选比对,也会拉高 BFS 遍历的扇出度。生产环境需要定期将超过保留窗口的陈旧失效边归档至冷存储(Compaction),或在检索驱动的 Cypher 查询中默认加上活动边索引过滤。 - 多租户隔离红线:
group_id仅充当逻辑分区键,不具备 RBAC 鉴权能力:在 Graphiti 源码中,group_id被广泛用于在图查询、向量检索和全文检索中划分数据命名空间。但group_id本身不具备任何密码学身份校验——如果允许前端或大模型自己在 Tool Call 参数里随意填写group_id,攻击者只需通过一行 Prompt 注入就能跨租户读取他人记忆。在生产架构中,group_id必须由服务端 API 网关根据已认证的会话 Token 强行注入,且在执行 GDPR 数据擦除时,必须顺着EpisodicNode -> EntityEdge -> EntityNode -> CommunityNode / SagaNode彻底清理所有派生摘要与向量索引。 - 记忆与权威业务主库(System of Record)的职责边界:Agent 记忆图本质上是由概率模型从对话流中提炼出的“认知缓存”。对于闲聊偏好、历史沟通脉络,直接采信记忆图毫无问题;但一旦涉及账户实时余额、库存扣减或合同法律状态,必须以实时业务数据库(System of Record)的强一致 API 为准,严禁拿记忆图里的模糊印象代替实时账本查询。
7.2 在知识图谱与 Agent 生态中的横向坐标
最后,我们将 Graphiti / Zep 与同领域的 MemGPT / Letta、Microsoft GraphRAG,以及本站同系列的 OpenSPG KAG 和 Neo4j 源码精读 放在同一张架构坐标系中对比:
| 系统 / 框架 | 核心解决的问题域 | 图与时间建模特征 | 在线查询与执行方式 | 在企业级架构中的生态位 |
|---|---|---|---|---|
| MemGPT / Letta | Agent 有限上下文窗口的自治换页管理 | 无显式知识图谱,分 Core / Archival 扁平存储 | 由 Agent 自身通过工具调用决定何时读写记忆 | Agent 内部工作记忆(Working Memory)控制器 |
| Microsoft GraphRAG | 静态大规模文档语料的宏观归纳问答 | 单时态实体关系图 + Leiden 层次化社区树 | Local 实体邻域检索 + 社区摘要 Map-Reduce 全局搜索 | 静态非结构化语料的全局主题分析引擎 |
| OpenSPG KAG | 专业领域的复杂多跳与数值逻辑问答 | 三层互索引()+ 概念图对齐 | Logical Form 符号编译 + 图优先混合检索 + 多轮反思 | 权威领域规程与专业文档的知识求解平面 |
| Graphiti / Zep | 流式对话与业务事件的动态长期记忆 | 三层子图(Episode/Entity/Community)+ 四维双时态边 | 去 LLM 化的 Cosine + BM25 + BFS 检索 + 5 种重排 | 跨会话用户状态与动态业务上下文平面 |
| Neo4j(图数据库) | 底层属性图的高性能事务存储与查询 | 定长记录文件 + 免索引邻接指针链 + WAL 日志 | Cypher 成本规划器 + Slotted/Pipelined 算子执行 | 承载 KAG 与 Graphiti 图数据的底层 ACID 存储引擎 |
这套对比揭示了一个极其清晰的现代 AI 架构范式:底层用 Neo4j 等原生图数据库守住 ACID 事务与毫秒级指针跳转;上面左路挂 OpenSPG KAG 负责啃透静态、严谨的行业规章与多跳逻辑计算;右路挂 Graphiti / Zep 负责捕捉每时每刻都在流动变化的用户状态与双时态历史记忆。当用户向 Agent 发起提问时,左右两路分别从“专业知识底座”与“个体动态记忆”中精准提取上下文,汇合在一起,才真正构成了既懂专业规矩、又记得住来龙去脉的智能体。
参考资料
- Preston Rasmussen et al., Zep: A Temporal Knowledge Graph Architecture for Agent Memory, arXiv:2501.13956v1, 2025.
- 官方开源仓库与文档:getzep/graphiti(
v0.29.2源码基线)、Graphiti 官方文档、Zep vs Graphiti 架构对比. - 核心源码入口:
graphiti.py、nodes.py、edges.py、maintenance/、search.py、search_config_recipes.py、driver/. - 相关领域工作:MemGPT: Towards LLMs as Operating Systems、Microsoft GraphRAG、LoCoMo、LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory.
comments