在手机相册或修图软件里用“魔法消除笔”涂掉画面中央的路人时,什么样的修复结果才算合格?
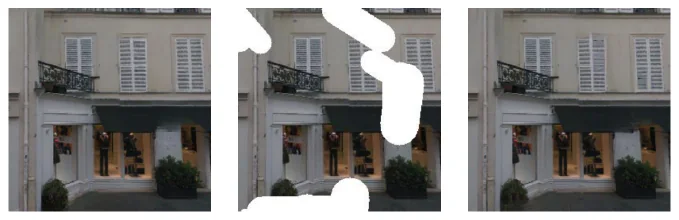
如果只是蹭掉电线杆或脸上的小斑点,哪怕用二十年前的局部纹理复制算法(PatchMatch)也能无缝抹平。可一旦涂抹区域占到了整张图的 30% 甚至 50%——比如路人正好挡住了一排铁艺栅栏、一整面百叶窗或者透视延伸的砖墙——传统的卷积神经网络往往会在孔洞中央画出一团模糊的灰色泥巴,或者把栅栏的横梁接错半格。更糟糕的是,很多在 小图上表现尚可的模型,一放到 的高清原片上,修复区就会崩出刺眼的竖向条带伪影。
为什么大面积掩码修复(Large Mask Inpainting)和高分辨率泛化对传统卷积网络如此残酷?
三星莫斯科 AI 中心(Samsung AI Center-Moscow)提出的经典工作 Resolution-robust Large Mask Inpainting with Fourier Convolutions(LaMa,发表于 WACV 2022,官方代码)一针见血地指出了病根:大孔洞修复失败的本质,是网络在早期层缺乏跨越孔洞的全局有效感受野。为此,LaMa 抛弃了繁琐的“先预测边缘或语义图、再填涂颜色”的多阶段套路,仅用 27M 参数的单阶段全卷积网络(扩展版 Big LaMa 为 51M),在仅使用 裁剪块训练的前提下,实现了惊艳的周期性结构恢复与近 2K 分辨率的零样本直接推理。
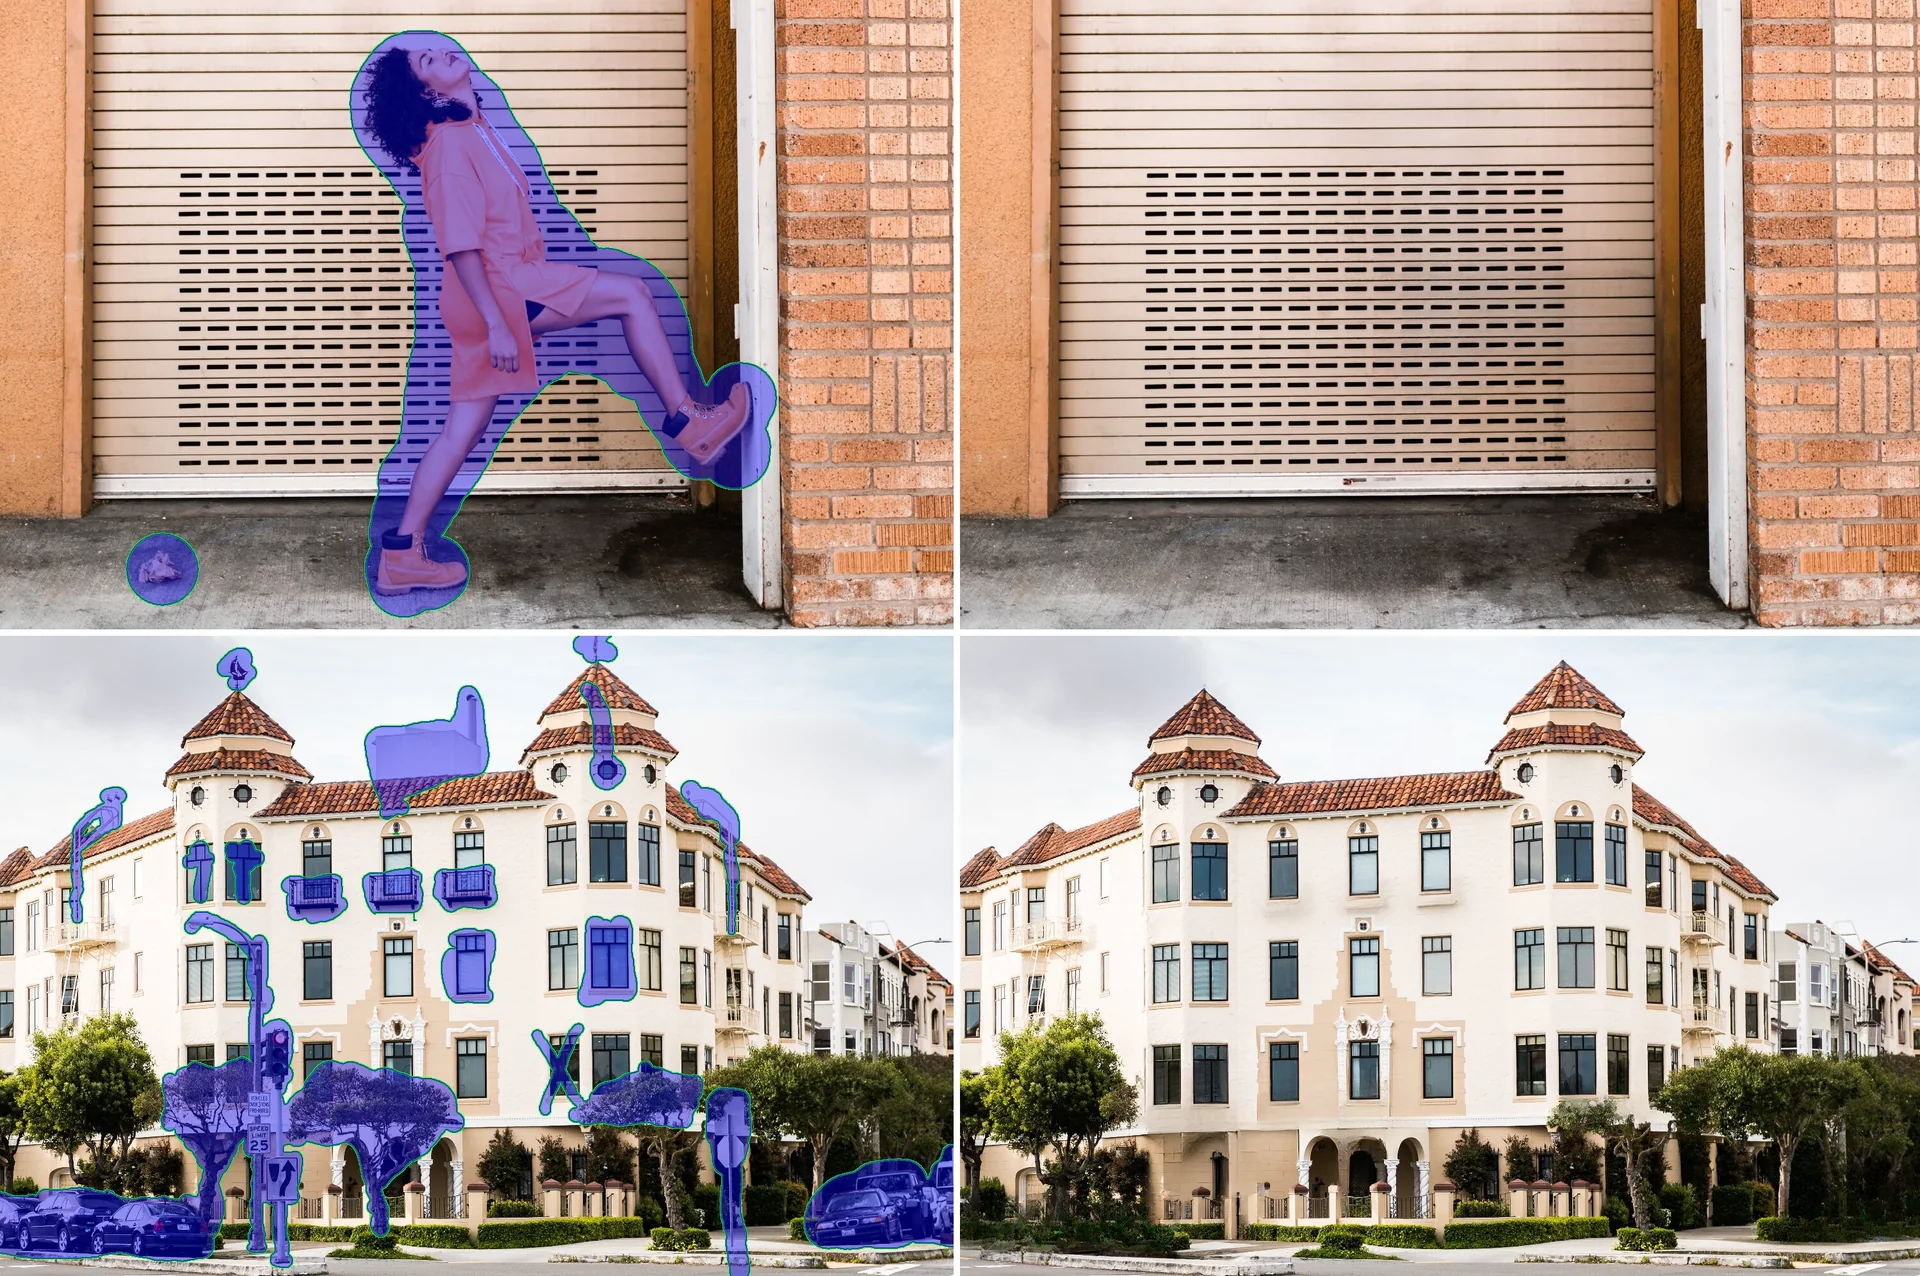
透过简洁的架构图,LaMa 的成功凝聚在四条高度协同的设计哲学之中:
- 在网络最早期层直接接通全图视野,拒绝靠堆叠局部卷积慢慢爬行(Early Image-Wide Receptive Field via FFC):对于一个宽达上百像素的实心孔洞,孔洞内部的初始像素全为 0。普通 卷积在前十几层里只能在全 0 的洞内空转,等到了深层虽然纸面上的“理论感受野”够大了,但呈高斯衰减的“有效感受野”(ERF)依然抓不住对岸信息。LaMa 将残差块中 75% 的通道送入频域做快速傅里叶卷积(Fast Fourier Convolution, FFC)——由于每个傅里叶频谱系数都是全图所有像素的线性求和,在频域做一次 卷积再逆变换回来,就能让第一个残差块的每一个像素当场看清孔洞两岸的栅栏间距与周期相位。
- 看得远的生成器,必须配一把“看得远的监督尺子”(High Receptive Field Perceptual Loss):大孔洞内部天然存在多解性(被挡住的墙后既可以是白墙也可以是窗框),逐像素 损失会把多种可能平均成模糊色块;而常规 ImageNet 分类 VGG 提取的感知特征又过于偏向局部纹理块。LaMa 改用在 ADE20K 密集语义分割上预训练、且后层带有扩张卷积(Dilated Conv)的 ResNet50 作为感知损失主干(HRFPL),配合只追究掩码交集区域的 PatchGAN 对抗损失,从监督端逼迫生成器对齐大尺度的建筑结构与场景布局。
- 用激进的宽孔洞训练分布,堵死模型“靠局部插值抄近道”的退路(Aggressive Large-Mask Curriculum):如果训练时只喂细碎的随机涂鸦掩码,每个缺失像素离可见背景只有三五个像素,哪怕给网络装上 FFC,优化器也会偷懒走局部插值的捷径。LaMa 以 50:50 的概率混合最大笔宽达 100 像素的粗折线与大矩形框,大幅拉高缺失像素到可见边界的平均欧氏距离(Mask Width),让模型唯有调用远距离频域通道才能把训练损失降下来。
- 利用全图 FFT 的相对视野恒定性,实现从 到高清大图的跨分辨率泛化(Scale-Robust Generalization):当测试图像从训练时的 放大 3 倍到 或 时,固定大小的空间卷积核相对于整张图的视野比例缩水成了原来的 ,再次退化为“管中窥豹”;而 FFC 的全局分支在任何尺寸下都对整张特征图做 2D FFT,视野覆盖率永远是 100%,加上自然图像低频结构与频域 卷积权重的尺度共享特性,使模型无需切片拼接即可直接修复高分辨率大图。
下面我们就顺着这四条设计哲学,结合数学推演、消融实验与开源仓库实现,彻底拆解 LaMa 的工作机理与工程边界。
1. 为什么大孔洞会击穿普通卷积?问题建模与感受野困局
1.1 四通道输入与“已知区域无损贴回”契约
在数学形式与代码实现上,设完整 RGB 图像为 ,二值缺失掩码为 。遵循官方仓库 advimman/lama 的极性约定,令 代表需要抹除重绘的孔洞区域, 代表需要保留的已知背景。
生成器的输入 是将孔洞区域清零后的可见图像 与单通道掩码 在通道维拼接而成的 4 通道张量;单阶段全卷积生成器 一次前向直接输出预测全图 ,并在最终交付时将已知区域的原始像素原封不动地合回输出图 :
不要小看最后一步合成公式 :不仅在产品交付上它保证了未被涂抹的背景像素 100% 零失真,在训练时它也与后文的掩码对齐判别器紧密配合,免去了生成器在已知区域浪费容量去背诵原图的负担。
1.2 理论感受野的假象与大孔洞的五重挑战
为什么小划痕修复很容易,而把孔洞扩大到占画面 30%~50% 时,堆叠了十几层 卷积的深层网络就会迅速崩溃?
从纸面算术来看,每堆一层步长为 1 的 卷积,感受野边长加 2;配合 3 次步长为 2 的下采样(倍率 ),9 个残差块叠加下来,最深层特征的理论感受野(Theoretical Receptive Field)似乎足以覆盖 画幅。然而,Luo 等人在 NeurIPS 2016 的经典研究早已揭示:深度卷积网络的“有效感受野”(Effective Receptive Field, ERF)只占理论感受野中心很小的一团区域,边缘像素对中心输出的梯度贡献呈指数级高斯衰减。
在图像修复中,这种衰减被进一步放大成了五重困境:
- 早期层在孔洞内部“盲算”:对于一个直径 120 像素的大洞,网络前几层的 卷积核落在洞中心时,周围 9 个格子里全是 。这意味着在网络前半程,洞中心根本提取不出任何有意义的特征,只能靠一层层极其缓慢的边界侵蚀往里传信息。
- 周期性结构的跨洞相位对齐:当被抹除的人物挡住了一段铁丝网或一排窗户(见后文 Fig. 4),仅仅把左边的纹理往右顺延、右边的纹理往左顺延,两股纹理在洞中央汇合时大概率会错开半格!要让两头严丝合缝,生成器必须在动笔的第一刻就同时算准全局周期的主频率与两岸的相对相位。
- 高分辨率放大下的“视野缩水”:一个在 上刚好能跨过 80 像素孔洞的普通卷积网络,放到 (边长放大 6 倍)的原图上时,同一个物体掩码的像素宽度变成了 480 像素,而卷积核的像素跨度却一寸没长!此时哪怕到了网络最深层,感受野也根本够不到孔洞边缘,洞中央彻底沦为无源之水。
怎么在完全不增加空间卷积核尺寸、也不构造 昂贵全局注意力矩阵的前提下,让网络从第一个残差块起就拥有 100% 的全图视野?答案是借道傅里叶频域。
2. 核心设计哲学一:快速傅里叶卷积(FFC)如何打破空间局部性?
2.1 Fourier Unit:为什么频域里的 1×1 卷积等价于空间全图感受野?
根据基础信号处理原理,空间域中的一张二维特征图 ,经过二维离散傅里叶变换(2D DFT)后得到的频谱图 中,每一个频率点 的复数值,都是空间域整张图所有像素 与对应正余弦基函数的全局加权和。
这意味着什么?意味着只要我们把特征图通过二维实数快速傅里叶变换(,复杂度仅 )切到频域,在频域上对每个频率点做一次极其廉价的跨通道 卷积,然后再用逆变换()切回空间域——频域上改动的任何一个数字,在逆变换回空间域时都会瞬间广播到全图的每一个像素上!
对照官方源码 saicinpainting/training/modules/ffc.py 中的 FourierUnit 类,给定输入特征张量 ,其四步运算干脆利落:
- 实数二维 FFT 变换:利用实数输入的共轭对称性,沿高宽两维执行
torch.fft.rfftn,最后一维只需保留约一半频率 ,得到复数频谱 ; - 实部与虚部通道拼接:将复数张量的实部 与虚部 沿通道维拼接为实数张量,通道数翻倍为 :
- 频域跨通道混合:在拼接后的频谱张量上施加可学习的 卷积(跨通道混合实部与虚部,等价于复数权重的线性变换并引入跨通道耦合)、批归一化(BatchNorm)与 ReLU 非线性激活:
- 二维逆 FFT 还原空间域:将 通道重新拆回实部与虚部组装为复数张量 ,调用
torch.fft.irfftn精确还原回原始空间尺寸 。
2.2 Local / Global 四路双分支残差块与 enable_lfu: false 的真相
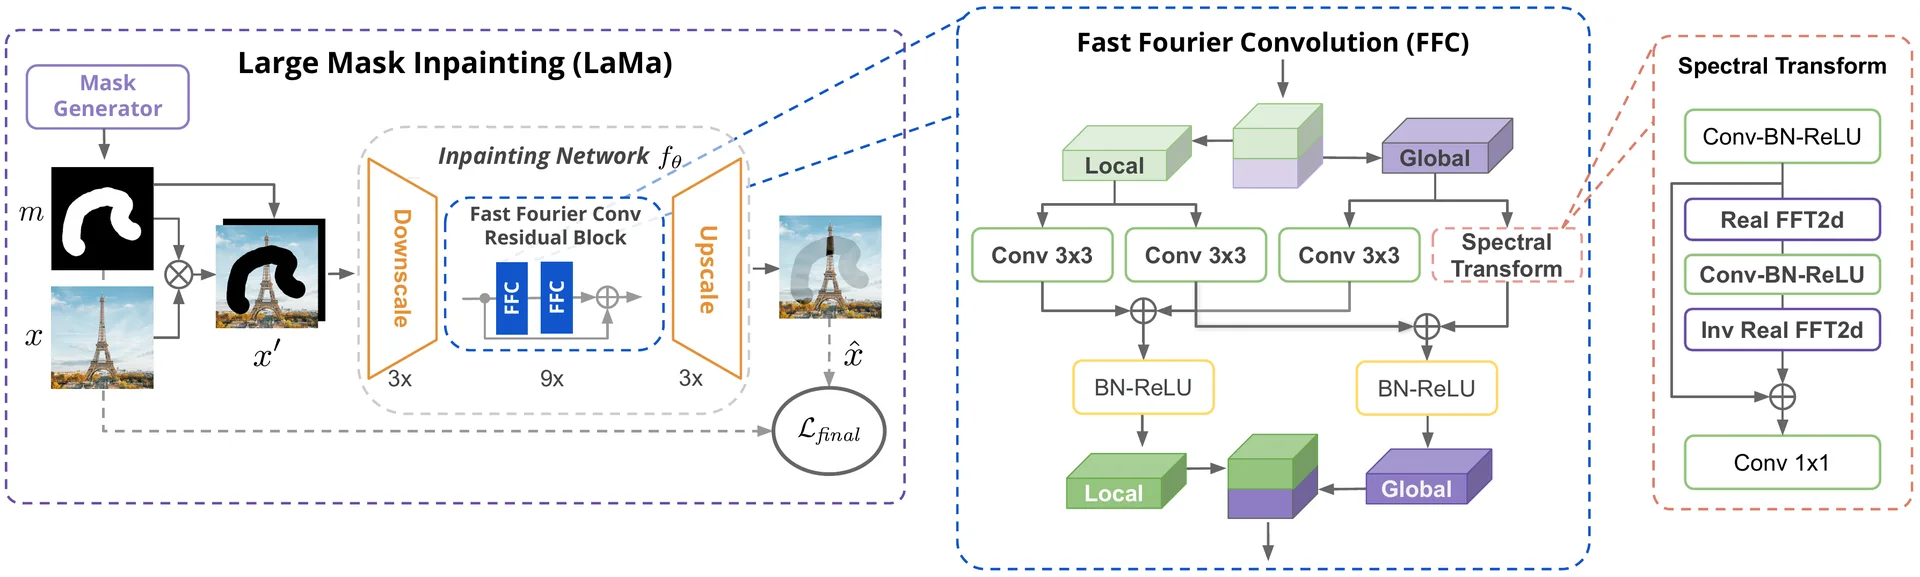
如果频域变换视野这么广,能不能干脆把网络里所有的 空间卷积全都删掉,100% 换成 FourierUnit?
不能!因为傅里叶基函数是铺满全图的周期正余弦波,它擅长捕捉全局周期节律和低频大局,却不擅长精确定位局部的锐利边缘与非周期微纹理(纯频域处理极易在强边缘附近引发吉布斯振铃伪影)。
因此,如 Fig. 2 中间面板所示,LaMa 采用的 FFC 残差块(FFCResnetBlock)走的是 “空间局部 + 频域全局”双剑合璧 的路线:将输入特征 按通道比例划分为局部分支 与全局分支 ,并在每个层内通过四条子路径让两路信息互相滋养:
- 局部到局部 、局部到全局 、全局到局部 :全部采用常规的 空间卷积,负责精细刻画局部边缘纹理,并随时把全局上下文拉回局部分支、把局部锚点送入全局分支;
- 全局到全局 :采用 Fig. 2 右侧的 Spectral Transform(先用 卷积将通道减半,过一遍上面的
FourierUnit做全图频率混合,残差相加后再用 卷积恢复通道数)。
在官方核心配置 configs/training/generator/ffc_resnet_075.yaml 中,中间残差块的全局通道占比被设定为 ——也就是说,每个残差块里足足有 75% 的通道在走频域全图高速路,剩下 25% 的通道走空间局部小路!
这里还有一个只有读过源码配置才会发现的重要事实:在 Fig. 2 最右侧的 Spectral Transform 框图里,画着一个虚线框标注的 LFU(Local Fourier Unit,把特征图切分成 局部象限再做半尺寸 FFT 的分支)。许多二手解读文章看到框图就以为 LaMa 靠 LFU 抓局部频率,但只要打开官方仓库的 ffc_resnet_075.yaml 就会看到:
resnet_conv_kwargs:
  ratio_gin: 0.75
  ratio_gout: 0.75
  enable_lfu: false
LaMa 官方所有主力模型全部显式关闭了 LFU(enable_lfu: false)! 因为 25% 的 空间局部分支配合 75% 的全图 FourierUnit 已经完全够用,省掉 LFU 不仅减少了额外的切块 FFT 开销,架构也更加纯粹。整个标准 LaMa-Fourier 生成器由 3 次下采样、9 个 FFC 残差块和 3 次上采样组成,总参数量仅 27M。
2.3 为什么 FFC 修窗户和铁丝网这么神?
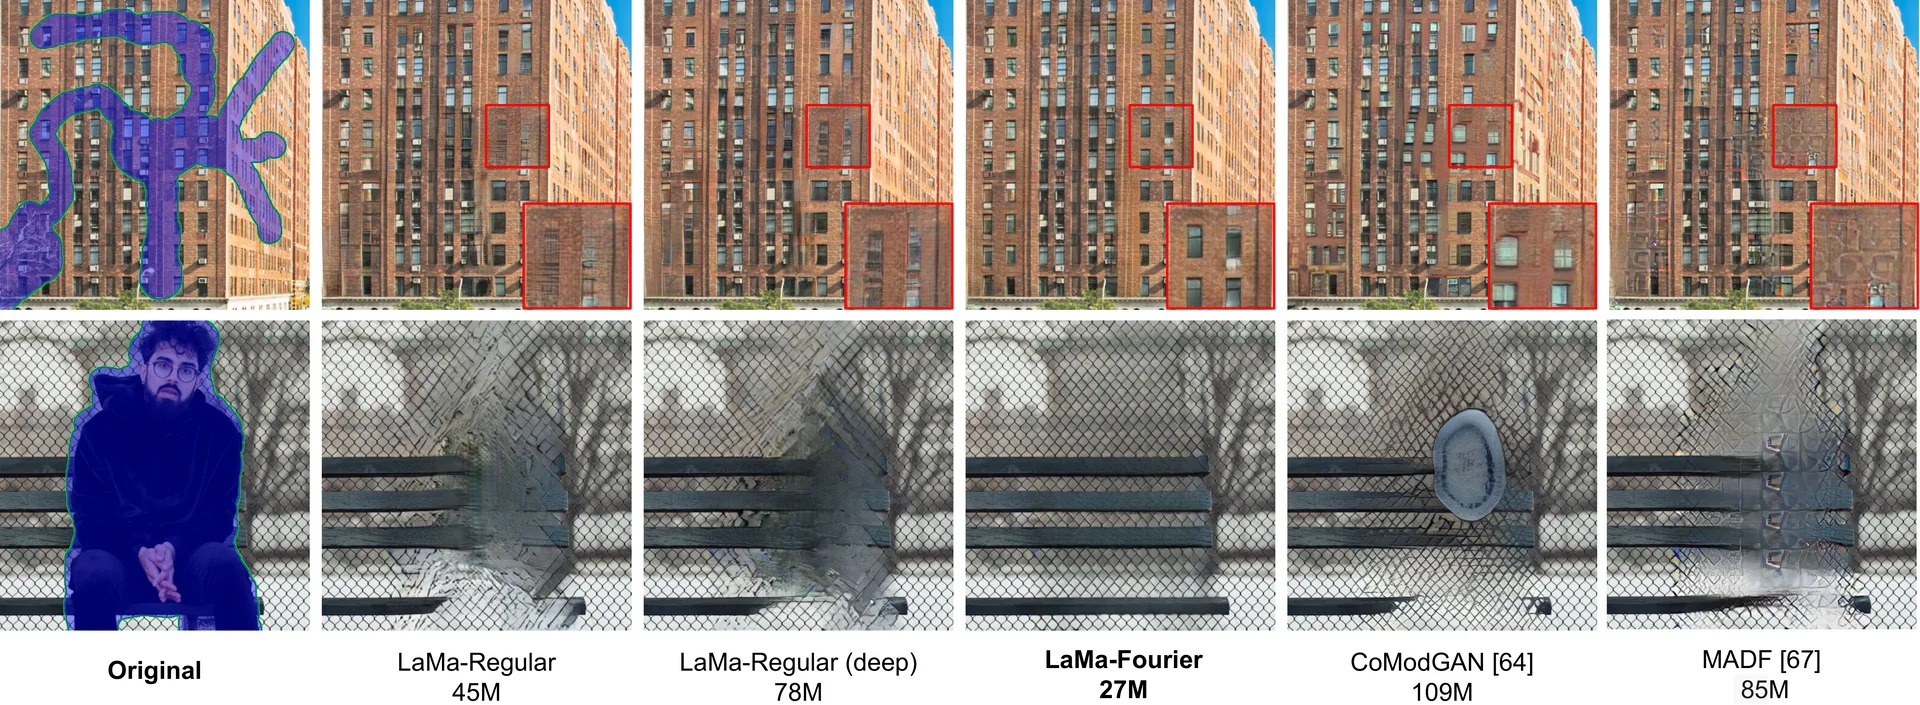
看 Fig. 4 的直观对比:当把大块掩码盖在密集的写字楼窗格或斜向交织的链式铁丝网上时,参数量高达 46M~74M 的普通卷积基线(LaMa-Regular)在洞中央完全迷失了方向,画出一片模糊重影;而仅 27M 的 LaMa-Fourier 却像拿尺子比着画一样,把横竖窗框和菱形网眼精准地从孔洞左边连到了右边。
用信号处理的眼光看,这再自然不过了:空间域里重复出现的百叶窗或铁丝网,本质上就是二维空间余弦波 。在空间域里,孔洞把波形拦腰截断,局部卷积核根本看不出周期步长;而一旦经 rFFT2 变换到频域,整面墙所有可见窗格的能量都会瞬间聚焦到特征频谱图上的同一个峰值坐标 及其谐波点上!频域里的 卷积只需保住这个频率峰的能量与复数相位角 ,逆变换 irFFT2 回空间域时,对应的周期网格就会自动铺满整个孔洞区域。
3. 核心设计哲学二:高感受野感知损失(HRFPL)与掩码对齐对抗训练
3.1 为什么放弃逐像素 L1 损失,改用分割预训练的扩张 ResNet50?
如果生成器已经靠 FFC 看清了全图,但训练时的裁判(损失函数)是个“近视眼”,会发生什么?
在大孔洞修复中,缺失区域内部往往有不止一种合理填法:比如抹掉沙发前站着的人,他身后的沙发靠垫褶皱往左偏 2 厘米或往右偏 2 厘米都完全自然。如果强行使用逐像素 或 损失去逼迫生成图对齐原图唯一的 Ground Truth,网络为了在所有可能的位置上同时讨好惩罚项,唯一的数学最优解就是输出所有可能褶皱的算术平均值——一团糊掉的色块。
那用传统的 VGG19 感知损失(Perceptual Loss)行不行?比 强,但还不够好。因为传统 VGG19 是在 ImageNet 单主体分类任务上用普通 卷积训练的,它的高层特征主要关注“图里有没有狗头、有没有车轮”这类局部判别纹理,对整面背景墙的几何连贯性并不敏感。
为此,LaMa 专门定制了高感受野感知损失(High Receptive Field Perceptual Loss, HRFPL):
这里的特征提取器 (对应源码 training/losses/perceptual.py 中的 ResNetPL)同时做了两项关键升级:
- 换用扩张卷积放大监督视野(Dilated Convolution):将 ResNet50 后部阶段的普通卷积替换为扩张卷积,使其在不降低特征图空间分辨率的前提下,单层视野迅速扩张覆盖大范围区域;
- 换用 ADE20K 密集语义分割作为预训练任务(Pretext Task):语义分割要求网络把墙面、窗户、地板、栏杆的每一个像素边界与全局共现关系都分得清清楚楚,因此其四个残差阶段提取出的特征天然对“整段建筑立面是否连贯、透视结构是否断裂”高度敏感。
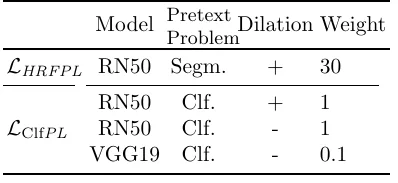
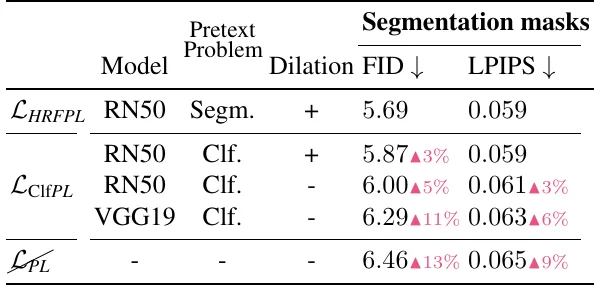
看上面补充材料 Table 5(各主干最优损失权重标定,由于不同网络特征激活的绝对数值尺度不同,HRFPL 最优权重标定为 30,分类 ResNet 为 1,VGG19 为 0.1)与主文 Table 3 的消融对比:在固定完全相同的生成器与大掩码训练条件下,从普通 VGG19(FID 6.29)换成普通分类 ResNet50(6.00),加上扩张卷积后 FID 进一步改善至 5.87,最后把预训练任务换成密集语义分割(即完整 HRFPL),FID 达到全场最佳的 5.69(LPIPS 0.059)。这清晰地证明了:只有当生成器(FFC)和监督器(HRFPL)同时具备大范围感受野时,全局结构才能真正对齐。
3.2 掩码对齐的 PatchGAN 判别器与四项联合损失
感知损失管住了大尺度的结构连贯性,但要让修补区域的草地、皮肤、砖面拥有以假乱真的高频微纹理,还得靠生成对抗网络(GAN)。LaMa 采用了一个 5 层卷积构成的 PatchGAN 判别器 (输出一张二维空间真假评分网格,每个网格点对应原图的一块局部感受野):
NLayerDiscriminator(
    Conv2d(3, 64, kernel_size=4, stride=2, padding=2), LeakyReLU(0.2),
    Conv2d(64, 128, kernel_size=4, stride=2, padding=2), BatchNorm2d(128), LeakyReLU(0.2),
    Conv2d(128, 256, kernel_size=4, stride=2, padding=2), BatchNorm2d(256), LeakyReLU(0.2),
    Conv2d(256, 512, kernel_size=4, stride=1, padding=2), BatchNorm2d(512), LeakyReLU(0.2),
    Conv2d(512, 1, kernel_size=4, stride=1, padding=2),
)
在设计对抗损失时,LaMa 做了一个极契合修复任务的工程处理——掩码对齐局部真假标签(Mask-Aligned Patch Discrimination)。
想一想:在一张修复后的图像里,掩码外面的像素()本来就是从真实原图直接贴回去的真像素。如果像普通 GAN 那样把整张生成图的所有 Patch 统统标为 Fake(假),判别器就会在已知区域吹毛求疵,逼着生成器浪费宝贵的容量去拟合根本不需要它管的已知区域。因此,源码 training/losses/adversarial.py 将二值掩码下采样到判别器输出特征图的尺寸:只有那些感受野与掩码孔洞()存在交集的 Patch 才被当作 Fake 监督;完全落在已知背景里的 Patch 哪怕在生成图上也一律当作 Real 对待!同时,因为跨越孔洞边缘的 Patch 感受野同时包含了真背景和新生成的像素,判别器会极其严厉地盯着接缝处看有没有色彩或纹理突变,天然起到了消除边界接缝的作用。
在此基础上,为防止对抗训练震荡或产生高频棋盘格噪声,系统还加上了判别器中间层特征匹配损失 (Feature Matching, 距离)和真实图像梯度惩罚 ,最终形成四项联合目标函数:
4. 核心设计哲学三:用激进的大掩码分布逼出远距离推理能力
4.1 为什么用“几何宽度(Mask Width)”衡量掩码难度?
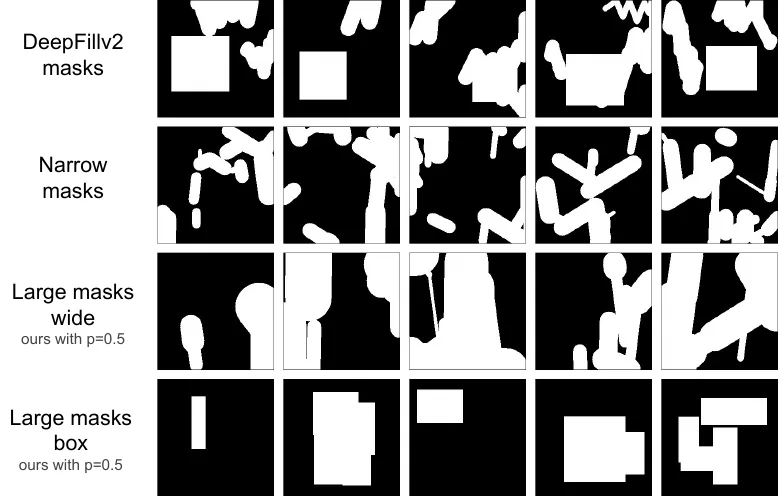
看 Fig. 3 展示的四列掩码形态对比:过去像 DeepFillv2 等主流方法在训练时,习惯用随机游走的细笔刷生成掩码(第一、二列)。这种细笔刷哪怕在图上画得密密麻麻、占了 30% 的总面积,但仔细一看,每一根线条只有十几像素宽,意味着洞里任何一个缺失像素离最近的可见像素都不超过 10 个像素!
用这种“窄掩码”训练出来的模型,根本不需要动用什么全局频域通道——它只要学会把紧挨着边缘的 10 个像素往里抹一抹,就能拿到很低的训练损失;可一旦到了真实应用里,用户拿大号涂抹笔把整个人或整辆车涂成一个实心大胖块(Fig. 3 第三、四列),模型就当场傻眼了。
为了定量刻画“洞心离岸边到底有多远”,论文提出用掩码几何宽度(Mask Width)替代单纯的面积占比:对孔洞 里的每一个缺失像素 ,先算出它到最近已知像素 的最短欧氏距离 ,再对整个孔洞求平均:
4.2 50:50 混合激进掩码生成器与测试集难度分层
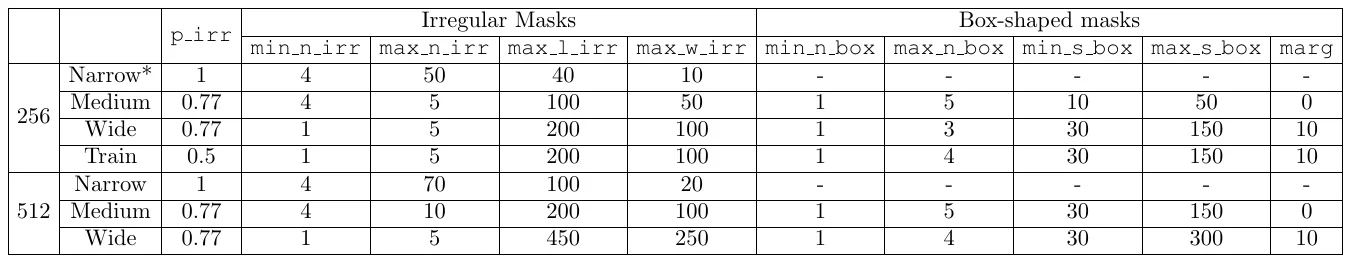
为了让模型在训练期天天经受大跨度孔洞的考验,源码 saicinpainting/training/data/masks.py 中的 MixedMaskGenerator 以 50% : 50% 的概率随机交替生成两类极具侵略性的宽掩码(具体参数见下方补充材料 Table 4):
- 50% 概率生成超宽随机折线(
RandomIrregularMaskGenerator):在 训练图上,单笔最大宽度直接拉到 100 像素,单段最大长度 200 像素,最多叠加 5 段折线; - 50% 概率生成大矩形盒(
RandomRectangleMaskGenerator):边长在 30 到 150 像素之间随机采样,最多叠加 4 个矩形框(单图掩码最大面积占比上限设为 50%)。
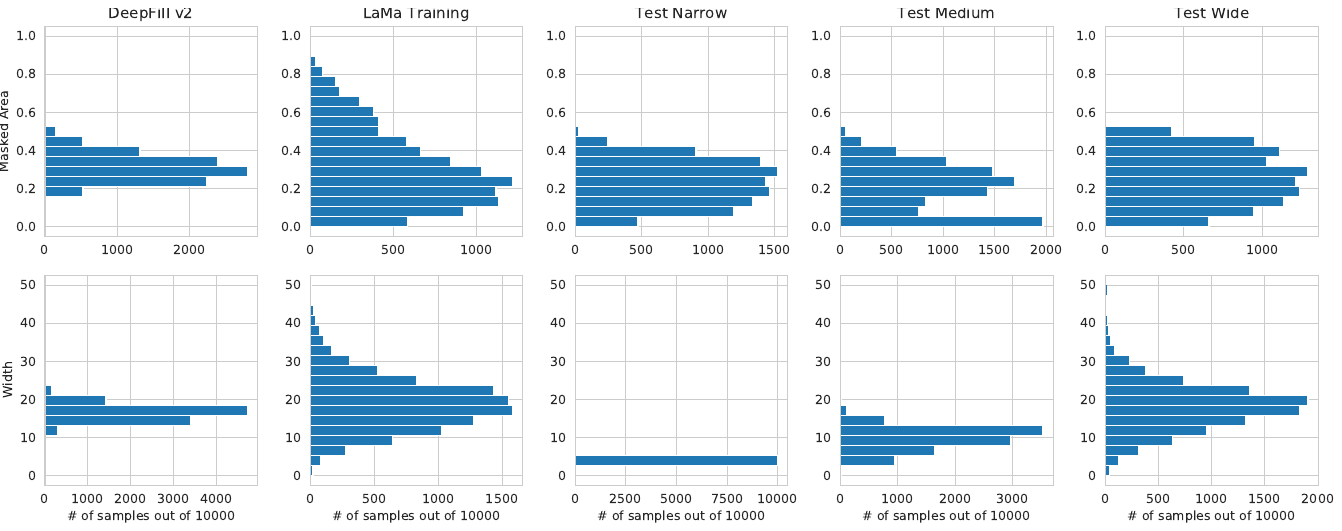
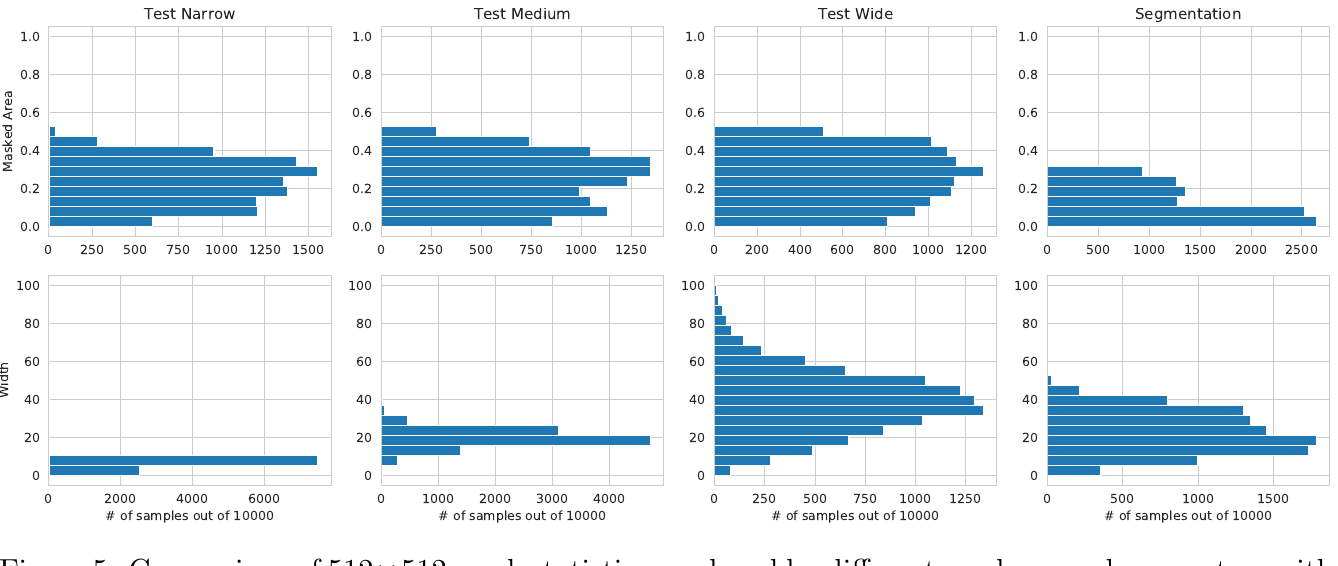
对照上面补充材料 Fig. 4(256 分辨率)与 Fig. 5(512 分辨率)的分布曲线,可以看到 DeepFillv2 的训练掩码(红色虚线)在几何宽度(Distance to known pixels)上全部挤在最左侧的极窄区,而 LaMa 的训练掩码(绿色实线)则一路平缓延伸到了极宽区域。
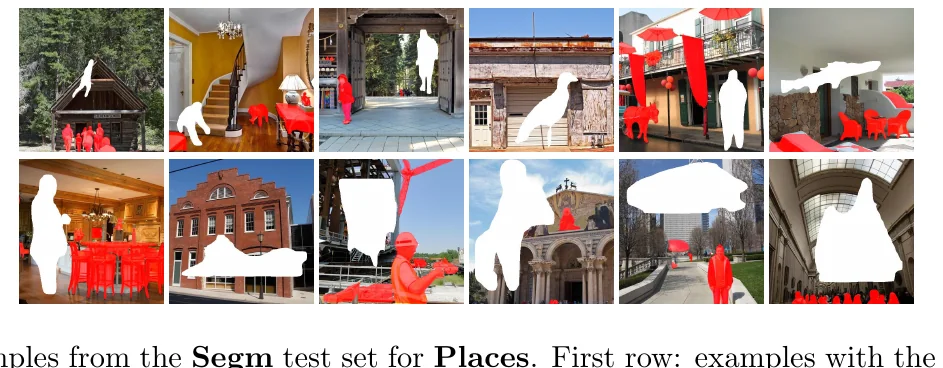
为了在测试时公平检验各模型在不同难度下的真实表现,作者不仅按几何宽度构造了 Narrow(窄)、Medium(中)、Wide(宽)三档随机测试集(Places 上每档各 30,000 对图像-掩码),还专门用 Detectron2 抠出真实场景中的人物、车辆、家具轮廓,构建了约 4,000 对 Segmentation Masks 测试集(如补充材料 Fig. 3 所示),直接模拟真实产品中“点选物体、一键消除”的工况。
5. 实验验证、三大核心消融与跨分辨率泛化机理
5.1 Places 与 CelebA-HQ 主实验及盲测用户研究
标准 LaMa-Fourier(9 个 FFC 残差块,27M 参数)与扩展版 Big LaMa(18 个 FFC 残差块,51M 参数,在 450 万张 Places-Challenge 全集上以 batch_size=120 用 8 张 V100 训练约 240 小时)均只在从约 图像上随机裁剪出的 图块上训练(生成器学习率 ,判别器学习率 ,跑满 100 万步)。
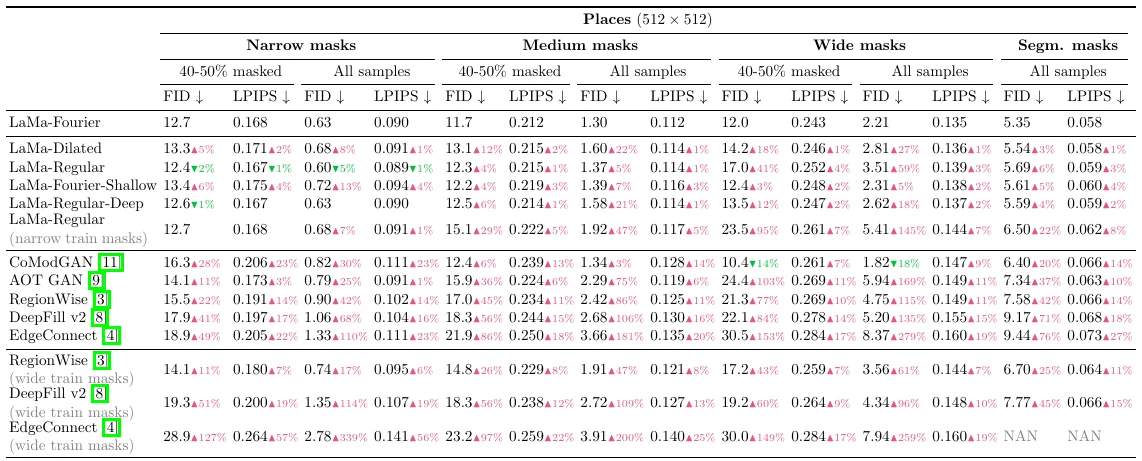
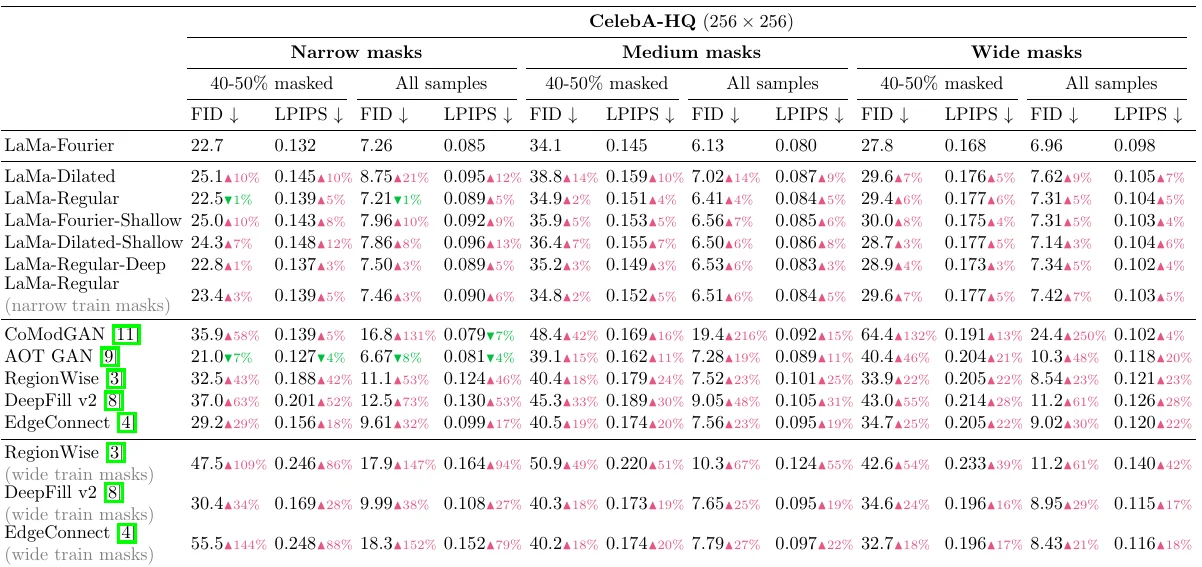
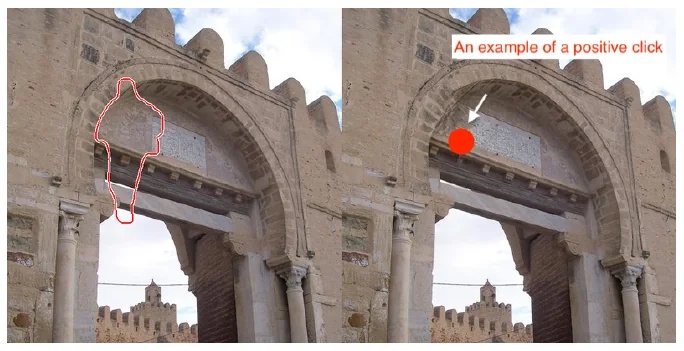
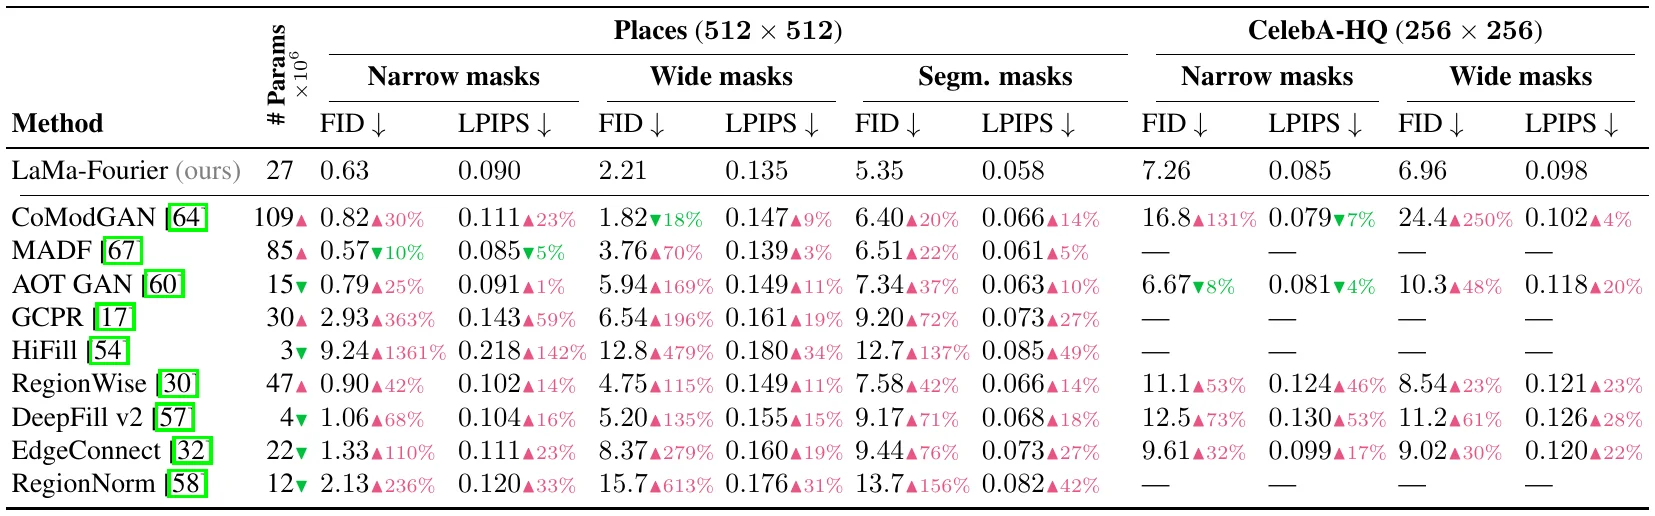
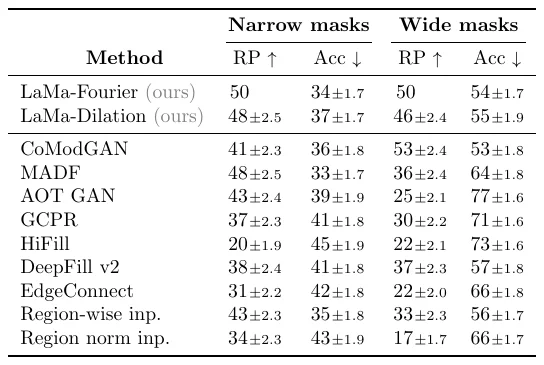
综合主文 Table 1、补充材料 Table 2/3(专门拆出遮挡面积达 40%~50% 的最困难子集)以及补充材料 Table 1 的盲测用户研究(界面见补充 Fig. 1 并排偏好 RP 与 Fig. 2 盲找伪造区 Acc),我们可以提炼出三点核心实验发现:
- 以四分之一的参数量击败重型基线:仅 27M 参数的确定性单阶段模型 LaMa-Fourier,在 Places()的 Narrow(FID
0.63)、Segmentation(FID5.35)以及 CelebA-HQ 的全部切分上,全面击败了参数量高达 109M 的随机生成对抗模型 CoModGAN 和 85M 的多阶段模型 MADF。 - 理性看待 Places Wide 上与 CoModGAN 的细微差异:在 Places Wide 极宽掩码上,109M 参数的 CoModGAN 拿到了略低的 FID(
1.82vs LaMa2.21),但在衡量与原图上下文结构对齐度的 LPIPS 上,LaMa(0.135)依然显著优于 CoModGAN(0.147)。这是因为 CoModGAN 引入了类似 StyleGAN 的随机潜码调制,擅长在超大孔洞里“自由发挥”编造逼真的随机纹理(因而集合分布距离 FID 占优),而确定性的 LaMa 则严格忠于孔洞周围的几何延伸(因而成对感知距离 LPIPS 占优)。 - 人类肉眼近半数无法识破大孔洞修补位置:在补充材料 Table 1 的“盲找掩码”(Spot-the-mask Acc,越低代表越难被肉眼看穿)测试中,面对 Narrow 掩码修复图,人类受试者只有
34%的概率能点中修补区域;即便面对遮挡严酷的 Wide 掩码,人类也只有54%的概率能找准位置,显著优于除 CoModGAN 外的所有对比模型。
5.2 架构与掩码双消融:到底是谁立了大功?
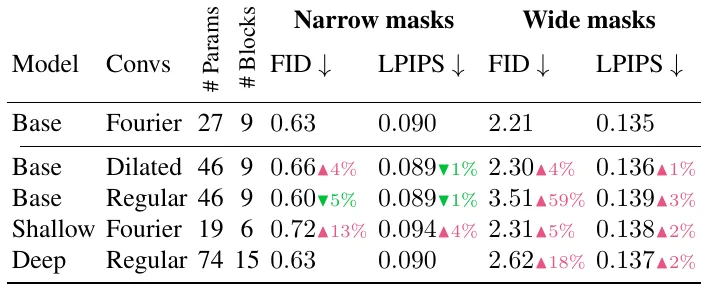
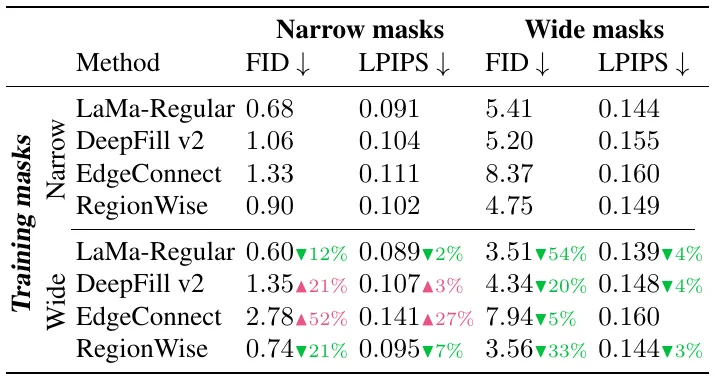
看 Table 2(生成器架构消融)和 Table 4(宽掩码训练跨模型迁移消融),这两张表设计得极具说服力:
- Table 2 粉碎了“只是因为参数多或网络深”的怀疑:
- 在孔洞很窄的
Narrow测试集上,46M 参数的普通卷积Base Regular的 FID(0.60)甚至比 27M 的Base Fourier(0.63)还低一丁点——这非常符合直觉:窄洞旁边全是有用像素,普通 卷积就够用了,没必要绕道频域。 - 可一旦到了宽孔洞
Wide测试集,Base Regular的 FID 瞬间崩到3.51,而参数少 40% 的Base Fourier稳稳守在2.21! - 如果不换 FFC,而是把普通卷积硬生生堆到 15 个残差块、参数量暴涨到 74M(
Deep Regular,参数量是 LaMa 的 2.7 倍)呢?Wide FID 只能勉强降到2.62,甚至连只有 19M 参数、6 个残差块的轻量版Shallow Fourier(2.31)都打不过!这铁证如山地说明,大孔洞修复拼的是早期全局有效感受野,靠堆叠局部卷积层数根本补不回来。
- 在孔洞很窄的
- Table 4 揭示了“宽掩码训练”跨模型迁移的普适性与前提:
把 LaMa 的宽掩码训练策略移植给 LaMa-Regular、RegionWise、DeepFillv2 和 EdgeConnect 四个模型后,四个模型在 Wide 测试集上的 FID 全部获得大幅改善(例如 LaMa-Regular 从
5.41大幅降至3.51)。但仔细看 Narrow 一列:单阶段大容量的 LaMa-Regular 和 RegionWise 在改用宽掩码训练后,连带窄洞指标也变好了(因为戒掉了局部插值懒惰习性);而两阶段的 EdgeConnect(先预测边缘图再填色)在被宽掩码轰炸后,第一阶段边缘预测器吃不消崩溃了,导致窄洞 FID 反而从1.33恶化到了2.78。这说明激进的数据课程必须配得上能够消化远距离信息的模型骨架。
5.3 核心设计哲学四:为什么只在 256×256 上训练,却能直接修 1920×1536 大图?
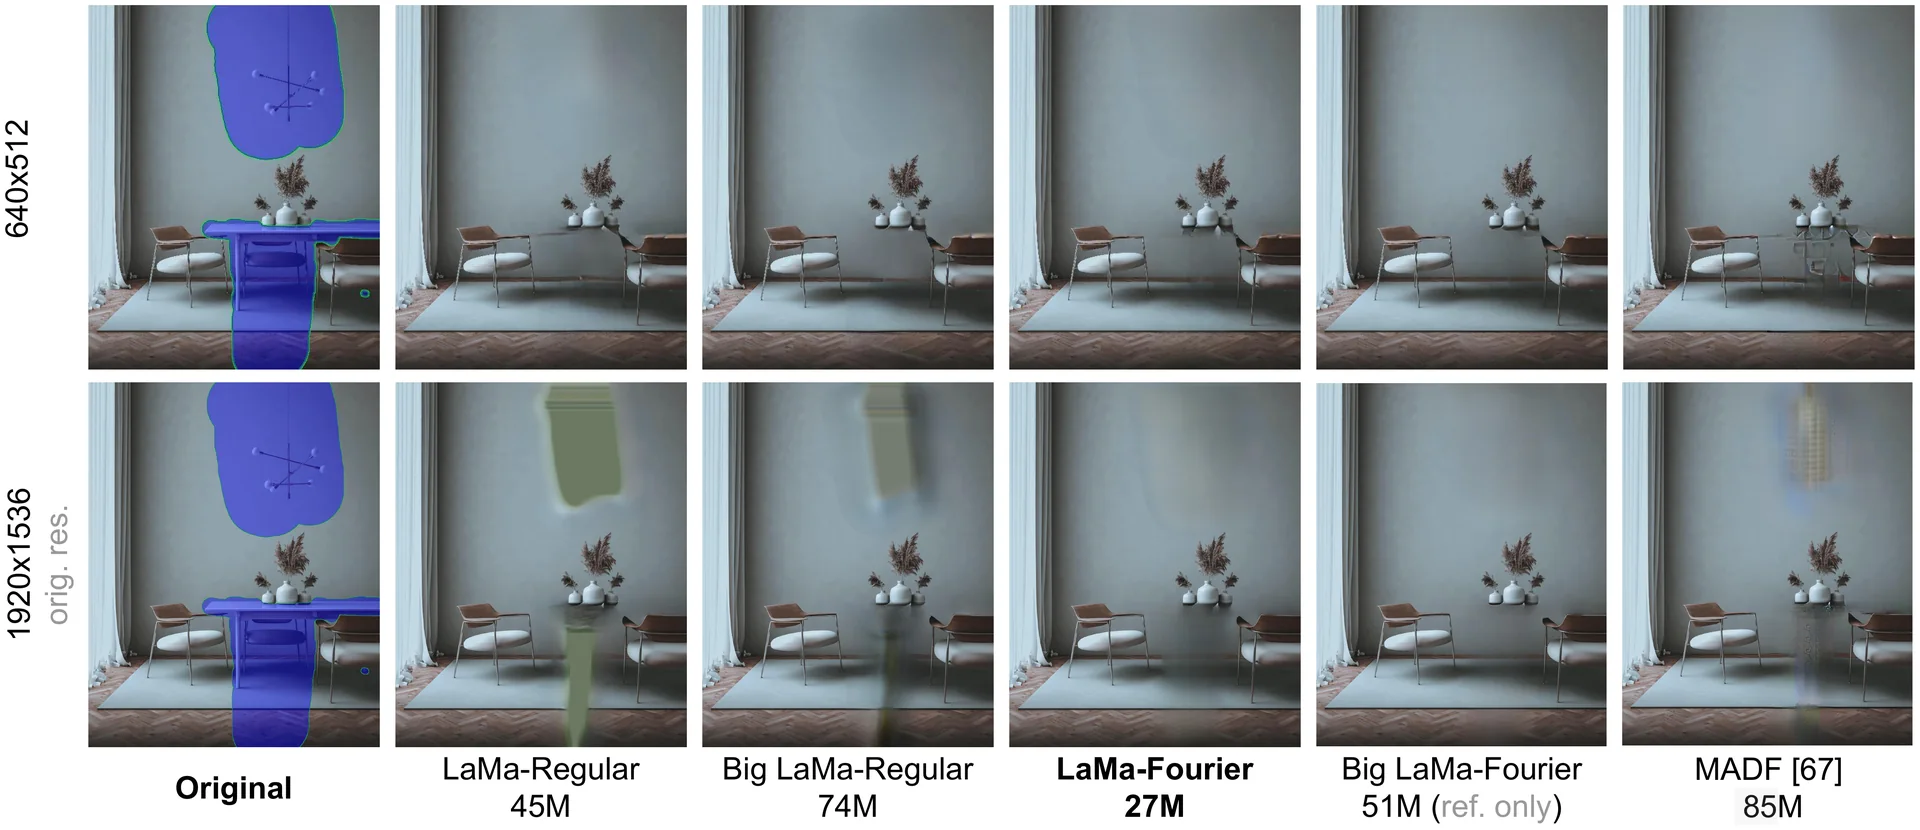
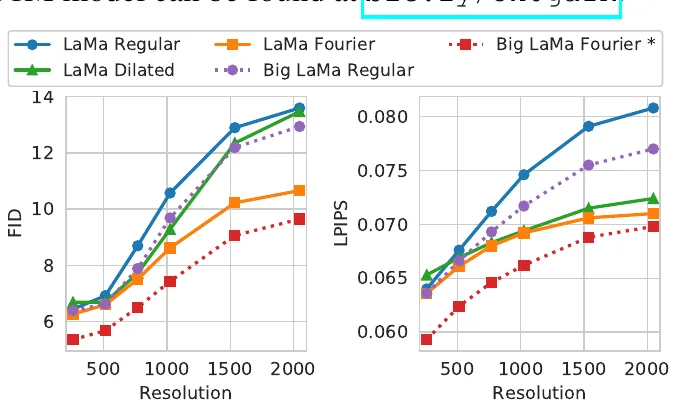
看 Fig. 5 和 Fig. 6,这是整篇论文最令人拍案叫绝的实验:所有 LaMa 变体在训练时只见过 的小图块;到了测试时,不做任何分块切片(Tiling),直接把 乃至 的高清大图整张喂进生成器前向传播。
在 (第一行)时,普通卷积(LaMa-Regular)和傅里叶卷积(LaMa-Fourier)看起来都还行;可一旦分辨率推高到 (第二行),LaMa-Regular 与 18 层的 Big Regular 在孔洞中央全都崩出了诡异的彩色竖条纹与大块模糊,唯独 LaMa-Fourier 和 Big LaMa-Fourier 依然平滑、干净地还原了整面高分辨率墙体与桌椅结构!Fig. 6 的曲线也定量展示了从 到 分辨率下,Fourier 变体的 FID 与 LPIPS 退化斜率远比普通卷积和扩张卷积平缓得多。
为什么没有见过高分辨率图的 FFC 能有如此神奇的跨分辨率外推能力?背后有三重物理机制:
- 相对视野永远保持 100%:当输入图像边长放大 4 倍时,普通卷积核或固定扩张率卷积(LaMa-Dilated)覆盖的相对画面比例缩小到了 ,再次变成“盲人摸象”;而
FourierUnit里的rfftn永远对当前整张特征图做全局变换,不管输入是 还是 ,它的视野覆盖率永远是整张图的 100%。 - 低频结构能量的尺度不变性:把一张自然图像放大 2 倍后,虽然增加了高频像素格点,但决定房间墙面、窗户排布、桌面轮廓的基频与低频谐波分量在频谱图上的相对能量结构高度稳定,使频域学到的全局协调能力得以跨尺寸复用。
- 频域 卷积的逐频率参数共享:注意
FourierUnit在频域里用的是 卷积,它的权重矩阵 只在通道维操作,与频谱图的空间尺寸 完全解耦!这意味着无论输入分辨率怎么变,同一套 卷积核都能无缝作用在每一个频率格点上。
6. Big LaMa 能力边界、无 FFT 替代架构与源码精读
6.1 从 Big LaMa 的正反例看清频域修复的真实局限
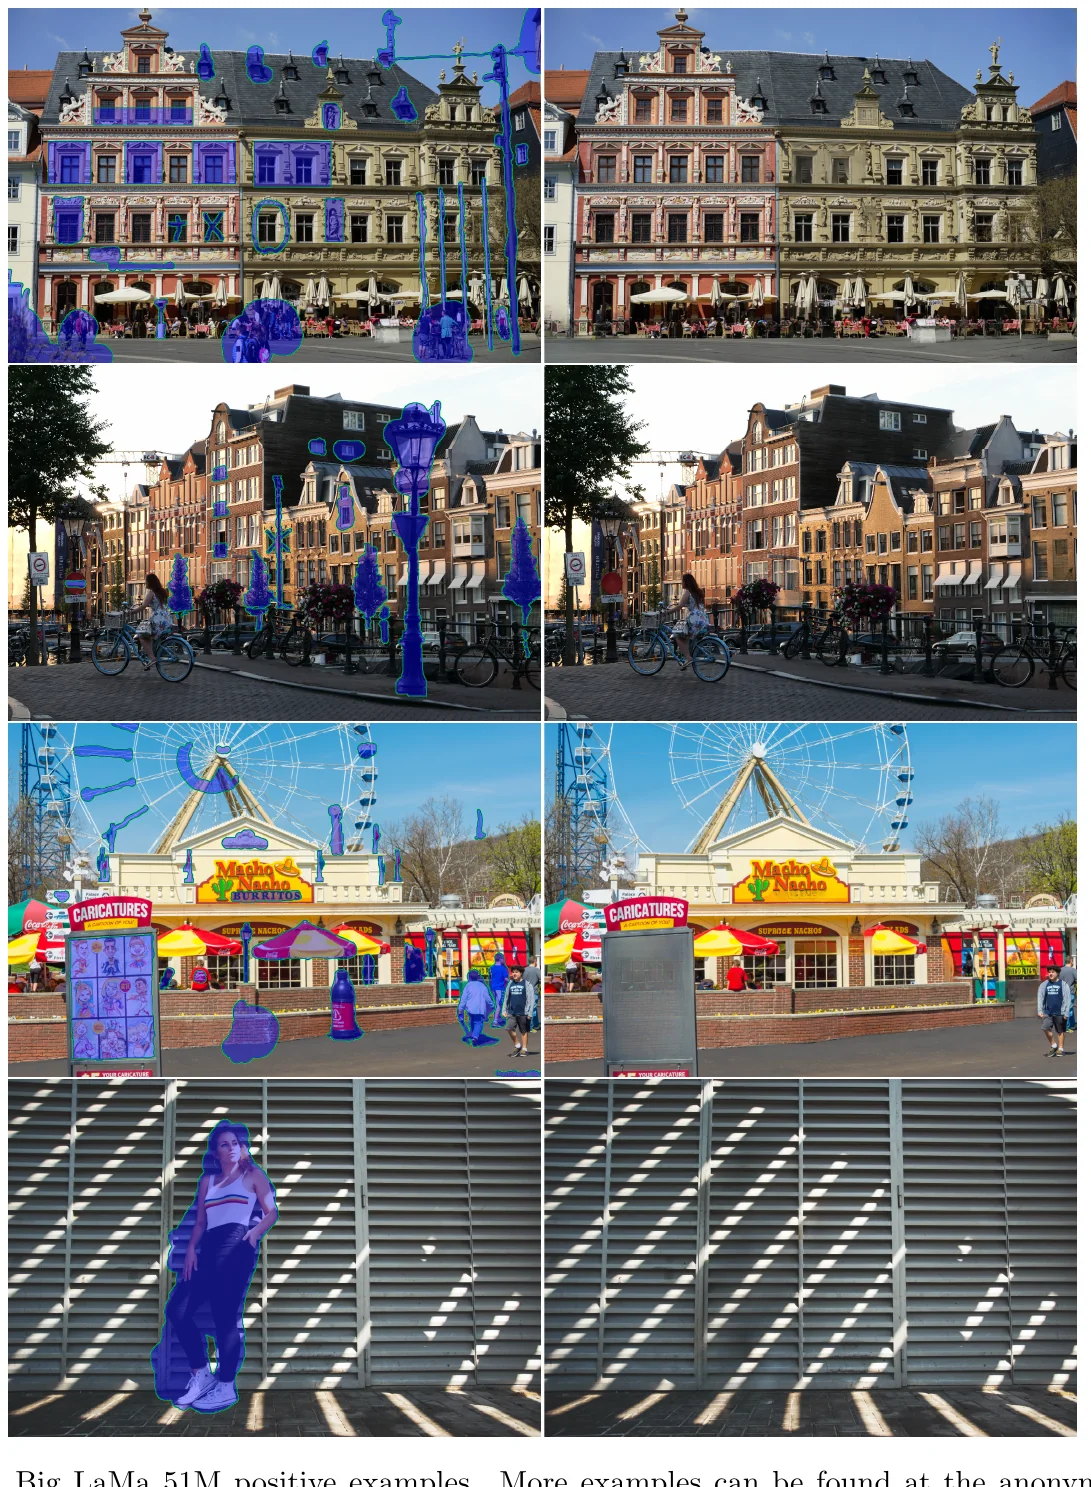
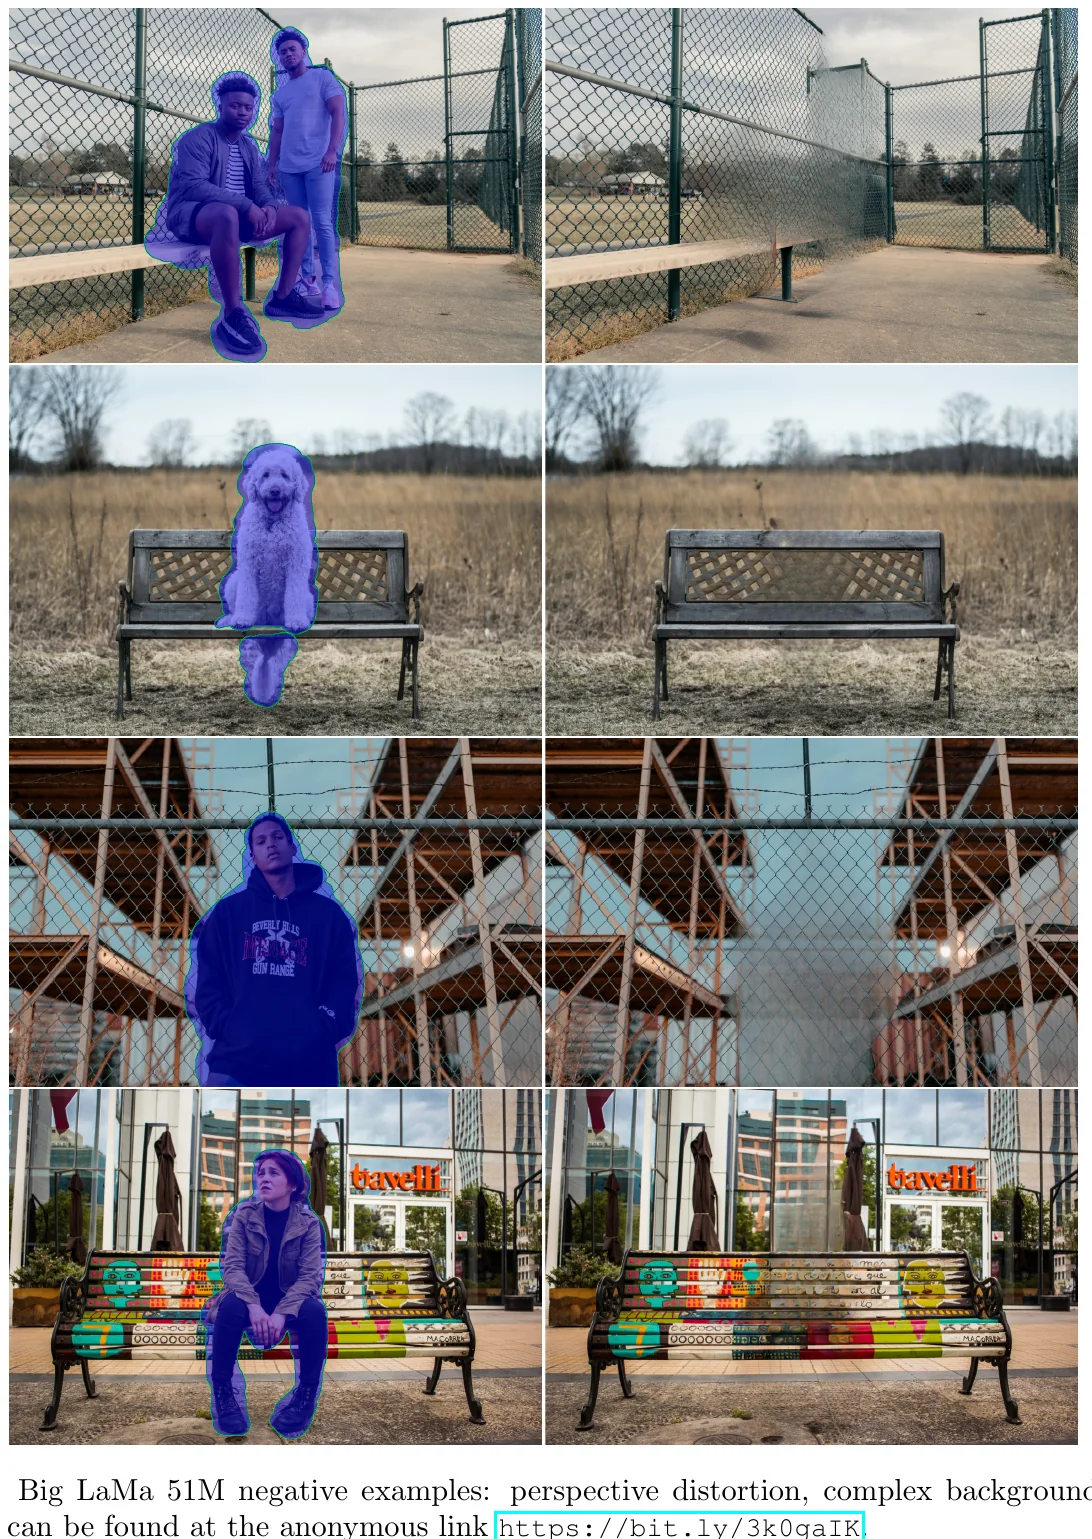
对比补充材料 Fig. 6(Big LaMa 的惊艳成功案例)与 Fig. 7(作者坦诚展示的典型失败案例),我们可以非常客观地总结出:什么时候该用 LaMa,什么时候 LaMa 会翻车?
- 最擅长的主场(Fig. 6):当被遮挡的背景是近似平行于相机平面的建筑立面、规则百叶窗、斑马线、摩天轮辐条或连续的自然地面/水面时,全局频谱峰值清晰平稳,Big LaMa 哪怕面对占画面近半的大掩码也能做到天衣无缝。
- 容易翻车的五类禁区(Fig. 7):
- 强透视收缩的非平稳周期网格(如 Fig. 7 左上角的倾斜铁丝网):因为近大远小的透视效应,铁丝网的网格频率从左到右一直在变(非平稳信号),而全局 FFT 把整张图的频率混在一起算,导致补出来的网眼大小与透视倾角接不上;
- 多层深度交错的复杂背景:当被删掉的路人背后同时叠着近处栏杆、中景立柱和远处店铺招牌时,纯 2D RGB 网络缺乏三维深度先后顺序先验,容易把不同深度层的结构揉成一团;
- 浅景深散焦光斑(Bokeh):当背景处于大光圈虚化状态时,生成器有时会在模糊背景中央补出一块过于锐利的纹理;
- 大型前景主体内部语义缺失:如果掩码盖住了半张人脸或半辆复杂的工业机械,LaMa 没有像大型扩散模型那样的生成式物体语义常识,只能靠周围颜色硬凑。
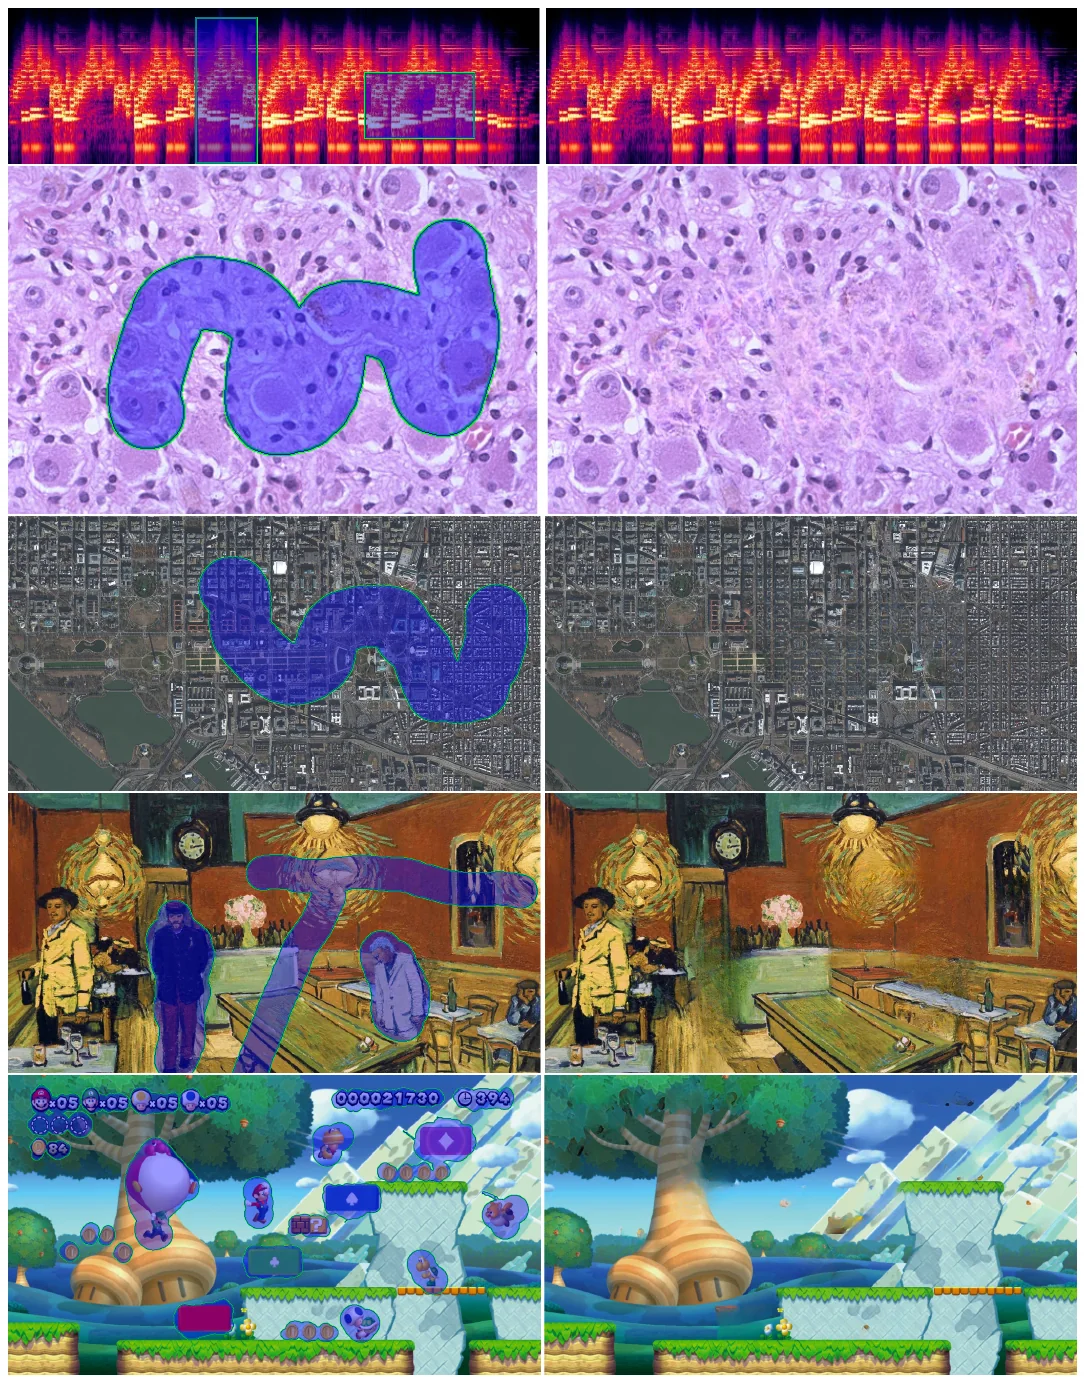
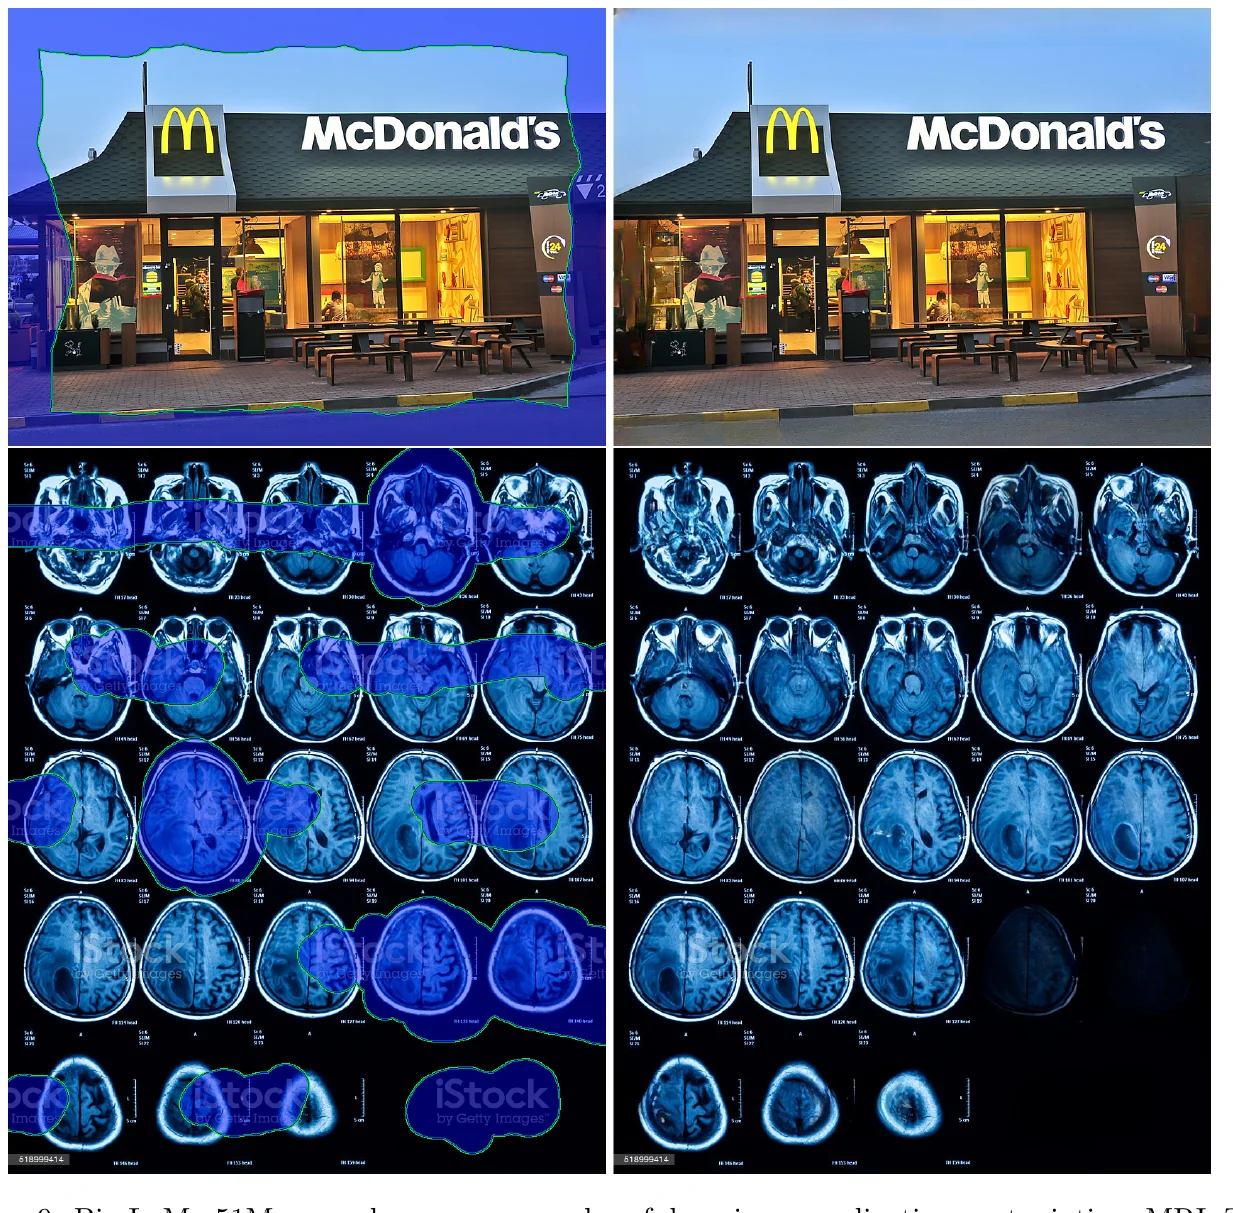
此外,补充材料 Fig. 8 与 Fig. 9 还展示了将自然场景训练的 Big LaMa 直接零样本拿去修补声谱图、组织病理切片、遥感航拍、油画、游戏画面、图像外扩(Outpainting)以及脑部 MRI 图像的有趣尝试。虽然低层纹理和频率连续性让输出画面看起来十分平滑,但在临床医学影像(MRI/病理)或司法物证等场景中,这种“看起来像真的”脑补恰恰是最危险的——它可能凭空抹掉病灶或伪造组织结构,绝不能用于定量医学诊断。
6.2 如果端侧芯片不支持 FFT 怎么办?LaMa-Dilated 替代方案与耗时拆解
在把模型部署到手机 NPU、车载芯片或特定 TensorRT/CoreML 引擎时,工程师经常遇到一个现实麻烦:很多端侧推理加速器对复数算子 rFFT2 / irFFT2 的硬件支持很差,甚至只能回退到 CPU 执行。
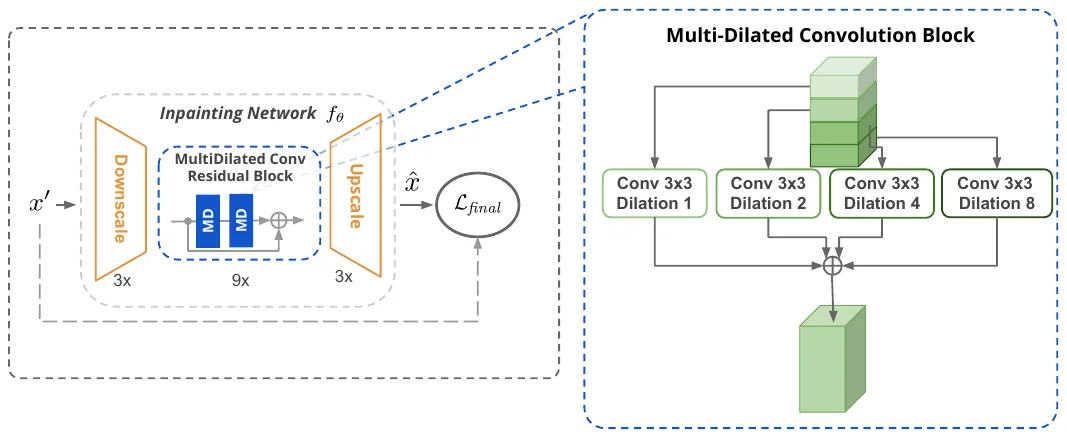
为了解决这个部署痛点,作者在补充材料 Fig. 10 中专门设计了一个纯空间卷积的替代架构 LaMa-Dilated:把每个残差块的输入通道平分为 4 组,分别通过扩张率(Dilation Rate)为 的四路 卷积核提取多尺度上下文,再求和融合。从前面 Table 2 可以看到,46M 参数的 LaMa-Dilated 在 Places Wide 上拿到了 2.30 的 FID(非常接近 LaMa-Fourier 的 2.21),且 100% 由标准空间卷积构成,端侧编译转换毫无障碍。
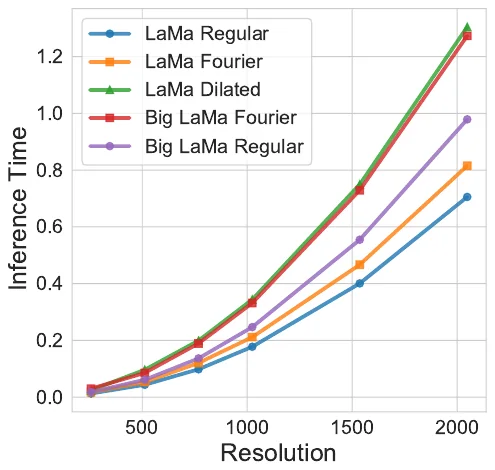
再看补充材料 Fig. 11 的实测吞吐耗时曲线(GTX 1080Ti,batch_size=100):这里打破了一个常见误区——“参数量少就一定跑得快吗?”
标准 LaMa-Fourier 的参数量(27M)虽然比普通卷积 LaMa-Regular(46M)少了整整 40%,但在实际 GPU 运行时,因为每次过 FourierUnit 都要做频域变换、实虚部内存重排与逆变换,LaMa-Fourier 的平均推理时间反而比 LaMa-Regular 慢了约 20%!不过,相比需要多阶段预测或几十步迭代去噪的扩散模型,单次前向的 LaMa 依然处在百毫秒级的极快梯队。
6.3 开源代码架构与工程落地铁律
对照官方仓库 advimman/lama@786f5936,核心代码模块与生产落地的关键注意事项可浓缩如下:
| 核心模块 | 源码路径与核心类 | 生产集成与部署铁律 |
|---|---|---|
| FFC 生成器 | saicinpainting/training/modules/ffc.py(FourierUnit, FFCResnetBlock) | 生成器包含 3 次步长为 2 的下采样,推理前必须将图像宽高以镜像填充(Reflection Padding)对齐到 8 的整数倍,前向后再裁回原尺寸 |
| 掩码预处理 | saicinpainting/training/data/masks.py / bin/predict.py | 掩码膨胀与羽化职责分离:送入模型第 4 通道的掩码必须是适度形态学膨胀(包住物体边缘阴影)后的硬边二值掩码 {0, 1};切勿把抗锯齿灰度软掩码直接喂给模型,软掩码只用于最后一步把预测像素贴回原图时的边缘 Alpha 羽化混合 |
| 高分辨率策略 | configs/training/big-lama.yaml | 严禁无脑网格切块(Tiling):切小块分别跑 FFC 会破坏全图频谱相位一致性并留下拼接缝;超大图像应采用“围绕掩码外扩充足上下文窗口(Context Crop)推理后再贴回”的策略 |
| 可选多尺度精化 | saicinpainting/evaluation/refinement.py(refine_predict) | 仓库额外提供的 refinement.py 是在测试时构建图像金字塔、用梯度下降多步迭代优化潜特征的可选后处理,耗时与显存是标准单次前向的十倍以上,仅适合离线精修导出,不应混入实时交互链路 |
7. 总结:从 LaMa 看视觉网络设计的本质
今天,当 Stable Diffusion Inpainting、Flux Fill 等百亿参数的扩散模型能够凭一句提示词在画布上凭空变出新物体时,为什么 2022 年提出的 LaMa(仅 27M / 51M 参数)依然在无数开源工具(如 IOPaint)、手机相册消除笔和工业视觉流水线中充当着不可替代的头号主力?
因为在实际工程中,90% 的“路人消除 / 杂物擦除 / 水印文字抹除”需求,核心诉求在于快速、确定、零幻觉地把周围已有的背景纹理和几何线条自然延伸过来,无需像文本引导生成模型那样凭空做天马行空的语义创造。扩散模型跑 30 步采样需要几秒钟,还冷不丁在空地上多画出一只奇怪的猫;而 LaMa 单次前馈只需几十毫秒,且严格忠于上下文信号。
更重要的是,LaMa 给视觉架构设计留下了一条永不过时的黄金准则:当你的任务需要跨越空间长距离依赖时,不要只盯着网络局部算子修修补补,必须让生成器的早期算子(FFC)、损失函数的感知视野(HRFPL)与训练数据的几何难度(Large Mask Width)三者同频共振。
参考资料
- Roman Suvorov, Elizaveta Logacheva, Anton Mashikhin, Anastasia Remizova, Arsenii Ashukha, Aleksei Silvestrov, Naejin Kong, Harshith Goka, Kiwoong Park, Victor Lempitsky, Resolution-robust Large Mask Inpainting with Fourier Convolutions, WACV 2022, pp. 2149–2159(CVF Open Access).
- 官方开源仓库:advimman/lama
- 相关核心文献:Fast Fourier Convolution (NeurIPS 2020)、Effective Receptive Field (NeurIPS 2016)、LPIPS (CVPR 2018)、DeepFillv2 (ICCV 2019)、CoModGAN (ICLR 2021)、MAT (CVPR 2022).
comments