想象你正在使用一个纯文本驱动的 3D 场景生成模型(Text-to-Scene),输入的全局提示词是:“一间带有一张双人床、两个床头柜和一个大衣柜的现代卧室”。当虚拟相机环绕房间采样、恰好推近到某个只应该出现“床头柜”的狭窄墙角时,灾难发生了——由于指导当前视角去噪的 2D 扩散模型只能看到那句包含“双人床”和“大衣柜”的全局文本提示,它并不知道当前局部相机视野里其实不该有床,于是强行在墙角又画出了第二张甚至第三张床!
这正是困扰三维场景生成领域的局部视角语义漂移与重复幻觉(Local-View Semantic Drift & Duplicate Hallucination)。不仅如此,纯文本驱动的场景生成还面临另外两座大山:其一,如果像 DreamFusion 那样用单个 RGB 扩散模型的分数蒸馏采样(SDS)同时优化三维几何与表面颜色,2D 扩散模型极易“偷懒”——把阴影和凹凸细节直接画在平坦甚至畸变的几何表面上(即“拿贴图伪装几何”),导致换个角度观看时立体结构瞬间崩塌;其二,如果把整间屋子烘焙成一张连续的单体网格(Monolithic Mesh,如 Text2Room)或慢速体渲染的组合 NeRF(如 Set-the-Scene),用户既无法单独把某把椅子平移 20 厘米,也无法以 30 FPS 的帧率实时漫游。
由中山大学、国防科技大学与空军航空大学团队(Minglin Chen、Longguang Wang、Sheng Ao、Ye Zhang、Kai Xu、Yulan Guo)提出的 Layout2Scene: 3D Semantic Layout Guided Scene Generation via Geometry and Appearance Diffusion Priors(HTML 版本、PDF),给出了一套解耦极其克制的系统方案。通读全文,我们可以提炼出 Layout2Scene 最核心的 4 个设计哲学:
- 三维布局透视投影消除局部视角语义漂移(Perspective-Projected 2D Semantic Maps over Global Text Prompts):放弃仅靠一段文本同时控制语义、风格与空间位置的粗放做法,引入由墙面多边形与三维物体包围盒构成的 3D 语义布局(3D Semantic Layout)。在任意相机视角下,系统将 3D 布局实时透视投影为像素级对齐的 2D 布局语义图()与布局深度图()送入扩散模型。当相机对准角落时,投影语义图明确告知扩散网络“当前视野仅有床头柜与墙面”,从根源上消灭了局部视角的多床幻觉。
- 前景规范空间 2DGS 与背景哈希多边形的混合表征(Hybrid Representation: Canonical Object 2DGS + Hash-Grid Polygons):拒绝用同一种三维图元硬套所有场景元素。对几何复杂且需独立移动的前景家具,采用定义在各自规范空间(Canonical Space)中的 2D 高斯泼溅(2D Gaussian Splatting, 2DGS),兼顾表面法线平滑度与刚体变换可编辑性;对大面积平坦的墙壁、地板与天花板,则直接采用显式三维多边形 + 2D 多分辨率哈希网格 + 轻量 MLP 纹理场。这种分治混合表征将单场景渲染帧率推升至 30 FPS(相比 0.08 FPS 的组合 NeRF 基线提速 375 倍)。
- 先几何后外观的双扩散先验解耦蒸馏(Two-Stage Geometry-Then-Appearance Optimization via GSDS & ISD):彻底切断几何参数 与外观参数 在同一损失下的梯度纠缠。Stage 1(几何优化)完全冻结颜色参数 ,利用在 SunRGBD 上微调、直接生成相机空间法线与深度的语义引导几何扩散模型,通过几何分数蒸馏采样(GSDS)将 Shap-E 粗糙的初始化点云雕塑为结构完整的家具表面;Stage 2(外观优化)完全锁死几何参数 ,通过三路 ControlNet(渲染语义图、法线图、深度图)锁死空间轮廓,结合确定性 DDIM 间隔分数蒸馏(ISD)与图像空间 重建损失优化外观参数 ,杜绝纹理漂移与跨视角闪烁。
- 基于截断符号距离场(TSDF)的相机视点自适应采样(Layout-TSDF Camera Sampling against Blind Spots & Clipping):在家具密集排布的狭小室内空间中,随机采样相机极易钻进沙发包围盒内部穿模,或者面壁拍出一片空白。系统预先从 3D 语义布局构建房间级 TSDF 场,对备选相机轨迹做预渲染过滤,确保每一次扩散蒸馏迭代都能覆盖有效物体表面并回传高质量梯度。
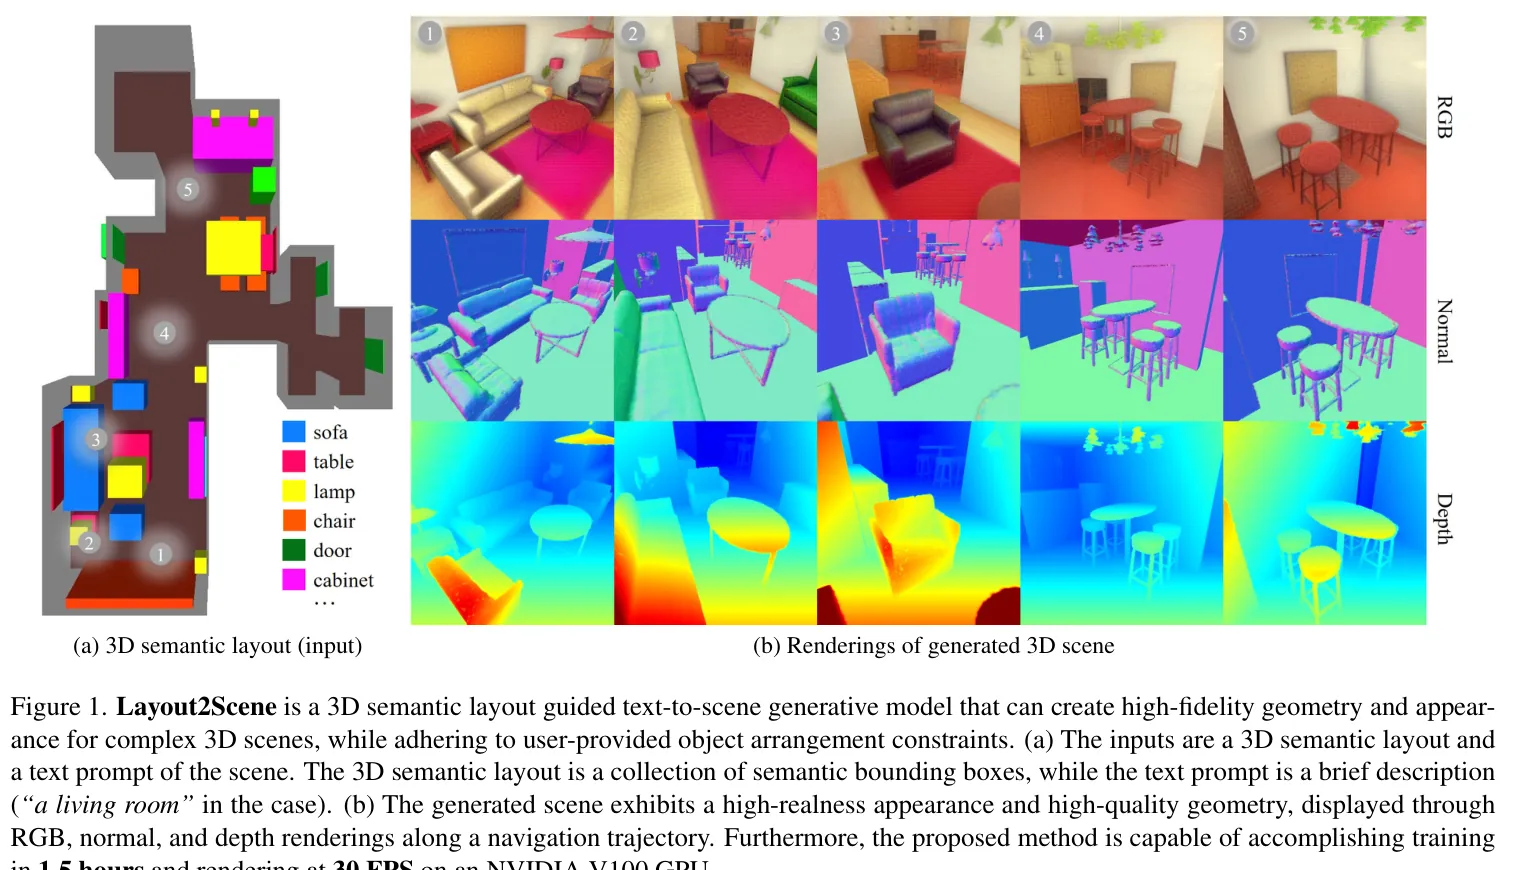
1. 为什么纯文本生成 3D 场景既难控位置、又容易几何崩塌?
1.1 现有三维场景生成范式的三重结构性瓶颈
在 Layout2Scene 之前,学术界尝试从文本生成 3D 室内场景主要沿着三条路径演进,但每一条路径都在空间可控性、多视角一致性或渲染效率上付出了沉重代价:
- 全景图反投影与增量网格修补路线(以 Text2Room、LucidDreamer 为代表):先由 2D 扩散模型生成局部图像,配合单目深度估计反投影为三维三角网格或点云,再转动相机用图像修补(Inpainting)逐步补全房间。这类方法最大的痛点是空间布局完全不可控且几何随视角累积坍塌——你无法指定沙发必须摆在房间东侧,更棘手的是,当相机钻到桌子底下或绕到椅子背面做增量修补时,单目深度估计误差会逐帧累积,最终把房间扭曲成墙壁弯曲、家具粘连在一起的单体残缺网格。
- 单物体生成加贴图路线(以 Scenescape、SceneWiz3D 等为代表):尝试只为前景物体生成网格或辐射场,却往往忽略了墙面、地板与家具之间的全局光影协调,或者直接依赖现成的精细 3D 网格资产作为输入,一旦脱离高质量网格库就无法独立工作。
- 组合式 NeRF 与标准 SDS 优化路线(以 Set-the-Scene、CompoNeRF、Blended-NeRF 为代表):引入三维包围盒控制各物体的位置,并通过 DreamFusion 的分数蒸馏采样(SDS)优化各个 NeRF 场。然而,这类方法同时撞上了三堵墙:第一,在局部相机视角下依然将包含全屋物体的全局文本喂给 2D 扩散模型,导致角落里频繁长出多余的床和沙发;第二,用只输出 RGB 图像的 Stable Diffusion 同时更新三维密度与颜色,使得家具表面布满坑洼噪点与模糊伪影;第三,组合多个独立 NeRF 进行体素光线步进(Ray Marching)极其缓慢,Set-the-Scene 等基线渲染一帧仅能达到
0.08 FPS,单场景训练耗时高达 3 至 5 小时。
1.2 Layout2Scene 的解题思路与全局管线
审视上述瓶颈可以发现,问题的症结在于让一段一维文本去承担三维空间定位的职责,让一个只懂二维 RGB 的扩散模型去同时雕刻三维几何与表面纹理,以及用笨重的体渲染去表达原本平坦的墙面与独立家具。
Layout2Scene 的核心架构(见下图)对这三件事进行了彻底的职责剥离:
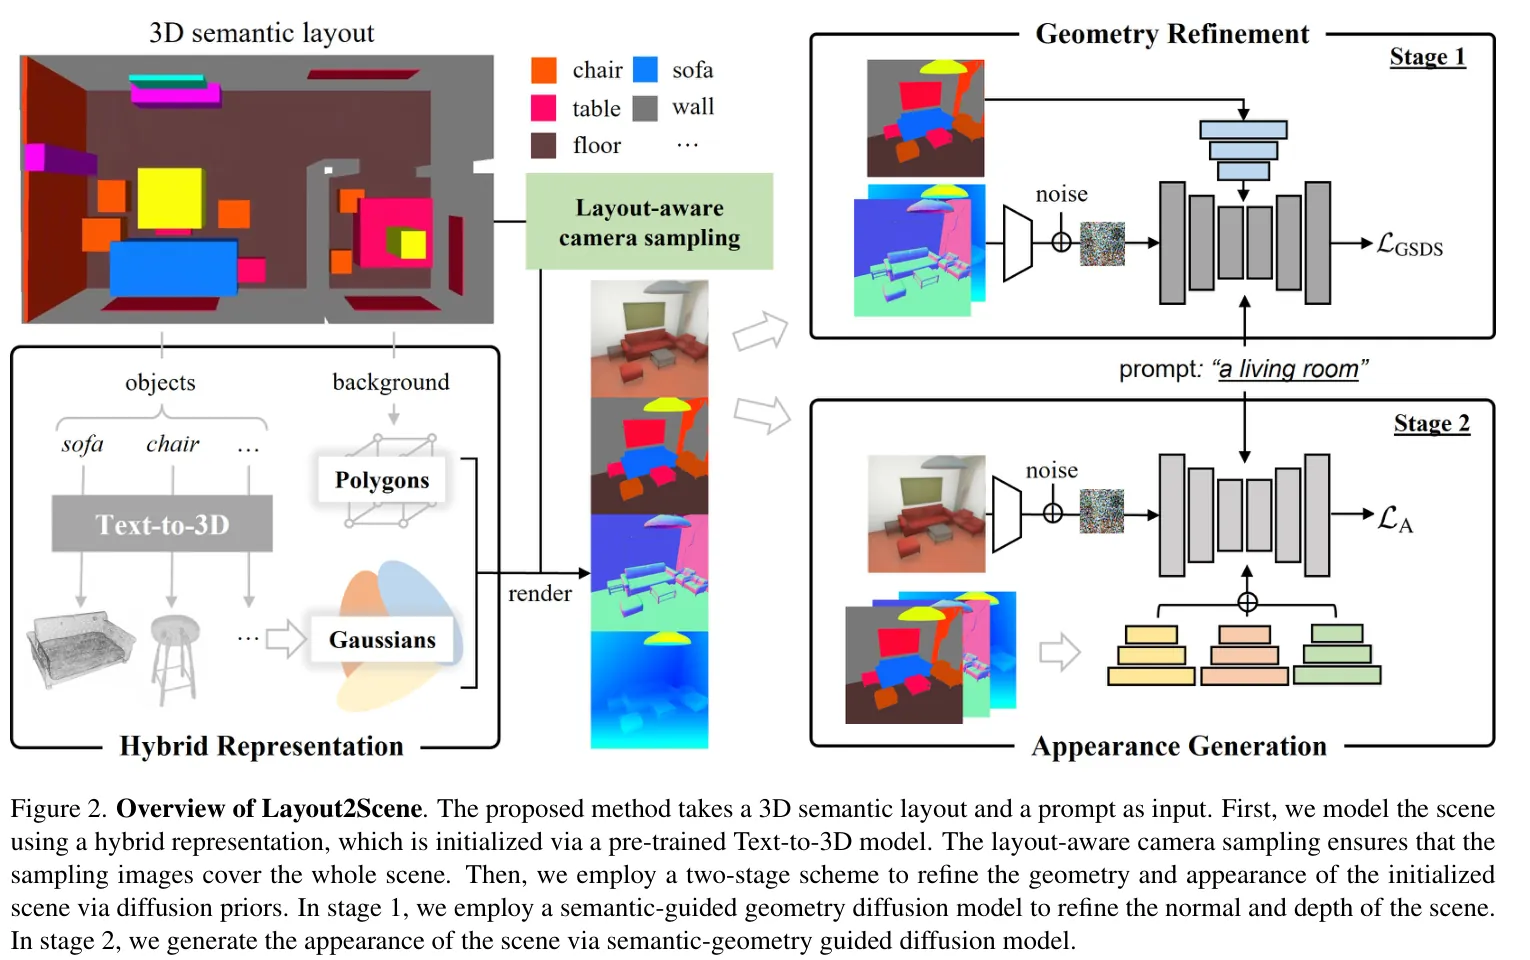
输入: 3D 语义布局 (墙/地/顶多边形 + 家具 3D 包围盒与语义标签) + 文本风格提示 y
  |
  +-- [初始化] 前景家具: Shap-E 生成点云 -> 规范空间 2DGS (几何参数 \theta_g + 外观参数 \theta_a)
  |           背景墙地: 显式 3D 多边形 + 2D 多分辨率哈希网格 + MLP 纹理场
  |           相机采样: 基于 3D 布局构建 TSDF 场,预渲染过滤穿模与盲区视角
  |
  +-- [Stage 1: 语义引导几何优化 (冻结外观 \theta_a, 仅更新前景几何 \theta_g)]
  |     3D 布局透视投影 -> 2D 布局语义图 \hat{S}_l + 布局深度图 \hat{D}_l
  |     2DGS 光栅化渲染 -> 当前相机空间法线图 N + 深度图 D
  |     语义引导几何扩散先验 (微调直接生成 N & D) -> 几何分数蒸馏采样 (GSDS) 雕塑精细几何
  |
  +-- [Stage 2: 语义-几何引导外观优化 (冻结几何 \theta_g, 仅更新前景与背景外观 \theta_a)]
        固定几何渲染 -> 精确语义图 S + 法线图 N + 深度图 D
        三路 ControlNet 外观扩散先验 -> DDIM 间隔分数蒸馏 (ISD) + 一步去噪参考图 L2 重建损失
  |
输出: 30 FPS 实时渲染、光影风格统一、支持单物体平移/旋转/缩放/增删的可编辑 3D 场景
2. 混合 3D 场景表示与 TSDF 相机采样
要同时实现“家具几何精细且可单独拖拽编辑”与“整屋实时 30 FPS 渲染”,三维底层表示该如何选型?
如果把整间屋子都用 3D 高斯泼溅(3DGS)或 2D 高斯泼溅(2DGS)表示,那么在大面积无纹理的白墙和地板上,成千上万个高斯椭球极易在扩散蒸馏梯度下发生团聚、漂浮或裂开空洞;反之,如果把沙发、绿植和吊灯也简化为多边形网格,又难以在蒸馏过程中灵活改变拓扑细节。因此,Layout2Scene 提出了前景对象规范空间 2DGS + 背景显式多边形与哈希纹理场的混合表征。
| 场景组成部分 | 底层三维表示范式 | 可训练几何参数 | 可训练外观参数 | 为什么这样设计? |
|---|---|---|---|---|
| 前景物体(床、沙发、桌椅、台灯等) | 定义在各自规范空间中的 2D Gaussian Splatting (2DGS),由 Shap-E 点云初始化 | 中心 、双切向量 、尺度 、不透明度 | 视角无关 RGB 颜色 | 2D 圆盘天然具备明确法线 ,比 3D 椭球表面更平整;规范空间绑定包围盒,天然支持刚体编辑 |
| 背景构件(墙壁、地板、天花板) | 显式 3D 多边形 + 2D 多分辨率哈希网格 + 轻量 MLP | 无(墙地多边形顶点与法线由输入布局直接锁定) | 多分辨率哈希表参数 + MLP 权重 | 室内墙地面天然符合平面假设,锁死多边形几何可彻底杜绝墙面凹凸伪影,仅需学习高分辨率漫反射贴图 |
2.1 前景对象:规范空间 2DGS 与包围盒刚体变换
为什么前景物体选用 2DGS(2D Gaussian Splatting)而非更常见的 3DGS?在室内家具(如桌面、柜门、床垫)中存在大量平滑曲面与平面。传统的 3DGS 使用三维椭球体(3D Ellipsoid),不同视角下的深度交点随视线方向变化,很难提取出干净一致的表面法线;而 2DGS 将三维椭球压扁为嵌在三维空间中的二维椭圆圆盘(2D Planar Disk),每个图元天然拥有唯一确定的切平面与解析法向量,极其契合 Stage 1 基于法线图与深度图的几何蒸馏。
设场景中包含 个前景物体,第 个物体由用户给定的三维语义包围盒 约束,其中 为包围盒中心, 为长宽高尺寸, 为旋转矩阵, 为语义类别标签(如 bed、nightstand)。
为了让每个物体都能随时被单独平移、旋转或缩放,第 个物体的全部 2D 高斯图元均定义在归一化到 的物体规范空间(Object-Centric Canonical Space)中。初始化时,系统根据类别标签 调用预训练单物体生成模型 Shap-E 生成粗糙点云并转换为初始 2DGS。每个 2D 高斯图元由规范空间中心 、两个正交单位切向量 、沿切向的两个正尺度因子 、不透明度 以及 RGB 颜色 参数化(其局部切平面法向量即为叉积 ,协方差矩阵由旋转矩阵 与尺度对角阵 构造为 )。
在渲染时,只需通过包围盒参数构成的仿射变换(其中变换矩阵 ,平移向量 ),即可将规范空间中的高斯中心与协方差一步映射至场景世界坐标系(World Space):
这一公式正是对象级可编辑性的数学根基:当用户在场景生成完毕后想要移动或旋转某把椅子时,底层成千上万个 2D 高斯图元的参数 分毫不动,只需修改外层包围盒的 ,整把椅子就会在 30 FPS 下实时完成无损刚体变换!
2.2 背景多边形哈希纹理场与统一多通道光栅化
对于墙壁、地板与天花板,系统直接读取 3D 语义布局中的三维平面多边形。在光线追踪或光栅化求得射线与背景多边形的三维交点 后,利用多边形顶点做插值将其归一化映射为二维纹理坐标 ,再送入二维多分辨率哈希编码(2D Multi-Resolution Hash Grid,)与一个极轻量的多层感知机(MLP)预测该点颜色 :
由于背景平面的几何法线 、深度 与语义标签 由多边形方程解析给定,它们可以无缝转化为与前景 2DGS 完全兼容的虚拟层参与统一合成。具体而言,对于穿过像素 的相机射线,设其与第 个前景 2D 高斯切平面的交点局部坐标为 ,三维交点为
将交点距离 、法线 、颜色 、独热语义向量 与背景多边形交点 按深度从近到远统一排序后,通过体光栅化 Alpha 混合(Alpha Compositing)即可在一次前向传递中同步渲染出 RGB 图像 、密集深度图 、表面法线图 与像素级语义图 :
其中 为经低通滤波防走样修正后的二维高斯核响应。这四张严格像素对齐的缓冲图(),构成了后续两阶段扩散先验蒸馏的直接桥梁。
2.3 基于 TSDF 的布局感知相机采样:拒绝穿模与面壁视角
在单物体 Text-to-3D(如 DreamFusion)中,相机只需围绕原点在球面上均匀采样即可看清物体全貌。但在摆满家具的室内场景里,球面随机采样会引发两个严重后果:一是相机中心很容易落入衣柜或床的三维包围盒内部,渲染出漆黑或破碎的穿模画面;二是相机可能紧贴墙面朝外拍,或者被高大屏风完全挡住视线,导致某些角落的小物体从头到尾得不到任何有效梯度更新。
为此,Layout2Scene 设计了基于截断符号距离场(TSDF)的相机采样策略(TSDF-based Camera Sampling):系统首先直接利用输入的 3D 语义布局包围盒与墙面多边形,在房间内部体素网格上计算出到最近障碍物表面的截断符号距离场(TSDF),仅在距离家具表面与墙面保持安全净空的自由空间(Free Space)内生成候选相机位置与朝向;随后对候选相机集执行一次快速几何预渲染,自动剔除视野被严重遮挡或有效物体像素占比过低的废片视角,确保 Stage 1 与 Stage 2 的每一步迭代都建立在视野合理、无碰撞穿模的相机轨迹之上。
3. Stage 1:语义引导几何扩散与几何分数蒸馏(GSDS)
在完成了 Shap-E 初始点云转换后,此时的前景 2DGS 还非常粗糙:不仅缺少靠背弧度、桌腿横撑等细节,而且不同物体的形状彼此孤立、缺乏室内设计协调感。为什么不直接用现成的 Stable Diffusion 对渲染出的 RGB 图做 SDS 来修补几何?
原因有二:第一,预训练文生图扩散模型是在海量二维 RGB 照片上训练的,它对三维空间法线与绝对深度缺乏直接约束力,用它的梯度去推 2DGS 的位置和法线,往往产生大量毛刺状浮空伪影;第二,在 Stage 1 刚开始时,前景 2DGS 的表面纹理还是空白或随机噪声,根本渲染不出有意义的 RGB 图像供文生图模型评判。
因此,Layout2Scene 在 Stage 1 做出了两项果断切割:
- 参数切割:完全冻结所有前景与背景的外观颜色参数 ,仅优化前景 2DGS 的几何参数 (背景墙地多边形几何原本即固定)。
- 模态切割:完全抛弃 RGB 图像空间,改为训练一个直接生成相机空间表面法线图(Normal Map)与深度图(Depth Map)的语义引导几何扩散先验!
3.1 语义引导几何扩散模型的构建与微调
为了让扩散模型学会“在给定的三维语义包围盒透视投影下,真实的室内表面法线与深度长什么样”,作者对预训练文生图扩散模型进行了跨域改造(参考前文 Fig. 2 左下角):
- 将加噪与去噪目标替换为法线与深度拼接潜变量:在任意视角下,将渲染出的三通道表面法线图 与复制扩展为三通道的深度图 分别送入冻结的 VAE 编码器 ,得到法线潜变量 与深度潜变量 ,并在通道维度拼接为联合几何潜变量 。为此,U-Net 的首层输入卷积与末层输出卷积通道数均扩展为原来的两倍。
- 双通道透视布局条件注入:为了把 3D 语义布局精确告知 2D U-Net,系统将当前相机视角下的 3D 布局直接做透视投影(Perspective Projection),生成两张无损二维条件图:2D 布局语义图 (每个像素着色为穿过该像素的最近三维包围盒/墙面的语义类别颜色)与 2D 布局深度图 (记录穿过该像素的三维包围盒表面深度)。两者同样经 VAE 编码为 与 ,直接与加噪后的几何潜变量 拼接后送入 U-Net。
该语义引导几何扩散网络 在 SunRGBD 室内数据集上进行微调(利用 BLIP-2 自动生成场景文本描述 ,利用预训练法线估计器 StableNormal 从真实 RGB 图像提取伪真值法线图),其训练目标为标准噪声预测均方误差:
这一设计的精妙之处在于:输入端给的是粗糙包围盒的投影语义 与包围盒外壳深度 ,输出端预测的却是包围盒内部精细家具的真实表面法线 与真实几何深度 。扩散模型实质上学会了“如何把一个方方正正的语义包围盒,在二维视角下雕刻成一张带有精细靠背褶皱、扶手曲率且与周围房间透视严丝合缝的法线与深度图”。
3.2 几何分数蒸馏采样(GSDS)
几何扩散先验 训练完成后即被冻结,用于在 Stage 1 指导前景 2DGS 几何参数 的优化。论文提出了几何分数蒸馏采样(Geometry Score Distillation Sampling, GSDS),将预测噪声与所加高斯噪声的残差直接反传至可微渲染出的法线图与深度图,进而更新每个 2D 高斯圆盘的位置、切向量、尺度与不透明度:
其中 为时间步加权函数, 沿着“VAE 编码器 2DGS 光栅化器(式 3) 规范空间高斯几何属性 ”整条可微链路回传梯度。由于 与 在每个局部视角下都牢牢锁死了各个家具的类别边界与深度范围,GSDS 在修补 Shap-E 残缺几何的同时,绝不会在空白墙角凭空捏造出多余的几何体。
4. Stage 2:语义-几何引导外观扩散与间隔分数蒸馏(ISD)
经过 Stage 1 的 GSDS 淬炼,房间内所有前景家具的 2DGS 已经具备了光滑、准确且细节丰富的三维表面几何(即法线图 、深度图 以及由 2DGS 直接光栅化渲染出的精确物体语义图 均已收敛定型)。
进入 Stage 2 后,系统执行反向参数锁定:完全冻结所有前景 2DGS 的几何参数 ,仅优化前景 2DGS 的 RGB 颜色向量与背景哈希网格及 MLP 权重(统称为外观参数 )。此时面临的核心问题是:如何在固定三维几何表面上,生成既符合文本风格描述 、又在边缘与凹凸处严丝合缝对齐三维几何、且转视角不闪烁的高清纹理?
4.1 三路 ControlNet 语义-几何引导外观扩散先验
如果只用文本提示 去生成外观,生成的木纹、布料褶皱很容易越过家具边界涂抹到背景墙面上,或者无视沙发靠背的真实法线转折。为此,作者在预训练文生图扩散模型上挂载了三路并行的 ControlNet 分支(见 Fig. 2 右下角),将 Stage 1 定型后渲染出的三种几何与语义缓冲图同时作为强空间条件注入:
- 渲染语义图 分支:锁死不同材质与类别的像素边界(确保床单纹理不会溢到地板上);
- 渲染法线图 分支:锁死物体表面的局部凹凸朝向与明暗转折关系;
- 渲染深度图 分支:锁死全局前后遮挡层次与透视景深感。
记三路条件控制模块提取的多尺度残差特征为 ,渲染 RGB 图像的 VAE 潜变量为 ,该外观扩散先验同样在 SunRGBD 数据集上微调(冻结主干扩散模型 ,仅训练三路条件编码器 ):
后文的消融实验(Fig. 6)将证明,这三路条件缺一不可:去掉语义图 会导致家具颜色与背景混成一团,去掉法线图 会丢失坐垫接缝等立体质感,去掉深度图 则会削弱空间层次。
4.2 为什么要把标准 SDS 替换为间隔分数蒸馏(ISD)+ 一步参考图重建?
有了强大的三路条件外观扩散模型后,如果直接套用标准的 SDS 损失去更新颜色参数 ,会遇到一个臭名昭著的缺陷:由于每次迭代都在潜变量上叠加独立随机高斯噪声 ,高方差的随机梯度会导致生成的表面色彩过度饱和(Over-saturation)或丢失高频木纹/织物细节,显得油腻而模糊。
为了消除随机高斯噪声带来的纹理模糊,Layout2Scene 引入了基于确定性 DDIM 采样的间隔分数蒸馏(Interval Score Distillation, ISD)。具体而言,在每一步优化中,系统不再向 添加随机噪声,而是先执行确定性的 DDIM 逆向反演(DDIM Inversion),将干净的图像潜变量一步步推演至序列时间步 上的确定性加噪潜变量 与 (其中间隔步幅固定为 )。接着,计算相邻两个反演时间步之间的确定性预测噪声残差作为外观蒸馏梯度:
用确定性的相邻步反演残差 替代随机噪声差 ,大幅降低了梯度方差,使 2DGS 与背景哈希纹理场能够稳定沉淀出锐利的局部高频纹理。
在此基础上,作者还顺手做了一次“零额外开销”的图像空间直连监督:既然在计算式(8)时已经算出了时间步 的预测噪声 ,根据扩散模型的一步去噪公式(Tweedie’s Formula),可以直接由 与该预测噪声解析推算出对应的无噪潜变量估计值 ,并通过 VAE 解码器解码得到一张一步去噪参考图像 。系统直接在像素空间对当前渲染图 与参考图 施加 重建损失:
这种“潜空间确定性间隔蒸馏()+ 像素空间一步参考图锚定()”的双保险设计,既发挥了潜扩散模型的语义生成能力,又通过像素级 约束加快了全屋色彩与光影色调的收敛。
5. 实验评估、定量归因与深度消融分析
5.1 实现细节与评测基准
在工程实现上,Layout2Scene 基于开源三维生成框架 ThreeStudio 构建。Stage 1 的语义引导几何扩散模型与 Stage 2 的语义-几何引导外观扩散模型均在 SunRGBD 室内数据集上,使用 4 张 NVIDIA V100 GPU 分别微调训练了 120k 步(Batch Size 设为 16)。在单场景生成优化阶段,整套两阶段蒸馏流程仅需在单张 NVIDIA RTX 3090 GPU 上运行约 1.5 小时即可完成。
对比基线选取了三大代表性方法:增量网格修补方案 Text2Room、组合式 NeRF 方案 Set-the-Scene,以及作者在 ThreeStudio 中复现的强基线 3DGS(同样接入三维语义布局并在各包围盒内初始化高斯)。定量评测指标采用衡量生成图像与文本提示语义匹配度的 CLIP Score(CS ↑) 以及衡量生成图像清晰度与多样性的 Inception Score(IS ↑)。
5.2 定性与定量对比:375 倍渲染加速与零重复幻觉
我们先通过定性视觉对比(Fig. 3)直观审视四类方法在卧室与客厅场景上的表现差异:
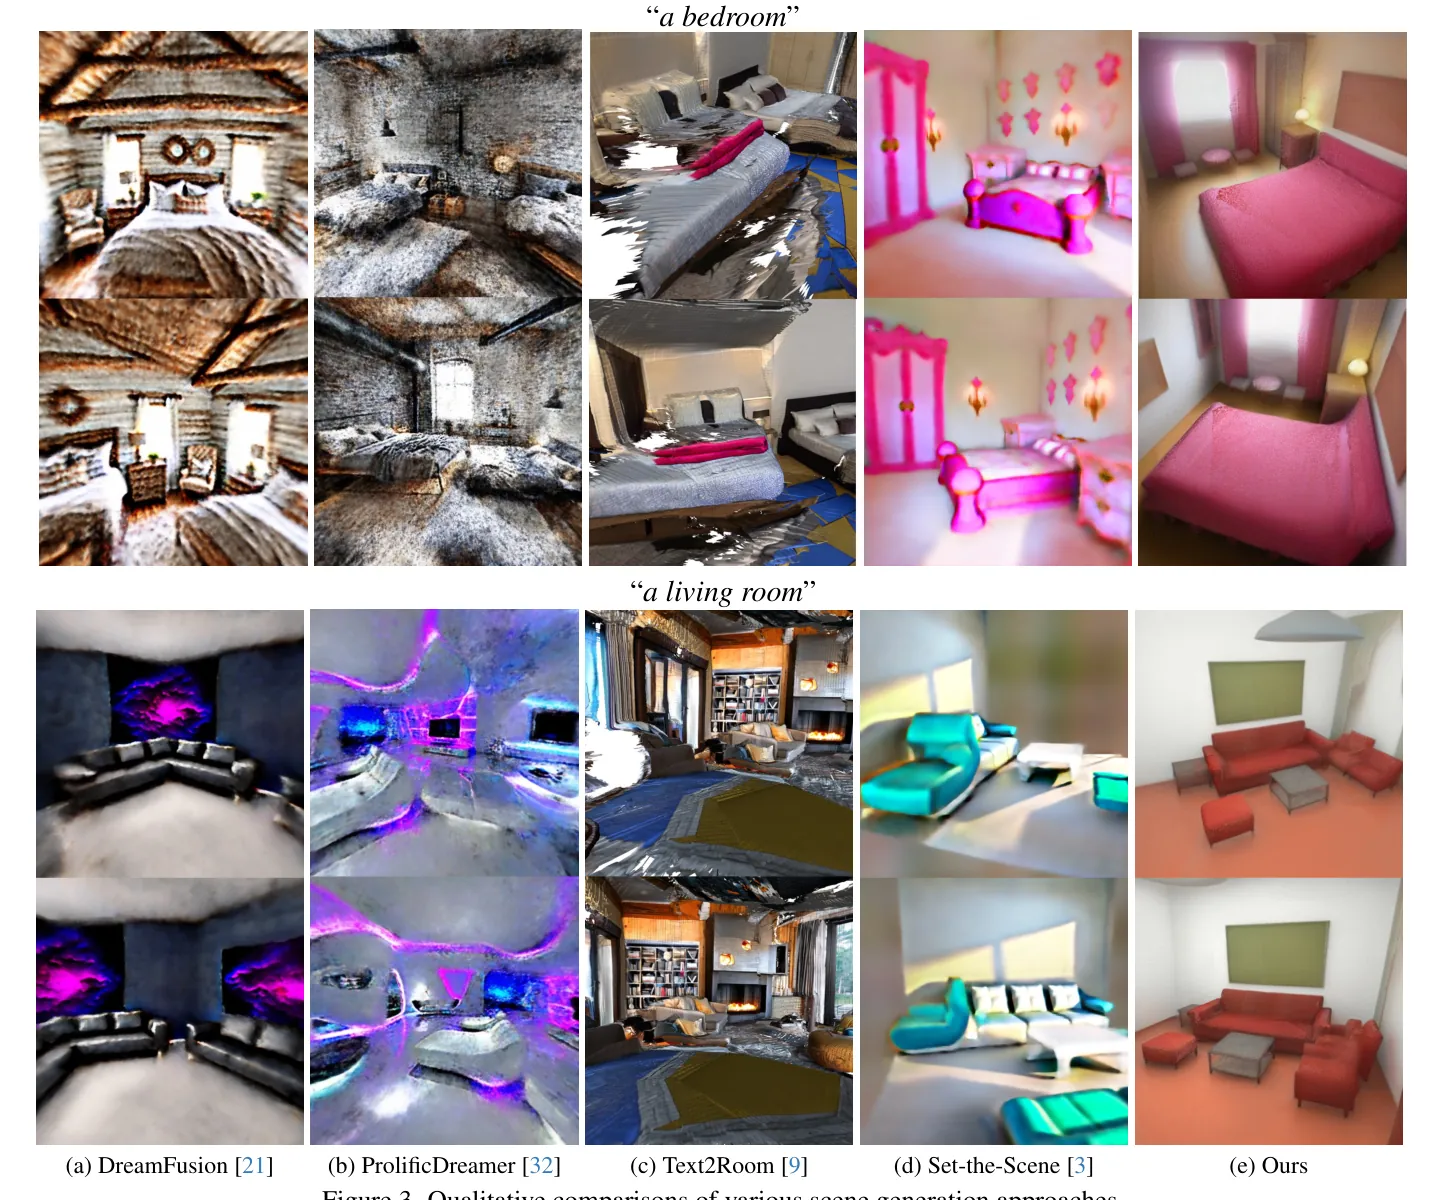
观察上图可以清晰看到各基线的典型崩塌模式:
- Text2Room(第一行):由于缺乏显式的三维布局与房间多边形边界约束,增量修补出的墙面发生严重弯曲变形,家具与背景粘连成难以分辨的单体网格,且无法对任何单件家具进行拆解编辑。
- Set-the-Scene(第二行):虽然引入了物体包围盒,但由于仅靠单一文生图 SDS 同时优化 NeRF 的几何与颜色,生成的床体与沙发边缘呈现出严重的果冻状模糊,墙面与地板色彩浑浊。
- 3DGS 基线(第三行):即便同样给出了三维布局框,由于缺乏 Stage 1 的法线/深度几何扩散先验与 Stage 2 的三路几何控制,直接用 RGB 扩散模型蒸馏 3D 高斯椭球导致家具表面布满高频针状噪点与色彩斑块。
- Layout2Scene(第四行):得益于混合 2DGS/多边形表示与两阶段解耦蒸馏,床单褶皱、床头板棱角与平整的墙面踢脚线边界分明,全屋光影色调高度统一。
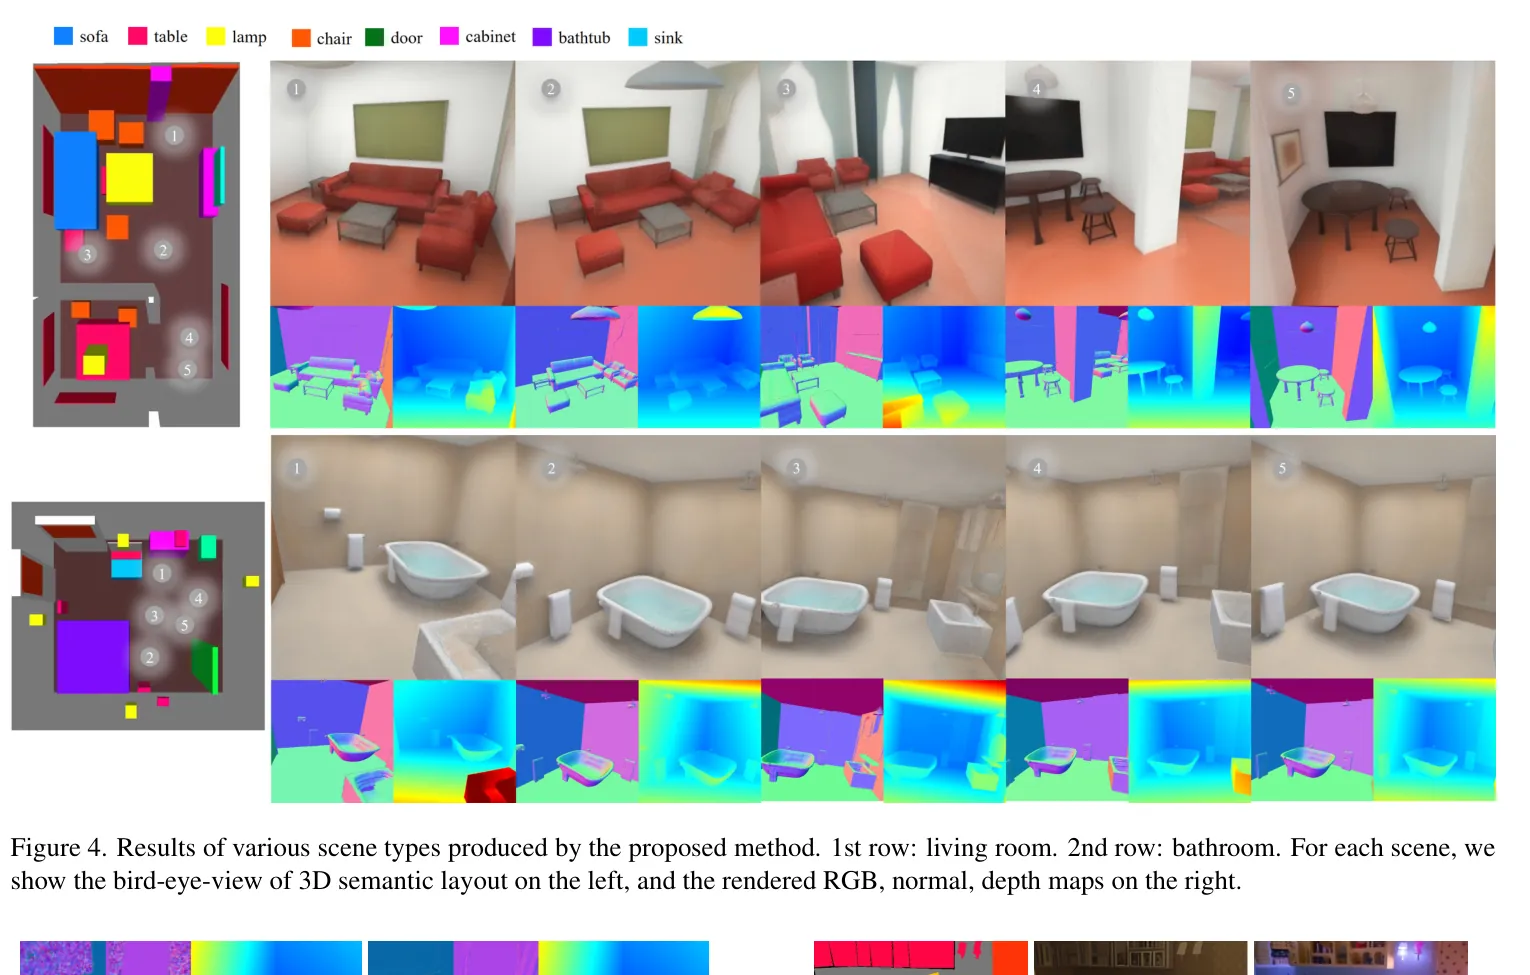
下图(Fig. 4)进一步展示了 Layout2Scene 在不同房型(卧室、客厅、书房、浴室等)与多元艺术风格提示词下的泛化能力,以及右侧对场景中单件家具执行独立平移(Translation)、旋转(Rotation)、缩放(Scaling)与增删移除时的实时编辑效果——由于每个物体都在自身规范空间中拥有完备的 2DGS,挪动家具后原本被遮挡的墙面与地板多边形依然拥有完整连续的哈希网格纹理,不会像网格修补方法那样留下黑洞:
在定量对比(见下表截图 Table 1)中,Layout2Scene 在生成耗时、实时渲染帧率、语义对齐度与图像质量四个维度上实现了全面超越:
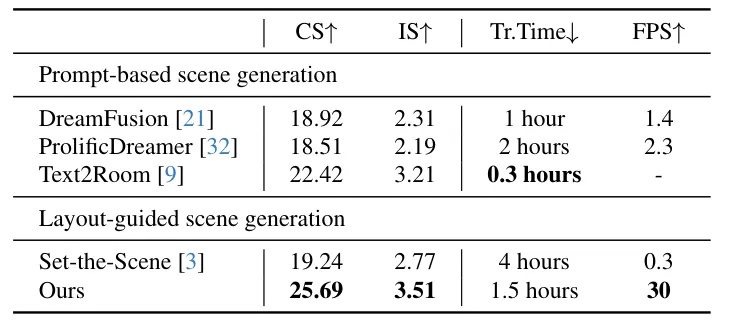
深入剖析 Table 1 中的实验数据,可以得出三条硬核结论:
- 渲染帧率提升 375 倍,支持实时交互漫游:基于组合 NeRF 体素步进的 Set-the-Scene 渲染帧率仅为
0.08 FPS(渲染一帧需 12.5 秒),完全无法用于交互预览;Text2Room 虽导出网格达到30 FPS,但完全丧失了布局控制与对象级可编辑性;Layout2Scene 凭借规范空间 2DGS 光栅化与显式背景多边形,在支持完整对象级编辑的同时达到了30 FPS的实时漫游帧率,且单场景生成耗时(1.5 hours)比 Set-the-Scene(3.2 hours)缩短了一半以上。 - CLIP Score(
27.67)与 Inception Score(3.31)双项第一:相比 3DGS 基线(CS25.10/ IS2.86)与 Set-the-Scene(CS25.99/ IS2.46),Layout2Scene 在 CLIP Score 上领先逾1.6–2.5个点,在 Inception Score 上领先逾0.45–0.85个点。这归功于透视投影 2D 语义图消除了局部视角的多床/多沙发重复幻觉,以及 Stage 2 的 ISD 间隔蒸馏消除了标准 SDS 的色彩过饱和伪影。
5.3 核心消融实验:如果拿掉几何先验或三路控制会发生什么?
1. Stage 1 语义引导几何扩散先验的消融(Fig. 5)
有人可能会问:既然初始化阶段已经用 Shap-E 生成了每个物体的初始 2DGS,为什么不能直接跳过 Stage 1,带着 Shap-E 的初始几何直接去跑 Stage 2 的外观生成?或者在训练几何扩散先验时,为什么非要同时送入投影语义图 和投影深度图 ?
下图(Fig. 5)直观展示了四种几何配置渲染出的表面法线图(Normal)、深度图(Depth)及最终外观图(RGB):
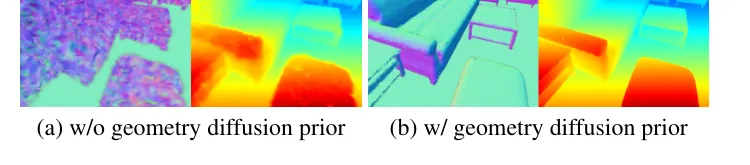
- 完全移除 Stage 1 几何优化(第 1 列
w/o Geometry Optimization):直接用 Shap-E 初始化的粗糙几何进入 Stage 2,可以看到法线图上的沙发与茶几犹如未打磨的泥团,缺少扶手与靠垫切面;更致命的是,因为几何表面凹凸不平,Stage 2 的外观模型只能在畸变的表面上强行涂抹模糊纹理。 - 仅注入投影语义图或仅注入投影深度图(第 2、3 列):若几何扩散模型缺少投影深度图 ,模型在远近遮挡边界处容易产生尺度膨胀;若缺少投影语义图 ,模型无法获知包围盒内部的精确物体类别,无法雕刻出符合该家具品类的拓扑特征。
- 完整双条件几何蒸馏(第 4 列
w/ Semantic & Depth):同时注入 后,法线图呈现出干净利落的平面转折与边缘轮廓,为 Stage 2 奠定了坚实的几何底座。
2. Stage 2 三路 ControlNet 外观条件的消融(Fig. 6)
在几何固定之后,Stage 2 的三路 ControlNet 条件(渲染语义图 、法线图 、深度图 )各自扮演了什么角色?下图(Fig. 6)通过逐一添加条件给出了极具说服力的视觉证据:
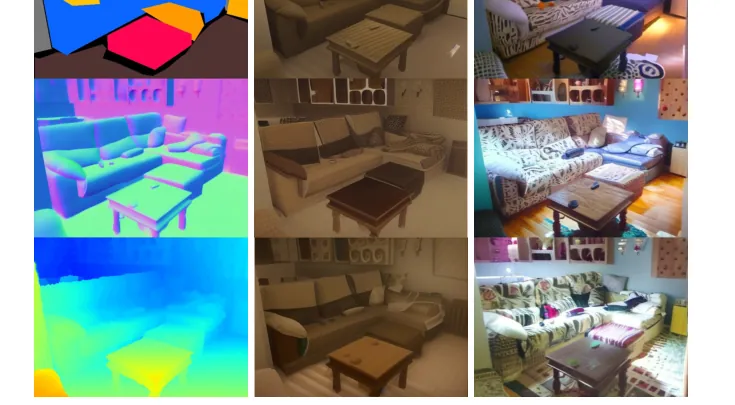
- 无任何空间条件,仅靠文本提示(第 1 列
w/o All):尽管底层 3D 几何已经固定,但失去空间条件引导的外观扩散模型在二维图像上胡乱绘制光影,导致床头背景墙与床体颜色互相渗透、糊作一团。 - 仅加入渲染语义图 (第 2 列
w/ Semantic):各个物体的颜色立刻被严格限制在各自的语义轮廓内部,不再发生跨物体串色;但由于外观模型看不见物体内部的法线转折与深度起伏,家具表面显得像平涂贴纸一样缺乏立体感。 - 加入语义图 + 法线图 (第 3 列
w/ Semantic & Normal):床垫边缘、枕头褶皱与柜门线框的立体光影细节瞬间浮现。 - 完整三路条件 (第 4 列
w/ All):最后补齐渲染深度图 后,近景床尾与远景墙角之间的全局景深明暗过渡变得自然协调,消除了局部视角的明暗割裂感。
6. 3D 场景生成与感知重建的技术生态横向对比
将 Layout2Scene 与本博客精读过的其他代表性三维场景生成与感知对齐工作(CasLayout、Imaginarium、Diorama、SUFLECA 以及组合式辐射场基线)放在同一张全景架构表中对比,可以清晰看清它在整个三维生成链路中的生态位与上下游互补关系:
| 代表工作 | 核心输入与任务边界 | 底层 3D 场景表示 | 几何与外观生成机制 | 渲染帧率与单场景耗时 | 核心优势与互补关系 |
|---|---|---|---|---|---|
| Layout2Scene | 已知 3D 语义布局框 + 文本提示 可编辑 3D 场景 | 前景规范空间 2DGS + 背景显式多边形与 2D 哈希纹理场 | 两阶段解耦蒸馏:Stage 1 语义几何扩散(GSDS)修形状 Stage 2 三路 ControlNet 外观扩散(ISD + )生纹理 | 30 FPS 实时渲染;单场景优化约 1.5 小时 | 无需任何预定义 CAD 资产库即可从三维框长出风格统一的 30 FPS 场景;可直接将上游 CasLayout 的输出作为输入 |
| CasLayout | 户型图 / 门窗构件 / 文本 生成 3D 室内包围盒布局 | 家具带朝向包围盒 OBB + 墙门窗构件节点 | 四阶段级联扩散(类别 尺寸与 VQ-VAE 特征 双向 Relation VAE 节点潜变量 OBB 落位) | UniPC 扩散采样仅 25 ms;从 3D-FUTURE 检索现成 CAD | 专注于上游结构化三维布局规划与门窗避让;恰可为 Layout2Scene 提供物理合理的输入 3D 语义布局 |
| Imaginarium | 简短文本 微调 Flux 2D 引导图 高密度 3D 资产场景 | 自建 2,037 个专业精模资产(含容器内部子空间与预计算体素) | VLM 三级支撑树与成套分组 + DINOv2 检索 + 162 视角 AENet/单应性/OBB 姿态 + 体素退火与 Blender 刚体物理 | 单场景生成约 240 秒;导出工业级 .blend 三角网格 | 单场景均 31.86 个物体,桌面与隔层陈设极丰富;强依赖预定义闭集精模库,无法生成库外自由形态资产 |
| Diorama | 单张野外 RGB 图像 零样本开放世界可交互 3D 场景 | 开放词汇分割 + Trellis 单图生成 3D 网格 + 分段平面背景 | VLM 局部接地场景图(支撑树 + 5 类相对成对约束)+ 渲染深度/掩码对齐 + 符号距离场(SDFS)防碰撞优化 | 零样本分钟级重建;自带刚体关节可动先验 | 无需训练且不依赖固定 CAD 库,直接从单张真实照片恢复带物理层级的可交互仿真环境 |
| SUFLECA | 单张真实 RGB 图像 端到端 CAD 检索与 9-DoF 对齐 | 像素对齐三维点云特征 + 预定义 CAD 库网格 | 训练期用冻结 DINOv2 视觉特征蒸馏三维点云编码器(),推理期前向一步回归 9-DoF 位姿与检索向量 | 神经网络单次前向推理(秒级) | 专攻单视角感知下的跨模态特征对齐与高精度 CAD 位姿恢复 |
| Set-the-Scene / CompoNeRF | 3D 包围盒 / 体素代理 + 文本 组合式 NeRF 场景 | 多个局部物体 NeRF + 背景 NeRF 的组合体渲染场 | 单阶段标准 SDS(同时用预训练文生图扩散模型更新密度与颜色) | 仅 0.08 FPS;单场景优化需 3–5 小时 | 开创了包围盒引导的组合神经场,但受困于几何外观梯度耦合、局部视角重复幻觉与极慢的体素步进速度 |
通过这张生态全景表,我们可以准确划定 Layout2Scene 的优势疆域与客观局限:
- 它解决了什么核心痛点? 当我们不想受制于固定 CAD 模型库(如 3D-FUTURE)千篇一律的款式,希望仅凭三维语义包围盒与一句风格描述,就从零生成一套几何平整、纹理锐利、无多床幻觉且能以 30 FPS 实时漫游并独立拖拽编辑的室内场景时,Layout2Scene 提出的“3D 布局透视投影条件 + 前景 2DGS / 背景哈希多边形混合表示 + 先 GSDS 几何后 ISD 外观的两阶段解耦蒸馏”是目前最优雅的生成式神经渲染解法。
- 它的客观边界在哪里?
- 不具备上游布局纠错与物理仿真能力:Layout2Scene 假设输入的 3D 语义布局天然合理。如果上游输入的包围盒本身发生了穿模、悬空或堵门,系统只会忠实地在错误的位置上雕刻出对应的家具;因此在实际工程中,将其与上游毫秒级布局生成器(如
CasLayout)串联,才能构成从户型图到可漫游神经场景的完整闭环。 - 室内曼哈顿先验与底座预训练成本:系统的两个核心扩散先验完全在 SunRGBD 室内数据集上微调,且背景采用显式平面多边形建模,默认了房间符合平整的曼哈顿世界(Manhattan World)假设,难以直接泛化至室外自然地貌或包含复杂曲面穹顶、旋转楼梯的异形建筑;同时,单场景 1.5 小时的蒸馏速度建立在预先使用 4 张 V100 训练两个 120k 步扩散底座的基础之上。
- 对 Shap-E 初始拓扑的依赖:前景 2DGS 的初始分布来自 Shap-E,若面对极其复杂的组合家具或细长镂空结构导致初始点云拓扑严重缺失,仅靠 Stage 1 的二维法线与深度蒸馏仍难以无中生有地修补内部不可见结构。
- 不具备上游布局纠错与物理仿真能力:Layout2Scene 假设输入的 3D 语义布局天然合理。如果上游输入的包围盒本身发生了穿模、悬空或堵门,系统只会忠实地在错误的位置上雕刻出对应的家具;因此在实际工程中,将其与上游毫秒级布局生成器(如
References
- Chen, Minglin, Longguang Wang, Sheng Ao, Ye Zhang, Kai Xu, and Yulan Guo. Layout2Scene: 3D Semantic Layout Guided Scene Generation via Geometry and Appearance Diffusion Priors. arXiv:2501.02519v1, 2025.
- arXiv HTML v1: https://arxiv.org/html/2501.02519v1
- arXiv PDF: https://arxiv.org/pdf/2501.02519
- Hugging Face paper metadata: https://huggingface.co/papers/2501.02519
- Guo et al. ThreeStudio: A Unified Framework for 3D Content Generation.
- Zhang et al. Adding Conditional Control to Text-to-Image Diffusion Models, ControlNet.
- Poole et al. DreamFusion: Text-to-3D using 2D Diffusion, ICLR 2023.
- Wang et al. ProlificDreamer: High-Fidelity and Diverse Text-to-3D Generation with Variational Score Distillation, NeurIPS 2023.
- Hollein et al. Text2Room: Extracting Textured 3D Meshes from 2D Text-to-Image Models, ICCV 2023.
- Cohen-Bar et al. Set-the-Scene: Global-Local Training for Generating Controllable NeRF Scenes, ICCV 2023.
- Song et al. Sun RGB-D: A RGB-D Scene Understanding Benchmark Suite.
- Li et al. BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models.
comments