在关系型数据库(RDBMS)里查一层外键关联轻而易举;但如果你在金融反欺诈、供应链溯源或知识图谱问答中写过一条 4 跳以上的自连接查询(SELECT ... FROM account a JOIN transfer t1 ... JOIN transfer t2 ... JOIN transfer t3 ... JOIN transfer t4),一定领教过延迟从几毫秒陡增到几十秒甚至把内存打爆的绝望。
为什么关系型数据库一遇到深层多跳连接就会性能雪崩?原因藏在最底层的存储物理布局里:在 B+Tree 支撑的关系表中,“实体与实体的关系”根本没有物理指针,只是一列冷冰冰的外键数值。每向外扩展一跳,数据库都必须拿着上一跳产出的成百上千个外键 ID,去一张存有数亿行记录的全局关联表索引里重新做 的树查找。这意味着在关系型数据库里,局部一跳的查找成本永远与整张表的全局数据总量 绑死在一起——你的历史表越庞大,哪怕只是查一个普通用户的三度好友,每一跳的 B+Tree 深度和跨页随机 I/O 就越重。
反过来,如果在内存里直接用哈希表加邻接链表(Map<NodeId, List<Edge>>)存图呢?纯内存邻接表虽然跳得快,却是一座没有地基的沙塔:一旦遇到断电崩溃如何恢复?两个并发事务同时给同一个节点加边,双向链表指针怎么避免写坏?一个热门大 V 节点挂了五百万条粉丝边(超级节点),怎么在不扫遍五百万条边的前提下找出他最近关注的 3 家企业?当用户写出一句直观的声明式查询时,系统又该如何算出从哪个节点起步最省算力?
这正是 Neo4j 作为工业界标杆原生图数据库的核心价值所在——它把“图的邻接指针”做成了底层物理存储的一等公民,又在这套指针链之上完整盖起了编译优化器、预写日志(WAL)、堆外页缓存与 ACID 事务内核。
本文结合 Neo4j Community 2026.06.0 开源源码(对应 commit eccd584a64d468af3daeab421478fe78567c518f,基于 Java 21、Scala 2.13.17、Lucene 10.4.0 与 Netty 4.2.15 构建)、SIGMOD 2018 经典论文 Cypher: An Evolving Query Language for Property Graphs 以及 Neo4j 2026.06 官方技术手册(涵盖最新默认语言标准 Cypher 25),从最底层的字节偏移量一路拆解到顶层的查询规划器。
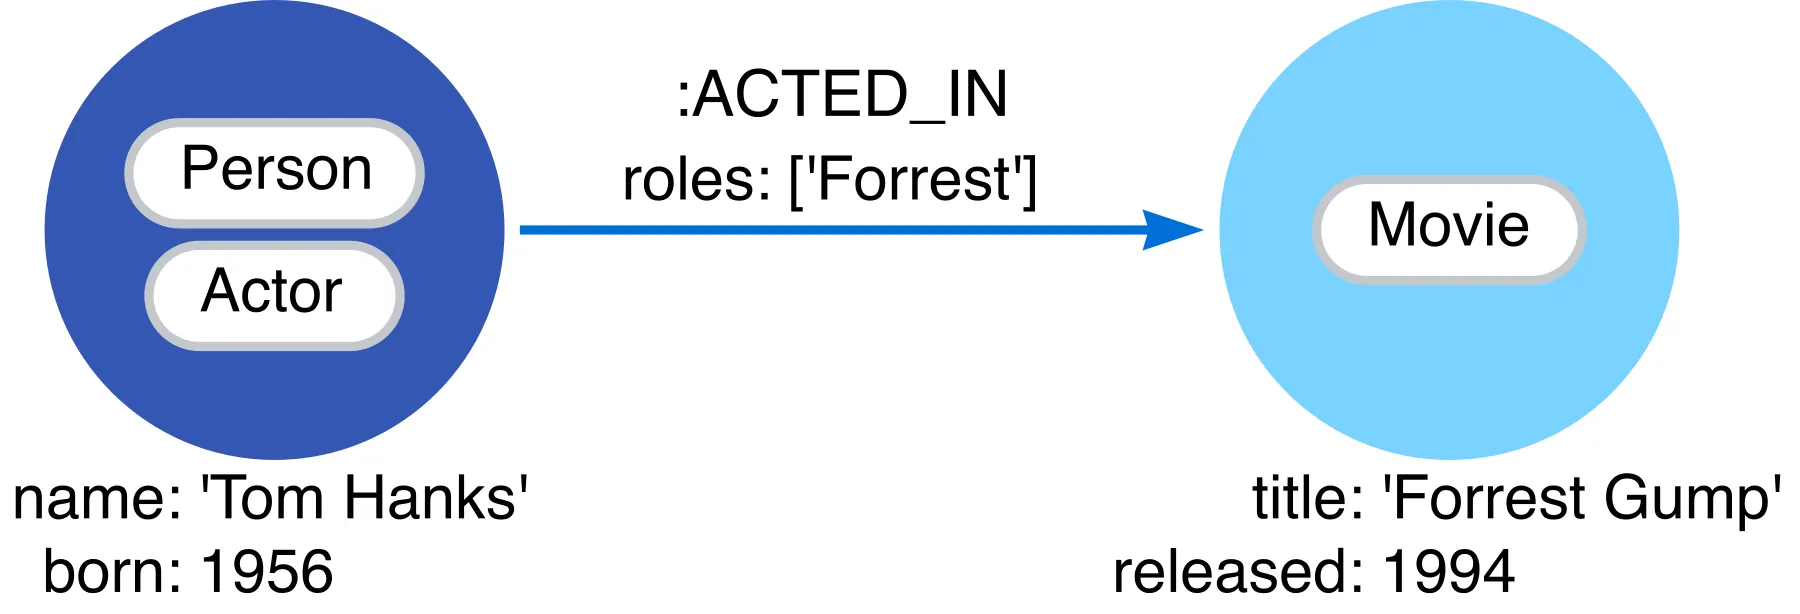
纵览整座代码库与论文体系,Neo4j 之所以能在百亿级图规模下保持毫秒级局部多跳遍历与强事务一致性,归根结底建立在四条核心设计哲学之上:
- 免索引邻接与定长记录算术寻址:把 的全局 B+Tree 查找变成 的物理偏移量指针跳转(Index-Free Adjacency via Fixed-Size Record Offset Arithmetic):在
RecordStorageEngine中,节点、关系与属性被拆分为各自独立的定长物理记录文件。只要知道一个节点或关系的内部长整型 ID,就能通过一行乘法 直接算出它在磁盘与页缓存中的精确字节位置。每个节点记录直接存着第一条关系的物理 ID,每条关系记录又用双向链表串起共享同一端点的前驱与后继关系,彻底省去了多跳连接时的全局索引树搜索。 - 声明式图模式与关系代数多集语义的统一:用“表到表的函数复合”管住模式匹配的组合语义(Declarative Pattern Matching Grounded in Bag Relational Algebra):用户在 Cypher 中用直观的 ASCII-Art 箭头
(a)-[:KNOWS]->(b)描绘想要寻找的图拓扑,而执行引擎在底层将其严格映射为变量绑定记录的多集表(Bag of Records)上的关系代数算子复合,并引入边同态匹配约束(Edge Isomorphism,即单条模式内禁止重复经过同一条物理关系)从语言层阻断无意义环路死循环。 - 基于统计与迭代动态规划的成本优化器 + 槽位化运行时:把“匹配什么形状”编译成“从哪个锚点出发最省步数”(IDP Cost-Based Planning + Slotted/Pipelined Execution):同一个三角或长链模式,从百万级普通标签起步还是从唯一索引锚点起步,中间状态数可以相差上万倍。
CypherPlanner读取内核级基数统计(Count Store)与索引选择率,利用迭代动态规划(Iterative Dynamic Programming, IDP)搜索最优逻辑计划,再编译到预分配长整型槽位数组的Slotted Runtime(或企业版按块流转的Pipelined Runtime)执行,将 JVM 堆对象分配压到最低。 - 事务状态叠加视图、WAL 预写日志与世代 B+ 树:在指针密集型图结构上守住 ACID 纪律(Transactional Overlay State + WAL + Generation-Aware Page Management):在图数据库里插入一条边,需要同时修改源节点、目标节点及相邻关系的多个双向链表指针。Neo4j 通过在事务私有内存
TransactionState中叠加底层MuninnPageCache快照实现“读己之所写”,提交时转化为物理存储命令顺序追加至 WAL 日志,配合双世代指针写时复制的GBPTree与 Lucene 全文/向量索引,实现了图结构与 ACID 事务的严密咬合。
1. 为什么关系表搞不定多跳图遍历?属性图模型与复杂度本质
1.1 带标签属性图(Labeled Property Graph)的七元组形式化
为什么 Neo4j 选择带标签属性图(Labeled Property Graph, LPG)作为核心数据模型,而没有直接照搬语义网的 RDF 三元组?
在 RDF(Subject-Predicate-Object)模型中,一条边本身只是一个裸谓词 URI,不能直接挂载键值对属性——如果你想表达“Alice 从 2022 年起在 Acme 担任高级工程师,置信度 0.95”,在传统 RDF 里必须通过繁琐的词汇具体化(Reification)把一条边拆成好几个虚拟节点和附加三元组。而在工程业务中,“关系本身拥有独立 ID、类型、时间戳、权重和属性”是最自然不过的需求。
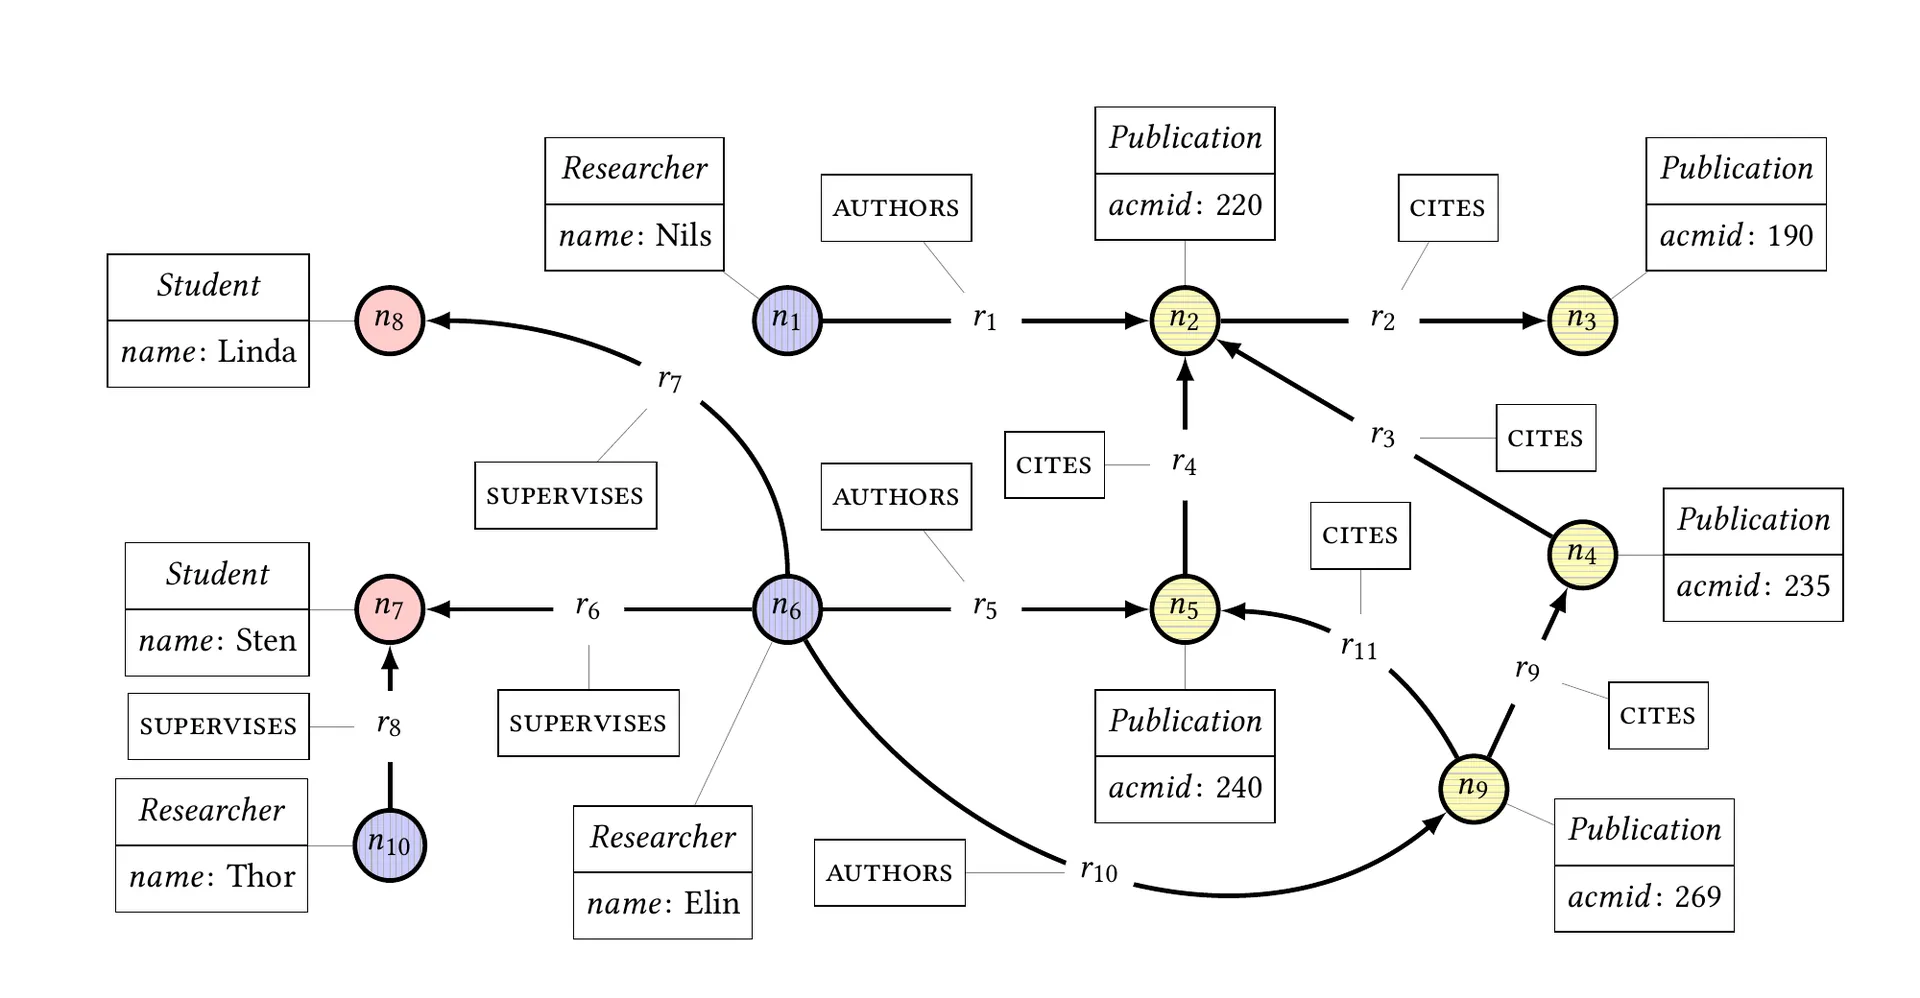
SIGMOD 2018 论文将 Neo4j 的属性图精确定义为一个七元组:
其中各分量的物理与语义分工如下:
- 与 分别是互不相交的有限节点标识符集合与关系标识符集合(在源码底层直接对应 Node Store 与 Relationship Store 中的 64 位长整型内部 ID);
- 与 是两个全函数,为每条有向关系指派唯一的源节点与目标节点;
- 是有限偏函数(Partial Function),将节点或关系与属性键 映射到属性值 。因为是偏函数,无需预先建表声明列,未设置的属性在查询时自然评估为
null; - 将每个节点映射为其携带的有限标签集合(一个节点可以同时拥有
:Person、:Researcher、:Reviewer多个标签,用于分类与索引分组); - 为每条关系指派唯一的关系类型(如
:AUTHORS、:SUPERVISES、:CITES)。
基于这一定义,同一对节点之间允许并存多条具有不同 ID、不同类型或不同属性值的平行边(Directed Multigraph);而图上的一条路径(Path)则是节点与关系严格交替衔接的序列:
满足对每个 ,要么 (正向经过),要么 (反向经过)。
1.2 免索引邻接(Index-Free Adjacency)的真实复杂度边界
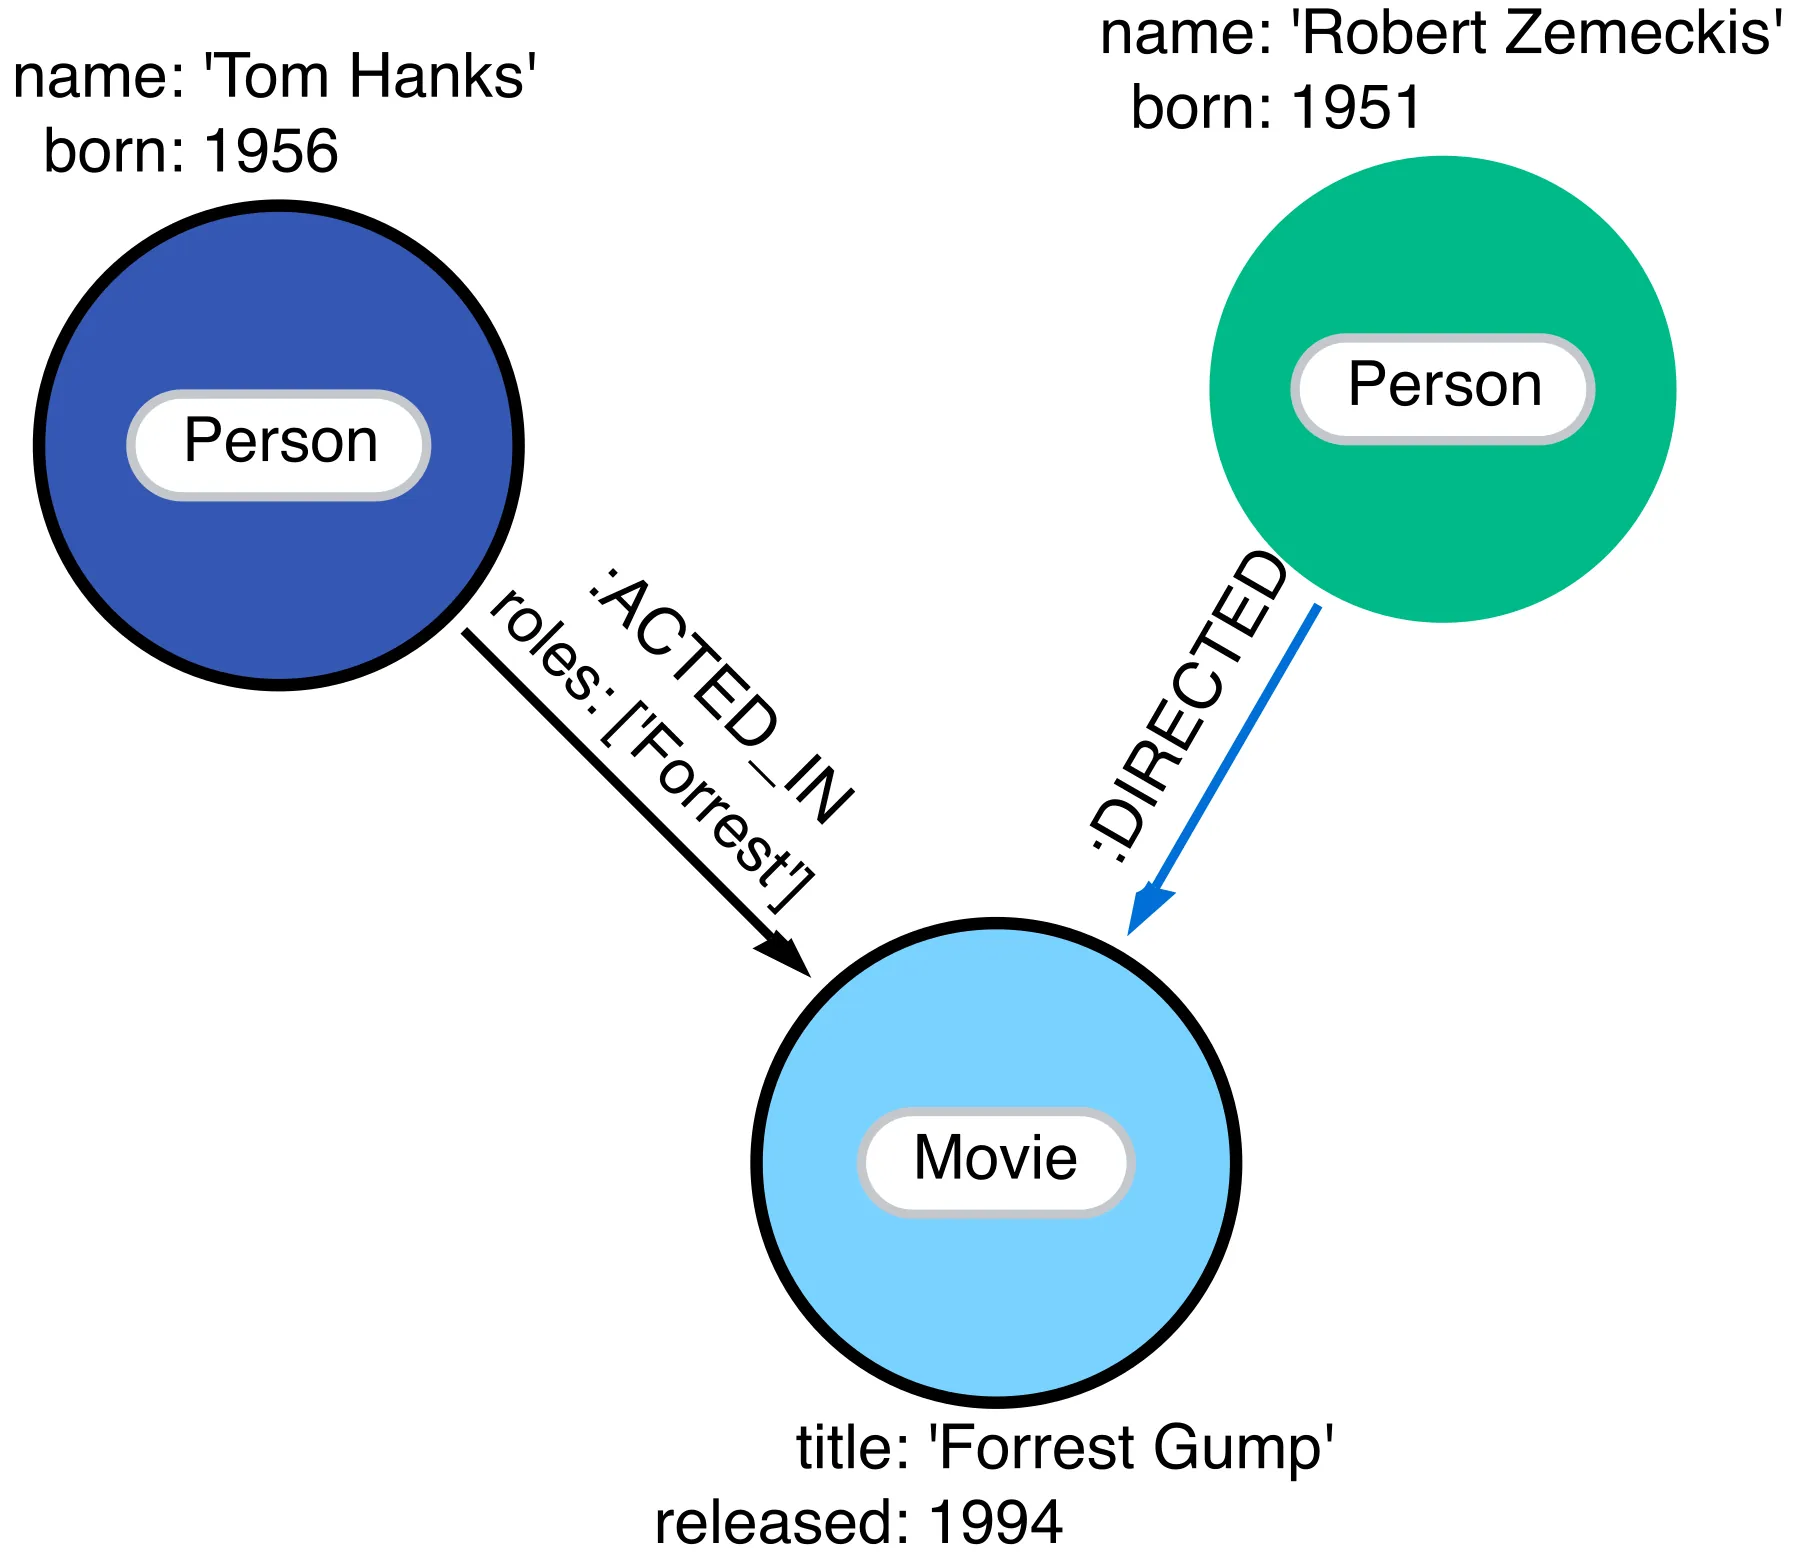
看上方第二张图:当我们要查找“谁导演了 Tom Hanks 参演的电影”时,执行引擎先通过索引定位到 Tom Hanks 节点,随后顺着 :ACTED_IN 关系跳到 Cloud Atlas、Forrest Gump 等电影节点,再顺着 :DIRECTED 关系反向跳到对应导演节点。
让我们算一笔硬核的复杂度账,看看关系型数据库 B+Tree 外键连接与 Neo4j 免索引邻接遍历在 跳查询上的本质差异:
- 在 RDBMS 中:假设关联表总共有 条边记录,B+Tree 扇出为 ,每次通过外键索引查找一个节点的邻居需要 次页面比较。如果每跳平均匹配出 条边,那么向外走 跳的总查找开销为: 一旦全库历史边数 从百万涨到百亿, 的惩罚会放大到每一跳的每一个中间节点上,且相邻关系的记录在磁盘上分散在不同 B+Tree 叶子页中,引发严重的随机 I/O。
- 在 Neo4j 免索引邻接中:一旦定位到锚点,从当前节点顺着物理记录指针跳向邻居节点,单步寻址开销是与全库规模 完全无关的常数 !设第 跳经过关系类型与方向过滤后的有效分支因子(Branching Factor)为 ,则 跳遍历访问的候选状态总数为:
这个公式揭示了图数据库工程中最重要的一条辩证法则:免索引邻接消灭了每一跳上的 全局规模因子,让局部遍历速度不受全图总数据量膨胀的拖累;但它并不能消灭 的多跳组合扇出!如果查询在半途一头撞进一个拥有百万条边的“超级节点”(Supernode,例如代表“中国”的国家节点或热门大 V 节点),或者写出了不设跳数上界的 [:KNOWS*],候选状态集依然会指数级爆炸。理解“单步 指针跳转”与“多跳 组合基数”的边界,是后续理解 Cypher 优化器与物理存储设计的钥匙。
1.3 开源社区版与商业企业版的内核能力边界
在深入源码模块之前,先用一张对照表厘清本文精读的 neo4j/neo4j Community 2026.06.0 开源仓库与商业闭源 Enterprise / Aura 版本在核心引擎上的准确分工(注:自 2025 年起 Neo4j 主线采用 YYYY.MM 日历版本号,与 5.26 LTS 并行维护;当前主线默认查询语言已演进至 Cypher 25):
| 核心内核维度 | Community Edition(本文开源源码范围) | Enterprise Edition / Aura(商业扩展) |
|---|---|---|
| 底层存储引擎格式 | aligned 定长记录格式(基于开源 RecordStorageEngine) | 默认采用 block 分块存储格式(将高频相邻数据紧凑打包进物理块,并支持原生 VECTOR 类型列) |
| Cypher 物理运行时 | slotted runtime(基于长整型/引用槽位数组的 Volcano 流式迭代器) | 额外提供按 morsel 批量融合管线的 pipelined runtime 与多核并发只读 parallel runtime |
| 数据完整性约束 | 节点/关系属性的唯一性约束(IS UNIQUE) | 额外支持属性非空存在性(IS NOT NULL)、属性类型约束(IS :: TYPE)与组合键 NODE/RELATIONSHIP KEY |
| 数据库拓扑与高可用 | 单一标准业务库 + system 系统库;单机独立部署 | 多数据库实例、Composite Database 联邦查询、基于 Raft 共识的 Autonomous Clustering 与读写分离路由 |
| 权限与安全治理 | 基础用户身份认证与密码生命周期管理 | 细粒度 RBAC 角色体系、按标签/关系/属性级拦截的细粒度访问控制、SSO / Kerberos 审计 |
2. 核心设计哲学一:声明式图模式与关系代数多集语义的统一
为什么 SQL 写图查询那么痛苦,而 Cypher 却能让开发者一眼看懂?因为 SQL 逼着人类在脑子里把“图拓扑”翻译成“外键等值连接表”;而 Cypher 允许直接用 ASCII-Art 字符画出图的形状:(r:Researcher)-[:SUPERVISES]->(s:Student)。
但“画着像图”只是语法糖。要把一门图形查询语言变成严肃的工业级数据库引擎,必须在数学上回答清楚:当多段图模式、可选匹配(OPTIONAL MATCH)、分组聚合(WITH)与集合并(UNION)组合在一起时,每一行中间结果到底是什么?为什么有时候连续做两次 MATCH 会让 count() 统计翻倍?
2.1 从图模式匹配到“变量绑定多集表(Bag of Records)”
我们来看 SIGMOD 2018 论文给出的经典学术网络查询——统计每位研究员指导的学生人数,以及他发表的所有论文累计被多少篇不同论文直接或间接引用:
MATCH (r:Researcher)
OPTIONAL MATCH (r)-[:SUPERVISES]->(s:Student)
WITH r, count(s) AS studentsSupervised
MATCH (r)-[:AUTHORS]->(p1:Publication)
OPTIONAL MATCH (p1)<-[:CITES*]-(p2:Publication)
RETURN r.name, studentsSupervised,
       count(DISTINCT p2) AS citedCount
这条查询在引擎内部是怎么流转的?看下方论文 Fig. 2 的推演过程:
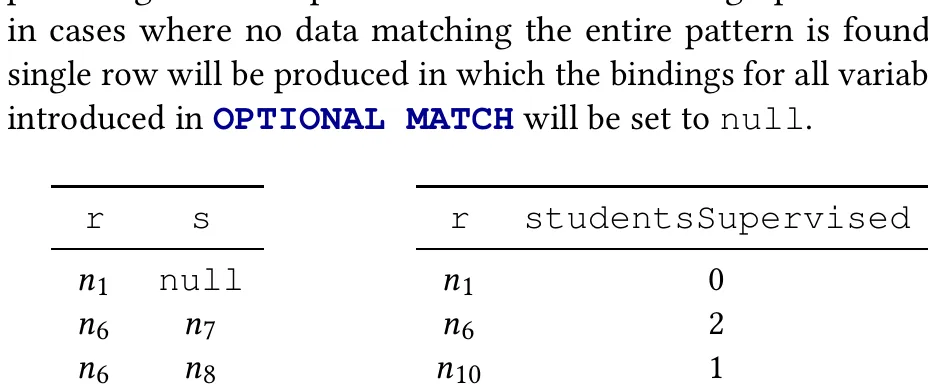
论文一针见血地指出:Cypher 查询的每一步输出,本质上都是一张由变量绑定记录(Record)组成的多集表(Bag / Multiset of Records)!
- 什么是绑定记录 ? 每当图上的一条子路径成功匹配了模式中的变量(如
r和s),就会产出一条从变量名到图元素 ID(节点、关系、路径或标量值)的映射字典,例如 。 - 为什么必须是多集而非集合(Bag vs. Set,允许重复行)?因为在执行聚合(如
sum(x.price)或count(*))之前,不同的匹配路径完全可能投影出相同的剩余变量组合。如果默认去重,不仅每次子句转换都要付出高昂的哈希去重代价,还会把原本来自不同分支的有效计数吞掉。 - 为什么中间必须插入
WITH r, count(s) AS studentsSupervised? 这是新手写 Cypher 最容易踩的“扇出笛卡尔积”大坑!假设某位研究员指导了 3 名学生,同时发表了 4 篇论文。如果省掉中间那行WITH聚合,直接连写两行MATCH (r)-[:SUPERVISES]->(s)和MATCH (r)-[:AUTHORS]->(p1),那么第一阶段产出的 3 行绑定记录会在第二阶段各自扩展出 4 篇论文,中间表瞬间膨胀为 行!此时再去count(s),统计出的学生数就会从 3 变成错误的 12。WITH子句在 Cypher 中充当了显式的关系代数阶段边界与作用域屏障——只有被WITH点名导出的变量才能存活到下一阶段,从而在进入下一段一对多扩展前把基数重新拍扁为每个研究员一行。
2.2 形式化模式语法、刚性展开与“边同态(Edge Isomorphism)”法则
为了给编译器和跨厂商实现(openCypher / ISO GQL)提供无歧义的数学规范,SIGMOD 2018 论文定义了完整的符号系统与模式语法:
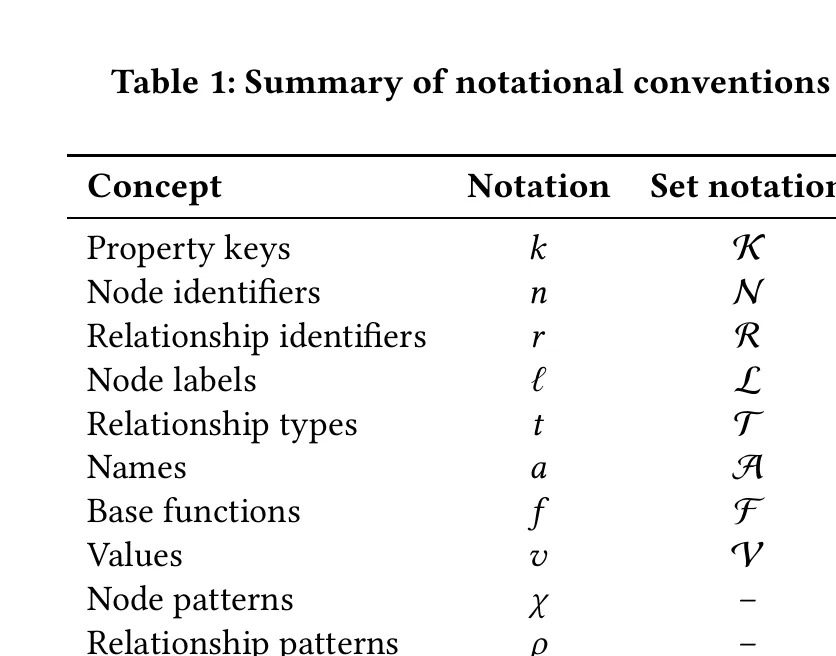
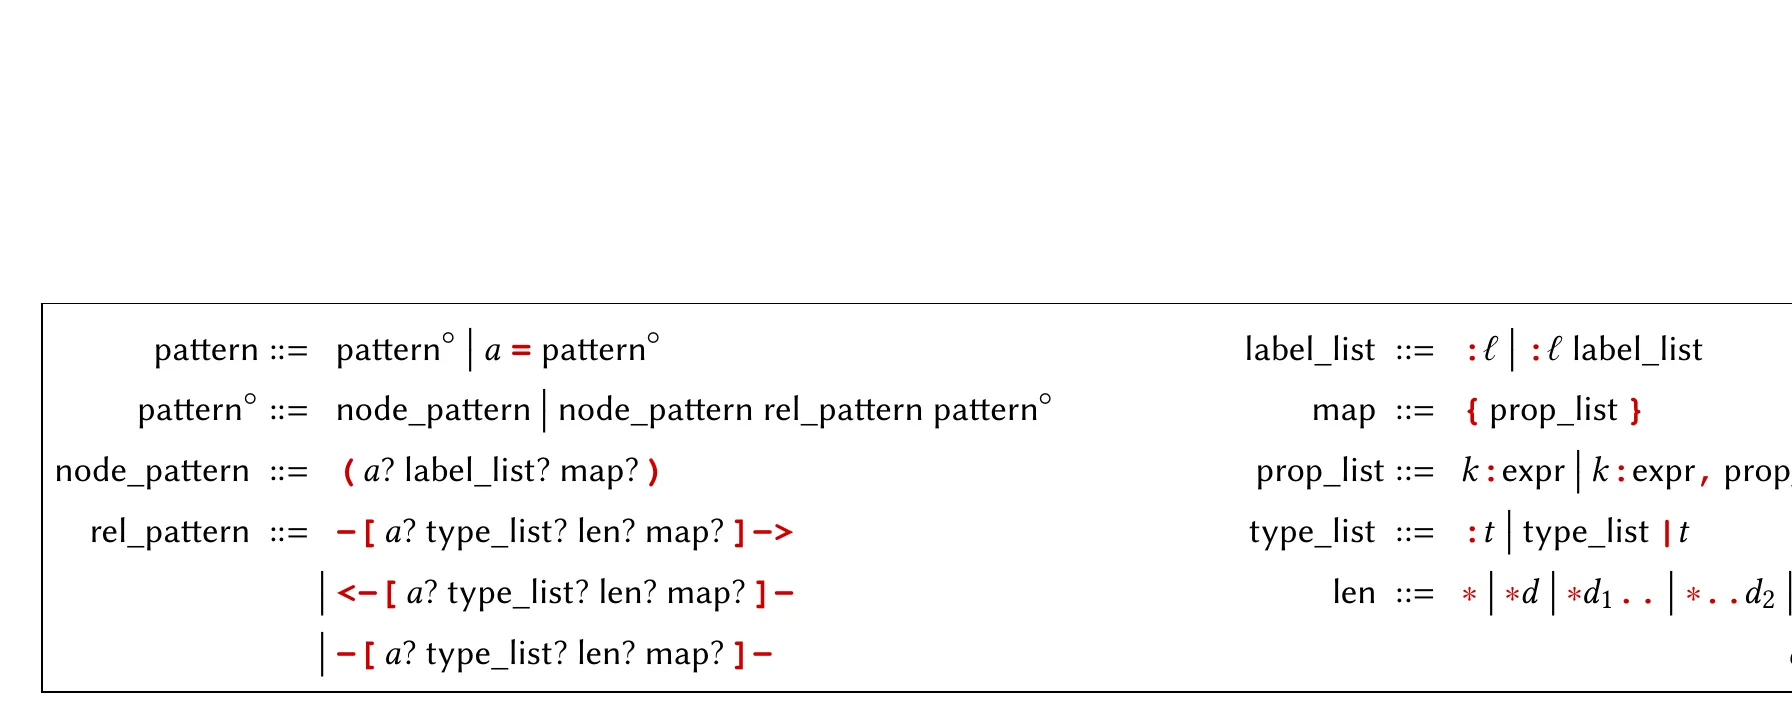
对照上方 Table 1 与 Fig. 3,一个路径模式 由节点模式 (变量名 、必含标签集 、属性键值约束 )与关系模式 (关系变量 、方向 、允许类型集 、跳数区间 、属性约束 )交替拼接而成:
给定图中的一条具体路径 、属性图 与当前上下文已绑定的变量记录 ,论文将“路径 在绑定 下满足模式 ”记作:
当模式中包含可变长关系(如 -[e:KNOWS*1..3]->,即跳数区间 )时,形式语义通过刚性展开(Rigid Extension)将其等价展开为长度为 1、2、3 的三组定长路径模式的并集(此时关系变量 绑定为由路径上各跳关系组成的列表 [r_1, r_2, ...])。
这里隐藏着一个极其关键、直接决定多跳查询生死的语义设计——Cypher 为什么采用“关系同构(Relationship / Edge Isomorphism)”匹配语义?
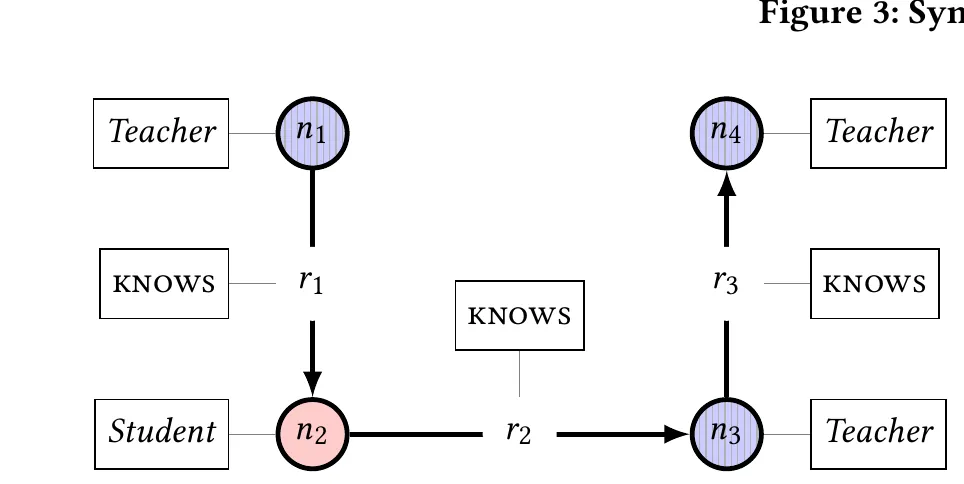
看上方 Fig. 4 的师生互相认识小图:图中存在大量双向认识关系甚至三角形环路。当我们写下一条多跳查询 MATCH (a)-[:KNOWS]->(b)-[:KNOWS]->(c) 或可变长查询 MATCH (a)-[:KNOWS*1..4]->(c) 时,如果不加任何限制(纯同态 Homomorphism),遍历器从 a 沿着某条边走到 b 后,下一步完全可以顺着同一条反向关系或无向匹配原路退回 a,在一条边或一个小环上来回震荡,产生成千上万条毫无业务意义的冗余路径!
但如果在另一个极端强制要求“节点同构(Node Isomorphism,即路径上所有节点互不相同,对应图论中的 Simple Path)”,又会导致用户无法用 (a)-[:KNOWS]->(b)-[:KNOWS]->(c)-[:KNOWS]->(a) 这种闭环模式去检测图里的三角形欺诈环路。
Cypher 的权衡堪称精妙——它选择了居中的边唯一性约束(Edge Isomorphism):在单次 MATCH 模式匹配的同一条实例路径 中,允许同一个节点出现多次(从而支持环路检测),但绝不允许同一条物理关系 在该模式中被重复经过两次(即要求 )!这既赋予了查询语言直接表达环路模式的能力,又保证即使在有限图上执行无界可变长匹配 [:KNOWS*],由于图中的物理边总数 有限,合法的匹配路径集合在数学上也必定是有限的。
2.3 表到表(Table-to-Table)函数复合、OPTIONAL MATCH 与三值逻辑陷阱
在定义了单条模式的匹配满足关系后,论文将整条 Cypher 查询语句 的执行语义统一归结为从输入表到输出表的函数复合:
查询启动前,引擎初始化一张只含有一行“空绑定元组 ”的单行种子表 ;随后的每一个子句(MATCH、WHERE、WITH、UNWIND、RETURN)都是一个接收上一阶段多集表 、产出新多集表 的算子函数:
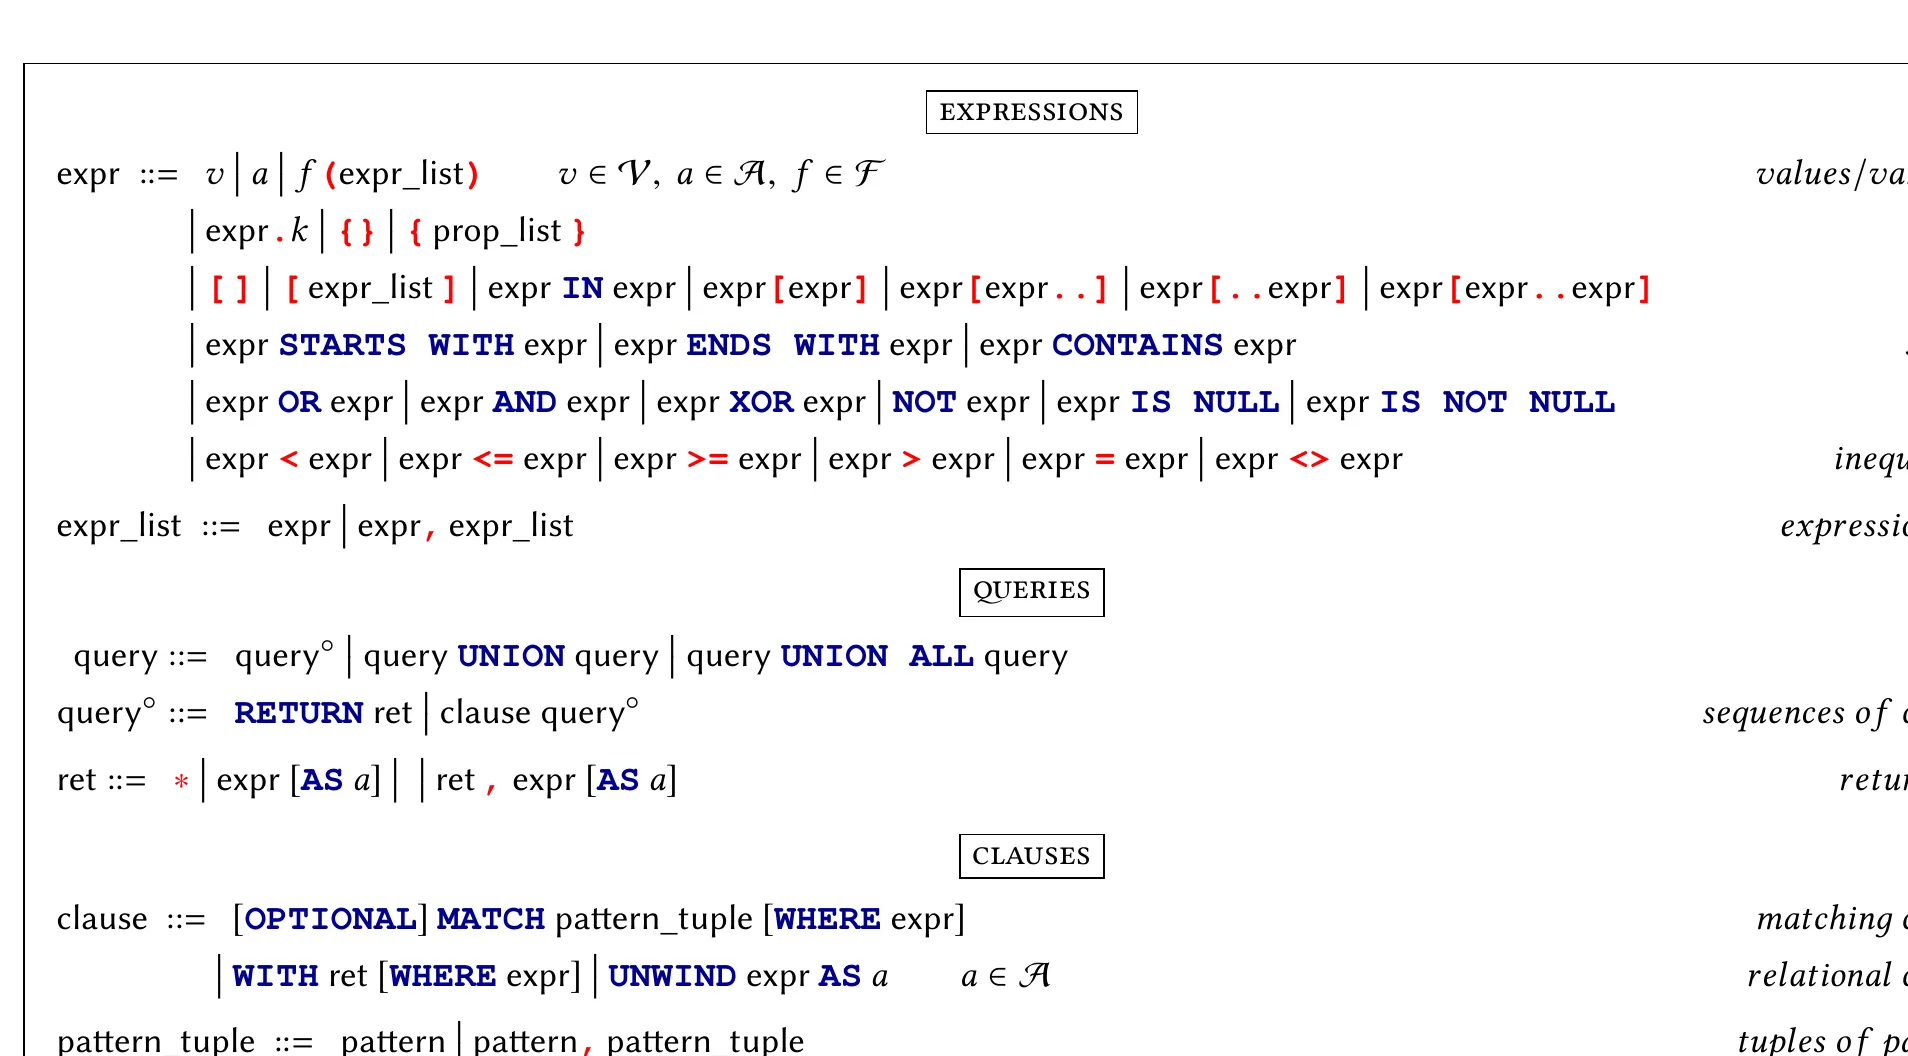
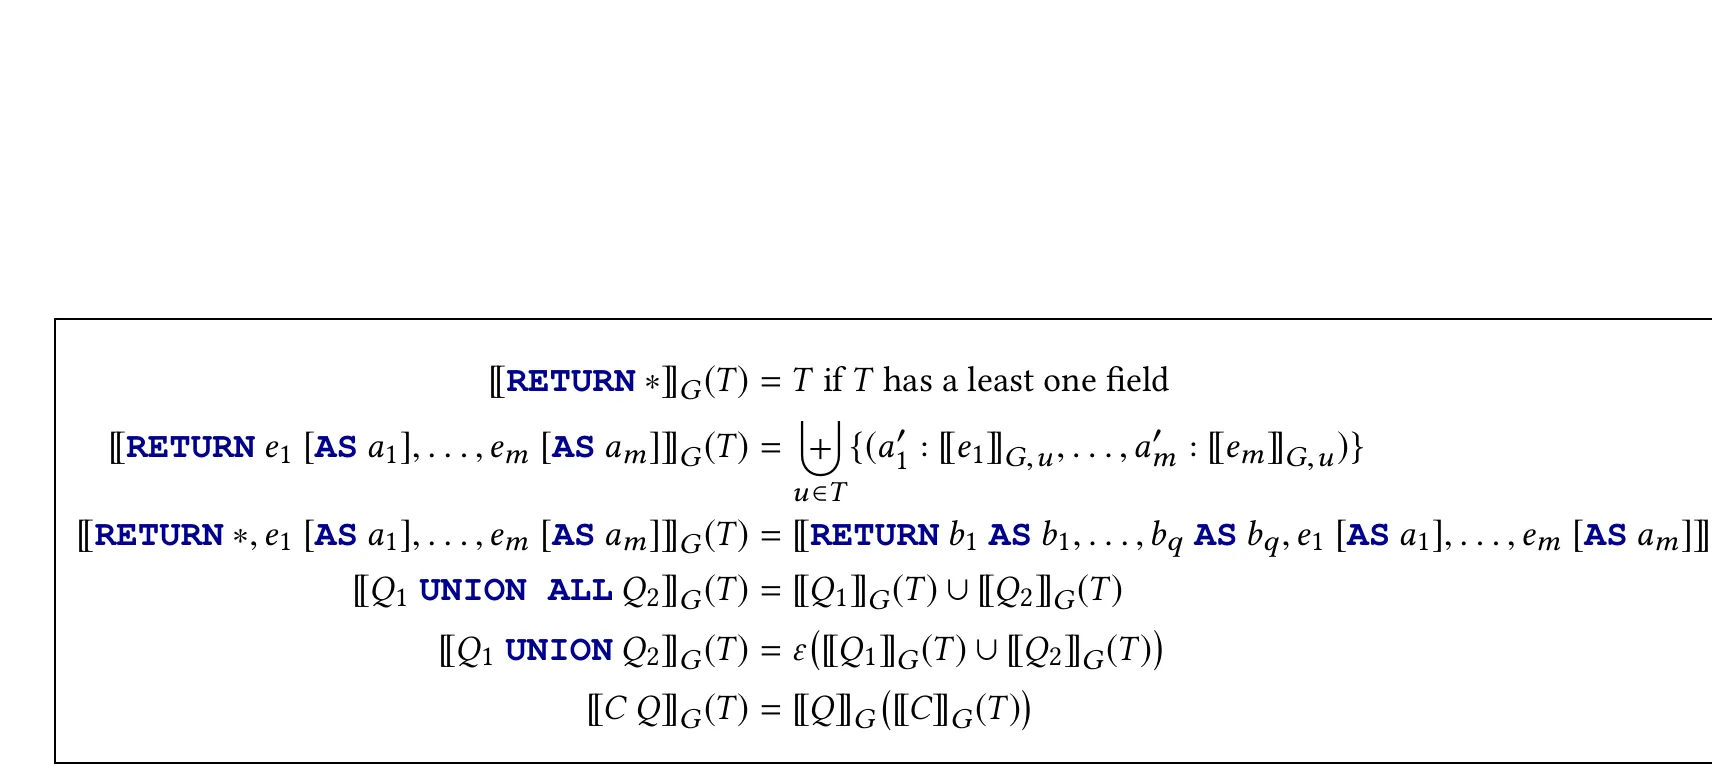
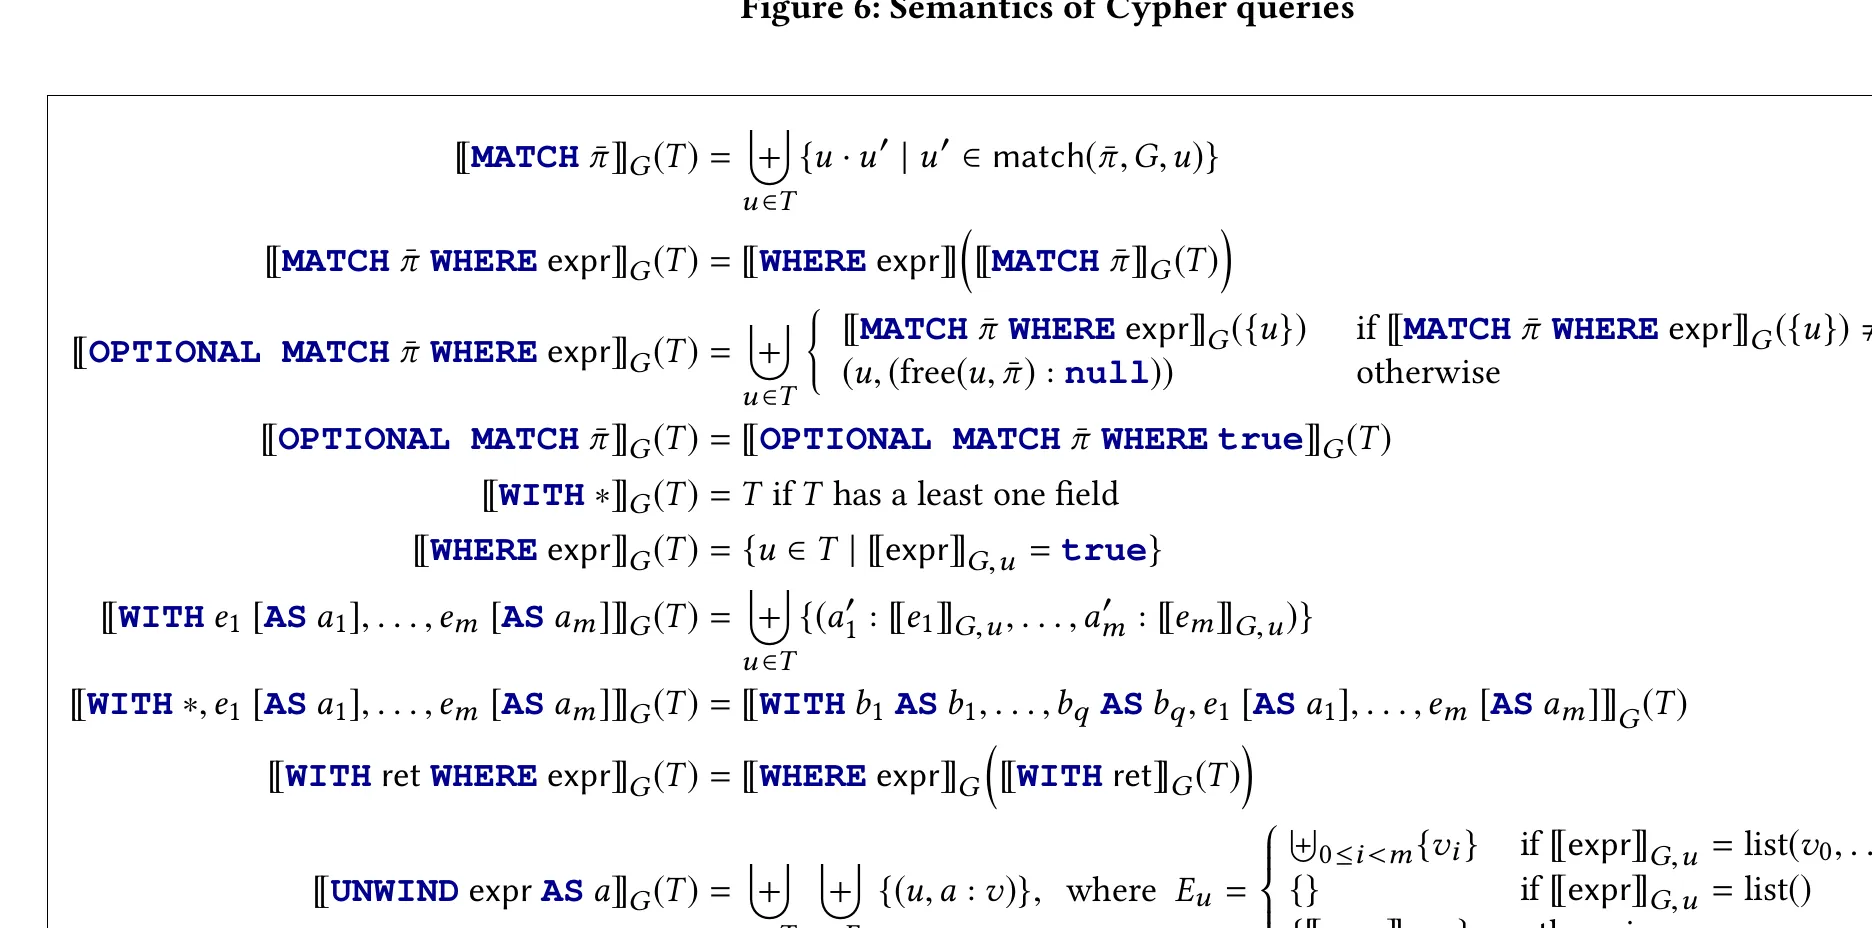
仔细研读上方 Fig. 6 与 Fig. 7 的形式化推导公式,我们可以把日常工程中最容易混淆的三个核心子句机制彻底看透:
- 多集重数(Multiplicity)与集合并:记绑定记录 在多集表 中出现的重复次数为 。
UNION ALL直接将两张表的重数相加: 而UNION则在此基础上将所有 的记录重数截断为 。 MATCH与OPTIONAL MATCH的代数分野:- 对于输入的每一行现有绑定 ,普通
MATCH计算所有满足 的扩展绑定。如果某一行 在图中找不到任何匹配的邻居(即 ),这行记录 就会像 SQL 的INNER JOIN一样从结果表中直接消失; - 而
OPTIONAL MATCH则对应关系代数中的左外连接(Left Outer Join):当 时,它不仅保留原行 ,还会把模式 中新引入的所有未绑定自由变量 显式赋值为null:
- 对于输入的每一行现有绑定 ,普通
WHERE位置与三值逻辑(Three-Valued Logic)的微妙交互: 在 Cypher 的布尔求值中,表达式结果包含true、false和null(未知),而WHERE仅保留求值结果为严格true的行。请对比下面两段看似差不多、实则结果天差地别的写法:- 写法 A(
WHERE紧跟在OPTIONAL MATCH内部):
此时MATCH (u:User) OPTIONAL MATCH (u)-[r:PURCHASED]->(p:Product) WHERE p.category = 'Book' RETURN u.id, count(p)WHERE p.category = 'Book'是左外连接连接条件的一部分!如果某位用户从来没买过书(只买过衣服,或者什么都没买),OPTIONAL MATCH匹配失败,但用户u依然会被保留下来,p被置为null,最终count(p)正确返回0。 - 写法 B(把过滤条件拆到后续阶段):如果在
OPTIONAL MATCH之后先WITH u, p,再单独写一句过滤WHERE p.category = 'Book',那么对于没买过商品的用户,由于p为null,p.category = 'Book'求值为null(非true),这行好不容易靠OPTIONAL MATCH保留下来的用户记录就会被当场淘汰,使外连接瞬间退化为内连接!
- 写法 A(
从论文所刻画的 Cypher 9 演进到 Neo4j 2026.06 默认搭载的 Cypher 25(以及对齐 ISO GQL 标准的现代化语法),这套以“多集绑定表 + 函数复合”为底座的执行模型始终未变,并在其上生长出了极其强大的 量化路径模式(Quantified Path Patterns, QPP,如 ((a)-[:TRANSFERRED]->(b WHERE b.riskScore > 0.8)){1,5},允许在可变长跳数的每一跳内部直接嵌入节点与边的局部谓词过滤,无需等整条路径展开后再过滤)、EXISTS / COUNT / COLLECT 标量子查询以及声明式向量检索子句 SEARCH。
3. 核心设计哲学二:从 Bolt 二进制流控到 IDP 成本优化器与物理运行时
当客户端驱动发出一行 Cypher 字符串时,Neo4j 是如何把一段 ASCII 字符变成底层内存页上的指针跳转的?让我们顺着 2026.06.0 源码调用链,拆解这条从网络协议一直贯穿到物理算子的完整流水线:
Application / Official Driver
        |
        v  1. TCP / WebSocket + 4-byte Magic (60 60 B0 17)
BoltServer (community/bolt) -> PackStream 编解码与连接状态机 (HELLO / RUN / PULL n)
        |
        v  2. ExecutionEngine.scala
Cypher Front-End (community/cypher/front-end) -> AST 解析、变量作用域校验与规范化重写
        |
        v  3. QueryCache 查表 (命中则直接跳至第 5 步,统计偏移超阈值则触发 Replanning)
CypherPlanner.scala -> 读取 Count Store 与索引统计,基于 IDP 算法搜索最优 LogicalPlan
        |
        v  4. Runtime 编译映射
Slotted / Pipelined Runtime -> 分配槽位偏移数组,生成可执行算子流水线 (ExecutableQuery)
        |
        v  5. KernelTransactionImplementation
StorageEngine SPI -> 合并内存 TransactionState 与底层 RecordStorageEngine / Index 游标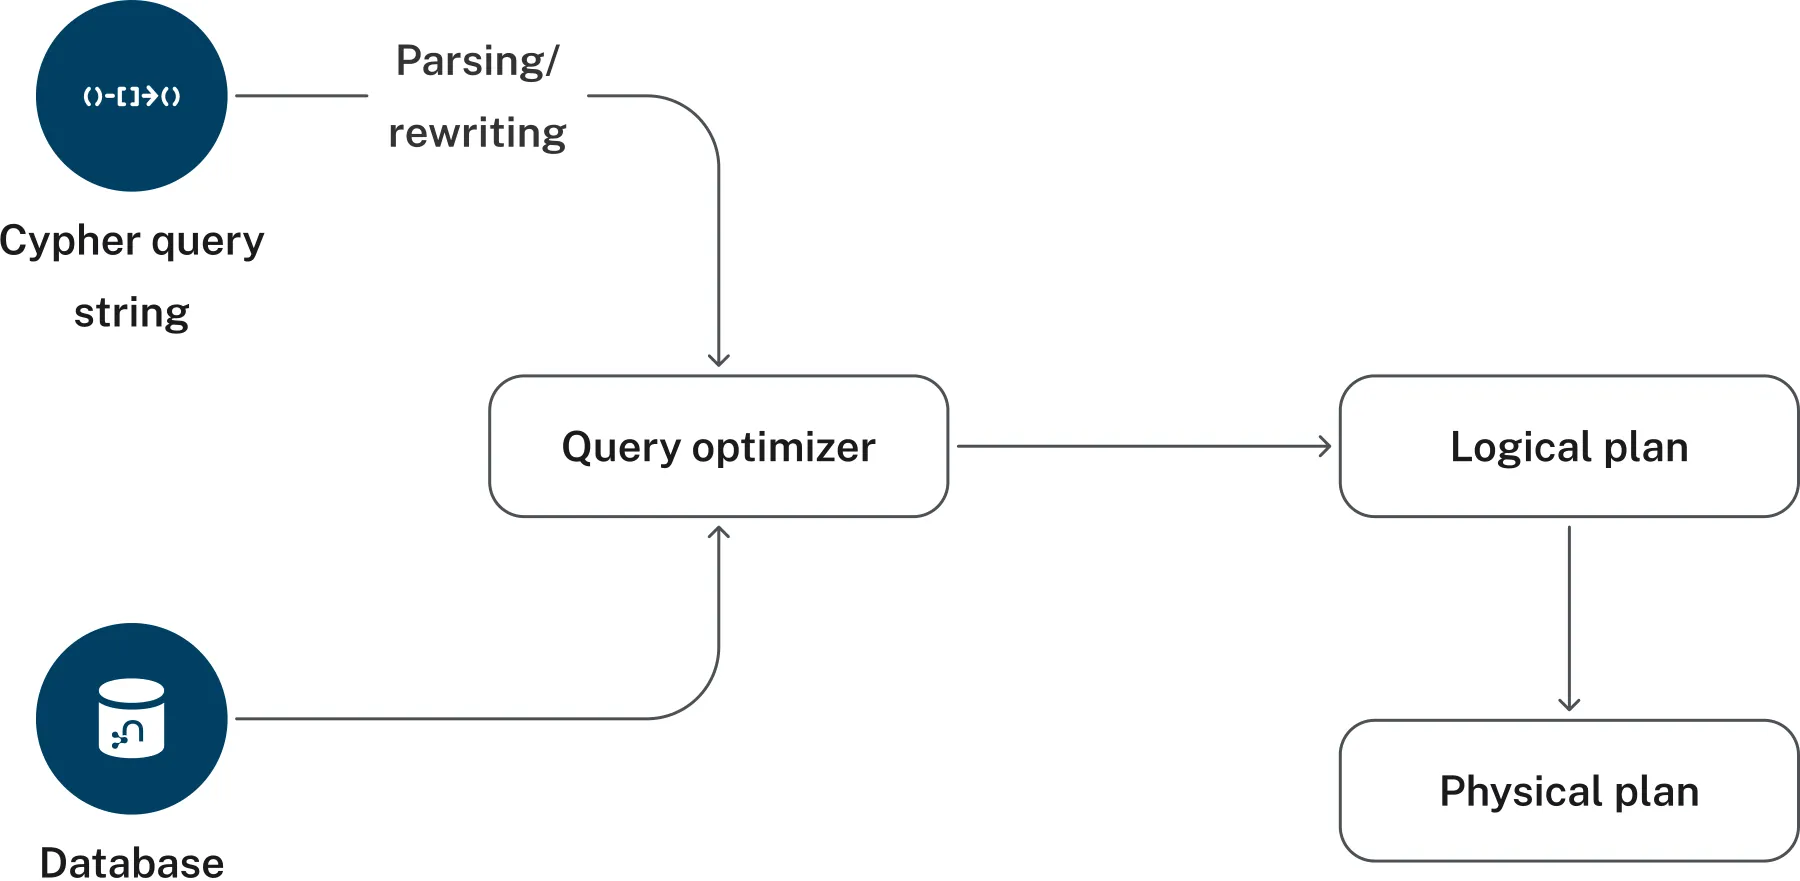
3.1 Bolt 协议与 RUN / PULL n 分离的端到端背压设计
为什么 Neo4j 放弃单纯依赖 REST/JSON 文本接口,专门设计了一套监听在 7687 端口的二进制协议 Bolt(源码位于 community/bolt/.../BoltServer.java)?
除了用紧凑的二进制 PackStream 编码消除了 JSON 文本序列化的 CPU 与带宽浪费外,Bolt 最精妙的工程设计在于有状态会话状态机与流式背压控制(Backpressure)。
客户端连接建立并发送 4 字节魔数 0x60 0x60 0xB0 0x17 协商协议版本后,一条查询的执行被拆成了两个独立的原语消息:
RUN <query> <parameters> <metadata>:仅向服务端提交查询语句与参数字典,触发编译规划并打开顶层结果游标,此时服务端并不会一次性把百万行匹配结果全部算出来塞进内存;PULL {"n": 1000}(或DISCARD):客户端每消费完一批数据,才向服务端发送一次PULL n请求拉取下 条记录。
这种设计直接打通了从客户端消费者到服务端底层图遍历游标的反向背压链路:当下游业务处理变慢、不再发送 PULL 或 TCP 发送缓冲区满时,Netty 通道暂停读取,服务端 Volcano / Pipelined 算子树自动挂起,不再继续向前推进页缓存读取,从而避免了“一条慢查询产出十万个节点直接把服务端 JVM Heap 撑到 OOM”的灾难。
3.2 CypherPlanner:统计基数估计与迭代动态规划(IDP)怎么选计划?
当查询文本进入 ExecutionEngine.scala 后,先经由 community/cypher/front-end 完成词法/语法分析(ANTLR / JavaCC)、语义校验(检查变量类型、聚合合法性与作用域)以及 AST 规范化重写(将字面量提取为参数以提高缓存命中率)。如果 QueryCache.scala 中尚未缓存该 AST 指纹对应的执行计划(或者底层数据量自上次编译以来发生了跨越阈值的剧烈变化,触发了基于统计偏差的缓存失效),编译流就会进入核心规划器 CypherPlanner.scala。
优化器面临的核心难题是什么? 假设用户写了一句两跳查询:
MATCH (u:User {country: 'CN'})-[:PURCHASED]->(p:Product {sku: 'SKU-9981'})
RETURN u.id
声明式 Cypher 只说了“我要找满足这个关系的 u 和 p”,却没说先找谁!在物理执行时,至少有三种截然不同的走法:
- 从左往右走:先扫出所有
country = 'CN'的用户(假设有 500 万人),再顺着每人的:PURCHASED边向外扩展(Expand(All)),最后检查商品是不是'SKU-9981'; - 从右往左走:先用商品唯一索引一击定位
sku = 'SKU-9981'的那 1 个商品节点(NodeUniqueIndexSeek),再顺着:PURCHASED入边反向扩展出买过它的几十个用户,最后检查u.country = 'CN'; - 两头同时找再汇合:左边用索引找出用户,右边用索引找出商品,中间用
NodeHashJoin或Expand(Into)碰撞连接。
显而易见,走法 2 只需几十次记录读取,而走法 1 要遍历上千万条边!为了自动挑出走法 2,CypherPlanner 在内部将 AST 转化为查询图(Query Graph, QG),并利用三类核心机制完成基于成本的规划(Cost-Based Optimization):
- O(1) 内核计数存储(Counts Store)与选择率估计:
Neo4j 在存储引擎内部专门维护了一个极轻量的 Counts Store,实时精确记录每个标签的节点总数(如
count(:User))、每种关系类型的边总数(如count(()-[:PURCHASED]->()))以及带单端标签的关系数(如count((:User)-[:PURCHASED]->()))。配合索引采样的属性唯一值分布,优化器为每个谓词计算选择率因子 ,并按乘法估算算子输出基数: - 迭代动态规划搜索连接顺序(Iterative Dynamic Programming, IDP):
当一个
MATCH包含七八个节点和关系模式时,所有可能的连接顺序与扩展方向呈阶乘级增长。Neo4j 采用 IDP 算法(在经典 System R 自底向上动态规划与贪心启发式之间取得平衡):将复杂模式切分为可管理的子问题块(默认每次在受控大小的子图组件内跑动态规划枚举最优子计划,挑选出代价最低的胜出计划简化查询图后,再迭代进入下一轮规划),从而在几毫秒的编译预算内找到接近全局最优的逻辑计划树(LogicalPlan)。 - 三大核心图扩展算子的精妙分工:
在生成的逻辑计划树中,最常出现也最体现图数据库特色的三个算子是:
Expand(All):已知一端节点 ,顺着关系链表找出另一端尚未绑定的所有邻居节点 (代价正比于 的局部度数);Expand(Into):当一条关系的两端节点 和 都已经在前面的步骤中被绑定好了(例如形成三角形闭环,或者两头都通过高选择率索引定位好了),引擎省去了全量扫出 和 所有邻居再做笛卡尔积的笨办法,直接调用Expand(Into)——自动挑选 和 中度数较小(尤其是把非密集节点优先于密集节点)的那一端,顺着它的关系链快速探测是否存在直接连向另一端的边!NodeHashJoin:当左右两套独立子模式各自都很庞大、但通过某个公共连接节点汇合时,先为左子树构建内存哈希表,再流式探测右子树,用空间换时间打破深层嵌套循环。
3.3 Slotted Runtime 内存槽位布局与 PROFILE 慢查询解剖刀
拿到逻辑计划树后,下一步是编译为可执行物理算子。如果采用最朴素的解释执行器(每走一步都 new 一个 scala.collection.immutable.Map[String, AnyValue] 来存当前行的变量绑定),一条扫描百万行的查询每秒会制造出几千万个短命 JVM 对象,直接触发疯狂的 GC 停顿。
为此,社区版默认搭载的 Slotted Runtime 做了一次极其硬核的内存布局优化:
- 在编译期,规划器遍历整棵逻辑计划树,统计出现过的所有变量,并为它们在一条紧凑的双数组槽位行(Slotted Row)中分配静态数组下标:
long[] longSlots:直接用原生 64 位long存放所有节点 ID、关系 ID 及布尔标记,彻底做到零装箱(Zero Boxing)!AnyValue[] refSlots:存放读取上来的字符串、数组、路径或复合属性对象引用。
- 在运行期,算子之间直接传递固定大小的
longSlots偏移游标,只有当算子真正需要读取某个节点的属性值(如u.name)时,才拿着longSlots[offset]里的节点 ID 去调用内核存储游标按需延迟加载(Lazy Property Loading)。而在企业版的 Pipelined Runtime 中,更进一步把相邻算子融合进同一个循环管线,按固定大小的 Morsel 数据块(如一批 1024 行槽位数组)在 CPU L1/L2 Cache 内批量流转,并支持只读查询的多核并行分片执行(Parallel Runtime)。
在工程实战中,当我们遇到慢查询时,只需在语句前加上 PROFILE,就能拿到如下图所示的完整执行解剖报告:
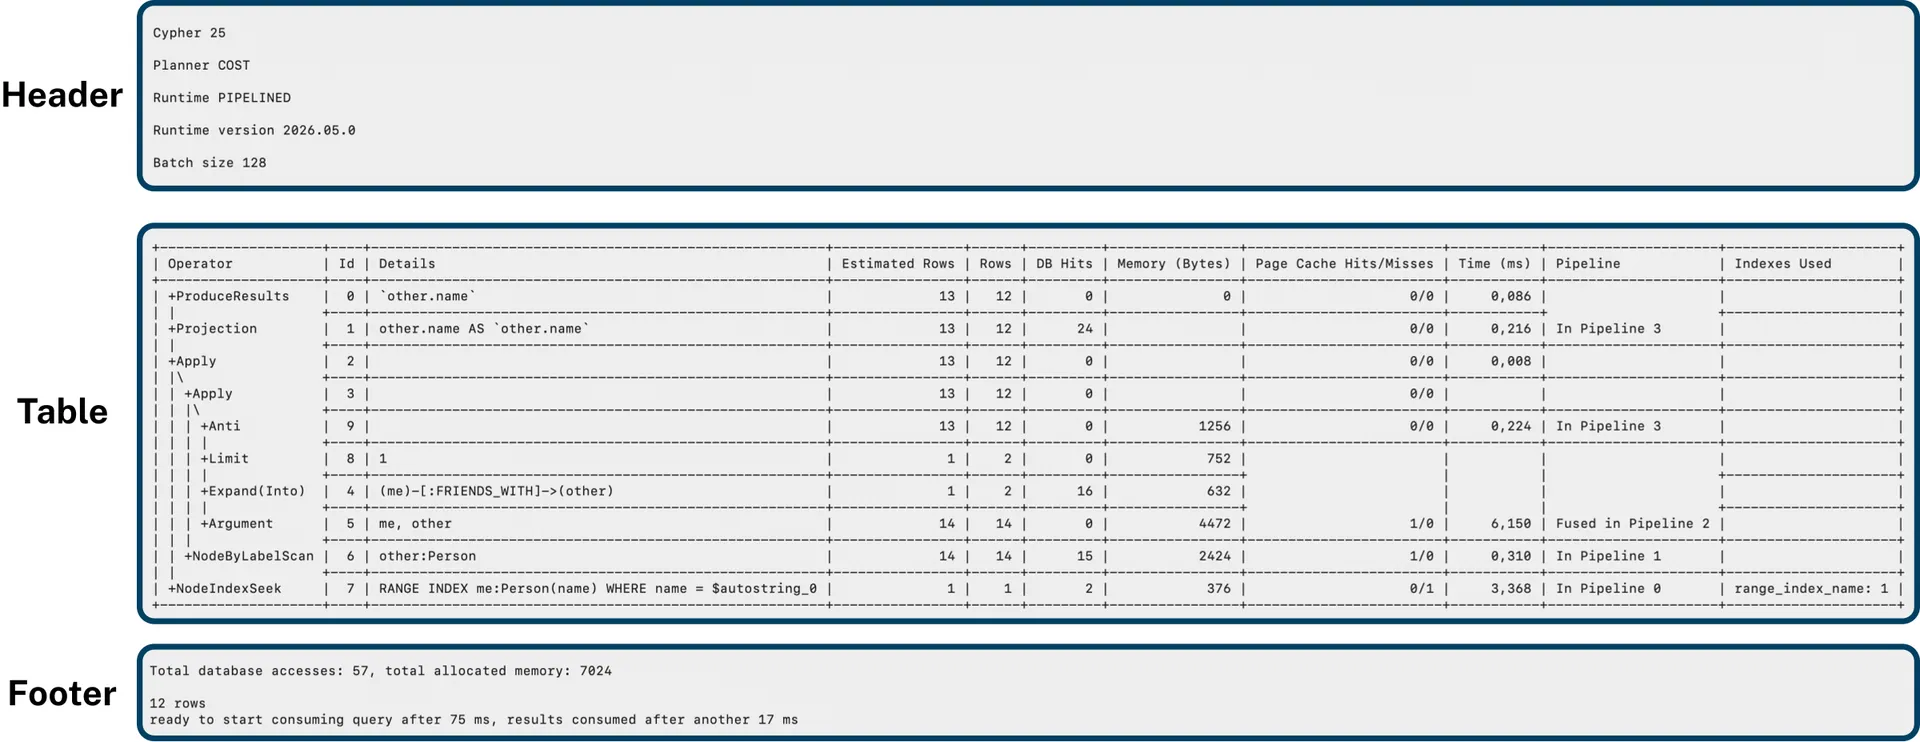
怎么像内核工程师一样在 30 秒内从 PROFILE 图表里揪出真凶?记住以下四条黄金判据:
- 盯紧
Estimated Rows与实际Rows的剪刀差:如果优化器预估某一步只有10行,实际却跑出了500,000行,说明两个过滤条件之间存在强正相关(独立性假设失效)或统计信息过时,导致优化器选错了起始锚点或误用了嵌套循环; - 盯紧
DB Hits暴增的那个算子:DB Hits代表算子向存储引擎请求读取节点、关系、属性或索引单元的逻辑次数。如果某个Filter或Expand(All)的DB Hits高达数千万,说明你正在超级节点上盲目扫边,或者在没有索引的属性上做全表属性拉取; - 盯紧
Page Cache Hits / Misses:如果DB Hits高但Page Cache Misses为 0,说明只是纯内存指针遍历;如果出现大量Misses,说明热图工作集已经超出了堆外页缓存server.memory.pagecache.size,正在发生昂贵的磁盘随机读; - 揪出名为
Eager的管线截断器(Pipeline Breaker):正常流式算子是读一行、算一行、吐一行;但如果读写混合查询中存在“后面的CREATE/DELETE可能会改变前面MATCH正在扫描的数据集”(万圣节问题,Halloween Problem),或者遇到了全局Sort/ 未带键分组的聚合,编译器会强行插入一个Eager算子——把前面所有上游产出的百万行数据一次性全量物化在 JVM 堆内存里再往下走,这也是生产环境查询触发MemoryPoolOutOfMemoryError的头号元凶。
4. 核心设计哲学三:定长记录算术寻址、双向关系链表与堆外页缓存
现在我们潜入 Neo4j 最让人着迷的深水区:打开 community/record-storage-engine,看看免索引邻接在磁盘字节层面到底是怎么长出来的。
4.1 RecordStorageEngine:为什么定长记录能把图遍历变成一条乘法公式?
为了把事务协议与物理文件格式解耦,community/kernel-api 定义了 StorageEngine.java SPI。在社区版开源仓库中,它的核心实现是 RecordStorageEngine.java(对应 aligned 存储格式)。
一个极具启发性的设计问题是:一个节点可能挂着 0 个属性,也可能挂着 50 个属性、甚至一段 10KB 的长文本,怎样才能让节点和关系的查找达到 数组级的速度?
Neo4j 的答案是:彻底实行“拓扑骨架与变长属性分离”,把拓扑骨架强制塞进严格定长的二进制记录槽位里!
neostore.nodestore.db (定长 15 Bytes/条, aligned 格式按页对齐)
+--------+----------------+----------------+----------------+------------+
| in_use | next_rel_id    | next_prop_id   | inline_labels  | extra_flag |
+--------+----------------+----------------+----------------+------------+
    |            |                 \-------------------------------+
    |            v  O(1) 算术偏移跳转                               |
    |     neostore.relationshipstore.db (定长 34 Bytes/条)          v
    |     +--------+--------+--------+------+-----------+-----------+-----------+-----------+
    |     | in_use | first  | second | type | first_prev| first_next| sec_prev  | sec_next  |
    |     |        | node   | node   | id   | rel_id    | rel_id    | rel_id    | rel_id    |
    |     +--------+--------+--------+------+-----------+-----------+-----------+-----------+
    |                                                                             |
    +-----------------------------------------------------------------------------+
                                                                                  v
                                                 neostore.propertystore.db (定长 41 Bytes/条)
                                                 +--------+-----------+-----------+-------------------+
                                                 | in_use | prev_prop | next_prop | 4x8B prop_blocks  |
                                                 +--------+-----------+-----------+-------------------+
                                                                                          | (超长溢出)
                                                                                          v
                                                                               Dynamic String/Array Store
对照上面的物理存储布局,来看看这套定长文件家族是如何协同工作的:
- 一行乘法算出磁盘字节偏移量:
因为
NodeStore中的每一条记录都是严格固定长度(基础结构 15 字节,aligned格式下确保记录绝不跨内存页边界),RelationshipStore中的每一条记录也是严格固定长度(基础结构 34 字节)。因此,内部节点 ID 或关系 ID 根本不需要走任何索引树映射表——ID 为id的节点或关系,在对应文件中的物理字节偏移量直接由算术公式给出: 这意味着,只要拿到了 ID10086,CPU 算一次乘法加一次加法,就知道它躺在文件的第几个 Page 的第几个字节上! - 节点记录(Node Record)怎么设计的?
每个节点记录极其苗条:只存 1 个
inUse标志位、指向该节点第一条关联关系的指针nextRelId、指向该节点第一个属性记录的指针nextPropId,以及 5 字节的labels字段(如果一个节点的标签少于等于 4 个,标签 Token ID 直接内联编码在这 5 个字节里,连外部表都不用查;只有标签极多时才指向 Dynamic Label Store)。 - 关系记录(Relationship Record)为什么存了两条双向链表?
这是
RecordStorageEngine最核心的工程设计!一条有向关系 连接源节点firstNode(设 ID 为 )和目标节点secondNode(设 ID 为 )。因为这条关系 既是节点 的出边,又是节点 的入边,为了做到“存一份关系记录,同时支持从 出发遍历和从 出发遍历”,每条关系记录内部同时内嵌了两套独立的双向链表指针:firstPrevRelId与firstNextRelId:将所有以 为端点的关系串成属于 的双向链表;secondPrevRelId与secondNextRelId:将所有以 为端点的关系串成属于 的双向链表! 因此,当你从节点 出发寻找它的所有邻居时,先读 的nextRelId拿到第一条关系 ,然后判断 在 里是firstNode还是secondNode——如果是firstNode,下一跳就顺着firstNextRelId走;如果是secondNode,下一跳就顺着secondNextRelId走!相比单向链表,双向链表的核心优势在于:当你要删除中间某条关系 时,可以在 时间内直接修改前后邻居 和 的指针完成摘除,无需从头遍历整条关系链。
- 属性记录(Property Record)与内联短值优化:
当查询真正需要读取属性时,才顺着节点或关系的
nextPropId跳进PropertyStore。每条属性记录(41 字节)内部包含 4 个 8 字节的PropertyBlock。如果是布尔值、整数、浮点数、日期时间,甚至是较短的 UTF-8 字符串或短小数组,引擎会通过紧凑位编码直接内联存放在这 4 个 8 字节块中,一次页读取就能拿出多达 4 个属性;只有超长文本或大数组才会将指针指向外部的DynamicStringStore或DynamicArrayStore。
4.2 密集节点(Dense Node)与 RelationshipGroupStore:如何拆解超级节点的长链?
顺着上面的链表设计往深处想,你一定会发现一个致命的极端情况(Edge Case):
假设节点 是一个拥有 100,000 条 :FOLLOWS 粉丝边、但只有 2 条 :WORKED_AT 雇主边的大 V 用户。如果这 100,002 条边全都混在上面那条单一的双向链表里,当查询问出 MATCH (u)-[:WORKED_AT]->(company) 时,存储游标岂不是要在链表上苦苦遍历十万条毫不相干的 :FOLLOWS 边,才能找到那 2 条 :WORKED_AT 边?!
为了解决这个痛点,RecordStorageEngine 引入了密集节点自动分桶机制(Dense Node):
- 当一个节点关联的边数量少于阈值(默认配置
db.relationship_grouping_threshold = 50)时,它是普通稀疏节点,nextRelId直接指向单条合并的关系双向链表,节省空间; - 一旦该节点的度数突破 50 条边,内核会自动将节点的
dense标志位置为1,此时节点的nextRelId转为指向RelationshipGroupStore(关系组存储文件)中的第一个分组记录! - 在
RelationshipGroupStore中,内核将该节点的所有关联边按照关系类型(type)进行分组,并在每个分组记录内部进一步拆出三个独立的链表头指针:firstOut(该类型下的所有出边链表头)firstIn(该类型下的所有入边链表头)firstLoop(该类型下自环边链表头)
这样一来,哪怕大 V 节点挂了十万条 :FOLLOWS 入边,当我们查询他的 :WORKED_AT 出边时,游标只需在寥寥几个 RelationshipGroupRecord 中找到 type = WORKED_AT 的分组头,顺着 firstOut 指针一跳就能直接拿到那 2 条目标边,把十万次无效遍历瞬间降为 2 次!
4.3 MuninnPageCache:为什么不用 OS mmap,而要手写堆外乐观锁页缓存?
所有这些定长存储文件和索引文件,在内存中由 MuninnPageCache.java(以北欧神话中奥丁的“记忆渡鸦” Muninn 命名)统一管理。它将磁盘文件切分为固定 8 KiB 的内存页(Page),常驻在 JVM 堆外内存(Off-Heap Memory)中。
这里有两个非常深刻的架构追问:
- 为什么不用操作系统自带的
mmap或 Page Cache,非要自己用堆外内存写一套MuninnPageCache? 因为数据库有两条铁律:第一是 WAL 先行落盘纪律——操作系统mmap会在后台随时擅自把脏页刷回磁盘,数据库根本拦不住,一旦脏页比 WAL 日志先落盘时发生断电,崩溃恢复就会彻底损坏数据;而MuninnPageCache完全掌控每一个 8 KiB 页面的刷盘时机。第二是无 GC 抖动与原子裁剪——使用堆外直接内存(Unsafe / MemorySegment),几百 GB 的图缓存完全不会增加 JVM 垃圾回收器的扫描负担。 - 多个读线程和一个写线程同时访问同一个 8 KiB 页面,怎么避免加重量级互斥锁?
在图遍历中,每秒钟有成百上千万次
PageCursor跨记录跳转。如果每次读一条 15 字节的节点记录都要对 8 KiB 页面加ReentrantReadWriteLock,多线程在多核 CPU 上光是争抢锁缓存行(Cache Line Bouncing)就会把性能拖垮。 因此,MuninnPageCache为读游标设计了基于序列计数器的无锁乐观读取协议(Sequence Lock / Optimistic Lock):
当写线程修改页面时,会递增页面头部的奇偶版本号;读线程在读取那 15 或 34 字节的前后完全不加阻塞锁,只通过// 读线程读取定长记录的标准乐观重试循环范式 do { readRecord(cursor, record); } while (cursor.shouldRetry());cursor.shouldRetry()检查读取期间该页面版本号是否发生了并发写入变化或页面驱逐——如果没有变化(99.99% 的情况),直接零锁开销拿走数据;如果恰好撞上并发写导致读到了撕裂字节(Torn Read),只需在原地立刻重读一次该记录即可!配合 Clock-Sweep 页面替换算法,若记页缓存命中次数为 、缺页中断(Page Fault)次数为 ,系统的有效访问速度直接取决于页缓存命中率:
5. 核心设计哲学四:事务叠加视图、WAL 预写日志、GB+Tree 与混合索引
5.1 KernelTransactionImplementation:一条边的增删如何保证 ACID 与死锁自愈?
在图数据库里,写事务的并发控制比关系型数据库微妙得多。思考一个最简单的写操作:CREATE (a)-[:KNOWS]->(b)。
在物理存储上,它绝不单单是在 RelationshipStore 末尾追加一条新记录——它还必须修改节点 a 的 nextRelId(或将新关系插入 a 的关系组链表头部并修改原头关系的 prevRelId),同时修改节点 b 的关系链表指针!
在 KernelTransactionImplementation.java 中,一次读写事务是如何安全走完一生的?
1. beginTransaction() -> 分配事务快照与空 TransactionState (JVM Heap)
2. 事务内读写执行:
   - 写操作: 获取目标节点/关系的排他锁 (Exclusive Lock),将变更记录在私有 TransactionState 中 (此时不改 MuninnPageCache)
   - 读操作: 内核 Cursor 自动将 [底层 MuninnPageCache 页面] + [当前事务私有 TransactionState] 实时合并为叠加视图 (Read-Your-Own-Writes)
3. prepare & validate -> 校验唯一性约束,将内存态 TransactionState 编译为物理 StorageCommands (NodeCommand, RelationshipCommand, PropertyCommand...)
4. TransactionLogWriter -> 将事务 Command 列表顺序追加写入 WAL 日志文件并执行 fsync/force 持久化边界
5. StorageEngine.apply() -> 将 Commands 真正写入 MuninnPageCache 内存页、Counts Store 与各类索引
6. close / releaseLocks() -> 递增已提交事务水位,释放持有的所有实体锁与 Schema 锁
这里有三个必须吃透的内核细节:
- 为什么未提交的修改要先存在堆内存
TransactionState里,等COMMIT时才写进MuninnPageCache? 这叫延迟物化(Deferred Materialization / Steal-No-Force 的变体)。如果在事务刚写到一半时就直接去改共享的MuninnPageCache内存页,一旦事务中途报错执行ROLLBACK,还得在并发环境下把双向链表指针一个个逆向恢复回去;而把未提交增量隔离在事务私有的TransactionState中,不仅让其他并发读事务天然只能看到已提交状态(Read Committed 隔离级别),而且万一事务回滚,只需直接丢弃内存中的TransactionState对象并释放锁,回滚开销几乎为零! - 并发给同一个节点加边为什么会锁竞争甚至死锁?
因为给节点
a和b之间增删一条关系,必须修改a和b的关系链表头指针,所以内核必须对端点a和b加排他锁(针对密集节点的并发加边,内核做了锁粒度细化优化,但在普通节点或属性更新时仍需锁住端点)。如果事务 先锁住了节点a、再去请求节点b的锁,而同一时刻事务 先锁住了节点b、再去请求节点a的锁,就会形成等待环路(Deadlock)。此时 Neo4j 内置的锁管理器(Forseti Lock Manager)会立即检测到环路,主动挑选其中一个事务抛出瞬态死锁异常(DeadlockDetectedException,标记为TransientError),由官方客户端驱动捕获后通过事务函数(session.executeWrite(...))自动带指数退避重试。
5.2 WAL 顺序不变量、Checkpoint 与崩溃恢复窗口
为什么事务提交时不直接把修改后的 NodeStore、RelationshipStore 8 KiB 内存页刷回磁盘,而要先调 TransactionLogWriter.java 写事务日志?
因为一次写事务可能改动了散落在几十个不同文件位置的节点、关系和属性页,随机刷写几十个 8 KiB 数据页需要几十次随机磁盘 I/O;而把本次事务生成的物理存储命令(StorageCommand,内部同时记录了修改前的 before 镜像与修改后的 after 镜像)打包成一条连续字节流,顺序追加到事务日志文件末尾并执行一次 fsync(或批量 Group Commit),只需要一次顺序磁盘 I/O!
这严格遵循数据库内核的 Write-Ahead Logging 铁律(WAL)——描述事务修改的日志记录,必须先于被该事务污染的数据页落盘之前到达持久化存储:
只要日志落了盘,哪怕下一毫秒服务器拔电源断电,MuninnPageCache 里还没来得及刷盘的脏页全丢了也毫无关系。为了防止重启时从创世第一条事务开始重放,后台线程会定期执行 Checkpoint:协调 MuninnPageCache 把截至某个已提交事务 ID 之前的所有脏页全部刷写落盘,并在日志里盖一个指向 的章。当实例意外崩溃(设崩溃前最后一条成功写入 WAL 的事务为 )并重新启动时,恢复引擎只需顺序扫描半开区间内的事务日志并重放其 StorageCommand:
5.3 多维索引矩阵:GBPTree 世代写时复制、Lucene BM25 与 vector-2026.06 HNSW
免索引邻接解决了“找到起点之后怎么顺着边跳”,但怎么在十亿个节点里用 1 毫秒抓出那个起始锚点?这就全靠 Neo4j 的六大索引子系统了:
| 索引类别 | 索引名称 | 底层物理结构与源码入口 | 核心解决的查询痛点 |
|---|---|---|---|
| 结构与精确搜索索引 | Token Lookup Index | 内核原生 GBPTree 位图映射 | 快速找出所有带 :User 标签的节点或所有 :PURCHASED 类型的边(默认自动存在) |
| 结构与精确搜索索引 | Range Index | 原生 GBPTree() | 等值查找(u.id = $id)、区间比较(> / <)、前缀匹配(STARTS WITH)与唯一性约束支撑 |
| 结构与精确搜索索引 | Text Index | 专用三元组/子串原生索引结构 | 专门加速 CONTAINS 与 ENDS WITH 精确子串过滤(不做自然语言分词) |
| 结构与精确搜索索引 | Point Index | 原生空间填充曲线(Hilbert 曲线)+ GBPTree | 二维/三维地理坐标(WGS-84 / Cartesian)球面距离与矩形包围盒检索 |
| 语义与近似检索索引 | Full-Text Index | Apache Lucene 10.4.0 倒排索引(FulltextIndexProvider) | 跨多标签、多文本属性分词检索、模糊匹配与 BM25 相关性排序(支持异步最终一致更新) |
| 语义与近似检索索引 | Vector Index | Lucene 10.4.0 HNSW 多层近邻图(VectorIndexProvider) | 1~4096 维稠密向量 ANN 相似检索、量化压缩与标量属性预过滤(Cypher 25 原生 SEARCH 子句) |
在这六类索引中,有两项底层实现非常值得细品:
- 为什么 Neo4j 的原生 B+Tree 叫
GBPTree(Generation-Aware B+Tree)? 在传统数据库中,B+Tree 发生节点分裂(Split)或合并(Merge)时,必须写极其复杂的物理/逻辑混合 WAL(ARIES 协议中的 Nested Top Actions),否则崩溃重启时树指针断成两截就无法恢复。 Neo4j 团队在community/index中独创了带世代双指针的GBPTree:每个 Checkpoint 周期对应一个递增的世代号(Generation),将上一轮已经安全落盘的旧世代记为stable generation,当前正在内存中修改的新世代记为unstable generation。树节点内部的每一个逻辑指针(如父指子、左指右兄弟)在物理上都占据两个槽位(Slot A 与 Slot B),分别附带各自的世代号与校验和! 当新事务修改树结构或触发节点分裂时,严禁原地覆盖属于stable generation的旧页面和旧指针槽位,转而从空闲列表分配新页面,并把新指针写入另一个unstable槽位(本质上是细粒度到指针槽位级的 Copy-on-Write)。这样一来,万一在两个 Checkpoint 之间发生断电崩溃,重启后的GBPTree只要忽略所有世代号大于最近一次成功 Checkpoint 的unstable指针槽位,整棵树瞬间原地回退到上一次 Checkpoint 时的 100% 一致状态,然后再重放 窗口内的逻辑索引更新即可! - BM25 全文检索与
vector-2026.06HNSW 向量检索如何赋能 GraphRAG? 在构建像前两篇精读的 OpenSPG KAG 或 Graphiti / Zep 这样的知识图谱系统时,每次实体消歧和混合检索都需要同时调用全文 BM25 与向量余弦相似度: 过去开发者不得不额外部署一套 Elasticsearch 或 Milvus,再写繁琐的双写同步代码把外部向量库的 ID 跟 Neo4j 里的节点 ID 对齐。而在 Neo4j2026.06中,community/lucene-index直接把 Lucene10.4.0的倒排索引与 HNSW 向量图深度集成进了内核事务生命周期——最新的vector-2026.06provider 不仅支持在创建向量索引时开启整型量化压缩与标量属性联合索引,还允许在 Cypher 25 中直接使用声明式的SEARCH子句(取代了早期笨重的CALL db.index.vector.queryNodes存储过程),在一个查询计划内无缝完成“向量 ANN 找锚点 + 标量预过滤 + 免索引邻接多跳扩展”!
6. 分布式集群拓扑、端到端工程实战与知识图谱底座全景
6.1 高可用集群架构与因果书签(Causal Chaining Bookmarks)
当单机吞吐或可用性需要升级到企业级多副本集群时,Neo4j 是如何在多台机器间同步图事务,并保证读写分离时不读到过期数据的?
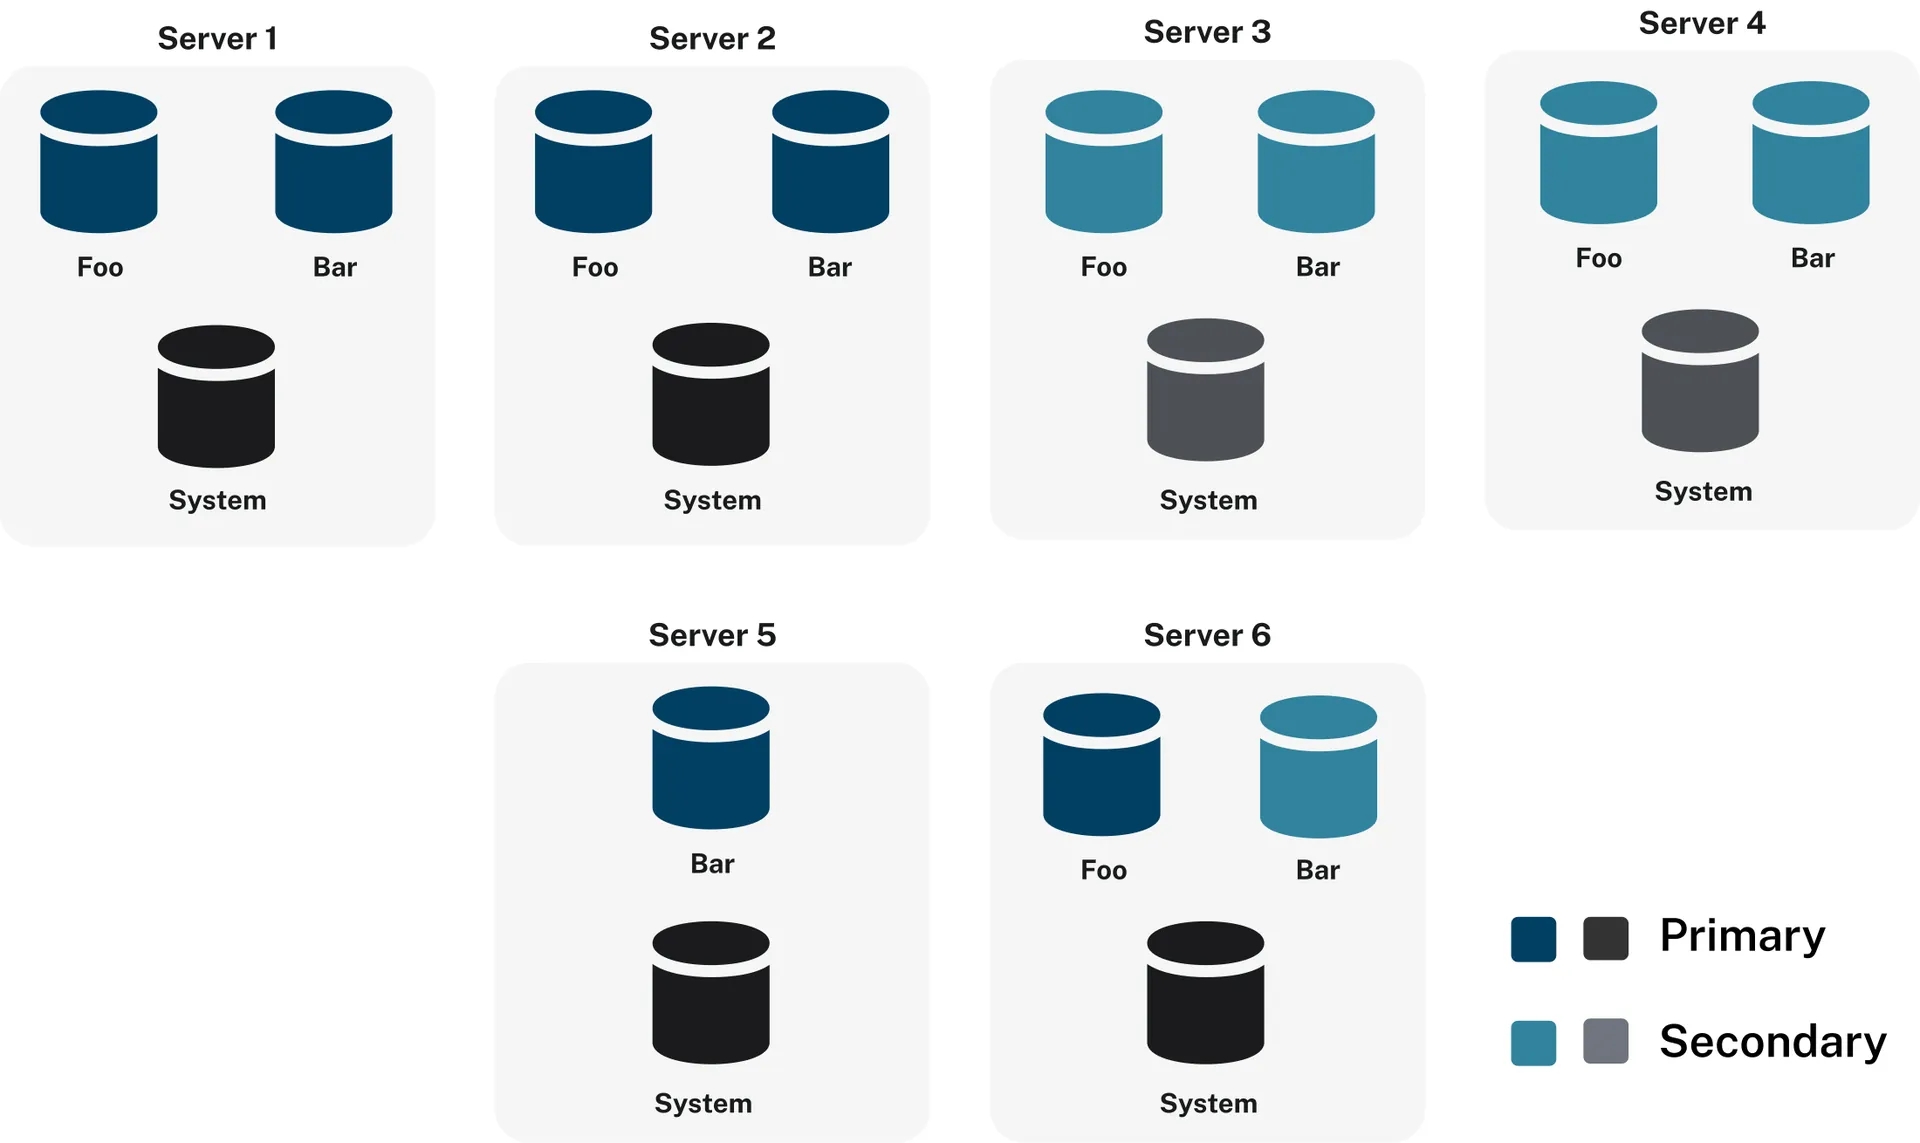
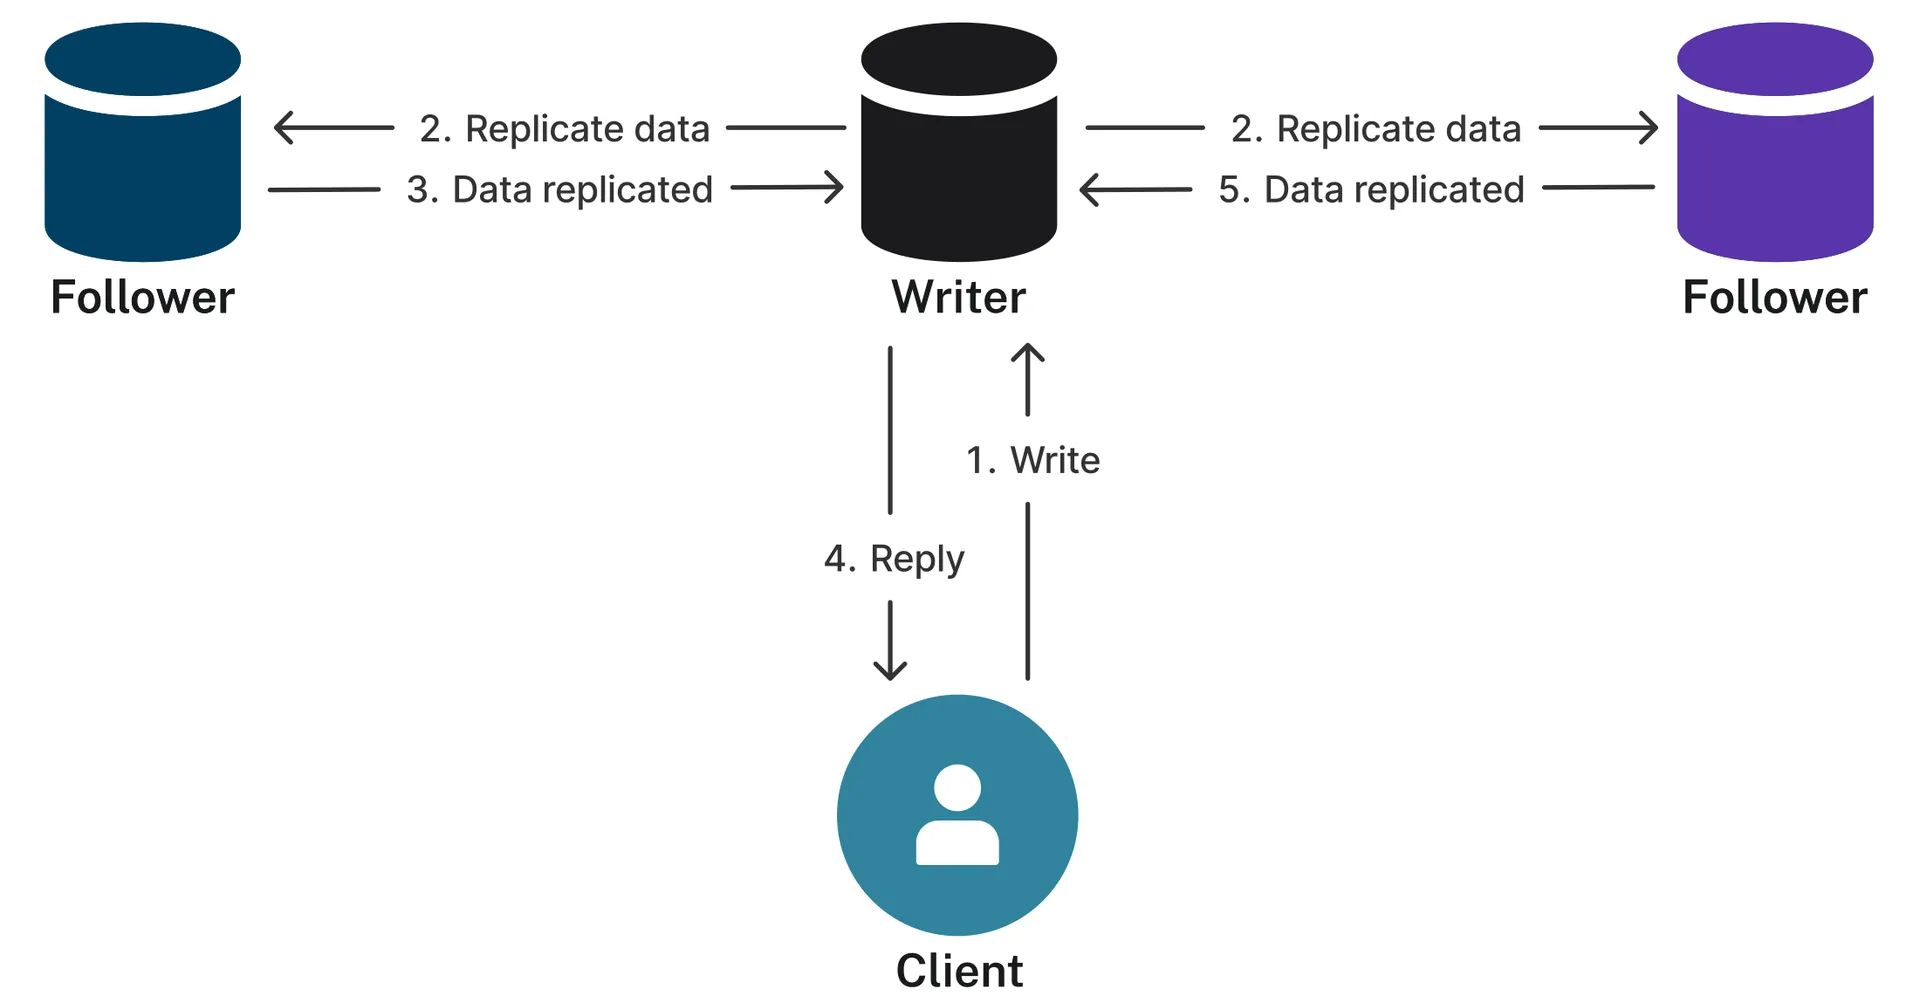
看上方两张官方集群拓扑图:
- Raft 共识复制的是什么? 集群中的 Primary(Leader / Follower)节点之间通过 Raft 共识协议复制的,正是我们在第 5 节剖析过的由
StorageCommand组成的事务日志流(Transaction Representation)!写事务全部由驱动路由到当前数据库的单一 Writer(Leader)节点执行锁校验与命令生成,一旦日志条目在 Raft 多数派节点落盘即完成提交;而 Secondary(Read Replica)节点则异步拉取事务日志流重放,用于水平扩展大规模只读图查询。 - 读写分离下怎么保证“刚创建的节点,下一毫秒在从库一定能查到”?
如果用户刚在 Writer 节点提交了一条写事务
CREATE (u:User {id: 'u1'}),紧接着发起一次读请求被路由到了稍微落后的 Follower 节点,直接读取就会出现“刚注册完却查不到自己”的尴尬。为此,Neo4j 设计了极轻量却极其可靠的因果书签(Causal Chaining Bookmarks): 每次写事务在 Writer 上成功提交后,服务端都会随响应返回该事务对应的单调递增事务日志位置 ID(Bookmark);当客户端驱动使用同一个 Session(或显式传递该 Bookmark)向任意 Follower 发起后续读请求时,会在 BoltBEGIN消息中顺带把这枚 Bookmark 传过去。目标 Follower 收到请求后,会检查本地已重放的最新事务 ID 是否已经大于等于该 Bookmark——如果还差两条日志没追上,Follower 会自动在本地等待几毫秒直到该事务日志重放完毕后再打开读快照,从而在不牺牲读扩展性的前提下实现了严格的因果一致性(Causal Consistency)。
6.2 端到端 Cypher 工程实战与六大慢查询防坑指南
把前面的内核原理全部融会贯通后,我们来看如何在生产代码中写出真正贴合 CypherPlanner 与 RecordStorageEngine 脾气的工业级 Cypher:
第一招:唯一约束先行,且 MERGE 括号内永远只放唯一主键。
-- 1. 建立唯一约束(底层自动创建 GBPTree 唯一索引,提供 O(log N) 的 NodeUniqueIndexSeek 入口)
CREATE CONSTRAINT user_id_unique IF NOT EXISTS FOR (u:User) REQUIRE u.id IS UNIQUE;
CREATE CONSTRAINT item_id_unique IF NOT EXISTS FOR (i:Item) REQUIRE i.id IS UNIQUE;

-- 2. 正确的幂等写入:MERGE 里只写唯一键,可变属性一律放在 ON CREATE SET / SET 中
MERGE (u:User {id: $userId})
  ON CREATE SET u.createdAt = datetime()
SET u.lastActiveAt = datetime(), u.tier = $tier

MERGE (i:Item {id: $itemId})
SET i.title = $title, i.embedding = $embedding

MERGE (u)-[r:INTERACTED]->(i)
SET r.weight = $weight, r.updatedAt = datetime()
为什么要严禁写出 MERGE (u:User {id: $userId, tier: $tier})?因为 MERGE 的语义是“全图匹配括号里的所有属性,只要有一个属性对不上就尝试 CREATE 一个全新的节点”!一旦用户的 tier 从 'SILVER' 升到了 'GOLD',把可变属性塞进 MERGE 会导致引擎判定找不到匹配的旧节点,转而尝试新建一个相同 id 的节点,当场触发唯一约束冲突报错!
第二招:跨系统事务一致性——用事务内 :OutboxEvent 节点消灭分布式双写不一致。
当业务既要在 Neo4j 里扣减额度创建订单关系,又要发 Kafka 消息通知下游时,切忌在数据库事务闭包里直接调外部网络接口(不仅拉长锁持有时间引发死锁雪崩,而且一旦网络超时回滚会导致两边状态劈叉)。最稳妥的做法是利用 KernelTransaction 的原子性,在同一个事务里顺手写一个 :OutboxEvent 节点,并且所有幂等 UUID 必须在客户端重试闭包之外预先生成(如 $orderId、$eventId):
MATCH (u:User {id: $userId})
WHERE u.quota >= $amount
SET u.quota = u.quota - $amount
CREATE (o:Order {id: $orderId, amount: $amount, createdAt: datetime()})
CREATE (u)-[:PLACED]->(o)
CREATE (:OutboxEvent {
  id: $eventId,
  topic: 'ORDER_CREATED',
  payloadId: $orderId,
  createdAt: datetime()
})在此基础上,我们将日常图数据库慢查询治理浓缩为六条可直接落地的工程铁律:
- 给一切可变长路径戴上跳数紧箍咒:单步指针跳转虽是 ,但 跳状态数是 。线上 OLTP 查询严禁出现无上界的
[:REL*],必须显式限制如[:REL*1..4],且尽量使用 Cypher 25 的量化路径模式在每一跳内部立刻过滤掉不合规节点。 - 善用
WITH提前拍扁聚合基数:当需要同时统计同一实体的多个一对多维度(如既统计发帖数、又统计粉丝数)时,每走完一个维度必须立刻用WITH u, count(x) AS cnt把行数拍回单行,或改用COUNT { (u)-[:FOLLOWS]->() }标量子查询,严防中间表发生隐式笛卡尔积。 - 利用密集节点的“类型 + 方向”分组红利:我们在 4.2 节看到,度数超过 50 的密集节点会在
RelationshipGroupStore中按关系类型 + 方向建立子链表头。因此,线上查询在经过高频节点时,务必在箭头上显式写明具体的关系类型和方向(如-[:PURCHASED]->),避免写无类型无方向的--,否则存储引擎不得不把该节点下的所有关系组链表挨个扫一遍! - 把高频过滤属性下沉或拆分为“分桶节点”(Bucket Nodes):如果一个超级节点挂了 100 万条
[:LOGGED_IN]边,每次查询都要找“2026 年 7 月 20 日当天的登录记录”,由于关系链表本身不按属性排序,哪怕指定了关系类型也要扫遍 100 万条边的PropertyStore。此时把日期拆成中间分桶节点(:User)-[:LOGGED_ON]->(:Day {date: '2026-07-20'})-[:AT_DEVICE]->(:Device),或者把核心维度编码进细粒度关系类型(如:LOGGED_IN_2026_07),就能直接借助RelationshipGroupStore或Expand(Into)把百万次扫描降为常数级。 - 警惕
LIMIT前面的全局ORDER BY/DISTINCT:MATCH ... RETURN n ORDER BY n.score DESC LIMIT 10如果没有命中有序 Range Index,引擎必须先把全量百万个候选节点的score属性从PropertyStore读出来完成全局排序,最后才截断前 10 条。 - 守住堆外
MuninnPageCache与 JVM Heap 的黄金内存配比:千万不要把机器 90% 的内存都分给 JVM Heap!对于图遍历密集型负载,应确保server.memory.pagecache.size足以容纳整张热图的nodestore、relationshipstore与核心GBPTree索引文件,让 99% 以上的指针跳转全部命中堆外内存页。
6.3 知识图谱与 AI 智能体技术栈的三层合龙
读到这里,我们终于可以把本系列的三篇深度源码与论文精读——OpenSPG KAG、Graphiti / Zep 与本文的 Neo4j 数据库内核——拼成一张完整的现代知识图谱与 AI Agent 系统全景图:
+-----------------------------------------------------------------------------------+
|                           顶层:AI Agent / 领域知识问答与决策应用                    |
+-----------------------------------------+-----------------------------------------+
                                          |
            +-----------------------------+-----------------------------+
            v (静态严肃领域规程与多跳逻辑计算)                             v (流式对话事件与跨会话动态状态跟踪)
+-----------------------------------------+   +-----------------------------------------+
|   左翼知识求解层:OpenSPG KAG             |   |   右翼动态记忆层:Graphiti / Zep         |
| - 概念层 KG_cs + 事实层 KG_fr + 原文块 RC |   | - Episode / Entity / Community 三层子图 |
| - 符号逻辑形式 (Logical Form) 规划与求解   |   | - 四维双时态边 (valid/invalid/created/   |
| - 混合多跳推理、数值计算与 3 轮自我反思     |   |   expired) 与去 LLM 化的百毫秒级混合检索  |
+-----------------------------------------+   +-----------------------------------------+
            \                             |                             /
             \                            v                            /
              +-------------------------------------------------------+
              |         统一查询与混合检索接口:Cypher 25 / Bolt        |
              |  (精确图模式 MATCH + Lucene BM25 全文 + HNSW 向量检索)  |
              +-------------------------------------------------------+
                                          |
                                          v
+-----------------------------------------------------------------------------------+
|                        底座存储与事务执行引擎:Neo4j 图数据库内核                     |
| - 编译优化:CypherPlanner (Count Store 统计 + IDP 成本规划) -> Slotted/Pipelined   |
| - 物理存储:RecordStorageEngine 定长记录 O(1) 算术偏移 + 双向关系链 + 密集节点分组   |
| - 事务缓存:KernelTransaction 叠加视图 + WAL 预写日志 + MuninnPageCache + GBPTree  |
+-----------------------------------------------------------------------------------+
为什么说这三套系统代表了图技术与大模型结合的三个互补维度?
| 架构层次与代表系统 | 它回答的核心问题(Why) | 核心数据结构与数学模型 | 关键工程权衡(Trade-off) |
|---|---|---|---|
| 底座存储层:Neo4j | 怎么在百亿节点边上实现毫秒级指针跳转与 ACID 事务安全? | 七元组属性图 + 定长物理记录文件 + 双向关系链表 + GBPTree / HNSW | 用定长记录与双向链表换取 免索引邻接;用内存 TransactionState 叠加视图与 WAL 化解指针并发修改风险 |
| 动态记忆层:Graphiti / Zep | 怎么让图谱跟上每一秒都在变化的流式对话,记住过去又搞清现在? | 三层记忆多图()+ 四维双时态时间戳() | 在异步写入期承担 LLM 抽取与局部端点消歧成本,换取在线查询期“零 LLM 调用”的百毫秒级混合检索与 98.6% Token 压缩 |
| 逻辑求解层:OpenSPG KAG | 怎么消除开放信息抽取的语义噪音,完成严谨的多跳与数值逻辑推理? | DIKW 层次化双层图(概念树 + 事实层 )+ 图文互索引 + 逻辑形式函数 | 用强 Schema 概念对齐与符号化 Logical Form 拆解约束大模型幻觉,通过“图结构优先、原文块兜底”跑通多跳确定性求解 |
当你看懂了 Neo4j 在底层如何用 15 字节的节点记录、34 字节的双向关系链、8 KiB 的 MuninnPageCache 乐观锁页面以及 GBPTree 世代双指针守住每一次跳转的微秒级确定性,再抬头看上层的 Graphiti 如何用四维双时态边管理流式记忆、KAG 如何用符号逻辑形式编排多跳推理,整座现代知识图谱大厦从磁盘字节到智能体认知的每一块齿轮,便严丝合缝地咬合在了一起。
附录:Neo4j 2026.06.0 核心源码模块走读导航
为方便读者顺着本文脉络直接阅读 neo4j/neo4j(2026.06.0 / eccd584a) 源码,下表整理了核心模块与关键入口类:
| 内核子系统 | Maven 模块路径 | 核心精读入口类与职责 |
|---|---|---|
| Bolt 协议与网络层 | community/bolt | BoltServer.java:Netty 通道初始化、4 字节魔数握手、PackStream 编解码与会话状态机 |
| Cypher 词法语法前端 | community/cypher/front-end | Parser、AST 节点定义、语义作用域检查(SemanticCheck)与 AST 规范化重写管线 |
| 查询编译与 IDP 规划器 | community/cypher/cypher | ExecutionEngine.scala、CypherPlanner.scala、QueryCache.scala |
| Slotted 物理运行时 | community/cypher/slotted-runtime | 槽位偏移分配(SlottedPipeMapper)、long[] / AnyValue[] 行布局与 Volcano 流式算子实现 |
| 事务内核与锁管理 | community/kernel | GraphDatabaseFacade.java、KernelTransactionImplementation.java |
| 存储引擎 SPI 与定长存储 | kernel-api, record-storage-engine | StorageEngine.java、RecordStorageEngine.java、Node/Relationship/Property/Group 定长 Store |
| 堆外页缓存与 WAL 日志 | community/io, kernel/.../transaction/log | MuninnPageCache.java、TransactionLogWriter.java |
| 原生树索引与语义索引 | community/index, community/lucene-index | GBPTree.java、FulltextIndexProvider.java、VectorIndexProvider.java |
参考资料
- Nadime Francis et al., Cypher: An Evolving Query Language for Property Graphs, SIGMOD 2018, DOI: 10.1145/3183713.3190657.
- Alastair Green et al., Formal Semantics of the Language Cypher, arXiv:1802.09984.
- 官方开源仓库:neo4j/neo4j(
2026.06.0Tag / Commiteccd584a64d468af3daeab421478fe78567c518f). - 官方技术文档:Neo4j Documentation、Cypher Manual (Cypher 25)、Query Lifecycle & Runtimes、Vector Indexes (
vector-2026.06)、Operations Manual: Store Formats & Transaction Management.
comments