在构建多租户 SaaS、在线协作文档、代码托管平台或企业级 RAG 知识库时,权限控制往往是后端架构中最容易腐化的模块。项目初期,团队通常用简单的 RBAC(基于角色的访问控制)起步:在用户表上挂一个 role = admin | editor | viewer 字段,在接口网关里写几行 if/else 校验。但随着业务向深水区演进,权限规则很快会突破静态角色的表达上限:
- 一个用户虽然是组织成员,但仅对部分项目拥有编辑权;
- 子文档默认继承三级父文件夹的查看权限,同时又允许单独分享给外部合作伙伴团队;
- 团队成员可以读取团队代码仓库,但一旦某人被列入仓库封禁名单或外部顾问合同到期,必须立即阻断访问;
- 在企业级 RAG 检索中,大语言模型生成回答前,必须确保召回的每一个文本分片(Chunk)对当前提问用户都有合法的查看路径。
如果继续用业务数据库的多表 JOIN 和散落在各个微服务里的 if/else 硬编码来应付这些需求,系统会迅速陷入三座泥潭:写时展开风暴(把一个百人团队加入顶层文件夹时,不得不写脚本去更新底下十万篇子文档的 ACL 表,一旦中途失败就会留下脏权限)、逻辑碎片化(权限规则散落在 SQL 视图、中间件和业务代码中,没人能说清某个人为什么能看到某篇文档)以及测试与迁移瘫痪(每次调整组织架构或目录层级,都伴随线上越权泄密或大面积误拒的风险)。
2019 年,Google 在 USENIX ATC 发表了 Zanzibar 论文,首次公开了支撑 Google Docs、Drive、Calendar、Cloud、YouTube 等数十亿级产品统一细粒度授权的底层架构;而 CNCF 生态的 OpenFGA 则将 Zanzibar 的关系授权思想转化为开源、可自托管、支持通用 SQL 数据库与声明式建模语言的工程引擎。
透过论文与源码的表象,Zanzibar 与 OpenFGA 的整套体系建立在四条核心设计哲学之上:
- 将权限判断升维为有向图可达性搜索(Authorization as Directed Graph Reachability):抛弃散落的代码分支与写时权限冗余展开,用极简的关系元组
<object>#<relation>@<user>记录原子事实(指针),用静态版本化的授权模型(schema 1.1)声明继承与集合代数规则。于是,“用户 能否访问资源 ”被严格转化为有向图上的起点到终点可达性搜索问题。 - 用因果快照一致性对抗分布式“新敌人问题”(Causal Snapshot Consistency against the New Enemy Problem):在多副本与缓存架构下,“先踢出前员工、紧接着写入机密文档”极易因权限缓存滞后而导致机密泄露。Zanzibar 设计了不透明一致性令牌 Zookie,结合 Google Spanner 的 TrueTime 外部一致性,让 98% 以上的请求在本地安全快照(
Check Safe)中极速完成,仅在发生权限变更的敏感窗口内触发最新同步读(Check Recent);OpenFGA 则在通用 PostgreSQL/MySQL 之上,通过请求级consistency策略与带模型版本的缓存键,赋予业务在毫秒级低延迟与强实时读取之间按需切换的控制权。 - 用集合代数索引与并发短路驯服深层图扇出(Taming Deep Graph Fan-out via Set Indexing & Short-Circuit Dispatch):深层嵌套用户组(Group-in-Group)和多级目录树会让递归图查询产生指数级扇出。Zanzibar 为此构建了 Leopard 扁平化跳表索引,把多层群组包含转化为 级底层集合求交,并在
aclserver层引入按对象一致性哈希路由、热点请求合并(Deduplication)与长尾对冲(Request Hedging);OpenFGA 则在 Go 引擎内部将or/and/but not编译为受并发度上限与递归深度熔断(默认 25 层)保护的 Goroutine 树,利用context短路取消机制在第一时间剪枝无效分支。 - 静态关系拓扑与动态上下文的正交融合(Orthogonal Fusion of ReBAC Graph and ABAC Context):纯关系图难以表达时间窗口、IP 网段等动态标量约束,纯属性策略(ABAC)又难以表达多层资源拓扑。OpenFGA 通过持久层 Conditions(基于 Google CEL 的类型化条件函数)与请求期 Contextual Tuples(仅在单次请求内存中参与图推导、不落盘的瞬态元组),在不污染底层关系图的前提下实现了 ReBAC 与 ABAC 的无缝合流。
本文将沿着**“Zanzibar 论文机制推导”与“OpenFGA(v1.18.1)+ CLI(v0.7.17)源码工程实现”**双线展开,从关系元组语法、Schema 1.1 建模、图遍历源码执行、Zookie 一致性协议,一路推演到生产级 SaaS 建模、RAG 权限过滤与存量系统平滑迁移。
1. 为什么传统 RBAC 会失效?授权系统的三层正交解耦
1.1 认证、RBAC、ABAC 与 ReBAC 的能力边界
在切入架构细节前,我们先将权限工程中最常交织的五个概念放在同一张坐标系里对齐:
| 核心概念 | 回答的本质问题 | 表达能力的物理上限与典型落点 |
|---|---|---|
| Authentication(身份认证) | 你是谁? | 校验 OIDC、JWT 签名或 Session,产出可信的主体标识(如 user:anne) |
| Authorization(访问授权) | 主体 能否对目标 执行动作 ? | 接收可信主体标识与目标资源,输出布尔放行决策或可访问资源列表 |
| RBAC(基于角色) | 主体拥有什么全局或租户级头衔? | 擅长粗粒度后台角色(super_admin、finance),遇到百万级文档实例与树状目录继承时角色数量会组合爆炸 |
| ABAC(基于属性) | 主体、资源与环境满足什么布尔表达式? | 擅长校验时间段、IP 网段、部门密级等标量属性,但无法高效表达“父文件夹的协作者所在的子团队成员”这类多跳图关系 |
| ReBAC(基于关系) | 主体与资源之间是否存在合法的拓扑关系路径? | 将用户、群组、组织、文件夹、文档统一建模为有向图节点,天然契合多级嵌套继承与跨实体共享 |
为了把复杂的权限逻辑从业务代码中彻底剥离出来,Zanzibar 与 OpenFGA 将授权系统正交拆解为三个互不耦合的层次:
┌───────────────────────────────────────────────────────────────────────────┐
│ 1. 授权模型层 (Authorization Model / Namespace Config)                     │
│    静态声明对象类型与关系推导代数规则:schema 1.1, [user], or, and, but not, from │
└─────────────────────────────────────┬─────────────────────────────────────┘
                                      │ 结合编译期类型图与运行时规则
                                      ▼
┌───────────────────────────────────────────────────────────────────────────┐
│ 2. 关系事实层 (Relationship Tuples + CEL Conditions)                       │
│    存储最小原子拓扑指针:document:roadmap#parent@folder:product             │
└─────────────────────────────────────┬─────────────────────────────────────┘
                                      │ 注入请求期 Contextual Tuples & Context
                                      ▼
┌───────────────────────────────────────────────────────────────────────────┐
│ 3. 图查询求值层 (Graph Query Evaluation Engine)                            │
│    在线并发图遍历与反向展开:Check / Expand / ListObjects / ListUsers       │
└───────────────────────────────────────────────────────────────────────────┘这三层解耦带来的最大工程红利在于:当文件夹移动位置或团队增减成员时,业务系统只需要修改那一条代表拓扑指针的 Tuple( 写入);至于其下属的十万篇子文档权限如何变化,完全由查询引擎在读取时顺着 Authorization Model 定义的有向边动态推导得出,彻底终结了传统 ACL 方案中的写时展开灾难。
1.2 Zanzibar 论文系统与 OpenFGA 开源引擎的架构映射
阅读本文时,理解 Google 内部 Zanzibar 与开源 OpenFGA 的同源机制与基础设施差异至关重要:
| 对比维度 | Google Zanzibar(ATC 2019 论文系统) | OpenFGA(CNCF 开源实现) |
|---|---|---|
| 核心定位 | Google 全球统一 ACL 与关系授权基础设施 | 开源、云原生可自托管的细粒度授权引擎(Go 语言实现) |
| 规则定义语言 | Protobuf 格式的 Namespace Configuration | 声明式 schema 1.1 DSL(编译为内部 Protobuf AST) + CEL 条件表达式 |
| 底层持久存储 | 深度绑定全球分布式数据库 Google Spanner | 可插拔通用存储接口:PostgreSQL、MySQL、SQLite、In-Memory |
| 深层群组加速 | 独立部署的 Leopard 扁平化跳表索引集群 | 依赖递归并发图扇出(internal/graph)、内存 Check/Iterator 缓存与反向模型图裁剪 |
| 一致性控制机制 | 客户端携带不透明令牌 zookie,依托 Spanner TrueTime 保障外部因果一致性 | 请求级 consistency 参数(MINIMIZE_LATENCY 走多级缓存 vs HIGHER_CONSISTENCY 强读主库) |
2. Zanzibar 关系元组模型与 Namespace 推导代数
2.1 Relation Tuple:为什么允许 <user> 字段填入另一个 Userset?
Zanzibar 的全部大厦都建在一种极简的数据结构之上——关系元组(Relation Tuple)。论文第 2.1 节用如下 BNF 范式定义了它的文本语义:
仔细看第三行产生式:元组的 @ 符号右侧既可以是一个具体的自然人 ID(<user_id>),也可以是另一个形如 <object>#<relation> 的用户集合(Userset)!这处看似简单的递归定义,正是关系授权模型能够统一表达“直接授权”、“群组嵌套”与“树状资源继承”的灵魂所在:
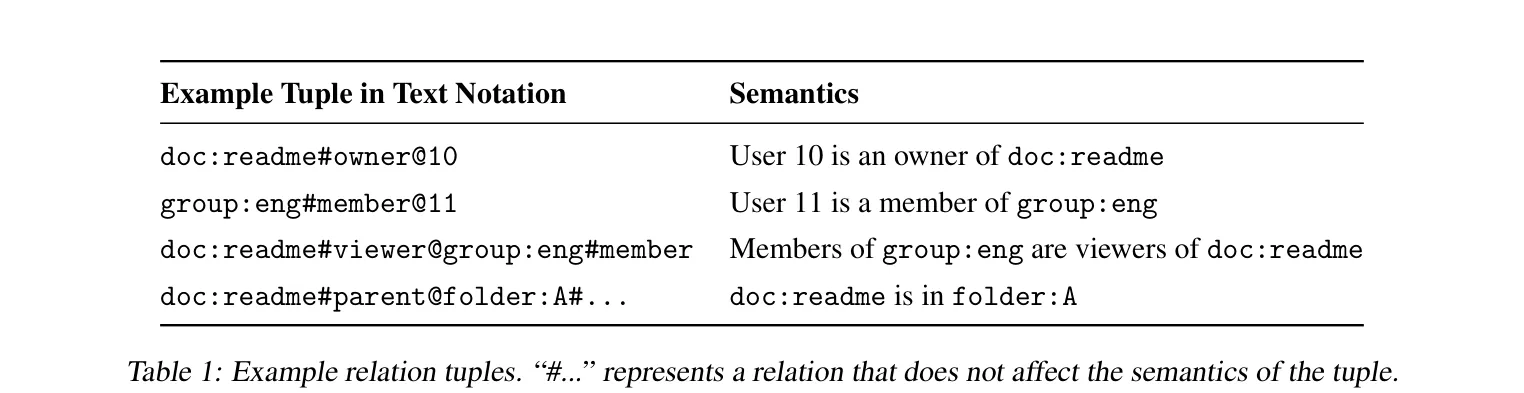
对照上方论文示例与下面四条元组,我们可以看清这种“指针式建模”是如何运作的:
doc:readme#owner@10                     # 1. 直接主体授权:用户 10 是 doc:readme 的所有者
group:eng#member@11                     # 2. 群组成员归属:用户 11 是工程组 group:eng 的成员
doc:readme#viewer@group:eng#member      # 3. 集合间接授权:工程组全体成员自动成为 doc:readme 的查看者
doc:readme#parent@folder:A              # 4. 资源拓扑指针:folder:A 是 doc:readme 的父文件夹
在传统数据库设计中,如果你想把 doc:readme 分享给拥有 5,000 名工程师的 group:eng,你往往要么在业务代码里写硬编码的 JOIN user_groups 查询,要么把 5,000 个用户 ID 冗余拷贝进文档 ACL 表。而在 Zanzibar 中,你只需要写入 doc:readme#viewer@group:eng#member 这一条元组。从图论视角看,这条元组在有向图上建立了一条从节点 doc:readme#viewer 指向节点 group:eng#member 的有向边;当工程组新入职一名员工 12 时,只需写入 group:eng#member@12,他瞬间就能顺着这条有向边获得所有已分享给 group:eng 的千万份文档的访问权。
2.2 Namespace Configuration 与三类 Userset 重写规则
光有底层元组还不够。在真实业务中,“拥有 owner 身份的人自动具备 editor 权限,拥有 editor 身份的人自动具备 viewer 权限,且父文件夹的 viewer 自动具备子文档的 viewer 权限”。如果每次给文档添加 owner 时都要由业务代码同时插入 owner、editor、viewer 三条物理元组,一旦撤销权限时漏删了一条,就会造成致命的权限残留。
为了解决同对象角色包含与跨对象继承,Zanzibar 引入了 Namespace Configuration(命名空间配置),通过静态的 Userset Rewrite Rules(用户集重写规则)在查询期动态展开关系:
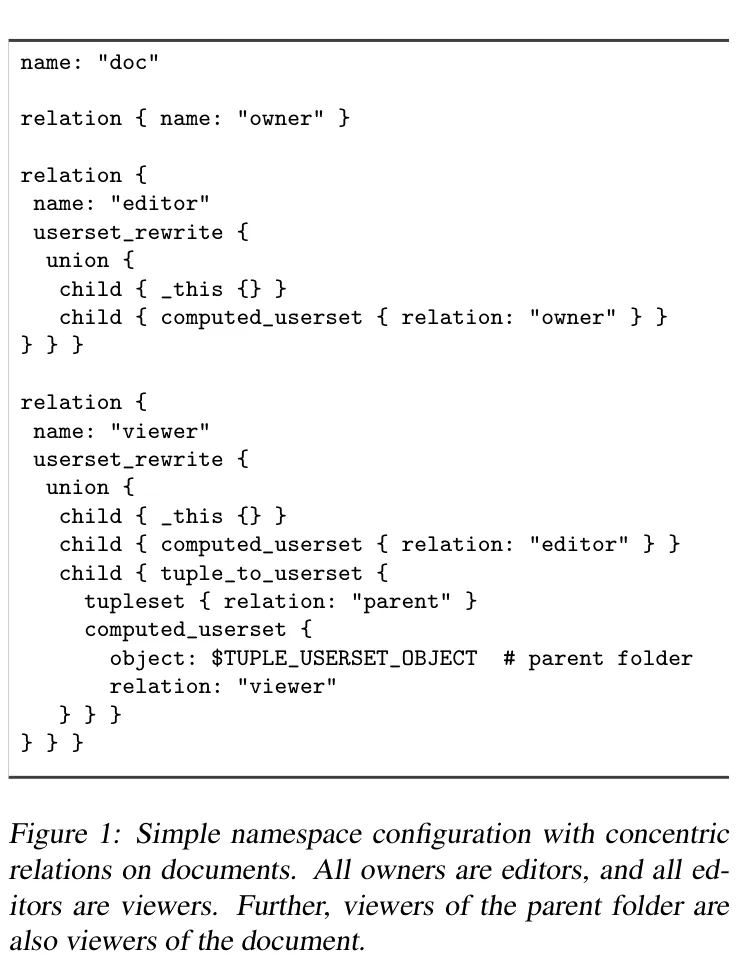
剖析上方的 doc 命名空间配置,你会发现 Zanzibar 定义了三类核心重写原语,并允许用集合代数(union、intersection、exclusion)将它们任意组合:
_this(直接元组查找):返回直接以doc:<id>#<relation>为左端存储在数据库中的所有物理元组集合。computed_userset(同对象关系映射):在不改变当前<object>的前提下,将待查关系重写为同一对象上的另一个关系。例如在editor的定义中声明computed_userset { relation: "owner" },意味着求值doc:readme#editor时,引擎会自动去求值doc:readme#owner,无需物理存储第二份元组。tuple_to_userset(跨对象两跳指针展开):这是实现树状目录与多租户继承的核心原语。它包含两个子字段:tupleset { relation: "parent" }与computed_userset { relation: "viewer" }。其求值过程严格分为两跳:- 第一跳(查指针元组):在数据库中查找当前对象
doc:readme的parent关系指向了哪些目标对象(假设查出doc:readme#parent@folder:A指向的对象为folder:A); - 第二跳(跨对象映射):将第一跳拿到的目标对象
folder:A与computed_userset指定的"viewer"拼接成新的用户集节点folder:A#viewer,递归继续求值!
- 第一跳(查指针元组):在数据库中查找当前对象
OpenFGA 的建模语言(schema 1.1)正是将上面那段略显繁琐的 Protobuf 重写树,提炼成了人类一眼可读的声明式 DSL:
model
  schema 1.1

type user

type folder
  relations
    define viewer: [user]

type document
  relations
    define owner: [user]
    define editor: [user] or owner
    define parent_folder: [folder]
    define viewer: [user] or editor or viewer from parent_folder
将两者的语法结构逐行对照,你会发现它们在代数语义上完全同构:
- 方括号
[user]对应_this加上写入期静态类型约束(只允许user类型的主体直接写入该关系); or owner对应union加上同对象上的computed_userset;viewer from parent_folder则精准对应tuple_to_userset(先沿parent_folder关系边找到父对象folder,再继承该folder上的viewer关系)。
3. OpenFGA 建模语言(Schema 1.1)与集合代数实战
3.1 七大核心抽象与闭环求值方程
在动手设计企业级模型前,我们先对齐 OpenFGA 引擎中的七个核心抽象及其工程职责:
| 核心抽象 | 物理定义与工程职责 | 典型示例 |
|---|---|---|
| Store | 授权模型与关系元组的逻辑隔离空间,通常对应一个独立环境或顶层隔离区 | store_id: 01HV8... |
| Authorization Model | 描述系统内所有实体类型与关系推导规则的不可变版本化快照 | model_id: 01HV9...(每次修改生成新 ID) |
| Type | 一类资源或主体的抽象定义 | user, team, folder, document |
| Object | 带有 type: 前缀的具体资源实例唯一标识 | document:roadmap |
| Relation | 定义在某个 Type 上的关系名称或可执行动作名称 | owner, parent_folder, can_view |
| User | 被授权的主体,支持单用户、类型通配符或另一个 Userset | user:anne, user:*, team:pm#member |
| Relationship Tuple | 持久化的原子关系事实三元组 (user, relation, object) 及可选条件绑定 | document:roadmap#editor@team:pm#member |
OpenFGA 的每一次在线鉴权求值,本质上都是在计算下面这个确定性状态方程:
这里有一条新手最容易踩坑的边界:OpenFGA 是一个纯粹的形式化图推导引擎,它绝不会主动连进你的业务 PostgreSQL 表去查“某篇文档属于哪个文件夹”。凡是参与权限推导的拓扑事实(如创建文件夹、移动文档、拉人进群),业务服务都必须同步将其以 Relationship Tuple 的形式写入 OpenFGA。
3.2 四大基础构造块与写入期类型安全
我们用一个包含用户、团队、嵌套文件夹与文档的完整 schema 1.1 模型,拆解 OpenFGA 建模语言的四大构造块:
model
  schema 1.1

type user

type team
  relations
    define member: [user, team#member]

type folder
  relations
    define parent: [folder]
    define viewer: [user, team#member, folder#viewer] or viewer from parent

type document
  relations
    define parent_folder: [folder]
    define owner: [user]
    define editor: [user, team#member] or owner
define viewer: [user, user:*, team#member] or editor or viewer from parent_folder- Direct Relationship 与静态类型守卫(
[...]):在 Zanzibar 论文中,任何元组理论上都能写进存储;而 OpenFGA 在schema 1.1中强制引入了方括号类型声明。例如define editor: [user, team#member]明确告诉引擎:该关系只接受形如user:<id>的个人,或者形如team:<id>#member的团队成员集。如果上游业务代码出现 Bug,试图写入document:roadmap#editor@organization:acme#member,OpenFGA 的internal/validation模块会在Write接口层直接报错拦截,从源头杜绝脏元组污染图存储。 - Type-Bound Public Access(类型绑定公开访问
user:*):在document#viewer中声明的user:*,用于表达“某个具体文档已开启全员公开访问”。注意它仅在该文档显式写入了一条document:public-spec#viewer@user:*元组时才会对所有user生效,平时不会影响其他私有文档。 - Computed Userset(同对象角色升级):
define editor: [user, team#member] or owner让权限具备天然的向上兼容——给用户赋予owner身份后,无需冗余写入editor和viewer元组。 - Tuple-to-Userset 与自递归展开(
from):不仅document可以通过viewer from parent_folder向上查找所属文件夹,folder自身也可以通过define parent: [folder]和viewer from parent实现多级目录树递归向上溯源。
3.3 集合代数运算符(or / and / but not)与建模复杂度权衡
当业务安全策略需要组合多条路径时,OpenFGA 提供了三种集合代数算子。它们不但在语义上截然不同,在底层的图遍历开销上也有显著差异:
| 集合算子 | 语法示例 | 集合代数语义 | 底层并发求值与短路特征(internal/check) |
|---|---|---|---|
Union(并集 or) | viewer or editor or viewer from parent | 满足任意一条子路径即放行: | 正向短路最快:并发扇出所有分支,只要最快的一个分支返回 allowed: true,立即通过 context.Cancel 终止其余慢分支 |
Intersection(交集 and) | ([user] or viewer from parent) and member from org | 必须同时满足所有子路径: | 反向短路快,正向需全跑完:任一分支返回 false 立即短路拒绝;但要返回 true 必须等待所有分支全部确认成立 |
Exclusion(差集 but not) | member but not blocked | 满足左端基础路径,且未命中右端排除集: | 最难缓存且心智负担重:即使左支 member 命中,也必须完整跑完右支 blocked 确认其为 false 才能放行 |
看一个交集与差集配合的实战例子:假设企业安全合规要求“即便员工不小心把内部文档分享给了外部人员,访问者也必须同时具备本公司 organization#member 身份,且未被列入安全风控黑名单 blocked”,用 schema 1.1 只需一行代数式即可锁死防线:
define can_view: (viewer or editor or can_view from parent_folder) and member from organization but not blocked假设业务系统写入了如下 6 条原子元组:
organization:acme#member@user:anne
folder:product#organization@organization:acme
folder:product#viewer@organization:acme#member
document:roadmap#parent_folder@folder:product
document:roadmap#editor@team:pm#member
team:pm#member@user:ben
此时,查询引擎在内存中构建出的有向推导路径一目了然:
user:anne沿着organization:acme#member→folder:product#viewer→document:roadmap#viewer路径获得文档查看权;user:ben沿着team:pm#member→document:roadmap#editor→document:roadmap#viewer路径同时获得编辑与查看权。
在设计模型时,请务必遵守两条工程铁律:
- 正向允许路径可以多元组合,反向否决路径(
but not)应当少而浅:如果一个模型在三四层嵌套里到处套用双重否定(A but not (B but not C)),一旦线上用户反馈“为什么我看不到这篇文档”,客服与研发在排查Expand树时会陷入极大的心智灾难。 - 只存拓扑关系,不存业务载荷:文档标题、Markdown 正文、商品价格或向量索引绝不能塞进 OpenFGA;OpenFGA 只存储决定访问控制拓扑的 ID 指针。
4. 四大关系查询 API、RAG 检索集成与动态上下文(ReBAC + ABAC)
4.1 Check、Expand、ListObjects 与 ListUsers 的职责与复杂度边界
OpenFGA 对外提供四个核心查询原语,分别对应有向图上的四类遍历问题:
| 查询 API | 图算法本质 | 核心工程用途 | 线上性能水位与调用规范 |
|---|---|---|---|
Check | 点对点可达性搜索(给定起点 与终点 ,判定是否存在连通路径) | 所有业务 API 入口的实时权限拦截(返回 allowed: true/false) | 极速热路径:单点查询易于命中缓存与并发短路,通常在数毫秒内完成 |
BatchCheck | 批量并发点对点可达性搜索(自带请求内去重与子图缓存复用) | 列表页渲染 20 个操作按钮状态,或对搜索引擎召回的 Top- 结果做后置权限过滤 | 高吞吐热路径:比循环单次调用 Check 节省大量网络往返与重复父节点查库 |
Expand | 静态重写树展开(将目标 展开为一棵由 Userset 构成的求值树) | 研发排障、安全审计与向用户解释权限来源 | 诊断与管理路径:不建议放在高频业务接口中调用 |
ListObjects | 反向图可达性枚举(给定起点 与目标类型 ,找出所有可达实例 ) | 渲染“我有权访问的项目列表”,或生成小基数前置过滤 ID 集合 | 高开销枚举路径:延迟随用户关联的对象基数与图深度增长,需严格受控使用 |
ListUsers | 正向主体展开枚举(给定终点 ,找出所有可达的用户或群组集合) | 渲染文档右上角的“协作成员面板”或合规审计盘点 | 管理面路径:深层群嵌套下开销较大,适合在详情管理面板按需调用 |
使用 OpenFGA CLI 发起一次标准 Check 请求非常直观:
fga query check \
  --store-id "$FGA_STORE_ID" \
  --model-id "$FGA_MODEL_ID" \
user:anne can_view document:roadmap在工程接入时,强烈建议在模型中采用“角色关系(Role Relation)与动作关系(Action Relation)分层命名法”:只允许向 owner、editor、viewer 写入物理元组,同时用 define can_view: viewer or editor、define can_delete: owner 暴露动作关系;所有微服务代码一律只针对 can_* 发起 Check。这样未来产品经理要求“让 editor 也能删除文档”时,只需发布一个修改了 define can_delete: owner or editor 的新 model_id,全公司几十个微服务一行代码都不用改!
4.2 企业级搜索与 RAG 知识库中的权限过滤模式
在构建企业级搜索引擎或 RAG 知识库问答系统时,一个经典架构难题是:“数据库里有 1,000 万个文档 Chunk,如何只检索出当前用户 user:anne 有权查看的 Top-10 相关 Chunk?”
切忌把 OpenFGA 当成全文或向量搜索引擎直接全量拉取!针对不同的授权基数分布,工程界有一套标准的双模协同模式:
【模式 A:Search + BatchCheck 后置过滤(适合高选择性检索 / 用户有权访问海量公共与部门文档)】
1. 检索引擎(如 Vespa / ES)按关键词与向量召回 Top-50 候选文档 ID:[doc:1, doc:2, ..., doc:50]
2. 业务编排层将这 50 个 ID 组装为一次 OpenFGA BatchCheck 请求并发校验:
   checks: [ (user:anne, can_view, doc:1), ..., (user:anne, can_view, doc:50) ]
3. 剔除 allowed=false 的结果,取前 10 个合法 Chunk 送入 LLM Prompt。

【模式 B:ListObjects + Search Filter 前置过滤(适合小基数私有资源 / 某用户仅对几十个项目有权限)】
1. 先调用 OpenFGA ListObjects(user:anne, can_view, type="project"),拿到 [project:alpha, project:beta]
2. 将该列表作为硬过滤条件注入检索引擎查询:
   SELECT * FROM chunk WHERE project_id IN ('alpha', 'beta') AND nearestNeighbor(embedding, q)
4.3 Contextual Tuples 与 CEL Conditions:打通 ReBAC 与 ABAC
如果遇到这样的业务需求:“某位外部审计员 user:auditor 只有在工作日的 09:00 ~ 18:00 之间、且客户端 IP 位于公司内网网段时,才能查看财务报表 report:2026-q2”,纯静态的关系元组该如何表达?
OpenFGA 提供了两把利器来解决动态上下文问题:
第一把利器是 Contextual Tuples(请求级瞬态元组)。它随单次 Check 请求在内存中传入,参与本次图遍历推导,但绝不写入底层数据库。当网关层已经核实了当前请求的 IP 网段或临时会话状态时,可以直接在请求中注入瞬态元组:
fga query check \
  --store-id "$FGA_STORE_ID" \
  --model-id "$FGA_MODEL_ID" \
  user:anne can_view transaction:A \
  --contextual-tuple "user:anne user ip-address-range:10.0.0.0/16" \
  --contextual-tuple "user:anne user timeslot:18_19"
第二把利器是 Conditions(基于 Google CEL 的类型化条件元组)。你可以在 schema 1.1 模型末尾直接定义强类型的 CEL 布尔函数,并在关系声明中通过 with <condition_name> 挂载它:
model
  schema 1.1

type user

type document
  relations
    define viewer: [user with non_expired_grant_and_valid_ip]

condition non_expired_grant_and_valid_ip(current_time: timestamp, grant_expires_at: timestamp, client_ip: ipaddress, allowed_cidr: cidr) {
  current_time < grant_expires_at && client_ip.in_cidr(allowed_cidr)
}
写入该临时授权元组时,将静态边界参数(如过期时间 grant_expires_at 和允许的网段 allowed_cidr)随元组一起持久化存入数据库:
{
  "user": "user:auditor",
  "relation": "viewer",
  "object": "document:q2-financial-report",
  "condition": {
    "name": "non_expired_grant_and_valid_ip",
    "context": {
      "grant_expires_at": "2026-12-31T23:59:59Z",
      "allowed_cidr": "10.24.0.0/16"
    }
  }
}
而在在线调用 Check 时,网关只需传入当前请求时刻的动态环境变量 {"current_time": "2026-07-08T10:30:00Z", "client_ip": "10.24.1.88"}。OpenFGA 的 internal/condition 引擎会在图遍历命中该元组时,瞬间合并持久化参数与请求上下文并执行 CEL 表达式求值!一旦时间过了 2026-12-31,即便后台定时清理任务还没删掉这条元组,在线 Check 也会毫秒级精准返回 allowed: false。
为了保持架构清晰,请严格按以下边界划分四类数据的归属:
| 授权信息的物理性质 | 推荐存放位置与机制 | 典型工程示例 |
|---|---|---|
| 长期稳定的组织与资源拓扑 | 持久化 Relationship Tuple | 部门成员、文件夹父子指针、文档 Owner |
| 已由上游网关核实的请求级瞬态关系 | Contextual Tuple(不落盘) | 当前请求携带的审批通过单据关联、OAuth 临时代理作用域 |
| 带有效期、配额或网络边界的动态约束 | CEL Condition + Request Context | 外包临时授权过期时间戳、允许访问的地域/CIDR 网段 |
| 高频变动的业务实体详情与全文内容 | 业务主数据库或检索引擎 | 账户实时余额明细、文档 Markdown 正文、向量 Embedding |
5. 深入底层:一致性协议、分布式架构与 OpenFGA 源码剖析
5.1 “新敌人问题”(New Enemy Problem)、Zookie 与一致性控制
为什么 Google 宁可大费周章基于全球原子钟数据库 Spanner 来重写授权系统,也不愿意只用普通的异步复制缓存?因为分布式权限系统里潜伏着一个致命的安全幽灵——“新敌人问题”(New Enemy Problem)。
我们用一条精确的时间轴来复现这场事故:
时刻 t0 : 共享文档 doc:plan 的 ACL 中包含 Alice 和 Bob(两人最初是同一项目组同事)。
时刻 t1 : Bob 转岗到了竞争业务部门。Alice 立即调用权限服务,从 doc:plan#viewer 中踢出了 Bob。
时刻 t2 : Alice 确认踢人成功后,在 doc:plan 中写入了针对 Bob 所在新部门的核心机密战略。
时刻 t3 : Bob 发起读取 doc:plan 的请求。此时:
          - 文档内容存储服务已经同步到了 t2 时刻的最新机密正文;
          - 但负责鉴权的某台边缘权限节点因为缓存未过期(或读取了滞后的从库副本),
            仍然拿着 t0 时刻的旧 ACL 快照做判断,得出了 allowed = true!
结果 : 被踢出的“新敌人” Bob 成功读到了踢他之后才写入的机密内容!看明白了吗?普通最终一致性缓存的问题在于:业务内容的可见性进度超前于权限吊销的可见性进度(即内容读到了 ,权限却停留在 )。要从数学上根除“新敌人问题”,授权引擎必须满足因果快照单调性:
Zanzibar 为此设计了精妙的 Zookie 协议:
- 在 时刻 Alice 移除 Bob 权限、或 时刻写入机密内容前,文档服务向 Zanzibar 申请一个编码了当前 Spanner 全局精确时间戳的不透明令牌
zookie(记其内部时间戳为 ),并将该zookie与新文档内容作为原子元数据绑定存储; - 在 时刻 Bob 请求读取文档时,文档服务先把文档的最新
zookie读出来,连同Check(doc:plan, viewer, Bob, zookie)一起发给 Zanzibar; - Zanzibar 收到请求后,检查本地缓存快照的时间戳 是否满足 :
- 绝大多数情况(
Check Safe,占生产流量 > 98%):文档很久没改过权限, 已经是几分钟前甚至几天前的时间戳,本地已经协商好的安全快照完全满足 ,直接免跨区通信在本地内存中极速返回! - 刚发生变更的敏感窗口(
Check Recent,占流量 < 2%):像上面 Alice 刚踢完人就写机密的场景, 极其新鲜,Zanzibar 识别到后会强制向 Spanner 发起最新时间戳同步读,确保 Bob 的请求在 时刻必然看到 的吊销结果,返回allowed: false!
- 绝大多数情况(
在开源的 OpenFGA 中,由于底层对接的是标准 PostgreSQL 或 MySQL(没有 TrueTime 原子钟硬件),OpenFGA 采用了工程上极其实用的双档位 consistency API 参数 + 版本化缓存键方案:
{
  "tuple_key": {
    "user": "user:bob",
    "relation": "can_view",
    "object": "document:plan"
  },
  "authorization_model_id": "01HV9...",
  "consistency": "HIGHER_CONSISTENCY"
}MINIMIZE_LATENCY(默认高吞吐模式):优先命中内存中的 Check 结果缓存与 Tuple 迭代器缓存,适合 99% 的常规读取接口;HIGHER_CONSISTENCY(强一致防越权模式):当业务刚执行完权限移除、敏感文档刚发生编辑,或者处于资金划转、删除库表等高危操作入口时,调用方显式传入HIGHER_CONSISTENCY,OpenFGA 会立即绕过内存缓存直连主数据库求值,在通用基础设施上低成本守住安全底线。
5.2 Zanzibar 分布式架构与 Leopard 扁平化索引机制
对照 Zanzibar 论文中的总体架构图,我们可以看清一个承载全球千万级 QPS 的授权引擎内部是如何协同运转的:
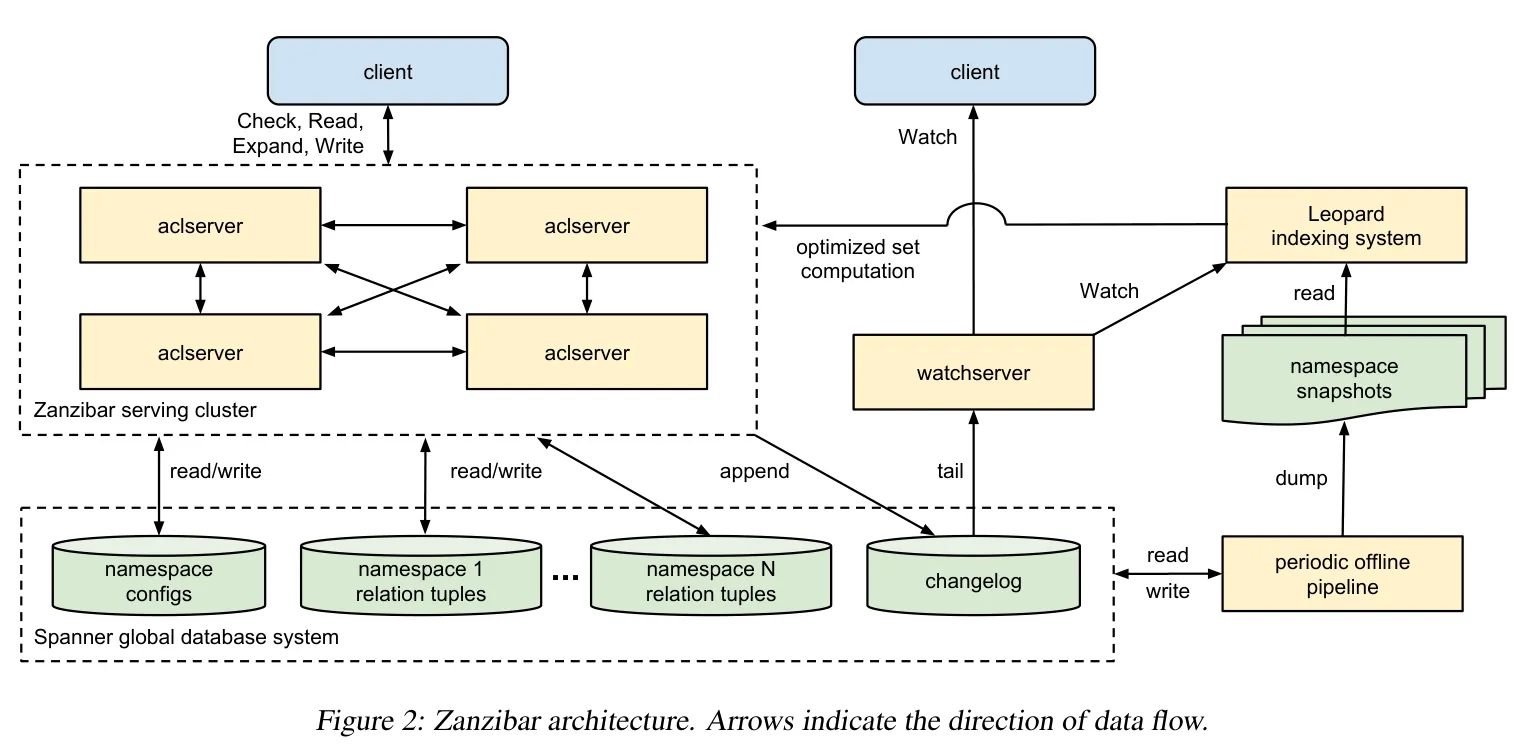
在这张架构图中,除了底层的 Spanner 元组数据库与 Changelog 变更订阅外,有两个极具工程智慧的核心设计值得深挖:
第一是 aclserver 的一致性哈希路由与尾延迟抑制。当一篇热门全员文档在早上 9 点被 10,000 名员工同时打开时,如果随机负载均衡,所有 aclserver 节点都会重复去数据库查这篇文档的父文件夹和群组关系。Zanzibar 采用按 (namespace, object_id) 的一致性哈希将同一文档或同一群组的子查询路由到固定的 aclserver 节点,并在节点内部实现了 In-Flight Request Deduplication(在途请求合并)——10,000 个并发请求中只有第 1 个会真正向下游发起读取,其余 9,999 个直接挂在同一块内存 Promise 上共享计算结果!同时,一旦某个子查询耗时超过 P95 阈值,aclserver 会自动向备用节点发送对冲请求(Request Hedging),取最先返回的结果以削平长尾毛刺。
第二是 Leopard 专用群组索引系统。思考一个极端情况:大企业里的员工群组往往存在深达 10 层以上的嵌套(例如 user:11 -> group:backend -> group:eng-cn -> group:eng-apac -> group:eng-global -> group:all-hands)。如果在每次 Check 时都顺着数据库一行行递归查 10 层父群组,延迟根本无法接受。
Leopard 的解法是将深层有向图的在线遍历,转化为扁平化有序集合的求交运算:
- Leopard 持续监听 Spanner 的 Changelog 增量日志,在内存中维护两张经过跳表(Skip-List)编码的扁平化倒排表:
- :记录用户 直接或间接归属的所有群组 ID 有序集合(包括传递闭包);
- :记录群组 直接或间接包含的所有子群组 ID 有序集合。
- 当需要判断“用户 是否属于嵌套群组 ”时,
aclserver无需做任何多跳递归,只需计算如下有序集合交集是否非空:
借助跳表指针的跳跃比较(Skip-List Seek),哪怕集合里有几十万个群组 ID,单次求交也能在微秒级内完成!
5.3 OpenFGA 源码级执行链路剖析(internal/graph 与 internal/modelgraph)
在开源的 OpenFGA(openfga/openfga 与 openfga/cli)中,这些理论是如何落成 Go 代码的?我们将核心模块与源码路径精确映射如下:
| 核心能力模块 | Go 源码路径(openfga/openfga & openfga/cli) | 底层实现机制与关键工程设计 |
|---|---|---|
| 服务引导与双协议栈 | cmd/openfga/main.go, cmd/run/run.go | 启动 gRPC (8081) 与 grpc-gateway HTTP (8080) 服务,装配缓存、限流器与 OpenTelemetry 追踪 |
| 存储引擎与迁移 | cmd/migrate/migrate.go, pkg/storage/postgres/*, pkg/storage/mysql/* | 实现 RelationshipBackend 接口,利用复合索引加速按 (store, object_type, object_id, relation) 与 (store, user) 的双向扫描 |
| 静态模型图编译 | internal/validation/*, internal/modelgraph/* | 解析 schema 1.1 DSL,构建带权重的正向/反向有向图(AuthorizationModelGraph),静态拦截类型越界与非法死循环 |
Check 并发图求值 | pkg/server/commands/check.go, internal/graph/cached_resolver.go, internal/check/* | 责任链模式的 CheckResolver(缓存层 → 并发调度层 → 本地递归求值层),带环路检测与短路取消 |
ListObjects 反向展开 | pkg/server/commands/list_objects.go, internal/graph/object_providers.go | 从主体 user 出发沿 modelgraph 反向边向上遍历,剪枝无关对象分支并流式输出合格 ID |
| CEL 条件求值器 | internal/condition/*, internal/condition/eval/* | 将模型中的 Condition 编译为 cel.Program AST,在命中带条件元组时合并 Context 实时求值 |
| CLI 自动化测试引擎 | cli: cmd/model/test.go, internal/storetest/* | 在进程内拉起轻量内存 Store,批量灌入 .fga.yaml 中的测试元组并并发跑完所有断言 |
深入阅读 internal/graph 下的 Check 与 ListObjects 源码,你会看到三个极其精彩的工程实现细节:
- 责任链模式的
CheckResolver与防环路死锁: 在cmd/run/run.go中,OpenFGA 将CheckResolver组装成一条责任链:CachedCheckResolver(查询 LRU/TTL 缓存,缓存键包含store_id + model_id + tuple_key + contextual_tuples_hash + context_hash) →DispatchThrottlingCheckResolver(控制单请求并发度,默认resolveNodeBreadthLimit = 100) →LocalChecker(执行图节点展开)。为了防止两个文件夹互设对方为parent(如folder:A#parent@folder:B且folder:B#parent@folder:A)导致无限递归死循环,Check在上下文中维护了一个线程安全的visited哈希表,遇到已访问过的object#relation节点立即剪枝返回false;同时设置硬性的递归深度上限resolveNodeLimit = 25,超限即抛出ErrResolutionDepthExceeded。 union/intersection的 Goroutine 短路风暴控制: 当LocalChecker评估define viewer: a or b or c时,它会为a、b、c派生受信号量约束的并发 Goroutine,并共享一个ctx, cancel := context.WithCancel(parentCtx)。一旦a在 0.5 毫秒内命中了直接元组返回allowed: true,主协程立即调用cancel(),正在查数据库跑b和c的慢协程会瞬间收到 Context 取消信号并释放数据库连接!ListObjects为什么不傻瓜式遍历全库对象?反向图展开揭秘: 假设数据库里有 100 万篇document,如果ListObjects(user:anne, can_view, "document")对 100 万篇文档挨个调一遍Check,数据库当场就会被打挂。OpenFGA 在internal/modelgraph中预先把授权模型的有向边全部反转,构建了一张反向可达图:- 查询开始时,引擎以
user:anne为起点,调用存储层的ReadStartingWithUser接口,先查出直接关联user:anne的那几个团队(如team:pm#member)和文件夹(如folder:product); - 再顺着反向边找出以
folder:product为parent_folder的几十篇候选document; - 如果路径上全是纯粹的
or(并集)关系,反向推导出的对象直接就是最终合法结果,无需二次校验;只有当路径上包含and(交集)或but not(差集)时,引擎才会仅对这几十个候选对象补发一次正向Check确认。
- 查询开始时,引擎以
5.4 Docker 本地启动与 CLI 自动化回归测试闭环
在本地开发或集成测试时,可以通过 Docker 快速拉起带持久化存储的 OpenFGA 实例(生产环境推荐使用 PostgreSQL 并通过 openfga migrate 管理表结构):
# 1. 创建专属网络并使用 SQLite 执行 Schema 迁移(本地测试轻量方式)
docker network create openfga

docker run --rm --network=openfga \
  -v openfga:/home/nonroot -u nonroot \
  openfga/openfga migrate \
  --datastore-engine sqlite \
  --datastore-uri 'file:/home/nonroot/openfga.db'

# 2. 启动 OpenFGA 服务(8080 为 HTTP API,8081 为 gRPC API,3000 为本地 Playground)
docker run -d --name openfga --network=openfga \
  -p 3000:3000 -p 8080:8080 -p 8081:8081 \
  -v openfga:/home/nonroot -u nonroot \
  openfga/openfga run \
  --datastore-engine sqlite \
  --datastore-uri 'file:/home/nonroot/openfga.db'

# (生产环境推荐)连接高可用 PostgreSQL 启动:
# openfga/openfga run --datastore-engine postgres \
#   --datastore-uri 'postgres://user:pass@pg-host:5432/openfga?sslmode=require' \
#   --playground-enabled=false
要把“权限即代码(Authorization as Code)”真正落到实处,最核心的工程抓手是把 fga model test 嵌入 Git CI 流水线。我们可以在代码仓库中维护如下一份自包含的 store.fga.yaml 文件,把模型定义、测试夹具元组(Tuples)和正反例断言(Assertions)写在一起:
name: collab-docs-auth-test
model: |
  model
    schema 1.1

  type user

  type team
    relations
      define member: [user]

  type folder
    relations
      define viewer: [user, team#member]

  type document
    relations
      define parent_folder: [folder]
      define owner: [user]
      define blocked: [user]
      define can_view: ([user] or owner or viewer from parent_folder) but not blocked

tuples:
  - user: user:anne
    relation: member
    object: team:engineering
  - user: team:engineering#member
    relation: viewer
    object: folder:architecture
  - user: folder:architecture
    relation: parent_folder
    object: document:rfc-001
  - user: user:bob
    relation: member
    object: team:engineering
  - user: user:bob
    relation: blocked
    object: document:rfc-001

tests:
  - name: "继承父文件夹团队权限且未被封禁的成员应放行,被封禁成员应精准拦截"
    check:
      - user: user:anne
        object: document:rfc-001
        assertions:
          can_view: true
      - user: user:bob
        object: document:rfc-001
        assertions:
          can_view: false
    list_objects:
      - user: user:anne
        type: document
        assertions:
          can_view:
            - document:rfc-001
      - user: user:bob
        type: document
        assertions:
          can_view: []
每次研发人员提交 PR 修改权限模型时,CI 只需执行以下两行命令即可在百毫秒内完成离线语法检查与全量回归测试,彻底杜绝“改一行 or 导致全站越权”的线上事故:
fga model validate --file model.fga
fga model test --tests store.fga.yaml
6. 三个典型生产场景的 ReBAC 建模范式
6.1 范式一:多级云盘文件夹与文档协作系统
云盘与飞书/Google Docs 类在线文档是 ReBAC 最经典的战场。下面的生产级模型同时支持群组授权、无限级文件夹树状继承以及单文档独立分享:
model
  schema 1.1

type user

type group
  relations
    define member: [user, group#member]

type folder
  relations
    define parent: [folder]
    define viewer: [user, group#member]
    define editor: [user, group#member]
    define can_view: viewer or editor or can_view from parent
    define can_edit: editor or can_edit from parent

type document
  relations
    define parent: [folder]
    define owner: [user]
    define editor: [user, group#member] or owner
    define viewer: [user, group#member] or editor
    define can_view: viewer or can_view from parent
    define can_edit: editor or can_edit from parent
当写入如下 4 条关系元组后:
folder:product#viewer@group:pm#member
group:pm#member@user:anne
document:roadmap#parent@folder:product
document:roadmap#owner@user:ben查询引擎无需任何额外同步即可推导出:user:anne 通过 group:pm#member 获得父文件夹 folder:product 的查看权,并顺着 can_view from parent 自动继承子文档 document:roadmap 的查看权;而 user:ben 作为文档 owner,自动具备 can_edit 与 can_view 权限。
工程落地边界提醒:注意 folder 上的 can_view from parent 是一条自递归边。如果业务允许用户创建 30 层深的文件夹嵌套,单次 Check 就会触发超过 25 层的默认递归深度限制(resolveNodeLimit)。因此在产品设计上应限制文件夹最大嵌套层级(例如不超过 10~15 层),并开启 OpenFGA 的节点迭代缓存。
6.2 范式二:B2B 多租户 SaaS 组织、项目与职能角色隔离
在 B2B 多租户 SaaS 系统中,权限往往围绕 Organization -> Project -> Resource (Report) 三级层级展开,同时必须严格隔离“业务项目读写权限”与“财务账单管理权限”:
model
  schema 1.1

type user

type organization
  relations
    define member: [user]
    define admin: [user]
    define billing_admin: [user] or admin

type project
  relations
    define organization: [organization]
    define member: [user] or member from organization
    define admin: [user] or admin from organization
    define can_read: member or admin
    define can_write: admin

type report
  relations
    define project: [project]
    define viewer: [user]
    define can_view: viewer or can_read from project
    define can_edit: can_write from project
这份模型的精妙之处在于职责正交:组织的 admin 既向下继承所有 project 和 report 的读写权,又在组织层具备 billing_admin 权限;而专门聘请的外部财务会计只需被赋予 organization:acme#billing_admin@user:cpa,他就只能访问账单接口,绝不会因为身处组织中而自动看到业务部门的核心项目报表。
6.3 范式三:GitHub 风格代码仓库、团队授权与违规账号封禁
开发者平台通常包含组织 Owner、团队 Member、代码仓库三级权限(Reader / Writer / Admin)以及针对安全风控账号的单点熔断(Blocked):
model
  schema 1.1

type user

type organization
  relations
    define member: [user]
    define owner: [user]

type team
  relations
    define organization: [organization]
    define member: [user]

type repository
  relations
    define organization: [organization]
    define reader: [user, team#member] or member from organization
    define writer: [user, team#member]
    define admin: [user, team#member] or owner from organization
    define blocked: [user]
    define can_read: reader or writer or admin
    define can_write: (writer or admin) but not blocked
define can_admin: admin在这里,can_write: (writer or admin) but not blocked 利用差集算子实现了精准止血:哪怕某位员工的账号由于泄露凭证正处于多个核心研发团队(team#member)中,安全响应中心只需写入一条 repository:core#blocked@user:compromised_dev,就能瞬间熔断其对核心仓库的代码推送权限,而不必先把他从十几个团队里挨个踢出。
7. 性能特征剖析、可观测性指标与六条安全铁律
7.1 从 Zanzibar 生产监控数据看关系授权引擎的性能规律
Zanzibar 论文公布了一组极具价值的全球生产集群性能图表。首先是 Check Safe 与 Check Recent 请求的每秒吞吐率对比,以及 Check Safe 响应延迟在不同百分位上的分布:
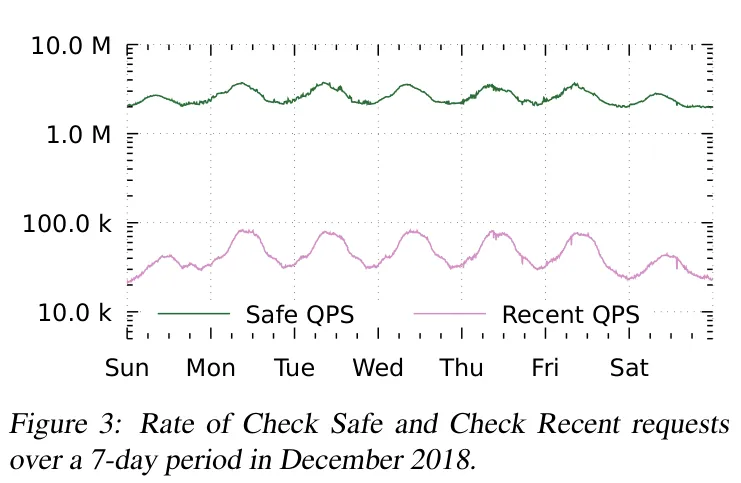
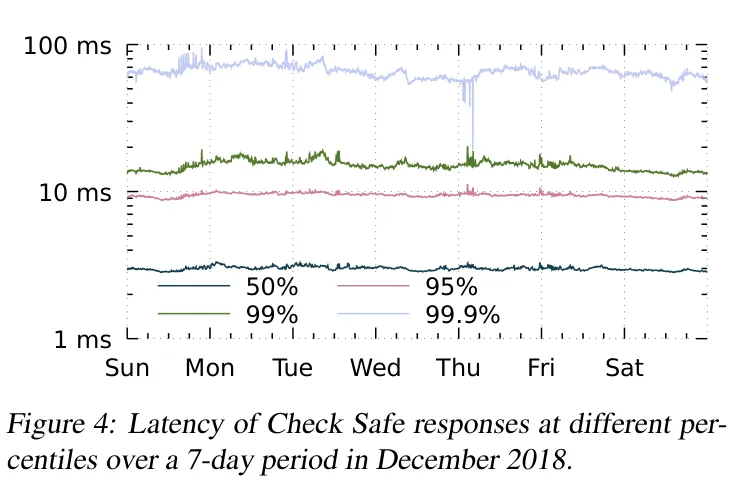
从上面两张生产曲线中,我们可以提炼出两条直接指导 OpenFGA 架构调优的底层规律:
- 读写比与冷热分布极度悬殊:在真实在线流量中,允许命中近期安全缓存的读取请求(
Check Safe)占比超过 98%,而刚发生权限变更需要强读最新状态的请求(Check Recent)不足 2%。这说明在 OpenFGA 生产部署中,开启内存查询缓存与子图迭代器缓存(--check-query-cache-enabled)是把中位延迟压进亚毫秒至数毫秒区间的第一杠杆。 - 长尾延迟主要来自深层图扇出:对比 P50 与 P99 曲线可以看到,简单直接关系(Direct Tuple)的校验极快,而跨多层
tuple-to-userset与深层群组的请求构成了 P99 长尾。
再看论文给出的不同 RPC 方法延迟对比与多年期可用性表现:
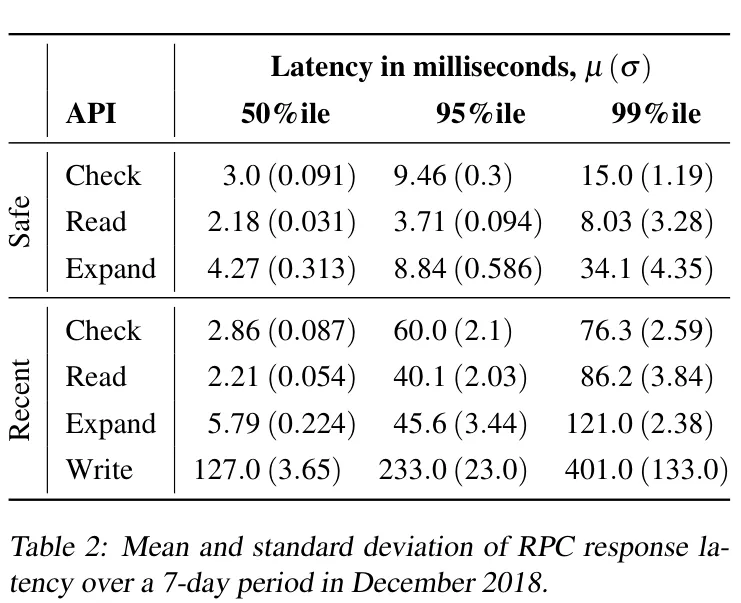
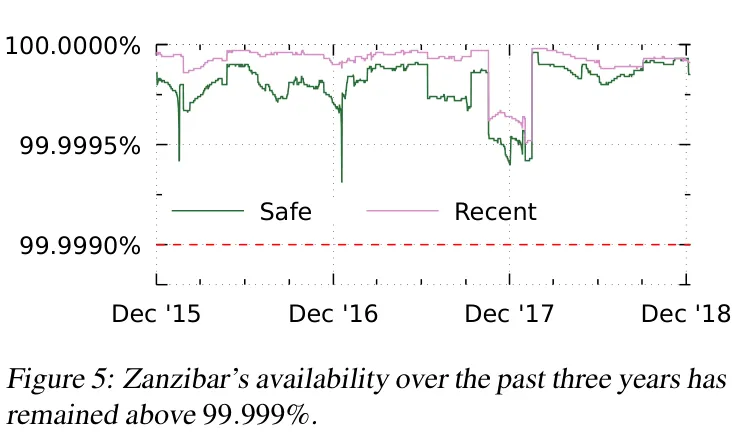
可以看到,点对点可达性查询 Check 的延迟远低于需要展开整棵推导树的 Expand 和批量扫描元组的 Read。当我们在企业内部基于 PostgreSQL/MySQL 运维自建的 OpenFGA 集群时,应重点围绕以下七项核心指标(OpenFGA 原生通过 Prometheus /metrics 暴露)建立监控与告警大盘:
| 核心监控指标 | 对应的内部物理含义 | 生产告警与调优关注点 |
|---|---|---|
Check P50 / P95 / P99 Latency | 直接叠加在所有业务接口上的在线鉴权耗时 | P99 突增通常意味着缓存命中率下跌、模型引入了慢分支或数据库连接池排队 |
Check Error & Timeout Rate | 鉴权异常率(会直接触发业务端 Fail-Closed 拒访) | 必须配置最高级别 P0 告警,密切监控 ErrResolutionDepthExceeded 报错 |
| Dispatch Count / Resolution Depth | 单次请求在关系图中派生的内部子查询扇出数与深度 | 若平均 Dispatch Count 显著大于 5~10,说明存在过深的目录嵌套或滥用 but not |
| Datastore Query Latency & QPS | 底层 PostgreSQL / MySQL 每次元组扫描的耗时 | 检查慢 SQL 日志,确保连接池(--datastore-max-open-conns)与实例规格匹配并发水位 |
| Cache Hit Ratio | CachedCheckResolver 与 Iterator 缓存的命中比例 | 理想生产状态下应保持在 80%~95% 以上,过低需调大 --check-cache-limit |
ListObjects Latency | 反向图展开枚举耗时 | 必须与 Check 分开监控,防止个别大基数枚举请求耗尽数据库 IOPS |
| Allow / Deny Ratio(放行拒绝比) | 全局与核心接口返回 allowed: true 的比例曲线 | 发版防呆神器:若新模型上线或双写断流导致 Allow 比例瞬间暴跌或飙升至 100%,立即触发自动回滚 |
7.2 认证与授权分离及六条安全工程铁律
在将 OpenFGA 接入企业生产网关时,必须时刻铭记:OpenFGA 是纯粹的授权(Authorization)引擎,它完全不负责身份认证(Authentication)。一条严密的在线鉴权调用链必须遵循如下拓扑:
客户端请求 (携带 JWT / OIDC Session Cookie)
  │
  ▼
API 网关 / 认证中间件 (验签 Token,提取不可伪造的可信身份 Subject = "user:anne")
  │
  ▼
业务微服务 (绑定不可变 model_id,调用 OpenFGA Check(user:anne, can_view, document:roadmap))
  │
  ├── 若返回 allowed: true  ──> 放行并执行业务逻辑
└── 若返回 allowed: false 或超时/报错 ──> 强制触发 Fail-Closed 拒绝访问 (HTTP 403)围绕这条链路,工程团队必须将以下六条安全铁律写入研发红线:
- 可信身份源铁律:传给 OpenFGA 的
user参数必须 100% 取自服务端验签后的认证上下文(Token Claims),严禁直接从前端传入的 HTTP Query、JSON Body 或未验签 Header 中读取user_id(否则攻击者改一个请求参数就能冒充任意管理员)。 - OpenFGA 服务端自身鉴权与网络隔离:生产环境的 OpenFGA 实例必须部署在内网安全区,关闭
3000端口的 Playground,并通过--authn-method=preshared(预共享密钥)或--authn-method=oidc开启服务间调用鉴权,严禁将 OpenFGA 端口直接暴露给公网浏览器。 - 读写接口权限分级收口:能够调用
Write增删元组、创建Authorization Model的管理凭据,必须与仅需调用只读Check/ListObjects的普通业务凭据严格分离,所有关键权限写入必须保留审计流水。 - 后端入口强制拦截:前端根据权限隐藏“删除按钮”仅属于 UI 交互友好性优化,每一个后端写接口与敏感读接口都必须在服务端独立执行
Check。 - 元组标识符脱敏(No PII in Tuples):Tuple 中的
user与object应统一使用内部不可逆唯一 ID(如user:u_9f8a7b),避免将员工邮箱、手机号或机密客户真名以明文写入权限表。 - 异常默认拒绝(Fail-Closed):当调用 OpenFGA 发生网络超时、连接池满、传入了不存在的
model_id或触发递归深度超限时,业务代码必须无条件按拒绝访问处理,严禁写出catch (err) { return true; }这类灾难性兜底代码。
8. 存量系统平滑迁移路线与权限生态横向选型
8.1 零停机渐进式迁移六步法与 Shadow 旁路比对
要把一个已经在线上跑了三年的老系统从“硬编码 RBAC + SQL JOIN”迁移到 OpenFGA,最忌讳“憋大招一次性重写所有接口直接切流”。经过大规模生产验证的平滑迁移路线分为六个阶段:
[阶段 0: 权限盘点] ──> [阶段 1: 离线建模 + CI 单测] ──> [阶段 2: 历史回填 + 增量双写]
                                                               │
[阶段 5: 下线旧代码] <── [阶段 4: 灰度切流 + 一键降级] <── [阶段 3: Shadow 旁路比对归零]| 演进阶段 | 核心工程目标 | 关键动作与进入下一阶段的准入标准 |
|---|---|---|
| 0. 权限盘点 | 摸清存量代码里的显式规则与隐式特例 | 梳理现有角色表、资源父子层级、共享逻辑以及散落在代码里的硬编码白名单 |
| 1. 离线建模 | 产出可测试的 schema 1.1 模型 | 编写 .fga 模型与覆盖所有业务正反例的 .fga.yaml,在 CI 中 100% 跑通 fga model test |
| 2. 存量回填与双写 | 让 OpenFGA 中的 Tuple 事实追平主库 | 跑批将存量 ACL 转化为 Tuple,并在业务增删改事务后通过消息队列/Outbox 开启幂等双写 |
| 3. Shadow 旁路比对 | 零业务风险验证线上决策一致性 | 线上请求仍以旧代码鉴权结果为准;旁路异步调用 OpenFGA Check,记录所有新旧结果不一致的 Diff 日志 |
| 4. 灰度切流 | 按租户或流量比例逐步移交决策权 | 当 Shadow 差异率收敛至 0 后,按 1% → 10% → 50% → 100% 切流,并保留配置中心一键切回旧逻辑的 Kill Switch |
| 5. 全面收敛 | 清理技术债并转入常态化治理 | 删掉业务代码中的旧 SQL 鉴权分支,建立删除资源自动清理孤儿 Tuple 的定时对账机制 |
在这套流程中,阶段 3(Shadow 旁路比对)是决定成败的分水岭。当你在大盘上看到 Shadow 比对出现 legacy=true, openfga=false(潜在误拒)或 legacy=false, openfga=true(潜在越权)时,通常都能归结为以下八类典型工程问题:
| 常见接入反模式与根因 | 引发的线上后果 | 标准工程纠偏方案 |
|---|---|---|
| 业务删除资源时漏删 Tuple | 孤儿元组持续堆积,污染 ListObjects 与 ListUsers 枚举结果 | 在资源删除/成员离职事件中同步发送 Tuple delete 指令,并配合每日离线对账清理脚本 |
| 双写链路无重试或乱序 | 创建文档后立刻跳转详情页,因异步双写延迟几百毫秒导致首屏 403 | 关键创建链路采用同步写 Tuple,或在跳转读取时对创建者自身请求开启 HIGHER_CONSISTENCY |
未固定 authorization_model_id | 研发在测试环境改了模型,线上服务默认拉取最新 Model 导致生产权限突变 | 生产环境调用 Check 必须显式传入经过 CI 验证并由配置中心下发的不可变 model_id |
| 把旧系统的扁平角色名原样照搬 | 只是把 if (role == 'dept_leader') 换了个地方存,丧失资源图推导能力 | 围绕真实的资源拓扑(organization -> folder -> document)与动作关系(can_view)重构模型 |
| 滥用 Contextual Tuples 传持久关系 | 鉴权结果依赖调用方每次手工传参,既无法用 ListObjects 枚举也无法审计 | 凡是跨请求存在的归属关系一律写持久化 Tuple,Contextual Tuples 仅用于请求级瞬态事实 |
8.2 与 SpiceDB、OPA、Cedar 及 Casbin 的技术选型对比
在云原生权限生态中,OpenFGA 经常与 SpiceDB、OPA、Cedar 和 Casbin 一起被讨论。它们各自针对不同的核心问题域演化出了截然不同的架构取舍:
| 权限引擎 / 框架 | 核心心智模型与算法底座 | 最契合的主战场 | 架构权衡与局限 |
|---|---|---|---|
| OpenFGA | Zanzibar 风格 ReBAC + CEL 条件(中心化关系元组图数据库 + schema 1.1) | 多租户 SaaS、文档/文件夹层级继承、群组协作共享、RAG 细粒度权限过滤 | 需维护中心化 Tuple 同步生命周期与独立服务集群 |
| SpiceDB (Authzed) | 原生 Zanzibar ReBAC(高度还原 ZedToken 一致性令牌与分布式图缓存) | 对 Zanzibar 严格因果一致性协议(防 New Enemy)有强诉求的大规模关系授权系统 | 专用性强,条件属性表达需配合 Caveats 机制 |
| OPA (Open Policy Agent) | 无状态通用策略引擎(基于 Datalog 变体 Rego 语言对输入 JSON 求值) | Kubernetes 准入控制(Gatekeeper)、API 网关路由策略、基础设施合规校验 | 不自带海量关系图存储;若要把千万条文档共享关系全塞进 OPA 内存 Bundle 会导致内存撑爆 |
| Cedar (AWS) | 形式化验证策略语言(围绕 Principal / Action / Resource + permit/forbid) | 适合规则以复杂属性判断和显式禁止策略为主、且追求 Rust 嵌入式高性能求值的应用 | 同样不内置分布式图存储,需调用方在评估前自行传入关联实体切片 |
| Casbin | 进程内轻量访问控制库(通过 PERM 元模型配置 ACL / RBAC / ABAC) | 单体或中小型微服务后台,希望直接在业务进程内用一张简单规则表搞定接口鉴权 | 缺乏跨层级递归图展开、反向对象枚举与分布式缓存去重能力 |
选型决策其实非常清晰:
- 如果你的核心复杂度在于“校验单次请求的 JSON 上下文属性、K8s YAML 规范或无状态网关路由规则”,选 OPA 或 Cedar;
- 如果你的核心复杂度在于“用户、嵌套团队、多租户组织、多级文件夹与海量业务资源之间存在动态变化的共享与继承拓扑图,且需要随时回答谁能访问哪个资源、某个资源有哪些协作者”,那么以 OpenFGA(或 SpiceDB)为代表的 Zanzibar 系关系授权引擎就是最契合的架构解。
9. 总结
回看从 Google Zanzibar 论文到 OpenFGA 开源引擎的演进脉络,你会发现它最深刻的工程贡献,是将原本散落在无数个微服务 if/else 分支和 SQL 多表 JOIN 里的隐式权限逻辑,升维成了一套显式的、可形式化推导的有向图系统:
原子指针化 :用 <object>#<relation>@<user> 消除写时展开风暴,让群组与目录变更降为 O(1) 指针修改
规则代数化 :用 schema 1.1 的 Computed Userset、Tuple-to-Userset 与集合算子声明静态推导图
一致性可控 :用 Zookie / consistency 档位在 98% 的本地缓存极速读取与敏感窗口防越权之间精准平衡
工程可测试 :用 fga model test 与 Shadow 旁路比对,让权限变更像普通代码一样可单测、可灰度、可回滚
当你把静态规则锁进不可变的 Authorization Model,把动态业务拓扑沉淀为标准的 Relationship Tuples,并严守认证与授权分离及 Fail-Closed 安全铁律时,权限系统就能彻底告别每次业务重构时人人畏惧的黑盒雷区,真正沉淀为支撑业务快速演进的可信安全底座。
参考资料
- Zanzibar: Google’s Consistent, Global Authorization System (USENIX ATC 2019) & Paper PDF
- OpenFGA Official Documentation — Core Concepts
- OpenFGA Configuration Language (Schema 1.1) & Conditions Guide
- OpenFGA Relationship Queries (
Check,Expand,ListObjects,ListUsers) - OpenFGA HTTP & gRPC API Reference
openfga/openfgaGitHub Repository (v1.18.1) &openfga/cliGitHub Repository (v0.7.17)
comments