在通用闲聊或简单文档摘要里,向量检索增强生成(Naive RAG)通常已经够用:把文档切成固定长度的 Chunk,算出 Embedding 放进向量库,用户提问时取余弦相似度最高的 Top- 片段塞进 Prompt。然而,一旦进入医疗指南核对、政务政策咨询、金融尽调或法律合规等严肃的专业领域,这种“靠语义长相找片段”的模式就会频频翻车。
为什么向量相似度撑不起专业领域的复杂问答?
想象三个真实的业务现场:第一,政策文件里写着“A 类补贴适用于年营收低于 2000 万元的科技型中小企业,但软件外包企业除外”,在稠密向量空间里,“适用”与“不适用”、“包含”与“除外”的余弦距离几乎贴在一起,向量检索极易召回表面词汇高度重合但逻辑方向截然相反的条款;第二,用户询问“某协奏曲作曲家的出生地在 14 世纪经历过多少次瘟疫?”,答案分散在音乐史、人物传记和城市编年史三篇完全不相关的文档里,单步向量检索连第二跳的目标城市叫什么都不知道,根本无从召回第三跳的疫情记录;第三,涉及年份相减、金额汇总或集合交并(AND / OR)时,语言模型很容易在自由生成中“凭感觉估算”出一个错误数字。
面对这些痛点,蚂蚁集团知识图谱团队与浙江大学联合提出的 KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation(配套开源仓库 OpenSPG/KAG 与知识底座 OpenSPG),给出了一套将符号知识工程与大语言模型深度融合的系统方案。在 HotpotQA、2WikiMultiHopQA 与 MuSiQue 三大多跳推理基准上,KAG 相比同基座模型的 IRCoT + HippoRAG 取得了 +12.5、+19.1 与 +12.2 个百分点的 F1 绝对提升(相对提升分别达 19.6%、33.5% 与 33.4%)。
透过具体的模块与实验表格,KAG 的核心突破建立在四条环环相扣的设计哲学之上:
- 三层知识表征与图-文互索引:用结构层做精确导航,用原文层做无损兜底(Hierarchical Representation with Mutual Indexing):纯专家 Schema 图谱太僵硬、覆盖慢,纯开放信息抽取(OpenIE)噪声大、缺规范,而纯文本块(Chunk)缺逻辑结构。KAG 通过 LLMFriSPG 将三者统一在同一套双向互索引体系中——上层图结构负责锁定实体约束与多跳路径,底层原文 Chunk 负责保留长尾条件与完整语境。
- 离线与在线双重概念对齐:用受控语义关系弥合开放抽取的粒度鸿沟(Concept-Bridged Semantic Alignment):开放抽取会产生海量同义词碎片与粒度错位。KAG 引入显式的概念图(Concept Graph)与六类有向语义关系(
isA、belongTo、isPartOf、contains、synonym、causes),离线阶段将零散实例挂载到稳定的概念层级树上,在线阶段则顺着概念桥接路径把用户的口语化提问导航至专业知识索引。 - 把自然语言编译为符号逻辑形式:用显式变量绑定与确定性算子取代黑盒推理(Logical-Form-Guided Hybrid Solving):放弃让大模型在纯自然语言 Chain-of-Thought 中边想边猜的做法,先把复杂问题编译成带显式变量依赖的逻辑形式(Logical Form),将拆解出的步骤交给
Retrieval、Sort、Math、Deduce等算子执行,并在结构化图检索不足时平滑回退到图-文混合检索与多轮反思(Reflection)。 - 离线构建与在线求解共享模型底座:NLU、NLI、NLG 协同微调(Co-designed Builder/Solver Capabilities):知识图谱构建(抽实体、判同义、写摘要)与在线问答求解(解析逻辑形式、判蕴含、受控生成)本质上依赖同一组底层语言能力。通过指令重构、语义关系推断与知识反馈对齐增强基座模型,能同时抬高离线构图质量与在线推理上限。
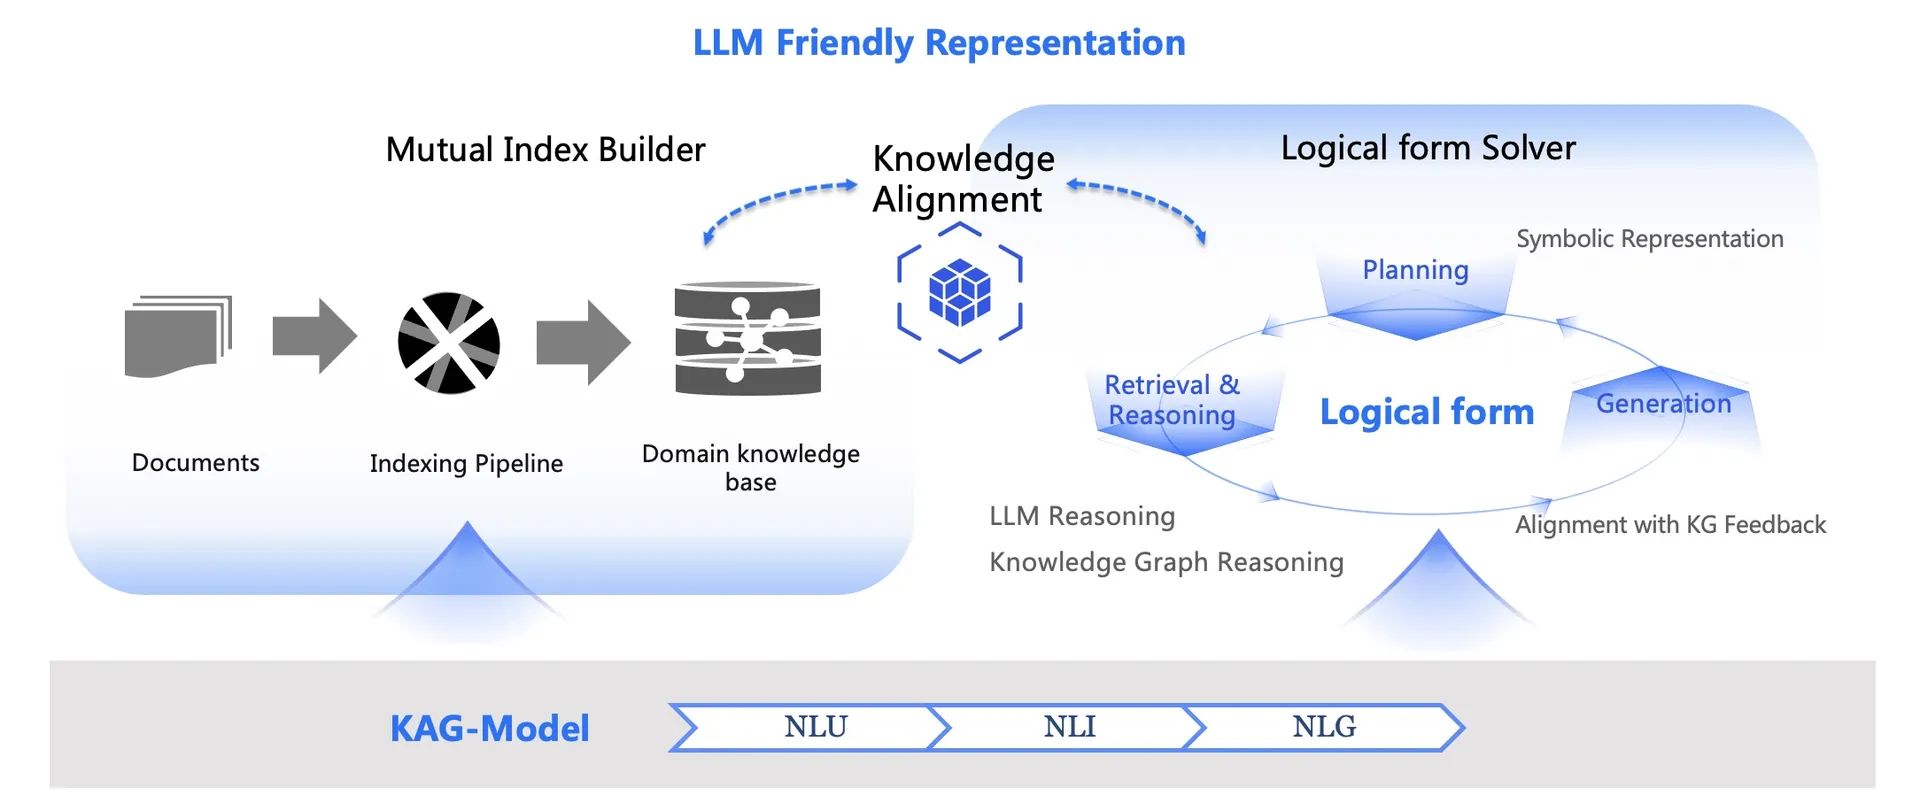
1. 为什么向量 RAG 搞不定专业领域问答?系统全景与架构权衡
1.1 专业知识服务的三大矛盾:准确性、完整性与逻辑严密性
在专业领域构建问答系统,架构师必须同时应付三项彼此拉扯的目标:
- 知识准确性(Knowledge Accuracy):专业问答容不得“大概相关”。比如医疗领域的药物配伍禁忌、政务领域的申办材料清单,一个否定词或适用范围的偏差就会导致结论反转。向量内积只能度量词面与话题共现,唯有显式的图拓扑、类型声明与逻辑操作符,才能把硬性约束从语言模型的概率模糊性中剥离出来。
- 信息完整性(Information Completeness):传统知识图谱最大的软肋是“抽不完”。文档里的前置定语、例外但书、背景解释和最新补充条款,一旦被强行压成
(主语, 谓语, 宾语)三元组,就会丢失大量上下文细节。因此,图谱绝不能丢弃原始文本,必须保留 Raw Chunks 并通过supporting_chunks边将每个实体、事件和关系死死锚定在原文证据上。 - 逻辑严密性(Logical Rigor):多跳问题包含严格的前后置依赖——上一步查出的实体是下一步检索的主体,多个分支查出的数值需要做差值或排序。将问题显式规划为符号化的执行步骤,才能让每一步的输入变量、命中证据和中间结论完全透明可查。
这三项目标之间存在天然的工程张力:追求极致的准确性需要重度专家 Schema,这会拖慢构建速度并牺牲覆盖率;追求完整性需要放开文本召回,又会放进噪声;增加多步逻辑规划与反思轮次,则会显著推高在线调用延迟。
1.2 KAG 三大子系统协同与 OpenSPG 底座分工
为了平衡上述张力,KAG 将全链路拆分为离线构建(KAG-Builder)、在线求解(KAG-Solver)与底座模型能力(KAG-Model)三大子系统:
- KAG-Builder 位于离线侧,接收领域文档、结构化数据、专家 Schema 与概念规则,依次完成语义切块、实体/事件/关系抽取、实例描述与摘要生成、概念挂载、实体消歧融合与向量化,最终将互索引结构写入图存储与向量库。
- KAG-Solver 位于在线侧,接收用户自然语言提问,先由 Planner 编译为带变量引用的 Logical Form 序列,再由 Reasoner 调度精确图检索、混合文本检索、数学计算或逻辑推断,将中间结果写入全局 Memory;若 Judge 模块判定证据仍不足以回答原问题,则自动生成补充查询(Supply Query)进入下一轮迭代,直至满足终止条件后由 Generator 输出最终答案。
- KAG-Model 位于底层,围绕 NLU(自然语言理解)、NLI(自然语言推断)和 NLG(自然语言生成)三项核心能力对开源基座进行针对性强化,同时服务离线抽取对齐与在线规划生成。
在工程代码层面,还需要厘清 KAG 与 OpenSPG 的职责边界:
KAG Builder / Solver (kag/*)
      |
      | SPGServerBridge / knext client
      v
OpenSPG Server :8887 (openspg/*)
  |          |          |
MySQL      Neo4j      MinIO
metadata   graph      objects
固定到 OpenSPG v0.8 与 KAG v0.8.0 源码来看,OpenSPG 是底层的可编程知识图谱底座(包含 server、builder、reasoner、cloudext 等模块,单机环境下由 :8887 服务端、存储元数据的 MySQL、承载图数据的 Neo4j 以及存储对象的 MinIO 组成);而 KAG 则通过 SPGServerBridge 和 knext 客户端调用 OpenSPG,在底座之上实现了互索引构建器、六类可配置索引管理器(KAGIndexManager)以及静态/迭代逻辑求解管线。
2. 核心设计哲学一:LLMFriSPG 与三层知识-文本互索引
2.1 为什么刚性 Schema 与纯开放抽取都走不通?
在构建领域知识图谱时,工程界长期分裂为两个极端:一派坚持专家预定义 Schema(Schema-Constrained),每个实体类型有哪些属性、允许连什么边都由领域专家严格限定,优点是结构干净、适合跑确定性规则,代价是建模周期极长,文档里90% 没被预先建模的长尾信息直接被丢弃;另一派转向大模型驱动的无约束开放抽取(Schema-Free / OpenIE),让 LLM 自由从文本里抽三元组,虽然自动化程度高,但抽出的关系名五花八门、概念层级混乱,很难写出稳定的图查询。
怎么把专家的严谨性与大模型的覆盖率捏合在同一个图模型里?论文提出了 LLMFriSPG(LLM-Friendly Semantic-Enhanced Programmable Graph),将其形式化为四元组:
其中, 是类型集合(涵盖 EntityType、EventType 等 SPG 类型), 是类型属性与关系的声明契约, 是独立于具体文档的通用与领域概念集合(含上下位层级语义关系), 则是可执行逻辑规则。
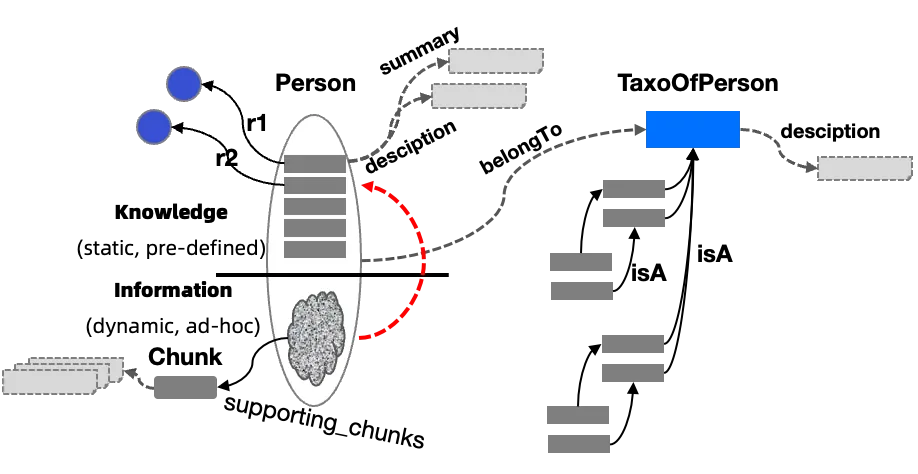
观察上图的层次结构,LLMFriSPG 的巧妙之处在于“顶层共享类型与概念词表,底层按约束强度分级实例化”。专家预先定义的核心业务字段和开放抽取出的临时动态关系,都挂载在同一套类型声明 与概念树 之下,并且统一指向底层的原文证据分块。
2.2 静态属性、动态属性与系统内建属性的协同契约
为了让大图模型和大语言模型都能无障碍读懂图中的节点,对于任意类型 ,LLMFriSPG 将其属性与关系集合 拆解为三个互补子集:
- 专家预定义静态属性 (Schema-Constrained):由领域专家事先声明的强约束业务字段(例如药品的标准批准文号、适应症、禁忌人群,或政务事项的法定办理时限),支撑高精度过滤与 DSL 规则推理。
- 运行时动态属性 (Schema-Free):在文档抽取阶段由大模型按需补充的开放属性与关系,用于兜底专家未预先枚举的事实细节。
- 系统内建属性 (System Built-in):这是让符号图谱变得“对 LLM 友好”的关键桥梁,强制每个实例节点和关系边维护四项核心元数据:
supporting_chunks:指向产出该实例或关系的原始文本块 ID 列表,构成从图回溯原文的铁证;description:挂在类型定义上时解释该类型的全局领域含义;挂在具体实例上时,则结合当前文档上下文生成针对性描述,避免同名异义实体在向量空间里挤成一团;summary:实例或关系在所属文档段落中的核心事实摘要;belongTo:将具体文档里的实例节点归纳连接到概念图中的标准概念节点(例如将具体文本中出现的议会实体Chamber连接到标准概念Legislative Body)。
2.3 KG_cs、KG_fr 与 RC 的三层互索引拓扑
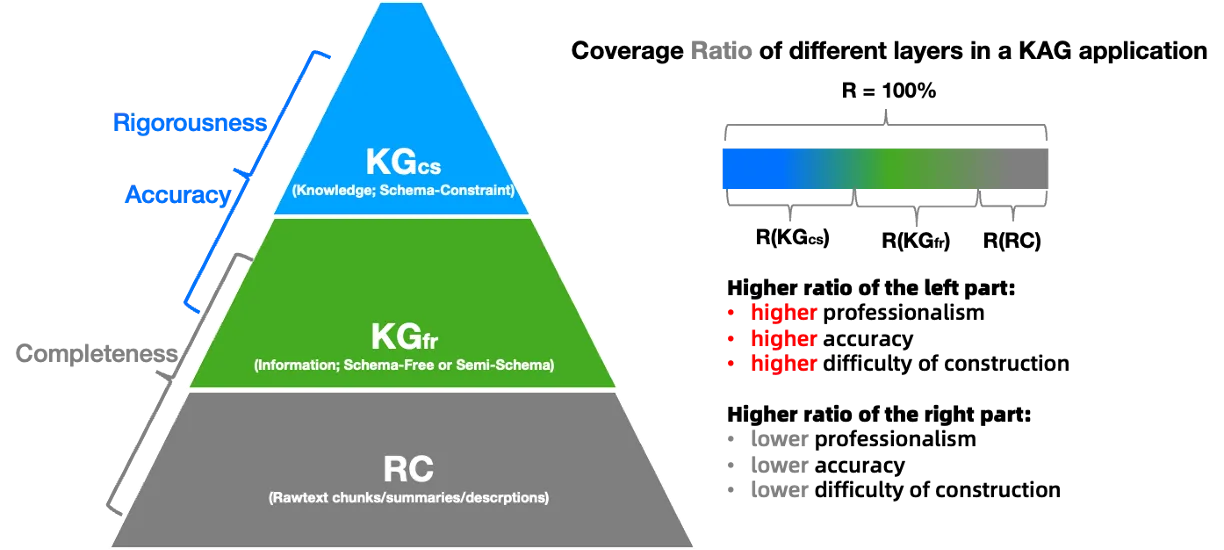
围绕上述属性设计,KAG 将整个知识空间划分为如上图所示的三个层次,并在图数据库(KG Store,如 Neo4j、TuGraph)与向量存储(Vector Store,如 Milvus、ElasticSearch 或图库内置向量索引)之间建立起双向互索引(Mutual Indexing):
| 知识层级 | 符号记法 | 承载的核心内容 | 在混合求解中的分工 |
|---|---|---|---|
| 强约束专业图谱层 | 遵循预定义 Schema 的高可靠实体、标准属性与逻辑规则 | 承担核心业务规则校验、精确属性过滤与高置信度路径推理 | |
| 开放信息图谱层 | 开放抽取的实体、事件、动态三元组及概念图语义边 | 捕捉跨段落长尾实体关联,并通过 belongTo / isA 提供概念级查询导航 | |
| 原始文本分块层 | 经语义切分的原始文档段落(Raw Chunks)、表格与章节树 | 保留 100% 原始措辞、例外条件与上下文语境,在图检索覆盖不足时提供原文兜底 |
为什么叫“双向互索引”?因为在在线求解时,检索游标可以在这三层之间双向自由穿行:
正向下钻(从结构到原文):
  Query Mention -> Concept (C) -> Instance/Event (KG_cs / KG_fr) -> SPO Path -> supporting_chunks -> Raw Chunk (RC)

反向升维(从原文到结构):
  Query Embedding -> Raw Chunk (RC) -> Extracted Entities -> Concept / 1-hop Neighboring Facts (KG_fr / KG_cs)
如果只有单向的 Entity -> Chunk,当用户的提问措辞高度口语化、未能直接命中图实体时,系统就无法先靠向量召回文本块再顺藤摸瓜进入图谱做多跳推理;反过来,如果只有 Chunk -> Entity,当图谱推理出某条多跳路径后,又无法顺着 supporting_chunks 拉出原始段落来核验前置条件是否成立。双向互索引加上跨版本稳定的 chunk_id,让“精确图推理”与“完整文本证据”真正连成了闭环。
3. KAG-Builder:从非结构化文档到双向互索引图谱
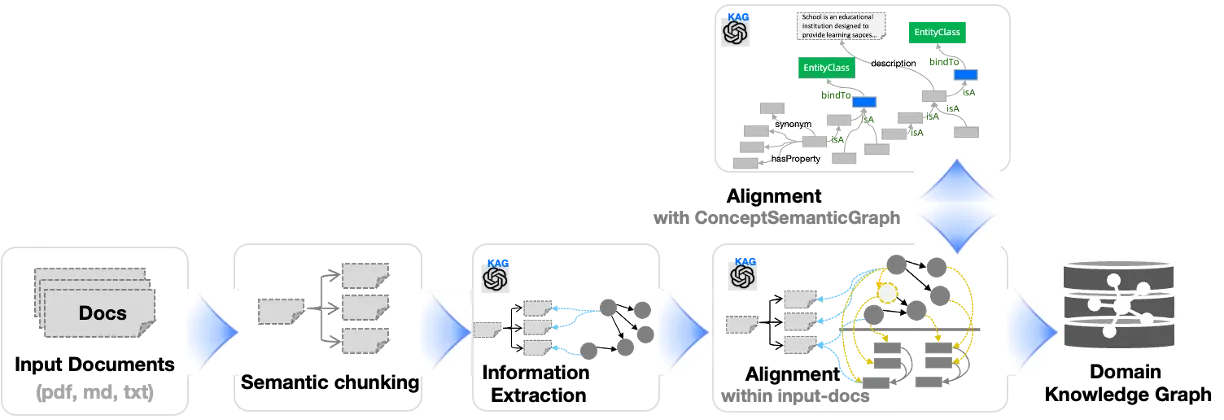
3.1 组件化构建流水线与语义切分契约
离线阶段如何把杂乱的 PDF、Word 或 Markdown 文档变成上面那套三层互索引结构?
在 KAG v0.8.0 源码中,构建入口 BuilderMain 与 default_chain.py 将离线流水线抽象为操作符重载的声明式链条:
pipeline = (
    reader
    >> splitter
    >> extractor
    >> vectorizer
    >> postprocessor
    >> writer
)
pipeline.invoke(input_data)
源码提供了三条预置主链:面向结构化表记录映射的 DefaultStructuredBuilderChain、面向非结构化文档切分与抽取的 DefaultUnstructuredBuilderChain,以及专门用于导入先验本体与概念树的 DomainKnowledgeInjectChain,并通过 ThreadPoolExecutor 并发调度处理。
在非结构化主链的第一棒,Semantic Chunking(语义切分)直接决定了后续抽取与溯源的成败。如果按固定字符数一刀切,很容易把一张表格的表头和表体劈成两半,或者把“除非存在以下情形:”和后面的列举项切进两个不同的 Chunk,导致抽取器抽出完全反向的结论。为此,kag/builder/component/splitter 提供了 outline(按文档标题大纲层级切分)、semantic(利用大模型或语义边界保持段落内聚)、pattern(按正则标记切分)与 length 组合策略。每一个生成的 Chunk 都会绑定包含文档 ID、章节路径(title_path)与确定性哈希的 chunk_id,确保文档局部修订时不会导致全量图节点的 supporting_chunks 引用悬空。
3.2 实体-事件-关系级联抽取与领域知识注入
拿到语义完整的 Chunk 后,如果直接让大模型一步抽完所有三元组,模型往往只盯着显眼的名词,漏掉隐含的动作条件、时间地点和因果修饰。KAG 因此采用了**“实体 事件 关系”的三阶段级联抽取协议**:
- 第一阶段抽实体集 :识别段落中的所有命名实体与专业术语,同步生成其实例级
description、summary与细粒度语义类型(semanticType); - 第二阶段抽事件集 :以第一阶段识别出的实体为锚点,抽取涉及这些实体的动态事件(Event)及事件要素(时间、地点、参与角色);
- 第三阶段迭代抽关系集 :在实体与事件构成的候选对之间抽取结构化 SPO 三元组,并将当前 Chunk 的 ID 写入所有产出节点和边的
supporting_chunks字段。
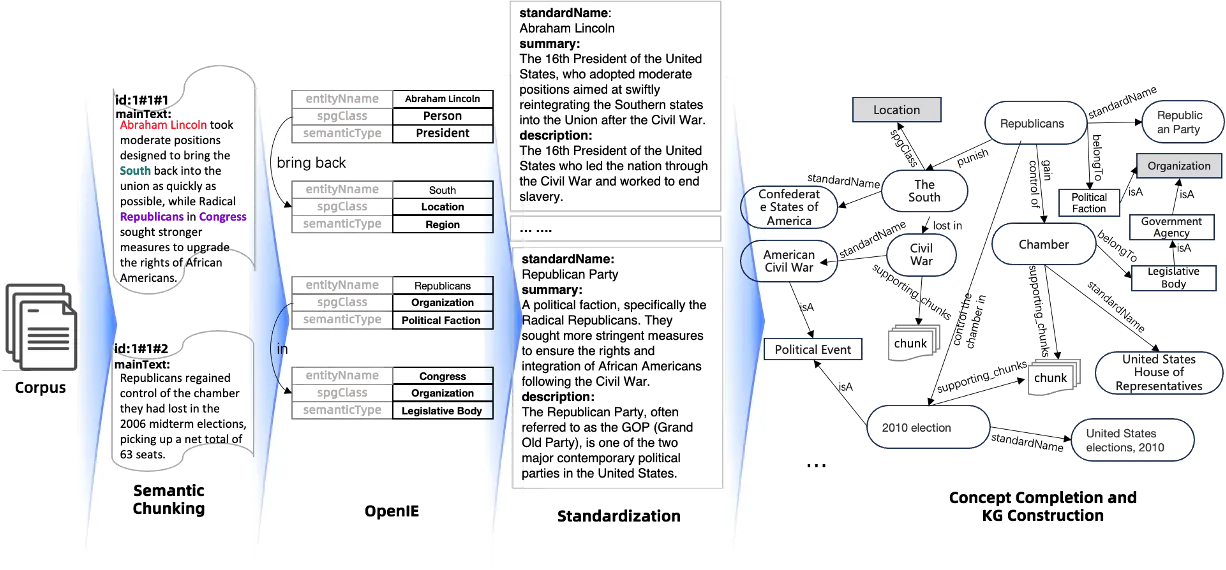
看上图从美国政治历史文档中抽取出的实例网络:具体文本中的人物、政党、议会机构与历史事件被抽取为底层实例节点,同时通过 belongTo 向上挂载到 Political Party、Legislative Body、Government Agency 等概念节点,向下则通过 supporting_chunks 连回原始文本段落。在 v0.8.0 的 kag/builder/component/extractor 目录下,抽取器进一步细化为 schema_constraint_extractor.py、schema_free_extractor.py、atomic_query_extractor.py、knowledge_unit_extractor.py、table_extractor.py 与 outline_extractor.py,支持针对不同文档形态产出定制化的索引单元。
4. 核心设计哲学二:基于概念图的离线与在线知识对齐
4.1 开放图谱的三大错位与六类有向语义关系
为什么很多团队用大模型抽完三元组塞进 Neo4j 后,发现多跳检索的命中率依然惨不忍睹?因为未经对齐的开放图谱普遍存在三种致命的结构错位(Misalignment):
- 语义关系方向错位:向量相似度具有对称性(),分不清“谁包含谁”、“谁导致谁”。比如“车轮”和“汽车”语义高度相关,但
wheel isPartOf car正确,car isPartOf wheel则是荒谬的。 - 知识粒度孤岛:不同文档作者用词习惯不同。一篇文档写“美国众议院”,另一篇写“下议院”,第三篇写“立法机构”;OpenIE 会把它们抽成三个毫无连边的孤立节点,导致跨文档多跳路径在此断头。
- 领域分类体系缺失:通用大模型知道“白内障是一种眼部疾病”,却未必清楚某地医保目录里“视觉障碍补贴”与“晶状体混浊手术”之间的政策归属层级。
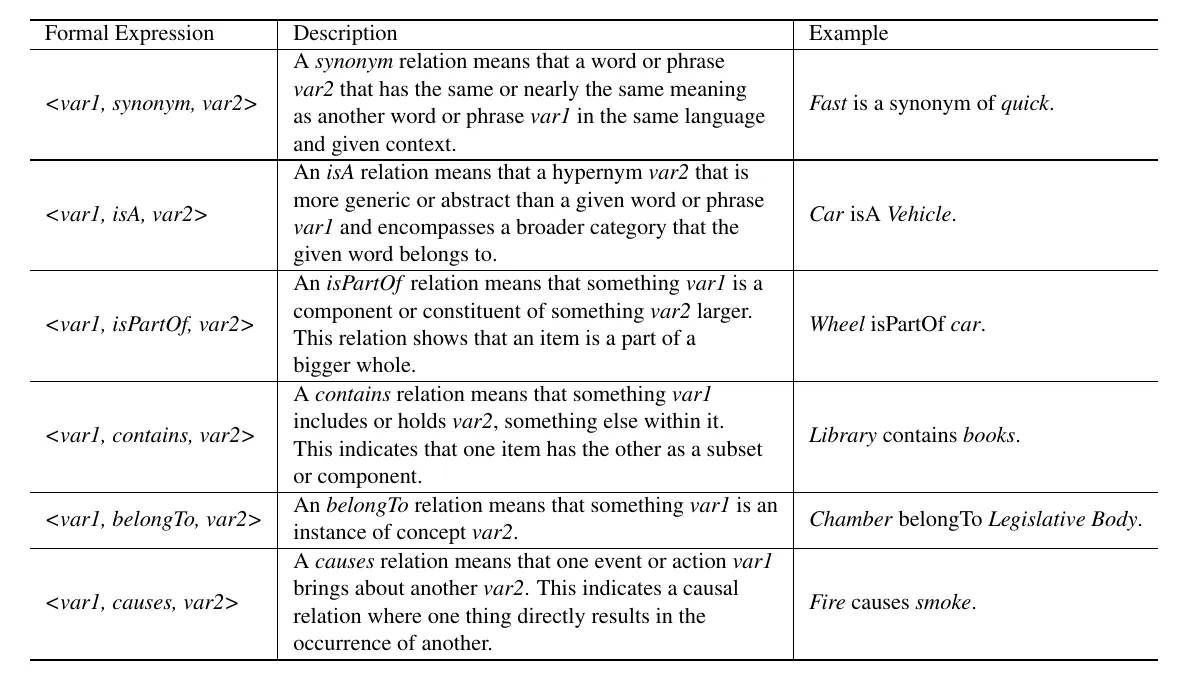
为了给松散的开放图谱装上严格的“方向感”与“层级骨架”,KAG 在概念图(Concept Graph)中重点引入了上表所示的六类有向语义关系:
synonym(<var1, synonym, var2>):用于同义词归一与实体消歧,要求在相同上下文语义域下完全等价,严格区别于宽泛的话题相关;isA(<var1, isA, var2>):从下位概念指向更宽泛的上位概念(Hypernym),具有明确的方向性与层级传递距离;isPartOf与contains:互为逆向的整体-部件/集合包含关系,用于界定空间、组织架构或流程模块的组成边界;belongTo(<var1, belongTo, var2>):专门用于从具体文档实例向抽象概念节点的归纳映射(Instance-to-Concept);causes(<var1, causes, var2>):从原因事件指向结果状态,为故障诊断、政策触发条件与医学病理提供有向因果链。
4.2 离线消歧融合与在线查询概念桥接
有了这六类语义关系,KAG 在离线索引构建与在线查询路由两个阶段打出一套组合拳:
在离线阶段,系统依次执行三步图增强:
- 结合上下文描述的实例消歧与融合:判断两个同名或近义节点是否指向同一实体时,绝不能只看名字字符串(否则会把水果里的“苹果”和科技公司“苹果”合在一起)。系统综合比对实体的一跳邻居关系与实例级
description预测synonym候选集 ,选定中心目标实体 后,将其他冗余节点的属性、关系及supporting_chunks归并过来并记录同义词列表。 - 实例到概念挂载:对每个抽出的实体和事件 ,预测其所属的标准概念 ,写入有向边 。
- 上位概念路径补全:利用大模型的概念推理能力(或注入的领域词表),自动补全从细粒度概念到高阶概念的
isA链条(例如Legislative Body -> isA -> Government Agency -> isA -> Organization)。这样一来,原本散落在不同文档里的细碎实例,在顶层概念树上被全部连通。
到了在线查询阶段,这套概念图就成了跨表达导航的“罗盘”。举个论文中的典型例子:文档库里记载的是针对 “visually impaired(视障人士)” 的政策条款,而用户提问时写的是 “白内障患者(cataract patients)能享受什么政策?”。
如果只做精确实体匹配,图中根本没有“白内障患者”直接连向该政策的边;如果放开做无约束的查询改写,又容易引入噪声。KAG 的在线对齐流程则是:先识别出查询中的核心概念 Cataract Patient,当精确匹配未命中目标关系时,顺着概念图中的有向边推导(Cataract -> causes -> Visual Impairment,或沿 isA / belongTo 向上回溯到 Visually Impaired),通过这条可解释、带方向的受控概念路径精准降落到对应的实例子图与原文 Chunk。
5. 核心设计哲学三:逻辑形式引导的混合推理与多轮反思
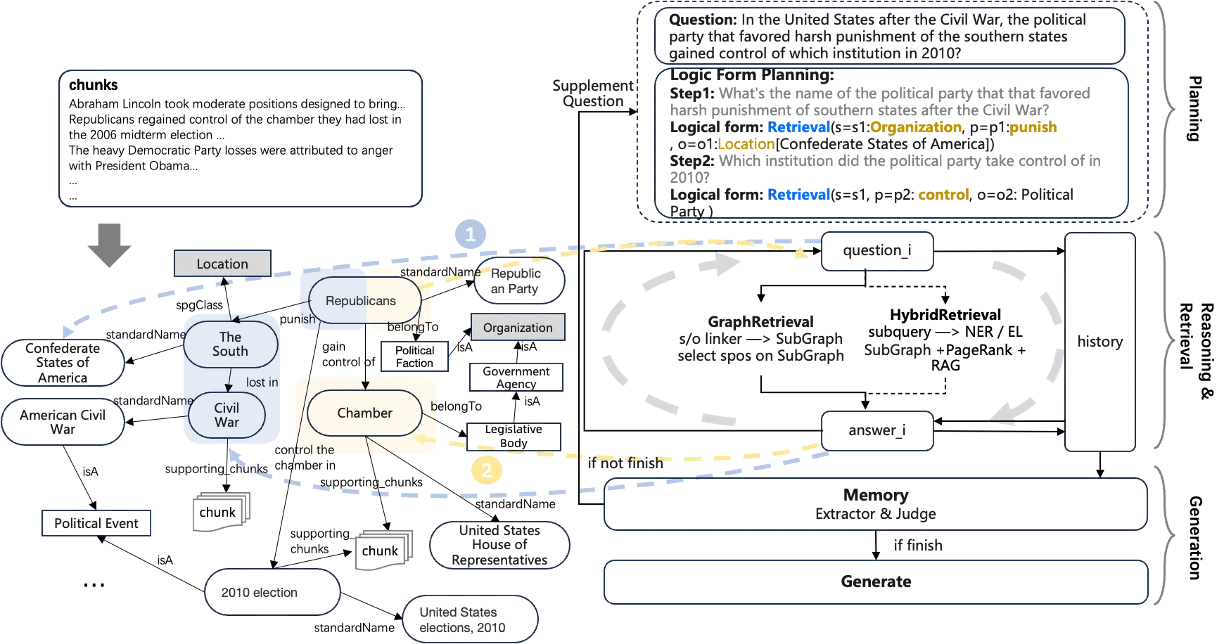
5.1 把多跳问答变成带变量绑定的状态机
为什么 IRCoT 等经典的“边想边搜(Interleaved Retrieval with Chain-of-Thought)”方法在复杂专业问题上还是容易出错?因为纯自然语言的思考过程没有严格的变量作用域和算子契约——模型在第二跳生成的自然语言查询很容易把第一跳设下的年份、地点或排除条件忘掉,或者在拿到一堆数字后直接在文本里心算出错。
如上图所示,KAG-Solver 的核心巧思是将多跳问答建模为一个由逻辑形式(Logical Form)驱动的显式状态机。每一轮迭代的运行时状态都清晰维护着原问题、当前子问题、符号函数列表、变量绑定字典(variable_bindings)、已召回证据以及历史子答案:
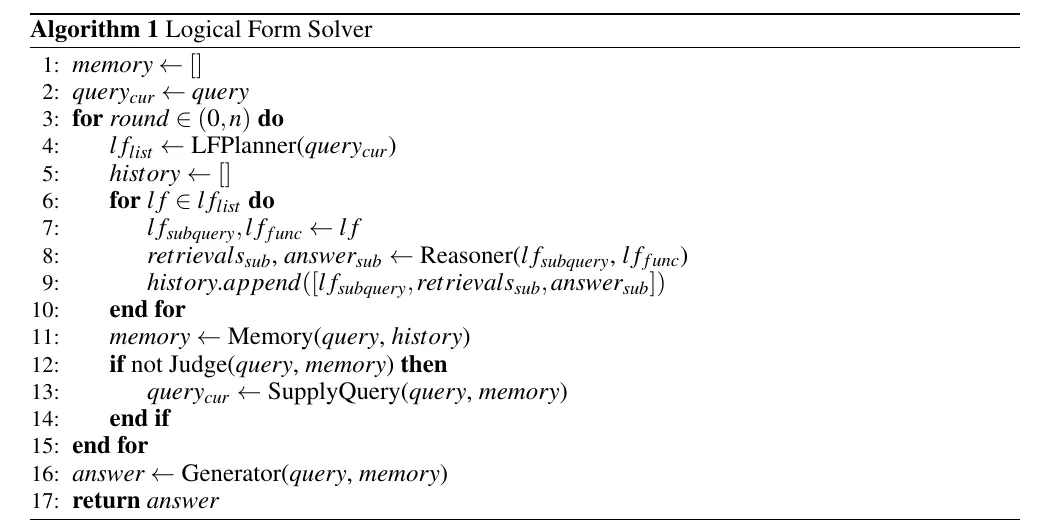
顺着上方 Algorithm 1 的伪代码看,整个求解主循环分为八个严密步骤:
- 初始化空的全局记忆
memory,将当前待解查询query_cur设为用户初始问题query; - 在最多 轮的反思循环中,先调用
LFPlanner(query_cur)将当前问题拆解为具有拓扑依赖的子步骤列表 ; - 对列表中的每一个逻辑步骤,分离出面向语义理解的自然语言子问题 与面向确定性执行的符号逻辑函数 ;
- 调用
Reasoner(lf_subquery, lf_func)执行该步操作,拿到当前步的检索证据retrievals与局部子答案answer_sub,并更新中间变量绑定; - 将当前子问题、证据与子答案追加进轨迹记录
history; - 当前计划的所有子步骤跑完后,调用
Memory(query, history)对多步证据与中间结论做去重归并; - 调用
Judge(query, memory)审视当前全局记忆中的已知事实是否已经足够且无歧义地回答原始问题; - 若
is_solved == False,则调用SupplyQuery(query, memory)针对缺失的证据环生成下一轮补充查询,继续循环;若已解决或达到轮次上限,则交由Generator(query, memory)基于完整证据链生成最终回答。
5.2 五类符号算子与多跳数值依赖拆解
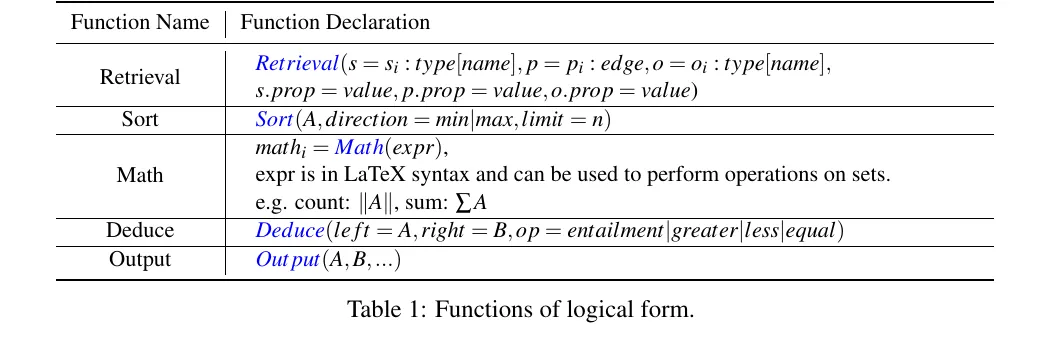
为了让 Planner 规划出的步骤既能被图数据库/搜索引擎执行,又能做精确计算,论文设计了上表所示的五类核心逻辑函数:
Retrieval:按主体(s)、谓词关系(p)、客体(o)以及边/节点属性约束,从图谱或文本索引中检索目标实体与属性值,并将结果绑定到符号变量(如o1、o2);Sort:对已绑定变量的候选集合按指定属性升序或降序排列,并截取 Top-(处理“最早”、“最高”、“前三个”等极值约束);Math:将计数(count: |A|)、求和(sum)、差值等算术运算从语言模型的概率生成中剥离出来,交给确定性数学执行器计算;Deduce:对已绑定变量执行蕴含判断(entailment)或数值/集合比较(greater、less、equal、and、or);Output:显式指定将哪些最终变量打包输出。
我们来看一个论文中的真实多跳数值问题:“C 罗在 2011 年效力的足球俱乐部,在当时已经成立了多少年?”
如果让普通 RAG 去答,向量检索往往只搜出 C 罗效力皇马的新闻,却漏掉了皇马的成立年份,或者模型自己算错减法。而在 KAG 中,Planner 会将其编译为如下四步逻辑形式程序:
Step 1: Retrieval(
  s=s1:Person["Cristiano Ronaldo"],
  p=p1:playFor,
  o=o1:SportsTeam,
  p.playForYear=2011
)
Step 2: Retrieval(s=s2:SportsTeam[o1], p=p2:foundedAt, o=o2:Year)
Step 3: Math(math1 = 2011 - o2)
Step 4: Output(math1)
看这段逻辑形式的精妙之处:
- 在
Step 1中,查询不仅指定了关系playFor,还把时间约束p.playForYear=2011显式挂在了边属性上,查出的俱乐部实体被绑定到变量o1(即 Real Madrid); - 在
Step 2中,主语直接引用上一步绑定的变量s2:SportsTeam[o1],去查其成立年份属性foundedAt并绑定到变量o2(即1902); - 在
Step 3中,Math算子直接对常量2011与变量o2做确定性减法2011 - 1902 = 109,彻底杜绝了算术幻觉。
5.3 图检索优先、混合检索回退与 Global Memory 反思闭环
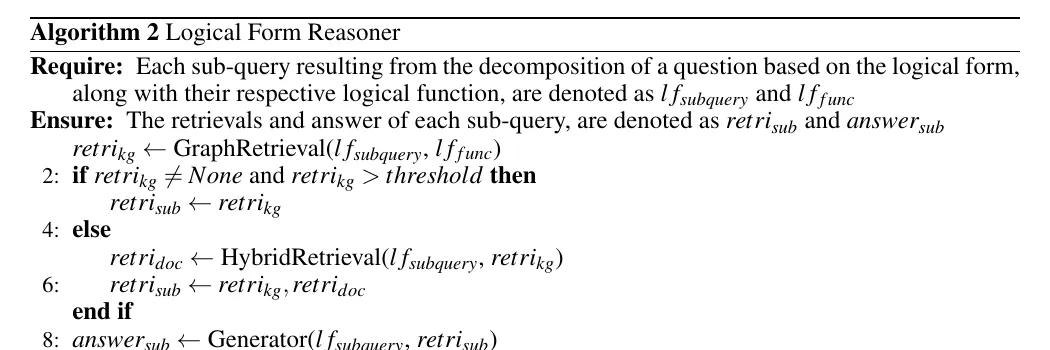
当单步 Reasoner 拿到子问题 和逻辑函数 时,它内部是怎样在“图”和“文本”之间做取舍的?上方 Algorithm 2 揭示了 KAG 的“图检索优先,混合检索回退”策略:
- 优先尝试精确/模糊图检索(
GraphRetrieval):系统首先解析 中的实体、类型与关系约束,在 与 上匹配结构化路径或一跳 SPO。如果精确模板未命中,还会借助前文第 4 节的在线概念对齐做受控语义扩展。 - 充分性门限判定(
score > threshold):如果图谱直接返回了满足约束的高置信度结构化事实(例如直接从图中查到了foundedAt = 1902),系统当场采纳该结果并跳过文本块召回,从而保持极致的上下文纯净度。 - 互索引混合检索回退(
HybridRetrieval):一旦图谱覆盖不足(结果为空或置信分低于阈值),系统立刻触发回退路径——把已经定位到的局部图节点作为锚点,顺着supporting_chunks边拉出关联原文,同时结合子问题的稠密向量与 BM25 检索召回补充文档 Chunk,合并图与文本证据后交由局部 Generator 提炼子答案。
而在多轮反思层面,如果只是把每轮召回的所有长段落无脑拼接到 history 里,两三轮下来上下文窗口就会被撑爆。因此,Global Memory 的核心职责是对跨轮次信息做结构化蒸馏:将已证实的实体与数值锁定在 facts 槽位(附带证据 Chunk ID),将首轮证据模糊的原因记录在 hypotheses 槽位,将尚待查明的缺口提炼为 unresolved 约束,并维护 visited_queries 集合以防止下一轮 SupplyQuery 陷入原地踏步的死循环。
6. 核心设计哲学四:KAG-Model 底座能力增强与单任务验证
6.1 NLU、NLI、NLG 的共享能力矩阵与指令重构
在早期的 NLP 流水线中,命名实体识别、实体链接、关系抽取、问题解析和答案生成往往由五六个不同的小模型分头承担,不仅维护繁琐,而且上游小模型一旦抽错,下游毫无自愈能力。
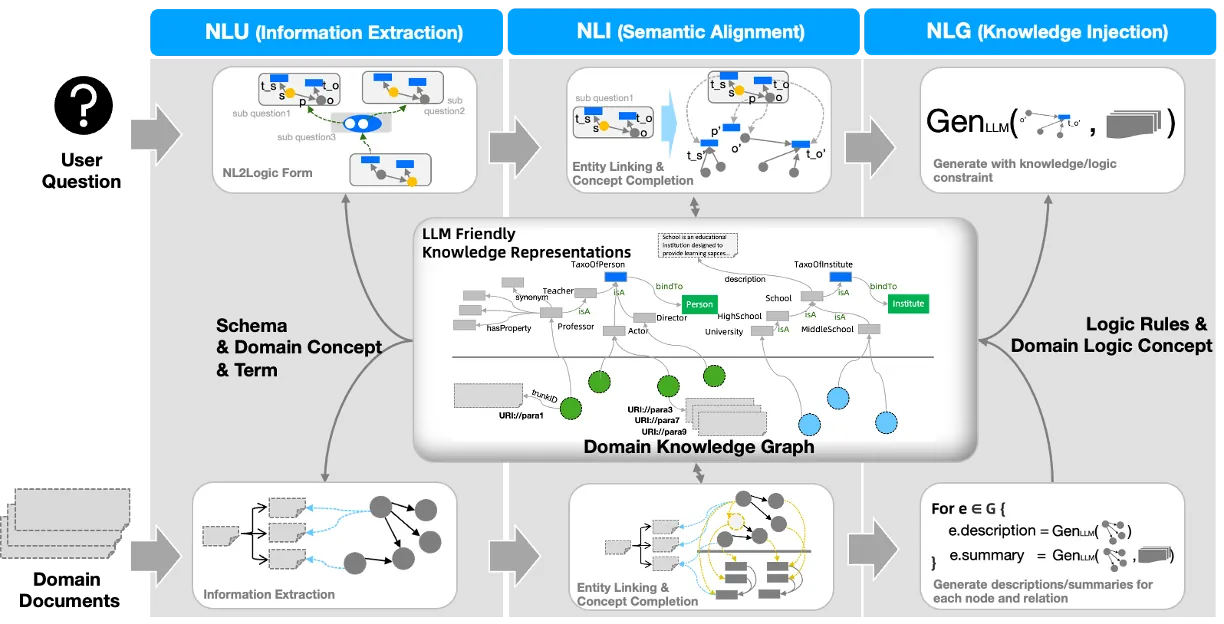
KAG 的第四条设计哲学是:把离线 Builder 和在线 Solver 依赖的所有原子任务,统一拆解并收敛到底座大模型的 NLU、NLI、NLG 三大基础能力上(如上图 Fig. 7 所示):
- NLU(自然语言理解):支撑离线侧的文档分类、实体提及检测(Mention Detection)、关系与事件抽取,以及在线侧将用户问题编译为 Logical Form;
- NLI(自然语言推断):支撑离线侧的实体消歧、实例到概念挂载(
belongTo)、上位概念发现(isA),以及在线侧的语义关系匹配与蕴含判断(Deduce); - NLG(自然语言生成):支撑离线侧生成实例级
description与上下文summary,以及在线侧严格遵循知识证据的受控回答生成。
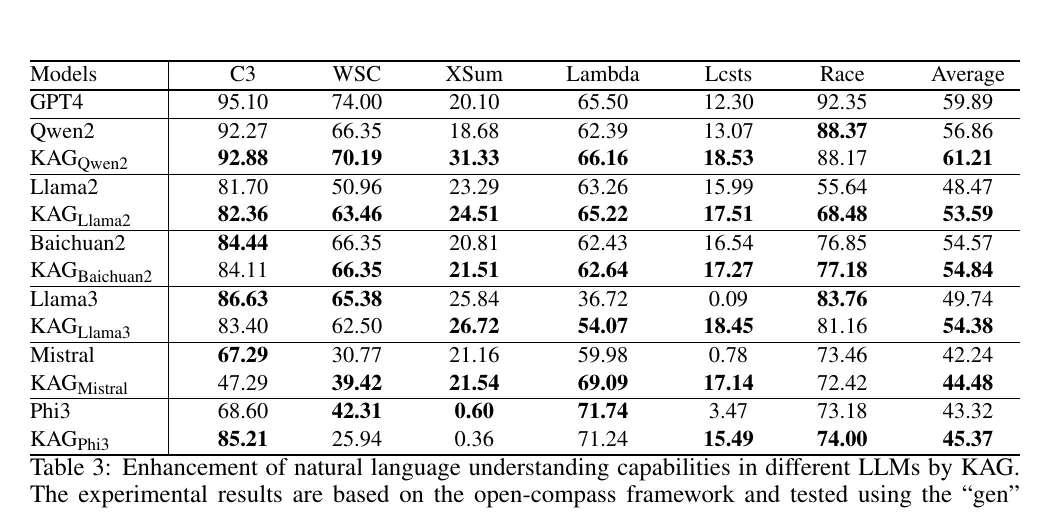
为了提升基座模型的 NLU 底盘,论文采用指令重构(Instruction Reconstruction)方法,将多样化的理解与抽取任务改写为多指令格式的监督微调数据。看上表 Table 3 在 C3、WSC、XSum、Lambda、L-CSTS、RACE 六个基准上的对比:经过 KAG 指令重构微调后,KAG-Qwen2 的六任务平均分从原生 Qwen2 的 56.86 跃升至 61.21(其中 XSum 与 L-CSTS 提升尤为显著),KAG-Llama2 从 48.47 提升至 53.59,展现出对复杂指令与长文本结构提炼的明显增益。
6.2 语义推断与医疗概念上位词发现
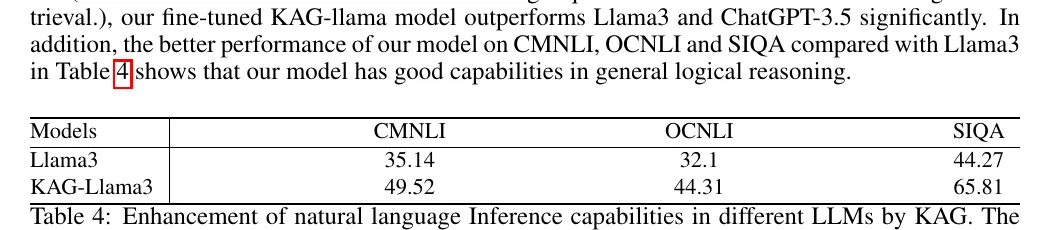
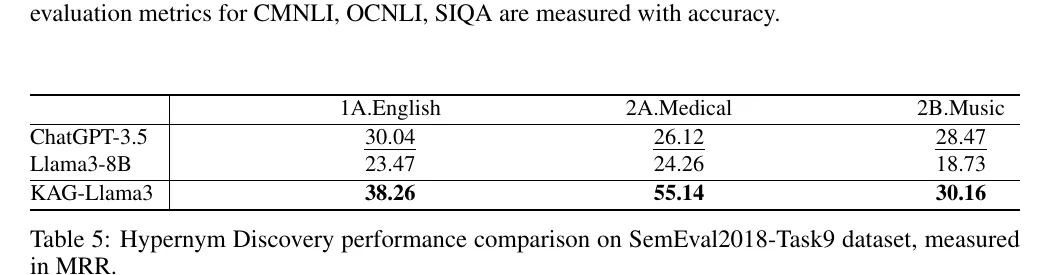
在决定知识对齐质量的 NLI 与概念推理能力上,论文收集了超过 2 万个高质量概念节点与 7 类核心语义关系构建训练集。看上方 Table 4 与 Table 5 的实验结果:
- 在通用自然语言推断基准(CMNLI、OCNLI、SIQA)上,
KAG-Llama3分别拿到49.52、44.31与65.81,相比原生 Llama3(35.14、32.1、44.27)实现了跨越式提升; - 更关键的是 Table 5 的 SemEval2018-Task9 上位概念发现(Hypernym Discovery)评测:在通用英语(1A English)和音乐(2B Music)子集上,
KAG-Llama3的 MRR 达到38.26和30.16,全面超越 ChatGPT-3.5 与原生 Llama3-8B;而在高度依赖专业术语层级的医疗子集(2A Medical)上,KAG-Llama3的 MRR 直接从原生模型的24.26飙升至55.14(翻了一倍有余)!这组数据直接印证了:只要通过领域概念关系数据对基座模型做针对性强化,大模型完全有能力为离线与在线概念对齐提供高精度的isA/belongTo语义桥接。
6.3 知识反馈对齐生成与单次前向联合探索
在生成端(NLG),专业问答最忌讳模型无视检索回来的知识证据、顺着预训练参数记忆自由发挥。为此,论文提出了 K-LoRA 与 AKGF(Aligning with Knowledge Graph Feedback),将知识图谱的一致性校验引入偏好对齐阶段。从奖励建模视角看,生成结果 在给定问题 与知识子图 下的综合反馈信号由三部分耦合而成:
分别约束输出与给定图谱事实的一致性(惩罚捏造实体或篡改关系)、回答本身的流畅完整性以及输出格式规范。
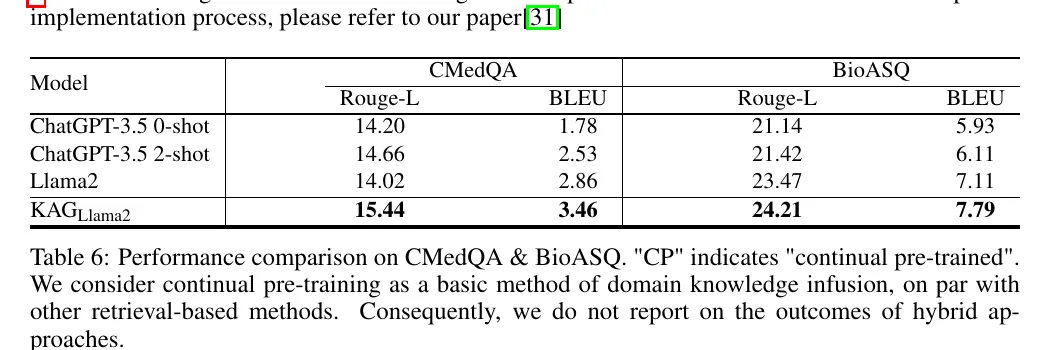
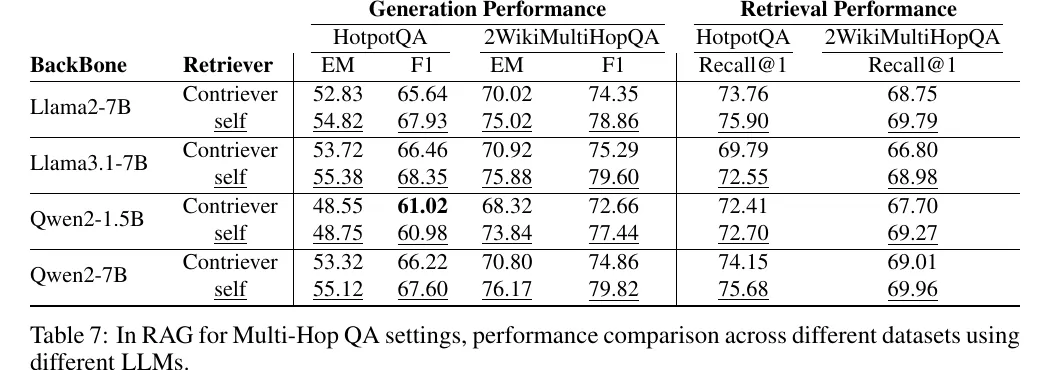
如 Table 6 所示,在 CMedQA 与 BioASQ 两大医疗问答数据集上,经过知识反馈微调的 KAG-Llama2 在 Rouge-L / BLEU 指标上分别达到 15.44 / 3.46 与 24.21 / 7.79,显著优于 ChatGPT-3.5(0-shot/2-shot)及原生 Llama2。同时,论文在 Table 7 中还展示了团队同期的探索工作 OneGen:通过在自回归生成序列中穿插特殊的检索 Token,让单个模型在一次前向传播(One-pass)中同时完成自检索(Self-Retriever)与答案生成,在 2WikiMultiHopQA 上将 Llama3.1-7B 的表现推高至 75.88 EM / 79.60 F1。
7. KAG v0.8.0 源码深挖:可配置索引、双模管线与优先级调度
论文发表时对应的是 KAG 0.5 原型,而在后续发布的稳定版 KAG v0.8.0 中,工程团队对代码架构做了一次彻底的模块化重构——将原本耦合在一起的索引与求解逻辑,拆解为可按业务场景自由拼装的平台级组件(后续更进一步支持接入独立演进的复杂推理模型 KAG-Thinker)。
7.1 KAGIndexManager:按查询形态按需装配六类索引
打开 kag/indexer/kag_index_manager.py,可以看到一个极具工程美感的设计:把“离线用什么 Extractor 建索引”和“在线用什么 Retriever 查索引”封装在同一个 KAGIndexManager 派生类里成对生成。这样应用层只需在 YAML 配置里指定一个索引管理器名称,离线 Builder 和在线 Solver 就会自动对齐数据契约,从源头杜绝“离线建了 A 索引、在线配错了 B 检索器”的错配问题。
v0.8.0 内置了六种成本与能力梯次分明的索引管理器:
| IndexManager 实现类 | 离线构建的核心索引对象 | 在线配对的 Retriever | 对应的典型业务场景 | 构建与服务成本梯度 |
|---|---|---|---|---|
ChunkIndexManager | 原始文本 Chunk + 稠密向量 | Vector / Text Chunk Retriever | 单跳事实问答、通用短 FAQ | 最低(仅切块与 Embedding) |
AtomicIndexManager | 从 Chunk 派生的原子问题(Atomic Queries) | Atomic Query + Chunk Retriever | 用户口语提问与文档正式表述差异极大 | 中低(构建期需 LLM 生成候选问题) |
TableIndexManager | 结构化表格行列 Schema 与表格摘要 | Table Retriever | 财报、政企统计表、规格参数对比问答 | 中(强依赖高质量表格解析器) |
SummaryIndexManager | 段落与文档级层次化摘要 | Summary Chunk Retriever | 长文档宏观主题归纳、全局概览问答 | 中(构建期需 LLM 递归摘要) |
OutlineIndexManager | 文档章节标题层级树(Outline Tree) | Outline Chunk Retriever | 操作手册、法律法规等强章节结构文档导航 | 低(依赖可靠的标题结构解析) |
KAGHybridIndexManager | KnowledgeUnit(实体+事件+SPO+概念+Chunk) | KG + Free-text Hybrid Retrievers | 跨文档多跳推理、强约束专业领域知识服务 | 最高(全套抽取、对齐与图-文双写) |
这种分级设计给工程落地带来了极大的灵活性:如果你的业务只是一套结构规整的内部规章手册,先开启 OutlineIndexManager + TableIndexManager 就能以极低的构建成本解决大半问题;只有当业务确实存在复杂的跨文档实体关系链时,才需要开启重型的 KAGHybridIndexManager。
7.2 KAGStaticPipeline 与 KAGIterativePipeline 的延迟-精度权衡
在求解端入口 SolverMain 下,v0.8.0 提供了两条适应不同延迟预算的求解管线:
1. KAGStaticPipeline(静态 DAG 并发管线):
   Query -> Planner (一次性生成完整 DAG) -> [Executor A || Executor B] -> Dependent Executor C -> Generator

2. KAGIterativePipeline(动态迭代反思管线):
   Query -> Plan 1 Step -> Execute -> Update Context & Memory --(Unresolved & iter < max)--> Plan Next Step
--(Solved)-------------------> GeneratorKAGStaticPipeline:Planner 在首轮一次性吐出完整的逻辑形式有向无环图(DAG),执行引擎识别出没有前后置变量依赖的平行分支后,直接并发调度 Executor 执行。它的最大优势是延迟可预测、并发度高、LLM 调用次数有硬性上界,非常适合问题套路相对固定、对响应延迟(SLA)敏感的在线服务;缺点是一旦初始 DAG 把实体或路径猜偏,中途无法改写计划。KAGIterativePipeline:每轮只规划并执行当前最紧迫的一步,拿到真实检索回来的实体和事实后更新上下文,再决定下一步往哪个方向追问(内置MaxIterationsReachedError熔断保护)。它能够应对前序实体未知、需要“摸着石头过河”的深度探索问题,但串行多轮调用会显著拉长尾延迟。
7.3 KAGHybridRetrievalExecutor:优先级组串行与同级并发短路
在混合检索执行器 KAGHybridRetrievalExecutor 中,v0.8.0 将论文 Algorithm 2 的“图优先、文本回退”推广为一套通用的优先级分组调度机制:
groups = group_by_priority(self.retrievers)
for priority in sorted(groups.keys()):
    outputs = run_concurrently_in_threadpool(groups[priority], query, context)
    merged_output.merge(outputs)
    if merged_output.is_sufficient():
        break
return merged_output
系统允许挂载任意多个 Retriever 并为每个 Retriever 配置整数优先级 priority:
- 跨优先级组串行:数字更小的高优先级组(例如精确图路径检索、原子问题检索)先跑;一旦合并后的证据满足充分性判定,立即
break短路返回,绝不浪费算力去跑低优先级的高开销检索; - 同优先级组内并行:处于同一
priority层级的多个互补检索器(例如同时查向量 Chunk 与全文 BM25),则交由ThreadPoolExecutor并发拉取,将墙钟等待时间压到最短。
此外,整个求解过程通过 Task-scoped Context 与 Reporter 实现全链路留痕,并在 kag_mcp_server.py 中封装了标准 MCP(Model Context Protocol)服务端,使外部 Agent 可以把 KAG 当作即插即用的专业知识求解工具。
8. 多跳问答实验复盘、消融拆解与垂直行业落地
8.1 多跳问答主实验与“低块召回、高答案精度”之谜
论文在 HotpotQA、2WikiMultiHopQA 和 MuSiQue 三个公认的多跳问答基准验证集中各抽取 1000 道题,以端到端精确匹配率(EM)和词级 F1 衡量生成质量:
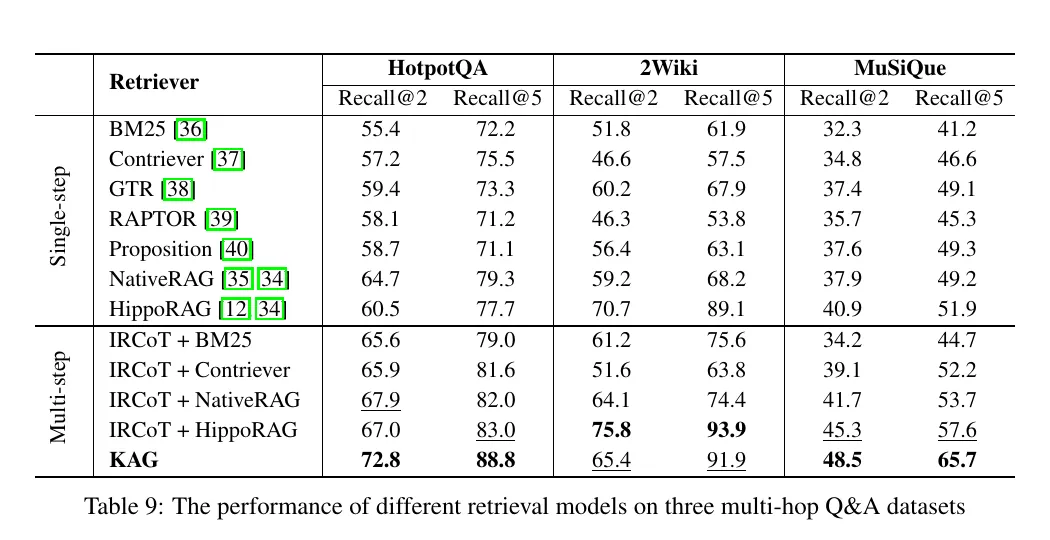
并以 Recall@2 与 Recall@5 衡量标注支撑段落(Supporting Chunks)的召回覆盖率。
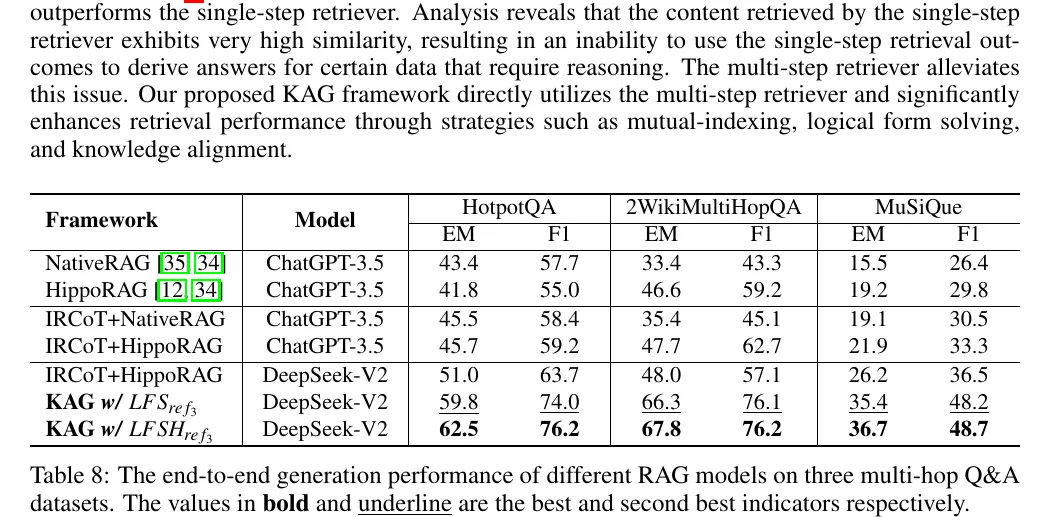
首先看 Table 8 的端到端问答主表:在同样采用 DeepSeek-V2 作为基座模型的前提下,最强配置 KAG + LFSH, ref3 相比强基线 IRCoT + HippoRAG,在三个数据集上的 F1 得分从 63.7 / 57.1 / 36.5 大幅跃升至 76.2 / 76.2 / 48.7。对其做严格复算:
无论是绝对百分点(+12.5 pp、+19.1 pp、+12.2 pp)还是超过 33% 的相对增幅,都展现出压倒性的优势。
然而,当我们把目光移到紧挨着的 Table 9(检索召回率表)时,却会发现一个非常反直觉的现象:在 2WikiMultiHopQA 上,KAG 的支撑段落召回率 Recall@2(65.4%)和 Recall@5(91.9%),居然比 IRCoT + HippoRAG(75.8% / 93.9%)还要低!为什么段落召回率更低,最终答案 F1 反而高出了整整 19.1 个百分点?
这恰恰揭示了 KAG 与传统文本 RAG 的本质区别:
- 结构化图推理直接短路了原文召回:2WikiMultiHopQA 中有大量高度规整的实体属性对比与两跳关系问题(例如比较两位导演的出生年份或父母国籍)。KAG 的
GraphRetrieval直接在 上命中 SPO 三元组并算出了精确子答案,触发了前文 Algorithm 2 的充分性短路机制,根本不需要再去把原始长文 Chunk 捞出来!由于 Recall@K 指标只死板统计“是否捞出了标注的原文段落 ID”,KAG 靠图谱直接做对的题在 Recall@K 上反而被记为“未召回段落”。 - 逻辑形式消除了多文档噪声干扰:
IRCoT + HippoRAG虽然把 93.9% 的相关段落塞进了上下文,但同时也带入了大量同名干扰段落,且靠自然语言 CoT 做年份比较和逻辑交并极易算错;KAG 则用精炼的三元组事实与确定性Math/Deduce算子把证据利用效率推到了极致。
8.2 模块消融、系统耗时成本与图连通性演化
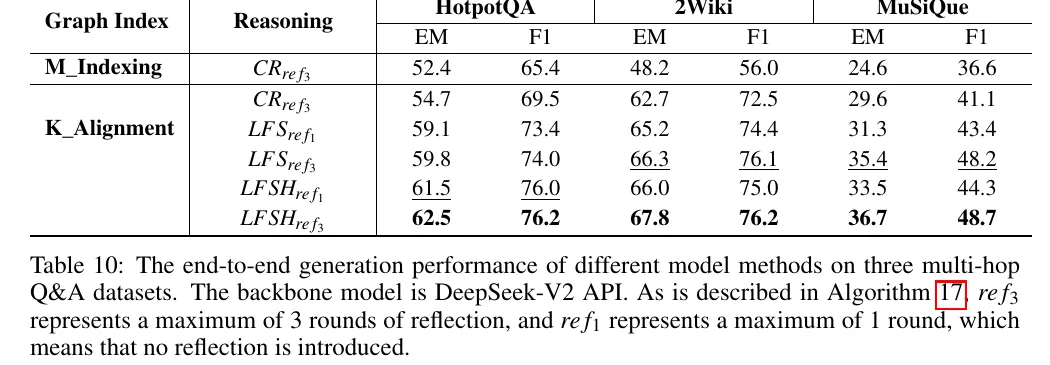
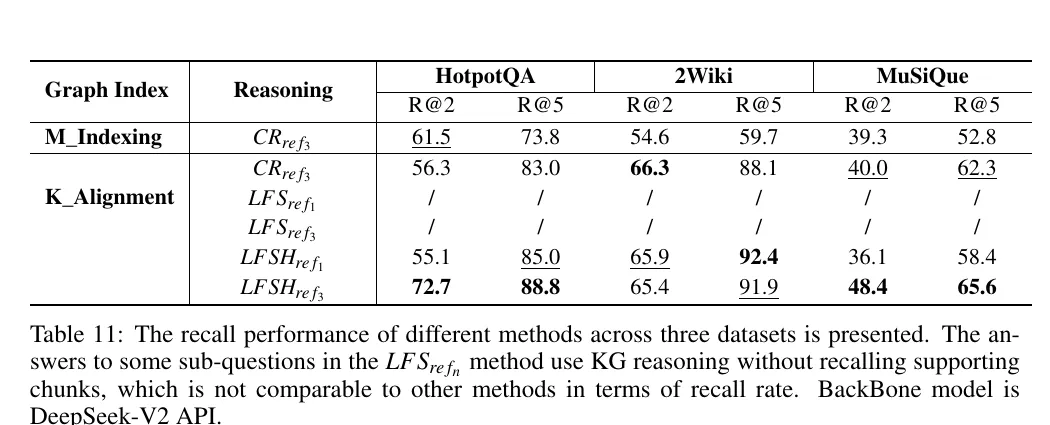
看 Table 10 与 Table 11 的逐层消融实验,可以清晰看到每个核心模块各自的贡献份额:
- 知识对齐是图谱能跑通多跳的前提(
K_Alignment):仅做互索引(M_Indexing + CR_ref3)时,2Wiki 的 F1 只有56.0;一旦加上离线与在线知识对齐(K_Alignment + CR_ref3),F1 瞬间暴涨 16.5 个百分点 达到72.5!因为消除了同义实体分裂并补齐了概念层级,原本断头的多跳路径被彻底接通。 - 逻辑形式求解与混合检索的互补(
LFS与LFSH):将传统推理(CR)升级为纯图谱上的逻辑形式求解(LFS),三个数据集继续稳步上涨(注意在 Table 11 中,LFS_ref1/ref3因为完全使用 KG 推理回答子问题、不召回文本块,所以 Chunk Recall 列全部记为/);在此基础上开启图-文混合回退(LFSH),补齐了图谱未覆盖的长尾事实,在三轮反思(ref3)下拿下全场最高分。
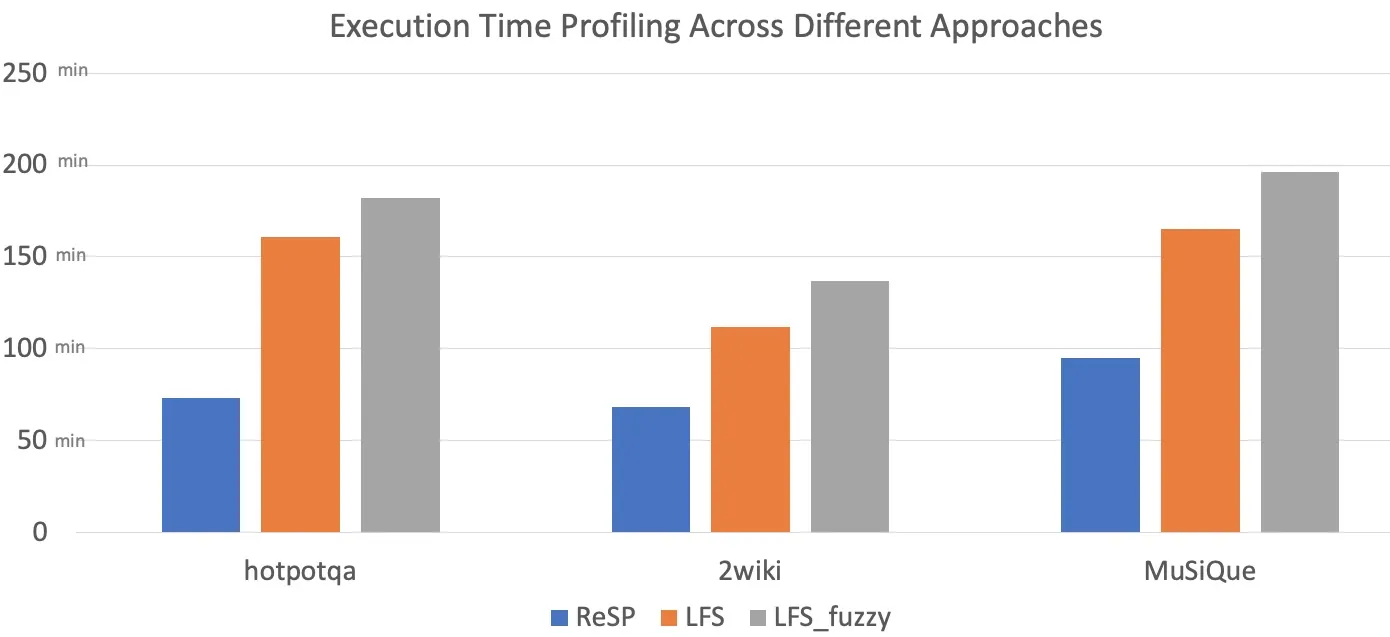
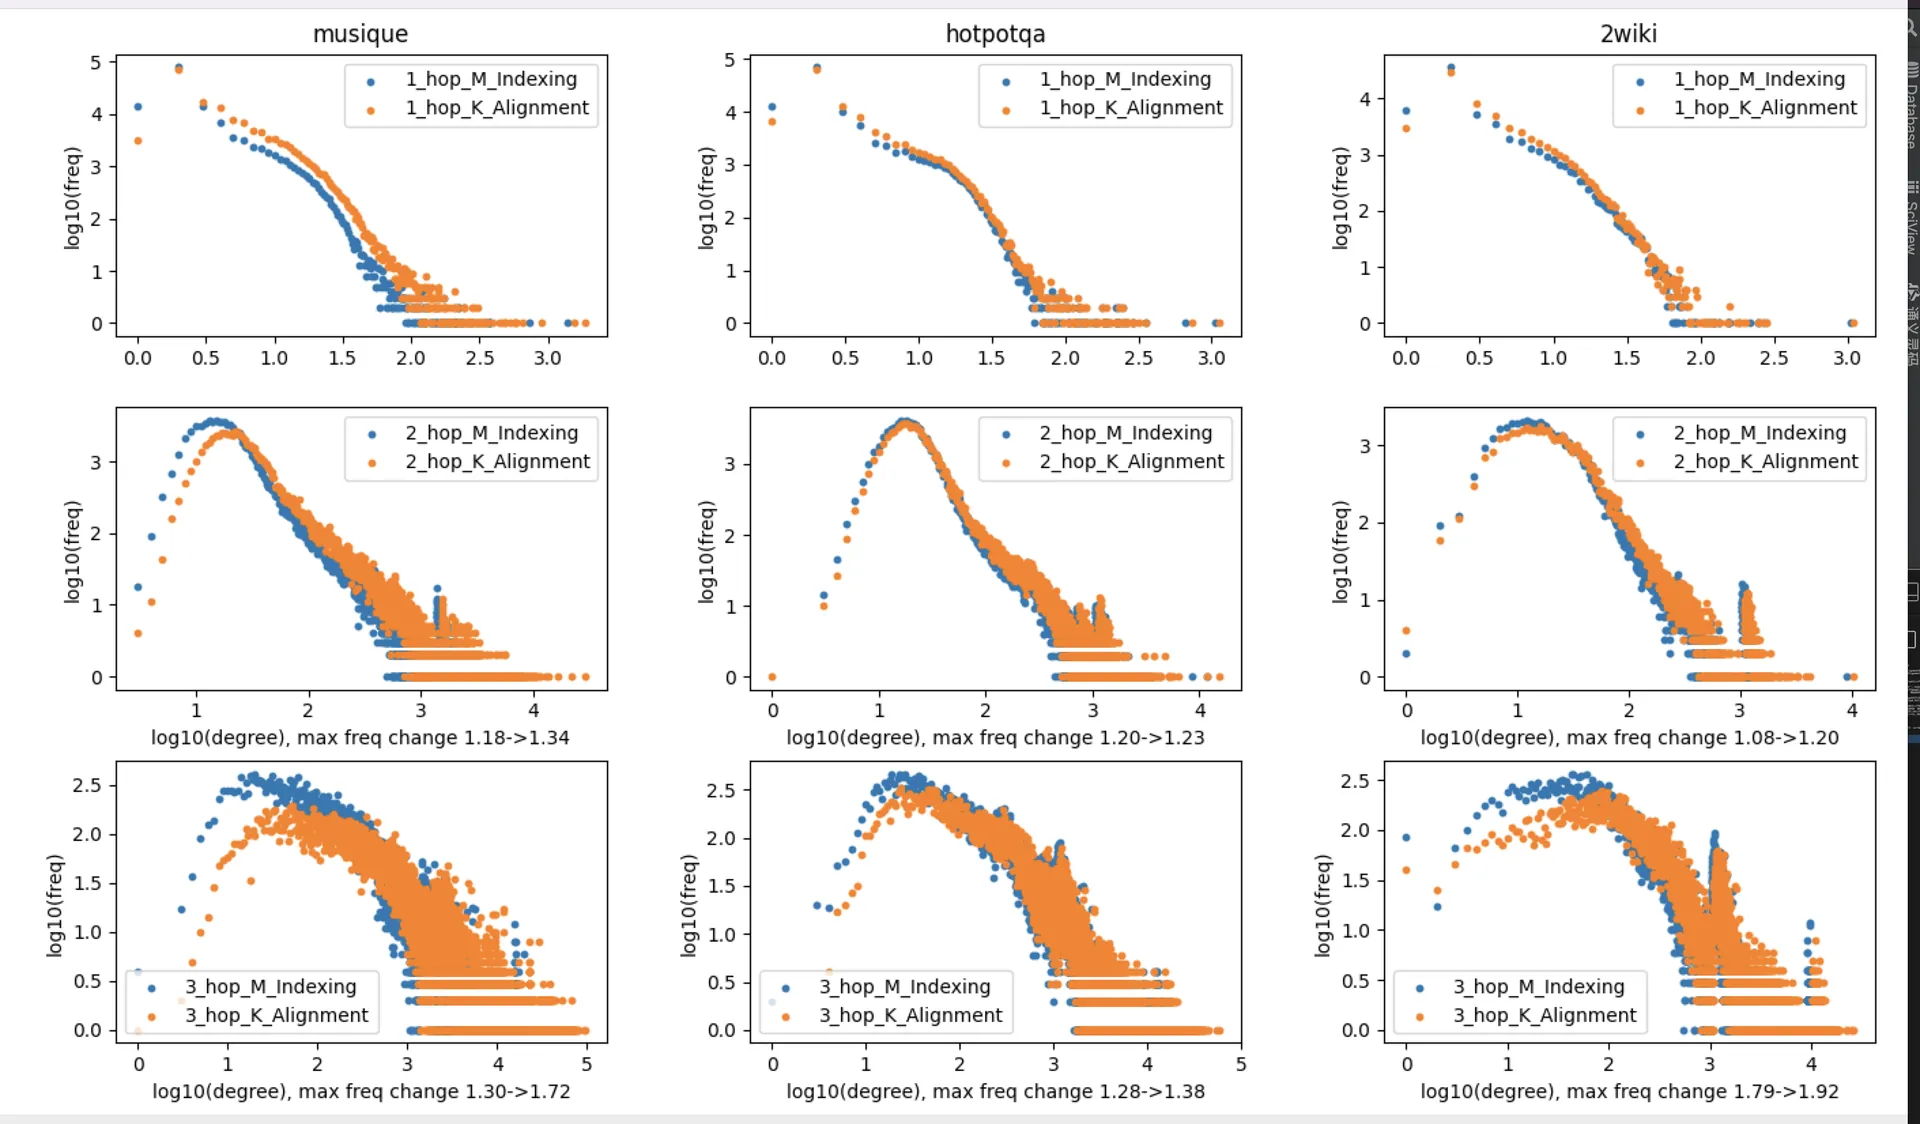
与此同时,Fig. 8 与 Fig. 9 诚实地展示了高准确率背后的系统代价与拓扑变化:
- 耗时翻倍的真实开销(Fig. 8):在 20 并发任务下跑完 1000 道题,从基础 ReSP 切换到
LFS再到包含模糊概念检索的LFS_fuzzy,HotpotQA 总耗时从 70 余分钟增长到 160~180 分钟,MuSiQue 从约 95 分钟增长到 165~195 分钟。多步规划、概念扩展与多轮反思带来了成倍的 LLM 调用开销,这也印证了前文第 7 节为什么v0.8.0必须引入KAGStaticPipeline与检索优先级短路来控制线上延迟。 - 图连通度向高阶移动(Fig. 9):对比加入知识对齐前(蓝点
M_Indexing)与对齐后(橙点K_Alignment)的一至三跳节点度数-频次分布,橙色曲线整体向右上方平移(例如 MuSiQue 两跳峰值对应对数度数从1.18升至1.34,三跳从1.30升至1.72)。这从图论角度证明了概念挂载与实体融合有效消除了孤立连通分量;但在工程实践中,也必须监控顶层泛化概念是否演变成了连接数万节点的“超级 Hub”,防止多跳扩展时发生召回爆炸。
8.3 典型案例追踪与政务、医疗场景的工程边界
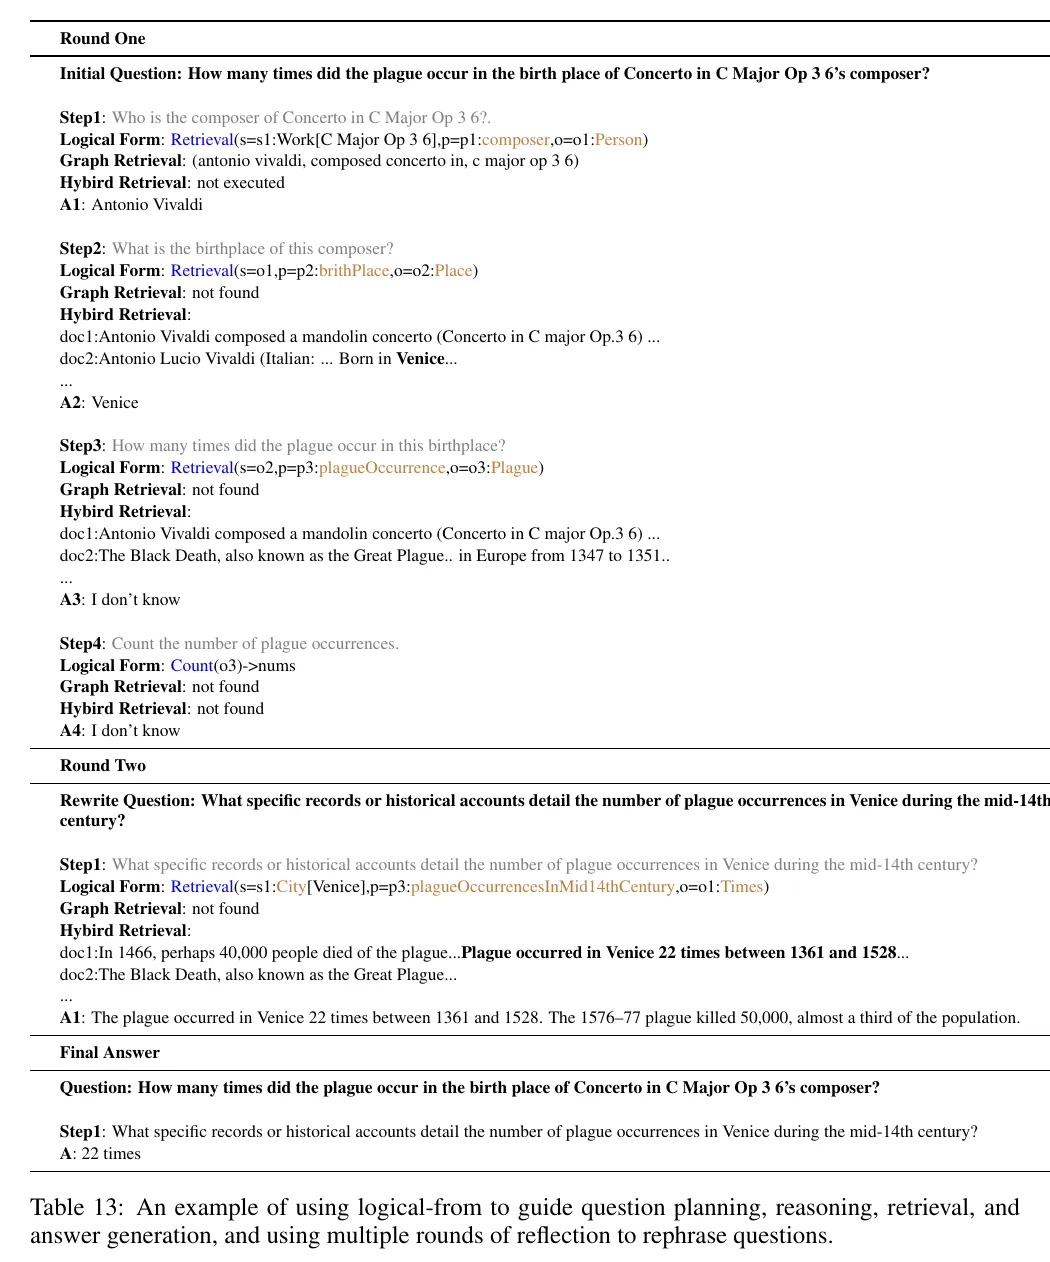
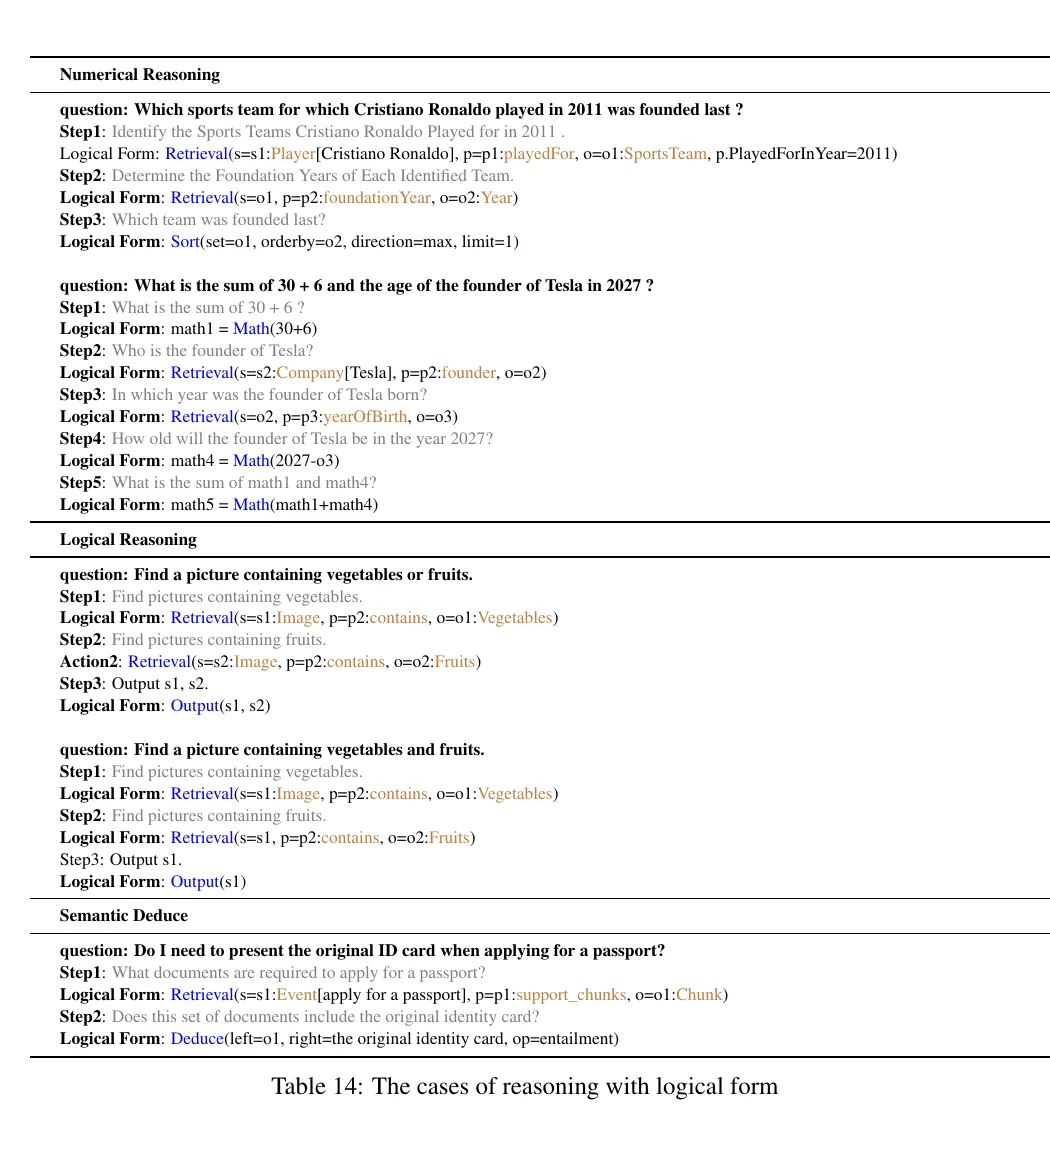
看上方 Table 13 的 Reflection 真实案例:问题要求计算《D 大调小提琴协奏曲(RV 208)》作曲家的出生地发生过多少次瘟疫。
- Round 1:Planner 先拆出三步——查 RV 208 的作曲家(得 Antonio Vivaldi) 查 Vivaldi 的出生地(得 Venice) 查威尼斯经历过的瘟疫次数。然而第 3 步初次检索召回的段落只提到“14 世纪中叶威尼斯爆发过灾难性瘟疫”,并没有包含具体次数。此时,Judge 模块清醒地识别出“发生过瘟疫”不等于“次数已知”,判定
is_solved = False,并由 SupplyQuery 生成精准的追问:“查找包含威尼斯历史上瘟疫爆发确切总次数的记录”。 - Round 2:系统保留第一轮已经锁定的实体
Venice,专门针对次数统计发起第二轮检索,顺利命中记载“威尼斯共爆发过 22 次瘟疫”的文献段落,最终输出精确答案22 times。而 Table 14 则进一步展示了逻辑算子如何精确区分自然语言中极易混淆的“包含蔬菜或水果(or)”与“同时包含蔬菜和水果(and)”。
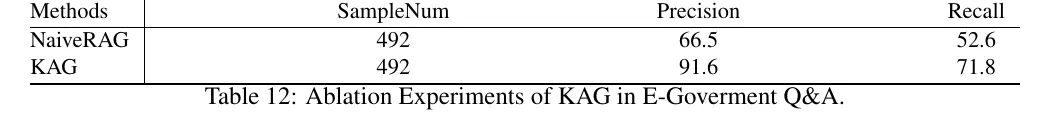
最后看蚂蚁集团内部的垂直行业落地数据:
- 政务办事问答(E-Government,Table 12):在涵盖约 11,000 份政务政策文档、492 个真实评测样本的测试中,由于政务咨询天然包含严密的事项分类、申办条件与材料清单约束,KAG 将 Precision 从 NaiveRAG 的
66.5%大幅拉升至91.6%,Recall 从52.6%提升至71.8%。 - 医疗健康知识服务(E-Health):团队构建了包含约 180 万个实体、40 万个标准术语集合、500 万条以上关系与 700 余条可执行 DSL 规则的医疗知识库,采样评测总体 Precision 达
81.32%、Recall 达60.67%,疾病科普与化验指标解读类准确率分别超过94%与93%。
在将这类系统推向医疗、金融等高风险生产环境时,必须守住两条工程红线:一是政策与指南的时效性治理(政策有生效期与废止期,不能让过期条款污染当前推理);二是临床与合规的 Fail-Closed 边界(高风险问题必须严格锚定权威指南与 DSL 规则,一旦检索证据不足必须明确拒答或转交人工,严禁通用 Generator 凭参数记忆自由补全)。
9. 横向技术坐标与总结:KAG 在知识增强生态中的位置
如果把 KAG 放到整个 RAG、Agent 记忆与图数据库的技术版图中,它与其他主流方案的生态位分工一目了然:
| 技术方案 | 核心索引与存储结构 | 在线查询与推理机制 | 最擅长的核心场景 | 工程落地的主要代价与边界 |
|---|---|---|---|---|
| Naive RAG | 扁平文本 Chunk + 向量/BM25 | 单步相似度召回 + 直接生成 | 简单事实问答、通用长文检索 | 无法处理多跳依赖、方向性约束与精确计算 |
| IRCoT | 扁平文本 Chunk | 自然语言 CoT 与文本检索交替迭代 | 开放域多跳文本问答 | 无显式图结构与符号算子,易受长文噪声干扰 |
| Microsoft GraphRAG | 实体关系图 + 层次化社区摘要 | Local Search + 社区摘要 Global Search | 针对整套语料库的宏观主题归纳与全局总结 | 离线全量聚类与摘要 Token 成本极高,非逻辑符号求解器 |
| HippoRAG / LightRAG | 轻量开放实体图 + 文本索引 | 个性化 PageRank 或双层图-文检索 | 开放域跨段落关联召回 | 缺乏强 Schema 约束、概念层级对齐与确定性算术算子 |
| Graphiti / Zep | Episode + 实体图 + 社区图(双时态边) | Cosine + BM25 + BFS + RRF/Rerank | Agent 动态长期记忆维护与历史冲突失效 | 聚焦流式对话/事件的状态演进,不包含多步符号规划执行器 |
| Neo4j(图数据库底座) | 定长记录存储 + 免索引邻接链 + B+Tree/HNSW | Cypher 成本优化器 + 物理管线 + ACID 事务 | 底层属性图的高可靠事务读写与高速多跳遍历 | 负责精确执行已入库的图查询,不负责上游 LLM 抽取与问答规划 |
| OpenSPG KAG | 三层表征()+ 概念图互索引 | Logical Form 编译 + 图优先混合检索 + 多轮反思 | 高严谨度、强规则、需多跳与数值推理的专业领域知识服务 | 离线构图与概念对齐链路重,在线多步 LLM 调用需配合静态管线控延迟 |
对比本站同系列的另外两篇深度精读——Graphiti / Zep 与 Neo4j 源码精读,可以看到一套完整的企业级知识架构是如何分层的:
- 最底层由 Neo4j 等图数据库提供定长记录存储、免索引邻接指针跳转、WAL 事务持久性与底层向量/全文索引;
- 当数据是随时间不断变化的用户偏好与业务事件流时,由 Graphiti / Zep 利用双时态边模型(
valid_at / invalid_at与created_at / expired_at)维护动态演化的 Agent 长期记忆; - 当任务是基于权威专业文档、行业规程与专家规则解答高复杂度领域问题时,则由 OpenSPG KAG 通过三层互索引、概念语义对齐与逻辑形式引导的混合推理,将模糊的自然语言问答转化为步步可追溯、可验算的知识求解工程。
参考资料
- Lei Liang et al., KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation, arXiv:2409.13731v3, 2024.
- 官方开源仓库:OpenSPG/KAG(
v0.8.0源码基线)与 OpenSPG(v0.8底座源码)、OpenSPG 官方文档. - 核心源码入口:
BuilderMain、default_chain.py、KAGIndexManager、SolverMain、KAGStaticPipeline、KAGIterativePipeline、KAGHybridRetrievalExecutor、SPGServerBridge. - 相关领域工作:IRCoT、HippoRAG、Microsoft GraphRAG、RAPTOR、Think-on-Graph、KAG-Thinker.
comments