让一个视觉模型在照片里“把所有狗分出来”,和让它“分出绿橙相间小船上戴米色帽子的那个人”或“从底部数第二个瓶子”,背后的认知跨度极大。前者只需要封闭或开放词表的类别匹配;而后者要求模型先读懂复杂的空间方位、序数逻辑、外观属性与多物体交互关系,在拥挤的画面中锁定唯一对应的实体,最后还得沿着发丝、衣角或细长瓶颈画出像素级严丝合缝的二值掩码。
在构建这类开放世界指代分割(Open-World Referring Segmentation, ORS)系统时,工业界长期面临一个两难抉择:
- 如果走
MLLM -> Box/Point -> SAM的双模型串联路线(如 LISA、SAM4MLLM 等),由多模态大语言模型(MLLM)负责语义理解并吐出提示点或框,再交给外部的 SAM 恢复像素边界,虽然掩码边缘锐利,但线上推理必须同时驻留两个庞大的基础模型,显存与链路延迟沉重,且 SAM 在拿到框之后缺乏细粒度语言语义引导(比如分不清“只选人手里的包”与“连同肩上背带一起选”); - 如果走 MLLM 纯自回归生成多边形或离散掩码 Token 路线,虽然架构统一,但把成百上千个轮廓顶点塞进自回归序列会导致生成延迟剧增,且坐标量化带来的多边形锯齿很难贴合复杂镂空拓扑。
针对这一核心矛盾,阿里通义实验室(Tongyi Lab)提出的 Qwen3-VL-Seg: Unlocking Open-World Referring Segmentation with Vision-Language Grounding 走出了一条兼顾紧凑性与边界精度的原生密集预测路径:在 4B 规模的 Qwen3-VL 主干旁挂载一个仅 17M 参数的框引导掩码解码器(Box-Guided Mask Decoder),在单栈模型内直接完成从开放语言指代到高分辨率像素掩码的端到端推理。
透过具体的网络模块与数据流水线,Qwen3-VL-Seg 的系统设计建立在四条环环相扣的设计哲学之上:
- 用“结构化框 + 单
<mask_token>”做接口契约,解耦高层语义消歧与底层密集解码(Decoupled Grounding and Dense Decoding):让擅长长程关系推理的语言模型输出确定性 JSON(包含bbox_2d、label与<mask_token>占位符),把最难的开放词汇与多跳空间逻辑压缩为四个框坐标和一个语义隐藏状态,再由轻量级解码器在密集特征图上一次性并行算出像素掩码。既省去了外挂 SAM 的双栈负担,又彻底消除了自回归输出掩码序列的长度瓶颈。 - 将预测框从“定位终点”升格为贯穿全链路的“空间结构先验”(Bounding Box as a Dual Structural Prior):如果只给解码器喂一个抽象的
<mask_token>隐藏状态,面对画面中多个同类物体时极易发生空间混淆。Qwen3-VL-Seg 让语言模型预测出的bbox_2d同时扮演双重角色——先经对数傅里叶编码注入目标查询(Object Query)锁定实例身份,再化作向外扩边 15% 的可微软门控(Soft Box Gate)过滤原图浅层纹理,在屏蔽框外杂乱背景高频噪声的同时,容忍预测框边缘的轻微切边误差。 - 以“查询 → 粗掩码 → 像素池化回流 → 精化掩码”的两轮闭环实现低成本自纠错(Two-Pass Mask-Aware Query Refinement):单次动态卷积核解码很难在重度遮挡或紧邻同类干扰物的边界处一步到位。模型将第一轮预测出的软掩码直接作为空间注意力权重,从高分辨率像素特征中池化出目标区域的真实视觉证据并残差写回查询向量,仅靠解码器内部极轻量的一次二次投影,就实现了底层像素证据对高层语义查询的反向校准。
- 数据侧“碎片重组 + 反向定位闭环”与训练侧“两阶段能力再平衡”(Self-Verifying Data Engine and Two-Stage Capability Rebalancing):利用碎片重叠率(IoF)将 SA-1B 的零散部件掩码缝合为完整实体(SA1B-CoRS),并通过“看图生成描述 → 抹去高亮反向框定()”的自洽闭环蒸馏出 194 万条实例级消歧样本(SA1B-DeRS);在训练上则采用“Stage 1 差分学习率微调 ViT 唤醒边缘感知 + Stage 2 冻结 ViT 并按
3:1:2配比通用与 STEM 推理数据全量微调 LLM”,化解了高强度像素监督对基座模型通用 VQA、OCR 和数学推理能力的灾难性遗忘。
下面我们沿着模型架构、数据引擎、两阶段训练与实验归因的脉络,深入拆解这套系统背后的技术细节与工程权衡。
1. 任务谱系与多模态分割路线权衡
1.1 从 REC、RES 到开放世界指代分割(ORS)
在视觉-语言定位领域,几类看似相近的任务在输出空间与容错边界上有着本质差异:
| 任务范式 | 输入形式 | 输出形式 | 评估容错度与核心瓶颈 |
|---|---|---|---|
| 指代框定位(REC) | 图像 + 指代表达式 | 单个二维边界框 bbox_2d | 框与真值 即算成功;只需框住主体,无需关心内部镂空与边缘毛刺 |
| 经典指代分割(RES) | 图像 + 指代表达式 | 单个像素级二值掩码 | 要求像素级贴合;自行车辐条、椅腿空隙或树枝分叉处的背景混入都会直接拉低 IoU |
| 广义指代分割(GRES) | 图像 + 表达式 | 零个、一个或多个掩码 | 引入无目标拒识(No-target)与多实例集合预测 |
| 开放词汇分割(OVS) | 图像 + 开放类别名词 | 该类别对应的全部区域 | 考验超出封闭词表的长尾名词泛化,但不涉及复杂空间关系与同物消歧 |
| 开放世界指代分割(ORS) | 图像 + 不受限类别/属性/关系描述 | 一个或多个实例级像素掩码 | 同时要求长尾开放词汇、多实例枚举、复杂空间/序数/状态关系推理与分布外(OOD)鲁棒性 |
为什么把一个已经很擅长做 REC(画框)的多模态大模型改成做 ORS(画掩码),远比表面看起来困难?
这源于多模态大模型内部视觉表征的固有张力:为了压缩视觉 Token 序列长度、降低自注意力计算量并对齐高层语言空间,图像进入 ViT 编码器后通常经历了 Patch 合并(Patch Merging)与深层语义抽象。越靠近 ViT 顶层,Token 越擅长回答“画面左边有只戴红项圈的狗”这类高层语义问题,但狗毛边缘、腿间空隙等高频空间细节已经在下采样与深层混合中流失殆尽。
因此,要从 MLLM 预测的边界框 跨越到高精度的像素掩码,解码器必须同时打通四条链路:找回 ViT 中间层的局部空间结构、把框的几何坐标与语言语义锚定到同一个查询向量、从原始图像直接引入浅层高频边缘并剔除框外背景干扰、以及利用初始粗掩码反馈修正边缘误判。
1.2 五类主流技术路线的工程账本
把 Qwen3-VL-Seg 放进当前多模态分割的技术坐标系中对比,可以清楚地看清它的架构取舍:
| 技术路线与代表工作 | 语言推理开放度 | 边缘精细度 | 在线推理依赖 | 核心优势与工程代价 |
|---|---|---|---|---|
| MLLM + 外部分割器(LISA, GSVA, SegAgent+SAM) | 高 | 高 | MLLM + SAM 双大模型 | 直接复用 SAM 强边缘先验;但显存与延迟翻倍,且框提示难以向 SAM 传递细粒度局部语义约束 |
| 自回归多边形 / 离散掩码码本 | 高 | 中 | 单一 MLLM | 架构无需额外解码头;但顶点序列极长、推理慢,坐标量化阶梯感明显,难以表达内部孔洞 |
| MLLM + 轻量原生解码器(PixelLM, UFO, Qwen3-VL-Seg) | 高 | 中至高 | MLLM + 17M 轻量解码头 | 端到端联合优化,单栈紧凑部署;需在模型前向计算中读取多层内部特征,强依赖高质量训练数据 |
| 分割基础模型(SAM, SAM2, SAM3) | 中至高 | 极高 | 专用视觉分割大模型 | 单纯名词概念下的多实例全图覆盖能力极强;但缺乏长句语法、否定排除与多跳空间关系推理能力 |
| 视觉通才模型(Florence-2, Grounding DINO) | 中 | 任务相关 | 统一视觉编码解码器 | 短语定位与检测速度快、精度高;但缺乏通用多轮对话、OCR 与复杂知识推理能力 |
Qwen3-VL-Seg 的算盘打得很精:既然基座模型 Qwen3-VL-4B 已经把开放世界框定位练得炉火纯青,那就绝不浪费这个现成的几何锚点,直接用 17M 参数(仅占 4B 基座参数量的 0.4%)的原生解码器把框先验吃干榨净。
2. 总体架构与 Box-Guided Mask Decoder 四大核心机制
2.1 结构化 JSON 协议与系统总体数据流
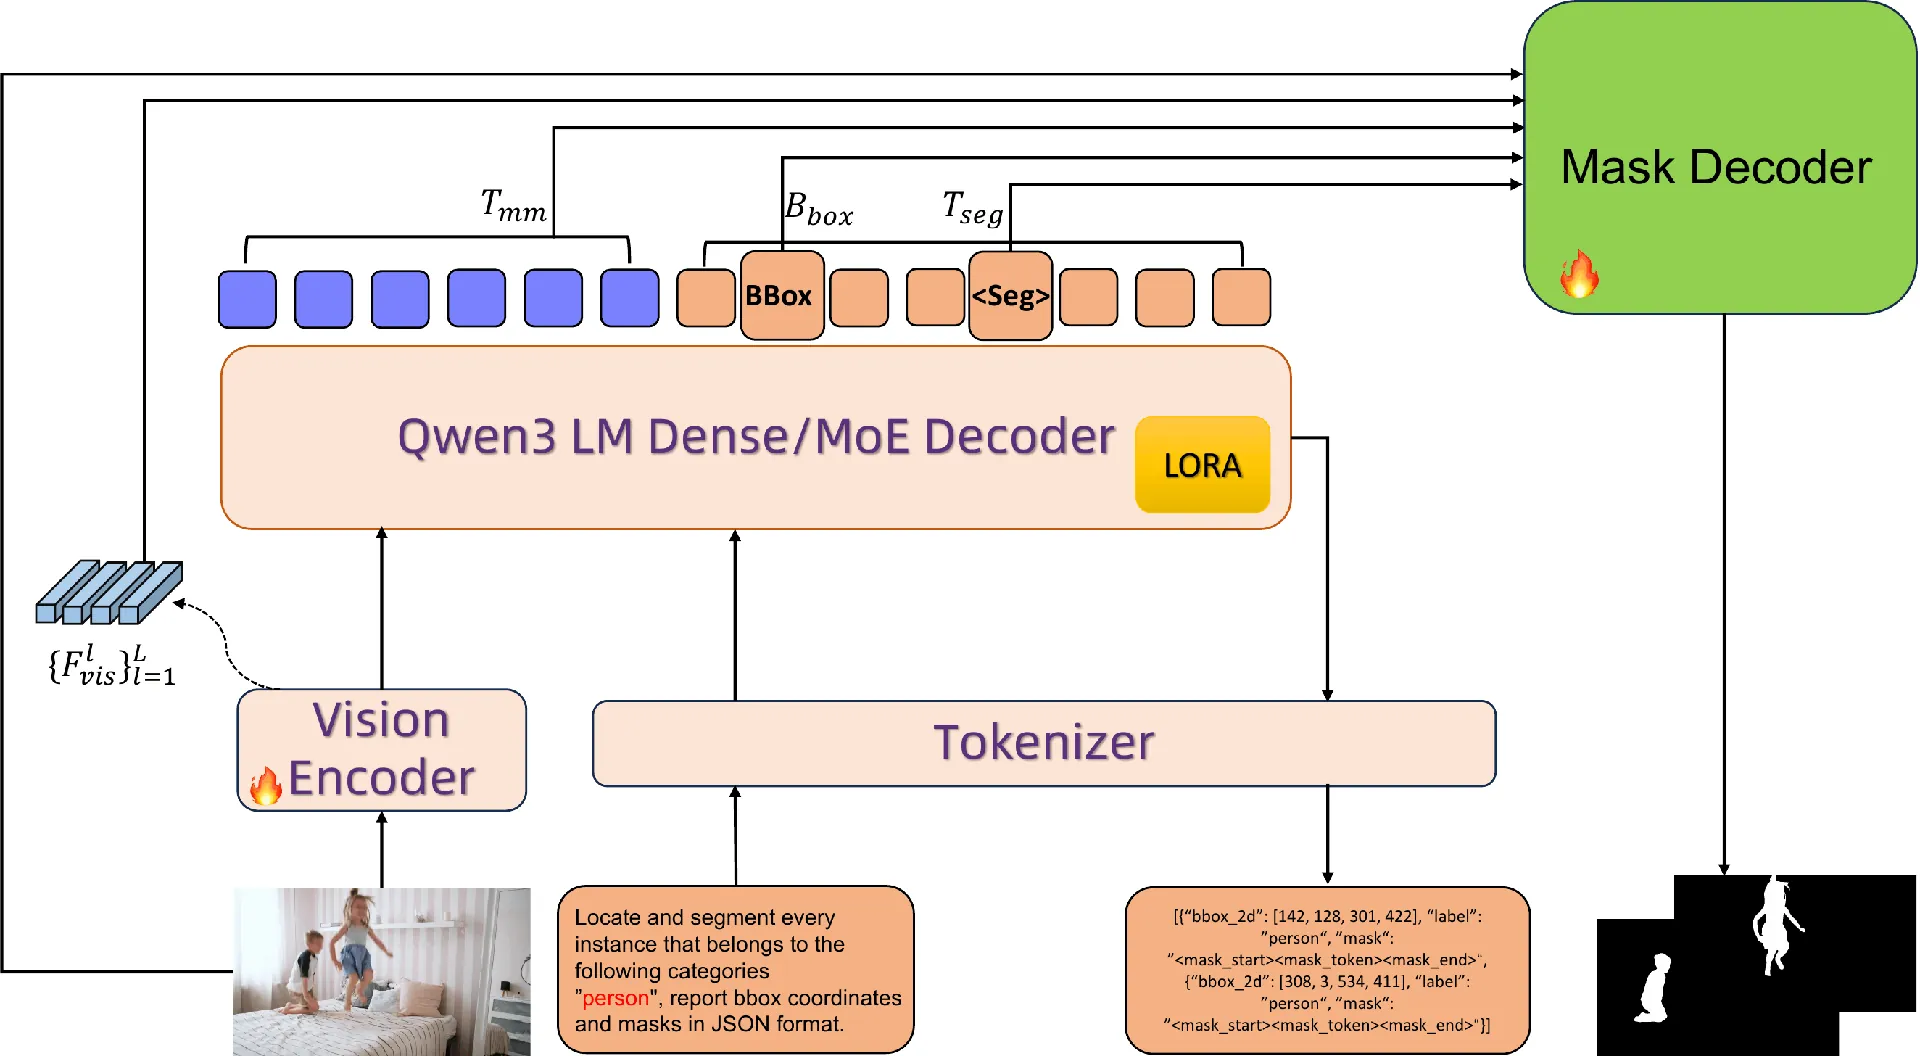
看上图的系统总览,Qwen3-VL-Seg 完整保留了 Qwen3-VL 的 ChatML 对话结构。当用户输入指令(例如要求分割特定类别或符合某段描述的实例)时,语言模型自回归输出如下确定性的 JSON 格式:
[
  {
    "bbox_2d": [210, 45, 890, 520],
    "label": "dog",
    "mask": "<mask_start><mask_token><mask_end>"
  }
]
这个看似简单的 JSON 协议蕴含着三层工程巧思:
- 多实例天然解耦:当一句
"Locate and segment every dog"对应画面中的 5 只狗时,LLM 会在 JSON 数组里依次列出 5 个对象,每个对象各自拥有独立的bbox_2d坐标和独立的<mask_token>占位符。 - 符号流与密集流各行其道:JSON 文本本身完全可读、可解析,不会因为塞入几千个掩码坐标而撑爆上下文;而每当自回归解码遇到
<mask_token>,系统就提取该位置的语言隐藏状态 ,连同前面的bbox_2d坐标 一起交给底层的密集掩码解码器。 - 优雅的故障降级契约:在生产环境中,万一后续掩码解码置信度过低或显存受限,上游业务依然可以直接拿 JSON 里高精度的
bbox_2d和label兜底展示,不会陷入全有或全无的黑盒失效。
写成数学形式,给定输入图像 与指代文本,预训练 MLLM 在一次前向过程中向掩码解码器 提供四组内部状态:ViT 各中间层的视觉特征图 、经过多模态对齐的顶层视觉嵌入 、<mask_token> 对应的语义特征 ,以及预测边界框 :
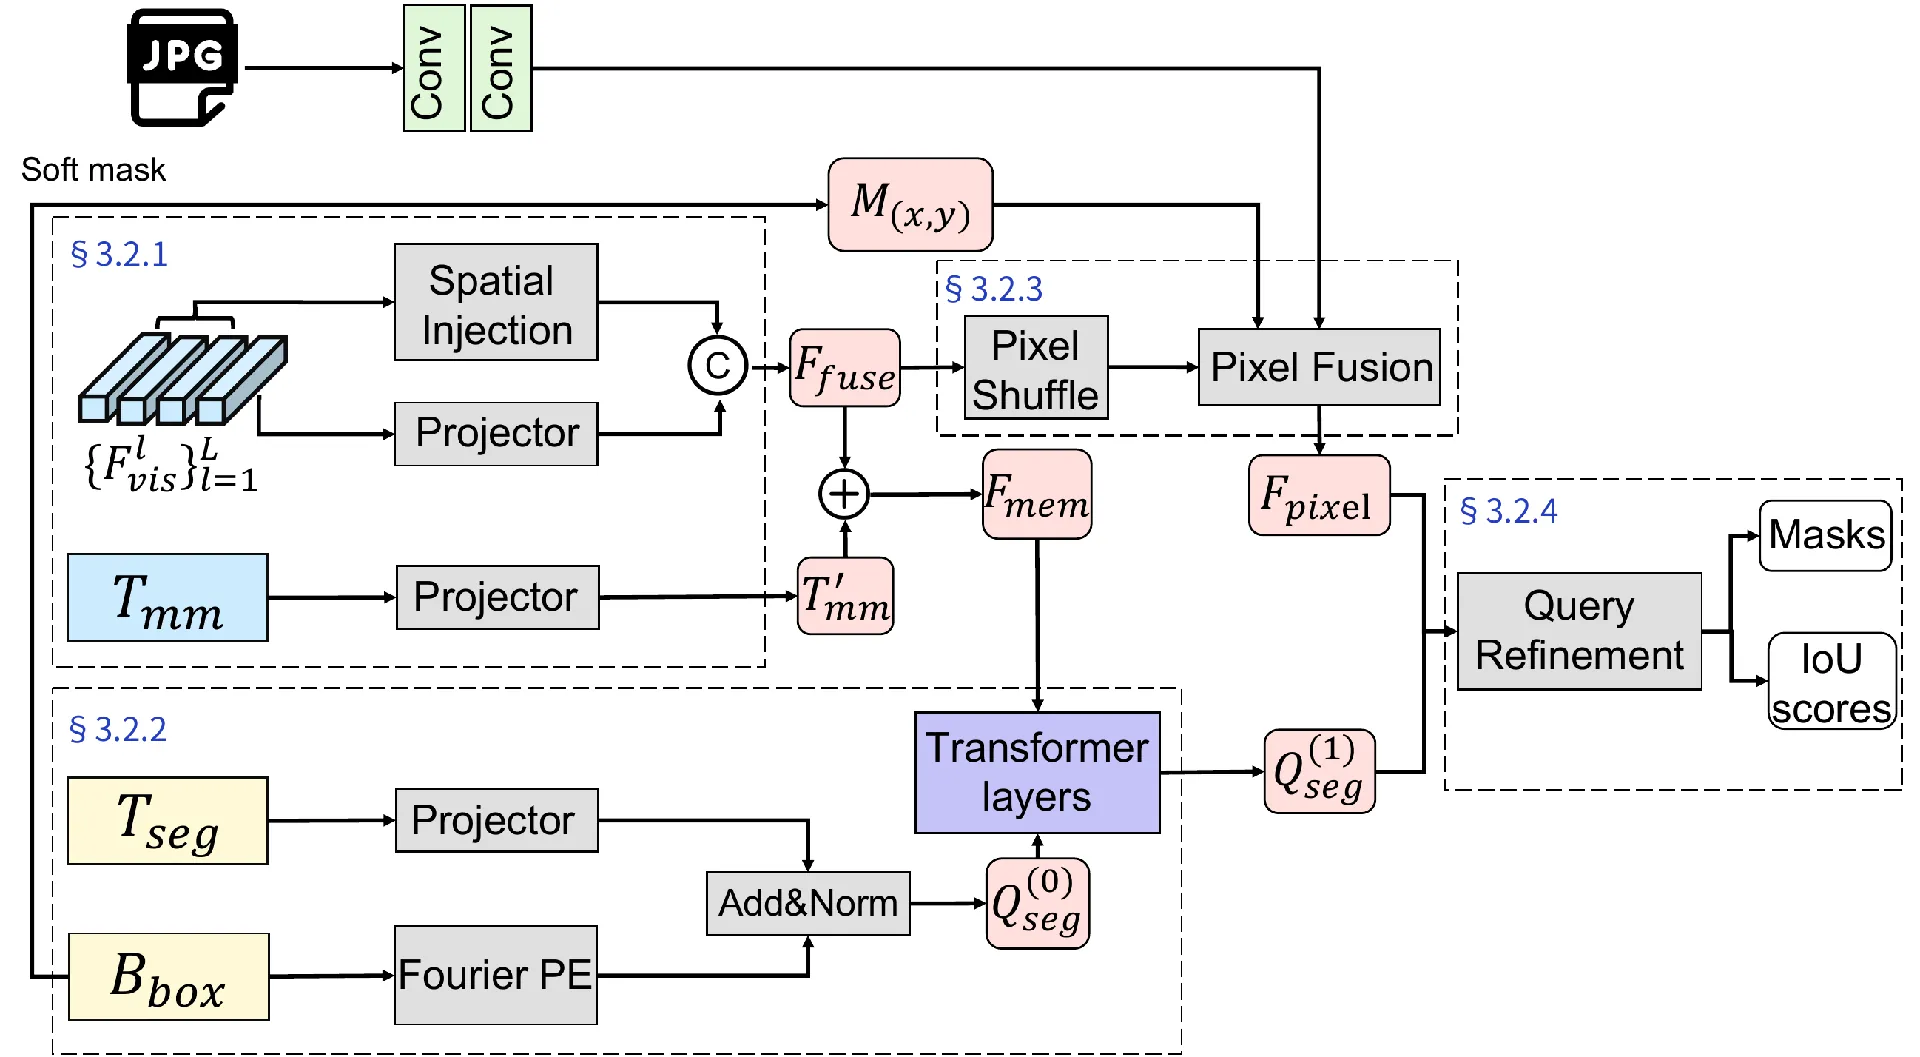
展开上图的 17M 解码器内部架构,整条计算链路由四条紧密咬合的支路组成:
多层 ViT 中间特征 {F_vis^l} ──> 空间适配器 (近零初始化 DWConv) ──┐
                                                                 ├─> 解码器记忆 F_mem
多模态顶层视觉嵌入 T_mm ─────────────────────────────────────────┘

分割语义特征 T_seg + 对数傅里叶框编码 E_box ──> 初始查询 Q^(0) ──> Transformer 解码 ──> Q^(1)

原始图像 I ──> 浅层 CNN 主干 ──> 15% 扩框软门控 M(x,y) ──┐
                                                        ├─> 高分辨率像素特征 F_pixel
多尺度融合特征 F_fuse ──> 两级 PixelShuffle 上采样 ─────┘

Q^(1) + F_pixel ──> 第 1 轮粗掩码 M^(1) ──> 掩码加权像素池化 F_tar ──> 精化查询 Q^(2) ──> 第 2 轮最终掩码 M^(2)
为了把参数量死死按在 17M 以内,作者没有像重型分割器那样在多尺度高分辨率特征图上反复跑多头交叉注意力,而是先把多层 ViT 特征压进紧凑的解码器记忆 更新查询,直到最后的动态卷积核内积阶段才接通高分辨率像素特征 。下面我们逐一拆解这四个模块的数学与设计细节。
2.2 机制一:近零初始化的多尺度空间特征注入与记忆构建
为什么只用 MLLM 顶层的视觉嵌入 画不出精细边界?因为 已经过了深层语义抽象和空间合并,高频轮廓早已被平滑掉了。为了找回丢失的局部边缘,解码器从 ViT 的多个中间层把特征图 抽出来,先用 卷积统一通道维度 ,再通过深度可分离卷积(DWConv)分支注入局部空间归纳偏置:
注意式中的可学习标量缩放因子 :它的初始值被显式设为极小的 。
为什么要做 的近零初始化?因为在训练刚起步时,新加的 DWConv 权重是随机的;如果直接以 的权重加到预训练特征上,随机卷积噪声会瞬间冲乱 ViT 原本稳定的特征流形。将 初始化为 ,使得该分支在训练初期几乎等价于恒等映射(Identity Mapping),随着梯度更新逐步推进,网络再按需放大 ,平稳地把中间层的局部几何边缘“唤醒”并拼合为多尺度特征 :
随后,将经过语言对齐的顶层多模态视觉嵌入线性投影并重排回二维网格 ,与多尺度特征 及可学习的二维位置编码 相加,构成 Transformer 解码器的键值记忆(Memory):
这三项加在一起,刚好凑齐了密集解码所需的全部底牌: 懂语言语义, 有局部结构, 锁住二维空间坐标。
2.3 机制二:对数傅里叶框编码与空间-语义双重锚定查询
在拿到了全局记忆 后,怎么构造去查询它的 Object Query?
如果只用 <mask_token> 的隐藏状态 当 Query,当指令是 "segment every person" 时,多个 <mask_token> 的语义特征高度相似,解码器很容易搞混当前到底该画左边的人还是右边的人。为此,Qwen3-VL-Seg 直接把前面自回归预测出的边界框 编码进初始 Query 里。设框的宽为 、高为 ,模型利用傅里叶位置编码 构造框几何嵌入:
这里为什么要把宽度 和高度 先取对数 再送进傅里叶编码,而不是直接编码 ? 从视觉尺度感知来看,尺度变化遵循的是相对比例(对数律)而非绝对差值:一个小目标的宽度从 10 像素变到 20 像素(放大了 100%),在几何结构上的剧烈程度远大于一个大目标从 500 像素变到 510 像素(仅变化 2%)。将宽高映射到对数域 ,能让不同大小的目标在尺度特征空间中获得均匀、平滑的分辨率表达。
接着,框几何嵌入 与语言分割特征 融合归一化,生成既知道“目标是谁”、又知道“目标在哪个框里”的初始查询 ,并经 Transformer 解码器与全局记忆交互得到第一阶段查询 :
2.4 机制三:扩边 15% 的可微软边界框门控(Soft Box Gate)
即便融合了 ViT 中间层特征,由于 ViT 本身存在 Patch 网格下采样(如 或 步长),仅靠上采样 依然难以抠出像素级锐利的发丝、叶片锯齿或细绳边缘。因此,模型直接从原始输入图像 上用轻量级卷积主干提取了一路高分辨率浅层特征 。
但这立刻带来了一个棘手的副作用:浅层 CNN 特征虽然边缘锐利,却是“语义盲”的——全图到处都是背景砖缝、树叶纹理和光影边缘,如果把整张图的 原封不动拼进来,框外杂乱背景的强烈高频响应反而会把目标边界搅乱。
那能不能直接按预测框 做硬裁剪(Hard Crop),把框外的 全置为 0?也不行!因为 MLLM 预测的边界框难免有几个像素的紧缩偏差,万一框稍微偏小了一点,切掉了小狗的尾巴尖或自行车的后轮外沿,硬裁剪一刀切下去,解码器就再也看不到尾巴尖的浅层纹理了。
为了兼顾“屏蔽框外背景噪声”与“容忍预测框切边误差”,作者设计了一个非常巧妙的扩边可微软门控(Soft Box Gate):
- 先将预测框 在宽度和高度两个方向上各自向外扩展
15%,得到宽松边界 ,给边缘留出充足的安全缓冲带; - 用四个方向相乘的 Sigmoid 函数构造平滑的二维门控掩码 (锐度系数取 ):
在扩展框内部,四个 Sigmoid 因子均接近 ,浅层高频纹理无损通过;在扩展框外部,至少有一个因子迅速衰减到 ,背景高频噪声被干净屏蔽;而在框边界过渡带上,门控值连续可导(当单条类别指令对应多个预测框时,对多个框的门控图取逐像素最大值 以构成并集区域)。
最后,将多尺度 ViT 特征经两级 PixelShuffle 上采样得到的 ,与经过软门控过滤的浅层特征在通道维拼接,形成最终的高分辨率像素表征 :
注意这里的非对称分工:承载全局语义上下文的主分支 不受框门控限制,保持全图视野;只有容易引入高频背景噪声的浅层纹理分支 被软门控约束在目标框周围。
2.5 机制四:两轮掩码感知查询精化与 IoU 置信度头
拿到目标查询 和高分辨率像素特征 后,动态掩码预测头 (由 Query 动态生成卷积核权重并与 做内积)先算出第一轮粗掩码 logits:
在绝大多数简单场景下, 已经相当准了;但在两个同类物体紧挨着、或者存在局部遮挡时,第一轮查询 只见过低分辨率的全局记忆 ,还没机会根据高分辨率像素图 上的真实前景激活做自我修正。
于是,作者把第一轮预测出的软掩码概率图 当作空间注意力权重,直接去高分辨率像素特征 里把“第一轮认为属于目标的像素特征”加权池化出来,凝练成一个目标专属表征 ( 防除零):
接着,把这个来自底层高分辨率像素的真实证据 经线性投影 残差加回查询向量,得到精化查询 ,再跑第二次动态掩码预测并插值回原图尺寸:
此外, 还会顺手喂给一个线性辅助头 ,用来预测整张掩码的期望 IoU 质量分,供下游做低质量拒识或多候选排序。
3. SA1B-ORS 数据引擎:如何从无标签碎片炼出 299 万开放世界样本?
有了精巧的 17M 解码器,如果只拿传统的 RefCOCO/+/g(仅源自早期 COCO 的几万张图、词表封闭、句子简短)去训练,模型根本不可能具备开放世界泛化能力。反观 Meta 开源的 SA-1B 数据集,虽然拥有十亿级高质量边缘掩码,但它有两个致命缺陷:第一,完全没有类别标签和自然语言描述;第二,SA-1B 的掩码是高度碎片化的(例如把一辆自行车拆成车轮、车架、车把十几个独立的局部碎片),直接拿来训指代分割会让模型支离破碎。
为了把 SA-1B 变成高质量的开放世界指代分割燃料,作者从 SA-1B 中抽取 200 万张原始图像,用一套全自动多模态数据引擎构建了包含 299 万样本的 SA1B-ORS 数据集(如 Fig. 3 所示),内部由两个互补子集组成:
- SA1B-CoRS(105 万样本,类别导向):训练模型处理开放词汇类别指令,支持单类别对应图中单个或多个实例(如
"segment all buildings")。 - SA1B-DeRS(194 万样本,描述性实例消歧):训练模型在复杂同类干扰物中,凭细粒度属性、姿态与上下文关系揪出唯一目标(如
"绿橙小船上戴米色帽子的那个人")。
3.1 SA1B-CoRS:为什么用 IoF(碎片重叠率)而不是 IoU 缝合掩码?
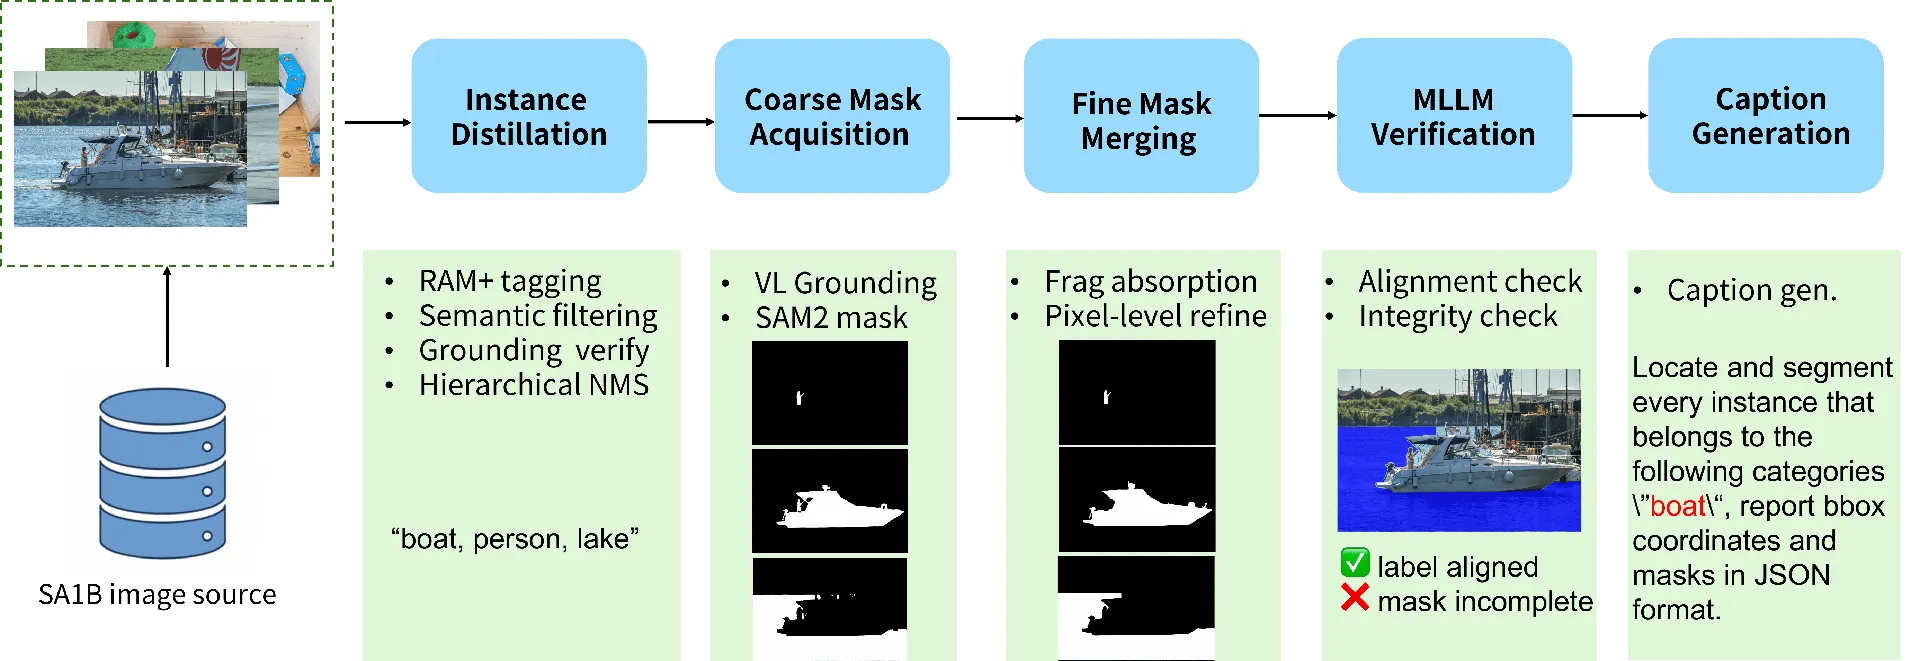
看 Fig. 4 的五步自动构建流水线,核心难题是如何把 SA-1B 的零散碎片合成为语义完整的对象级真值掩码:
- 开放词汇蒸馏与层级化 NMS:先用图像打标模型 RAM++ 提取开放词汇标签,过滤掉纯颜色、抽象事件或场景词,仅保留高优先级词表或能沿 WordNet 上位词路径(Hypernym Path)归入
person、vehicle、animal、artifact、clothing、food、structure七大实体根节点的词汇。随后经开放词汇定位模型生成候选框,并执行层级化 NMS(Hierarchical NMS)——当同一个位置同时框出animal、dog、golden retriever时,自动按语义上下位关系保留最具体的细粒度标签golden retriever,得到候选实体集 。 - 粗掩码获取(Coarse Mask Prior):用 Qwen3-VL-Plus 为每个实体预测定位框,并调用 SAM2 生成初始粗掩码 。
- 基于 IoF 的精细碎片缝合(Fine Mask Merging):SAM2 给出的粗掩码 整体语义完整,但边缘细节不如 SA-1B 原生的高精度局部碎片 。怎么判断一个局部小碎片 (比如自行车的一个脚踏板,或者椅子的一个扶手)属不属于目标主体 ? 如果算标准交并比 ,因为脚踏板的面积还不到整辆自行车的 2%,分母是整辆自行车,算出来的 IoU 只有 0.02,立刻就被当成噪声过滤掉了! 因此,论文改用碎片重叠率(Intersection over Fragment, IoF)作为吸收准则——把分母换成小碎片自身的面积 :
只要这个小碎片绝大部分面积都落在粗掩码 肚子里面( 接近 1),就说明它是目标身体的一个零件,直接将所有高 IoF 碎片求并集!合并之后,再依次用粗掩码补齐漏掉的邻近区域、填充内部孔洞、做形态学平滑与连通域去噪(若合并后面积异常缩水则安全回退至粗掩码)。 4. MLLM 视觉审验与指令封装:把“原图 + 蓝色高亮掩码叠加图 + 类别名”喂给教师模型 Qwen3-VL-Plus,严格检查五项指标:类别是否对得上、主体是否包全、有没有吞进背景、掩码是否碎裂、画面里有没有漏掉同样显眼的同类实例。只有五项全过的样本才入库生成 CoRS 训练对。
3.2 SA1B-DeRS:“生成描述 → 抹除高亮反向框定”的自洽闭环
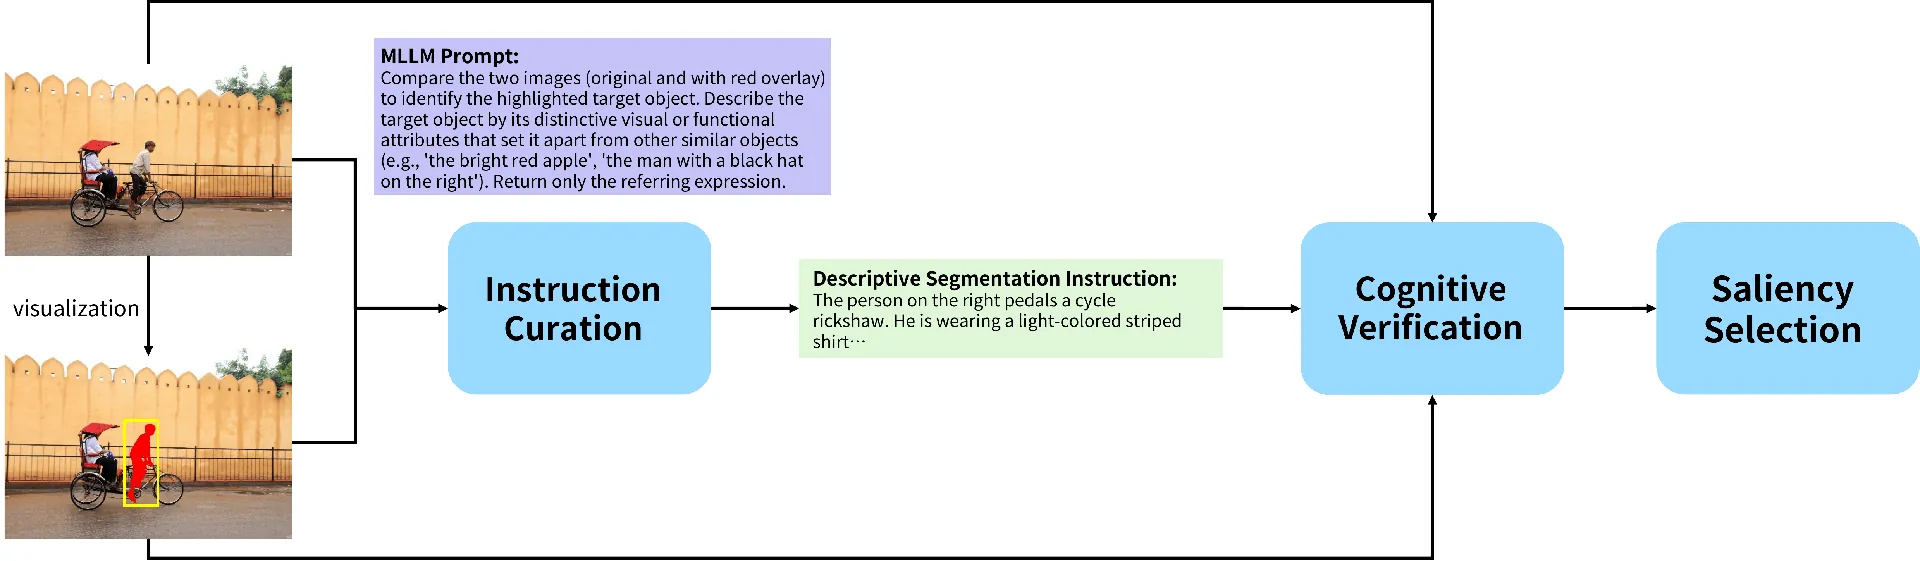
如果让大模型看图自由写一段物体描述,最常见的毛病是写出一段模棱两可的废话——比如画面里有三个穿白衣服的人,模型给左边那个人生成的描述却是 "a person wearing a white shirt"。拿这种有歧义的句子去训分割模型,模型只会一头雾水。
如 Fig. 5 所示,SA1B-DeRS 用一个极其聪明的认知反向验证闭环(Cognitive Verification Loop)根除了歧义:
- 五维特征提示生成:先把原图、高亮标出目标的掩码图和真值框喂给教师模型 Qwen3-VL-Plus,要求它结合五个维度写出一句能把该目标和其他干扰物区分开的描述:类别名(是什么)、外观属性(颜色、材质、穿着)、状态动作(站立、打开、损坏)、相对空间位置(最左边、从下往上第二个)以及上下文关系(站在绿橙小船上)。
- 盲测反向定位(IoU 生死线):描述写好后,把高亮掩码图撤掉,只把干净的原始图片和刚写好的那句描述重新喂给 Qwen3-VL-Plus,让它凭这句话去图里找目标并输出边界框。如果反向找出来的框与真实目标框的 ,说明刚才那句话写得不够唯一、有歧义,当场作废丢弃!只有能让大模型在盲测下精准找回原目标()且目标面积占比达标的显著实例,才会被收录进 194 万条 SA1B-DeRS 语料库。
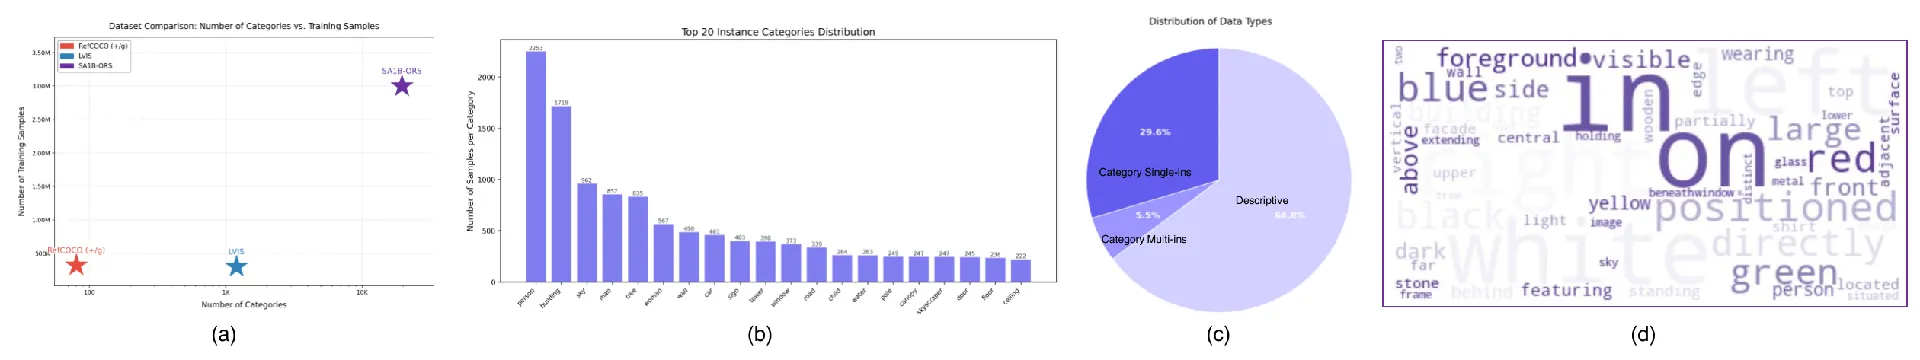
看 Fig. 6 的数据分布统计:SA1B-ORS 的类别规模与长尾跨度远超 LVIS 与 RefCOCO 系列,且 64.8% 的样本是复杂描述性指令(DeRS),词云中高频出现 left、above、foreground 等方位词与丰富的状态属性词。
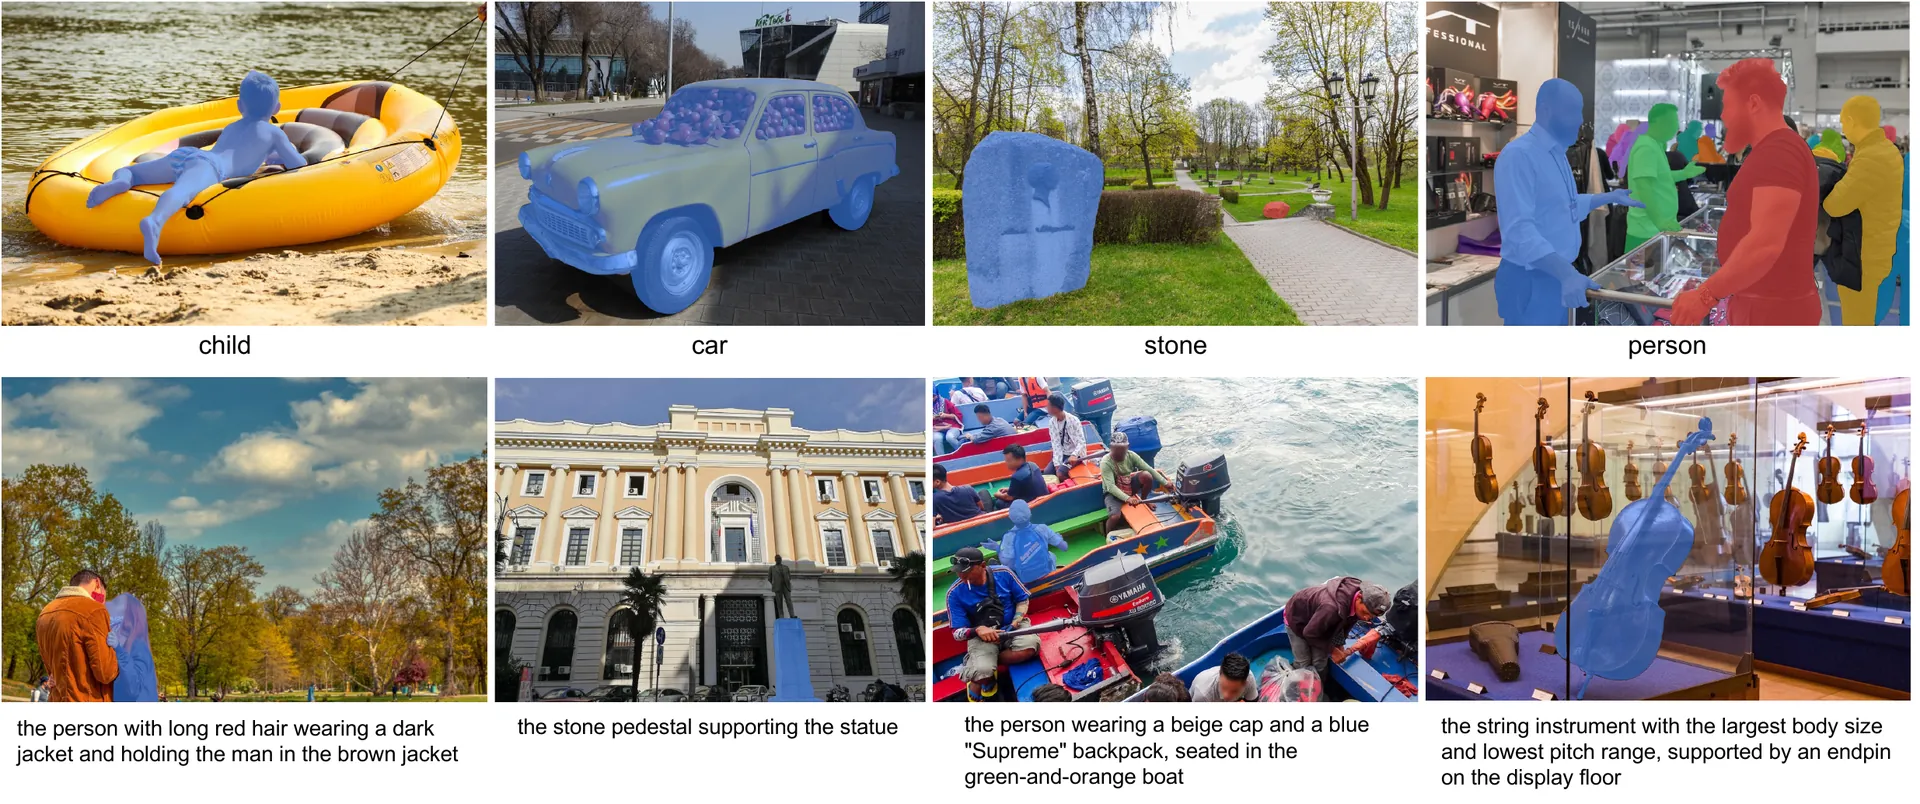
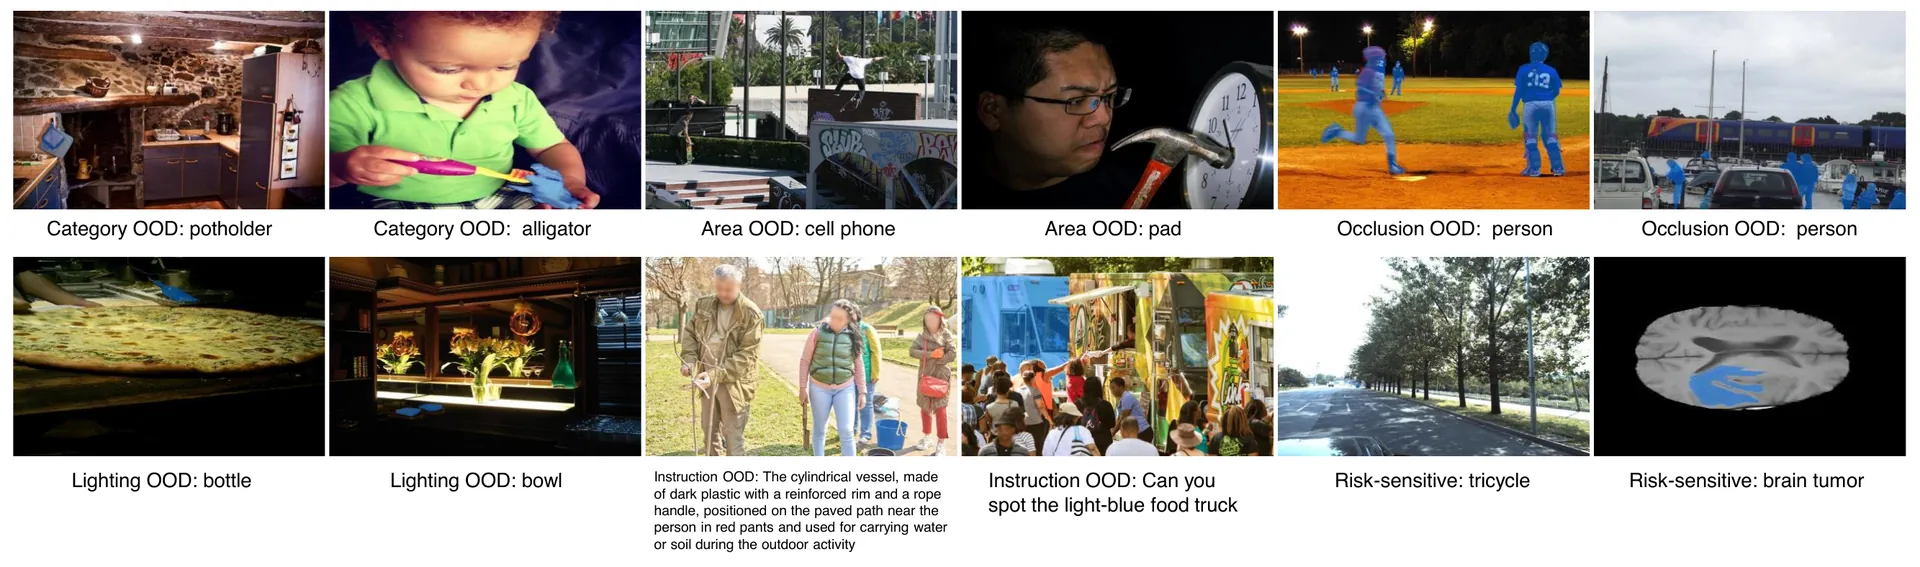
为了全面考校模型的开放世界能力,论文还配套构建了全部经过人工核验的评测基准 ORS-Bench:包含 9,055 个分布内样本的 ORS-ID-Bench(划分为单实例类别 2,465、多实例类别 1,823、短语指代 2,946、复杂描述 1,821 四个子桶),以及专门挑出训练集罕见或缺失场景的 ORS-OOD-Bench(如 Fig. 7 所示,涵盖罕见类别、极端大小面积、含否定/疑问/隐喻的复杂指令、重度遮挡、恶劣光照、以及自动驾驶与临床医疗风险敏感场景共 6 大桶,每桶约 200 样本)。
4. 两阶段协同训练:如何学会画精细掩码却不把脑子训傻?
在训练目标上,Qwen3-VL-Seg 同时优化自回归文本生成损失 (保证 JSON 格式、坐标与标签准确)和像素级分割损失 (由逐像素二元交叉熵 与抵抗前景背景面积失衡的 加权相加):
然而在多模态大模型微调中,有一个令所有研究者头疼的“跷跷板效应”:一旦用百万级分割数据高强度微调视觉编码器(ViT)和语言模型,模型的分割 IoU 确实蹭蹭往上涨,但原有的通用视觉问答(VQA)、图表 OCR 和数学几何推理能力却会大面积退化!
为了解决“长了像素眼、丢了推理脑”的冲突,论文设计了权责极其分明的两阶段协同训练配方:
| 训练阶段 | 各模块解冻与冻结状态 | 步数与学习率策略 | 训练数据配比与设计意图 |
|---|---|---|---|
| Stage 1:分割中心适配(Segmentation-Centric Adaptation) | 冻结 LLM 原权重并挂 rank=32 的 LoRA;解冻 ViT 视觉编码器 + 解冻 17M 掩码解码器 | 10,000 步;主学习率 ,ViT 采用 0.01x 差分学习率() | 100% 分割数据(公开 RES + SA1B-ORS);用极小步长温和改造 ViT 特征使其适应像素边界,同时让新解码器快速收敛 |
| Stage 2:通用能力重平衡(Synergistic Enhancement) | 将 LoRA 合并回 LLM,全量微调(Full Fine-tuning)4B LLM 主干 + 掩码解码器;彻底冻结 ViT | 5,000 步;全局采用极低学习率 余弦衰减 | 分割 : 通用多模态理解 : 多模态推理 = 3 : 1 : 2(含由原版 Qwen3-VL-Instruct 生成的 STEM 离策略蒸馏样本) |
仔细品味这两个阶段的切换逻辑:
- 为什么 Stage 1 必须解冻 ViT,但学习率又要压低 100 倍(
0.01x)? 后文消融实验(Table 5)证明,如果全程锁死原生 ViT,严格边界指标 P@0.9 会暴跌6.1个百分点,说明原生 ViT 特征确实太粗;但若用 的大步长去改 ViT,预训练视觉表征就会被分割损失彻底带偏。0.01x的差分学习率刚好在不破坏底层视觉流形的前提下唤醒了边缘感知。 - 为什么到了 Stage 2 反过来把 ViT 冻死,却把 4B LLM 放开做全量微调? 因为经过 Stage 1 的一万步洗礼,ViT 已经调校到了最适合密集分割的黄金状态,此时绝不能让涌入的通用 VQA 和数学题把 ViT 的像素敏感度再次冲淡;而把 LLM 放开配合
3:1:2的混合数据(特别是 STEM 推理蒸馏样本)做 的微调,则是为了让语言大脑重新找回被 Stage 1 单一 JSON 输出格式压抑的开放式推理与 OCR 阅读能力。
5. 实验深读:密集分割如何反哺框定位?能力边界在哪里?
5.1 经典指代分割(RES)与框定位(REC)的双向促进
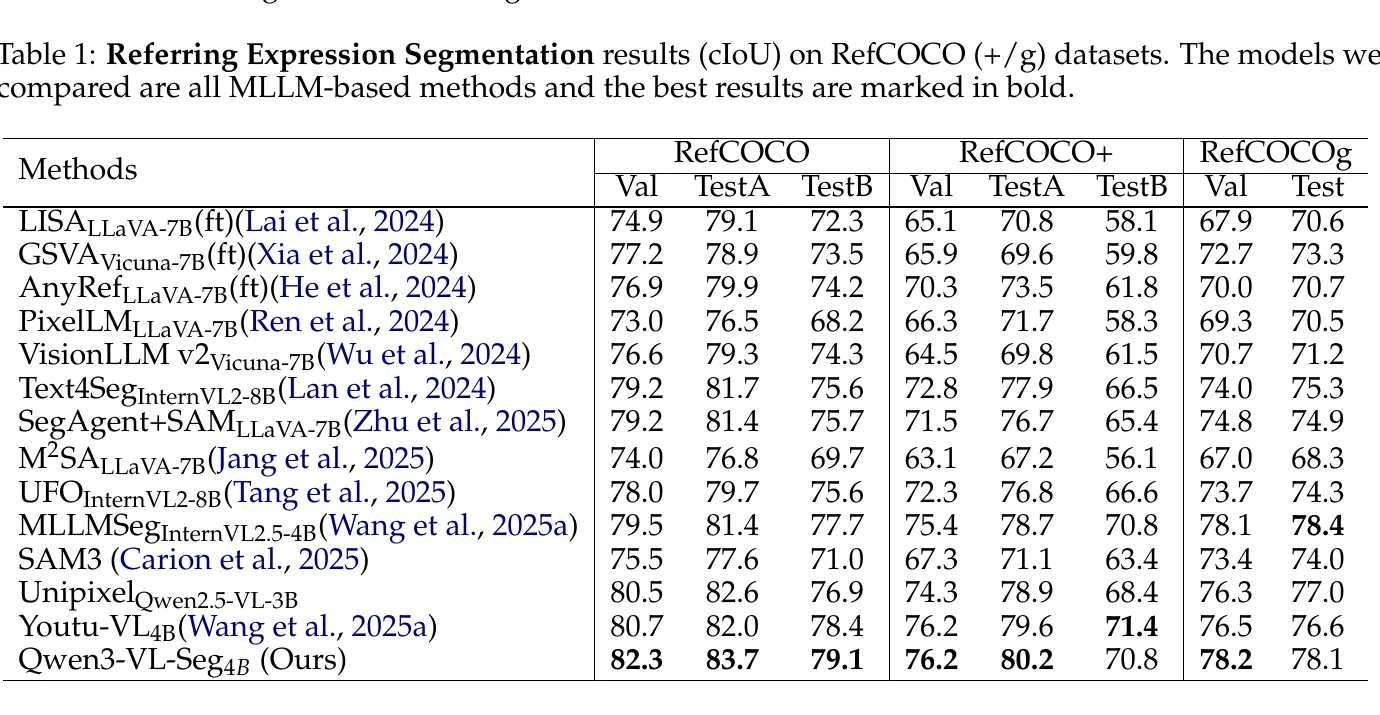
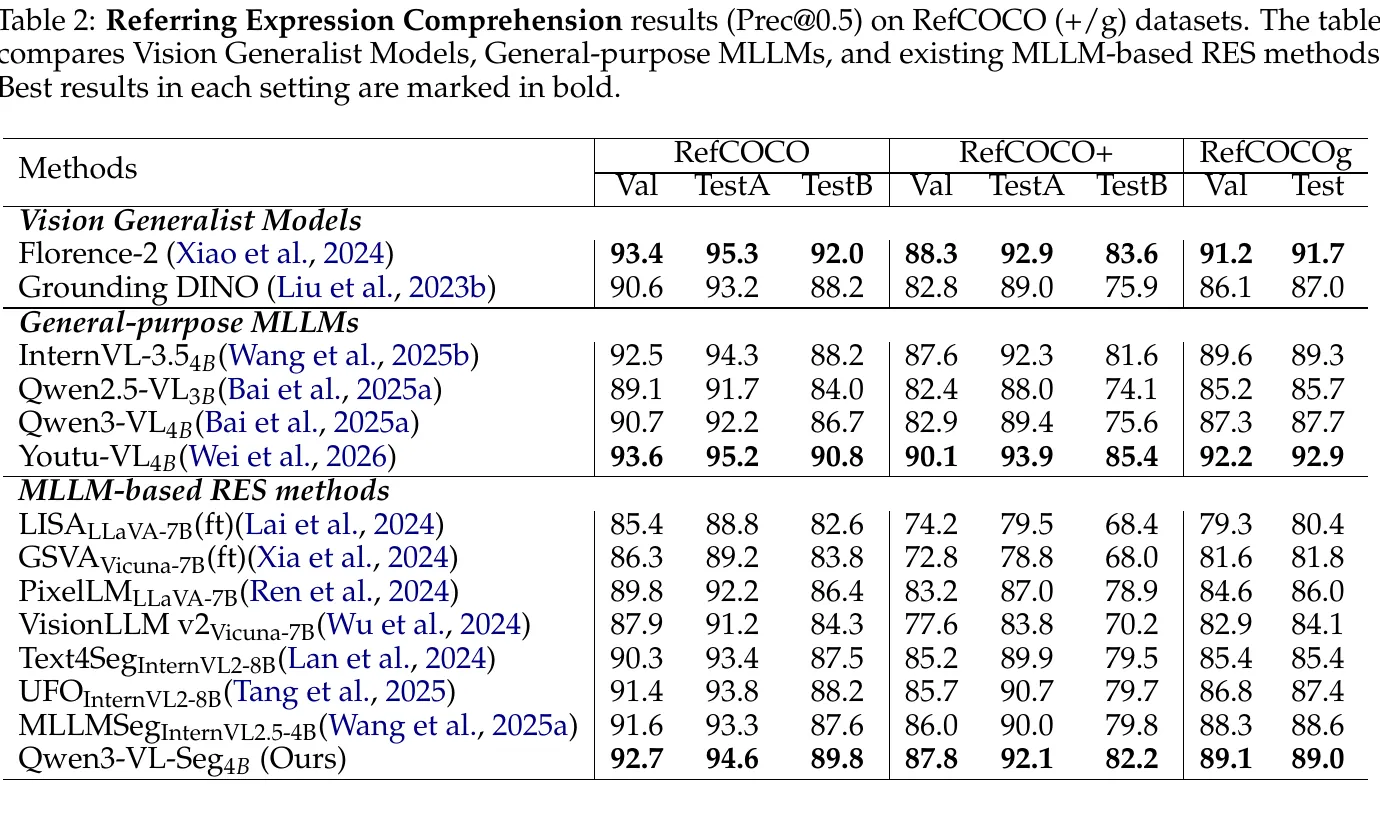
把 Table 1(RefCOCO/+/g 像素分割 cIoU)和 Table 2(框定位 Prec@0.5)放在一起对照,能读出两条非常有意思的结论:
- 单栈 17M 解码器全面压制外挂 SAM 双模型方案:在 Table 1 的 8 个标准切分中,4B 规模的 Qwen3-VL-Seg 拿下 6 项第一(RefCOCO Val/TestA/TestB 达
82.3 / 83.7 / 79.1)。相比把 MLLM 与外部 SAM 串起来的代表作 LISA,Qwen3-VL-Seg 在 RefCOCO Val 上高出7.4个百分点,在禁止使用方位词、纯靠外观属性消歧的 RefCOCO+ TestB 上更是大幅领先12.7个百分点;相比最新的 SegAgent+SAM 与专用分割基座 SAM3,也在全部切分上胜出。 - 像素级掩码监督反过来让框定位(REC)暴涨 6.6 个百分点:看 Table 2 最底下的对比——同样是输出
bbox_2d做框定位,经过分割联合训练的 Qwen3-VL-Seg 相比未经分割训练的原始基座 Qwen3-VL-4B,在全部 8 个切分上实现了无死角提升!特别是在最难的 RefCOCO+ TestB 上,框定位准确率从基座的75.6%直接跃升至82.2%(净增+6.6点)。这有力地证明了细粒度的像素级掩码损失就像一副高倍显微镜,逼着视觉特征更精准地剥离前景物体与紧邻背景,从而反向校准了语言模型画边界框的准星。
5.2 ORS-ID-Bench:与 SAM3 的正面交锋说明了什么?
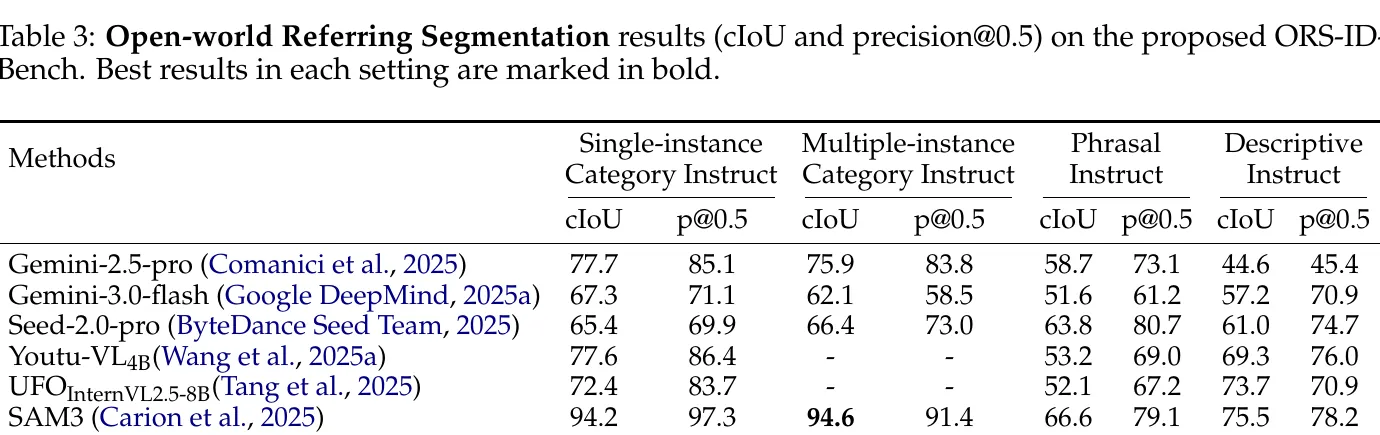
Table 3 在 9,055 个样本的 ORS-ID-Bench 上,将 Qwen3-VL-Seg 与闭源商业旗舰(Gemini-2.5-pro、Gemini-3.0-flash、Seed-2.0-pro)、同类原生分割模型(Youtu-VL-4B、UFO-8B)以及专用分割霸主 SAM3 进行了分桶对决。
这张表最值得细品的,恰恰是 Qwen3-VL-Seg 唯一没拿到第一的那个单元格,以及它在后面两列拉开 15 个百分点以上的统治级优势:
- 在“多实例纯类别分割”(Multiple-instance Category)上,为什么 SAM3 的 cIoU(
94.6%)略高于 Qwen3-VL-Seg(93.2%)? 当输入指令仅仅是一个简单的类别词(如"car"或"person"),且画面里密密麻麻有十几辆车时,任务的核心瓶颈不在语言推理,而在全图密集概念搜索与掩码覆盖。SAM3 作为专门为全图概念提示分割设计的视觉基座,天然擅长一次性把所有大大小小的同类像素扫出来;而 Qwen3-VL-Seg 必须先由语言模型在 JSON 数组里把十几辆车的bbox_2d一个不落地枚举出来(按匈牙利匹配评测),一旦自回归枚举漏掉远处一两个小实例,累计像素 cIoU 就会吃亏(尽管在样本级达标率 P@0.5 上,Qwen3-VL-Seg 仍以91.6%略超 SAM3 的91.4%)。 - 一旦进入“短语指代”(Phrasal)与“复杂描述”(Descriptive),为什么 Qwen3-VL-Seg 能狂胜 SAM3 超过 15 个百分点?
当指令变成
"从底部数第二个瓶子"或"绿橙小船上戴米色帽子的那个人"时,SAM3 的 cIoU 瞬间跌落至66.6%和75.5%,Gemini-2.5-pro 在复杂描述上更是只有44.6%;而 Qwen3-VL-Seg 交出了82.8% / 94.3%与91.0% / 91.3%的惊艳成绩,分别甩开最强基线16.2(较 SAM3)和15.5个百分点的 cIoU!这正印证了开篇的设计哲学:当指代条件涉及空间序数、状态动作与多物体交互时,唯有靠大语言模型先做深层关系消歧并锚定预测框,才能准确锁定目标。
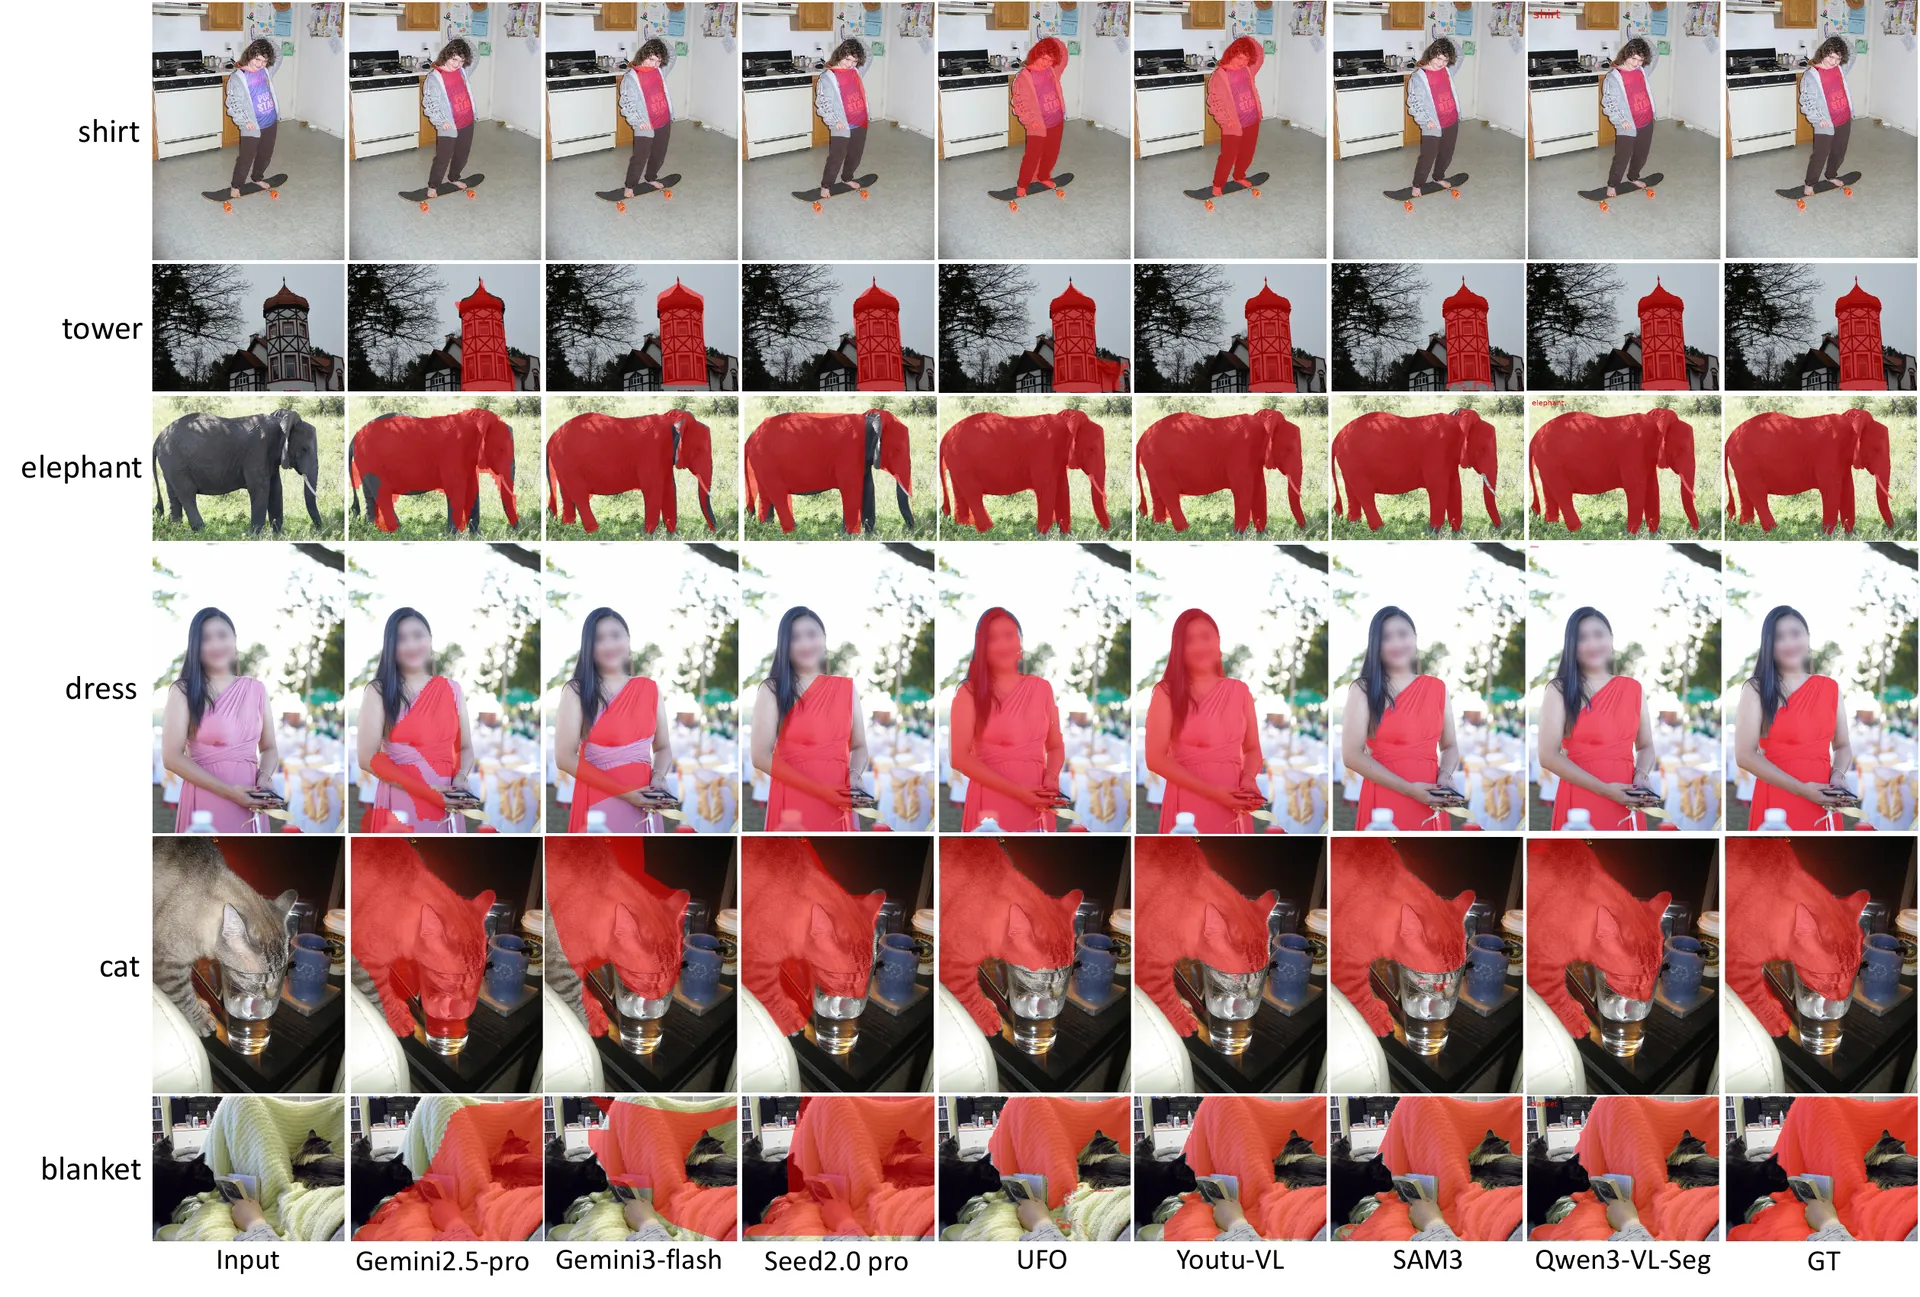
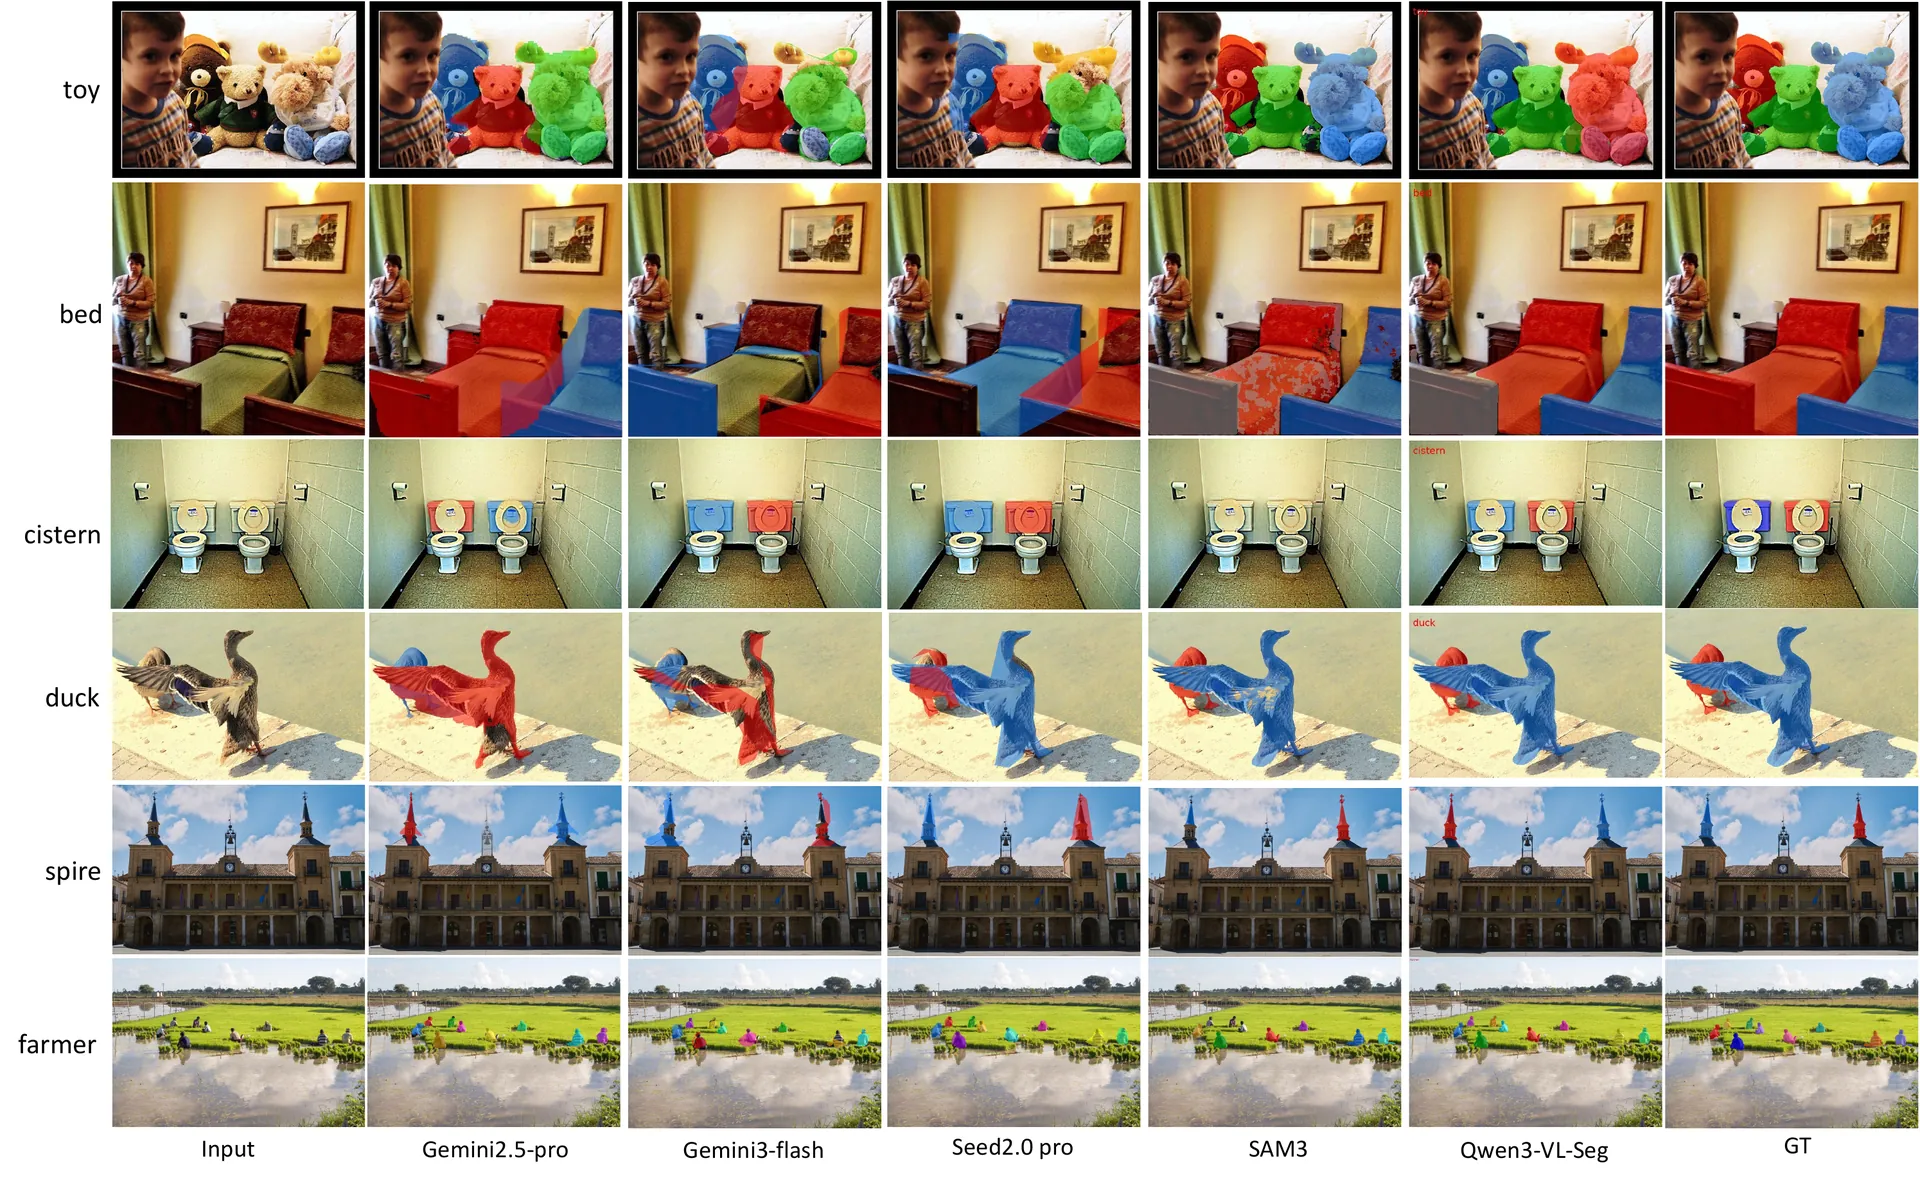
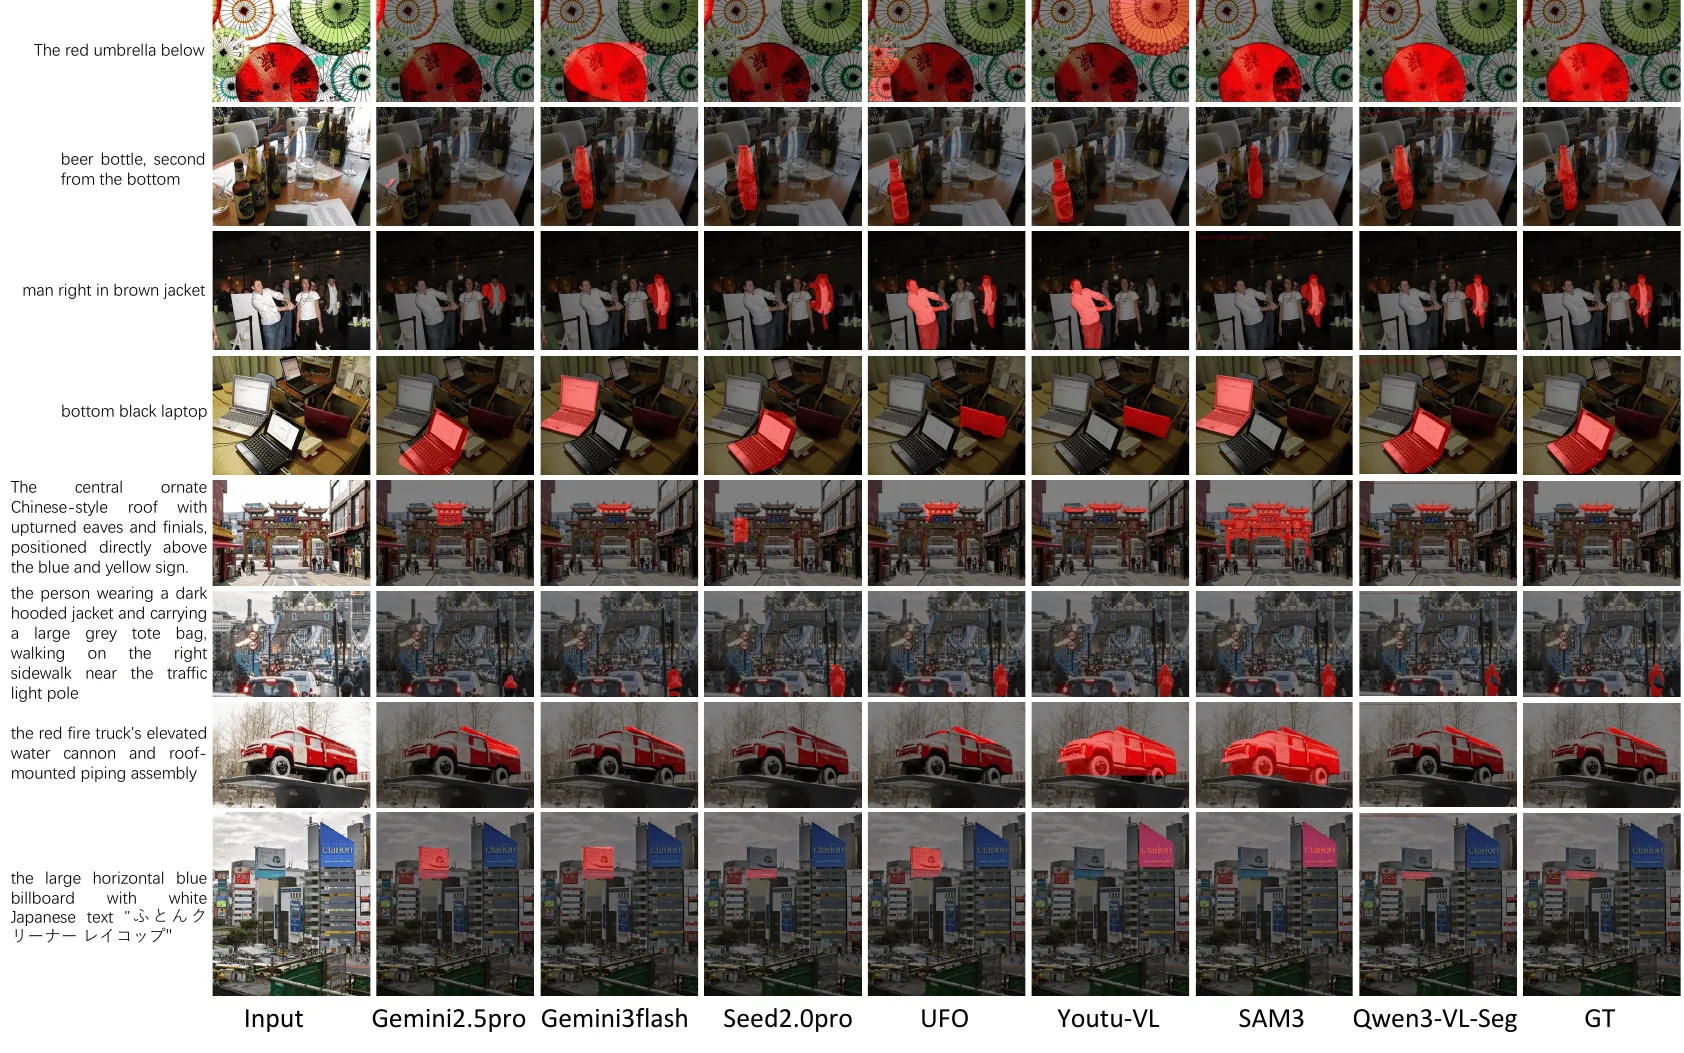
结合 Fig. 8(单实例类别)、Fig. 9(多实例类别,不同颜色代表独立预测实例)与 Fig. 10(短语及复杂描述)的可视化结果,可以直观看到:通用商业大模型(Gemini 系列、Seed)虽然能找对大致方位,但输出的掩码带有明显的多边形折线锯齿或粗块状膨胀;而 Qwen3-VL-Seg 凭借软门控浅层 CNN 分支与两轮精化,在大象腿部空隙、密集人群分离以及“消防车上抬起的水炮”等细长部件上均保持了紧致的边缘贴合。
5.3 ORS-OOD-Bench:六类分布偏移下的真实安全边界
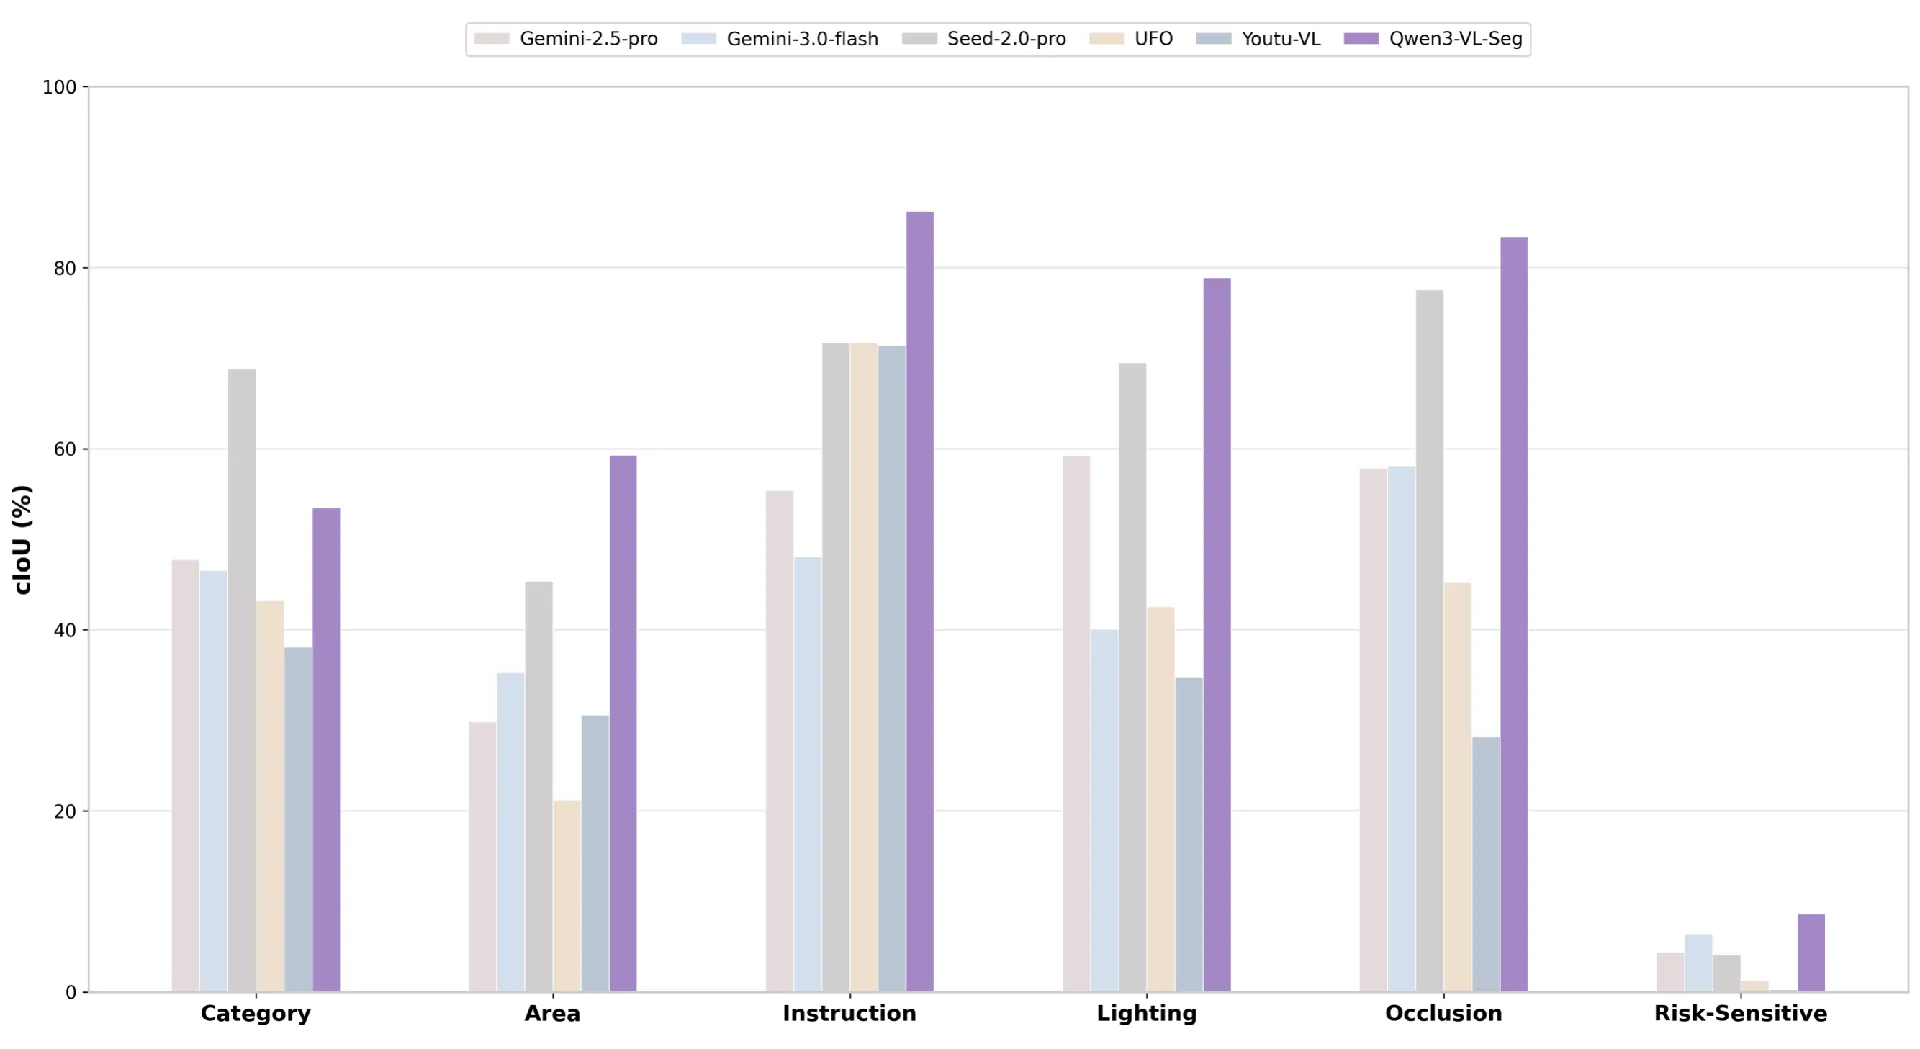
看 Fig. 11 的六类分布外(OOD)压力测试雷达/柱状对比,尽管 Qwen3-VL-Seg 在全部六个维度上都领先于对比模型,但六个桶的绝对分数呈现出耐人寻味的三级分化:
- 第一梯队——语言形式偏移与常规视觉干扰高度稳健:在隐去类别名、使用否定排除或疑问句式的
Instruction OOD上,模型拿到了86.22%的高分;在重度遮挡Occlusion OOD(83.45%)和夜间逆光等恶劣光照Lighting OOD(78.90%)上也保持坚挺。这说明大语言模型对复杂句式的泛化能力成功迁移到了分割链路。 - 第二梯队——极端尺度与罕见长尾类别明显回落:在目标面积占比小于 或大于 的
Area OOD上,cIoU 降至59.30%;在训练频率低于 的Category OOD上降至53.49%。其中极小目标的退化,直接呼应了前面第 3.2 节 SA1B-DeRS 数据引擎为了过滤碎片噪声而主动剔除极小面积目标的工程取舍。 - 第三梯队——高风险专业领域几乎不可用:在涵盖临床医学影像与自动驾驶复杂街景的
Risk-sensitive scene桶中,cIoU 断崖式跌至8.64%!这是因为医学 CT/MRI 与车载鱼眼相机在成像物理机制、专业解剖/交通语义以及标注规范上与互联网日常照片存在巨大鸿沟。这一数字给出了最诚实的工程警示:未经垂直领域专门数据微调与不确定性校准,绝对不能拿通用开放世界分割模型直接去跑医疗诊断或自动驾驶安全决策。
5.4 两阶段通用能力修复与解码器消融拆解
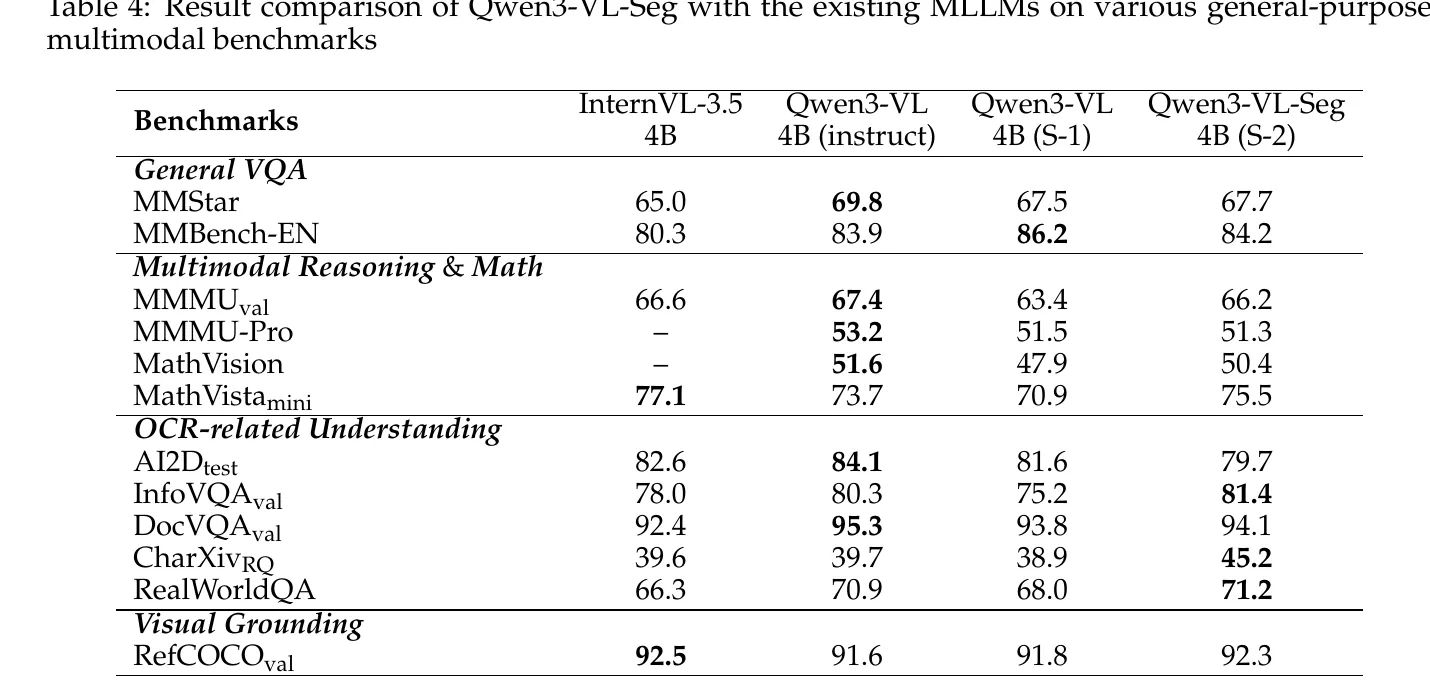
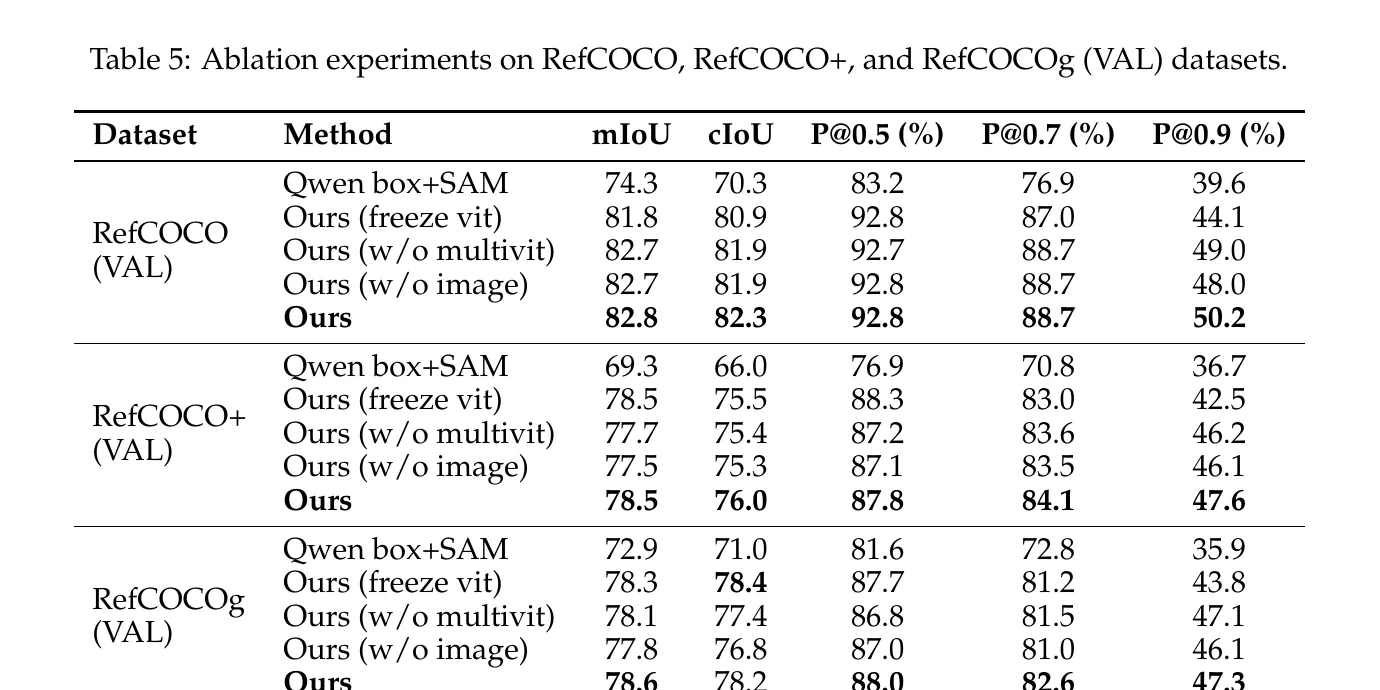
最后看 Table 4(通用多模态基准追踪)与 Table 5(解码器组件消融),它们用硬核数据回答了两个关键设计问题:
- Stage 2 到底救回了多少通用能力?
在 Table 4 中,对比原始基座
Qwen3-VL-4B Instruct、刚跑完分割适配的Stage 1与最终Stage 2:刚跑完 Stage 1 时,虽然 RefCOCO 涨了,但大学学科推理 MMMU Val 从67.4跌到63.4(掉了 4 分),文档图表理解 InfoVQA 从80.3跌到75.2(掉了 5.1 分),视觉数学 MathVision 从51.6跌到47.9。而经过 Stage 2 的3:1:2混合数据与 STEM 蒸馏重平衡后,MMMU 恢复到66.8,InfoVQA 更是反超基座达到81.4,RealWorldQA 升至71.2,科学图表推理 CharXiv-RQ 升至45.2(仅在 AI2D79.7 vs 84.1和 MMStar67.7 vs 69.8等少数基准上留有轻微折损)。这套两阶段配方实打实地证明了“鱼与熊掌可以兼得”。 - 严苛边界指标 P@0.9 到底靠谁撑起来?
在 Table 5 中,P@0.9 要求预测掩码与真值 IoU 超过
0.90才算对,是对边缘贴合度最严酷的考验:- 如果不训原生解码器,直接把同一个 Qwen3-VL 预测的框喂给外部 SAM(
Qwen box + SAM),RefCOCO Val 上的 P@0.9 只有39.6%;而端到端联合训练的 Qwen3-VL-Seg 高达50.2%(高出10.6个百分点)! - 如果在训练时完全锁死视觉编码器(
freeze vit),RefCOCO Val 的 P@0.9 会从50.2%摔到44.1%(掉了6.1个百分点),证明 Stage 1 用0.01x学习率微调 ViT 是恢复高精边界的必要条件。 - 如果去掉多层 ViT 特征注入(
w/o multivit)或去掉受软门控保护的原图浅层 CNN 分支(w/o image),三个数据集上的 cIoU 与 P@0.9 均出现一致下滑,证实了“中层 ViT 补结构、浅层 CNN 抠边缘”的互补效应。
- 如果不训原生解码器,直接把同一个 Qwen3-VL 预测的框喂给外部 SAM(
6. 工程审视:架构得失、误差归因与混合路由落地
6.1 核心设计的工程得失权衡表
跳出论文刷榜视角,站在系统架构师的角度审视 Qwen3-VL-Seg,它的每一项巧妙设计实际上都伴随着明确的工程权衡:
| 核心设计机制 | 解决的痛点 | 获得的架构收益 | 引入的潜在风险与代价 |
|---|---|---|---|
| 预测框双重注入(Query + Soft Gate) | 单 <mask_token> 在多实例/复杂背景下空间指向模糊 | 把 LLM 强大的框定位先验直接转化为像素解码锚点 | 框误差二次放大:一旦 LLM 第一步框错了目标,或者细长结构超出 15% 扩框范围,Query 和浅层纹理门控会同时失效 |
| 多层 ViT + PixelShuffle + 浅层 CNN | 顶层视觉 Token 空间分辨率过低、边缘模糊 | 仅用 17M 参数就把 P@0.9 严格边界指标推高 10 个百分点 | 需侵入式修改 MLLM 前向图以保留多层特征;高分辨率特征拼接与动态卷积会增加激活显存(Activation Memory) |
| 两轮掩码感知池化精化 | 单次动态卷积核在遮挡与同类紧邻边界易失误 | 无需重跑 LLM,仅靠解码器内一次特征回流即可校准边界 | 若第一轮粗掩码完全锁定了错误物体,池化出的错误特征 反而可能让第二轮错得更笃定 |
| SA1B-CoRS / DeRS 自动数据引擎 | 人工标注百万级像素掩码与长句描述成本高昂 | 构建出 299 万长尾类别与无歧义复杂描述训练样本 | 强依赖同家族教师模型 Qwen3-VL-Plus 审验,存在同源风格偏好;过滤极小碎片导致 Area OOD 极小目标性能受限 |
| Stage 1 + Stage 2 两阶段训练 | 高强度分割微调会导致通用 VQA 与数学推理退化 | 在拿下 SOTA 分割精度的同时保住并部分提升了通用推理与 OCR | 17M 仅代表推理新增参数;Stage 2 仍需全量微调 4B 语言模型,训练显存与算力门槛依然可观 |
6.2 生产环境全链路可观测性与混合路由架构
由于 Qwen3-VL-Seg 天然输出结构化的中间产物(JSON 标签、二维预测框、第一轮粗掩码、第二轮精化掩码以及 IoU 置信度头打分),在工程落地与评测诊断时,我们可以摆脱传统端到端分割模型“错了也不知道错在哪一步”的黑盒困境,将线上故障精准拆解为 6 类可观测归因桶:
F0 协议解析故障:JSON 语法截断,或 bbox_2d 数量与 <mask_token> 数量不一致
F1 语言逻辑故障:否定排除、序数计数或空间方位词被 LLM 误读,选错指代对象
F2 框定位故障(Grounding Error):理解了语义,但预测框偏移过大或漏枚举多实例
F3 边缘解码故障(Decoder Error):预测框完全准确(如 GT-Box Oracle 测试通过),但掩码边缘锯齿或镂空粘连
F4 二轮精化退化(Refinement Regression):第 2 轮掩码 IoU 反而低于第 1 轮粗掩码
F5 领域越界故障(Domain Shift):落入医疗影像、自动驾驶等未校准高风险领域
基于这一透明的中间接口,在构建工业级视觉工作流(如智能交互修图、大规模数据标注平台或具身智能感知)时,最理想的架构是将 Qwen3-VL-Seg 部署为开放世界语言路由器与默认原生分割引擎:
图像 + 任意自然语言指令
        │
        ▼
Qwen3-VL-Seg 单栈推理(输出 label + bbox_2d + 原生掩码 + IoU 置信度)
        │
        ├─> [常规场景 & 置信度高] ──> 直接返回 17M 解码器生成的低延迟原生掩码
        ├─> [精细发丝/半透明抠图] ──> 将预测框与粗掩码作为提示,按需路由给外部 Matting / SAM3 精修
        ├─> [医疗/车载等高风险域] ──> 触发领域门禁拦截,转交垂直领域专用分割模型
        └─> [交互式人工标注平台] ──> 在 UI 上同时渲染预测框与掩码多边形,供标注员一键微调
总而言之,Qwen3-VL-Seg 给多模态感知架构带来的最大启示,在于它看清了大语言模型的强项是“高层关系推理与粗粒度框定位”,而卷积与多尺度特征的强项是“局部高频边缘恢复”。用一个预测框和一枚 <mask_token> 把这两头精准焊在一起,既发挥了 4B 多模态大模型的语言天赋,又让 17M 的轻量解码器站在了坚实的几何肩膀上。
参考资料
- Yuan Yao, Qiushi Yang, Humen Zhong, Jiangning Wei, Yifang Men, Shuai Bai, Miaomiao Cui, Zhibo Yang, Qwen3-VL-Seg: Unlocking Open-World Referring Segmentation with Vision-Language Grounding, arXiv:2605.07141.
- 基座模型报告:Qwen Team, Qwen3-VL Technical Report, arXiv:2511.21631.
- 相关核心文献:LISA (CVPR 2024)、GSVA (CVPR 2024)、GRES (CVPR 2023)、Segment Anything (ICCV 2023)、SAM 2 (2024)、RAM (CVPR 2024)、Florence-2 (CVPR 2024).
comments