在搭建企业级搜索、RAG(检索增强生成)或实时推荐系统时,很多工程团队都会经历一段痛苦的“多系统拼接期”:用 Elasticsearch 跑 BM25 关键词检索,用 Milvus 或 Qdrant 跑稠密向量近邻(ANN),用 Redis 存文档的实时点击率、库存或租户 ACL 权限列表,最后再起一组 Python 微服务跑重排模型(Reranker)。
这套拼装架构在 Demo 阶段跑得顺风顺水,可一旦上了生产高并发流量,延迟和成本就会迅速失控。原因很直观:假设每次查询需要从文本路和向量路各召回 500 个候选文档,为了给这 1,000 个候选打分排序,业务网关必须先把 1,000 个文档 ID 拉回内存,再去 Redis 批量捞取上千条实时属性,拼接成庞大的 JSON/Protobuf 载荷发给排序服务。最终你会发现,80% 的 P99 延迟和 CPU 开销都浪费在了跨服务的网络序列化与候选数据搬运上,真正花在相关性计算上的时间反而微乎其微。
Vespa(Vespa.ai / Vespa Engine)正是为了终结这种“数据到处搬运”的碎片化架构而生的开源大规模实时检索与服务引擎。透过繁多的配置项看本质,Vespa 的整套架构建立在四条环环相扣的设计哲学之上:
- 计算向数据靠拢(Compute-near-Data over Data Movement):将词法倒排索引(Inverted Index)、HNSW 向量图索引、内存列式属性(Attribute)以及张量/模型推理引擎统一部署在同一个有状态内容节点(Content Node)中。检索出上千个候选后,直接在数据所在的内存地址上原地读取特征、执行多阶段打分,最后只把胜出的几十条结果摘要通过网络传回上层。
- 多阶段级联排序漏斗(Cascaded Phased Ranking):相关性精度与算力开销天生存在矛盾。Vespa 在架构层面原生定义了三阶段排序漏斗:在每个数据分片上用廉价代数表达式对全量匹配候选做粗排(
first-phase),仅对分片内前 名运行特征交叉、GBDT 或轻量网络做精排(second-phase),最后在无状态容器层对跨分片归并后的全局前 名做重型交叉编码器重排或分数归一化(global-phase)。 - 单次执行计划内的过滤与双路召回融合(Single-Pass Filtered Hybrid Retrieval):在分离架构中,“先过滤还是先做向量近邻”是个臭名昭著的两难问题——后置过滤(Post-filtering)极易把 Top- 候选滤空,而外置前置过滤又会破坏 HNSW 图的连通性。Vespa 将结构化属性位图(Bitvector)直接注入 HNSW 图游走与倒排求交算子内部,在单次 YQL 查询计划中同时完成多租户硬过滤、BM25 词面召回与向量近邻搜索。
- 声明式应用包与白盒特征归因(Declarative Application Package & White-Box Match Features):把集群拓扑(
services.xml)、字段物理布局(index/attribute/summary)和排序公式(rank-profile)收拢进统一的声明式配置包,并允许通过match-features随每条命中文档输出所有子特征的真实计算值,让线上相关性调优彻底告别黑盒盲猜。
下面我们就顺着这四条设计哲学,用一个贯穿全文的 docs-search 实战工程,从本地 Docker 容器启动开始,一步步走完应用包配置、Schema 物理存储设计、数据实时写入、YQL 检索、BM25 与 HNSW 混合排序调试,直至演进为生产级多租户 RAG Chunk 检索后端。
1. 架构全貌与核心心智模型:为什么不把所有需求都塞进普通向量库?
1.1 搜索、向量库与 Vespa 的工程权衡
如果你的需求仅仅是存 1 万条静态文本向量、快速搭一个个人知识库原型,那么直接用 Qdrant、Chroma、Milvus 甚至 SQLite 向量插件都会非常轻便。但当业务进入深水区,面临以下复合挑战时,单一向量库就会捉襟见肘:
| 真实生产痛点 | 传统多系统拼装方案的做法 | Vespa 的原生解法 |
|---|---|---|
| 专有名词与语义意图需要兼顾 | 分别查 ES 和向量库,在业务代码里写 RRF(倒数排名融合)硬拼两路结果 | 同一条 YQL 中用 or 联合召回词法与向量候选,共享同一个 rank-profile 统一打分 |
| 排序需要融合实时业务特征 | 召回 ID 后再查外部缓存拉取发布时间、点赞数、权威度做二次加权 | 业务特征以 attribute 常驻内容节点内存,排序表达式直接原地读取 attribute(published_at) |
| 文档高频局部更新 | 改一个标签或点击率就要重新传整段文本和 384 维向量重建索引 | 原生支持面向 attribute 字段的内存级高频局部更新(Partial Update),毫秒级对查询可见 |
| 企业级 RAG 强权限隔离 | 先搜出 Top-50 向量再调权限服务过滤,常因无权限导致返回结果不足 | tenant_id / acl 开启 fast-search 内存索引,与 nearestNeighbor 在底层协同过滤 |
把 Vespa 放回主流检索基础设施坐标系中,可以清晰看清各自的架构重心:
| 系统 | 核心架构定位 | 最契合的工程场景 |
|---|---|---|
| Elasticsearch / OpenSearch | 基于 Lucene 的分布式文档搜索与日志分析引擎 | 全文检索、ELK 可观测性日志分析、多维分面聚合(Aggregations) |
| Milvus | 面向海量高维 Embedding 的云原生专用向量数据库 | 亿级规模纯向量存储、多索引类型(IVF/HNSW/DiskANN)高吞吐近似近邻召回 |
| Qdrant | Rust 编写的轻量高性能向量检索引擎 | 追求快速落地、以语义检索为主并附带 JSON Payload 过滤的应用 |
| Vespa | 计算与数据合一的 AI Retrieval & Ranking 引擎 | 多路召回(文本+向量+结构化)+ 多阶段复杂排序 + 在线张量/模型推理 + 实时特征更新 |
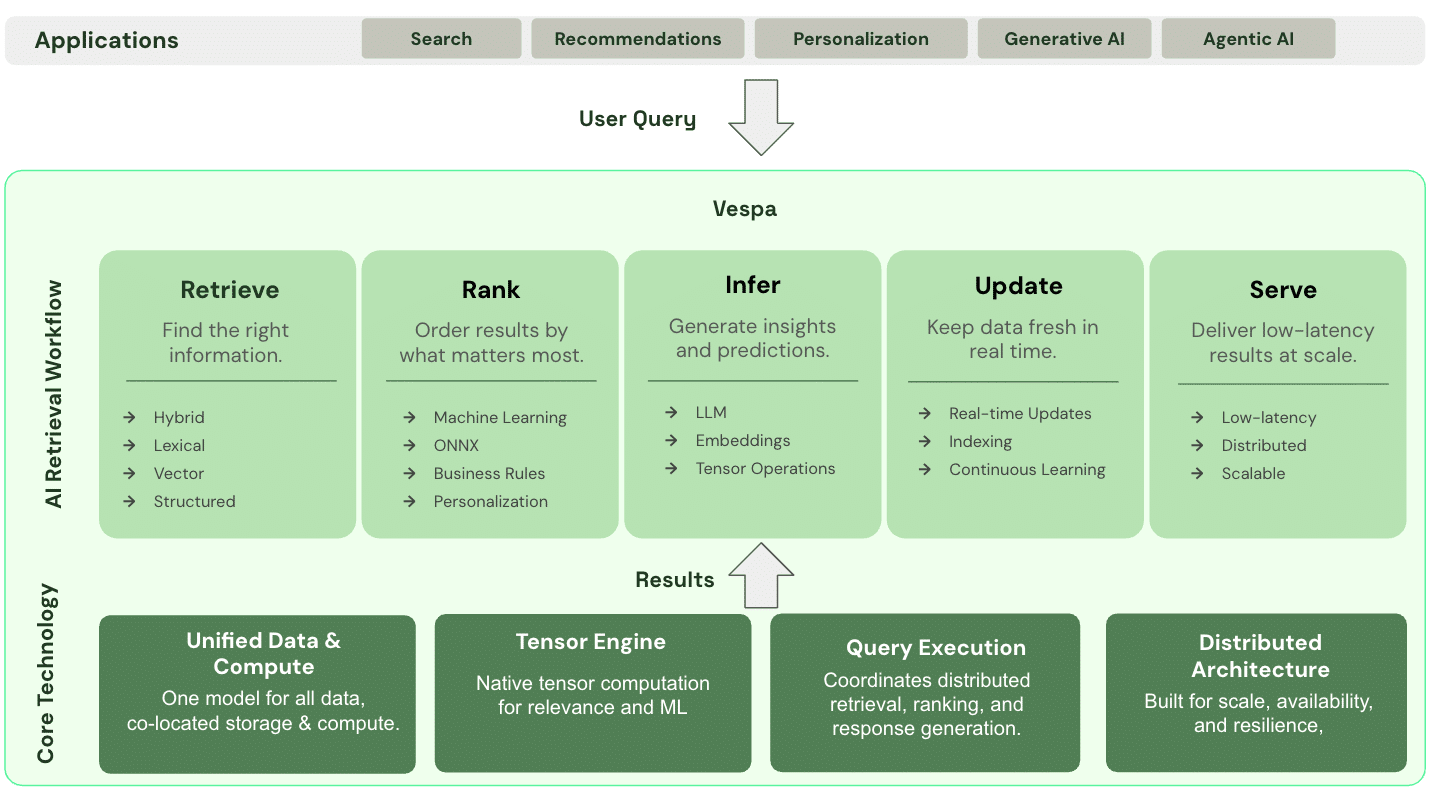
从上方架构图可以看到,Vespa 将在线检索拆解为 Retrieve(多路召回)、Rank(多阶段排序)、Infer(模型推理)、Update(实时更新)和 Serve(分布式服务)五个闭环阶段。普通向量库只回答“给我一个查询向量,返回余弦距离最近的 Top- 向量”;而 Vespa 回答的是一个完整的在线决策问题:
输入:用户搜索词 + 查询向量 + 用户画像张量 + 多租户/时间过滤条件
  -> 1. 在各分片原地完成布尔过滤、倒排词项匹配与 HNSW 图近邻召回
  -> 2. 对分片内所有召回候选执行 First-Phase 粗排(BM25 + 向量 Closeness + 实时新鲜度)
  -> 3. 对分片内 Top-N 候选执行 Second-Phase 精排(特征交叉 / GBDT / ONNX 模型)
  -> 4. 容器层归并各分片结果,按指定 Document Summary 裁剪字段并附带调试特征返回
1.2 无状态容器层与有状态内容层的两层解耦
初学者看 Vespa 文档时容易被各种组件名绕晕,其实只需要抓住五个核心概念以及“无状态层 vs 有状态层”的物理分工:
| 核心概念 | 职责与物理角色 | 直观工程类比 |
|---|---|---|
| Application Package | 包含 services.xml 与 schemas/*.sd 的声明式配置目录 | 搜索集群的基础设施即代码(IaC)工程包 |
Schema (*.sd) | 定义单类文档的字段类型、三种物理存储方式、返回摘要与排序模型 | 数据库建表语句 + 索引定义 + 排序算子脚本 |
| Document | 具有全局唯一 ID 的单条写入记录 | 一篇技术文档、一件商品或一个 RAG 文本块(Chunk) |
| Container Cluster | 无状态请求处理层:接收 HTTP 请求、解析 YQL、向内容节点扇出(Fan-out)并归并最终结果 | API 网关 + 分布式查询协调器(Coordinator) |
| Content Cluster | 有状态数据与计算层:负责数据分片存储、倒排/HNSW 索引构建,以及就地执行匹配和排序 | 存储分片引擎 + 原地计算工人(Worker) |

对照上方组件拓扑图,一条查询请求(Query Path)和一条写入请求(Feed Path)在两层之间的流转轨迹非常清晰:
【查询链路 Query Path:扇出计算,仅归并轻量胜出者】
Client ──(HTTP /search/)──> Container Cluster (解析 YQL,准备查询张量,并发扇出)
                                  │
                    ┌─────────────┴─────────────┐
                    ▼                           ▼
           Content Node (Shard 0)      Content Node (Shard 1)
           1. 倒排 + HNSW + 属性过滤     1. 倒排 + HNSW + 属性过滤
           2. 原地计算 First/Second 排序  2. 原地计算 First/Second 排序
           3. 仅返回本分片 Top-K ID 与分值 3. 仅返回本分片 Top-K ID 与分值
                    └─────────────┬─────────────┘
                                  ▼
                Container Cluster (归并全局 Top-K,按 Summary 拉取必要展示字段,渲染 JSON)

【写入链路 Feed Path:按 ID 路由,内存与索引实时更新】
Client ──(JSONL put/update/remove)──> Container (document-api 校验并按 Document ID 哈希路由)
                                          │
                                          ▼
                                Content Cluster (落盘 Document Store,刷新内存 Attribute,增量更新倒排与 HNSW 图)
理解了这张图,你就明白了为什么 Vespa 在高并发下依然能保持低延迟:在 First-Phase 和 Second-Phase 阶段,成千上万个候选文档根本不会离开各自所在的 Content Node 内存;只有最终胜出的 Top- 文档才会在最后一步填充摘要(Summary Fill)并通过网络返回给 Container。
2. 本地环境搭建与第一个 Application Package
2.1 启动 Docker 容器与配置 Vespa CLI
我们在本地通过 Docker 运行单节点 Vespa 容器来动手实验。启动前请确认本地 Docker Desktop 或 Podman 正在运行,且至少分配了 4 GB 及以上的可用内存(HNSW 图索引构建与 JVM 容器层需要一定的常驻内存,内存不足会导致部署超时或容器 OOM 退出)。同时安装好 vespa-cli(macOS 可直接执行 brew install vespa-cli)、curl 与 python3。
Vespa 容器对外暴露两个核心端口:
8080(数据面端口):承载查询(/search/)、文档读写(/document/v1/)等所有在线 HTTP 流量;19071(控制面端口):承载 Config Server,专门接收vespa deploy发来的应用包配置并下发给内部进程。
执行以下命令拉取镜像并启动容器:
docker pull vespaengine/vespa

docker run --detach --name vespa --hostname vespa-container \
  --publish 8080:8080 --publish 19071:19071 \
  vespaengine/vespa
容器启动后,可以使用内置的 vespa-logfmt 工具查看格式化后的实时服务日志,并将 CLI 目标指向本地验证就绪状态:
# 查看容器内格式化服务日志(可选)
docker exec vespa vespa-logfmt

# 将 CLI 指向本地容器并检查控制面与数据面状态
vespa config set target local
vespa status
当 vespa status 显示 Container (query API) 和 Deploy API 均为绿色 Ready 状态时,说明底座已经就绪。
2.2 最小应用包结构与 services.xml 拓扑解析
我们创建一个名为 docs-search 的技术文档检索应用。在 Vespa 中,一个最小可运行的 Application Package 只需要两个声明式文件:
docs-search/
  services.xml
  schemas/
    doc.sd
先在本地创建该目录并进入工作区(后文所有 vespa deploy 命令均在 docs-search/ 目录下执行):
mkdir -p docs-search/schemas
cd docs-search
将以下集群拓扑配置写入 docs-search/services.xml:
<?xml version="1.0" encoding="UTF-8"?>
<services version="1.0">
  <container id="default" version="1.0">
    <search />
    <document-api />
    <nodes>
      <node hostalias="node1" />
    </nodes>
  </container>

  <content id="docs" version="1.0">
    <redundancy>1</redundancy>
    <documents>
      <document type="doc" mode="index" />
    </documents>
    <nodes>
      <node hostalias="node1" distribution-key="0" />
    </nodes>
  </content>
</services>
这段 XML 就是前文“两层解耦架构”的代码映射:
<container id="default">声明了无状态容器集群,内部通过<search />开启查询接口,通过<document-api />开启文档写入与 CRUD 接口;<content id="docs">声明了有状态内容集群,<redundancy>1</redundancy>表示本地单节点保存 1 份数据副本;<document type="doc" mode="index" />是连接两个文件的关键纽带——它告诉内容集群加载名为doc的 Schema(对应schemas/doc.sd),并启用支持实时倒排与向量索引的index模式。
3. Schema 物理存储哲学:index、attribute 与 summary 的黄金边界
3.1 为什么一个字段要区分三种物理存储形态?
在关系型数据库里,你建一列 VARCHAR 再加个索引就完事了;但在追求极致低延迟的检索系统里,“怎么查这个字段”直接决定了它应该用什么数据结构躺在内存或磁盘上:
- 如果你要对一段长文本做分词、词干提取、短语匹配和 BM25 打分,它必须建成词典 + 倒排链(Inverted Index);或者如果它是一个 384 维向量且需要快速找近似最近邻,它必须建成 HNSW 导航图索引——在 Vespa 中,这叫
indexing: index。 - 如果你要在排序公式里每毫秒读取上千个文档的
published_at时间戳算时间衰减,或者按tags/tenant_id做精确过滤与分组统计(Grouping),去倒排链或磁盘行存里捞数据会慢得无法接受。它必须像列式数据库一样,按文档 ID 下标做成常驻内存的正排数组/查找表——在 Vespa 中,这叫indexing: attribute。 - 如果某个字段(比如
url或正文body)只需要在最后选出 Top-10 结果后展示给前端看,平时根本不参与匹配和算分,那它只需要存进支持按文档 ID 批量读取的压缩文档摘要库(Document Store)——在 Vespa 中,这叫indexing: summary。
想通了这三者的物理本质,我们再来编写 docs-search/schemas/doc.sd 就会觉得每一行配置都顺理成章:
schema doc {
  document doc {
    field id type string {
      indexing: attribute | summary
      match: word
    }

    field title type string {
      indexing: index | summary
      match: text
      index: enable-bm25
    }

    field body type string {
      indexing: index | summary
      match: text
      index: enable-bm25
    }

    field url type string {
      indexing: attribute | summary
      match: word
    }

    field tags type array<string> {
      indexing: attribute | summary
    }

    field published_at type long {
      indexing: attribute | summary
      attribute: fast-search
    }

    field embedding type tensor<float>(x[384]) {
      indexing: attribute | index
      attribute {
        distance-metric: angular
      }
      index {
        hnsw {
          max-links-per-node: 16
          neighbors-to-explore-at-insert: 100
        }
      }
    }
  }

  fieldset default {
    fields: title, body
  }

  document-summary compact {
    summary id {}
    summary title {}
    summary url {}
    summary tags {}
    summary published_at {}
  }

  rank-profile default {
    first-phase {
      expression: nativeRank(title, body)
    }
  }

  rank-profile bm25 inherits default {
    first-phase {
      expression: bm25(title) + bm25(body)
    }
    match-features {
      bm25(title)
      bm25(body)
    }
  }

  rank-profile semantic {
    inputs {
      query(q) tensor<float>(x[384])
    }
    first-phase {
      expression: closeness(field, embedding)
    }
    match-features {
      closeness(field, embedding)
      distance(field, embedding)
    }
  }

  rank-profile hybrid inherits semantic {
    first-phase {
      expression: bm25(title) + bm25(body) + 0.5 * closeness(field, embedding)
    }
    match-features {
      bm25(title)
      bm25(body)
      closeness(field, embedding)
      distance(field, embedding)
    }
  }
}
仔细审视这份 doc.sd 中的四个关键工程细节:
index: enable-bm25的预计算机制:为什么title和body开了indexing: index还不够,必须额外写一行index: enable-bm25?因为标准 BM25 公式需要用到词项在文档内的词频(TF)以及经过文档长度归一化后的阻尼系数;显式声明enable-bm25会指示 Vespa 在构建倒排索引时额外存储预编码的词频与文档长度字节,从而让排序阶段调用bm25(title)时只需极速查表,省去现场扫描分词的开销。attribute: fast-search的取舍:普通attribute本质上是按文档内部序号索引的数组,如果直接在上面执行where published_at > 1760000000,内容节点需要线性扫描该分片的内存数组;加上attribute: fast-search后,Vespa 会为该属性额外维护一棵 B-Tree 字典与倒排位图(Bitvector),把高频过滤从线性扫描加速为对数级查找。代价是多消耗一份内存,因此只应加在高频出现在where过滤条件里的字段上。embedding同时声明attribute | index:向量字段必须存成内存attribute才能支持读取原始浮点数计算精确距离,同时加上index并配置hnsw才能构建近似最近邻图索引。document-summary compact的带宽保护:默认的全文摘要会把长篇body甚至 384 个浮点数的embedding一并塞进返回 JSON;定义compact摘要后,列表页查询只需指定presentation.summary=compact,就能只拉取轻量元数据,大幅削减摘要填充与网络传输耗时。
我们可以将 Schema 字段的设计套路浓缩为一张速查表:
| 字段业务角色 | 推荐物理配置 | 底层数据结构与作用 |
|---|---|---|
全文检索文本(title, body) | indexing: index | summary + match: text + index: enable-bm25 | 磁盘/内存倒排索引 + BM25 预计算表 + 摘要存储 |
高频过滤与排序标量(published_at) | indexing: attribute | summary + attribute: fast-search | 内存列存数组 + B-Tree/位图索引,支持微秒级过滤与排序读取 |
低频过滤标签或展示字段(tags, url) | indexing: attribute | summary | 内存列存(支持局部更新与按值匹配)+ 摘要存储 |
稠密语义向量(embedding) | tensor<float>(x[D]) + indexing: attribute | index + hnsw | 内存张量存储 + 内存 HNSW 多层导航图 |
3.2 生产环境的 Schema 演进风险与向量版本隔离
在本地实验时,改完 doc.sd 直接跑 vespa deploy 就能生效;但在存有数千万文档的生产集群上,不同 Schema 变更的破坏半径截然不同:
| 变更操作 | 线上风险等级 | 底层发生了什么?该如何安全操作? |
|---|---|---|
新增 document-summary 或调整 rank-profile 公式 | 低风险 | 仅改变容器层裁剪逻辑或算分算子,无需重写底层文档数据;建议新增带版本号的 hybrid_v2 灰度对比后再切换默认 profile |
新增 attribute 或 index 字段 | 中风险 | 已存量文档在该字段上为空,需先部署 Schema,再通过异步管线执行 Partial Update 回填数据后,方可在查询中启用强过滤 |
修改字段类型或修改 tensor 向量维度(如 x[384] → x[768]) | 高风险(破坏性) | 底层内存布局与 HNSW 图结构完全不兼容,会被部署校验拦截(需 validation-overrides 强行清空重建);生产上应采用新增字段(如 embedding_v2)或蓝绿集群双写平滑切换 |
| 切换 Embedding 模型(哪怕维度同为 384 维) | 极高隐蔽风险 | 新旧模型的向量空间旋转错位,拿新模型的 Query 向量去搜旧模型的文档向量会导致相关性静默雪崩 |
针对最后一条“Embedding 模型跨版本污染”的经典大坑,最稳妥的工程规范是在 Schema 中显式设立一个带 fast-search 的模型版本字段:
field embedding_version type string {
  indexing: attribute | summary
  match: word
  attribute: fast-search
}
在模型升级期间,双写管线为新向量打上新版本号,在线查询则在 YQL 中强制锁死当前网关所使用的 Embedding 模型版本,从而实现零停机的平滑灰度与秒级回滚:
vespa query \
  'yql=select * from doc where embedding_version contains "e5-small-v2" and ({targetHits:50}nearestNeighbor(embedding, q))' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=semantic'
4. 数据写入(Feed)、首次部署与 Document API 实时更新
4.1 全局 Document ID 规范与测试数据生成
Vespa 要求写入的每一条文档都必须携带全局唯一标识符(Document ID),其标准格式为:
id:<namespace>:<document-type>::<user-specific-id>例如在 id:docs-search:doc::hybrid-search 中,docs-search 是用于逻辑归类的命名空间(Namespace),中间的 doc 必须严格等于 Schema 文件中声明的 document doc 类型名,双冒号后面的 hybrid-search 则是业务系统自己的主键 ID。
为了在本地立即跑通 384 维向量检索与混合排序,我们在 docs-search/ 目录下用一段 Python 脚本生成 4 条测试文档并保存为 documents.jsonl(脚本使用正弦函数依据固定 seed 生成确定性的 384 维测试向量,实际生产中替换为调用句向量模型即可):
python3 - <<'PY' > documents.jsonl
import json
import math

docs = [
    {
        "id": "vespa-basics",
        "title": "Vespa application package basics",
        "body": "Learn how services.xml, schema, document fields and rank profiles work together in Vespa.",
        "url": "https://docs.vespa.ai/en/basics/",
        "tags": ["vespa", "schema", "beginner"],
        "published_at": 1760000000,
        "seed": 1,
    },
    {
        "id": "hybrid-search",
        "title": "Hybrid search with BM25 and vector retrieval",
        "body": "Hybrid search combines lexical retrieval, vector nearest neighbor search and ranking profiles.",
        "url": "https://docs.vespa.ai/en/learn/tutorials/hybrid-search.html",
        "tags": ["vespa", "hybrid-search", "vector-search"],
        "published_at": 1760000100,
        "seed": 2,
    },
    {
        "id": "rag-backend",
        "title": "Vespa as a retrieval backend for RAG",
        "body": "A RAG backend stores chunks, filters by metadata, retrieves candidates and ranks evidence.",
        "url": "https://docs.vespa.ai/en/rag/",
        "tags": ["rag", "retrieval", "ranking"],
        "published_at": 1760000200,
        "seed": 3,
    },
    {
        "id": "recommendation-serving",
        "title": "Real time recommendation serving",
        "body": "Recommendation systems need candidate generation, filtering, ranking and real time feature updates.",
        "url": "https://vespa.ai/",
        "tags": ["recommendation", "serving", "ranking"],
        "published_at": 1760000300,
        "seed": 4,
    },
]

def embedding(seed, dim=384):
    values = []
    for i in range(dim):
        values.append(round(math.sin(seed * 0.17 + i * 0.013), 6))
    return values

for d in docs:
    fields = {
        "id": d["id"],
        "title": d["title"],
        "body": d["body"],
        "url": d["url"],
        "tags": d["tags"],
        "published_at": d["published_at"],
        "embedding": embedding(d["seed"]),
    }
    print(json.dumps({
        "put": f"id:docs-search:doc::{d['id']}",
        "fields": fields,
    }))
PY
4.2 部署应用、批量 Feed 与局部字段实时更新(CRUD)
确认当前目录下已有 services.xml、schemas/doc.sd 和 documents.jsonl 后,执行部署与高速批量写入:
vespa config set target local
vespa deploy
vespa feed documents.jsonl
写入完成后,先跑一条全量匹配查询验证端到端数据链路:
vespa query 'yql=select * from doc where true limit 3'看到返回的 JSON 中 root.fields.totalCount 为 4,且 root.children 数组包含了文档的 fields 摘要,说明集群已经正常运转:
{
  "root": {
    "id": "toplevel",
    "relevance": 1.0,
    "fields": {
      "totalCount": 4
    },
    "children": [
      {
        "id": "id:docs-search:doc::vespa-basics",
        "relevance": 0.0,
        "source": "docs",
        "fields": {
          "id": "vespa-basics",
          "title": "Vespa application package basics"
        }
      }
    ]
  }
}
除了用 vespa feed 批量写入 put 操作外,借助 services.xml 中开启的 <document-api />,我们还可以随时对单条文档执行读取(get)、内存级局部更新(update)与删除(remove)。例如,当某篇文档新增了一个标签或更新了发布时间戳时,根本不需要重新传输正文和 384 维向量,直接向 /document/v1/<namespace>/<doc-type>/docid/<id> 发送 assign 或 add 指令即可原地修改内存 attribute:
# 1. 按 Document ID 直接读取单条文档完整内容
vespa document get id:docs-search:doc::hybrid-search

# 2. 局部更新 (Partial Update):仅向 tags 数组追加一个新标签,不触碰正文与向量索引
curl -X PUT -H "Content-Type: application/json" \
  --data '{"fields": {"tags": {"add": ["production"]}}}' \
  http://localhost:8080/document/v1/docs-search/doc/docid/hybrid-search
5. YQL 检索语法、BM25 打分与结构化分面聚合
5.1 YQL 的核心边界:把“选候选”和“算排序”彻底分开
很多从 SQL 转过来的开发者容易习惯性地把所有排序逻辑都写成 ORDER BY。但在 Vespa 中,必须建立一条清晰的工程铁律:YQL 的 where 子句只负责把符合条件的文档召回进候选池(Retrieval & Filtering),至于候选池里的文档谁排第一、谁排第二,交给 rank-profile 决定(Ranking)。
下面这组命令展示了 YQL 在投影、全文检索、结构化数组/数值过滤以及组合查询上的核心用法:
# 1. 字段投影:只拉取 id、title、url 三个字段,省去传输大段 body
vespa query 'yql=select id,title,url from doc where true limit 2'

# 2. 默认全文检索:userQuery() 解析外部 query 参数,并在 default fieldset (title, body) 上匹配
vespa query \
  'yql=select id,title,url from doc where userQuery() limit 5' \
  'query=hybrid search'

# 3. 单字段词项包含:指定只在 title 字段中匹配词项 "Vespa"
vespa query \
  'yql=select id,title,url from doc where title contains "Vespa" limit 5'

# 4. 结构化数组过滤:匹配 tags 属性数组中包含 "vector-search" 的文档
vespa query \
  'yql=select id,title,tags from doc where tags contains "vector-search" limit 5'

# 5. 数值范围过滤 + 属性硬排序:利用 fast-search 属性筛选时间戳并按时间倒序排列
vespa query \
  'yql=select id,title,published_at from doc where published_at > 1760000000 order by published_at desc limit 10'

# 6. 结构化过滤与 BM25 全文检索联合召回
vespa query \
  'yql=select id,title,tags from doc where tags contains "vespa" and userQuery() limit 10' \
  'query=rank profile' \
  'ranking=bm25'
在真实的电商或文档中心页面上,除了展示中间的搜索结果列表,往往还需要在左侧边栏渲染“按标签统计命中数”的分面导航(Faceting,如 vespa (3)、ranking (2))。在 Vespa 中无需发起第二次查询,直接在 YQL 末尾通过管道符 | 接上 Grouping 聚合表达式,就能在单次扫描中同时拿到命中文档和标签计数:
vespa query \
  'yql=select id,title from doc where true limit 2 | all(group(tags) each(output(count())))'
5.2 BM25 词面相关性与 match-features 白盒验证
当我们在查询中传入 ranking=bm25 并附带 ranking.listFeatures=true 时,Vespa 不仅会按 bm25(title) + bm25(body) 计算总分,还会把 match-features 中声明的每个子项得分随文档一并吐出:
vespa query \
  'yql=select id,title,url from doc where userQuery() limit 5' \
  'query=hybrid search tutorial' \
  'ranking=bm25' \
  'ranking.listFeatures=true'
观察返回 JSON 中的 matchfeatures 块,你可以清楚看到某篇文档排在第一究竟是因为标题命中了高 IDF 词项(bm25(title) 高),还是因为正文反复提及了关键词(bm25(body) 高)。
BM25 的优势是词面匹配精准、零推理开销且完全白盒可解释,对专有名词、错误码、函数名和产品型号极其敏锐;但它的软肋在于词汇鸿沟(Lexical Gap)——当用户搜索 "semantic retrieval",而文档里写的是 "vector nearest neighbor" 时,由于两边没有共同词项,纯 BM25 的得分为 0。要跨越这道鸿沟,就必须引入稠密向量检索。
6. 向量近邻(HNSW)与 Hybrid Search 混合检索
6.1 HNSW 图索引参数与距离度量权衡
回顾 doc.sd 中 embedding 字段的定义,Vespa 将向量表示为固定维度的稠密张量 tensor<float>(x[384]),并在内存属性之上构建了 HNSW(Hierarchical Navigable Small World)多层近邻图索引:
| HNSW 与向量配置项 | 物理机制说明 | 线上性能与内存权衡 |
|---|---|---|
distance-metric: angular | 余弦/角度距离度量;若向量在写入前已做过单位长度归一化,生产上更推荐改用 prenormalized-angular(直接蜕化为极速内积运算) | 省去每次距离计算时的平方根归一化开销,显著降低 CPU 消耗 |
max-links-per-node: 16 | HNSW 图中每个节点在每层最多维护的邻居边数(即参数 ) | 调大(如 32)可提升高维复杂分布下的召回率,但图索引常驻内存与写入耗时线性增长 |
neighbors-to-explore-at-insert: 100 | 插入新文档向量时动态搜索候选邻居的队列宽度(即参数 ) | 调大(如 200)能建出质量更高的导航图,代价是文档写入(Feed)吞吐下降 |
6.2 nearestNeighbor 查询与“三处张量名对齐”铁律
我们先用 Python 生成一个与第 2 条测试文档(seed=2,即 hybrid-search)同分布的 384 维查询向量,存入 query-vector.txt:
python3 - <<'PY' > query-vector.txt
import math
values = [round(math.sin(2 * 0.17 + i * 0.013), 6) for i in range(384)]
print("[" + ",".join(map(str, values)) + "]")
PY
随后调用 YQL 的 nearestNeighbor(field, query_tensor) 算子执行向量近邻搜索,并指定使用 compact 轻量摘要返回:
vespa query \
  'yql=select * from doc where {targetHits:10}nearestNeighbor(embedding, q)' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=semantic' \
  'presentation.summary=compact' \
  'hits=5'
在编写向量查询时,新手十有八九会栽在 missing query tensor 报错上。请务必牢记:YQL、请求参数、Schema 排序配置三处的查询张量名字(此处为 q)与维度必须严丝合缝对齐:
1. Schema (doc.sd)         : rank-profile semantic { inputs { query(q) tensor<float>(x[384]) } }
                                                                   │
2. YQL (where 子句)         : ... where {targetHits:10}nearestNeighbor(embedding, q)
                                                                                 │
3. HTTP / CLI 请求参数       : input.query(q)=[0.333, 0.345, ...]  <───────────────┘
同时,这里有两个极易混淆的数量参数必须区分清楚:
{targetHits: 10}(单分片向量召回预算):这是传给底层 HNSW 图搜索算子的注解,意思是要求每个内容节点从 HNSW 图里找出至少 10 个最近邻文档送入first-phase排序池;hits=5或limit 5(最终返回条数):这是经历完所有阶段排序并跨分片归并后,最终打包进 HTTP 响应返回给客户端的文档数量。
当需要在向量近邻搜索上叠加结构化过滤时,直接用 and 连接即可。Vespa 会先评估过滤条件的命中比例:如果满足 tags contains "rag" 的文档很少,直接对这批文档算精确向量距离;如果满足条件的文档较多,则在遍历 HNSW 图的过程中动态检查过滤位图,彻底避免了“先找 Top-10 向量再过滤导致结果为空”的窘境:
vespa query \
  'yql=select * from doc where tags contains "rag" and ({targetHits:20}nearestNeighbor(embedding, q))' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=semantic' \
  'hits=5'
6.3 Hybrid Search:词面与语义的双路召回与尺度陷阱
把 BM25 和向量检索合二为一,就是生产级检索系统最核心的混合检索(Hybrid Search)。在 Vespa 中,只需在 YQL 里用 or 将 userQuery() 与 nearestNeighbor() 并联起来,两路命中的文档就会自动取并集进入同一个 hybrid 排序流水线:
vespa query \
  'yql=select id,title,url from doc where userQuery() or ({targetHits:20}nearestNeighbor(embedding, q))' \
  'query=hybrid search tutorial' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=hybrid' \
  'ranking.listFeatures=true' \
  'hits=5'
看返回的 matchfeatures,你会立即发现一个关键的工程问题:为什么不能在生产环境里无脑把 bm25 和 closeness 直接相加?
因为两者的数学量纲完全不同:
closeness(field, embedding)的定义为 ,其取值严格有界,永远落在 区间内(角度距离下通常集中在 之间);bm25(title) + bm25(body)则是无上界的非负实数,当查询包含多个生僻词且同时命中标题和正文时,BM25 总分轻松飙到 分;而当查询只做语义改写、词面零命中时,BM25 得分为 。
如果你直接写 bm25(title) + bm25(body) + 0.5 * closeness(field, embedding),只要词面碰巧擦中一两个词,十几分的 BM25 就会把最大只有 分的向量相似度彻底淹没!为了解决跨路特征的尺度对齐问题,下一节我们就来看 Vespa 的多阶段排序与全局归一化机制。
7. 多阶段排序(Phased Ranking)、特征归一化与性能调优
7.1 first-phase → second-phase → global-phase 三级火箭
为什么 Vespa 要把排序拆成三个阶段?算一笔账就明白了:假设一个内容节点上有 1,000 万篇文档,一次混合查询初步匹配到了 50,000 个候选文档。
- 如果对这 50,000 个候选文档全都跑一遍复杂的 GBDT 树模型或神经网络,单次查询的 CPU 时间就会突破数秒;
- 反过来,如果先用极低成本的基础算子(如预计算的 BM25 + 向量距离)在 5 毫秒内给 50,000 个候选快速排个名(
first-phase),只挑出得分最高的前 100 名(rerank-count: 100)送入second-phase跑复杂特征交叉与业务衰减函数,最后再把各分片汇总后的前 20 名送入容器层的global-phase做跨文档分数归一化(如normalize_linear或reciprocal_rank),就能用 1% 的算力开销拿到 99% 的精排质量!
下面这段进阶 rank-profile 展示了如何在 doc.sd 中综合运用自定义函数(function)、新鲜度实时衰减、两阶段排序以及 global-phase 倒数排名融合(RRF):
rank-profile hybrid-production inherits semantic {
  function age_days() {
    expression: max(0, (now() - attribute(published_at)) / 86400)
  }

  function freshness_score() {
    expression: exp(-age_days / 30.0)
  }

  function lexical_score() {
    expression: bm25(title) * 2.0 + bm25(body)
  }

  first-phase {
    expression: lexical_score + 10.0 * closeness(field, embedding)
  }

  second-phase {
    rerank-count: 100
    expression: firstPhase + 2.0 * freshness_score
  }

  global-phase {
    rerank-count: 20
    expression {
      reciprocal_rank(lexical_score, 60) +
      reciprocal_rank(closeness(field, embedding), 60) +
      0.1 * freshness_score
    }
  }

  match-features {
    bm25(title)
    bm25(body)
    lexical_score
    closeness(field, embedding)
    age_days
    freshness_score
    firstPhase
  }
}
看看这段配置里的精妙之处:在 global-phase 中,内置算子 reciprocal_rank(feature, k) 会自动根据当前 Top-20 候选在该特征上的相对名次 计算 (常取 )。这样一来,不管 lexical_score 是 30 分还是 3 分,也不管向量用的是余弦距离还是内积,它们在 global-phase 里都被转换成了量纲完全一致的名次得分,彻底解决了混合检索的分值支配难题!
7.2 响应结构拆解与 tracelevel 执行计划剖析
当你需要排查线上慢查询或相关性异常时,读懂 Vespa 返回 JSON 的顶层诊断字段至关重要:
| 返回 JSON 核心路径 | 诊断价值与工程含义 |
|---|---|
root.fields.totalCount | 匹配 YQL where 条件的候选文档总数 |
root.coverage | 查询健康度风向标:包含 coverage(覆盖百分比)与 degraded 原因;若出现 timeout 或 match-phase 降级,说明某分片负载过高未能扫完全部候选 |
root.children[].relevance | 当前命中文档经过最高阶段排序(如 global-phase)后的最终得分 |
root.children[].fields.matchfeatures | 开启 ranking.listFeatures=true 后输出的各子特征真值,用于复盘排序名次 |
如果发现某条查询耗时偏高,可以在请求时临时加上 tracelevel=2(注意仅在排障时按需开启,避免线上全量打印):
vespa query \
  'yql=select * from doc where userQuery() limit 3' \
  'query=vespa schema' \
  'tracelevel=2'
在返回的 trace 树中,你可以精确看到查询在 Container 层的解析耗时、向 Content 节点扇出的网络往返时间、各分片执行匹配与 first-phase / second-phase 排序的毫秒数,以及最后一步读取 summary 摘要的耗时。
7.3 性能与质量调优的八个黄金旋钮
在将 Vespa 推向高并发生产环境前,建议优先围绕以下八个第一层旋钮建立压测基线(观测 targetHits -> P99 延迟、targetHits -> NDCG@10 与 Summary 体积 -> 吞吐 三条曲线):
| 调优旋钮 | 作用阶段 | 性能与质量权衡指南 |
|---|---|---|
targetHits | 向量近邻召回 | 决定每个分片送入粗排的 ANN 候选数;通常设在 50 ~ 200 即可,盲目设上千会导致距离计算与粗排耗时陡增而质量边际收益极小 |
HNSW max-links-per-node | 向量索引构建与遍历 | 默认 16;若高维向量召回率不达标可升至 24 ~ 32,但需预留充足内存 |
attribute: fast-search | 结构化条件过滤 | 凡是出现在 where 子句中的高基数过滤字段(如 tenant_id、published_at)务必开启,消除全表内存扫描 |
first-phase 复杂度 | 全量候选粗排 | 严禁在 first-phase 放重型张量矩阵乘或深度模型,只放 BM25、基础 closeness 和简单属性加权 |
second-phase rerank-count | 分片内精排 | 控制单分片跑精排模型的文档数(常取 50 ~ 200),是在线 CPU 水位的总阀门 |
global-phase rerank-count | 容器层全局重排 | 控制跨分片归一化或 Cross-Encoder 的文档数(常取 20 ~ 50) |
document-summary 粒度 | 最终摘要填充 | 为列表页、RAG 引用上下文、详情页分别定义专属的轻量 document-summary,绝不在列表查询里拉取原始向量和长篇全文 |
match-features 开关 | 结果打包 | 离线评估与线上抽样 Debug 时开启 ranking.listFeatures=true,正常生产流量默认关闭以节省序列化带宽 |
8. 从教程示例演进到生产级 RAG 与推荐系统后端
8.1 企业级多租户 RAG Chunk Schema 实战
为什么说 Vespa 极其适合做企业级 RAG 的检索底座?
因为在真实的 ToB 知识库问答中,存入系统的往往是切分自数百万份 PDF、Wiki 和工单的海量文档分片(Chunks)。每一次用户提问,检索后端必须在几十毫秒内同时搞定五件事:
- 多租户与 ACL 权限硬隔离(绝不能把 A 公司的财报 Chunk 召回给 B 公司员工,否则送进 LLM 就会酿成越权泄密);
- 多粒度词法召回(同时匹配文档大标题
title、小节标题section与分片正文text的 BM25,确保精确型号与错误码不漏); - 语义向量近邻召回(捕捉自然语言同义提问);
- 融合文档时效性(
updated_at)与多路信号重排; - 精准返回带溯源链接(
source_uri)的证据摘要供 LLM 生成角标引用。
我们可以直接将前面的 doc.sd 扩展为如下开箱即用的生产级 schemas/chunk.sd:
schema chunk {
  document chunk {
    field chunk_id type string {
      indexing: attribute | summary
      match: word
    }

    field doc_id type string {
      indexing: attribute | summary
      match: word
      attribute: fast-search
    }

    field source_uri type string {
      indexing: attribute | summary
      match: word
    }

    field title type string {
      indexing: index | summary
      match: text
      index: enable-bm25
    }

    field section type string {
      indexing: index | summary
      match: text
      index: enable-bm25
    }

    field text type string {
      indexing: index | summary
      match: text
      index: enable-bm25
    }

    field tenant_id type string {
      indexing: attribute | summary
      match: word
      attribute: fast-search
    }

    field language type string {
      indexing: attribute | summary
      match: word
      attribute: fast-search
    }

    field updated_at type long {
      indexing: attribute | summary
      attribute: fast-search
    }

    field embedding type tensor<float>(x[384]) {
      indexing: attribute | index
      attribute {
        distance-metric: prenormalized-angular
      }
      index {
        hnsw {
          max-links-per-node: 16
          neighbors-to-explore-at-insert: 100
        }
      }
    }
  }

  fieldset default {
    fields: title, section, text
  }

  document-summary citation {
    summary chunk_id {}
    summary doc_id {}
    summary source_uri {}
    summary title {}
    summary section {}
    summary text {}
    summary updated_at {}
  }

  rank-profile rag-hybrid {
    inputs {
      query(q) tensor<float>(x[384])
    }
    function lexical() {
      expression: 2.0 * bm25(title) + 1.5 * bm25(section) + bm25(text)
    }
    first-phase {
      expression: lexical + 10.0 * closeness(field, embedding)
    }
    global-phase {
      rerank-count: 24
      expression: reciprocal_rank(lexical, 60) + reciprocal_rank(closeness(field, embedding), 60)
    }
    match-features {
      bm25(title)
      bm25(section)
      bm25(text)
      closeness(field, embedding)
    }
  }
}
有了这份 chunk Schema,上游 RAG 编排服务(无论用 LangChain、LlamaIndex 还是自研网关)只需要发一条查询,就能在单次网络往返中拿到经过租户隔离、双路召回与 RRF 重排后的 Top-8 引用片段(按 citation 摘要自动剥离掉庞大的 embedding 字段),直接拼进 Prompt 喂给大模型:
vespa query \
  'yql=select * from chunk where tenant_id contains "acme" and language contains "zh" and (userQuery() or ({targetHits:50}nearestNeighbor(embedding, q)))' \
  'query=Vespa 如何配置多阶段排序' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=rag-hybrid' \
  'presentation.summary=citation' \
  'hits=8'
8.2 推荐系统在线召回与实时特征服务落点
同样的“计算向数据靠拢”架构,也可以无缝迁移到实时推荐系统中:
| 推荐系统在线模块 | 在 Vespa 中的原生实现方式 |
|---|---|
| 双塔召回(Two-Tower Retrieval) | 物品侧向量(Item Tower Embedding)存入文档 tensor 字段并建 HNSW 索引;用户侧实时向量(User Tower Embedding)随请求 input.query(user_emb) 传入,通过 nearestNeighbor 毫秒级召回候选集 |
| 高频实时特征更新 | 物品的实时曝光量、点击率(CTR)、库存状态定义为内存 attribute 字段,通过流处理管线高频发送 Partial Update 原地刷新,无需重建双塔向量索引 |
| 粗排与精排模型推理 | 将双塔内积、用户-物品交叉特征写入 first-phase,将导出的 ONNX 神经网络或 GBDT/XGBoost 模型挂载到 second-phase 在内容节点本地推理 |
| 作者/类目多样性打散 | 利用 YQL 的 Grouping 语法(如 all(group(category) max(5) each(max(2) each(output(summary())))))在单次查询内强制限制同一类目或同一作者的曝光上限 |
9. 部署选型、故障排错手册与完整命令回放
9.1 本地 Docker、Vespa Cloud 与自托管选型
当应用从个人笔记本走向生产环境时,三种主流部署形态的工程权衡如下:
| 部署方式 | 适用阶段与团队画像 | 核心收益 | 运维与工程成本 |
|---|---|---|---|
| 本地 Docker 单容器 | 本地开发、Schema 调试、CI 集成测试 | 启动极快、零外部依赖、支持完整功能验证 | 单点无冗余,不可直接用于承载生产流量 |
| Vespa Cloud(官方托管) | 追求快速上线、希望省去底层运维的中小团队或核心业务 | 自动管理多节点分片、滚动升级、证书安全与自动扩缩容 | 按节点资源计费,需配合云端租户与证书体系 |
| Kubernetes / 裸金属自托管 | 有专职基础设施团队、对数据合规驻留与硬件成本有强管控诉求 | 100% 自主可控,可针对 NVMe 与大内存机型深度定制 | 需自行维护 Config Server 集群高可用、容量规划、监控告警与版本升级 |
9.2 高频故障速查表与五步黄金排障法
日常开发中遇到报错或查询结果异常时,可对照下表直接定位根因:
| 故障现象 | 根因定位 | 修复方案 |
|---|---|---|
vespa status 报错或部署卡死退出 | Docker 守护进程未启动、端口 8080/19071 冲突或容器内存不足 4 GB | 检查 docker ps 与 docker logs vespa,调大 Docker 内存配额并清理旧容器 docker rm -f vespa |
vespa deploy 提示找不到应用文件 | 执行命令时不在包含 services.xml 的根目录 | 切换至 docs-search/ 目录后再执行 vespa deploy |
写入或查询报 document type 不存在 | services.xml、Schema 文件名与 Document ID 三处的类型名不一致 | 确保 <document type="doc">、schema doc 与 id:ns:doc::xxx 中的类型名完全一致 |
查询命中了文档,但 fields 里缺少某字段 | 该字段在 Schema 中未声明 summary,或当前查询指定了不含它的 document-summary | 在字段定义中补上 indexing: ... | summary 并重新部署 |
使用 bm25(field) 时部署失败或恒得 0 分 | 文本字段漏写了 indexing: index 或漏开了 index: enable-bm25 | 为该文本字段补齐 indexing: index | summary 与 index: enable-bm25 |
| 向量写入或查询报 Tensor 维度/格式错误 | 写入数组长度、Query 向量长度与 Schema x[384] 不一致 | 严格校验生成脚本,确保每一条向量恰好包含 384 个浮点数 |
nearestNeighbor 报 Expected 'query(q)' | YQL、CLI 参数与 rank-profile inputs 三处的张量名未对齐 | 核对 nearestNeighbor(embedding, q)、input.query(q) 与 inputs { query(q) ... } |
| Hybrid 排序完全被 BM25 词面分统治 | 未做分值缩放或跨路归一化,无界 BM25 淹没了 区间的 closeness | 开启 ranking.listFeatures=true 观察分值区间,调整权重或引入 global-phase reciprocal_rank |
任何时候遇到“查不出结果”或“排序不对劲”,请严格沿着下面这条五步黄金排障流水线自底向上排查,切忌在底层尚未确认打通时盲目乱改排序权重:
Step 1 [查容器状态] : docker ps + vespa status ──> 确认 8080 与 19071 端口绿灯就绪
Step 2 [查部署生效] : vespa deploy ──> 确认 services.xml 与 doc.sd 通过静态语法与类型校验
Step 3 [查全量写入] : vespa feed + select * from doc where true ──> 确认 totalCount > 0 且 summary 字段完整
Step 4 [查单路召回] : 先单独跑通 BM25 (userQuery),再单独跑通向量近邻 (nearestNeighbor)
Step 5 [查混合特征] : 合并 or 查询 + ranking.listFeatures=true ──> 对照 matchfeatures 核验每一项子特征得分
9.3 从零跑通的完整命令回放与核心术语表
将前文所有步骤串联起来,下面是一套可在 3 分钟内从零跑通本地 Vespa 混合检索应用的完整命令清单(生成 documents.jsonl 与 query-vector.txt 的内联 Python 脚本分别见第 4.1 节与第 6.2 节):
# 1. 拉取并启动本地 Vespa 容器
docker pull vespaengine/vespa
docker run --detach --name vespa --hostname vespa-container \
  --publish 8080:8080 --publish 19071:19071 \
  vespaengine/vespa

# 2. 创建工程目录并写入 services.xml、schemas/doc.sd 与测试数据
mkdir -p docs-search/schemas
cd docs-search
# (在此写入第 2.2 节的 services.xml、第 3.1 节的 schemas/doc.sd,并运行第 4.1 节与第 6.2 节的 Python 脚本)

# 3. 部署应用包并批量写入文档
vespa config set target local
vespa deploy
vespa feed documents.jsonl

# 4. 验证全量连通性与 BM25 词法检索
vespa query 'yql=select * from doc where true limit 3'
vespa query \
  'yql=select id,title,url from doc where userQuery() limit 5' \
  'query=hybrid search tutorial' \
  'ranking=bm25'

# 5. 验证 HNSW 向量近邻检索
vespa query \
  'yql=select id,title,url from doc where {targetHits:10}nearestNeighbor(embedding, q)' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=semantic' \
  'hits=5'

# 6. 验证 Hybrid Search 混合检索与白盒特征输出
vespa query \
  'yql=select id,title,url from doc where userQuery() or ({targetHits:20}nearestNeighbor(embedding, q))' \
  'query=hybrid search tutorial' \
  "input.query(q)=$(cat query-vector.txt)" \
  'ranking=hybrid' \
  'ranking.listFeatures=true' \
  'hits=5'
最后,将 Vespa 日常开发中高频出现的核心术语汇总如下,供随时查阅:
| 核心术语 | 物理本质与一句话速记 |
|---|---|
| Application Package | 定义 Vespa 集群拓扑、Schema 与排序模型的完整声明式配置包 |
index / attribute / summary | 字段的三种物理存储形态:倒排或 HNSW 图索引(用于检索)、内存列式正排(用于过滤/排序/局部更新)、磁盘压缩摘要(用于结果返回) |
attribute: fast-search | 为内存属性额外构建 B-Tree 与位图索引,把 where 过滤从线性扫描加速为对数级查找 |
| Fieldset | 将多个文本字段(如 title, body)编组,作为 userQuery() 的默认全文搜索范围 |
| YQL | Vespa 查询语言,专门负责声明“按什么布尔、词法或向量条件把文档选进候选池” |
targetHits vs hits | targetHits 是单分片 HNSW 算子捞取的候选预算;hits 是跨分片归并排序后最终返回给客户端的条数 |
| Rank Profile | 排序流水线配置,定义输入张量、自定义函数、first-phase / second-phase / global-phase 与调试特征 |
match-features | 随每条命中结果返回的排序子项真值字典,是排查线上排序原因的显微镜 |
10. 总结:把四句话刻进检索工程直觉
回看 Vespa 的整套设计,你会发现它表面上是一套包含 XML、Schema DSL 和 YQL 的配置体系,底层却处处闪耀着分布式系统与信息检索的硬核工程智慧:为了消灭跨服务搬运候选集的网络开销,它坚持让计算向有状态内容节点靠拢;为了平衡精度与算力,它用三阶段级联漏斗把昂贵算子锁在极小候选集内;为了兼顾实时性与多模态检索,它在同一套内存引擎里打通了倒排、HNSW 图与列式属性。
在实际工程中,只要把下面这四句话刻进直觉,就能游刃有余地驾驭 Vespa:
Schema 决定字段以什么物理结构驻留内存与磁盘(index / attribute / summary)
YQL 决定哪些文档有资格进入候选池(userQuery / nearestNeighbor / filter)
Rank-Profile 决定候选文档如何在数据原地分阶段算分排序(first / second / global phase)
Summary 决定最终胜出的 Top-K 文档裁剪哪些字段返回客户端
参考资料
- Vespa.ai Official Website & Vespa AI Search Platform Architecture
- Vespa Documentation & Vespa Basics
- Hybrid Text Search Tutorial
- News Search and Recommendation Tutorial
- Vespa CLI Documentation
- Approximate Nearest Neighbor Search using HNSW & Nearest Neighbor Search Guide
- Schemas Reference、YQL Query Language & Phased Ranking
comments