当推荐系统的服务规模膨胀至十亿级活跃用户与数以百万计的动态视频库时,传统协同过滤与浅层点击率(CTR)预测模型会同时撞上三堵高墙:全量打分的算力延迟墙、每秒海量新视频上传带来的非平稳时效墙,以及标题党(Clickbait)污染隐式点击反馈的噪声墙。2016 年,Google 团队的 Paul Covington、Jay Adams 与 Emre Sargin 在 ACM RecSys 发表了仅有 8 页的经典论文 Deep Neural Networks for YouTube Recommendations(ACM DOI、Google Research 页面、论文 PDF)。这篇论文之所以成为工业界推荐系统设计的分水岭,核心在于它跳出了单纯堆叠局部算子的学术视角,展示了一套将深度学习严丝合缝嵌入超大规模生产约束的系统工程范式:
user history and context
  -> candidate generation: millions -> hundreds
  -> ranking: hundreds -> dozens
  -> impression
  -> watch / no watch / watch time
  -> offline training + online A/B
穿透文中的网络结构图与离线实验曲线,可以将 YouTube DNN 的架构精髓提炼为四条核心设计哲学:
- 算力与特征的非对称漏斗解耦:在数十毫秒的在线响应上限内,用复杂交叉网络遍历百万级视频库在物理上不可行。系统必须切分为两个非对称阶段——候选生成(Candidate Generation,即召回)仅消费用户与上下文特征,将百万级语料库快速粗筛至百级候选;精排(Ranking)则在百级规模上引入高维度的“用户—候选视频—曝光上下文—召回通道”细粒度交叉特征,完成头部列表的精准校准。
- 离线分类训练与在线内积检索的数学同构:候选生成在离线训练时被形式化为极大规模多分类(Extreme Multiclass Classification),借助负采样交叉熵(Sampled Softmax)迫使用户表征向量 与常看视频向量 在内积空间靠拢;到了在线服务时,由于单次请求中 Softmax 分母配分函数对所有候选恒为正数常数,分类概率排序直接退化为无需计算分母的近似最近邻(ANN)最大内积检索。
- 时间因果边界与非平稳热度的显式对齐:拒绝随机留出(Random Holdout)造成的未来信息泄漏,坚持按时间轴回滚历史构造样本,甚至主动抹平紧邻搜索词的强序列结构,防止神经网络在代理任务上“走捷径”复刻搜索结果页;同时引入 Example Age 特征显式编码训练样本距当前时刻的时间跨度,消除滑动训练窗口的时间平均流行度偏置,在线服务时将该特征统一置零即可直接输出最新时刻的即时热度分布。
- 将商业目标内嵌于分类损失的几率变换:针对纯点击率目标易受标题党诱导的顽疾,精排网络在标准逻辑回归中将正样本按真实观看时长 加权,负样本保持单位权重;借助低点击率场景下加权几率的泰勒近似 ,在线推理仅需把顶层激活换为指数函数,便能直接输出单次曝光的预期观看时长(Expected Watch Time per Impression)。
下文将沿着“直觉痛点 → 数学与架构推演 → 工程边界与现代演进”的脉络,完整拆解这套支撑十亿级用户的深度学习推荐架构。
1. 工业推荐的三大核心挑战:Scale、Freshness、Noise
将 YouTube DNN 放入推荐系统的技术演进史中,可以清晰看到它在四条技术主线上的承前启后作用:
| 技术主线 | 论文发表前的主流范式 | 论文的核心突破与贡献 | 后续工业界演进方向 |
|---|---|---|---|
| 协同过滤表征 | 线性矩阵分解(MF)、WSABIE、成对排序损失 | 将深度候选生成定义为融合多源异构特征的非线性泛化协同过滤 | 双塔向量召回、DSSM 扩展、MIND/ComiRec 多兴趣召回 |
| 工业推荐架构 | 两阶段或多阶段漏斗已在内部使用,但公开文献缺乏端到端细节 | 完整公开从百万级语料到百级候选再到十级展示的双阶段漏斗与特征边界 | 多路召回融合、粗排(Pre-ranking)、精排、重排(Re-ranking)四级漏斗 |
| 优化目标设计 | 显式评分预测、点击率(CTR)二分类 | 指明 CTR 易受标题党诱导,提出基于加权逻辑回归直接逼近预期观看时长 | 多目标联合优化(MMoE/PLE)、长期用户留存、创作者生态与安全护栏 |
| 深度推荐工程 | 局部模块尝试小型神经网络 | 打通高基数 Embedding、Sampled Softmax 训练、离线向量导出与在线 ANN 检索全链路 | Wide & Deep、DeepFM、DIN/DIEN 序列注意力、生成式与大模型推荐 |
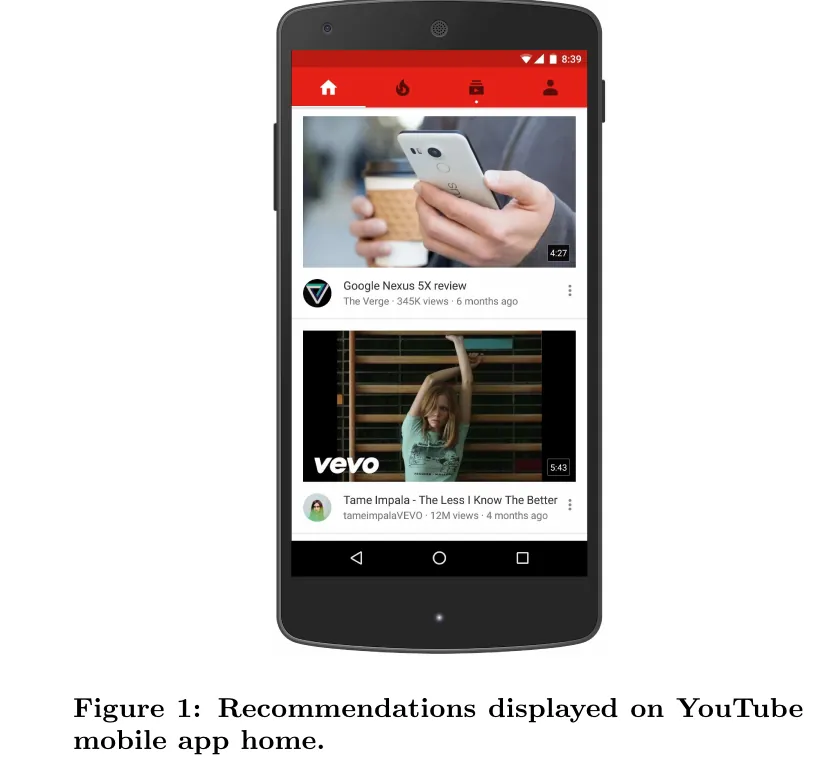
移动端首页(Home)的产品形态(见上图)直接界定了整个推荐系统的物理边界:系统需要在特定的请求时刻、移动屏幕视口、卡片排列位次与缩略图上下文中,为用户实时组装出一列视频,并依靠用户随后的点击与真实观看时长完成反馈闭环。论文开篇将 YouTube 推荐面临的工程挑战高度凝练为 规模(Scale)、时效性(Freshness)与 反馈噪声(Noise)三个维度。
1.1 Scale:十亿级用户与百万级视频库下的算力约束
YouTube 拥有十亿量级的活跃用户与数以百万计的在线视频库,每日产生千亿规模的用户行为样本。在这一量级下,要求精排模型在数十毫秒的在线响应预算内对全库百万个视频逐一计算复杂交叉特征在算力上完全不可行。系统必须通过两级漏斗分配算力预算:
large corpus: millions of videos
  -> cheap but personalized retrieval (Candidate Generation)
  -> hundreds of candidate videos
  -> expensive feature-rich scoring (Ranking)
-> dozens of displayed videos在这套分工体系中,候选生成阶段对召回覆盖率负责,精排阶段对头部列表的排序精度与业务目标校准负责。一旦候选生成阶段漏掉了用户真正感兴趣的视频,后续精排模型即便表达能力再强也无从挽回;反之,若试图在候选生成阶段塞入高开销的候选级实时交叉特征,则会立即击穿在线延迟红线。
1.2 Freshness:高频动态内容流的非平稳分布挑战
与曲库或电影库相对静态的推荐场景不同,YouTube 每秒都有海量新视频上传。用户对突发新闻、热点事件与创作者最新动态存在强烈的消费诉求,视频的流行度分布随时间剧烈演化。然而,深度模型的离线训练数据通常截取自过去数周或数月的滑动时间窗口;若不对时间维度做显式建模,神经网络自然倾向于拟合整个训练窗口内的时间平均流行度,从而系统性偏爱已经积累了大量历史观看的老视频,对刚上传或正处于爆发初期的新视频反应迟钝。论文为此提出了极为巧妙的 Example Age 特征:在训练期显式告知模型每条样本距离训练窗口末端的时长,在线服务时将该特征统一置为 (或微小的负数),直接引导模型输出“当前最新时刻”的即时热度分布。
1.3 Noise:隐式反馈的偏置与真实满意度鸿沟
在真实视频平台上,用户主动留下的显式点赞、点踩或满意度问卷极为稀疏,大规模模型训练只能依赖海量的隐式交互行为。然而,不同类型的用户反馈在数据丰度与噪声结构上存在显著差异:
| 反馈信号类型 | 数据可用性与规模 | 潜在偏差与噪声来源 |
|---|---|---|
| Click(点击) | 数量极庞大、实时性最高 | 极易受夸张标题党(Clickbait)、诱导性缩略图与屏幕误触污染 |
| Watch(完成一定观看) | 规模大、比单纯点击更贴近真实兴趣 | 受自动连播(Autoplay)、后台播放与默认列表位置影响 |
| Watch Time(观看时长) | 连续信号,能有效反映用户沉浸度(Engagement) | 天然偏爱长视频,且娱乐消遣类与工具教学类视频的合理时长基准不同 |
| Like / Dislike(赞踩) | 语义极明确 | 极度稀疏,且主动表达群体的行为分布存在幸存者偏差 |
| Survey(满意度问卷) | 最接近长期主观满意度 | 采集成本高昂、覆盖率极低,仅适合做离线校准与护栏评估 |
针对上述噪声特征,论文在两阶段采取了差异化的监督策略:在候选生成阶段以“用户实际完成了视频观看(Watch)”作为正样本标签,过滤单纯的误点噪声;在精排阶段则抛弃传统的点击率(CTR)目标,将每个正样本按其真实观看时长(Watch Time)加权,从根本上遏制靠标题党骗取点击却被用户迅速退出的低质视频。
2. 双阶段漏斗总体架构:候选生成与精排的职责解耦
下图描绘了 YouTube 推荐系统的端到端双阶段漏斗架构:
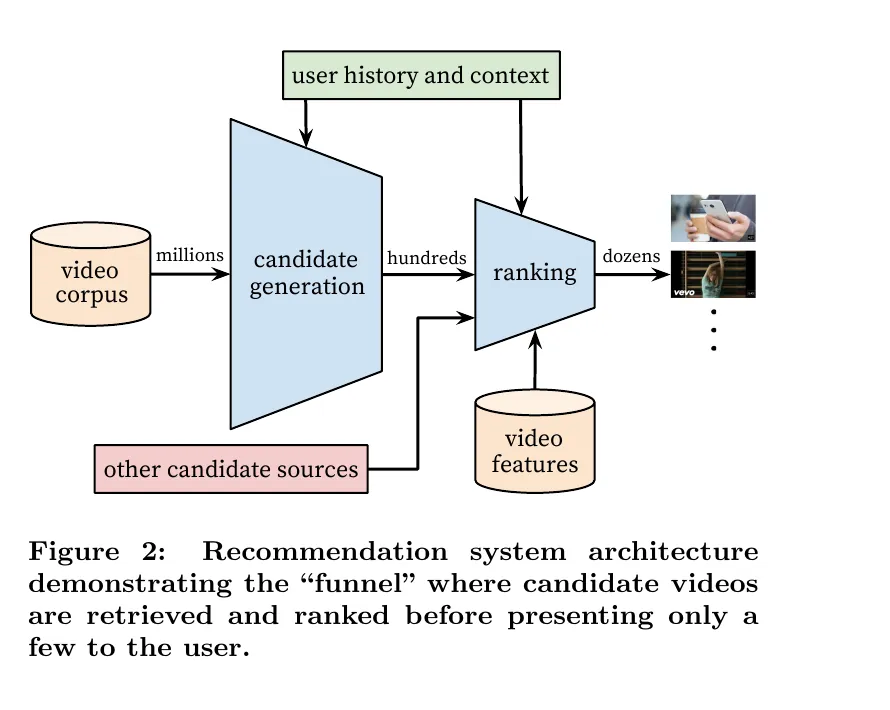
架构中六个核心模块的数据流转与工程职责归纳如下:
| 架构模块 | 输入信号 | 输出产物 | 系统角色定位 |
|---|---|---|---|
| Video Corpus | 全量在线可播放视频库 | 百万级(Millions)候选空间 | 底层检索语料池 |
| User History and Context | 历史观看序列、历史搜索词、地理区域、设备、人口统计学属性 | 用户侧多模态上下文特征 | 个性化意图来源 |
| Candidate Generation | 用户上下文表征 + 全量视频库输出向量 | 百级(Hundreds)高相关候选视频 | 低延迟粗粒度个性化召回 |
| Other Candidate Sources | 订阅频道更新、热门趋势、相似视频扩展、运营规则等 | 补充候选视频集合 | 多路召回融合(保障覆盖与新颖性) |
| Video Features | 候选视频细粒度属性、曝光历史统计、缩略图特征、用户-视频交叉关系 | 百级候选的高维排序特征向量 | 精排决策信号供给 |
| Ranking | 百级合并候选 + 丰富交叉与上下文特征 | 十级(Dozens)最终首页展示列表 | 精确校准预期观看时长与界面呈现 |
剖析这一双阶段漏斗,可以提炼出四条对现代工业推荐系统至关重要的工程准则:
- 召回与精排的评估体系各司其职:候选生成关注召回率(Recall@K)、平均精度均值(MAP)、候选多样性与数十毫秒内的检索延迟;精排则聚焦于具体曝光上下文下的预期观看时长、相对排序损失与 CPU 算力预算。
- 深度候选生成作为多路召回生态的主力一环协同运作:架构图中明确标出了
Other candidate sources,表明工业系统在深度向量召回之外,仍会并列保留订阅流、实时热点、同频道扩召与新内容探索等通道,共同汇入候选池以兼顾精确性与生态多样性。 - 跨阶段特征传递是精排校准的前提:由于不同召回通道(Source)产出的原始分数量纲与分布互不可比,精排网络除了接收候选视频本身的特征外,还显式将“哪些召回通道提名了该视频”以及“各通道给出的原始分数与排名”作为输入特征,由精排网络统一学习跨通道非线性校准。
- 线上 A/B 实验拥有最终一票否决权:离线的精确率、召回率与排序损失仅用于指导研究迭代方向;任何架构、特征或样本构造变更,最终都必须通过线上真实流量的长周期 A/B 测试(观测真实人均观看时长、会话深度与留存)裁定。
3. 候选生成形式化:极大规模多分类与 Sampled Softmax
3.1 直觉痛点与极大规模多分类建模
在深度学习进入推荐系统之前,主流召回方案大多基于矩阵分解(Matrix Factorization)或浅层线性模型(如 WSABIE),通过最小化用户向量与物品向量的平方误差或成对排序损失(Pairwise Ranking Loss)来学习内积空间。然而,浅层线性分解存在一个致命短板:它很难低成本地融入用户历史搜索词、人口统计学属性、地理位置、设备类型以及样本时间年龄等多源异构信号。
为了将协同过滤自然拓展为支持任意连续与离散特征的深度非线性模型,论文创造性地将推荐召回建模为极大规模多分类问题(Extreme Multiclass Classification):给定用户 及其在时刻 的上下文 ,模型需要在包含数百万个视频的语料库 中,预测用户在时刻 实际完成观看的视频类别 。在标准 Softmax 形式下,类别 的条件概率定义为:
其中 表示用户历史与上下文经深度神经网络编码后输出的 维稠密向量(User/Context Embedding), 表示第 个候选视频在 Softmax 输出层对应的类别权重向量(Output Video Embedding)。
这一建模方式实现了离线分类训练与在线向量检索的数学同构:
- 离线训练期:模型通过最小化真实观看视频类别 的交叉熵损失 ,迫使具有相似观看偏好的用户向量 与其常看的视频向量 在内积空间中相互靠拢。这在几何上构成了深度非线性的不对称矩阵分解。
- 在线服务期:单次请求中用户向量 实时计算后保持固定,而推荐召回仅关心候选视频的概率相对排序。此时分母上的全库配分函数 是一个与候选下标 无关的正数常数,且指数函数 严格单调递增。因此,寻找条件概率 最高的 Top- 视频,在数学上严格等价于在向量空间 中求解最大内积检索(Maximum Inner Product Search, MIPS):
3.2 训练加速:为什么弃用分层 Softmax 而选择候选负采样
在离线训练中,由于全集 的基数高达百万级,每次梯度更新都精确遍历分母 会带来难以承受的计算开销。早期自然语言处理中常使用分层 Softmax(Hierarchical Softmax),将百万类别组织成二叉树,把复杂度从 降至 。但论文实测发现分层 Softmax 在视频推荐中效果不佳:因为走树路径要求人工或启发式地将视频聚类到树节点上,树结构上相邻的节点往往把毫无关联的跨领域视频强行绑定在一起,导致中间节点分类语义混乱,严重拖累表征质量。
为此,论文转而采用候选负采样(Candidate Sampling / Sampled Softmax):对每条正样本,从预设背景分布 中随机采样数千个负例视频 ,仅在“1 个真实正类 + 数千个采样负类 ”的子集上计算交叉熵损失,并通过重要性加权(Importance Weighting,即在 Logit 上减去采样概率的对数 )修正采样分布与真实全集分布之间的偏差:
这一采样近似方案在保证收敛精度的同时,将百万级词表上的训练速度提升了 100 倍以上。需要特别注意这里的样本语义边界:候选生成阶段通过背景分布采出的数千个负类,仅用于近似 Softmax 归一化分母以撑开向量表征空间,它们属于未观测项(Unknown),并不代表用户真实看到并厌恶这些视频。
3.3 在线服务:近似最近邻检索与四级评估解耦
在线服务时,为了在数十毫秒(tens of milliseconds)的严苛延迟上限内从百万级视频向量 中检索出与实时计算的用户向量 内积最大的数百个候选,系统放弃了遍历精确打分,转而通过基于局部敏感哈希(LSH)或树/图索引的近似最近邻(ANN)服务完成次线性(sublinear)检索。
这种“训练用 Sampled Softmax 拟合分类概率、服务用 ANN 检索最大内积”的形态转换,要求工程上必须建立分层解耦的四级评估指标:
| 评估层级 | 核心观测指标 | 检验的工程目标 |
|---|---|---|
| 离线模型训练层 | Sampled Softmax 交叉熵损失、梯度范数、Embedding 模长与奇异值分布 | 监控网络收敛稳定性与向量空间是否发生坍缩 |
| 离线召回评测层 | 留出集 Recall@K、MAP@K、品类覆盖率、新上传视频召回占比 | 评估表征空间对未来真实观看视频的捕获能力 |
| 在线 ANN 服务层 | 检索 P99 延迟、QPS 吞吐、近似检索相对于精确暴力检索的 Recall 折损率 | 平衡在线算力延迟预算与向量量化/剪枝精度损失 |
| 线上产品 A/B 层 | 人均观看时长、有效点击率、会话深度、新视频消费占比与留存护栏 | 验证召回候选与后续精排模型配合后的真实产品收益 |
4. 候选生成网络架构:异构序列池化与塔式 ReLU
下图给出了候选生成深度神经网络的完整内部结构:
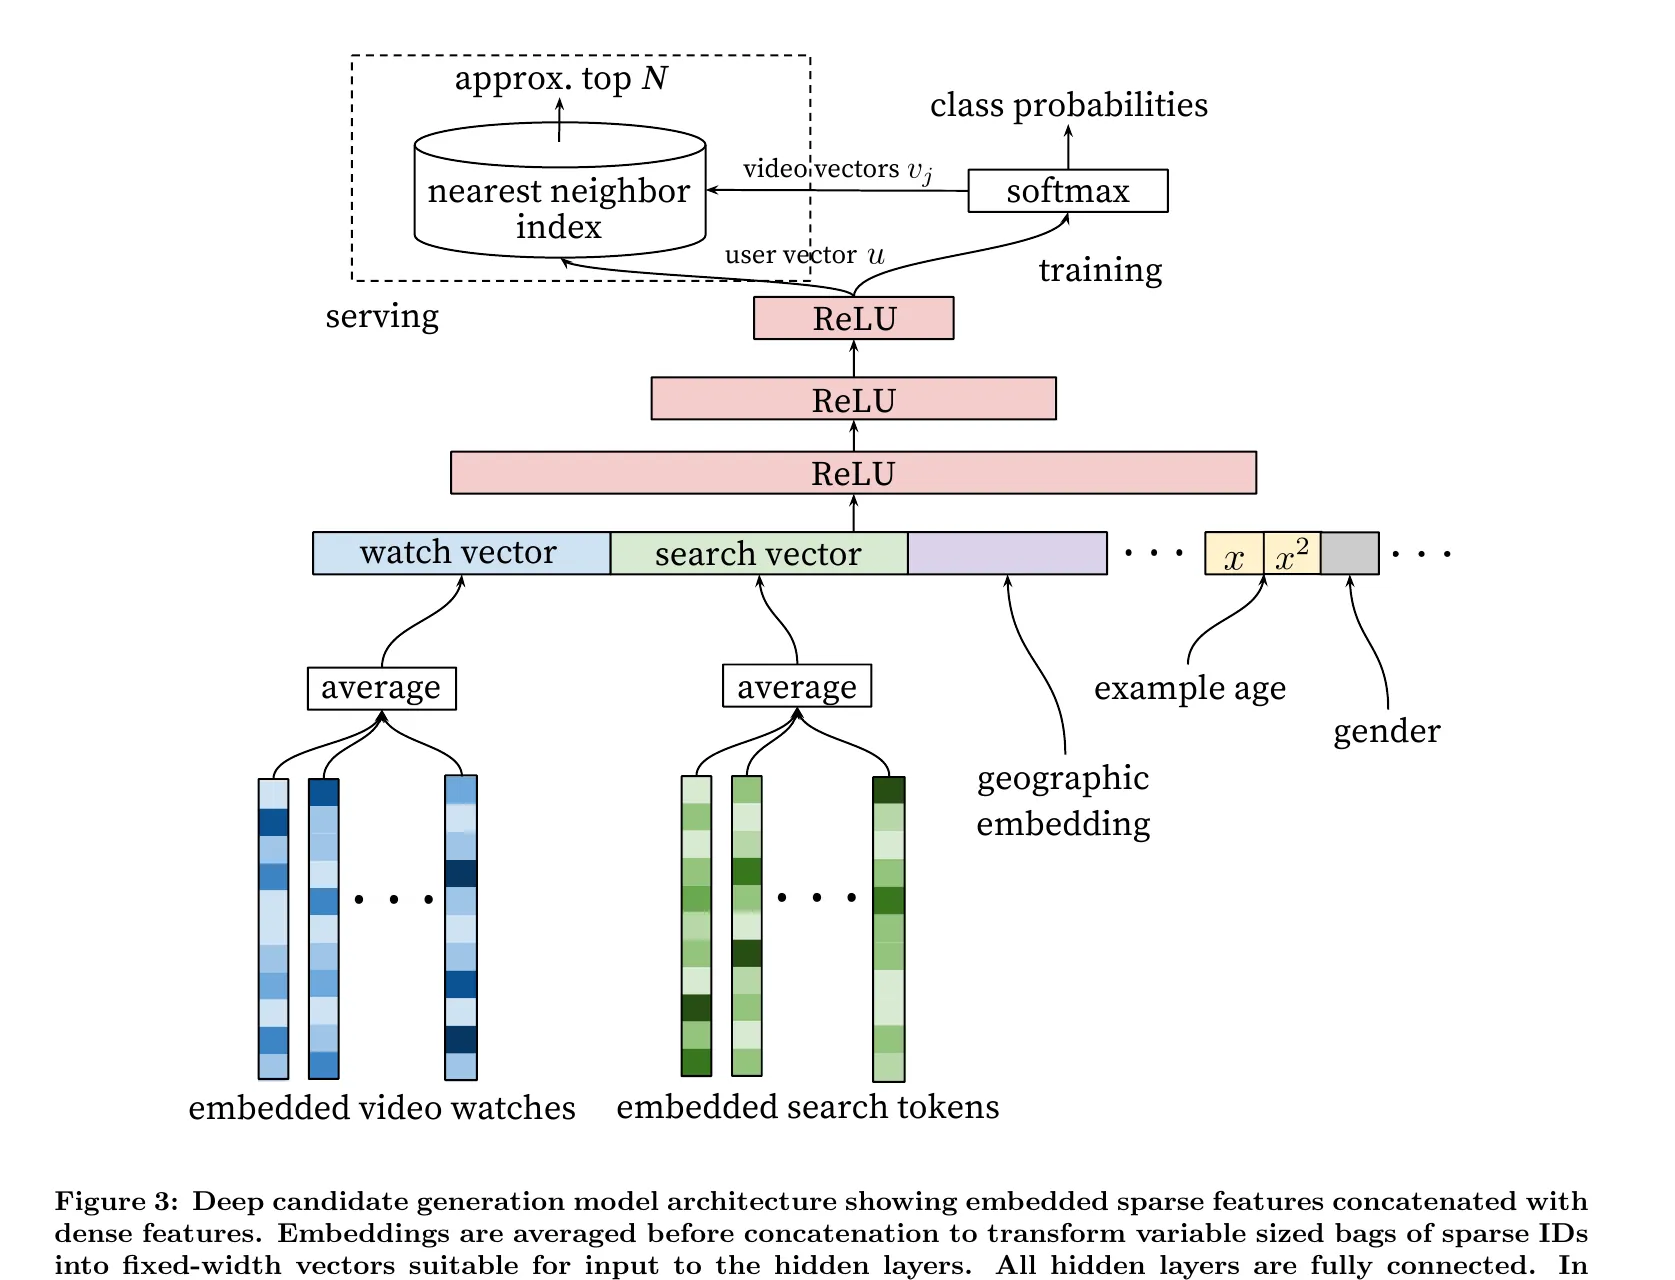
沿着自底向上的数据流向,该网络通过三个关键设计解决了变长历史聚合、新用户冷启动与跨模态非线性交叉问题:
4.1 观看历史与搜索历史的变长序列平均池化
用户的历史观看记录表现为变长的稀疏视频 ID 序列 。网络首先通过共享的大规模 Embedding 表将每个离散视频 ID 映射为稠密向量 (这些底层输入 Embedding 与前文 Softmax 输出层的视频向量 一同通过端到端反向传播联合学习,灵感源自 Word2Vec 的连续词袋模型 CBOW)。为了将不同长度的历史序列转化为全连接层所需的定长输入,论文对比了求和(sum)、逐维取最大值(component-wise max)与平均池化,实证发现简单的算术平均池化(Average Pooling)效果最为稳健:
用户的历史搜索查询(Search History)采用完全对称的方式处理:系统将历史搜索词切分为一元词(unigrams)与二元词组(bigrams)词元集合,查表映射为 Token Embeddings 后同样经平均池化聚合为定长的 search vector()。平均池化虽然舍弃了序列内部的严格先后次序,但对不同活跃度用户的序列长度变化天然免疫(不会像求和操作那样因重度用户历史长而导致激活值爆炸),在分布式训练与在线特征组装中具有极高的工程稳定性;同时,搜索词表征直接注入了用户主动表达的强显式意图,有效弥补了被动观看历史的滞后性。
4.2 人口统计学与多源异构上下文特征融合
若仅输入观看与搜索历史,模型对于刚注册或未登录的冷启动新用户将束手无策。为此,候选生成网络在底部广泛接入了非历史类的异构上下文信号(Heterogeneous Signals):地理位置(Geographic Region)与设备类型(Device)作为离散类别特征映射为 Embedding;性别(Gender)、登录状态(Logged-in State)与用户年龄(Age)等二值或连续属性则归一化至 区间后直接拼接。这些特征一方面为缺乏行为记录的新用户提供了可靠的地域与群体流行度先验(Prior),另一方面也允许深层网络学习“同一观看历史在不同设备(如客厅电视大屏 vs. 通勤手机小屏)或不同国家下的差异化推荐偏好”。
4.3 由宽到窄的漏斗形 ReLU 多层感知机
底部所有池化向量与稠密特征拼接为宽输入向量 :
随后送入由宽逐层减半的塔式全连接 ReLU 网络(例如 1024 ReLU -> 512 ReLU -> 256 ReLU),通过多层非线性变换 充分交叉历史兴趣与当前上下文,最终在顶层输出 256 维的用户表征向量 。架构图右上方清晰展示了训练与服务的双头分流:离线训练接入 Softmax 层计算类别概率,在线服务则导出 构建最近邻索引并实时检索 Top-。
5. 时效性建模与样本构造:Example Age 与时间回滚机制
整篇论文最富洞察力的工程贡献,集中在第 3.3 节与第 3.4 节对时间偏置修正(Example Age)与代理任务样本构造(Label and Context Selection)的剖析。许多团队照搬了双塔与多层感知机结构却在线上 A/B 实验铩羽而归,根源往往就出在这两个样本与特征时间边界的细节上。
5.1 Example Age:消除滑动训练窗口的时间平均偏置
下图直观展示了视频流行度随上传后天数的剧烈衰减,以及引入 Example Age 前后的模型预测分布对比:
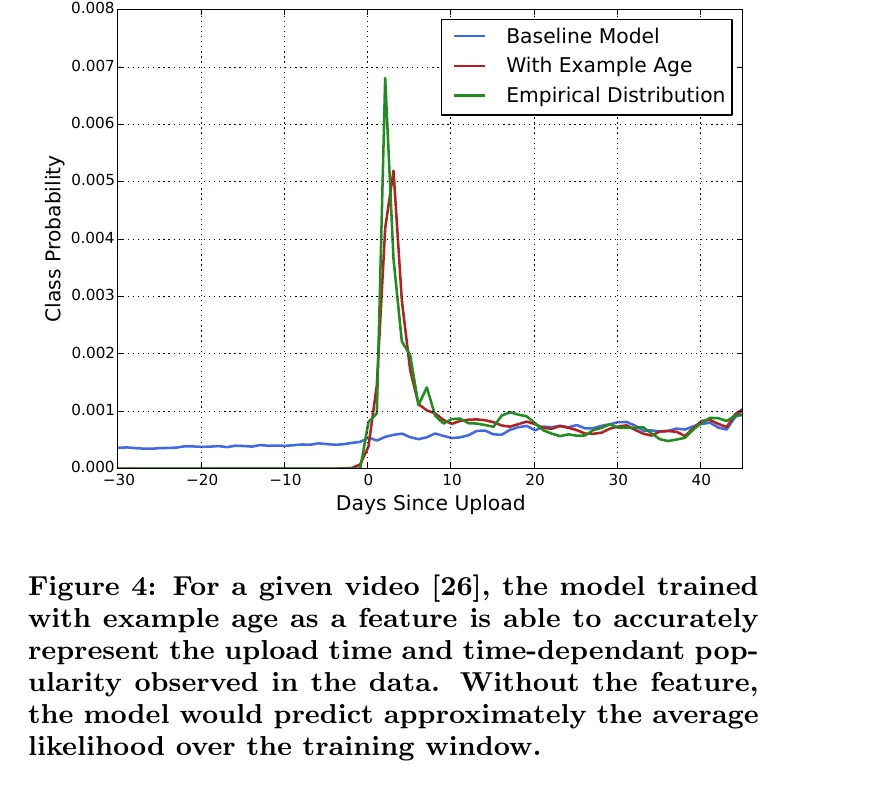
我们可以从数学上推演为什么普通神经网络会天然歧视新视频。设离线训练数据集截取自长度跨度为 (如过去 4 周)的时间窗口。一条新视频上传后往往在最初几天内迎来观看峰值,随后热度迅速回落(如上图绿色经验曲线所示)。如果模型输入中不包含样本发生时刻的时间坐标,神经网络在最小化整个训练窗口的总交叉熵损失时,对于给定视频 只能学到其在窗口期 内的时间平均观看概率:
这正是上图中蓝色基线(Baseline)曲线平坦低矮、严重低估新视频刚上传时爆发峰值的根源:一个昨天刚上传、正在全网疯传的新视频,在过去 28 天的滑动窗口中有 27 天观看量为零,其时间平均概率 自然被摊薄了二十多倍!然而,线上推荐服务永远发生在训练窗口结束之后的最新时刻 ,系统真正需要预测的是窗口最右端的即时分布 。
为了解开这一时间混叠,论文为每条训练样本引入了一个标量特征 Example Age:
其中 为该次训练数据集覆盖的最大截止时间戳(或当前时刻), 为当前训练样本实际发生的时间戳(论文中还同时传入了该特征的平方项 与平方根项 以增强非线性拟合能力)。
这一设计在训练与服务两端形成了一套极其精妙的配合:
- 离线训练期:模型通过 清晰获知每条观看记录发生在距离窗口末端多久以前,从而与视频 ID 特征交叉学习出每个视频随时间演化的真实热度曲面 (图中红色曲线与绿色真实分布高度吻合)。
- 在线服务期:系统将所有请求的
example age统一硬编码为 (或略小于 的微小数),直接指令神经网络输出处于时间轴最末端(即当下最新时刻 )的概率预测值。无需依赖粗糙的人工规则提权(Boost),模型便能自适应地捕捉新上传视频与突发热点内容的时效性红利。
5.2 样本标签与上下文构造:防止未来信息穿越与代理任务走捷径
下图对比了两种截然不同的训练样本构造方式:随机留出(Random Holdout)与时序回滚预测未来观看(Rollback History to Predict Future Watch)。
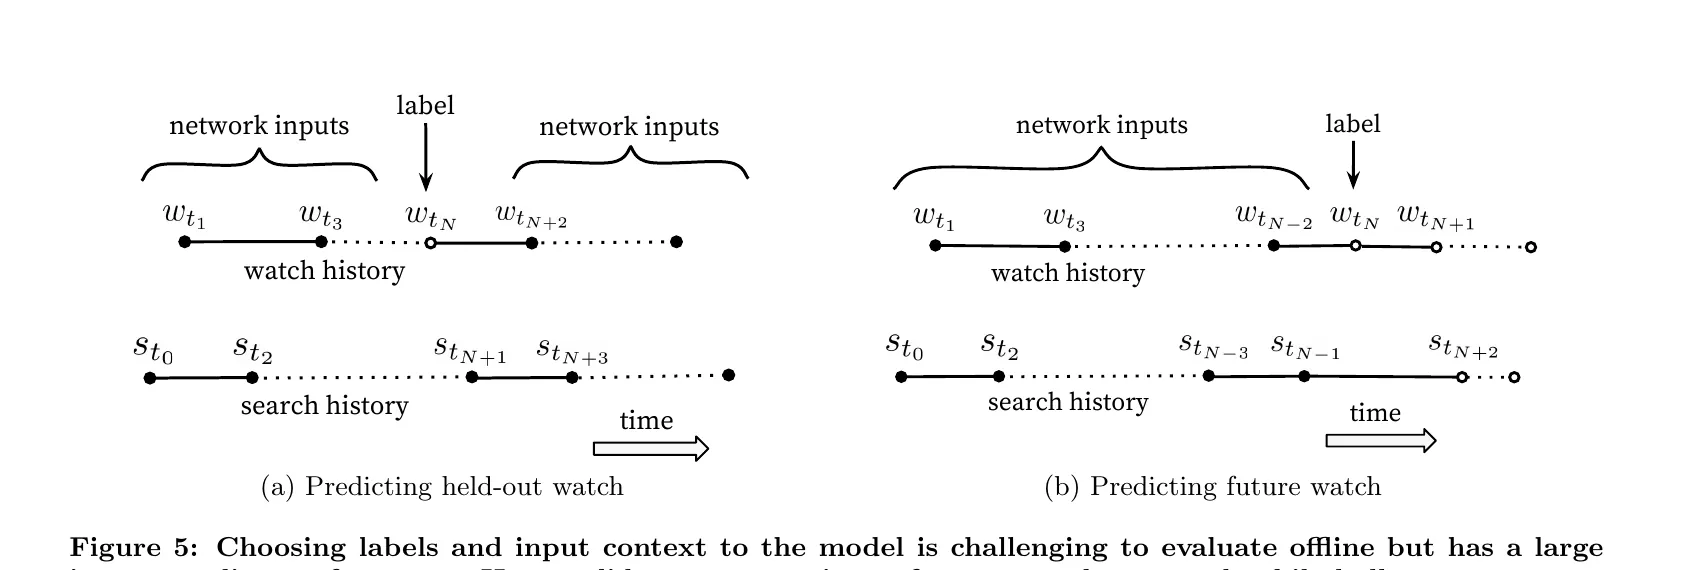
在传统学术界协同过滤基准中,常见做法是从用户的全部观看集合中随机抽出一项作为预测标签(上图 a),将其余所有观看记录(包括发生在标签时刻之后的未来行为)一并作为输入特征。论文一针见血地指出,这种做法在真实时间序列中会导致严重的未来信息泄漏(Future Information Leakage)与因果倒置。用户消费视频具有强烈的单向序列不对称性(Asymmetric Co-visitation):例如用户通常按第一集、第二集、第三集的顺序追剧,或者先浏览宽泛的大众流行音乐、再逐步深入某个小众独立音乐人。若拿周三观看的第三集去“预测”周一观看的第二集,离线验证集上的准确率虽然极高,但线上服务时系统根本不可能提前获知用户的未来行为。因此,正确的样本构造必须严格执行时间回滚(Rollback,上图 b):选定用户在时刻 的某次真实观看 作为正样本 Label,仅将严格发生在时刻 之前的历史观看与搜索记录 组装为输入上下文,时刻 之后的行为全部屏蔽。
在此基础上,论文还披露了另外三项直接决定线上 A/B 成败的样本工程铁律:
- 主动抹平紧邻搜索结构以防模型在代理任务上“走捷径”:如果用户刚刚搜索了“Taylor Swift”并点击观看了搜索结果页的第一个视频 ,随后将该视频作为正样本标签,且在输入特征中原封不动地保留该次刚发生的搜索词与时间先后顺序,高容量的深度神经网络会迅速找到一条偷懒捷径——直接把首页推荐变成“复刻上一次搜索结果页”。这虽然能让离线 Next-Watch 预测准确率飙升,但用户回到首页时绝不希望满屏重复刚搜过的旧结果。为此,论文故意丢弃了搜索历史的序列先后次序与紧邻搜索页结构,将其降格为无序词袋(Unordered Bag of Tokens),迫使模型挖掘更广泛的延伸兴趣。
- 每个用户采样固定上限的训练样本(Per-User Sample Capping):平台用户的活跃度服从极度偏斜的幂律分布。若直接按原始观看事件流生成样本,少数超重度活跃用户(或挂机爬虫)将贡献成千上万条样本并彻底主导梯度方向。论文对每个用户强制限制生成固定数量 的训练样本(),确保所有用户在损失函数中享有平等的权重,防止模型过拟合重度极客群体的偏好。
- 采集全渠道观看而非仅限首页推荐曝光:候选生成模型的训练正样本覆盖了用户在全网(包括外部网站嵌入播放器、搜索页、频道页等所有路径)触发的 YouTube 观看事件。假使训练仅局限在既有首页推荐系统曝光产生的点击上,新上传或未被旧推荐策略覆盖的视频将永远无法进入协同过滤传播链路,系统会迅速陷入自我强化的信息茧房(Feedback Loop)。
6. 候选生成离线实验:异构特征叠加与网络深度收益
下图汇报了候选生成模型在离线留出集上的平均精度均值(MAP@K)实验结果:
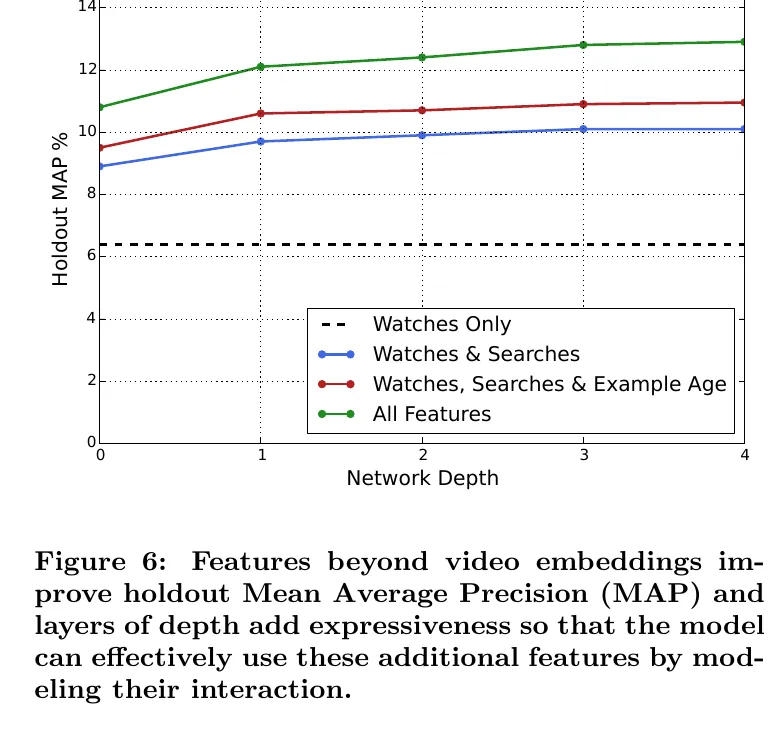
该实验的底层词表规模、序列截断长度与五档网络深度(Depth 0–4)配置整理如下:
| 实验配置项 / 网络深度 | 具体参数与结构设定 |
|---|---|
| 视频与搜索词表规模 | 1M 视频类别(Video Vocabulary)、1M 搜索词元(Search Tokens) |
| Embedding 维度与截断窗口 | 向量维度统一为 256 floats;截取最近 50 次观看记录与最近 50 次搜索查询 |
| Depth 0(线性基线) | 无隐藏层,输入特征直接线性变换映射至 256 维 Softmax 空间(近似于线性矩阵分解) |
| Depth 1 | 256 ReLU |
| Depth 2 | 512 ReLU -> 256 ReLU |
| Depth 3 | 1024 ReLU -> 512 ReLU -> 256 ReLU |
| Depth 4 | 2048 ReLU -> 1024 ReLU -> 512 ReLU -> 256 ReLU |
综合剖析上图中四组特征组合(Watches Only、Watches & Searches、Watches, Searches & Example Age 与 All Features)随深度变化的曲线走势,可以得出两条清晰的工程结论:
- 多源异构特征的引入带来的性能跃升远超单纯加深网络:在任意固定深度下,从仅使用观看历史(
Watches Only,蓝色虚线)到叠加搜索词意图(Watches & Searches,绿色点线,MAP 暴涨逾一倍)、再叠加 Example Age(黄色虚线)与人口统计学特征(All Features,红色实线),MAP 均呈现显著阶跃。尤其是 Depth 0 线性模型在接入异构特征后难以消化跨模态交互,而多层 ReLU 塔则为{历史观看 × 搜索词 × Example Age × 地域设备}提供了高阶非线性交叉通道,使All Features曲线在深层结构下持续拉开优势。 - 网络深度的边际收益递减规律显著:从 Depth 0 到 Depth 3,各特征组合的 MAP 稳步提升;但从 Depth 3 增至 Depth 4(再加一层
2048 ReLU)时增益已明显收窄,继续加宽加深不仅收敛愈发困难,还会推高在线 User Tower 的单次推理延迟,因此工程选型需在表征容量与在线服务预算之间适度止步。
7. 精排网络架构与特征工程:Impression 粒度与分位数归一化
经过候选生成与多路通道合并,候选规模从百万级收敛至数百个(Hundreds),精排(Ranking)模块正式接棒。与候选生成阶段仅能访问粗粒度用户特征不同,精排阶段由于打分候选数量少了四个数量级,得以基于具体曝光记录(Impression Data)引入高维度的候选视频特征以及精细的“用户—候选视频—召回源—界面上下文”交叉特征。下图展示了精排深度网络的整体架构:
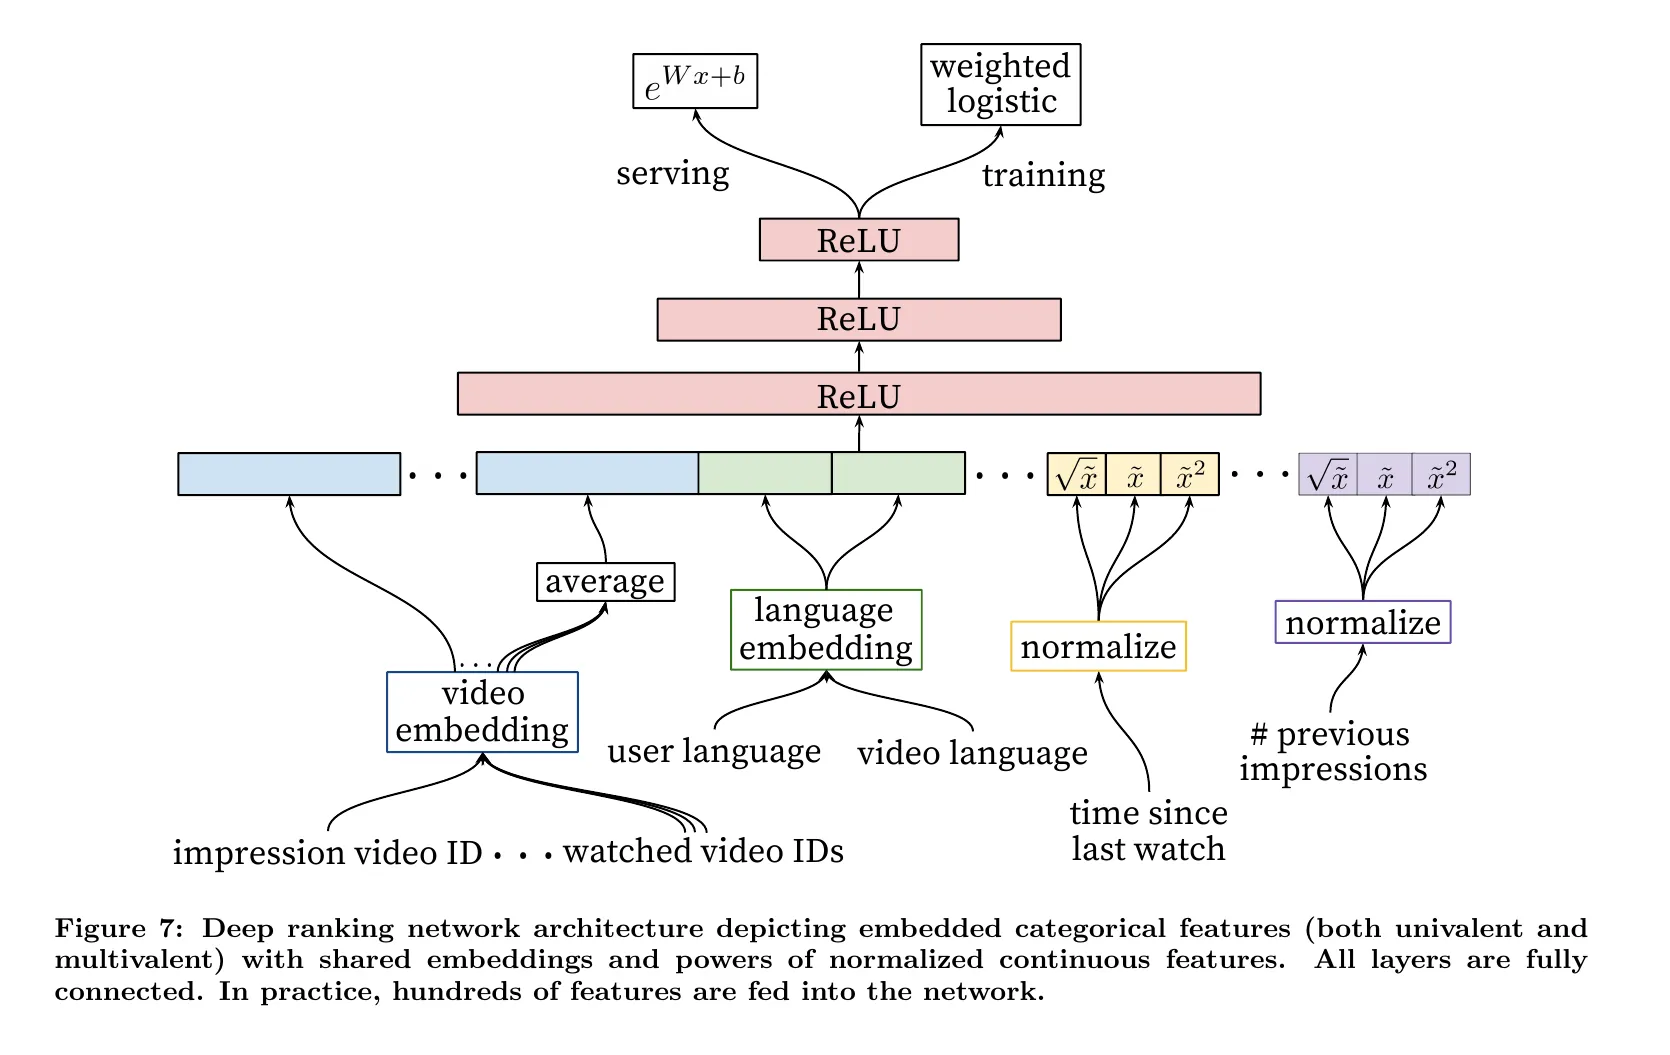
7.1 精排特征体系:计算频率解耦、跨槽位共享 Embedding 与交互统计
尽管深度学习减轻了人工构造高阶特征交叉的负担,但将数十个原始业务信号转化为神经网络易于消化的输入表征,依然耗费了最主要的工程精力。精排特征按照取值基数与在线计算频率可分为四个正交维度:
| 特征分类维度 | 子类型 | 典型特征示例 | 编码与在线计算策略 |
|---|---|---|---|
| 按取值基数划分 | 单值类别特征(Univalent) | 当前曝光视频 ID(impression video ID) | 直接查表映射为单个稠密 Embedding |
| 按取值基数划分 | 多值类别特征(Multivalent) | 用户最近观看的 个视频 ID 集合 | 查表后执行算术平均池化 $e_{\text{bag}} = \frac{1}{ |
| 按计算频率划分 | 请求级特征(Query Features) | 用户设备、语言、地理区域、近期全局活跃度 | 每次请求仅计算一次,向所有候选广播复用以节省算力 |
| 按计算频率划分 | 曝光级特征(Impression Features) | 候选视频 ID、候选召回源得分、用户在该频道历史观看数 | 随候选数量线性增长,需对数百个候选逐一计算与拼接 |
围绕高基数 ID 特征与用户-物品交互关系,论文重点强调了两项工程实践:
- 同语义域跨特征槽位共享底层 Embedding 表与词表截断:“视频 ID”这一实体空间会同时出现在当前曝光视频(
impression video ID)、用户最近观看视频(watched video ID)、触发推荐的种子视频(seed video ID)等多个不同特征槽位(Feature Slots)中。精排网络让所有同属 Video ID 域的槽位共享同一张底层大 Embedding 表,但在拼接进入第一层全连接层时各自占据独立的输入通道;这既大幅削减了显存参数并加速长尾泛化,又允许上层网络针对不同槽位学习差异化权重。同时,针对百万级视频与频道空间,系统仅按点击曝光频次截取高频 Top- 纳入词表(Embedding 维度大致按唯一值数量的对数 缩放),词表外(OOV)长尾 ID 统一映射至全零向量(Zero Embedding),依靠其他连续统计特征与类目特征完成泛化打分。 - 强区分度的用户-物品历史交互与疲劳度特征:精排阶段最具预测力的信号来自刻画用户与当前候选视频(或同频道、同主题)过往互动深度的连续统计特征,包括“用户此前在该频道累计观看了多少个视频”、“用户距离上一次观看该主题视频过去了多久(Time since last watch)”,以及至关重要的历史曝光未点击疲劳度特征(Number of previous impressions)——如果某个视频在过去几次首页刷新中已连续向该用户曝光却均未被点击,模型会据此敏锐下调其预测得分,自然实现在线曝光降权与列表常看常新(Churn)。此外,将候选生成阶段各通道提名该视频的标志位与原始得分传入精排,也是赋能多路召回校准的核心桥梁。
7.2 连续特征工程:经验累积分布分位数归一化与幂次展开
决策树模型(如 GBDT)对输入特征的单调非线性尺度变换天然不敏感,但基于梯度下降的深度神经网络对连续特征的数值尺度与长尾偏态分布高度敏感。推荐系统中的曝光次数、观看间隔时长、历史点击数等连续特征普遍呈现极端的幂律长尾与零膨胀分布,若直接输入原始数值(Raw Value)或仅做线性均值方差标准化(Z-score),少数极端离群值便会引发梯度爆炸或令高层 ReLU 神经元彻底饱和失活。
为此,论文提出在预处理阶段对每个连续特征 (设其概率密度分布为 )执行基于经验累积分布函数(Empirical CDF / Quantile Normalization)的分位数归一化,将其保序映射至 区间内的均匀分布:
在工程实现上,离线管线只需单次扫描训练数据统计出一组百级分位点边界(Quantile Boundaries),在线与离线推理时在相邻分位点之间执行高速线性插值即可获得 。这种分位数映射不仅彻底消除了长尾离群点的数值冲击,还将原本挤在零附近的稠密样本均匀拉开,使梯度在全定义域内平稳流动。
更进一步,为了让浅层 ReLU 网络无需消耗过多隐藏层折线近似就能轻松拟合变量的超线性与次线性响应曲线,论文将归一化后的特征 与其平方项和平方根项一同作为三个独立通道输入网络底部:
后续消融实验证明,这一极低成本的显式多项式基展开能够稳定带来可观的离线与在线排序增益。
8. 预期观看时长目标与精排实验:加权逻辑回归解析
精排模型的优化目标是决定整个推荐系统价值取向的指挥棒。本节详细推导论文如何通过加权逻辑回归(Weighted Logistic Regression)与指数激活函数,在不改变分类训练框架的前提下直接预测预期观看时长。
8.1 为什么用 Expected Watch Time 替代单纯 CTR
如果精排模型仅以点击与否(0/1 二分类)训练标准逻辑回归并按点击率(CTR)排序,系统会不可避免地沦为标题党(Clickbait)的帮凶:一个封面耸人听闻但内容空洞的 10 分钟视频,可能诱骗大量用户点击并在观看 6 秒后愤怒关闭;在纯 CTR 指标下它会被排在榜首,而一个封面朴实但用户点击后会沉浸观看 5 分钟的优质深度视频反而排在后面:
| 候选视频特征 | 点击率(CTR) | 点击后平均观看时长 | 纯 CTR 排序位次 | 预期观看时长(Expected Watch Time)排序位次 |
|---|---|---|---|---|
| 视频 A(标题党短退) | 极高(如 ) | 极短(如 秒) | 榜首(预期点击高) | 靠后(每次曝光期望观看仅 秒) |
| 视频 B(优质深度内容) | 中等(如 ) | 很长(如 秒) | 靠后(点击率偏低) | 榜首(每次曝光期望观看达 秒) |
那为什么不直接训练一个均方误差(MSE)回归模型去拟合观看时长 ?原因在于曝光数据集中存在超过 的未点击零时长样本(Zero-inflated)以及高度偏斜的超长观看样本,直接做连续回归不仅方差极大、对长尾异常值高度敏感,还会丧失分类交叉熵在零值附近的概率校准几何性质。因此,如何在保留逻辑回归交叉熵稳定训练动力学的同时,让输出值直接对齐每次曝光的预期观看时长(Expected Watch Time per Impression),便成了精排损失设计的核心命题。
8.2 加权逻辑回归的几率(Odds)数学推导
论文给出了一套极其优雅的解法:所有发生点击的正样本在交叉熵损失函数中按其实测观看时长 进行样本加权,所有曝光未点击的负样本保持单位权重 。
我们来严格推导这一加权方式为何能让网络学出的对数几率(Logit)直接逼近预期观看时长。设某个特征邻域内的总曝光样本数为 ,其中发生点击的正样本数为 (故未点击负样本数为 ),第 个正样本的真实观看时长为 。在标准无加权逻辑回归中,正类概率为 ,模型线性输出层 学习的是正负样本计数的对数几率(Log-Odds),即:
当我们将第 个正样本的权重设为 (等价于将该正样本在训练集中复制了 份),而每个负样本权重仍为 时,加权逻辑回归学到的新几率(Weighted Odds)自然变为正样本总权重与负样本总权重之比:
记该曝光条件下的真实点击概率为 ,点击条件下的期望观看时长为 ,则单次曝光的无条件预期观看时长(Expected Watch Time per Impression)为 。将其代入上面的加权几率表达式,分子分母同除以 可得:
在推荐列表曝光场景中,单次曝光的点击率 通常是一个较小的值(例如 ,几百分之几),利用一阶泰勒展开 ,上式立即化简为:
这一推导揭示了一个极具美感的工程结论:在训练阶段,只需使用带样本权重的标准交叉熵损失(正样本权重 ,负样本权重 )训练逻辑回归;到了在线服务(Serving)阶段,只需将最后一层激活函数从 Sigmoid 替换为指数函数:
模型输出的标量分数即直接近似于该候选视频在当前曝光下的预期观看时长 !
8.3 精排网络深度、宽度与消融实验解析
下表给出了精排网络在次日留出集(Next-day Holdout Data)上不同隐藏层配置对应的按用户加权逆序损失(Weighted Per-User Loss):
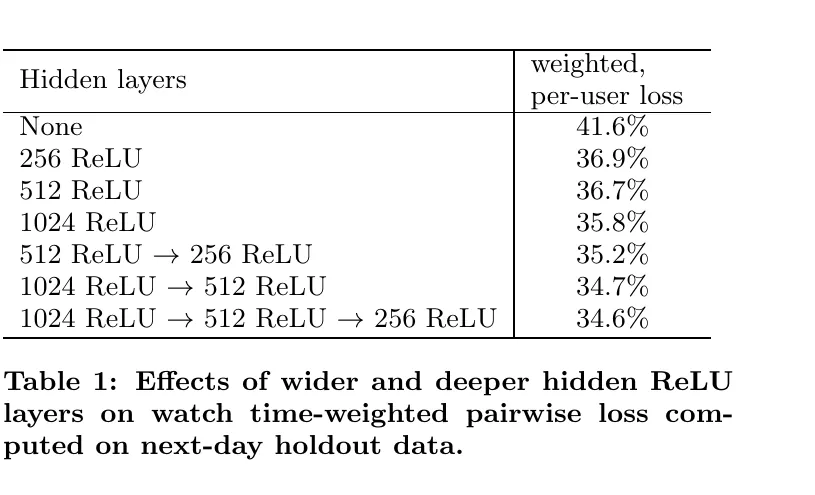
论文定义的评估指标 Weighted Per-User Loss 紧扣观看时长目标:在同一用户的同一次推荐页面曝光中,任取一对正样本(被点击观看,时长为 )与负样本(曝光未点击);若精排模型给负样本打出的分数高于正样本(发生逆序错误),则将该正样本的观看时长 计入“误排序时长损失”,最终指标即为全用户误排序观看时长占总观看时长的百分比(数值越低代表排序越精准)。实验结果整理如下:
| 精排隐藏层配置(Hidden Layers) | 按用户加权逆序损失(Weighted Per-User Loss) |
|---|---|
| None(纯线性逻辑回归基线) | |
256 ReLU | |
512 ReLU | |
1024 ReLU | |
512 ReLU -> 256 ReLU | |
1024 ReLU -> 512 ReLU | |
1024 ReLU -> 512 ReLU -> 256 ReLU |
审视上述数据及正文中配套的消融实验,可以提炼出三项极具价值的工业规律:
- 非线性特征交叉与多层深度的权衡:从无隐藏层(
None,损失高达 )引入单层256 ReLU(损失骤降至 ),减损幅度达 个百分点,证明在丰富的 Query 与 Impression 特征之上引入非线性变换收益巨大;随着网络继续加宽加深至三层塔式结构1024 -> 512 -> 256,损失进一步降至 ,但相比两层结构1024 -> 512()仅微降 个百分点。由于精排需要对数百个候选逐一前向传播,最终线上选型必须严格受控于单次请求的在线 CPU 算力预算。 - 连续特征幂次展开的边际贡献:在
1024 -> 512 -> 256架构下,若仅输入分位数归一化后的 而去掉 与 ,加权逆序损失会上升 (退化至 ),说明在输入端显式提供超线性与次线性基函数对深层网络依然大有裨益。 - 目标函数加权远比多堆一层网络更关键:同样在
1024 -> 512 -> 256架构下,若取消训练阶段的正样本观看时长加权(退化为正负样本等权重的普通 CTR 逻辑回归),加权观看时长逆序损失将剧烈恶化 (飙升至 ,甚至不如最简单的单层256 ReLU加权模型)。这一对比有力印证了推荐系统的黄金定律:样本标签与损失函数对业务目标的对齐精度,决定了模型效果的上限。
9. 召回与精排全维度对照及十年架构演进脉络
将候选生成与精排两个阶段置于同一表格下对比,可以一目了然地把握整个 YouTube DNN 架构的工程边界:
| 对比维度 | 候选生成(Candidate Generation / 召回) | 精排(Ranking / 排序) |
|---|---|---|
| 候选空间规模 | 百万级(Millions)全量视频库 | 百级(Hundreds)多路合并候选池 |
| 核心阶段使命 | 高召回覆盖率、低延迟粗筛个性化相关视频 | 高精度区分头部列表、校准多通道得分与业务目标 |
| 训练样本粒度与构造 | 全渠道观看事件;时序回滚历史 → 预测未来下一次观看 | 具体推荐页面曝光(Impression)→ 点击与观看时长 |
| 主力输入特征 | 观看/搜索历史 ID 序列池化、人口统计学、Example Age | 曝光视频与历史交互统计、疲劳度计数、候选源与得分、分位数归一化连续特征 |
| 离线训练目标 | 极大规模多分类 + Sampled Softmax(重要性加权负采样) | 观看时长加权逻辑回归(正样本权重 ,负样本权重 ) |
| 在线服务(Serving)形态 | 导出视频向量 ,对用户向量 执行近似最近邻(ANN)检索 Top- | 对每个候选视频前向传播 MLP,通过 预测预期观看时长 |
| 输出规模与硬约束 | 输出百级候选;受数十毫秒延迟与全局向量索引刷新约束 | 输出十级展示列表;受单次请求 CPU 算力预算与特征拉取延迟约束 |
站在 2016 年之后的十年技术演进视角回望,YouTube DNN 当年受限于工程阶段所做的四处简化假设,恰好构成了此后工业推荐系统四大前沿方向的起点:
9.1 从 Softmax 独立类别向量到显式双塔(Two-Tower)内容编码
YouTube 2016 论文在候选生成阶段的视频侧向量 本质上是 Softmax 输出层的独立 ID 类别参数,对毫无历史观看记录的纯新上传视频缺乏基于视频内容特征的泛化编码能力。现代双塔召回架构(如 Google 后续在 RecSys 2019 发表的混合双塔模型与 Pinterest Learned Retrieval)将视频/物品侧显式扩展为独立的 Item Tower ,把标题文本、封面视觉、类目属性与统计特征实时编码为物品向量 ,与用户塔 进行内积匹配,从而彻底打通了新物品的内容冷启动通道。
9.2 从无序平均池化到目标注意力与生成式序列模型
YouTube DNN 采用简单的算术平均池化(Average Pooling)聚合历史观看与搜索序列,既抹平了行为的先后次序与时间间隔,又导致面对不同候选视频时用户历史表征始终固定不变。随后阿里提出的 DIN(Deep Interest Network)在精排侧引入目标候选注意力机制(Target Attention),根据当前待打分的候选视频动态加权用户的历史观看记录;DIEN、SASRec 以及近年兴起的生成式序列推荐(如 Meta HSTU)则进一步引入自回归 Transformer 架构,深度建模长周期兴趣演化轨迹。
9.3 从单一用户向量到多兴趣胶囊与聚类召回
在候选生成阶段将一位用户数十次跨领域的观看历史强行压缩为单一 256 维向量 ,容易导致多峰兴趣(例如同一用户既看硬核编程教程、又看古典音乐与健身视频)在求平均后落入几个领域的几何中间地带,造成“哪个领域都召回不准”的平均化失真。后续的 MIND(Multi-Interest Network with Dynamic Routing)与 ComiRec 通过动态路由胶囊网络或自注意力机制为每位用户提取多个兴趣向量 ,分别并发检索 ANN 索引再合并候选,显著改善了多兴趣用户的召回覆盖度。
9.4 从单一预期观看时长到多目标优化与安全生态治理
论文通过加权逻辑回归将优化目标从 CTR 推进至 Expected Watch Time,成功遏制了浅层标题党;但在长期运营中,单纯追求观看时长仍会产生偏爱超长视频、诱导沉迷与信息窄化等副作用。现代大型推荐平台普遍演进为基于 MMoE(Multi-gate Mixture-of-Experts,Google KDD 2018)或 PLE 的多任务学习框架,同时预测点击、完播率、观看时长、显式点赞/收藏、分享、负向点踩/不感兴趣以及随机抽样问卷满意度(Satisfaction Survey),并通过带约束的多目标融合公式兼顾创作者公平曝光与平台内容生态健康。
| 拓展研究主题 | 经典参考文献 |
|---|---|
| YouTube 早期图与关联规则推荐 | Davidson et al., The YouTube Video Recommendation System, RecSys 2010 |
| 大词表线性排序与采样训练 | Weston et al., WSABIE: Scaling Up To Large Vocabulary Image Annotation, IJCAI 2011; Jean et al., ACL 2015 |
| 隐式反馈与停留时长建模 | Hu, Koren, Volinsky, ICDM 2008; Yi et al., Beyond Clicks: Dwell Time for Personalization, RecSys 2014 |
| 记忆与泛化联合精排架构 | Cheng et al., Wide & Deep Learning for Recommender Systems, DLRS 2016; DeepFM, IJCAI 2017; DCN, KDD 2017 |
| 序列注意力与多兴趣推荐 | Zhou et al., DIN, KDD 2018; DIEN, AAAI 2019; MIND, CIKM 2019; SASRec, ICDM 2018 |
10. 结语:跨越十年的工业推荐工程启示
回望 Deep Neural Networks for YouTube Recommendations,它历经十年仍被奉为工业推荐系统设计的圭臬,原因在于它清晰示范了如何用面向生产约束的系统分解思维驾驭深度学习:
- 严格区分训练目标与在线服务形态:候选生成在离线是带负采样的极大规模多分类,在线则是免配分函数的 ANN 最大内积检索;精排在离线是样本加权的交叉熵二分类,在线则是经 转换的预期时长打分。
- 用防穿越的时间回滚构造替代随机留出:离线样本必须严守在线服务时的信息边界(只用时刻 之前的历史预测时刻 的未来观看),甚至主动抹平过强的近期搜索结构特征,防止模型在代理任务上走捷径而损害真实首页体验。
- 把时间非平稳性显式编码进模型:通过 Example Age 在训练期学习流行度随时间的演化曲面,并在服务期置零输出当下时刻分布,比手工给新视频加固定偏置分更为精准自洽。
- 召回与精排必须通过召回源特征紧密咬合:ANN 召回仅提供一路候选池,精排模型必须显式消费候选来源 ID 与原始通道分数,并在曝光级(Impression)特征空间内融合疲劳度惩罚完成最终校准。
- 模型收益高度依赖连续特征变换与目标函数对齐:经验 CDF 分位数归一化配合 幂次展开保障了梯度平稳,而观看时长样本加权带来的 逆序损失降幅更是远超多层网络堆叠。(关于如何在缺乏初始样本的业务中从零落地曝光日志、防穿越样本契约、双塔召回与四阶段上线闭环,可进一步参阅站内姊妹篇《简单推荐算法实施指南:从冷启动弱监督到真实反馈闭环》。)
无论底层神经网络从当年的多层 ReLU 演进为如今的深层 Transformer 还是生成式大模型,这套将算法模型严丝合缝嵌入数据闭环、算力预算与真实商业目标的工程哲学,始终是工业界推荐系统迭代演进的基石。
参考资料
- Paul Covington, Jay Adams, Emre Sargin. Deep Neural Networks for YouTube Recommendations. RecSys 2016.
- Google Research. Deep Neural Networks for YouTube Recommendations.
- Google Research PDF. Deep Neural Networks for YouTube Recommendations.
- James Davidson et al. The YouTube Video Recommendation System. RecSys 2010.
- Jason Weston, Samy Bengio, Nicolas Usunier. WSABIE: Scaling Up To Large Vocabulary Image Annotation. IJCAI 2011.
- Yi et al. Beyond Clicks: Dwell Time for Personalization. RecSys 2014.
- Steffen Rendle et al. BPR: Bayesian Personalized Ranking from Implicit Feedback. UAI 2009.
- Yifan Hu, Yehuda Koren, Chris Volinsky. Collaborative Filtering for Implicit Feedback Datasets. ICDM 2008.
comments