让一个大语言模型在单轮对话里写一段 SQL,和训练一个通才智能体(Generalist Agent)同时在五个截然不同的真实环境里连续干活——在 WebShop 里搜索比价下单、在 MySQL 数据库里多轮探查表结构修正查询、在知识图谱里做多跳关系推理、在 Ubuntu 终端里执行 Bash 命令排障、以及在 ALFWorld 房间里搜寻操作物体——在系统架构和强化学习动力学上完全是两码事。
如果你直接拿单轮强化学习(RLVR)的同步训练管线去跑多轮多任务智能体,马上就会撞上四堵墙:
- 同步流水线被长尾交互拖垮:有的样本调一次工具就结束,有的样本在错误路径上往返交互满 20 轮;同步批处理下,先跑完的 GPU 只能干等最慢的会话。
- 有状态沙箱无法塞进训练进程:数据库、操作系统和购物环境各自维护着真实的容器会话状态(Stateful Session),一旦和 GPU 推理进程硬绑在一起,一个沙箱卡死就会拖垮整组显卡。
- 单策略多轮自采样极易陷入“探索坍缩”:在多轮决策树上,模型早期的动作偏好决定了后续能看见什么状态;同一个策略自己采数据自己训,很快就会在局部死循环里越陷越深,导致同一个问题采出的 8 条轨迹大同小异,丧失学习信号。
- 多任务混合训练发生“梯度霸权”:5 个环境的初始成功率、平均交互轮数和单步 Token 长度天差地别,把所有任务的优势值混在一锅里更新,长序列或高方差任务会瞬间淹没其他任务的梯度。
为了系统性拆解这四堵墙,清华大学与 Z.AI 团队推出了 AgentRL: Scaling Agentic Reinforcement Learning with a Multi-Turn, Multi-Task Framework(并完整开源了包含训练引擎与环境控制面的 THUDM/AgentRL 代码库)。在不做任何冷启动 SFT 的前提下,AgentRL 将 Qwen2.5-32B-Instruct 在五大环境上的平均成功率从 37.2% 拉升至 70.4%,用单一多任务模型追平了五个单任务专家模型的组合上限(14B 规模下 67.7% vs. 67.8%),并在 16~64 张 H800 GPU 上实现了接近同步基线 2 倍 的训练吞吐率。
透过论文推导与开源源码看本质,AgentRL 的成功建立在四条软硬协同的核心设计哲学之上:
- 物理切分推理与训练资源池,用“跨组全异步 + 组内聚拢”消除全局空泡(Group-Aware Asynchronous Decoupling):将集群 GPU 物理划分为独立的 SGLang 推理池与 FSDP 训练池,配合有界队列打破“全批次生成完才能进训练”的全局屏障;同时在
Buffer内部以group_id为键聚拢同一问题的 8 条轨迹——既消除了跨样本与跨阶段的等待气泡,又保住了 GRPO 无需维护同规模 Critic 的显存红利。 - 把有状态容器从 GPU 进程剥离,收敛为统一的 Function-Call 控制面(Centralized Environment Control Plane):用高并发 Go Controller 与容器化 TaskWorker 统一接管数据库、操作系统等异构沙箱的生命周期,向训练侧仅暴露
start / observation / end三个标准 OpenAI Function-Call 原语,并在 Agent Loop 中通过对话模板差分编码严格隔离模型动作 Token(loss_mask=1)与环境观测 Token(loss_mask=0)。 - 把异步系统的“策略陈旧性”变废为宝,用滞后引擎构造步骤级跨策略探索(Turn Stale Engines into Step-Level Cross-Policy Explorers):常规异步 RL 视旧版本策略为需要压制的噪声,AgentRL 却反其道而行之——从推理 GPU 池中专门切出 25% 算力作为每隔 25 步才更新一次权重的 Stale Rollout Engine,在单条多轮轨迹的每一个环境步骤(Step)按概率随机切换最新策略与陈旧策略,以零异构模型部署成本实现了跨策略采样(Cross-Policy Sampling),打破单一策略的局部动作死循环。
- 在 GRPO 组内比较之上叠加“任务级 Token 标准化”,平抑跨任务梯度干扰(Two-Level Advantage Normalization):GRPO 的组内归一化只回答了“同一个问题下哪条轨迹更好”,却解决不了不同任务之间的方差与 Token 数量失衡。AgentRL 在每个训练批次内按任务类别(
data_source)收集所有有效动作 Token 的优势值做二次标准化,让稀疏难任务与高频短任务在共享梯度中拥有对等的话语权。
下面我们顺着这四条设计哲学,结合论文数学建模与官方仓库源码,逐层剖析整套系统的运转机理。
1. 从单轮 RLVR 到多轮多任务智能体:问题空间与架构全景
1.1 多轮交互与异构环境带来的五重质变
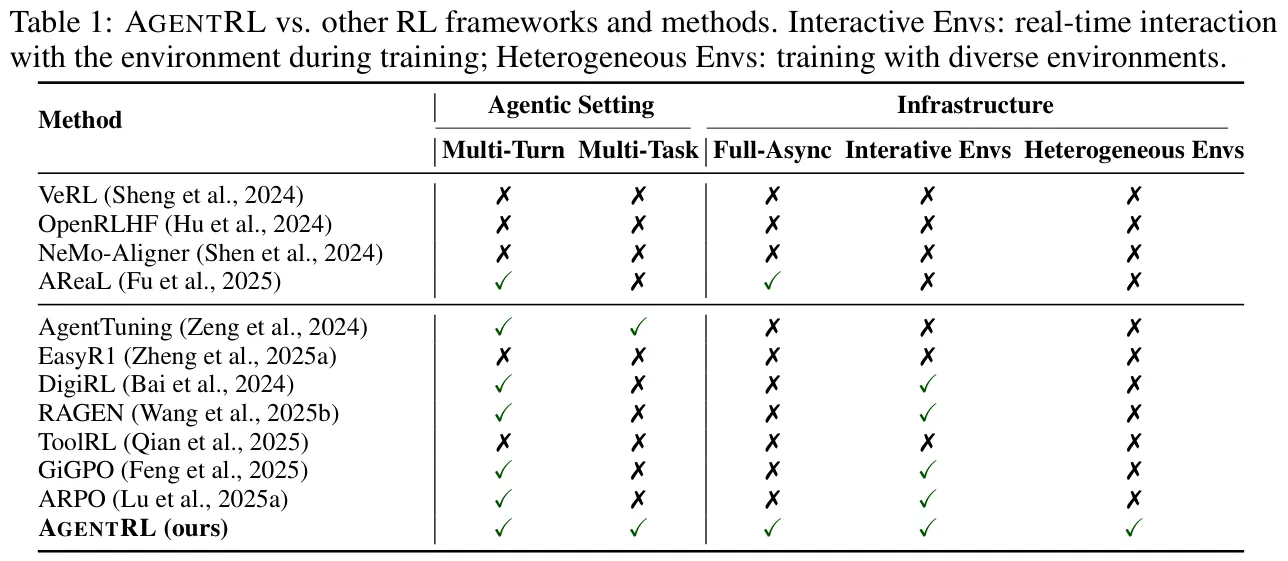
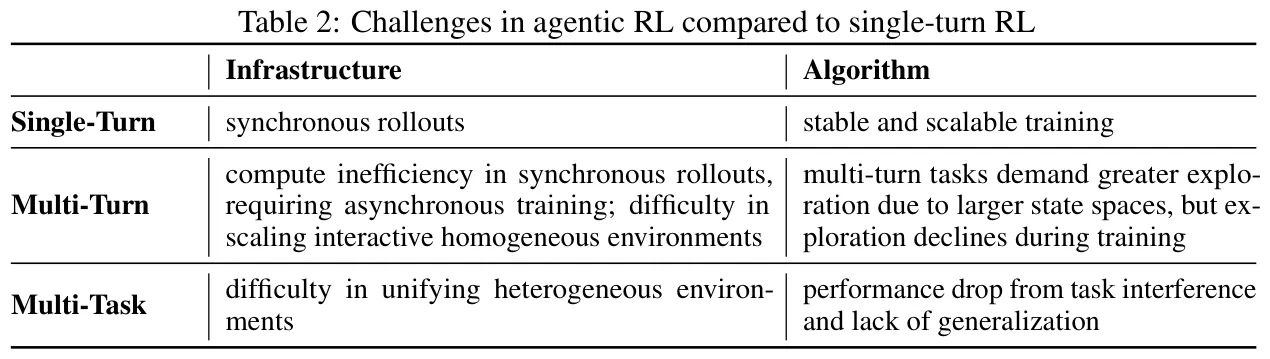
对照上面两张问题界定表(Table 1 与 Table 2),为什么单轮数学/代码强化学习框架(如只针对单次生成设计的同步 RL 管线)很难直接搬到多轮多任务 Agent 场景?
在单轮 RLVR 中,一条样本的生命轨迹只有简单的一步:Prompt -> 模型一次性输出完整回答 -> 规则校验器打分。而在多轮智能体交互中,单条 Episode 会演变成一场长达数十轮的拉锯战:
prompt / initial observation
  -> model action or tool call
  -> environment state transition
  -> observation and reward signal
  -> append to conversation context
  -> next model action
  -> ...
  -> terminal reward / timeout / task limit (-0.2 penalty)
如 Table 2 所总结的,从 Single-Turn 走向 Multi-Turn 再走向 Multi-Task,系统在基础设施(Infrastructure)与算法(Algorithm)两侧同时遭遇了质变:
- 在多轮维度(Multi-Turn):基础设施侧面临长短轨迹混杂导致的同步等待浪费,以及成千上万个并发有状态沙箱的调度难题;算法侧则面临指数级膨胀的多步状态空间——随着训练推进,模型策略熵快速下降,极易在多轮交互中退化出机械重复的局部死循环。
- 在多任务维度(Multi-Task):基础设施侧必须把千差万别的环境(SQL 数据库、Linux 容器、网页商城、知识图谱接口)收束到同一套训练协议下;算法侧则必须解决不同任务在联合优化时的梯度尺度打架与灾难性遗忘。
1.2 四条数据流交织的系统全景
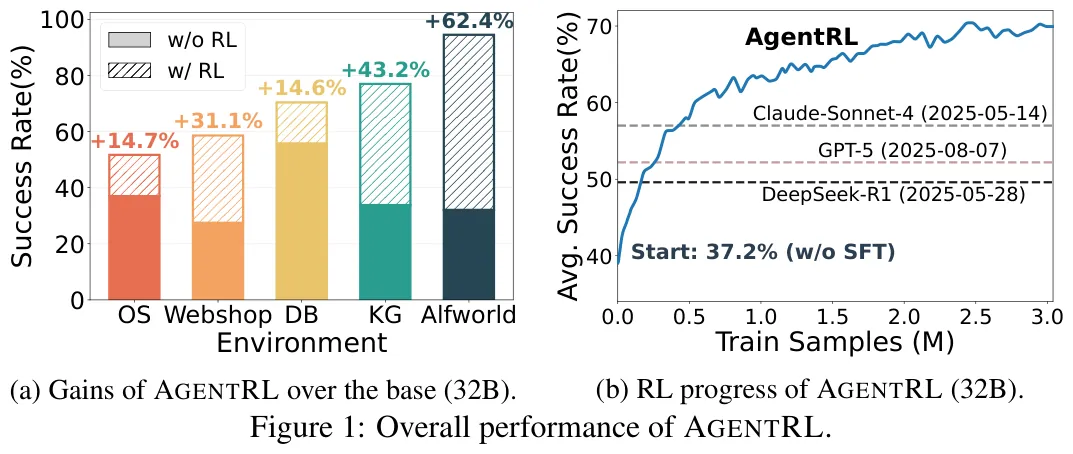
看 Fig. 1 的训练收益预览:在完全不做 SFT 预热的情况下,Qwen2.5-32B 经过 AgentRL 多任务强化学习后,五项任务成功率全面飙升——OS 提升 14.7 个百分点、DB 提升 14.6 个百分点、WebShop 提升 31.1 个百分点、KG 提升 43.2 个百分点、ALFWorld 更是暴涨 62.4 个百分点,五任务平均成功率从 37.2% 一路爬升至 70.4%。
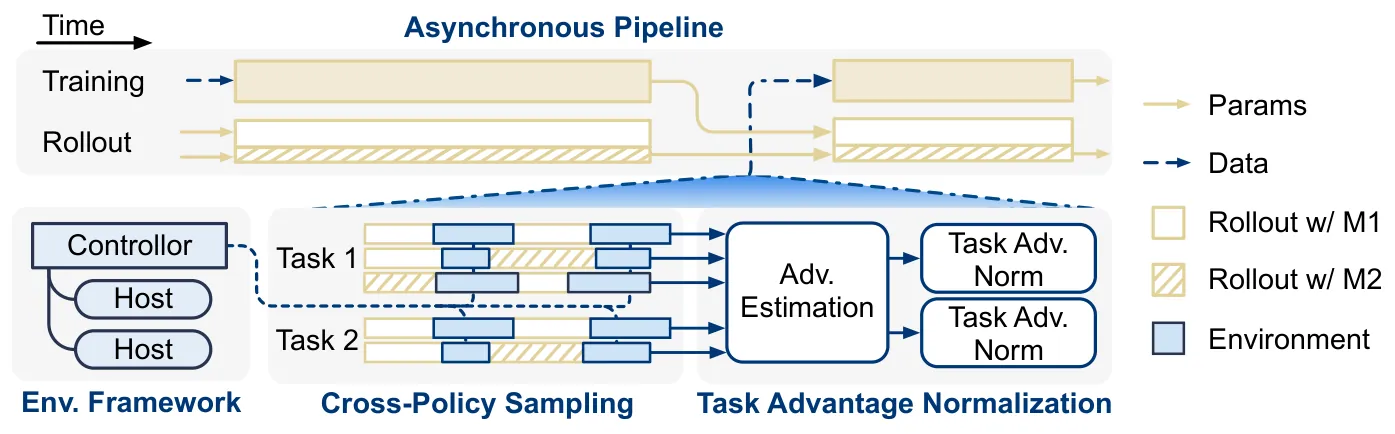
再看 Fig. 2 的总体架构图,AgentRL 是如何把这套系统组织起来的?我们可以顺着图中的箭头梳理出四条并发运转的数据流:
- 任务调度流(Task Stream):多任务交错数据流进入异步
Task Manager,向中央 Controller 请求在对应容器中初始化环境会话(Session)。 - 跨策略交互流(Cross-Policy Interaction Stream):在每一轮环境交互中,系统从策略池(主实验由实时更新的 Current Rollout Engine 与周期更新的 Stale Rollout Engine 组成)中选择一个模型生成工具调用动作,经 Controller 路由至具体的容器化
TaskWorker执行,拿回环境观测、状态码与奖励。 - 双层优势训练流(Training Stream):完成的轨迹写入
Buffer;一旦某个问题的 8 条轨迹凑齐即进入可消费队列,由 Learner 拉取批次,依次执行 GRPO 组内相对优势计算 Task Advantage Normalization 任务级 Token 标准化 Reference Model 前向与 Actor PPO/KL 梯度更新。 - 双速参数同步流(Parameter Stream):Actor 每完成一步优化,立即通过 NCCL 将最新权重推送给 Current Rollout Engine;而 Stale Rollout Engine 则每隔固定的
stale_step(如 25 步)才接收一次权重同步,刻意保持受控的策略代差。
2. 核心设计哲学一:双层粒度 MDP 与感知采样组的异步流水线
2.1 环境按轮交互、策略按 Token 优化:组合状态 MDP 与 GRPO 基座
在写代码之前,必须先把多轮多任务智能体的数学账算明白:外部环境是按“一轮完整的函数调用”推进状态的,而底层的 Transformer 策略模型却是按“一个个 Token”自回归生成的。怎样把这两个不同粒度对齐到同一个强化学习目标里?
论文将第 个任务定义为马尔可夫决策过程(MDP):
其中 是容器内部的真实环境状态(比如数据库里当前有哪些表、Linux 目录下有哪些文件), 是高层动作空间, 是转移函数, 是奖励函数, 是初始分布。因为语言模型看不见容器内存,只能看见文本序列,所以第 步的完整状态被定义为环境状态与语言上下文的组合状态:
其中 保存了截至第 轮的完整对话历史、已发出的工具调用和环境返回的观测文本。模型在第 轮生成的高层动作 是一串长度为 的 Token 序列 ,其条件概率由自回归链式法则分解为:
这就把双层粒度彻底打通了:环境在每个交互步 接收完整的 并返回转移结果,构成轨迹 ;而训练端则在展开后的每个动作 Token 上计算对数概率、重要性比率与策略梯度。
在多任务集合 中,系统对第 个任务的第 个样本 采样 条轨迹,组成一个 GRPO 采样组 ,先计算组内相对优势:
再代入标准 PPO 裁剪代理目标(公开源码还叠加了系数为 的参考模型 KL 损失):
2.2 拆掉全局同步墙:Rollout 与 Learner 双池解耦及吞吐实测
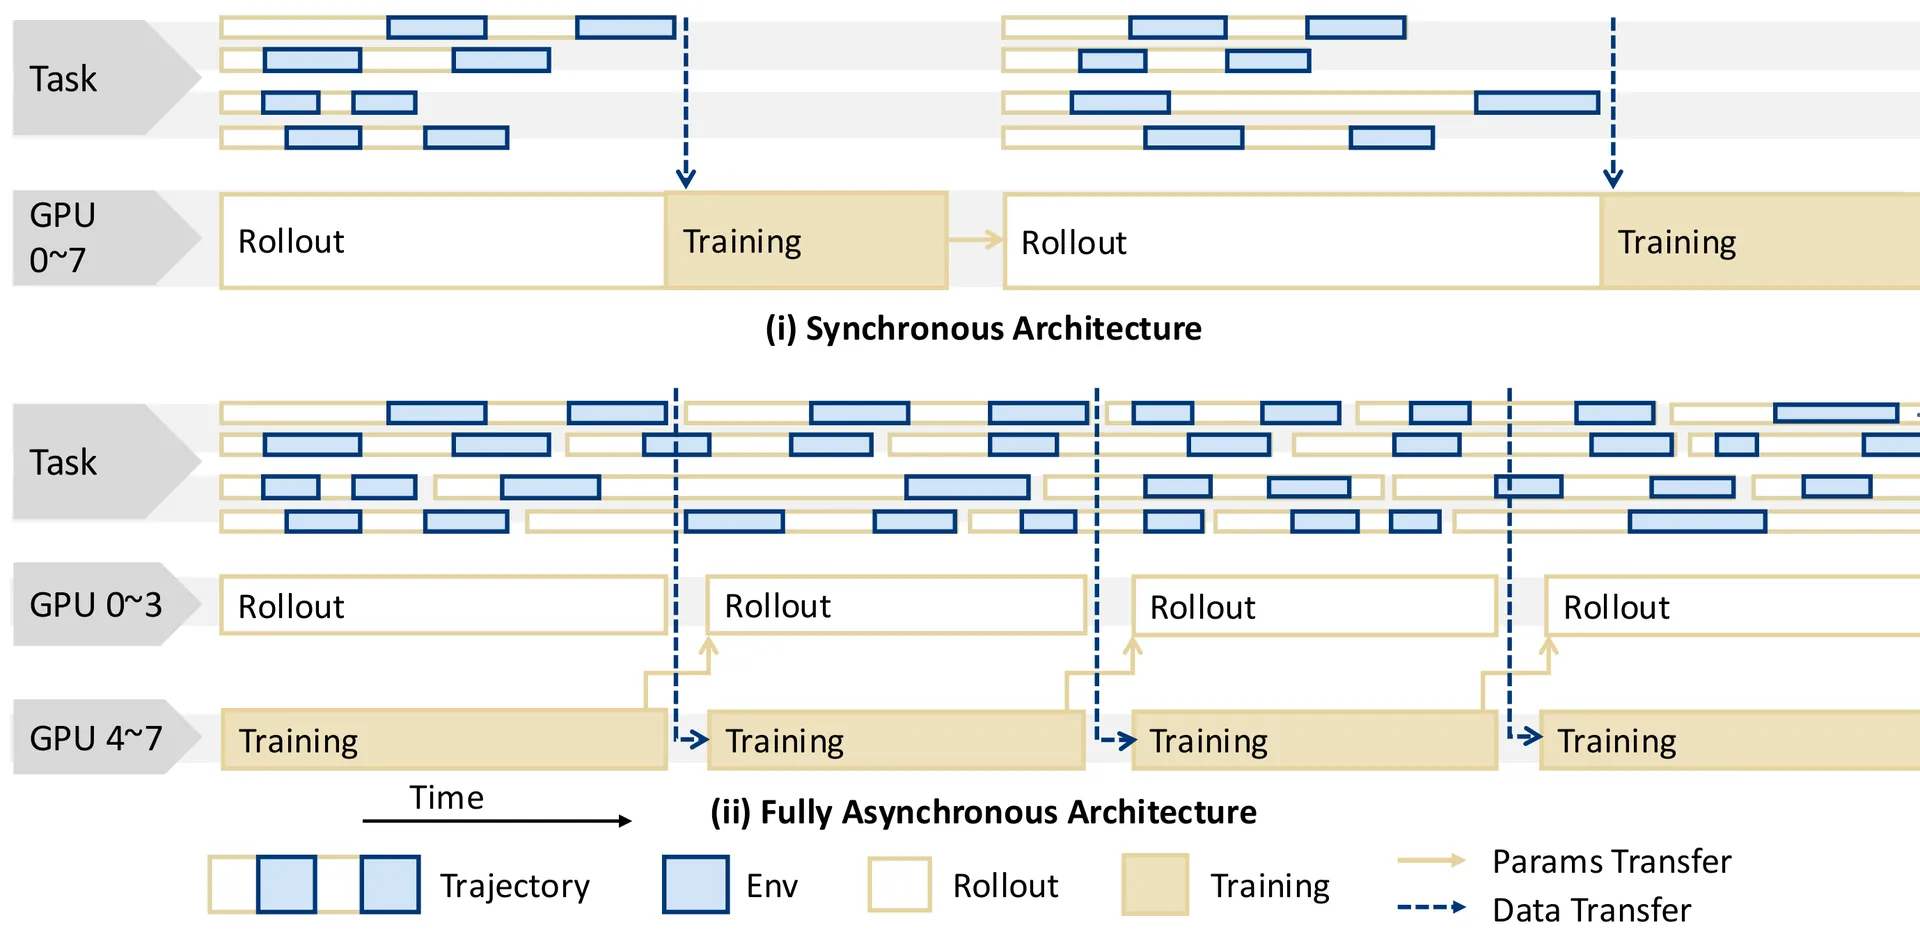
看上图(Fig. 3)对同步架构与 AgentRL 异步架构的对比:
- 在上半图的同步训练(Synchronous Training)中,所有 GPU 先集体扮演 Rollout 角色去跑多轮环境交互;由于不同任务、不同样本的交互轮数悬殊,早早跑完的通道只能空转等待最慢的那条轨迹,等整批 2048 条轨迹全部收齐后,所有 GPU 再集体切换成 Training 角色更新参数。时间轴上大片大片的灰色区域全部是白白浪费的算力空泡。
- 在下半图的 AgentRL 全异步训练(Fully-Asynchronous Training)中,GPU 集群被物理切分为常驻的 Rollout Group 与 Training Group。数百个异步任务协程源源不断地向 Rollout GPU 喂入多轮交互请求,完成的采样组直接流入数据队列;另一边的 Learner GPU 只要从队列里拉够最小批次下限,就立刻开火更新参数并通过高速网络把新权重推回推理端。
rollout GPU pool:  continuously run multi-turn agent sessions ---------->
learner GPU pool:       pull ready groups -> update -> pull -> update -->
NCCL weight stream:                        broadcast latest weights ---->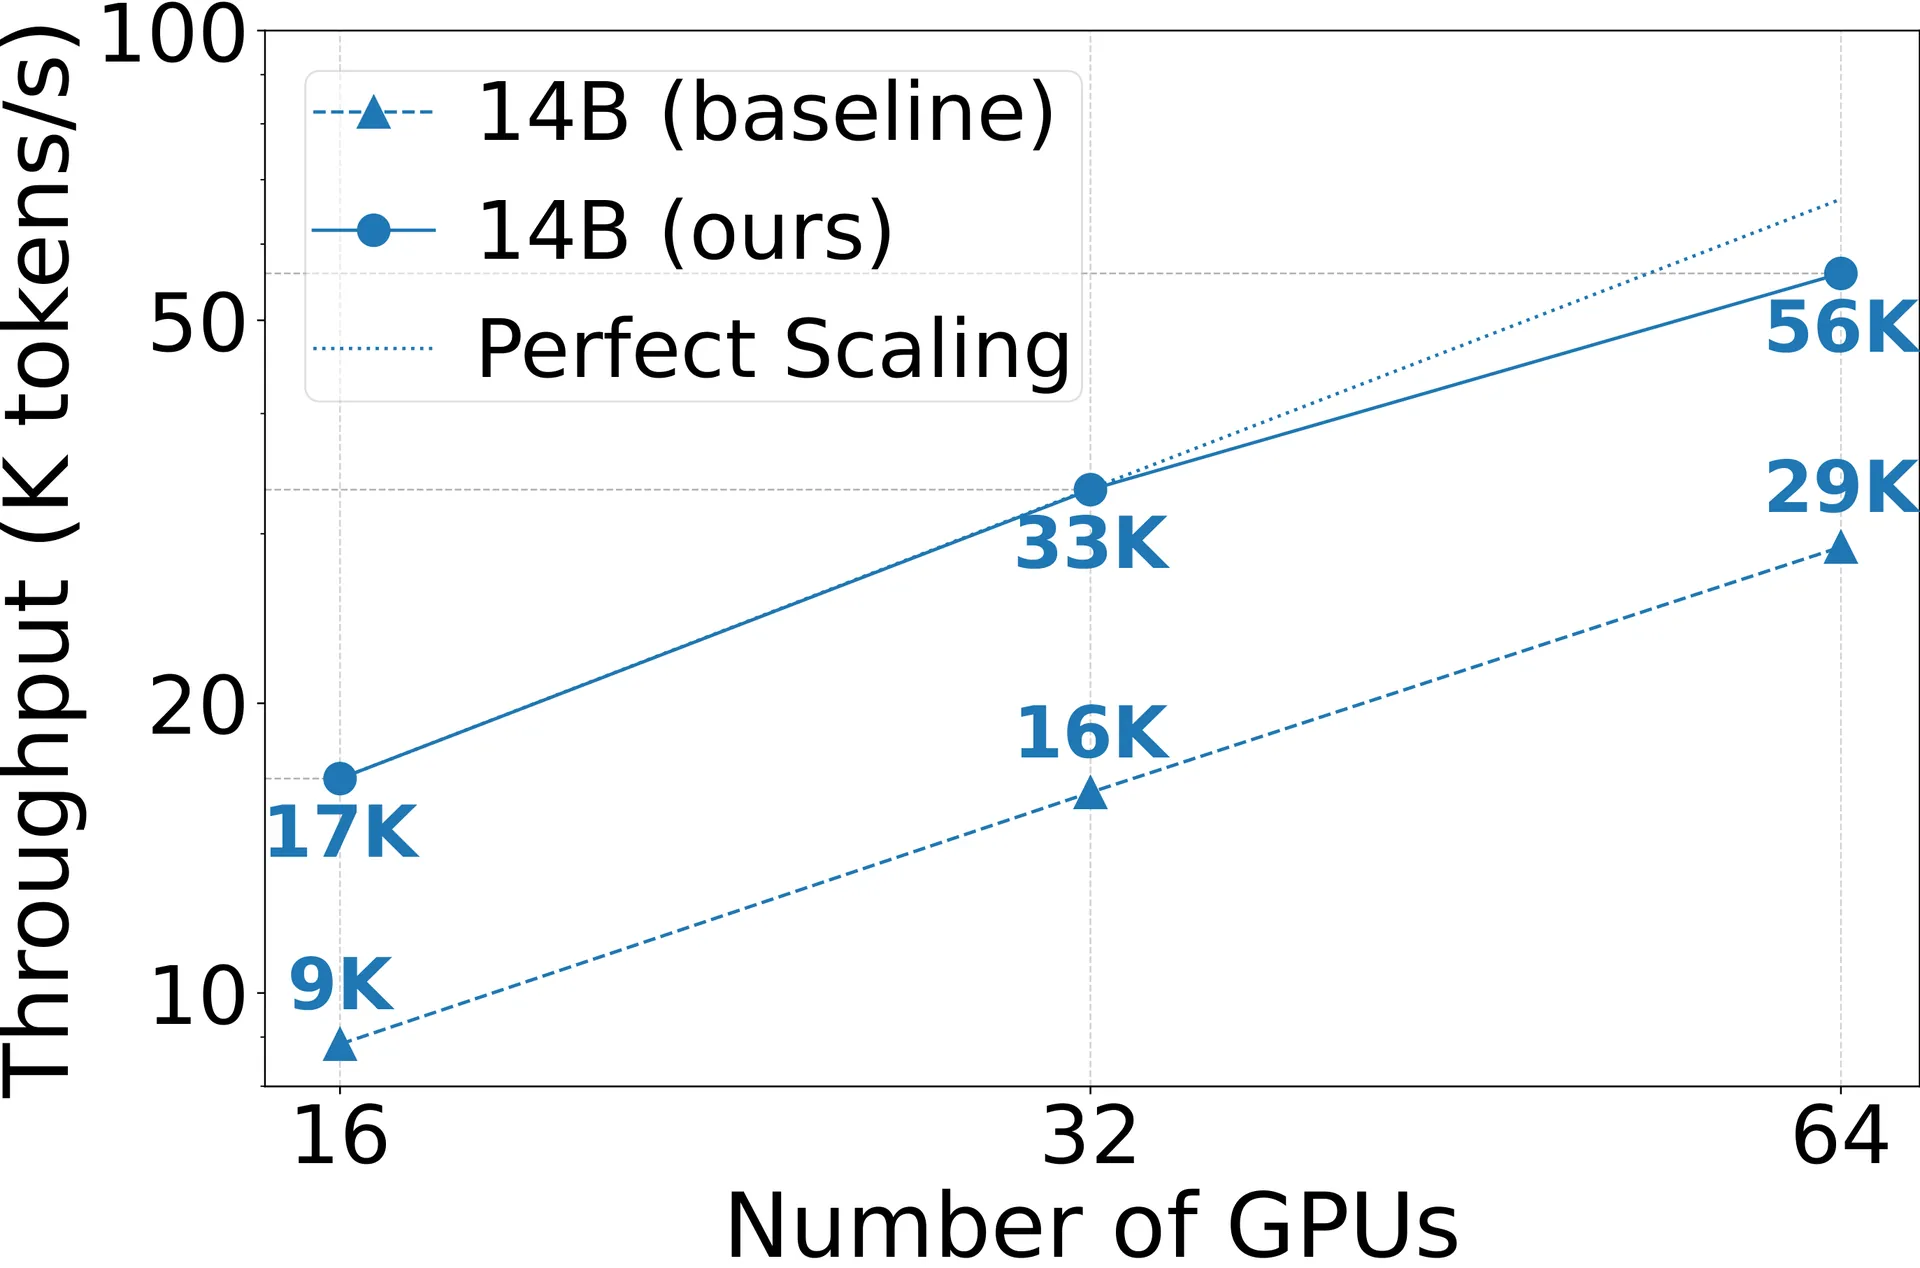
这种物理切分与流水线解耦究竟能省下多少时间?看上图(Fig. 4)在 Qwen2.5-14B 与 WebShop 环境上的实测吞吐曲线(双对数坐标,单位为千 Token/秒):
- 16 张 GPU 时:同步基线吞吐为
9K tokens/s,AgentRL 达到17K tokens/s(提升 1.89 倍); - 32 张 GPU 时:同步基线为
16K tokens/s,AgentRL 达到33K tokens/s(提升 2.06 倍); - 64 张 GPU 时:同步基线为
29K tokens/s,AgentRL 达到56K tokens/s(提升 1.93 倍)。
从 16 卡扩展到 64 卡,AgentRL 始终稳定保持着接近同步方案 两倍 的有效吞吐率。
2.3 源码深挖:Buffer 里的真实异步边界与 NCCL 直连权重广播
很多读者看到论文里的“Fully-Asynchronous(全异步)”字眼,会下意识以为“每一条轨迹一跑完就会立刻被 Learner 拿去算梯度”。但如果我们打开官方仓库的 trainer/src/agentrl/trainer/components/buffer.py,就能看清它在工程上的真实同步边界:
class Buffer:
    def __init__(self, max_size, group_size):
        self.strict_group = group_size > 1
        self.group_size = group_size
        self.groups = {}
        self.queue = deque()

    async def add(self, item):
        if self.strict_group:
            group_id = item["group_id"]
            self.groups.setdefault(group_id, []).append(item)
            if len(self.groups[group_id]) >= self.group_size:
                self.queue.extend(self.groups.pop(group_id))
        else:
            self.queue.append(item)
看这段只有十几行的核心代码,设计非常讲究:
- 以
group_id为屏障的二级缓冲:当使用 GRPO(group_size = 8)时,self.strict_group为True。每当一条轨迹从环境里跑完调add(item),它首先被放进暂存字典self.groups[group_id]里;只有当同一个group_id的 8 条兄弟轨迹全部到齐(len >= 8)时,这 8 条轨迹才会被一把从self.groups弹出并追加进真正对 Learner 可见的就绪队列self.queue! - 动态批次拉取与公倍数对齐:当 Learner 调用
get(minimum, multiple)取数时,Buffer 不仅保证至少取出minimum条轨迹,还会把当前self.queue里所有已经攒够的完整组尽可能全部搬走(对齐到group_size与 FSDPmultiple的最小公倍数),从而最大限度清空队列积压、压低数据陈旧度(Staleness)。
也就是说,AgentRL 实现的是 “跨采样组全异步(Cross-Group Async)+ 组内 8 轨迹聚拢(Intra-Group Sync)”:不同问题之间谁先凑齐 8 条谁就先插队进训练,彻底消除了“全批次 256 个问题共 2048 条轨迹必须一起等最慢那条”的全局屏障;同时通过在 self.groups 字典里等待同组 8 条轨迹到齐,保证了 GRPO 优势公式里的组内均值与标准差永远完整可用。
而在参数同步链路上,agentrl_trainer.py 完全绕开了缓慢的磁盘 Checkpoint 读写:Actor 的 rank 0 进程在初始化时直接创建 NCCLTensorSender,与所有 SGLang Rollout Worker 上的 NCCLTensorReceiver 组建跨进程通信组,每完成一步优化就通过 GPU 显存直连把最新权重刷进推理引擎。
3. 核心设计哲学二:统一环境控制面与多轮掩码契约
3.1 算力层与沙箱层解耦:中央 Controller 与容器化 TaskWorker
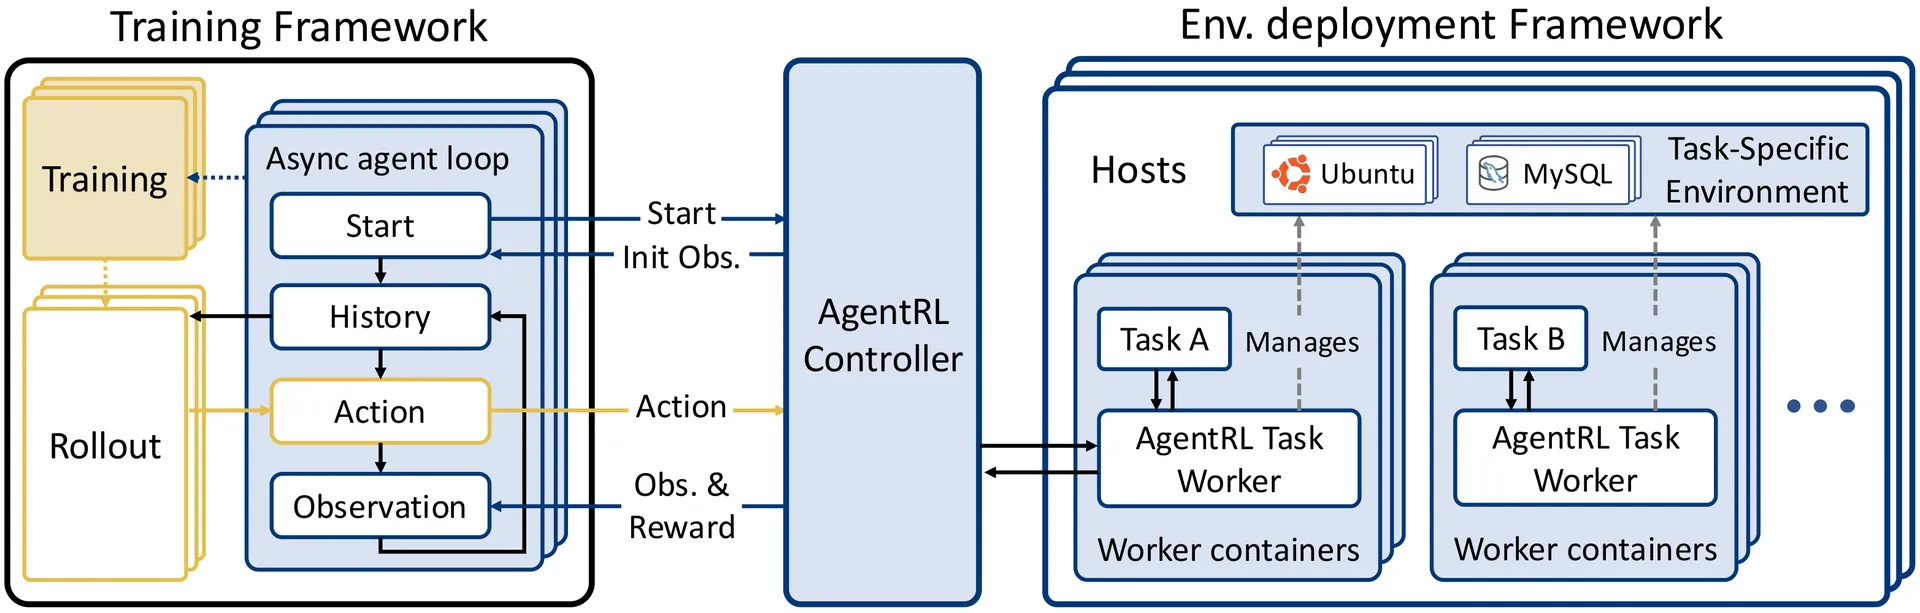
为什么 AgentRL 要像上图(Fig. 5)那样,把系统一切为二——左边是跑在 GPU 集群上的 Training Framework,右边是跑在多台 CPU 宿主机上的 Environment Deployment Framework,中间用一个 AgentRL Controller 隔开?
因为大模型算力与真实工具沙箱的资源脾气完全相反:
- 左边(Rollout & Learner)是典型的显存与矩阵计算密集型负载,最怕进程阻塞或网络 I/O 卡顿;
- 右边(Task Workers & Containers)则是典型的 CPU、磁盘 I/O 与状态隔离密集型负载——跑一句复杂的 SQL 联表查询、在 Docker 容器里起一个 Ubuntu 子进程或者渲染 WebShop 页面,随时可能遇到死锁、超时或容器崩溃。
通过引入用 Go 语言编写的高并发中央 Controller(设计支持高达 10,000 个并发会话路由与心跳管理)以及挂载在各台物理机上的 Python/FastAPI TaskWorker,训练框架彻底摆脱了对具体环境细节的依赖:不管底层新增的是移动端 GUI 模拟器还是 Kubernetes 沙箱,左边的大模型训练代码一行都不用改。
3.2 统一 OpenAI Function-Call 原语与模板差分 Token 掩码
为了把五花八门的异构环境装进同一个训练循环,AgentRL 将 AgentBench 的所有任务全部重构成标准的 OpenAI Function Call 协议。每个环境的 TaskWorker 只需要向 Controller 注册三个生命周期接口:
start(task sample)
  -> session_id + initial messages + tool JSON schemas

observation(session_id, assistant message / tool call)
  -> new environment messages + step reward + status + finish flag

end(session_id, done)
  -> release container session and clean up temporary state
当一段多轮交互跑完,怎么把夹杂着系统提示词、用户指令、模型思考、函数调用 JSON 和环境返回结果的对话历史,变成精确对齐的训练张量?我们直接看 trainer/src/agentrl/trainer/agentic/loops.py 中的 openai_chat_agent_loop() 源码:
第一步,会话启动拿到初始消息后,用 Tokenizer 的 Chat Template 编码出初始 ids,并将这些非模型生成的输入位置全部标记为 loss_mask = 0。
第二步,在每一轮循环中,调用推理引擎生成模型回复,并当场记录每个生成 Token 的 ID 与行为对数概率 received_log_probs:
text, received_log_probs = await gen_fn(input_ids=ids)
new_ids = [token_id for log_prob, token_id in received_log_probs]
new_log_probs = [log_prob for log_prob, token_id in received_log_probs]

ids += new_ids
loss_mask += [1] * len(new_ids)
log_probs += new_log_probs
注意这里所有由模型自己采样出来的 Token,loss_mask 都被严格设为 1,同时把采样时刻真实的 new_log_probs 存入 log_probs。
第三步,FunctionCallParser 将模型文本解析为结构化工具调用发给 Controller;拿到环境返回的观测消息后,代码利用前后两次 Chat Template 编码的差分,精准抠出新增的环境观测 Token(observation_ids)追加到序列中:
ids += observation_ids
loss_mask += [0] * len(observation_ids)
log_probs += [0] * len(observation_ids)
环境观测 Token 的 loss_mask 和占位对数概率全部被设为 0!这样一来,在拼接而成的完整上下文序列中,模型后续的每一轮动作都能通过自注意力看到前面的所有环境反馈,而在反向传播算 PPO 损失和任务优势归一化时,只有 loss_mask == 1 的模型动作 Token 会参与计算。此外,如果交互达到最大轮数(max_turns = 20)或最大长度(max_total_len = 8192)时会话状态仍未达到正常结束(completed),循环会自动给该轨迹打上 incomplete_punishment = -0.2 的超时惩罚,逼迫智能体学会在有限步数内干净利落地收尾。
4. 核心设计哲学三:化陈旧为探索——跨策略采样(Cross-Policy Sampling)
4.1 为什么多轮自采样会陷入“探索坍缩”?支持集严格扩张的直觉
在单轮强化学习里,如果觉得模型探索不够,把采样温度(Temperature)调高一点通常就够用了。但在多轮智能体交互中,“探索坍缩”(Exploration Collapse)是一个结构性难题。
想象一个知识图谱(KG)或数据库(DB)任务,完成它需要连续走对 5 步工具调用:
- 模型 A 很擅长前 2 步的关系拆解,但一到第 3 步需要调用聚合计数工具时,它因为预训练偏见总是习惯用肉眼数而忘了调工具,导致第 3 步之后永远走不通;
- 模型 B 前两步规划经常跑偏,但它只要看到分解好的中间列表,就非常积极地调用聚合计数工具。
如果让模型 A 自己采 8 条轨迹训自己,它采出的 8 条轨迹全都在第 3 步卡死,拿到一模一样的 0 分,组内相对优势全为 0,永远学不会第 3 步;同理,模型 B 自己训自己也因为前两步总是走错而拿不到正奖励。
AgentRL 提出的 Cross-Policy Sampling(跨策略采样)正是为了打破这种单策略死锁:不再让同一个策略包办整条轨迹的所有轮次,而是维护一个策略池 ,在多轮轨迹的每一个交互步 ,随机从策略池里抽一个模型来生成当前步的动作:
论文在附录中给出了一个非常漂亮的集合论形式化直觉:设 Grounding 映射 将合法的语言上下文映射为外部环境状态分布。如果成功完成任务的目标环境状态集合为 ,那么所有能通向成功状态的合法语言轨迹集合(成功原像)就是:
当策略池 中的不同策略具备互补的局部动作分布时,步骤级交替采样生成的跨策略轨迹支持集 ,在成功区域上的覆盖范围将严格大于各个单模型独立采样支持集的并集:
用大白话讲:让模型 A 走前两步,第 3 步切换成模型 B 触发工具调用,就能拼出一条无论是模型 A 还是模型 B 单独跑都极难采到的全新成功路径!一旦这条成功轨迹进了训练池,当前策略就能把这条打通了任督二脉的路径内化成自己的能力。
4.2 轨迹级混合(Mix)与步骤级切换(Cross)的本质差异
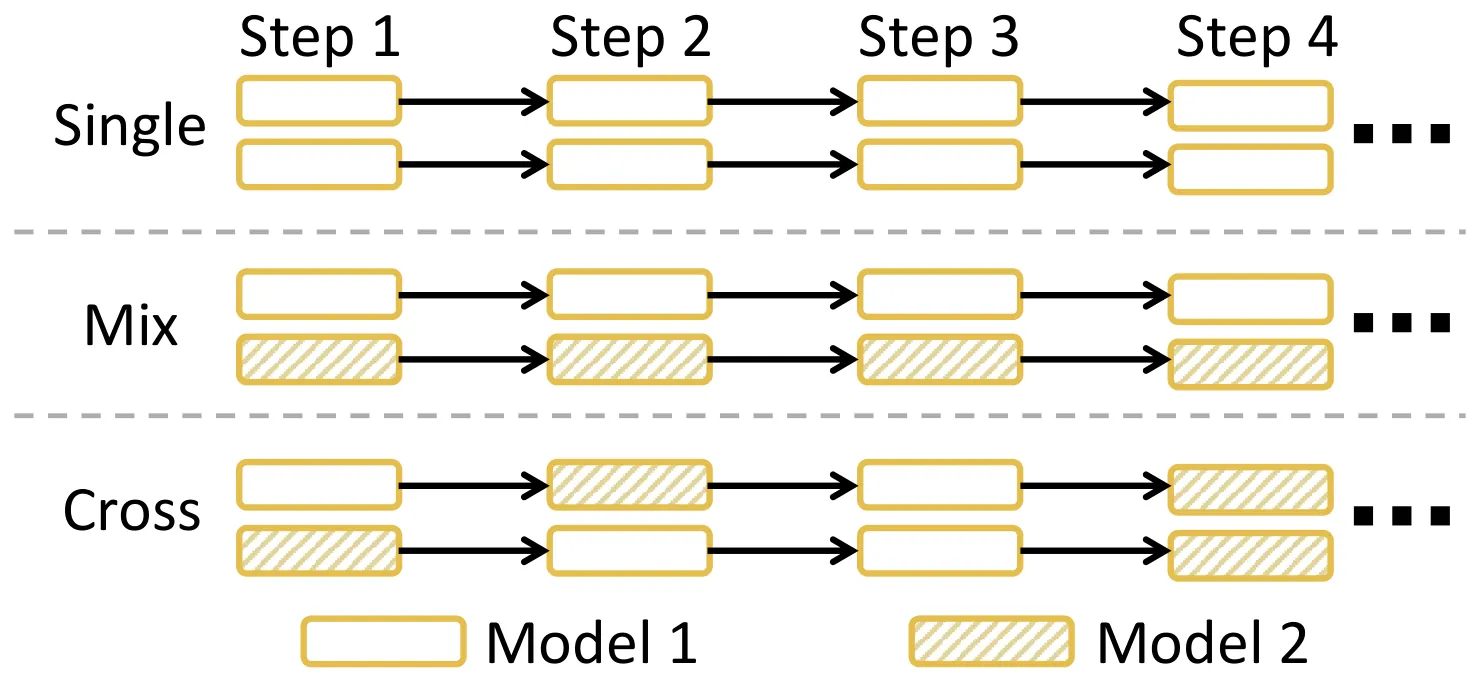
看上图(Fig. 6)对三种采样模式的对比,很容易看清为什么很多团队做多模型混合采样效果不佳:
- Single(单策略采样):每条轨迹从头到尾由单一模型生成,可达范围是 ;
- Mix(轨迹级混合):50% 的完整轨迹由模型 1 从头跑到尾,另外 50% 的完整轨迹由模型 2 从头跑到尾。注意,Mix 的可达成功路径最多只能等于两个模型各自成功集合的简单并集 ——如果一道题必须靠模型 1 的前半程规划加模型 2 的后半程工具调用才能解开,Mix 采一万条也凑不出一条成功样本;
- Cross(步骤级跨策略采样):在同一条轨迹内部的 Step 1 用 、Step 2 切到 、Step 3 再切回 ,真正实现了单条 Episode 内部的跨策略行为嫁接。
4.3 源码落地:用滞后 25 步的 Stale Rollout Engine 近似策略池
理论很丰满,但到了在线强化学习训练时,怎么低成本地构造这个策略池 ?总不能在训练 Qwen2.5-14B 的时候,还在旁边额外常驻一个 Llama 和一个 GLM 陪跑吧?而且异构模型之间的 Tokenizer 和特殊 Token 格式还不兼容。
AgentRL 的工程解法堪称神来之笔:直接利用强化学习训练自身在时间轴上产生的“历史版本模型”来充当异构策略池!
回想一下,在 RL 训练过程中,25 步之前的旧模型(Stale Policy)与刚刚更新完的当前模型(Current Policy)虽然共享完全相同的模型架构和 Tokenizer,但它们的动作分布已经发生了分化——当前模型可能已经对某些高频工具形成了强烈偏好(但也可能因此变得狭隘),而 25 步前的旧模型还保留着更早期、更发散的探索倾向。
打开 examples/training/agentrl_trainer.py 和配置文件 qw14b_waodk.yaml,看看源码是怎么用寥寥几行实现这套机制的:
rollout_ratio: 0.5
rollout_stale_ratio: 0.25
stale_step: 25
task_adv_norm: true- 物理切分新旧两个推理池:系统先把集群 50% 的 GPU 分给推理侧(
rollout_ratio: 0.5),然后再从推理 GPU 里切出 25% 单独组建一个陈旧推理池rollout_stale(剩下 75% 组建实时推理池rollout)。 - 双速权重同步:每当 Actor 完成一步梯度更新,立刻通过 NCCL 把新权重广播给实时池
rollout;而只有当全局步数满足global_step % 25 == 0(stale_step: 25)时,才把权重同步给陈旧池rollout_stale。 - 单步随机路由(
cross_sampler):在多轮交互循环中,智能体每准备生成一步动作,都会调用cross_sampler:
def cross_sampler(item, **kwargs):
    if rollout_stale is None:
        return rollout.dispatch_rank(...).generate(**kwargs)
    if random.random() < (1 - stale_ratio):
        return rollout.dispatch_rank(...).generate(**kwargs)
    return rollout_stale.dispatch_rank(...).generate(**kwargs)
每一次工具调用前,系统掷一枚硬币:以 75% 的概率 调实时引擎 rollout,以 25% 的概率 调滞后至多 25 步的陈旧引擎 rollout_stale!
无论这一步抽中的是实时引擎还是陈旧引擎,生成动作时都会把该引擎真实的 Token 对数概率写进 rollout_log_prob。这样既在单条多轮轨迹内部实现了新旧策略的交替探索,又为后续 PPO 损失计算提供了真实的行为策略分母,配合 clip_ratio = 0.2 与 kl_loss_coef = 1e-4 将离策偏移控制在安全范围内。
5. 核心设计哲学四:双层优势归一化与多任务联合训练主链
5.1 为什么有了 GRPO 组内归一化,多任务还是会互相打架?
既然我们已经对每个 Prompt 的 8 条轨迹做了 GRPO 组内归一化 ,按理说每个采样组内部的均值都已经变成 0、标准差变成 1 了,为什么把 5 个任务混在一起训练时,不同任务之间还是会发生严重的梯度干扰?
这里藏着两个在多轮 Token 级优化中极易被忽视的统计偏差:
- 组内奖励退化与离散分布差异:在二值奖励(成功得 、失败得 )加超时惩罚()的设定下,一个只有 8 条轨迹的小组里,离散奖励的组合形态非常有限;不同任务的当前平均成功率(比如 ALFWorld 成功率 80%,OS 成功率 35%)与超时率截然不同,导致展开到每个动作 Token 后,不同任务在批次内的实际有效优势方差依然存在显著差距。
- 单轨迹有效动作 Token 长度的悬殊差异:在组级优势 算出后,它会被广播给这条轨迹里所有
loss_mask == 1的动作 Token。在 WebShop 或 ALFWorld 里,一条成功轨迹可能走了 15 轮、包含 1500 个动作 Token;而在 DB 任务里,一条成功轨迹可能只写了 2 轮 SQL、包含 120 个动作 Token。如果不按任务维度对所有有效动作 Token 做二次校准,Token 数量庞大或优势分布偏移的任务就会在批次梯度求和中占据压倒性权重。
为此,AgentRL 在 GRPO 组内归一化之后,紧接着设计了第二层归一化——Task Advantage Normalization(任务级优势归一化)。
具体而言,在一个训练批次内,针对第 个任务,先将该任务下所有样本 、所有组内轨迹 、所有交互步 中属于模型生成的有效动作 Token()的优势值全部收集到一个大集合 中:
然后,以任务 为单位,计算该任务全体有效动作 Token 的均值 与标准差 ,做任务内二次标准化:
在源码 adv_norm(items) 中,程序按每个样本的 data_source 字段将批次切分为 5 个任务桶,分别用 loss_mask 掩码提取有效位置拼成一维向量求出 mean 和 std(分母加 1e-6 防除零),再原地标准化。这两层归一化的分工极其明确:第一层 GRPO 负责在“同一个问题内部”分出高下;第二层 Task Advantage Normalization 负责在“五个异构任务之间”拉平梯度量纲。
5.2 从配置解析到单步更新:14B 五任务训练主链走读
把异步 Buffer、跨策略采样器、多任务交错加载器与双层优势归一化组装在一起,agentrl_trainer.py 中的完整训练循环可以分为清晰的十个步骤:
- 解析配置与划分算力:读取 YAML 配置(如
max_steps: 1000、batch_size: 256、n: 8、concurrency: 2048),按比例计算rollout、rollout_stale与actor的 GPU 数量。 - 创建 Ray Placement Groups:在集群上锁定三组物理资源,其中 Actor 与 Reference 模型通过
num_gpus=0.5共享训练侧 GPU 显存。 - 拉起分布式 Worker 句柄:通过
spawn()实例化AsyncSglangWorker(推理侧)与FSDPWorker(训练侧,fsdp_size: 16,单微批次上限max_tokens_per_micro_batch: 16384)。 - 初始化模型与优化器:构建 SGLang 引擎、FSDP Actor 模型、学习率为
1e-6的优化器、Checkpoint 管理器以及冻结的 Reference 模型。 - 建立 NCCL 权重通道:将 Actor rank 0 的
NCCLTensorSender注册到全体 Rollout Worker 的NCCLTensorReceiver,并在开训前完成首次全量权重对齐。 - 启动多任务交错采样流:为 5 个环境分别构建独立 DataLoader,每个 Prompt 重复
n=8次并赋予唯一group_id,再通过interleave()与无限cycle()均匀交错推入 Ray Queue,由 2048 个并发协程驱动openai_chat_agent_loop与中央 Controller 交互。 - 成组入队与预热拉取:完成的轨迹进入
Buffer;在训练第 0 步,Learner 等待队列攒够 条轨迹完成 Buffer 预热,后续每步拉取至少real_bsz = 256 * 8 = 2048条完整成组轨迹。 - 计算双层归一化优势:先算 8 轨迹组内 GRPO 优势,再按
data_source执行adv_norm()任务级 Token 标准化。 - 前反向传播与梯度更新:Reference 模型前向算出
ref_log_prob,Actor 模型按动态打包的微批次前反向计算 PPO 裁剪损失与 KL 正则损失,执行optimizer.step()。 - 双速广播与周期评测:每步结束立即向
rollout池广播最新权重;每满stale_step = 25步向rollout_stale池广播一次权重;每隔固定步数在验证集上用rollout池(重复评估val.n = 4次)检验各任务成功率并保存 Checkpoint。
6. 实验验证、跨策略案例剖析与消融拆解
论文在改装为统一函数调用协议的 AgentBench-FC 五大交互环境——ALFWorld(AF,家居具身规划)、Database(DB,SQL 探查与查询)、Knowledge Graph(KG,图谱多跳检索)、Operating System(OS,Bash 终端交互)与 WebShop(WS,电商搜索购买)——上进行了全面实验,覆盖 Qwen2.5-3B/7B/14B/32B-Instruct 四个规模档位以及异构家族的 GLM-4-9B。
6.1 五类异构环境主实验与通才 vs. 专才对决
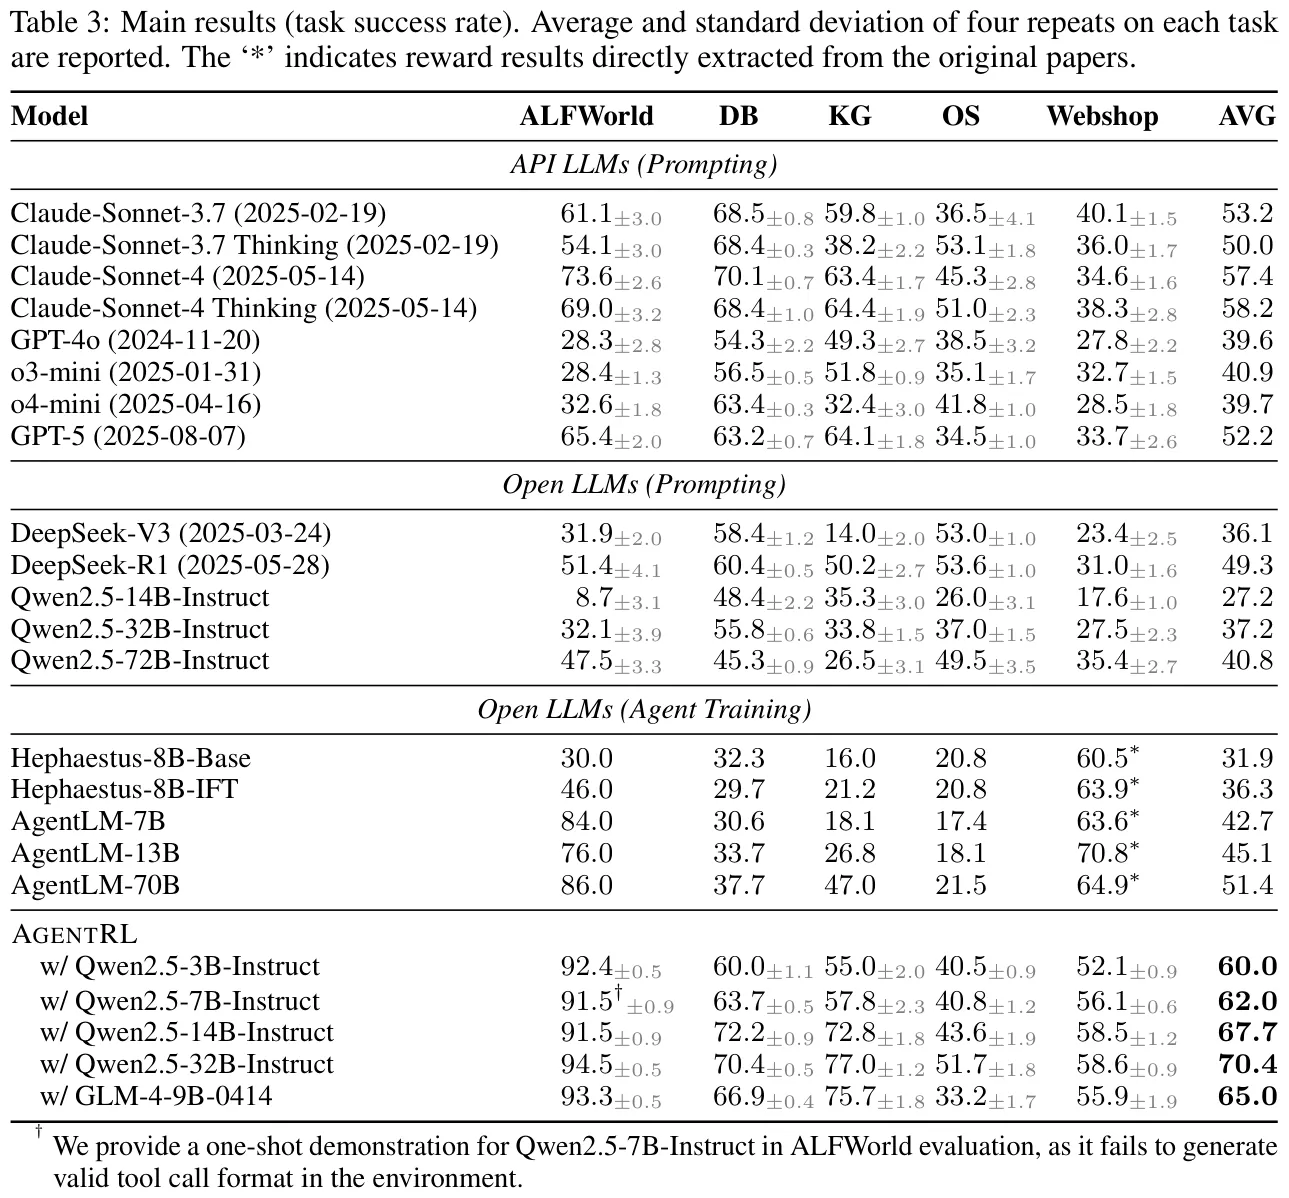
观察上面这张五任务主实验表(Table 3,每项任务连续评估 4 次报告均值与标准差),我们可以读出三层极具含金量的实验结论:
- 小模型经在线 Agentic RL 后即可跨代反超:未经环境强化学习的
Qwen2.5-14B-Instruct基座平均成功率只有27.2%(其中 ALFWorld 仅8.7%,WebShop 仅17.6%),32B基座也只有37.2%。而经过 AgentRL 五任务联合训练后,哪怕是最小的Qwen2.5-3B模型,平均成功率也一举冲到了60.0%(ALFWorld 飙升至92.4%),不仅反超了大自己十倍的 32B 原始基座,还超过了表中直接采用提示式(Prompting)评测的 Claude-Sonnet-4 Thinking(58.2%)、GPT-5(52.2%)与 DeepSeek-R1(49.3%)。 - 随参数规模扩展的稳健 Scaling Law:沿着
AgentRL-Qwen2.5的四个尺寸往上走,五任务平均成功率从 3B 的60.0%7B 的62.0%14B 的67.7%32B 的70.4%稳步递增。特别是在需要深层逻辑与精确语法的 KG(从 3B 的55.0%涨到 32B 的77.0%)和 OS(从40.5%涨到51.7%)两个硬骨头环境上,大模型的底座容量在强化学习中得到了充分兑现。 - 跨模型家族同样奏效:在经历少量冷启动 SFT 对齐函数调用格式后,
GLM-4-9B在 AgentRL 下同样拿到了65.0%的平均成功率(其中 KG 达到75.7%),证明这套框架并不挑特定模型底座。
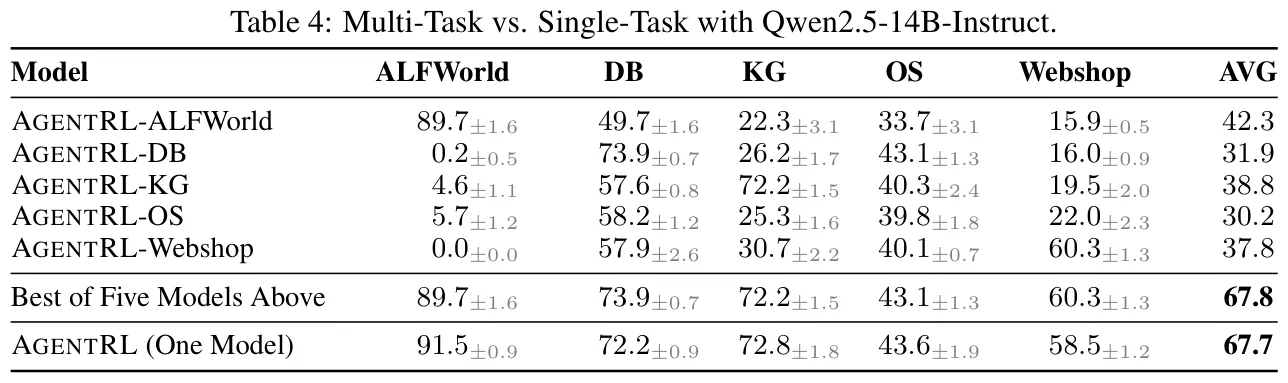
比主表更精彩的是上面这张 “单任务专家 vs. 多任务通才”(Task-Specific Specialists vs. Multi-Task Generalist)对照表(Table 4,基于 Qwen2.5-14B):
- 单任务强化学习的灾难性偏科:看表中前五行,如果你只拿某一个环境的数据去训 RL,模型确实能在该环境上刷出高分,但它在其他四个环境上的能力会遭受毁灭性打击!最典型的是第 5 行
AgentRL-WS(只在 WebShop 上训):它的 WebShop 成功率达到了60.3%,可一旦把它放到 ALFWorld 里,成功率直接从基座的8.7%跌成了0.0%;放到 DB 里也从48.4%腰斩到24.8%,五任务平均分甚至跌到了25.3%(比不训 RL 的基座27.2%还低)!原因在于单环境 RL 会让模型把所有的函数调用先验死死绑定到特定网站的按钮格式上,彻底破坏了通用工具协议。 - 一套权重追平五个专家的组合上限:如果把五个单任务专家各自最擅长的那一列成绩挑出来拼成一个虚拟的“全明星组合(Best Specialist per Column)”,平均分是
67.8%(89.7 / 73.9 / 72.2 / 43.1 / 60.3)。而底部的单个 AgentRL 多任务模型,仅靠一套 14B 权重同时应付五个环境,就拿下了67.7%的平均分(91.5 / 72.2 / 72.8 / 43.6 / 58.5)——不仅消除了跨任务遗忘,甚至在 ALFWorld、KG 和 OS 三个环境上反超了专门只训该任务的单科状元!
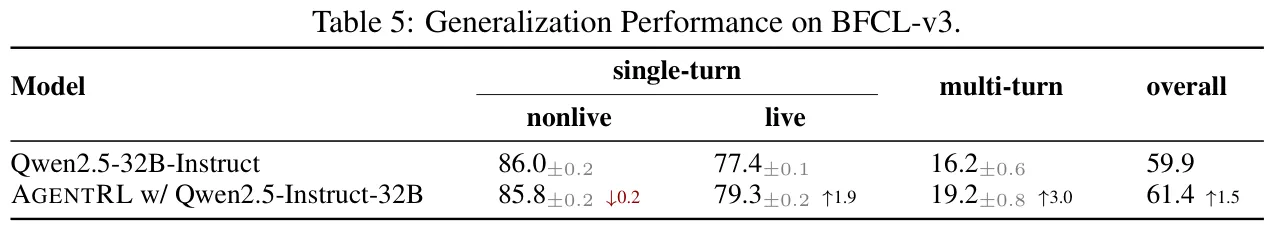
那在五个固定环境上训完 RL,会不会把模型在陌生工具上的通用函数调用能力训坏?看上图(Table 5)在分布外基准 BFCL-v3 上的测试结果:AgentRL-Qwen2.5-32B 在 Single-Turn Non-Live 上保持稳定(85.8% vs. 86.0%),而在需要真实交互的 Single-Turn Live(77.4% -> 79.3%)与 Multi-Turn(16.2% -> 19.2%)上均取得了正向迁移,总分从 59.9% 提升至 61.4%。
6.2 算法组件消融与跨策略协同破局实证
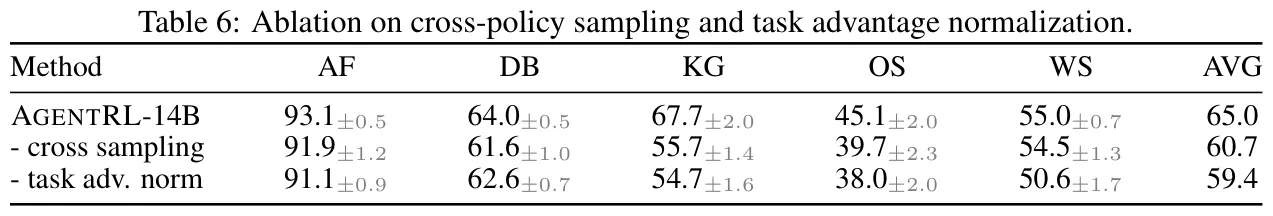
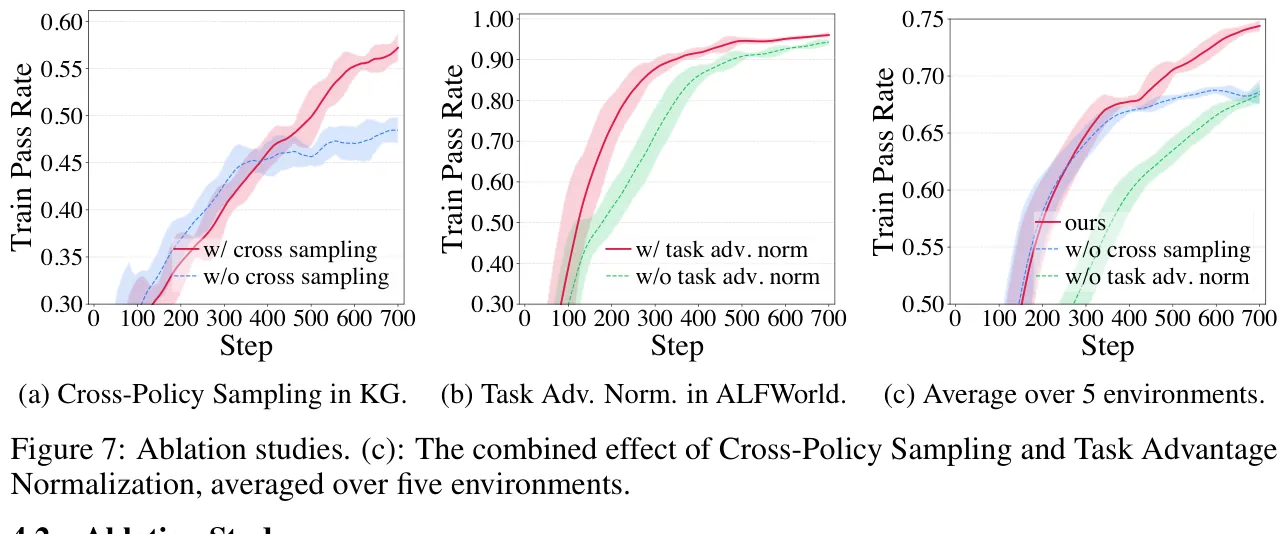
Cross-Policy Sampling 与 Task Advantage Normalization 到底各自贡献了多少功劳?看上面的一表一图(Table 6 与 Fig. 7,在 14B 模型同一阶段快照下对比):
- 去掉跨策略采样(
w/o cross sampling):五任务平均分从65.0%跌至60.7%(掉了4.3个百分点),其中多步探索空间最大的 KG 任务从67.7%断崖式暴跌至55.7%(狂掉12.0个百分点),OS 也掉了5.4个百分点!对照 Fig. 7(a) 的 KG 训练曲线看得更清楚:不加跨策略采样的紫线虽然前 200 步涨得挺快,但在第 300 步之后就早早撞上天花板躺平了;而带跨策略采样的蓝线则在 300 步之后一路向上突破,证明步骤级策略切换确实帮模型跳出了局部最优。 - 去掉任务级优势归一化(
w/o task advantage norm):五任务平均分更是从65.0%大幅跌落至59.4%(掉了5.6个百分点),KG、OS、WebShop 全面回退;在 Fig. 7(b) 的 ALFWorld 曲线上,去掉任务归一化的橙线不仅爬升极其缓慢,而且全程剧烈震荡。
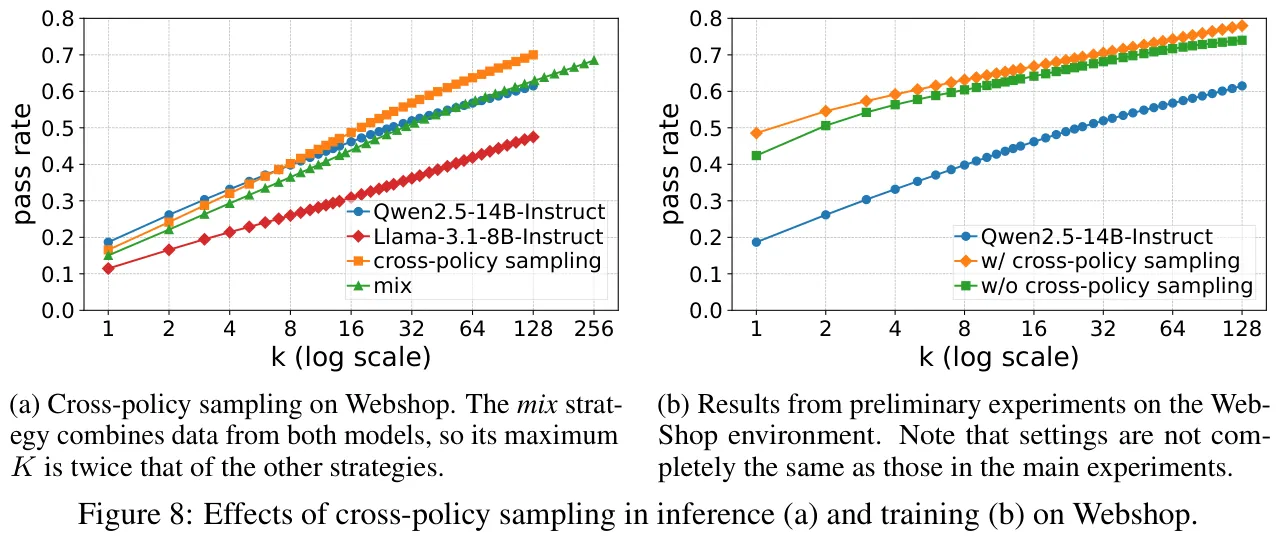
为了进一步验证“跨策略步骤级切换能扩大成功支持集”的理论直觉,作者在 Fig. 8(a) 中做了一个纯粹的推理期实验:拿 Qwen2.5-14B 和 Llama-3.1-8B 两个异构模型在 WebShop 上测 pass@k。可以看到,当只采 1~2 次(小 )时,随机切换模型的 Cross-Policy 略逊于单模型表现更好的 Qwen;但随着采样次数 增大到 8、16、32,Cross-Policy 的 pass@k 曲线强势反超了两个单模型以及轨迹级混合(Mix)!这说明当两个模型各自的套路都解不开某道难题时,在步骤间交替切换真的能碰撞出全新的通关路径。Fig. 8(b) 则显示,将这一机制转化为训练期的 Stale Engine 后,WebShop 训练前后的整个 pass@k 包络线都得到了显著抬升。
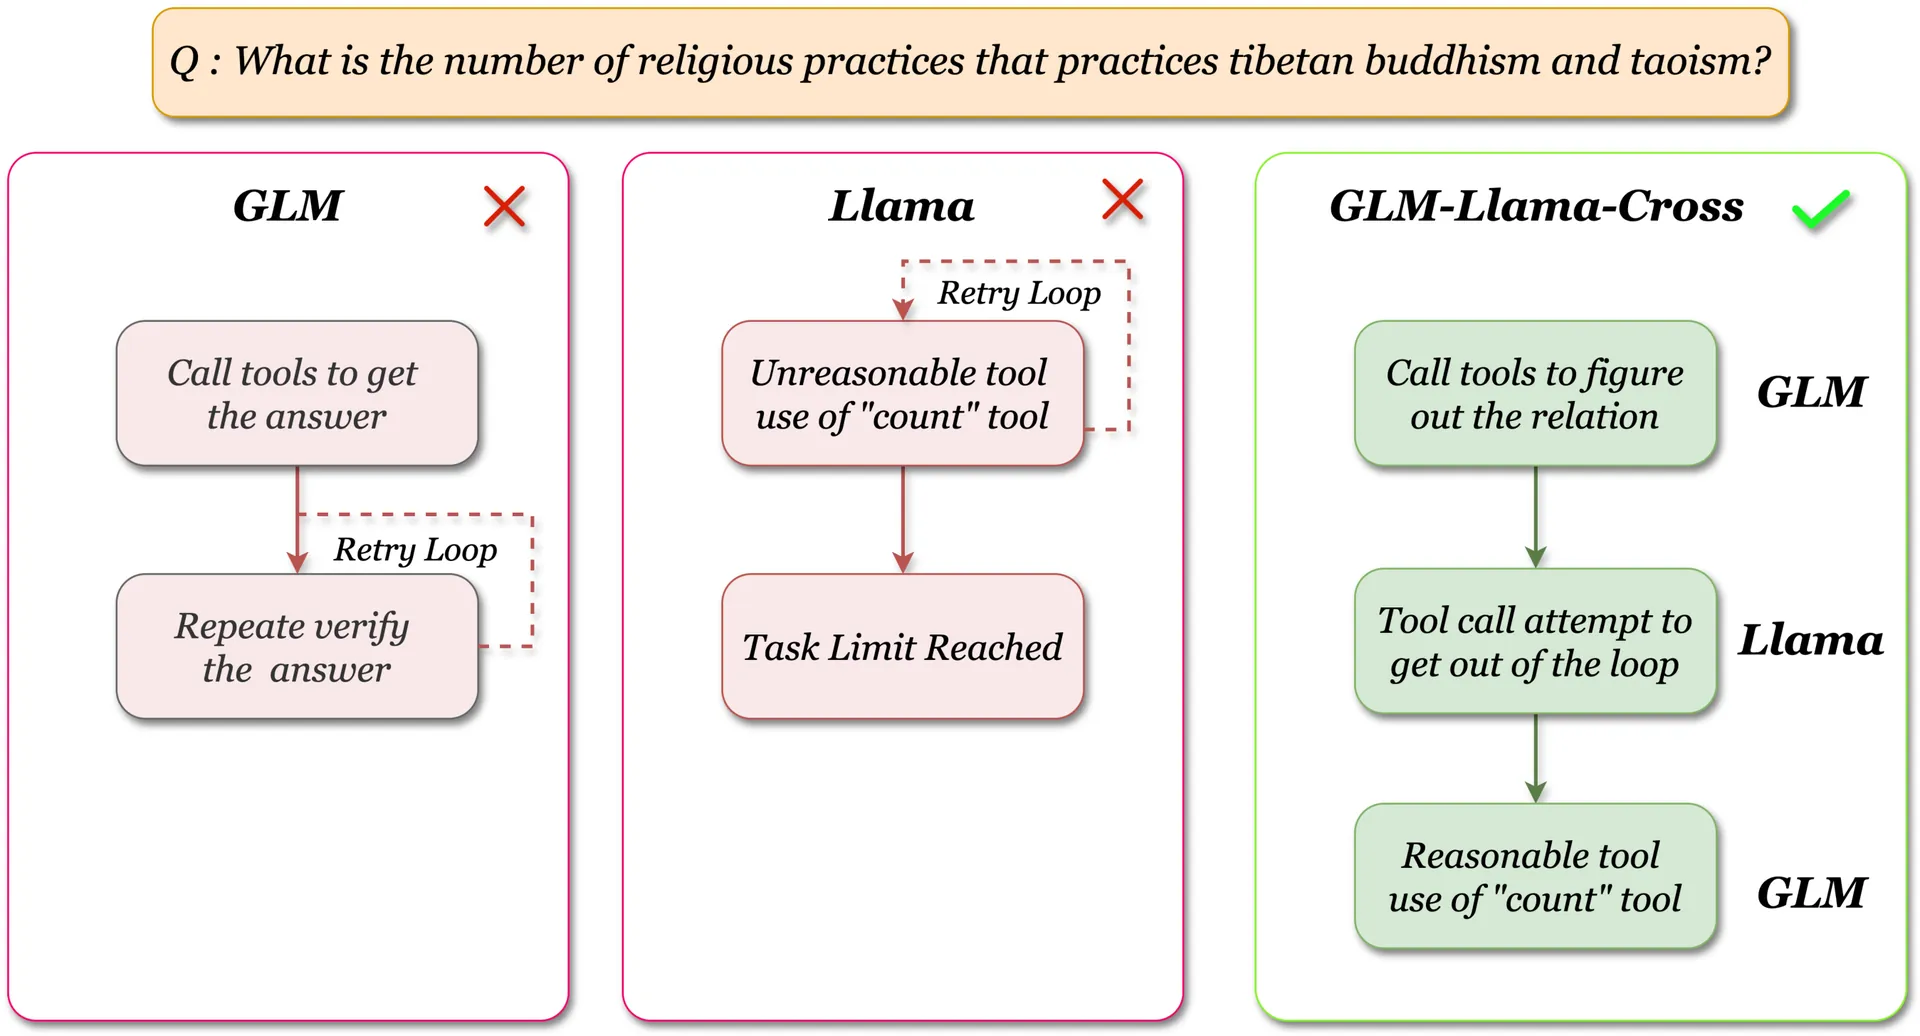
上图(Fig. 9)用一个真实的知识图谱(KG)案例,把这种“跨策略接力破局”的过程拍得一清二楚。题目要求查询*“同时包含藏传佛教与道教的宗教实践数量”*:
- 左边单跑 GLM:它准确推理出了应该先查两者的实体交集,但在拿到结果后陷入了自我怀疑的重复确认循环,迟迟不按协议调最终提交动作,直到超时失败;
- 中间单跑 Llama:它非常痛快地去调工具,却误解了
count工具的参数语义,一上来就传错参数导致连续报错,同样耗尽轮数失败; - 右边跑 Cross-Policy(GLM + Llama 步骤级交替):前几步由擅长关系规划的 GLM 把关键的实体关系查出来放进上下文;到了容易卡壳的中间步骤,接力棒切给果断调工具的 Llama 打破僵局;最后一步再切回 GLM,根据上下文里已经齐备的证据顺利调对
count并提交正确答案!
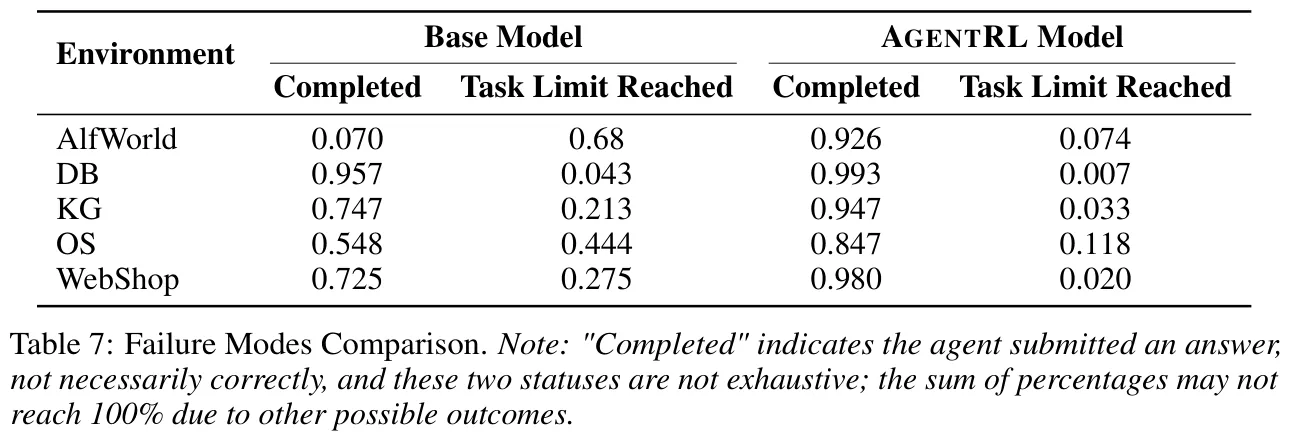
最后看上图(Table 7)对训练前后轨迹终止状态的统计:原始基座模型在 ALFWorld 中有高达 68.0% 的轨迹是因为在屋里乱转直到耗尽 20 轮上限(Task Limit Reached)而被迫中止的,在 OS 中也有 44.4% 的轨迹死于轮数耗尽。经过 AgentRL 训练并配合 -0.2 的未完成惩罚后,ALFWorld 的超时率暴降至 7.4%(主动完成提交率从 7.0% 升至 92.6%),WebShop 的超时率更是压到了 2.0%。
7. 异步 Agentic RL 生态坐标与总结
7.1 双雄对照:AgentRL 与 SAO 的异步哲学分野
把这篇 AgentRL 与我们同时精读的姊妹篇 SAO(单轨迹异步优化)放在一起对比,你会发现同一个研究团队在面对“多轮智能体异步强化学习”时,针对不同的任务形态演化出了两套截然不同却又高度互补的架构哲学:
| 核心设计维度 | AgentRL (arXiv:2510.04206) | SAO (arXiv:2607.07508) |
|---|---|---|
| 主攻任务场景 | 中长轮次(20 轮内)、多任务异构容器环境联合训练 | 超长时域(50~300 轮、128K 上下文)单任务深度推理与仓库编码 |
| 每 Prompt 采样组() | 保留 (GRPO 组采样) | 压至极致的 (Single Rollout 单轨迹流) |
| 异步队列同步边界 | 跨组全异步 + 组内 8 轨迹聚拢(Buffer.groups 攒齐 8 条入队) | 单条轨迹完成即刻入队,彻底拆除组内等待屏障 |
| 优势基线(Baseline) | 无 Critic,靠 GRPO 组内相对比较 + 任务级 Token 二次归一化 | 重新引入 Token-level Value Model( 双倍速更新 + 冻结 Attention) |
| 对“陈旧策略”的态度(Lag) | 化陈旧为探索:主动保留滞后 25 步的 Stale Engine 做跨策略切换 | 视极端离策为毒药:用 Rollout Log-Prob 双边硬门控(DIS)直接清零越界梯度 |
| 环境观测处理(Observation) | 差分编码设 loss_mask = 0,屏蔽策略梯度与优势统计 | 设 loss_mask = 0,且设计 Skip-Observation GAE 在动作边界跨过观测倒推 |
| 硬件开销账本 | 省下 Critic 显存,但需为每个 Prompt 采 8 次并常驻 Stale 推理池 | 每个 Prompt 只采 1 次,但 Learner 侧需额外承担同规模 Critic 的双倍更新算力 |
这两套方案没有绝对的高下之分,只有场景契合度之别:
- 当你的场景是多任务混合、单轮交互在 20 步以内、且显存预算不想再塞一个巨大的 Critic 模型时,AgentRL 的“组感知异步 Buffer + Stale Engine 跨策略探索 + 任务级 Token 优势标准化”是一套性价比极高的工业级方案;
- 而当你的场景走向 单条轨迹动辄跑上百轮单元测试、上下文长达 128K、同组 8 条轨迹里总有一两条慢得离谱 时,组内 8 等 1 的屏障就会变得难以忍受,此时就该切换到 SAO 的“ 单轨迹流 + DIS 双边硬门控 + Skip-Observation GAE”。
如果再结合本站的《长期收益强化学习算法研究进展》以及 VeRL、AReaL、THUDM/slime、Alibaba ROLL 等开源系统来看,整个大模型 Agentic RL 基础设施已经形成了清晰的分层:最底层由 FSDP/Megatron 与 SGLang/vLLM 解决张量并行和高速生成,中间层由 AgentRL Controller 这类控制面解决成千上万个有状态容器的会话路由与故障隔离,最上层则由跨策略采样、任务级优势归一化、DIS 门控与跨观测 GAE 解决多步探索与信用分配。
7.2 开源仓库架构演进与核心代码地图
对于希望直接上手阅读或二次开发 THUDM/AgentRL 源码的读者,建议沿着下面这张核心模块地图按图索骥(仓库在论文发布后还持续演进出了 gRPC 反向注册传输、Web Dashboard、Kubernetes 沙箱控制器以及包含 REINFORCE++/RLOO/GAE 的通用 async_trainer.py):
| 模块职责 | 仓库核心源码路径 | 走读重点关注的机制细节 |
|---|---|---|
| 论文训练主入口 | examples/training/agentrl_trainer.py | 三组 Placement Group 划分、cross_sampler 概率路由、adv_norm 与 NCCL 双速权重广播 |
| 五任务超参配置 | examples/training/configs/qw14b_waodk.yaml | rollout_ratio: 0.5、rollout_stale_ratio: 0.25、stale_step: 25、n: 8 与微批次 Token 上限 |
| 组感知异步队列 | trainer/src/agentrl/trainer/components/buffer.py | self.groups 字典的 8 轨迹聚拢屏障、self.queue 就绪队列与最小公倍数动态取数 |
| 多轮交互与掩码 | trainer/src/agentrl/trainer/agentic/loops.py | openai_chat_agent_loop 中的模板差分编码、loss_mask(1 vs. 0)与 -0.2 未完成惩罚 |
| 优势与损失函数 | algorithms/advantage.py & loss_funcs.py | GRPO 组相对优势、基于 rollout_log_prob 的重要性比率、PPO 裁剪与参考模型 KL 损失 |
| 环境控制面与沙箱 | controller/(Go)& worker/(Python) | 高并发 Session 路由表、HTTP/gRPC 双协议通信与 Docker/K8s 容器生命周期回收 |
回看整篇论文与代码库,AgentRL 留给我们最宝贵的工程启示在于:多轮多任务智能体的规模化训练,绝不能只盯着损失函数里的那几个字母打转。把异构有状态沙箱收拢成干净的 Function-Call 控制面、用组感知异步队列榨干 GPU 空泡、把原本讨厌的陈旧策略巧妙变成打破多轮死循环的探索催化剂、再用任务级 Token 标准化按住多任务梯度打架——正是这一整套系统与算法的严密咬合,才让一个大模型真正学会在千差万别的真实数字世界里从容行事。
参考文献与一手资料
- Hanchen Zhang, Xiao Liu, Bowen Lv, Xueqiao Sun, Bohao Jing, Iat Long Iong, Zhenyu Hou et al., AgentRL: Scaling Agentic Reinforcement Learning with a Multi-Turn, Multi-Task Framework(arXiv:2510.04206v1, 2025)
- THUDM, AgentRL Official Repository(含
trainer、controller、worker与eval完整实现) - Xiao Liu et al., AgentBench: Evaluating LLMs as Agents(ICLR 2024)
- Zhenyu Hou et al., Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning(SAO, 2026)
- Zhihong Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(GRPO, 2024)
- Guangming Sheng et al., HybridFlow: A Flexible and Efficient RLHF Framework(VeRL, 2024)
- Wei Fu et al., AReaL: A Large-Scale Asynchronous Reinforcement Learning System for Language Reasoning(2025)
- Mohit Shridhar et al., ALFWorld: Aligning Text and Embodied Environments for Interactive Learning(ICLR 2021)
- Shunyu Yao et al., WebShop: Towards Scalable Real-World Web Interaction with Grounded Language Agents(NeurIPS 2022)
- Shishir G. Patil et al., Berkeley Function Calling Leaderboard (BFCL)
comments