训练大语言模型回答一道单轮数学题,和训练一个智能体(Agent)在代码仓库里连续工作两小时修好一个棘手的 Bug,在强化学习系统底层面临的是完全不同的物理世界。
在单轮推理中,哪怕每条回复长短不一,整体生成时间也基本处在同一数量级;同步收集一整批样本、为每个问题并发采样 条回复并计算组内相对优势(GRPO),是一套既省去价值网络(Critic)显存、又足够稳定的标准打法。但当模型进入多轮工具交互环境——交替编写代码、调用 Python 解释器、等待单元测试执行、根据报错日志重新定位问题——不同轨迹的完成耗时立刻拉开数十倍甚至上百倍的差距。只要同一采样组里的 7 条轨迹在 30 秒内顺利结束,而第 8 条轨迹卡在长达 300 轮的测试循环里,前 7 条早已就绪的数据就必须原地干等,才能算出组内均值与标准差。
面对这一卡住长时域 Agent 扩展性的核心矛盾,清华大学与 Z.AI 团队提出的 Single-Rollout Asynchronous Optimization(SAO)(已用于支撑 750B 总参数、40B 激活参数的 GLM-5.2 智能体强化学习后训练管线)交出了一套从采样调度到信用分配全链路重构的方案:在 Qwen3-30B-A3B 基座上,SAO 稳定训练满 1000 步不崩溃,将 AIME2025 准确率从 SFT 的 80.4% 推高至 97.3%、BeyondAIME 从 53.3% 推高至 74.8%,并在 300 轮交互上限的 SWE-Bench Verified 上取得 29.8% 的解决率。
透过具体的公式与消融曲线看本质,SAO 的整套算法架构建立在四条环环相扣的设计哲学之上:
- 拆掉组内同步墙,让采样粒度回归单次真实交互(Single-Rollout Stream over Group Barrier):彻底放弃“同一个 Prompt 必须凑齐 条轨迹才能算优势”的组内相对基线约束,将采样组大小压到极致的 。每条轨迹一经环境返回奖励即可流式进入就绪队列,再由训练端从队列中聚合 128 个不同 Prompt 的已完成轨迹组成全局批次——用单轨迹异步流消除了组内最慢样本的木桶效应。
- 直接采信采样时刻的行为日志,对越界离策 Token 执行双边硬门控清零(Direct Behavior Log-Prob & Double-Sided Hard Gating):异步解耦后,长耗时轨迹完成入队时,训练端的策略往往已经迭代了多个版本。SAO 抛弃了维护多版本历史模型快照 的包袱,直接读取推理引擎采样时记录的 计算重要性比率,并对超出非对称信任区间的离策 Token 直接将梯度置零(而非标准 PPO 的边界软截断),精准掐断占比不足 却足以引发训崩的极端尾部噪声。
- 用“双倍速更新 + 冻结注意力”重建单轨迹的价值罗盘(Two-Timescale & Frozen-Attention Critic):拿掉 GRPO 的组内均值后,单条轨迹必须依靠学习型价值网络(Value Model)提供状态相关的方差缩减基线。为了防止 Critic 滞后于策略演化或被稀疏奖励冲垮,SAO 让 Critic 以 2:1 的双时间尺度高频追踪 Actor,并在强化学习全程锁死 Critic 的底层 Attention 权重、仅微调 MoE 专家投影层。
- 让信用分配跨过环境噪音,只在模型的决策 Token 间架桥(Skip-Observation Credit Assignment):在多轮工具交互中,Python 报错栈或测试日志(Observation)属于外部环境状态转移,模型并不为这些 Token 的生成概率负责。SAO 设计了 Skip-Observation Token-level GAE,在动作片段末尾直接跳过整段环境观测,将下一轮动作首 Token 的状态价值跨越式接回上一轮末尾动作,实现跨工具调用的细粒度信用回传。
下面我们顺着这四条设计哲学,从同步屏障的数学根源出发,逐层拆解 SAO 的核心机制与实验动力学证据。
1. 为什么长时域 Agent 训练苦“组同步”久矣?
1.1 长尾轨迹空泡与异步流水线的天然张力
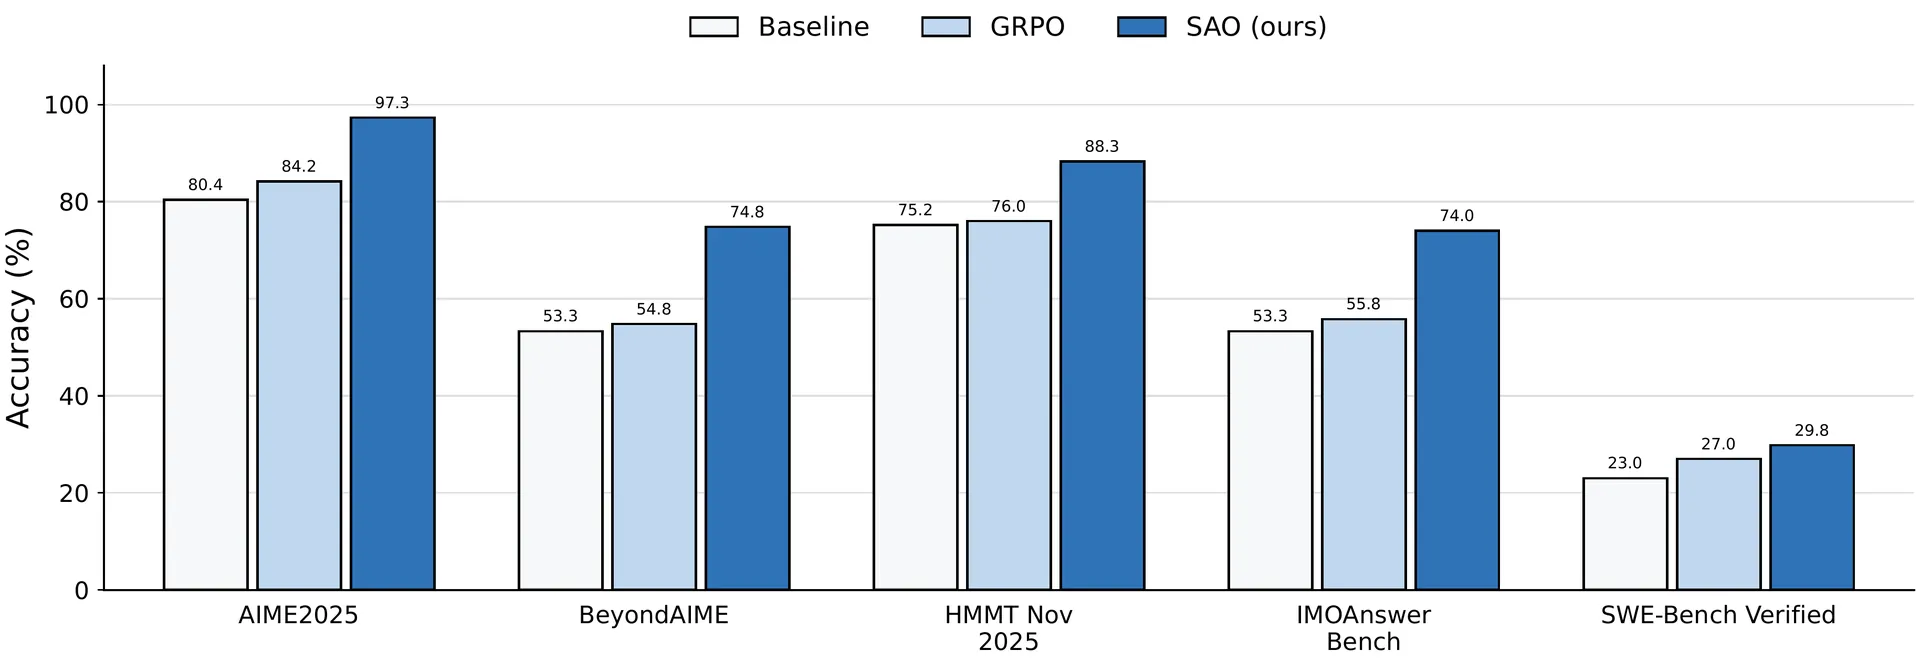
观察上图展示的五项长时域基准(AIME2025、BeyondAIME、HMMT Nov 2025、IMOAnswerBench 四项带 Python 解释器的数学竞赛基准,以及基于 OpenHands 框架的 SWE-Bench Verified 软件工程基准),为什么标准 GRPO 相比 SFT 的提升如此微弱,而 SAO 却能拉开超过 13~20 个百分点的巨大身位?
要回答这个问题,必须先看清多轮智能体交互的耗时分布。假设一个训练批次需要收集 条轨迹。在工具集成推理或代码修复中,简单问题可能调用一两次 Python、耗时 30 秒就顺利收工;而复杂问题可能反复修改代码、运行测试、读取报错,在高达 50 轮甚至 300 轮的交互上限边缘徘徊,生成数万乃至上十万个 Token。在同步批处理调度下,整批数据的完成时间被最慢的那条长尾轨迹(Straggler)死死卡住:
平均轨迹耗时根本反映不了同步屏障的代价,真正决定算力空泡(Pipeline Bubble)面积的是分布的最右端尾部。
异步 Actor-Learner 架构试图把这道批处理高墙推倒:推理工作节点(Rollout Workers)与训练节点(Learner)在物理资源上解耦,先完成的轨迹立刻写入就绪队列(Ready Queue),Learner 只要攒够可用样本就持续更新并发布新权重,而慢轨迹在后台继续执行,互不阻塞:
rollout workers              learner
---------------              -------
trajectory A --done------->  replay / ready queue
trajectory B --------done->  sample -> optimize
trajectory C --done------->  publish new weights
trajectory D ------------->  continue generation
然而,天下没有免费的并行。当慢轨迹 D 终于跑完 300 轮测试进入队列时,Learner 可能已经用 A、B、C 的数据更新了十几次参数。异步化把“硬件干等的同步空泡”转化成了“行为策略滞后(Policy Lag)与离策分布漂移(Off-Policy Drift)”。
1.2 PPO 与 GRPO 的两难:省掉 Critic 却背上了组内屏障
在进入单轨迹异步设计前,我们先对比一下当前大模型强化学习的两大主流基座:PPO 与 GRPO。
给定问题 与模型生成的自回归序列 ,策略记为 。标准 PPO 计算当前策略与采样参考快照 在每个 Token 位置上的概率比:
并通过最大化裁剪代理目标(Clipped Surrogate Objective)限制单步更新幅度:
为了让策略梯度方差可控,PPO 引入一个与策略模型同规模的价值网络(Critic),用均方误差拟合真实回报 :
再通过广义优势估计(GAE)沿时间步指数加权累积 TD 残差 ,在偏差与方差之间取得平衡:
PPO 的最大好处在于,它的基线 只依赖当前状态 ,天然支持“一个 Prompt 只采一条轨迹”。代价则是必须额外维护并训练一个百亿乃至千亿参数的 Critic 模型。
GRPO 正是为了砍掉 Critic 而生的:它对每个 Prompt 并发采样 条完整输出 ,拿到对应的标量奖励 后,直接用组内均值 和标准差 构造相对优势:
在短序列同步训练里,GRPO 优雅地省下了一半显存;但在长时域异步智能体场景下,上式分母和分子里的 却变成了一道绕不过去的数学枷锁:只要同一个 Prompt 组里的第 条慢轨迹还没从容器沙箱里跑出来,前面已经完成的 条轨迹就根本算不出 ! 此外,在真实的在线交互环境(如真实用户对话或不可回滚的外部系统)中,系统本来就只能对单次请求执行一次动作并收到一次反馈,根本不可能把同一个初始状态复制 8 份去平行试错。
1.3 单轨迹流式入队与全局批次聚合语义
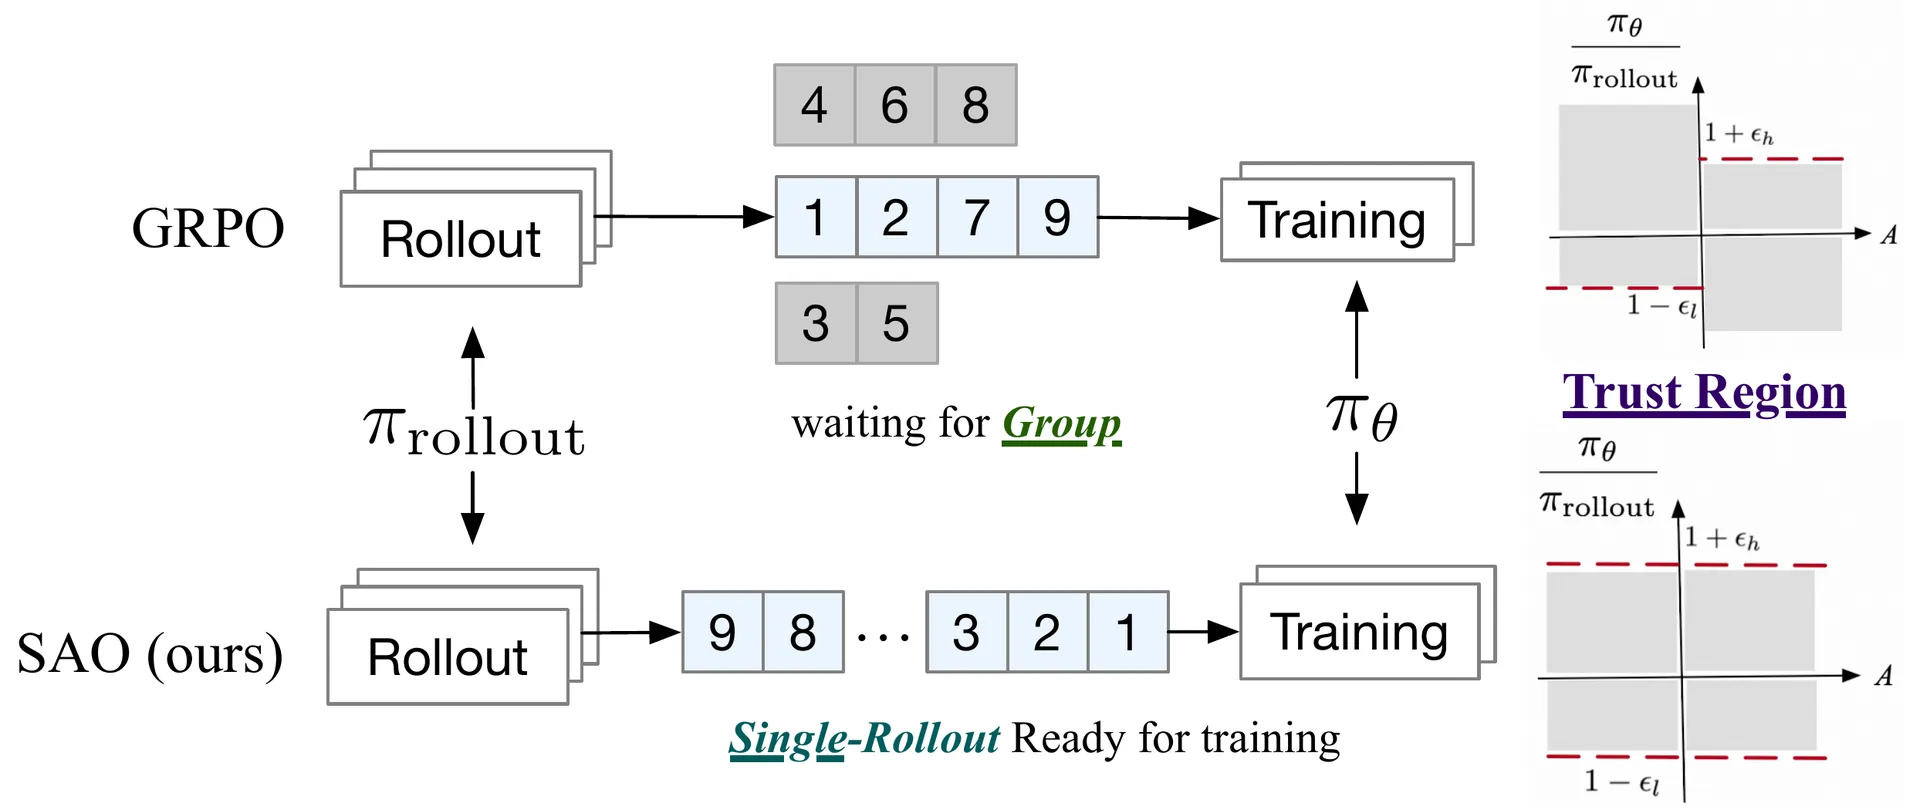
看上图对 GRPO 与 SAO 调度机制的直观对比:上半部分的 GRPO 中,即便不同轨迹按各自的速度陆续完成,训练队列也必须等待同属一个 Prompt 组的样本全部到齐才能放行;而下半部分的 SAO 彻底拆除了组内屏障,让每个 Prompt 只生成一条轨迹(),所有轨迹严格按照 9, 8, ..., 3, 2, 1 的实际完成先后顺序流式进入可训练状态。
这里必须厘清一个非常容易混淆的工程概念:Single Rollout(每个 Prompt 采 1 条轨迹)绝不等于训练的 Batch Size 为 1。
在 SAO 的实验设置中,每次参数更新的全局策略批次大小(Policy Batch Size)依然高达 128 条轨迹(作为对照的 GRPO 基线则是每批 16 个 Prompt 每个 Prompt 8 条轨迹,总样本数同样是 128)。换言之,SAO 的完整数据流是:
many distinct prompts
  -> 1 rollout per prompt (no sibling barrier)
  -> completion-ordered ready queue
  -> aggregate 128 completed trajectories into 1 global batch
  -> 2 critic updates + 1 policy update
把 16 × 8 改成 128 × 1,不仅消除了同组兄弟样本之间的等待空泡,还在相同的 128 条轨迹计算预算下,让模型在每一个训练步里看到了 8 倍数量的独立问题(Prompt Diversity)!当然,代价也是立竿见影的:失去了组内均值 的保护,异步队列里的陈旧轨迹与单样本方差会直接冲击策略梯度。接下来我们就看 SAO 是如何用三大算法模块驯服这头猛兽的。
2. 核心设计哲学一:双边直接重要性采样(DIS)与离策硬门控
2.1 区分三种策略版本:为什么版本号之差测不出真正的离策程度?
在异步强化学习的讨论中,如果不把三个策略版本分清楚,很容易在公式推导和代码实现上踩坑:
| 策略名称 | 数学记号 | 在异步系统中的真实物理含义 |
|---|---|---|
| 当前策略(Current Policy) | Learner 当前正在执行反向传播和参数更新的目标模型 | |
| 旧策略快照(Old Policy) | 传统 PPO 在一轮优化周期(Epoch)开始前固定的参考快照 | |
| 行为采样策略(Rollout Policy) | 推理引擎在生成具体某个动作 Token 那一瞬间实际使用的模型分布 |
在同步 PPO 中, 与 是同一个模型;但在异步系统里,一条长轨迹生成期间 Learner 已经更新了多次,如果还拿 Learner 侧最近一次的 去充当分母,算出来的重要性比率根本无法反映数据生成时的真实行为分布。
那么,能不能只靠模型版本号之差 来过滤旧数据?
答案是不够。版本号之差只是一个粗糙的外部代理指标:有时候 Learner 连续更新了 5 步,某个常见推理连接词的生成概率几乎纹丝未动;有时候只更新了 2 步,某个关键工具调用 Token 的概率就已经偏移了几个数量级。真正决定梯度是否会失控的,是当前策略与采样时刻行为策略在具体动作 Token 上的对数概率偏移量:
因此,SAO 的第一步设计就是:无需在显存或磁盘上维护一大堆历史检查点 ,直接在推理引擎生成每个动作 Token 时把行为对数概率 随轨迹持久化下来,训练时直接用它计算精确的 Token 级重要性比率:
2.2 从软截断到双边硬清零:DIS 目标函数与非对称阈值
拿到真实的当前/行为策略概率比 后,为什么不能直接套用标准 PPO 的 ?
回想一下标准 PPO 裁剪的机制:当优势 且比率 跌破下界 时(说明当前策略已经极不倾向于采样这个曾经拿到正奖励的旧动作), 会选择未截断的 ,继续保留梯度强行拉高该 Token 的概率;反之当 且 冲破上界 时,也会继续保留大梯度打压该 Token。在近似同策略(On-Policy)的微小偏移下,这种单侧放行是有益的;但在长时域异步训练中,一条滞后了十几步的陈旧轨迹里,某些 Token 的 可能已经偏离到极端值,继续对这些严重离策的样本施加强梯度,会在几个训练步内直接把策略模型拉崩。
为此,SAO 提出了 Direct Double-Sided Importance Sampling(DIS,双边直接重要性采样),将策略优化目标定义为:
其中双边校准门控函数 为:
对比一下上式和标准 PPO 的区别:
- 标准 PPO 是“软截断”:越界后把权重卡在边界常数 (或在另一侧不截断),越界 Token 依然留在计算图里参与梯度方向投票;
- SAO 的 DIS 是“双边硬门控清零”:不管优势 是正是负,只要 Token 的重要性比率 跌破下界 或者 冲破上界 ,校准函数直接返回
0!也就是说,一旦某个动作 Token 的分布偏移超出了信任区间,它对当前策略梯度的贡献会被彻彻底底地抹零。
非常有意思的是论文在两类任务上标定的非对称阈值:
- 数学推理任务:,对应可信比率开区间 ;
- SWE-Bench 编码任务:,对应可信比率开区间 。
为什么论文称之为“Strict(严格)”,但允许的上界却放宽到了 ?因为这里的“严格”指的是一旦越界就执行零梯度死刑,而非把区间缩得很窄;同时,概率比率的上侧(,当前策略比旧策略更青睐该动作)与下侧(,当前策略已基本放弃该旧动作)在优化动力学上的风险高度不对称:适度容忍当前策略正在强化的新兴动作(允许上界到 倍),同时严防把早已淘汰的极低概率旧动作硬拉回来,才能在“异步去噪”与“保留学习信号”之间取得平衡。
2.3 对数空间数值保护与跨引擎同版本对齐
在把 DIS 写成分布式训练代码时,有两个极易引发隐蔽 Bug 的工程细节:
第一,千万不要先算完两个概率再做除法,也不要先算 再做门控比较。在 bf16 混合精度下,低概率 Token 的原始概率值极易下溢,而严重离策 Token 的对数差 一旦达到几十,直接调 exp(delta) 就会产生 Inf 并在乘以 0 时炸出 0 * Inf = NaN!稳健的做法是先在对数空间完成双边门控判定:
只对通过门控的合法位置计算 ,并通过 .detach() 阻断比率本身的梯度回传:
log_ratio = current_logprobs - rollout_logprobs
trusted = (log_ratio > math.log(1.0 - eps_low)) & (log_ratio < math.log(1.0 + eps_high))
weight = torch.where(trusted, torch.exp(torch.clamp(log_ratio, max=10.0)), 0.0)
policy_loss = -(weight.detach() * advantages * current_logprobs)[action_mask & trusted].mean()第二,必须保证推理引擎与训练引擎的同版本对数概率语义一致。异步强化学习通常用 SGLang 或 vLLM 做高速 Rollout,用 Megatron-LM 或 FSDP 做 Learner 训练。如果 Rollout 保存的是未除以采样温度 或经过 Top- 截断后的残缺概率,而 Learner 重算的是全词表原始 Logits 的 Softmax,那么哪怕两边加载的是完全相同的模型权重,算出来的 也会偏离 1.0,导致 DIS 门控把实现误差误判为策略滞后。
3. 核心设计哲学二:双时间尺度与冻结注意力的稳健价值网络
3.1 失去组内对照后,为什么全局滑动均值救不了单轨迹方差?
当采样组大小从 变成 时,每个 Prompt 只剩孤零零的一个标量奖励 。这时候一个最偷懒的想法是:我还是不想训 Critic,干脆维护一个全局(或按 Prompt 历史)的奖励滑动平均值 ,令优势为 行不行?
后文 Table 4 的消融实验会给出一记响亮的耳光:用滑动均值做基线,AIME2025 准确率只有 79.8%,甚至比不训 RL 的 SFT 起跑线(80.4%)还要低!
原因其实非常直观:全局滑动均值是一个“文盲基线”,它根本看不懂当前题目有多难,也看不懂模型当前走到了哪一步。一道全网只有 5% 成功率的压轴奥数题,模型靠精妙的 Python 辅助推导出正确结果拿到 分,本该获得极强的正向激励;一道 99% 都能做对的送分题拿到 分,则只该获得微弱更新。只有重新引入状态相关的价值网络 :
让 Critic 根据当前题面 与已经展开的多轮交互上下文 动态评估“从当前状态出发预期能拿多少分”,才能在单轨迹下给出准确的信用信号。然而,一旦没有了组内统计兜底,Critic 自身的预测质量就成了决定成败的生命线。SAO 为此对 Critic 做了两项关键改造。
3.2 双倍速价值更新:用快时间尺度追赶移动中的策略
在 Actor-Critic 训练中,策略 每迈出一步,它所访问的轨迹状态分布以及每个状态下的预期回报都在发生改变。如果 Critic 和 Actor 按 1:1 的步调同步更新,Critic 永远在拟合“上一代策略”的价值函数,它给当前 Actor 算出的优势就会带着明显的滞后偏差。
SAO 从双时间尺度随机逼近(Two-Timescale Stochastic Approximation)的直觉出发,提出了 Faster Value Update(快速价值更新)——将 Critic 与 Actor 的更新频率解耦为 2:1:
同时,在优化器超参数上,Policy 学习率设为 ,而 Value Model 学习率设为更高的 (配合 10 步线性 Warmup)。每次策略准备更新前,先让 Critic 在当前批次数据上连续迭代 2 次,确保价值基准面牢牢咬住快速演化的策略分布。
3.3 冻结 Attention 仅微调 MoE 专家层:给 Critic 加上结构正则化
把 Critic 的更新频率翻倍、学习率放大 5 倍之后,新的麻烦来了:大模型做价值回归时,面对的是长达 128K 上下文、且只在序列最末端给出的稀疏二值奖励,剧烈的回归误差反向传播时极易引发 Critic 梯度爆炸。
作者在剖析全参数 Critic 训练的各层梯度范数时发现了一个极其重要的现象:剧烈的梯度震荡主要集中在 Full Attention(全注意力)层,而 MoE(混合专家)投影层的梯度则平稳得多。
想一想背后的表征机理:由于 Critic 与 Policy 一样,都是从已经具备强大推理能力的 SFT 模型初始化而来的,其底层的 Attention 层其实早就学会了“如何在长上下文里定位关键代码行、如何把工具报错与前面的函数调用关联起来”;Critic 在强化学习阶段真正需要学习的,是如何把这些已经提取好的高层语义表征映射成一个标量预期回报。如果放开全部 Attention 参数任由高方差的稀疏奖励去冲刷,反而会破坏预训练沉淀下来的底层注意力路由。
因此,SAO 采取了果断的结构正则化——在强化学习全程彻底冻结价值网络的全部 Attention 层参数,只更新 MoE 投影层(MoE Projections)。配合前置的规模化价值预训练冷启动(Scaling Value Pretraining),Critic 既保留了稳固的长文理解底座,又具备了灵活适应当前策略回报分布的可塑性。
4. 核心设计哲学三:跨环境观测的 Skip-Observation Token-level GAE
4.1 动作与观测的语义鸿沟:同在一个序列,为何不能一视同仁?
在多轮智能体交互中,一条完整轨迹 是模型动作与环境观测交替拼接而成的长序列:
其中 是模型生成的动作片段(如一段思考过程、一段 Python 代码或一个修改文件的 Patch),而 是外部环境执行后吐回来的观测片段(如标准输出、长达上千行的单元测试报错栈或读取的文件源码)。
在送进 Transformer 前向传播时, 和 都被编码成了看似平权的 Token ID;但在强化学习优化中,它们之间横亘着一条不可逾越的语义鸿沟: 是策略自己选出来的决策动作,而 是外部环境强加给模型的客观事实。模型既不能决定测试报错栈里冒出什么单词,也不应该为环境观测 Token 的对数概率或内部状态转移背锅。
4.2 跨观测搭桥:Skip-Observation GAE 的递推方程与边界处理
如果我们直接套用传统的 Token 级 GAE,沿着序列下标 逐个 Token 倒推计算 TD 残差 ,会发生什么?
在第 轮动作的最后一个 Token 后面,紧挨着的是长达几百个 Token 的环境输出 (而非模型的下一个决策)。如果让 GAE 顺着 内部的每一个报错单词逐个传递价值残差,不仅会把环境文本的局部波动噪声揉进优势估计里,还会因为 在长篇工具日志上的成百上千次连乘,把下一轮真正关键决策的信用信号严重稀释!
为此,SAO 设计了 Skip-Observation Token-level GAE(跳过观测的 Token 级广义优势估计)。设 为第 个动作片段的末尾 Token, 为跨过环境观测 之后、第 个动作片段的首个 Token。在动作片段的交界处,GAE 的倒推指针直接飞越整段 ,在 与 之间架起直连桥梁:
这里有一个非常精妙的问题:直接跳过了 ,那环境返回的关键信息(比如“刚才那行代码报错了”或者“测试跑通了”)岂不是丢掉了?
一点都没丢!因为因果自注意力机制(Causal Self-Attention)在计算下一轮首动作的状态价值 时,它的输入前缀里早就原封不动地包含了整段环境观测 。如果 里出现了致命报错, 的预测值就会瞬间暴跌,从而通过 产生一个巨大的负向 TD 残差,精准惩罚触发这次工具调用的末尾动作 及前面的推理链!
换言之,Skip-Observation GAE 保留了环境观测对状态价值的完整条件输入,却剔除了在非决策环境 Token 上的无效递推与衰减。落到数据结构上,系统只需在预处理阶段为每个 Token 预计算好 next_action_index:
| 轨迹片段类型 | 生成主体 | 参与策略梯度 (action_mask) | 参与价值回归 | GAE 倒推的下一位置 (next_action_index) |
|---|---|---|---|---|
| 动作内部 Token () | 策略模型 | 1 | 是 | 相邻的下一个动作 Token |
| 动作末尾 Token () | 策略模型 | 1 | 是 | 跨过 ,直连下一轮首动作 Token |
| 环境观测片段 () | 外部工具/沙箱 | 0 | 屏蔽 | 不参与递推(直接跳过) |
| 终局动作末尾 () | 策略模型 | 1 | 是 | 终止哨兵(Terminal,自举价值置 0) |
4.3 长度自适应衰减与信用分配粒度权衡
在长达 128K 上下文的多轮轨迹中,有的样本 2000 个动作 Token 就解出了答案,有的样本写了 40000 个动作 Token 才修好代码。如果所有轨迹都用一个死板的固定常数 (例如 ),那么在长轨迹上 还没传回序列前半截就已经衰减殆尽了。
因此,SAO 在策略侧引入了沿袭自 VAPO 的 Length-Adaptive GAE(长度自适应 GAE),根据有效序列长度 动态计算衰减系数:
而 Critic 的价值回归目标则固定采用无偏的 。序列越长, 越小, 就越逼近 ,确保终端的成败信号能穿透长决策链传回早期推理步;序列越短, 适度调小以压低方差。
同时,作者在论文附录中还探讨了一个关乎智能体本质的粒度问题:在多轮交互里,优势估计到底应该按每个 Token 算(Token-level),还是把一整轮对话动作打包成一个整体算(Step-level)?
论文测试了两种按对话轮次(Conversation Turn)聚合的 Step-level 变体:
- Step Average(轮内均值):将第 轮动作内所有 个 Token 的价值预测取平均 ;
- Last-Token Prediction(轮末预测):直接取该轮最后一个动作 Token 的价值预测 。
两种变体都只按轮次计算一个轮级优势 (其中 ),再把这个标量平均广播给该轮里面的所有数百个 Token。为什么这种看似清爽的轮级聚合在实验里打不过 Token-level?因为在复杂推理中,模型在一轮回复里往往先写了几百字正确的公式推导,最后一行写 Python 调用时不小心手滑写错了一个变量名——如果按整轮广播同一个负优势,前面几百字正确的数学推导也会跟着一起挨板子;而 Token-level GAE 则允许在长动作内部逐 Token 区分局部贡献。
4.4 串联全局:SAO 异步训练与门控核心实现参考
把前面的单轨迹异步入队、 冻结注意力 Critic 更新、Skip-Observation GAE 与对数空间 DIS 硬门控串起来,整套 SAO 的核心控制流可以用下面这段清晰的 Python 参考代码完整表达:
ready_queue = AsyncTrajectoryQueue()

async def rollout_worker(prompt, rollout_model, environment):
    trace = []
    state = environment.reset(prompt)

    while not state.terminal:
        # 采样动作并持久化采样时刻真实的 Token 级行为对数概率
        action, token_ids, logprobs = rollout_model.generate(state.context)
        trace.append({
            "role": "action",
            "token_ids": token_ids,
            "rollout_logprobs": logprobs,
        })

        observation, reward, done = environment.step(action)
        trace.append({
            "role": "observation",
            "text": observation,
        })
        state = state.advance(observation, reward, done)

    # 单条轨迹一完成即刻入队,彻底移除同 Prompt 组内等待屏障
    await ready_queue.put(finalize(trace, reward=state.reward))


def learner_step(batch):
    # 构造 action_mask 以及跨过 observation 的 next_action_index 跳转索引
    token_batch = build_action_and_skip_obs_indices(batch)

    # 1. 双倍速价值更新 (K = 2) + 冻结 Attention 仅训练 MoE 投影层
    for _ in range(2):
        values = critic(token_batch.input_ids)
        value_targets = build_skip_observation_returns(
            token_batch, values, gamma=1.0, lam=1.0
        )
        critic_loss = masked_mse_loss(values, value_targets, token_batch.action_mask)
        update_frozen_attention_critic(critic_loss)

    # 2. Skip-Observation Token-level GAE + 长度自适应 lambda
    with torch.no_grad():
        values = critic(token_batch.input_ids)
        advantages = skip_observation_gae(
            token_batch, values, gamma=1.0, alpha=1.5
        )

    # 3. 对数空间双边直接重要性采样 (DIS) 硬门控
    current_logprobs = policy.logprobs(token_batch.input_ids)
    log_ratio = current_logprobs - token_batch.rollout_logprobs
    trusted = (log_ratio > math.log(1.0 - eps_low)) & (
        log_ratio < math.log(1.0 + eps_high)
    )

    effective_mask = token_batch.action_mask & trusted
    ratio = torch.where(effective_mask, torch.exp(torch.clamp(log_ratio, max=10.0)), 0.0)

    actor_loss = -(ratio.detach() * advantages * current_logprobs)[effective_mask].mean()
    update_policy(actor_loss)
    publish_weights_to_rollout_workers()
5. 实验深潜:千步不崩的动力学证据与消融拆解
论文在 Qwen3-30B-A3B-Thinking-2507 基座上展开了系统评测:数学推理任务先在由 GPT-OSS-120B 合成的工具集成推理(TIR)语料上做 3 个 Epoch 的 SFT,再用该 SFT 模型同时初始化 Policy 与 Critic(最大交互 50 轮,上下文上限 128K,DIS 阈值 );SWE-Bench Verified 编码任务则直接从基座模型出发,在 OpenHands 框架下训练(最大交互 300 轮,上下文上限 128K,DIS 阈值 )。
5.1 数学推理与 SWE-Bench 编码主实验拆解
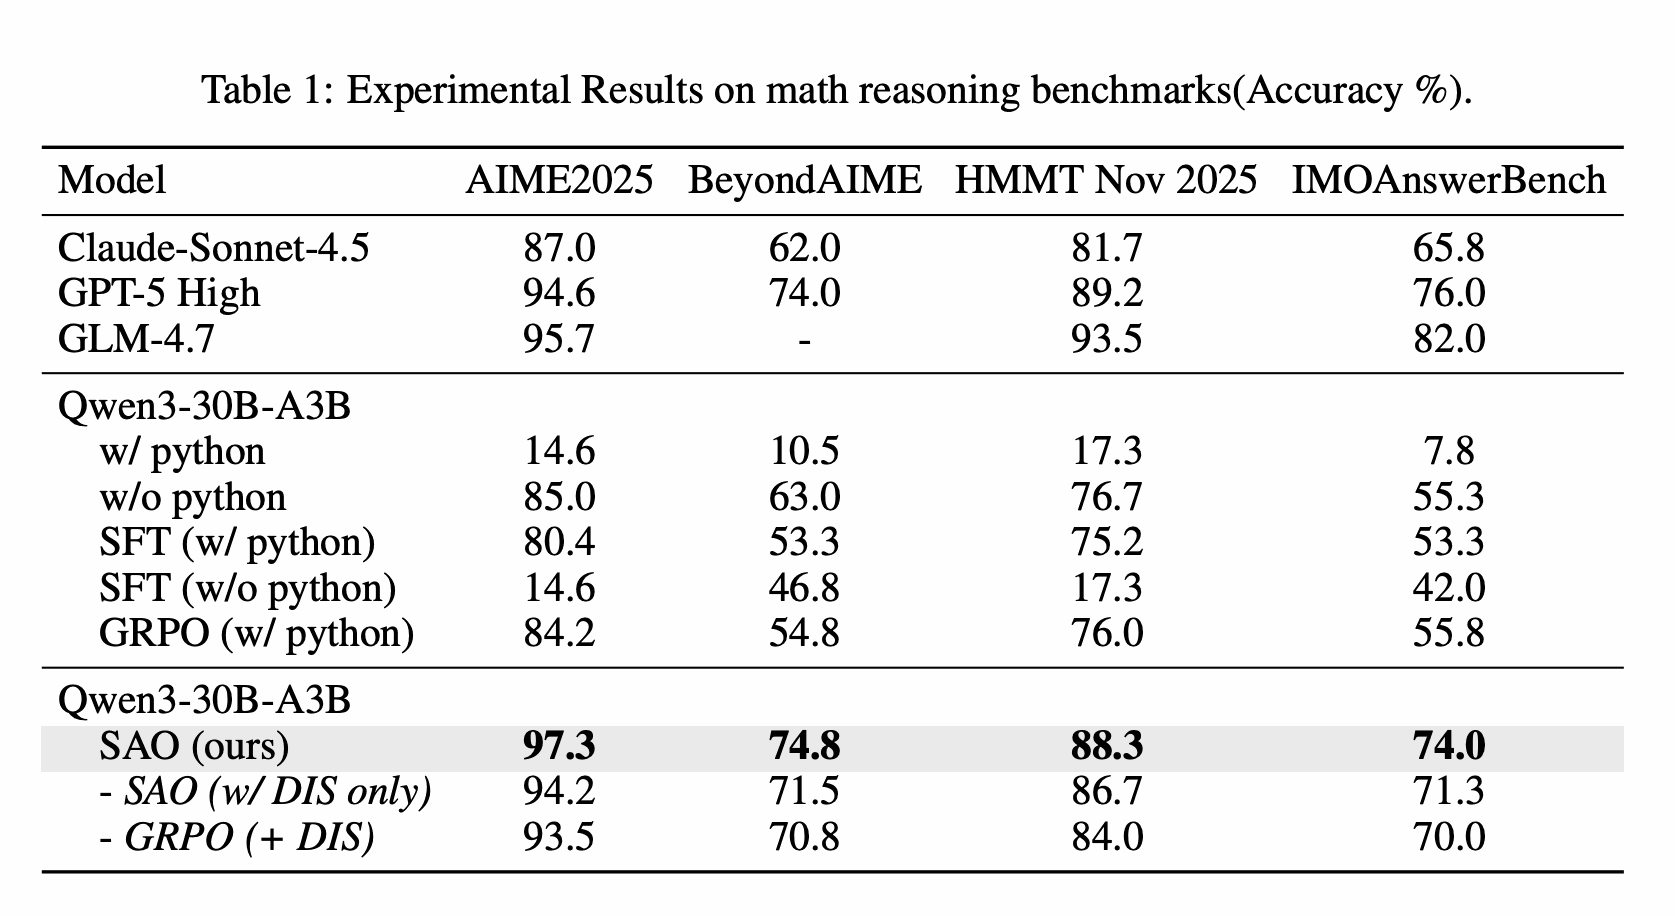
细看上面这张数学推理主实验表(Table 1,其中 AIME2025、HMMT、IMOAnswerBench 为 16 次独立采样评估均值,BeyondAIME 为 4 次评估均值),最值得咀嚼的是底部五行的阶梯式跃升:
- 为什么原生异步 GRPO 几乎原地踏步? 从
Qwen3-30B-A3B SFT (w/ python)到标准GRPO (w/ python),AIME2025 只从80.4微涨到84.2,BeyondAIME 只从53.3涨到54.8。原因很简单:在异步长时域环境下,缺乏离策硬门控的标准 GRPO 在训练到约 160 步 时就发生了灾难性崩溃,表里的分数只是取了它崩溃前的最高点。 - 加上 DIS 门控后,GRPO 立刻“起死回生”:看倒数第二行
GRPO + DIS,仅仅是把双边直接重要性门控加进 GRPO,AIME2025 就从84.2飙升到了93.5,BeyondAIME 飙升到了70.8!这直接证明了:在异步 Agentic RL 中,拦截极端离策 Token 是让训练活过早期的头号前提。 - 从
GRPO + DIS到完整SAO,单轨迹与稳健 Critic 带来了最后一块拼图:在同样拥有 DIS 保护的前提下,把 的组采样换成 的单轨迹异步采样并配齐改进后的 Critic(SAO行),四项指标进一步全面推高至97.3 / 74.8 / 88.3 / 74.0,比GRPO + DIS再高出3.8~4.3个百分点,相比 SFT 起点更是实现了+16.9至+21.5个百分点 的跨越式增长;同时,完整版SAO也显著超越了未做 Critic 稳定化加固的SAO (DIS only)(94.2 / 71.5 / 86.7 / 71.3)。
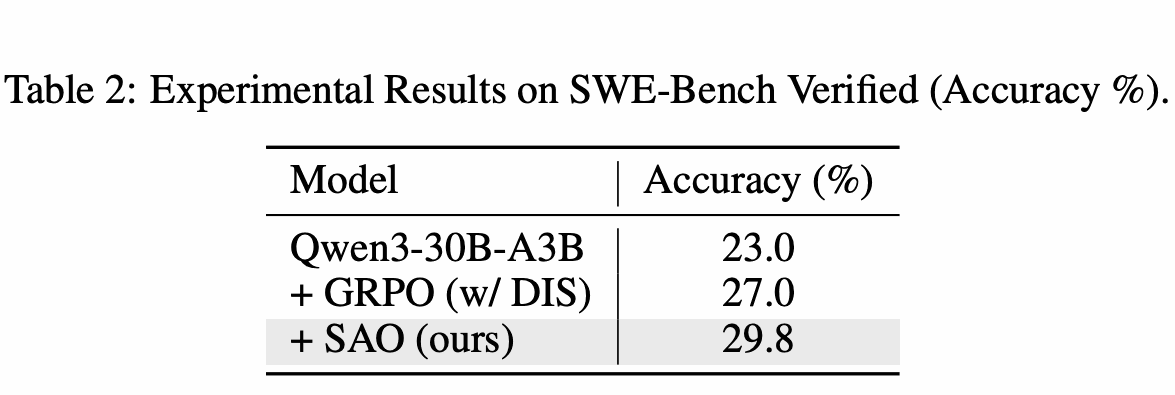
再看上图(Table 2)的真实软件工程修复基准 SWE-Bench Verified:在最高 300 轮仓库探索、文件编辑与测试执行的长尾环境下,SAO 将解决率从基座模型的 23.0% 提升至 29.8%(+6.8 个百分点),并且在完全相同的 DIS 稳定机制下比 GRPO (w/ DIS)(27.0%)高出 2.8 个百分点,验证了这套单轨迹 Actor-Critic 方案在超长交互编码智能体上的普适性。
5.2 千步训练曲线与价值网络消融:谁管“不崩”,谁管“上限”?
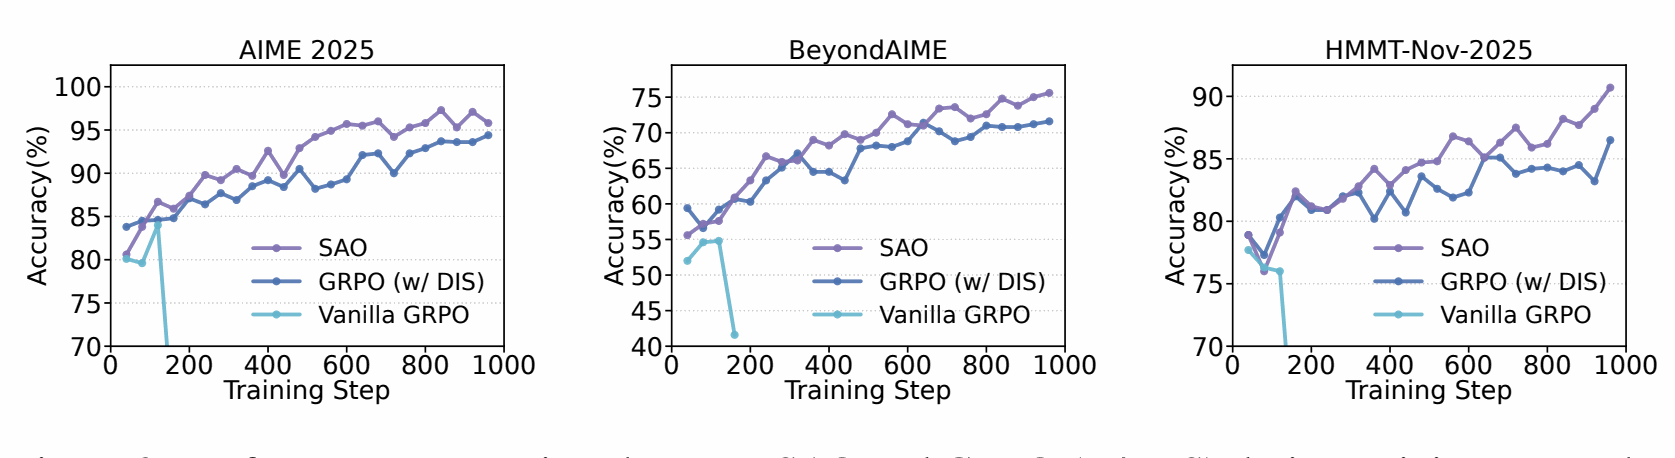
如果只看静态表格,很容易错过训练过程中的时序分水岭。看上图(Fig. 3)长达 1000 步的完整训练曲线:
- 绿色的 Vanilla GRPO 在 160 步附近准时雪崩;
- 蓝色的 GRPO w/ DIS 与红色的 SAO 在前 400 步 内几乎贴着同一条轨迹并驾齐驱;
- 一旦跨过 400 步 分水岭,
GRPO w/ DIS开始进入增长缓慢的平台期,而红色的 SAO 则在后半程持续向上爬升,一直稳健涨到第 1000 步!
这张图把各个模块的职责分工照得一清二楚:前 400 步不崩盘,靠的是 DIS 双边门控剔除了异步毒样本;而 400 步之后能打破天花板,靠的则是单轨迹带来的 8 倍 Prompt 覆盖多样性,以及渐入佳境的价值网络给出的精准 Token 级优势信号。
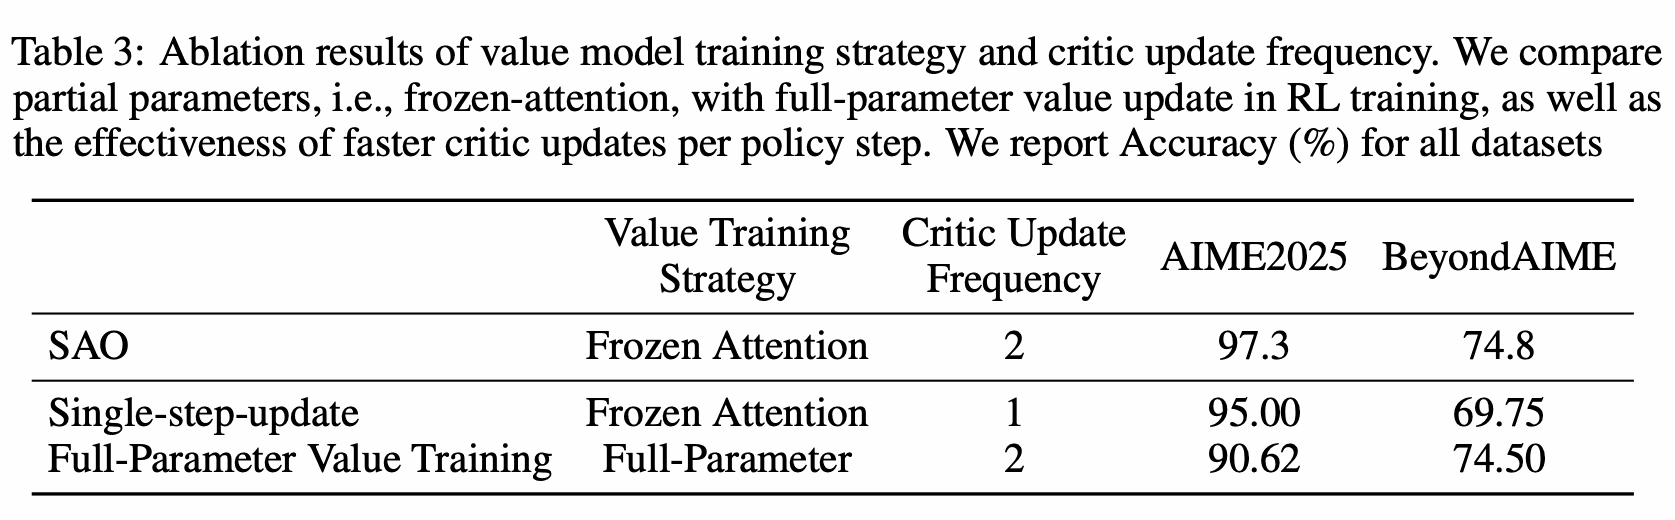
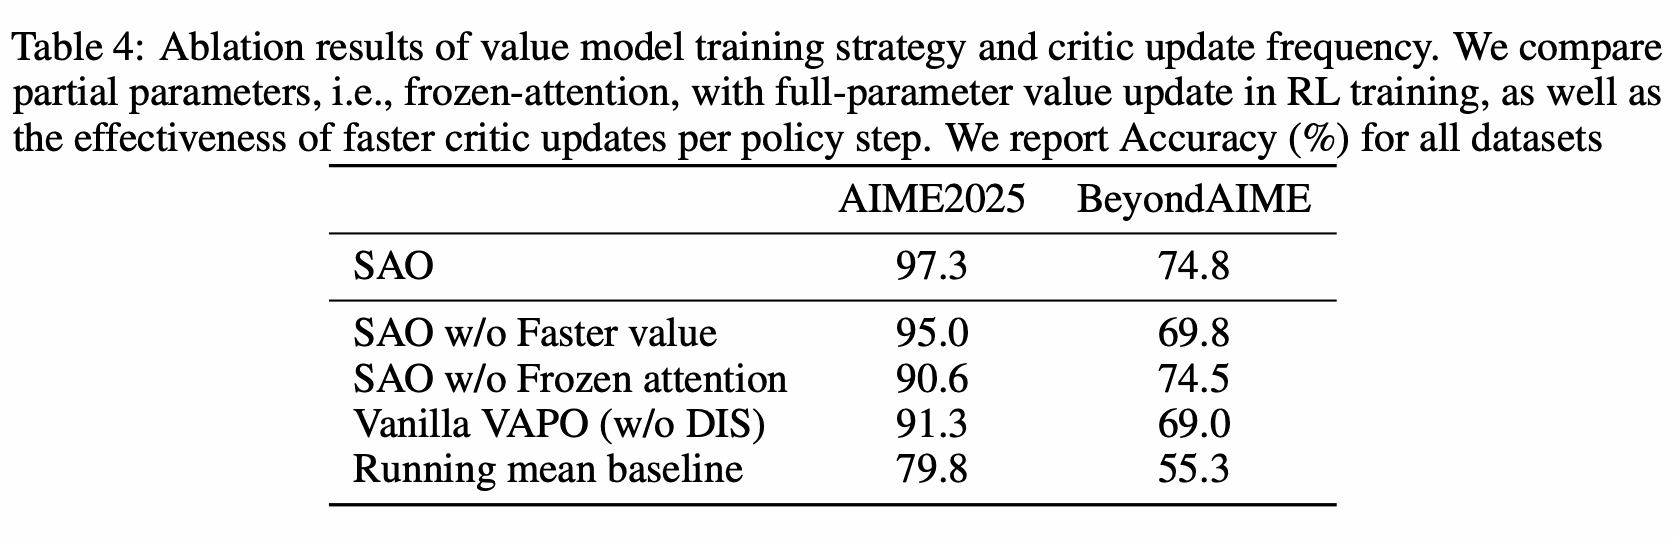
对照上面两张消融表(Table 3 与 Table 4),我们可以把 Critic 与各组件的贡献逐一定量拆开:
- 砍掉双倍速更新(
K=2 → K=1,即Single-step-update/SAO w/o Faster Value):AIME2025 从97.3掉到95.0,而在难度更高的 BeyondAIME 上更是从74.8大幅跌落至69.75(掉了超过5个百分点)。这说明题目越难、推理链越长,策略分布变化时对 Critic 追踪速度的要求就越苛刻。 - 放开全参数训练(不冻结 Attention,即
Full-Parameter Value Training/SAO w/o Frozen Attention):AIME2025 直接从97.3重挫至90.62(暴跌6.68个百分点),印证了冻结底层 Attention 对抑制稀疏奖励梯度冲击的必要性。 - 去掉 DIS 的同步算法直接移植(
Vanilla VAPO w/o DIS):把原本在同步推理上表现优异的 VAPO 直接放到异步单轨迹环境里,大约 90 步 就发生训练崩溃,崩溃前最佳成绩仅停留在91.3 / 69.0。 - 用历史均值代替 Critic(
Running Mean Baseline):用每个 Prompt 最近 8 次奖励的滑动均值充当基线,完全省掉 Critic,结果最终成绩只有惨淡的79.8 / 55.3——再次证明单轨迹异步优化绝不能靠简单的标量历史均值糊弄过关。
5.3 内部动力学三联证:解释方差、梯度范数与千分之六的致命离策 Token
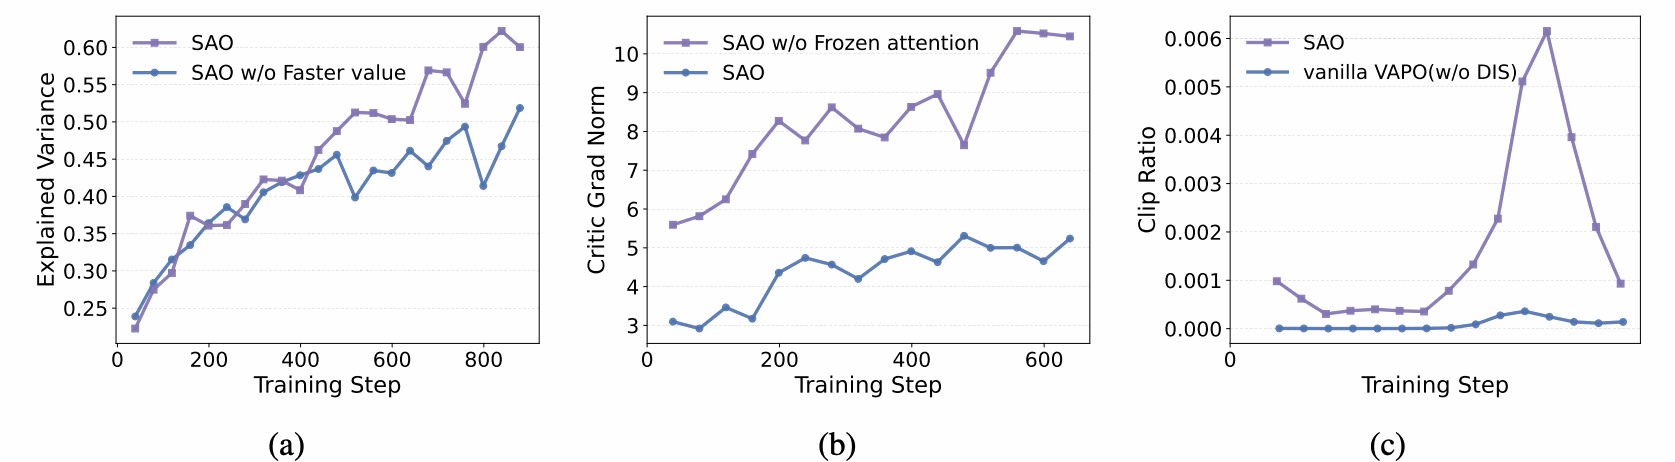
为什么上面那些消融项会表现出那样的外部准确率差异?上图(Fig. 4)从三个内部监控指标给出了铁证:
- 左图 Fig. 4(a)——价值网络的解释方差(Explained Variance, EV):
论文用解释方差衡量 Critic 预测值 对真实回报 波动的拟合程度:
越接近 ,说明 Critic 算出的基线越准。看左图曲线:前 350 步里,单次更新(
SAO w/o Faster Value)与双倍速更新(SAO)的 差不多;但一过 400 步,双倍速更新的 明显站上了更高台阶(稳定在0.6以上,而单次更新掉在0.5附近)。这个 400 步拐点 与前面 Fig. 3 中任务准确率开始拉开差距的时刻分秒不差! - 中图 Fig. 4(b)——Critic 的梯度范数(Gradient Norm):
蓝色虚线是放开全参数训练的 Critic,其梯度范数从第 200 步开始一路狂飙到
6.0以上并剧烈锯齿震荡;而冻结了 Attention、只训 MoE 投影层的红色实线,全程梯度范数都温顺地贴在1.5~2.5之间。 - 右图 Fig. 4(c)——被 DIS 门控屏蔽的 Token 比例(Clipped Tokens Ratio):
这张图的纵轴刻度非常值得玩味:在整个训练过程中,被 SAO 双边门控判定越界并置零的 Token 比例,最高峰也只有
0.006(即千分之六,约 0.4%~0.6%)!而没有 DIS 的 VAPO 裁剪率几乎是0,随后在 90 步直接训崩。这揭示了一个深刻的异步优化事实:毁掉一场大模型异步强化学习的,往往只是万分之几到千分之几的极端离策尾部 Token;把这不到 0.6% 的“害群之马”精准清零,剩下 99.4% 的异步数据就能安全高效地驱动模型进化。
5.4 非平稳在线适应与动作粒度消融
为了验证单轨迹 Critic 在真实在线交互(偏好随时间突变)下的适应速度,论文设计了一场可控的文风切换模拟实验:模型需要在学术(Academic)、可爱(Cute)、中二(Chuunibyou)和古风(Classical)四种风格间选择,环境的目标偏好每隔一个阶段发生突变。由 GLM-4.7 充当裁判,联合打分内容质量与风格契合度:
对照基线采用最近 128 个全局历史奖励的滑动窗口均值:
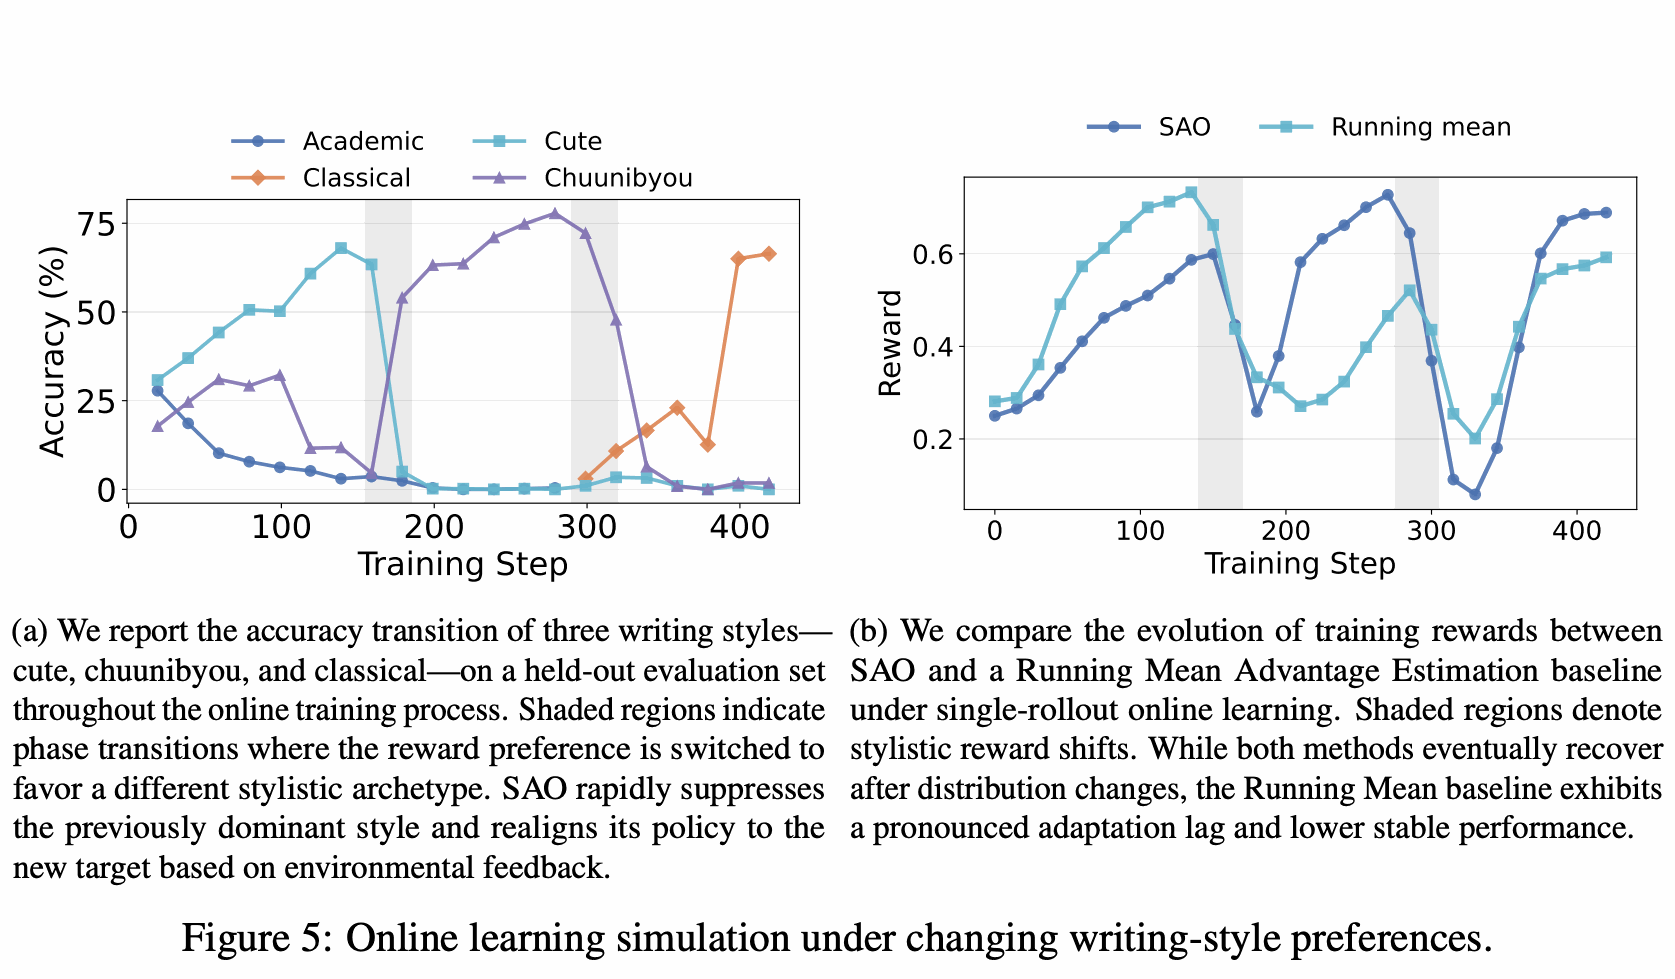
如上图(Fig. 5)所示,每当经过灰色阴影区的环境偏好切换,SAO 都能迅速压低旧风格占比、拉起新目标风格(左图);而在右图的训练奖励恢复曲线上,滑动窗口基线因为历史窗口里还装满了上一阶段的旧奖励而反应迟钝,SAO 的高频 Critic 则依托状态表征迅速完成基线重校准,收敛速度和平台高度全面占优。
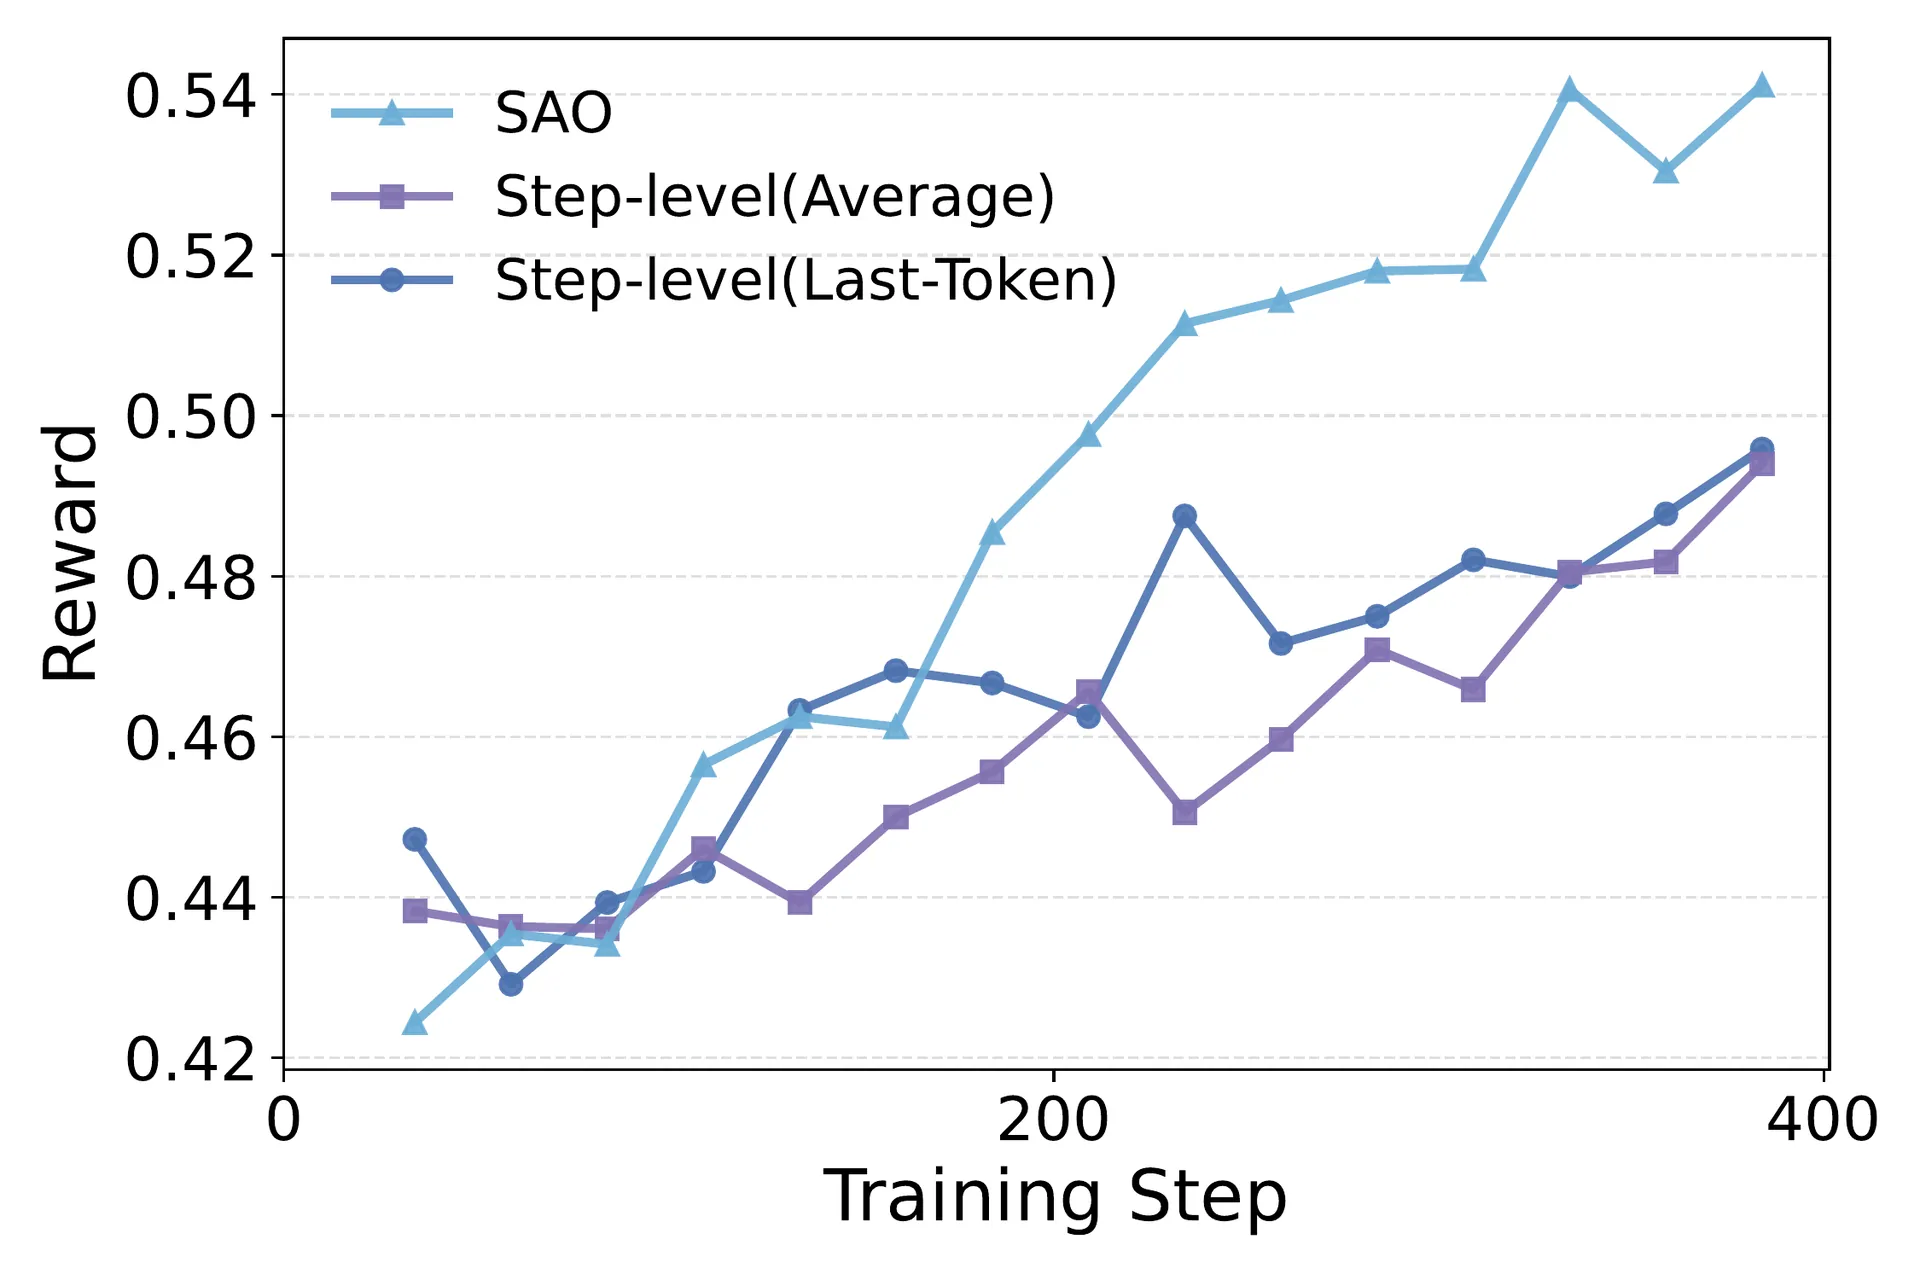
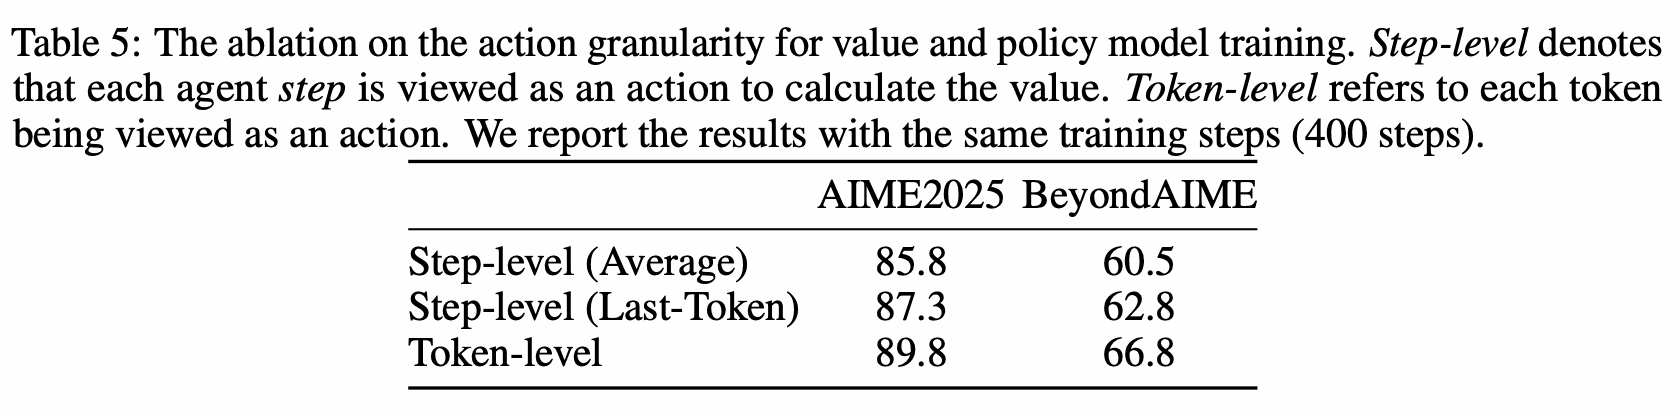
最后看上面两组关于信用分配粒度的消融结果(Fig. 6 与 Table 5,固定在 400 步快照对比):
- 在两种按轮次打包的方案中,取轮末 Token 价值的
Step-level (Last-Token)(AIME202587.3/ BeyondAIME62.8)优于轮内求平均的Step-level (Average)(85.8 / 60.5),因为经过因果注意力汇聚后,一轮末尾的隐状态比整轮大锅饭平均更能代表该步的完整语义结论; - 而主线的
Token-level方案在 400 步时进一步达到89.8 / 66.8,在 Fig. 6 的训练奖励曲线上从第 150 步起就一路绝尘。这证实了在单轮包含大段思维链推导与代码编写的推理智能体中,保持 Token 级细粒度优势递推是不可替代的。
6. 算法谱系坐标、工程边界与总结
6.1 在异步与长时域强化学习版图中的坐标
如果把 SAO 放进本站精读过的强化学习算法与系统版图中,它的生态位与取舍脉络非常清晰:
| 方法 / 系统 | 优势基线来源 | 每 Prompt 采样数 | 是否需要 Critic | 应对异步滞后与多轮工具交互的核心机制 |
|---|---|---|---|---|
| PPO | 学习型 Value Model | 是 | 依赖 快照软裁剪,无专门跨环境观测 GAE 跳跃 | |
| GRPO / RLOO | Prompt 组内相对统计 | 否 | 受制于组内最慢轨迹同步屏障,长尾工具调用下算力空泡显著 | |
| VAPO | 学习型 Value Model | 是 | 提出 Length-Adaptive GAE,但缺少异步离策硬门控,异步下易早期崩溃 | |
| GSPO / IcePop | 组内相对或序列级校准 | 视配置 | GSPO 采用序列级比率;IcePop 启发了双边过滤,SAO 进一步去除对 的依赖 | |
| IMPALA | V-trace 修正价值 | 是 | 用截断重要性权重修正价值回报,未针对 128K 超长自回归与工具观测跳跃定制 | |
| AgentRL | GRPO + 任务级 Token 归一化 | 否 | 跨组全异步但保留组内 8 轨迹屏障,主动利用 Stale Engine 做跨策略探索 | |
| SAO | Token-level Value Model | 是 | Rollout Log-Prob 双边硬清零 (DIS) + 冻结注意力 Critic + Skip-Obs GAE |
与本站另一篇综述《长期收益强化学习算法研究进展》所探讨的层次化强化学习(Hierarchical RL)、世界模型和逆强化学习相比,SAO 解决的是最贴近大模型后训练基础设施的一层问题:当长轨迹异步流式到达、中间夹杂大量外部环境反馈、且每个问题只采样一次时,如何让 Actor-Critic 的每一步梯度更新既算得快又不训崩。而在底层系统承载上,它与 THUDM/slime、AReaL 及 Alibaba ROLL 等负责 Megatron/FSDP 与 SGLang 异步参数同步的分布式框架天然互补。
6.2 工程权衡边界与总结
当然,任何架构取舍都有其适用边界,在实际工程中引入 SAO 时需要清醒评估以下四点权衡:
- 移除组屏障的吞吐收益 vs. 双倍速 Critic 的算力开销:SAO 虽然拆掉了 GRPO 的组内等待墙,但它在训练端重新引入了一个与策略模型同规模的 Critic,而且每次策略更新要跑 次 Critic 前反向传播。如果任务本身交互很快、长尾效应不明显,Learner 侧多出来的 Critic 算力与显存成本可能会抵消异步采样省下的等待时间;只有当多轮环境交互(如 300 轮代码沙箱测试)占端到端耗时大头时,这套“用 Learner 侧额外算力换取 Rollout 侧零组内等待”的账才最划算。
- 冻结 Attention 对 MoE 架构的依赖:论文中“冻结全部 Attention、只训 MoE 投影层”的稳定化技巧,建立在
Qwen3-30B-A3B与GLM-5.2这类拥有充裕专家容量的 MoE 模型之上;若迁移至稠密(Dense)Transformer 模型,则需要进一步探索仅微调 FFN 层或高秩 LoRA 等替代方案。 - 完成顺序偏差(Completion-Order Bias):在“轨迹一完成即刻入队”的流式调度下,耗时 20 秒的简单题天然比耗时 15 分钟的困难题更早填满训练队列。如果不加时间窗分桶或难度配额控制,训练早期的梯度容易被高频完成的简单样本主导。
- 冷启动对价值预训练的依赖:单轨迹 Actor-Critic 在第 0 步就完全仰仗 Critic 指路,工程落地时必须先准备覆盖成功与失败轨迹的离线语料完成 Value Model 预训练冷启动,避免随机初始化的 Critic 在起步阶段把策略带进沟里。
总而言之,SAO 最核心的启示在于:不要让算法定义里的“组内统计量”反过来绑架分布式系统的异步数据流。当智能体走向长时域真实环境交互时,果断让采样回归 的自然单轨迹流,用采样时刻持久化的行为对数概率守住双边信任边界,再用高频稳健的 Critic 与跨观测 GAE 接住信用分配——这套软硬协同的设计思路,为下一代长时域 Agentic RL 提供了极具价值的范本。
参考资料
- Zhenyu Hou, Yujiang Li, Jie Tang, Yuxiao Dong, Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning(arXiv:2607.07508v1, 2026)
- Z.AI, GLM-5.2: Built for Long-Horizon Tasks & GLM-5.2 Model Card
- John Schulman et al., Proximal Policy Optimization Algorithms(2017)& High-Dimensional Continuous Control Using Generalized Advantage Estimation(2015)
- Zhihong Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(GRPO, 2024)
- Yu Yue et al., VAPO: Efficient and Reliable Reinforcement Learning for Advanced Reasoning Tasks(2025)
- Chujie Zheng et al., Group Sequence Policy Optimization(GSPO, 2025)
- Ling Team et al., Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model(IcePop, 2025)
- Lasse Espeholt et al., IMPALA: Scalable Distributed Deep-RL with Importance Weighted Actor-Learner Architectures(ICML 2018)
- 相关开源异步与智能体强化学习系统:THUDM/slime、THUDM/AgentRL、inclusionAI/AReaL、alibaba/ROLL
comments