在工业级推荐系统里做精排模型迭代,最让人崩溃的往往是这样一个瞬间:你花了一周时间整理好新特征、在共享底座前加上了显式交叉网络 DCN-v2,或者为了加快收敛把学习率调高了一倍;训练任务在 TPU/GPU 集群上平稳跑了二十万步,离线 AUC 一路看涨,结果在某个凌晨突然触发报警——训练 Loss 垂直起飞,主任务 AUC 瞬间跌到 0.5(等同于随机瞎猜),而且无论再接着训多少万步,模型都彻底锁死在坍塌状态,几百卡时的算力当场报废。
为什么大规模多任务排序模型这么容易在训练中途突然“暴毙”?为什么大家熟知的标准梯度裁剪(Gradient Clipping, GC)和自适应梯度裁剪(Adaptive Gradient Clipping, AGC),到了基于 Adagrad 训练的推荐模型里常常拦不住这种崩盘?
Google 与 YouTube 团队在 KDD 2023 发表的 Improving Training Stability for Multitask Ranking Models in Recommender Systems(arXiv 预印本、TensorFlow Recommenders 官方源码),正是为了彻底解决这一工业痛点。透过具体的公式与实验,这篇论文提炼出了四条极具启发性的优化器设计哲学:
- 约束“参数真正走出的步长”,放弃只盯原始梯度(Clip the Effective Update, Not the Raw Gradient):在 Adagrad 优化器中,决定参数移动多少的是经过历史梯度平方累加器缩放、并乘上当前学习率后的实际更新量 。一个平时罕见激活的坐标哪怕原始梯度 并不算大,除以极小的累加器 后也会变成巨大的参数跳变;盯着原始梯度做裁剪,根本管不住预条件化之后的步长失控。
- 用逐坐标无穷范数取代被大层宽稀释的二范数(Coordinate-wise Bound over Dilution):精排模型的共享隐藏层动辄宽达 4096 维(单层超过 1600 万个参数)。当某几个特征坐标在失稳前夜出现极端跳变时,全局 范数会被上千万个正常坐标大幅摊薄,导致 GC 与 AGC 给出的缩放力度弱了整整两个数量级。Clippy 改为逐坐标核算安全上界,并取全层最严苛的缩放比统一作用于整层——既保住了该层更新矢量的几何方向,又绝不允许任何一个单点坐标越界。
- 双阈值阶段自适应:初期靠绝对下界破冰,中后期靠相对尺度巡航(Absolute Floor for Cold Start, Relative Bound for Mature Scaling):如果只限制更新量与参数模长的相对比例(),零初始化的偏置项与初期极小的权重就会因为上界为 0 而被死锁。引入绝对安全下界 后,Clippy 在参数接近 0 的起步期自动表现为定值裁剪,待参数增长成型后平滑切换为按参数模长比例放缩的相对控制。
- 把优化器变成层间稳定性探针,隔离异常梯度污染(Optimizer as a Diagnostic Probe with Outlier Isolation):通过导出每一层的裁剪系数 ,并在源码实现中采用“延迟累加器更新(Delayed Accumulator Update)”,系统不仅能实时定位全网最脆弱的瓶颈层,还能防止单次极端异常梯度永久撑大 Adagrad 累加器、进而废掉该坐标后续的学习能力。
下面我们顺着这四条设计哲学,从多任务精排的失稳机理出发,一步步拆解 Clippy 的数学设计、实验证据与生产级源码实现。
1. 为什么多任务精排模型总在训练中途崩盘?
1.1 微发散与完全发散:工业训练的生死界限
在论文中,作者把训练过程中的损失发散(Loss Divergence)归纳为了一条清晰的因果链:当局部损失曲面变得异常陡峭(steep loss curvature),而优化器迈出的有效步长又过大(excessive effective step size)时,参数就会一步跨出稳定盆地,引发 Loss 飙升与 AUC 坍塌。
但并非每一次 Loss 跳升都意味着训练报废。根据模型在遭受冲击后能否自行恢复,论文将发散严格区分为 微发散(Micro-divergence)与 完全发散(Full Divergence):
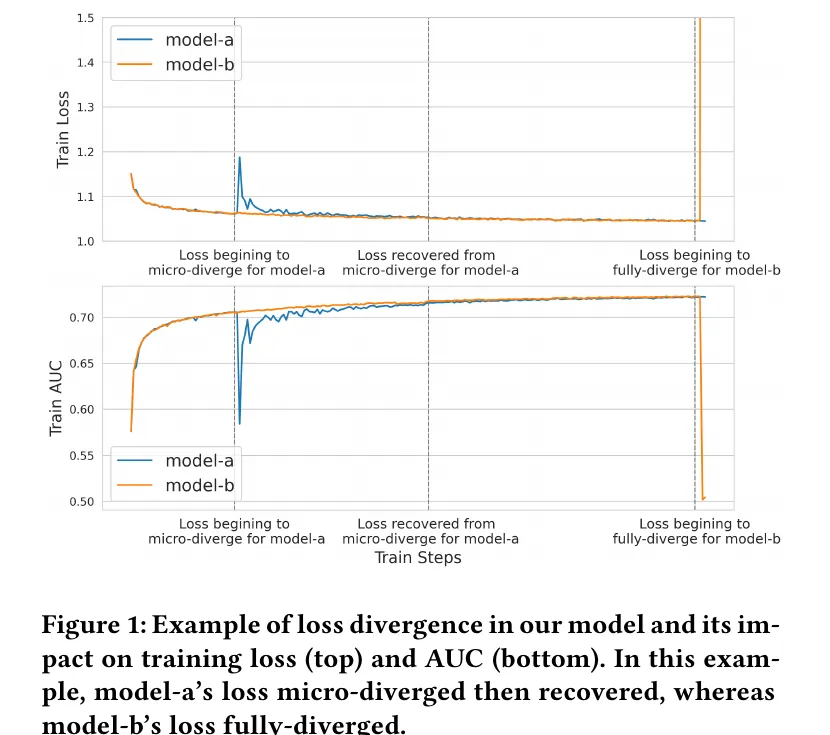
观察 Fig. 1 中两个模型在训练中途的轨迹差异:
- 微发散(蓝色曲线
model-a):在训练到约三分之一处,Loss 突然向上窜起一根尖刺,训练集 AUC 同步砸出一个深坑;但由于参数尚未彻底跌入死区,随着后续正常 batch 的梯度修正,曲线很快拉回正轨,最终收敛的 AUC 与从未发散过的健康模型几乎一致。 - 完全发散(红色曲线
model-b):在训练后半程(约 60% 进度处),Loss 突然垂直飙升并维持在高位,二分类 AUC 直接断崖式跌落到0.5附近并变成一条死水般的水平线。此时网络内部已发生大面积激活函数死区(如 Dying ReLU),继续喂再多数据也无法恢复。
在工业流水线里,真正棘手的是完全发散带来的三重治理困境:复现难(Reproducibility,发散受随机种子、异步数据流与硬件并发影响,偶发性极强,很难抓到引发崩盘的那个特定 batch)、检测难(Detection,高频跑评估集拖慢训练吞吐,低频评估又容易漏掉微发散前兆)以及 度量难(Measurement,开训前没有先验指标能预判某个新结构会不会在第 50 万步崩掉,只能靠多模型容量、多倍学习率、多随机种子的网格压测来检验)。
1.2 为什么精排模型比召回模型脆弱得多?
沿着 YouTube DNN 经典的“召回(Candidate Generation / Retrieval) 精排(Ranking)”两阶段架构来看,工业界一个普遍的经验现象是:多任务精排模型发生训练发散的频率,远高于召回模型。
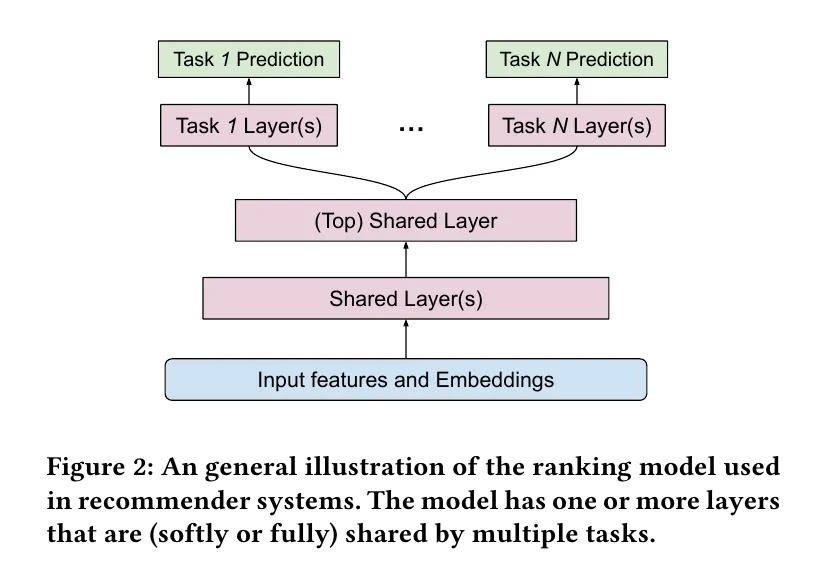
为什么会这样?看看 Fig. 2 展示的典型多任务精排拓扑(Shared-Bottom 架构)就能明白:
- 特征与交叉结构复杂度的量级差异:召回模型为了满足线上近似最近邻(ANN)检索的延迟与内积解耦要求,特征通常只包含粗粒度用户历史与基础上下文,双塔结构相对轻量;而精排模型只需对几百个候选视频做打分,因此塞入了海量高维稀疏特征、细粒度统计特征、用户-视频交叉特征,并在底层堆叠了 DCN-v2 等高阶显式交叉网络与宽达数千维的深层 MLP。
- 多任务异构目标的梯度拉扯:精排模型需要同时预测点击(Click)、完播(Watch)、点赞(Like)等二分类目标,观看时长(Watch Time)等回归目标,以及隐藏/不感兴趣等负反馈目标。不同任务的损失函数量纲、正负样本比例与梯度方差天差地别。
- 共享底座(Shared Bottom)的故障放大效应:设底层共享网络参数为 ,第 个任务塔的专属参数为 ,总损失为 个任务损失的加权和:
对底层共享参数 求梯度,它直接等于所有任务回传梯度的线性叠加:
平时,这种共享能让数据稀疏的任务借用主任务的表征;但一旦其中某一个回归任务或稀疏任务在某个 batch 上撞上极端样本、爆出异常大梯度,这个冲击就会直接写入底层共享参数 。紧接着在下一步前向传播中,被污染的底层表征会同时喂给所有 个任务塔,诱发全网跨任务的连锁崩溃。
1.3 稳定边界与流式训练的三重挤压
从优化理论来看,崩盘的本质是什么?我们用最直观的二次损失曲面近似来拆解。对于步长为 的标准梯度下降 ,参数要想收敛而不发生发散震荡,步长 与损失函数海森矩阵(Hessian Matrix)的最大特征值 (即局部曲面最陡峭方向的曲率 / Sharpness)必须满足经典的稳定边界条件(Edge of Stability):
一旦当前点沿着某个特征方向的局部曲率 突然变陡,使得有效步长跨过了 这条红线,迭代点就会在峡谷两侧越弹越高,呈指数级发散。
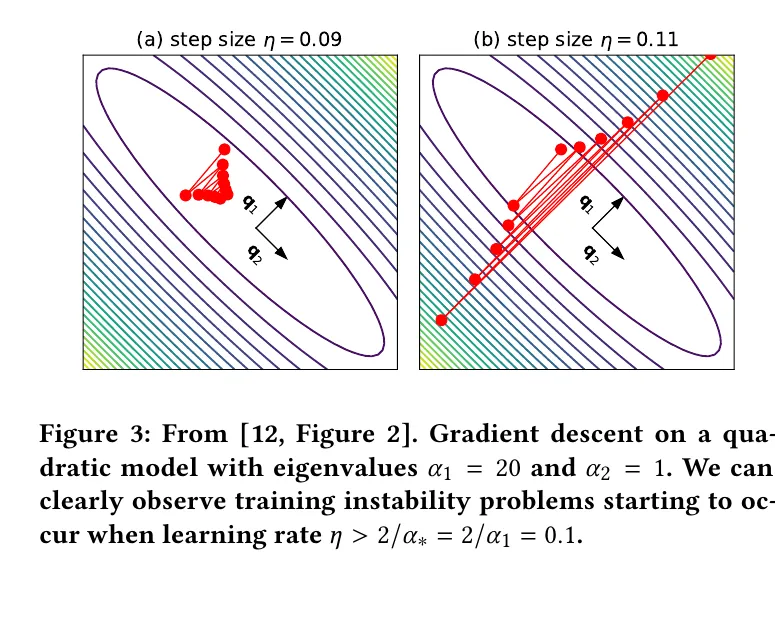
Fig. 3 用一个最大特征值 的二维二次曲面算例直观展示了这道生死线:此时稳定边界为 。当步长取 0.09(左图)时,轨迹虽然在峡谷壁之间来回折返,但振幅逐步收敛并稳稳滑向谷底最优解;而当步长仅仅增加到 0.11(右图,只超出边界 10%)时,每一次跨谷反弹都会把误差放大,几步之内就彻底飞出稳定区。
在学术界的静态数据集(如 ImageNet)上,数据分布是固定的,我们只要把初始学习率调到安全线以下就能高枕无忧。但在 YouTube 这样的工业级流式训练(Sequential Training)环境中,有三股力量在训练中途不断把局部曲率 往高处推:
- 流式数据分布突变(Data Distribution Changes):模型按时间顺序持续消费最新产生的用户行为日志。突发社会热点、节假日流量切换或上游候选源策略变更,都会让输入特征与标签分布在某个时间窗口突然漂移,导致损失曲面瞬间变陡。
- 模型容量与高阶交叉结构升级(Model Size & Complexity):深度学习的经验规律表明,网络越宽越深、或者引入了 DCN 这类多项式乘积交叉层,训练过程中的海森最大特征值 就越容易飙升,稳定边界 随之急剧收窄。
- 多目标梯度耦合与大 Batch / 高学习率需求(Multiple Objectives & Aggressive Hyperparameters):为了吃透海量流式日志并加快实验周转,工程团队总是希望尽可能调大 Batch Size 和学习率 ——这就好比一边在不断收窄峡谷的宽度(推高 ),一边又在不断加大跨越的步幅(推高 ),擦枪走火引发完全发散几乎成了必然。
2. 传统梯度裁剪为什么拦不住 Adagrad 崩盘?
2.1 GC、AGC 与 LAMB 的盲区:原始梯度与实际步长的错位
推荐模型里充斥着幂律分布的稀疏 ID 特征,工业界最常用的主力优化器是 Adagrad。在时间步 ,记损失函数对某层参数 的随机梯度为 ,Adagrad 维护一个逐坐标累加的历史梯度平方和 ,并据此计算预条件更新方向 与参数更新:
注意上式中的所有平方、开方与乘法都是按元素逐坐标(Coordinate-wise)执行的。真正加减到参数 身上的实际更新步长,是经过 逐坐标放缩、再乘以当前学习率 后的 。
当曲面变陡时,我们自然想把步长缩回来(乘一个缩放系数 )。看看现有的三类主流方法是怎么做的:
- 标准梯度裁剪(Gradient Clipping, GC):当原始梯度的二范数 超过阈值 时,按 缩小梯度。它的致命伤在于各层的梯度尺度差异极大,固定阈值 极难调优;更糟糕的是,它完全看不见 Adagrad 的累加器 。
- 自适应梯度裁剪(Adaptive Gradient Clipping, AGC):为了免去逐层调阈值的痛苦,AGC 把梯度的二范数与参数自身的二范数作比较,令 。这比 GC 进了一步,但它监控的依然是原始梯度 !试想:某个冷门坐标此前几乎没怎么更新过,累加器 接近于 0;突然来了一个中等大小的梯度 ,在 AGC 看来 完全正常,根本不触发裁剪,但除以极小的 后,预条件步长 却直接炸飞了!
- LAMB 优化器迁移:LAMB 直接用参数范数与预条件更新范数的比值 来重标定步长。它虽然盯住了 ,但因为它彻底丢掉了更新量本身的幅值信息、强行让每一步的更新比例对齐参数范数,在训练初期参数范数 较小时会过度压制步长,导致模型虽然不崩,但收敛极慢、最终精度严重掉队。
2.2 抓拍失稳前夜的黄金窗口:step-b 发生了什么?
为了看清崩溃到底是怎样在几步之内发生的,作者在 Fig. 4 中用放大镜对准了一次真实完全发散事故的现场,抓拍了三个关键时刻:
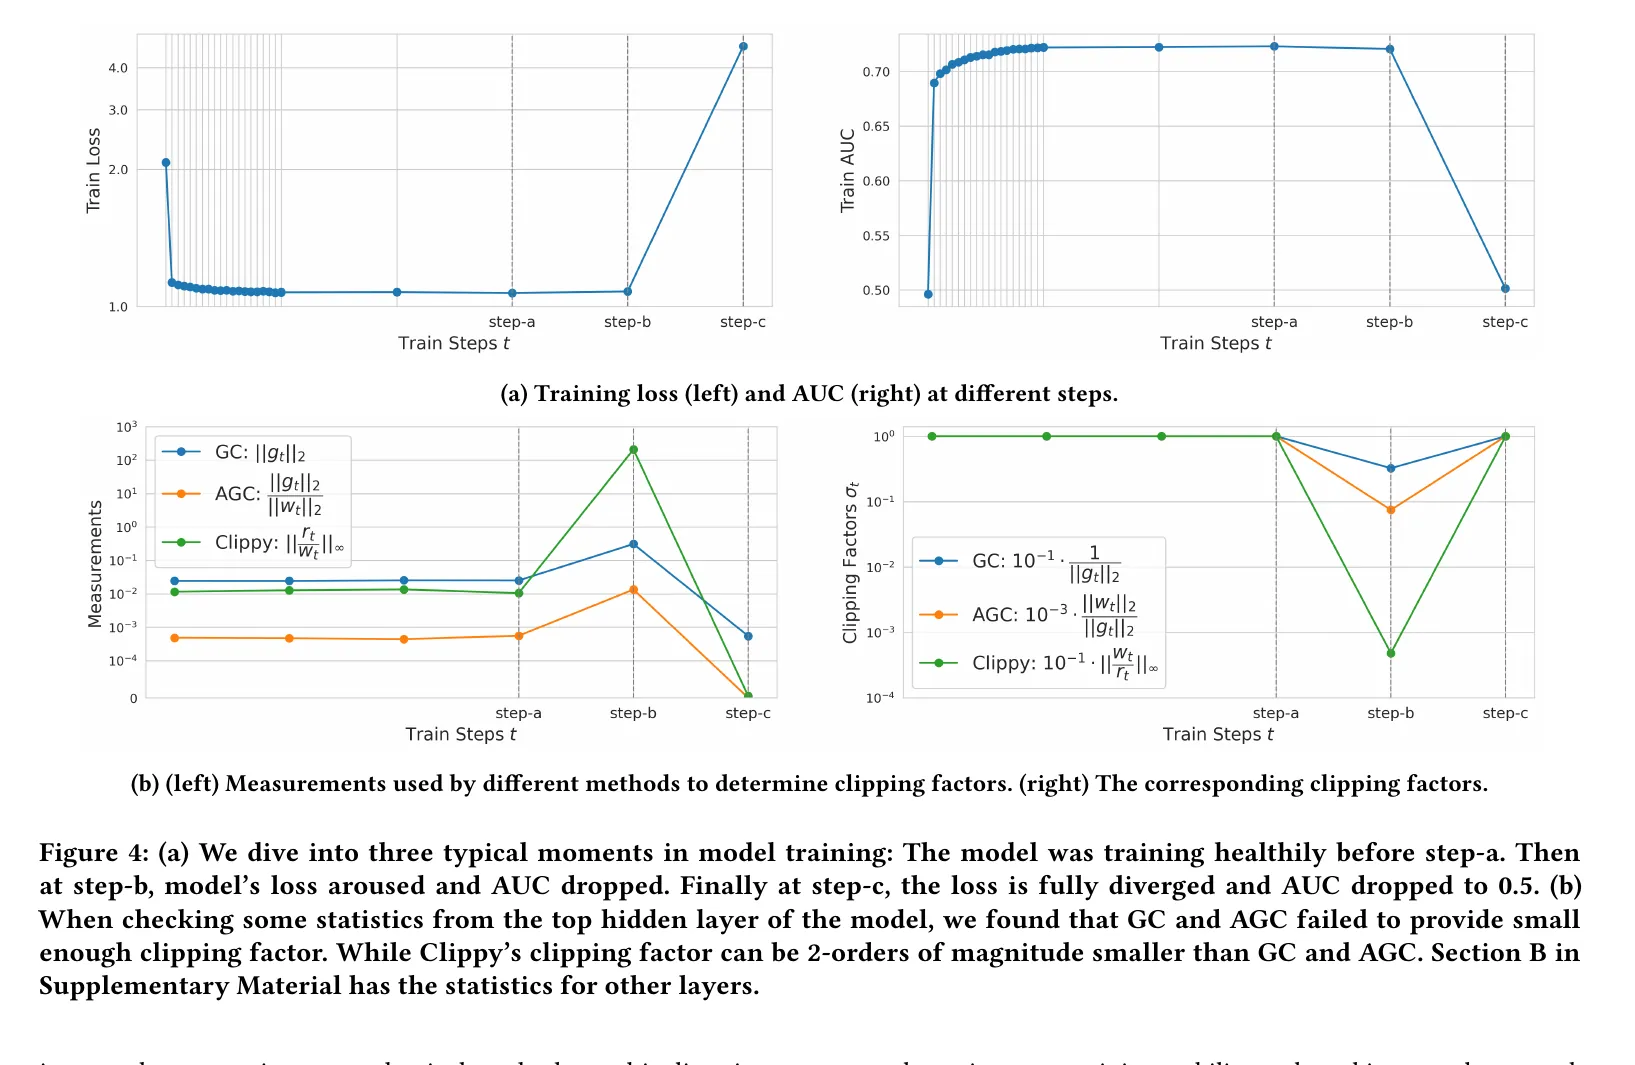
仔细看 Fig. 4a 标出的三个时间点与 Fig. 4b 顶层共享隐藏层(Top Hidden Layer)的内部指标轨迹:
step-a(健康期):Loss 平稳,AUC 处于高位,各项梯度与更新指标一切正常。step-b(失稳起跳的黄金抢救窗口):此时训练 Loss 刚刚抬头,AUC 只出现了极其微小的下滑,模型整体表征还没坏透。然而在网络内部,顶层隐藏层的梯度范数和更新量已经爆出了一根陡峭的尖刺!step-c(完全坍塌的死亡期):仅仅过了很短的时间,Loss 已经冲上云霄,AUC 砸穿到0.5。更诡异的是,看 Fig. 4b 的第一行——到了step-c时,该层的梯度范数反而暴跌到了接近 0 的水平!
为什么 step-c 损失这么大,梯度反而变成 0 了?因为 step-b 那一脚失控的大步长,已经把大批神经元的权重踹进了 ReLU 激活函数的负半轴死区(Dying ReLU),前向输出恒为 0,反向回传的梯度自然也全变成了 0。这意味着:等到 step-c 看到 Loss 爆炸再去裁剪,神仙也救不活了;唯一能救命的时刻,就是在 step-b 异常步长刚露头的瞬间把它死死按住!
那么在生死攸关的 step-b 时刻,GC 和 AGC 干什么去了?看 Fig. 4b 最下面两行:在 step-b 处,GC 和 AGC 虽然也察觉到了异常,但它们算出来的裁剪系数 都在 0.1~0.5 左右,只是轻描淡写地削掉了一半步长;唯有最底下一行的 Clippy,在 step-b 瞬间给出了低至 0.001 量级(比 GC/AGC 小整整两个数量级)的强力缩放系数!
为什么 GC 和 AGC 在 step-b 会如此迟钝?罪魁祸首就是 二范数( Norm)的维度稀释效应。在一个 的大宽层里,共有 个参数坐标。假设在 step-b 这一步,有 100 个与特定稀疏交叉特征相连的坐标因为数据突变,预条件步长暴涨了 500 倍,而其余 1677 万个坐标保持平稳。当你对整层求平方和再开根号算 范数时,这 100 个坐标的 500 倍暴涨被上千万个分母一平均,整体 范数只温和地涨了不到两倍!GC 和 AGC 看着温和的 范数觉得“问题不大”,结果那 100 个坐标一脚踩穿稳定边界,直接把下一层神经元打进死区,引发全网雪崩。
3. Clippy 核心算法:逐坐标边界与四类方法统一视角
3.1 Adagrad with Clippy 的五步迭代与几何直觉
既然症结在于“Adagrad 预条件步长 失控”与“ 范数稀释局部坐标突变”,Clippy 的解法就非常顺理成章了。
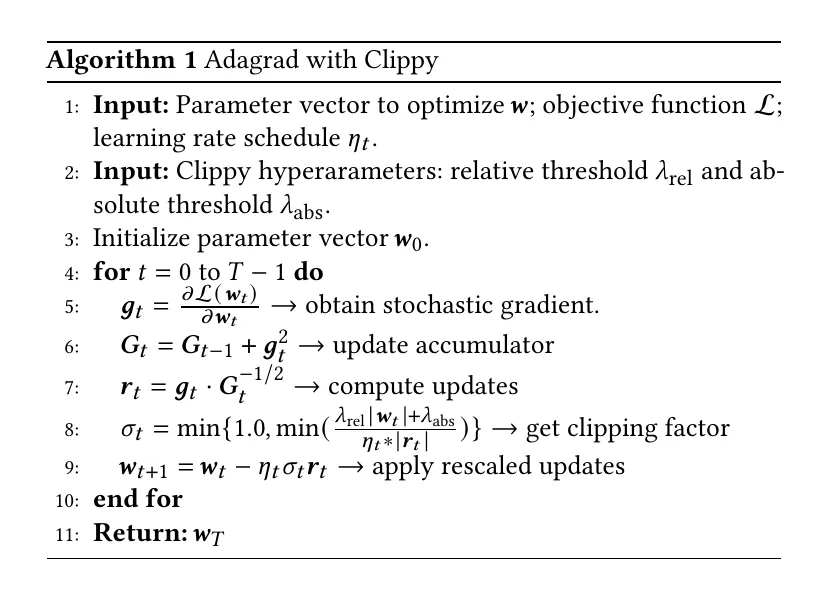
对照上面 Algorithm 1 的伪代码,在每一步迭代 中,Clippy 对每一层参数张量 执行如下五步计算:
- 计算随机梯度:。
- 累加逐坐标梯度平方:。
- 计算 Adagrad 预条件更新方向:。
- 计算层级标量裁剪系数 :
- 执行裁剪后的参数更新:。
怎么直观理解第 4 步这个核心公式?我们把第 4 步的内层最小化条件拆开,移项到不等式两边:对于该层张量里的每一个坐标 ,Clippy 要求它在本步真正走出的参数位移绝对值 ,绝对不能超过由该坐标当前权重绝对值 与绝对下界 共同决定的安全红线:
这里有一处非常精妙的几何权衡:为什么先逐坐标算比例上限,最后却取全层最小值 得到一个统一的标量 去乘整层的 ,而不干脆把每个坐标各自独立截断(Element-wise Clipping)?
因为如果只把越界的那 100 个坐标截断,而不动同层的其余坐标,整层更新矢量 的几何指向(Direction)就会发生严重扭曲,相当于在梯度下降时走偏了方向,会严重破坏优化收敛性;而取满足所有坐标安全约束的最小标量 统一缩放整层,既保证了哪怕只有 1 个坐标发疯也能立刻把全层步幅拉住(具备无穷范数 级别的峰值敏感度),又完好无损地保留了 Adagrad 预条件更新矢量 的原始方向!
3.2 破除零初始化死锁与学习率耦合机制
再看分子上的双阈值项 (论文经验超参通常设 或 ,)与分母上的学习率 :
- 为什么不能漏掉绝对阈值 ? 在神经网络初始化时,偏置项(Bias)通常全部初始化为
0,许多权重坐标也随机落在0附近。如果没有 ,当 时,允许的最大更新步长 就等于0——参数从第 1 步起就被永久冻结在 0 上,一步也动不了!加上 后:- 在训练初期(), 挑大梁,允许零值和小权重以至少 的安全步幅快速破冰启动(行为类似 GC);
- 在训练中后期( 已经长到较大数值), 自动接管主导权,允许大权重迈出成比例的大步幅(行为平滑过渡为 AGC)。
- 为什么要把学习率 放进分母? 传统 GC 和 AGC 的裁剪系数只看梯度和权重,跟学习率 无关——如果你把外部学习率调高 2 倍,就算触发了相同的裁剪系数,参数实际迈出的步子还是跟著大了 2 倍。而 Clippy 把 显式写进分母 :当你为了加速收敛开启 2 倍学习率(2x LR)或者正处在 Warmup 爬坡期时,一旦某些步的 超出安全边界, 会自动成比例缩减一半来抵消过大的学习率。这正是后文实验中 Clippy 能稳稳跑通 2 倍学习率的数学根基。
3.3 从统一预条件框架看 GC、AGC、LAMB 与 Clippy
论文第 4.3 节将这四类方法统一写进了通用预条件更新公式 (其中 )。在这个统一坐标系下,四者的本质差异一目了然:
| 优化稳定性方法 | 统一框架下的有效缩放因子 | 监控对象与范数性质 | 为什么在工业精排模型中受限或胜出? |
|---|---|---|---|
| GC(标准梯度裁剪) | 原始梯度 ,层级 范数 | 忽略参数尺度、学习率与 Adagrad 累加器放缩;跨层阈值极难调 | |
| AGC(自适应梯度裁剪) | 原始梯度与参数比,层级 范数 | 虽引入参数相对尺度,但仍看原始梯度 ,且大宽层 范数严重稀释局部坐标尖峰 | |
| LAMB(信任域重标定) | (或带上限截断) | 预条件方向 ,层级 范数 | 强行用参数范数覆盖更新幅值,初期参数较小时步长过分保守,收敛慢且损害最终 AUC |
| Clippy(本文方法) | $\min\left{1,, \min_i \frac{\lambda_{\mathrm{rel}} | w_{t,i} | +\lambda_{\mathrm{abs}}}{\eta_t |
4. YouTube 生产实验与跨层消融拆解
4.1 三档复杂度压力测试与翻倍学习率大考
为了模拟工业界“模型越改越大、结构越改越复杂”的真实演进过程,作者没有只拿一个固定小模型跑实验,而是在 YouTube 生产排序数据集上构建了三档复杂度逐级递增的测试台(Table 1):
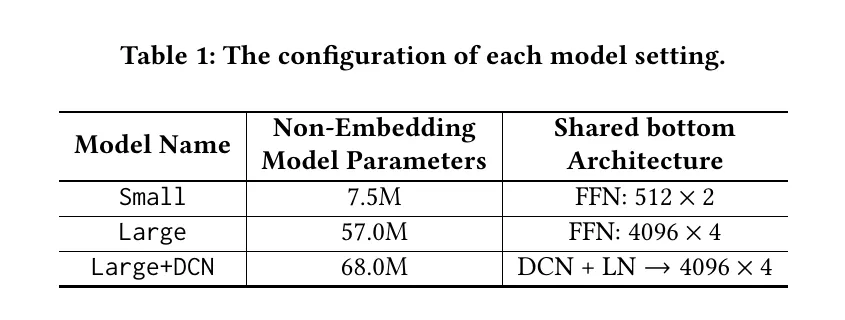
这三档模型共享相同的底层稀疏 Embedding 表,同时联合训练 6 个生产任务,但非 Embedding 的稠密网络结构步步加码:从基础的 Small(7.5M 稠密参数,2 层 512 维 FFN),扩容近 8 倍到 Large(57.0M 稠密参数,4 层 4096 维宽 FFN),再到最具挑战性的 Large+DCN(68.0M 稠密参数,在 4 层 4096 维 FFN 前面直接串入 DCN-v2 显式特征交叉网络与 LayerNorm)。每种优化方法都在基准学习率(1x)和翻倍学习率(2x)下寻找最优配置,并用 3 个随机种子跑完训练,汇报核心二分类任务的 AUC 与回归任务的 RMSE(Table 2):
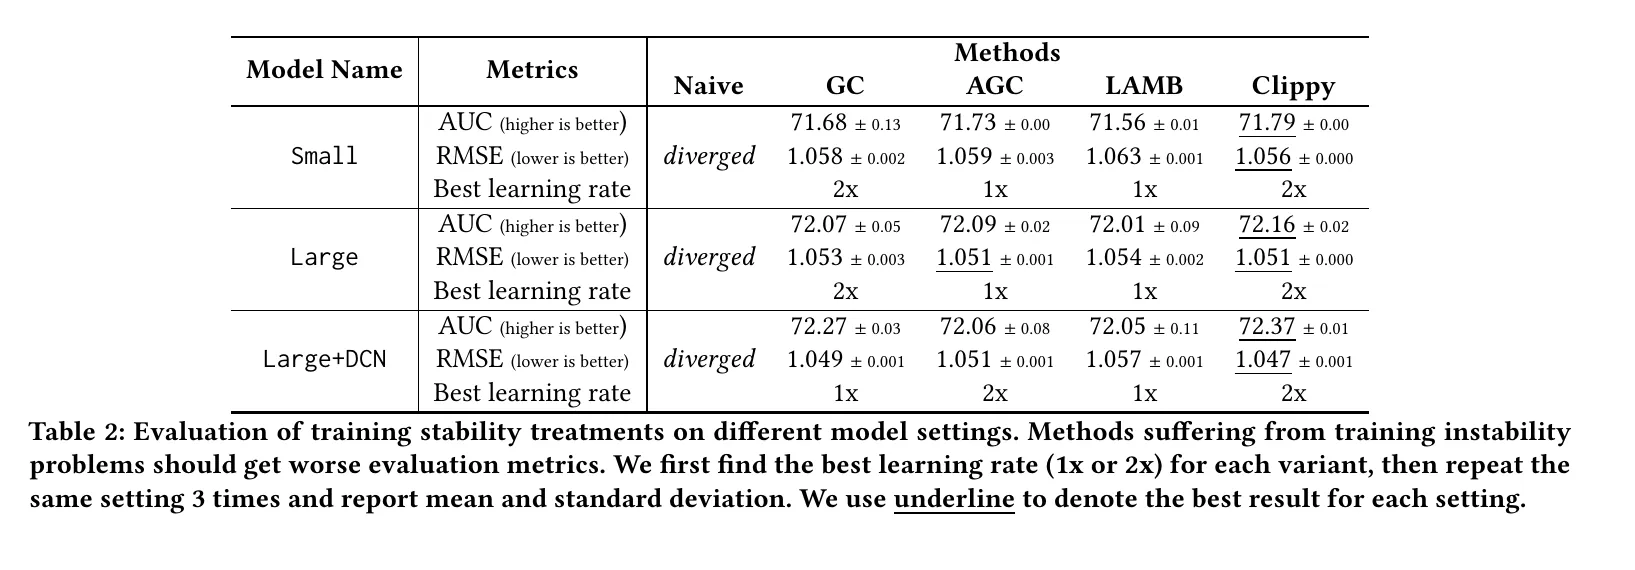
细读 Table 2 的实验矩阵,可以拆解出五层极具工程含金量的结论:
- 裸跑 Adagrad(Naive)在全线模型上 100% 暴毙:哪怕是最迷你的 Small(7.5M)模型配 1x 学习率,不加任何裁剪保护的 Naive Adagrad 也会全部发散(表中全为
diverged)。这说明在多任务流式数据下,局部高曲率冲击是必然发生的常态事件。 - 精心调参的 GC 在上马 DCN 后痛失 2x 学习率:在纯 MLP 结构的 Small 和 Large 模型上,人工精调阈值的 GC 其实非常能打,都能顺利开启
2x学习率;但一旦升级到引入高阶多项式交叉的 Large+DCN,GC 在2x学习率下当场崩盘,被迫退回1x学习率,导致最终 AUC 卡在72.27%。 - AGC 全线无缘 2x 学习率且在复杂模型上摇摇欲坠:AGC 在全部三档模型上都无法承受
2x学习率;到了 Large+DCN 上,即便退守1x学习率,其 3 个随机种子的 AUC 标准差也飙升到了±0.11(其它稳定方法通常只有±0.02~±0.05),证明 范数监控原始梯度已处于崩溃边缘。 - LAMB 虽能保命却付出了惨重的精度代价:LAMB 虽然在三档模型上都撑住了
2x学习率没崩,但它在 Large+DCN 上的 AUC 只有72.07%、RMSE 高达0.8220,比退回1x学习率的 GC 还要差一大截。这给工程团队敲响了警钟:不能光看训练崩没崩,靠无脑压小步长换来的“假稳定”会直接毁掉模型的收敛质量。 - Clippy 是全场唯一在 Large+DCN 上跑通 2x 学习率并刷新最高精度的方案:在 Large+DCN 上,Clippy 稳稳吃下了
2x学习率,将二分类 AUC 推高到72.37%(相比最强基线 GC 提升了整整+0.10%,在 YouTube 精排主模型中0.1%的离线 AUC 增幅已属于能直接兑现显著线上大盘收益的重大突破),同时将回归 RMSE 压低到全场最优的0.8180,且随机种子标准差仅有±0.02。
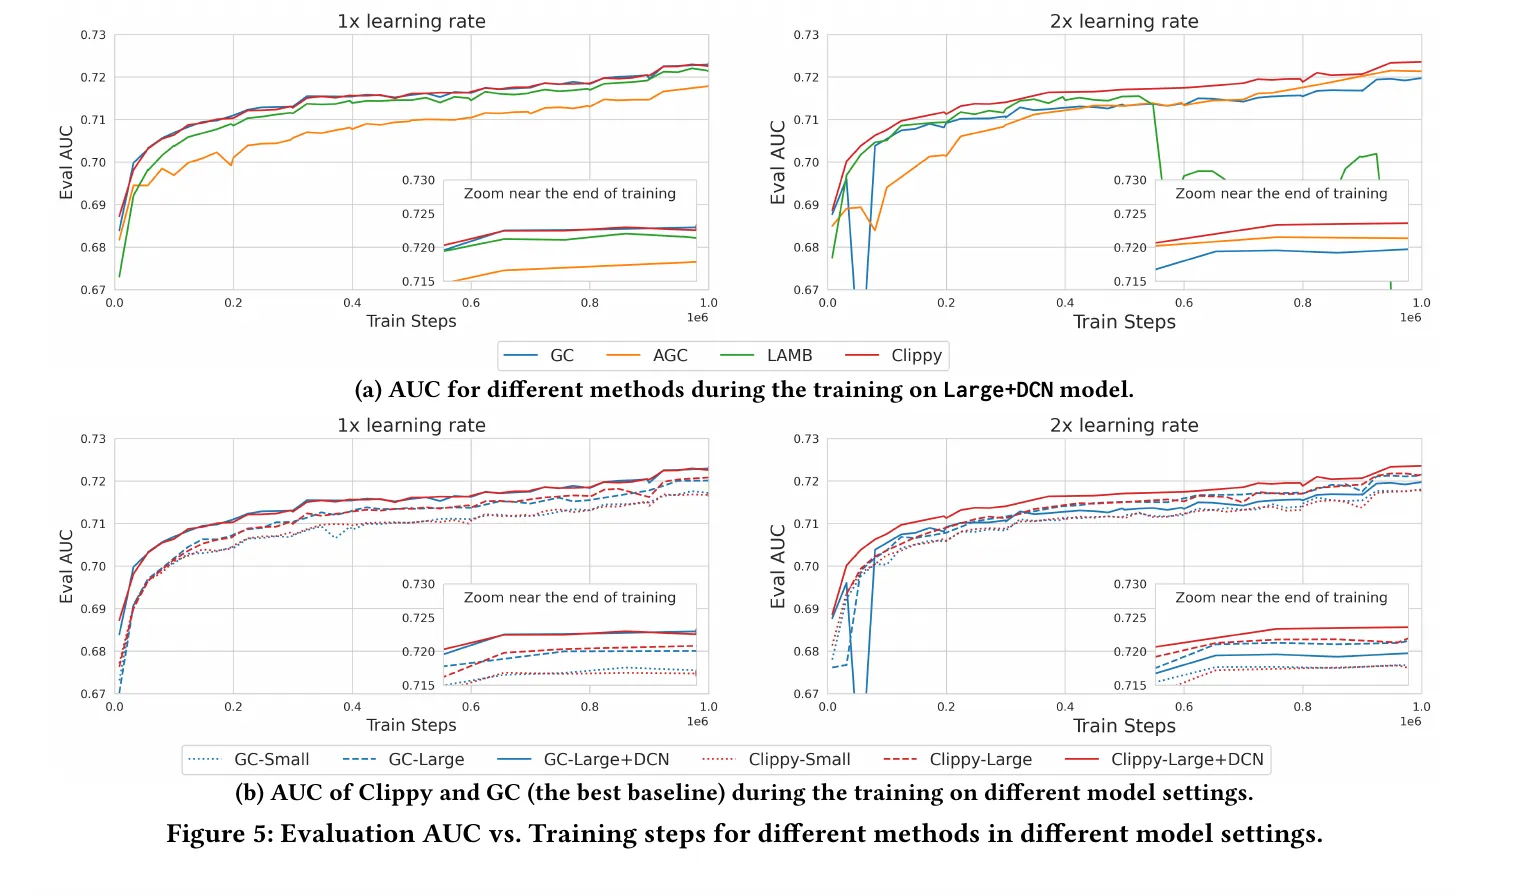
配合 Fig. 5 的全程训练曲线看就更加透彻了:在 Fig. 5a 的 1x 学习率(实线)下,GC、AGC 与 Clippy 的曲线几乎严丝合缝地叠在一起,证明在没有失稳风险的安全区,Clippy 绝不会瞎插手干扰正常收敛;而一旦切到 2x 学习率(虚线),GC 和 AGC 先后跳水崩盘,唯有 Clippy 一路丝滑攀升,把高学习率带来的收敛速度与精度上限红利吃干抹净。Fig. 5b 则直观展示了模型从 Small 升级到 Large 再到 Large+DCN 时,结构越复杂,Clippy 甩开传统 GC 的身位就越远。
4.2 哪一层最脆弱?跨层裁剪分布与诱因归因消融
在训练 Large+DCN 的过程中,Clippy 到底主要在替哪一层“踩刹车”?作者把五类网络层的裁剪系数 全程记录下来画成了 Fig. 6(数值越小说明裁剪越剧烈):
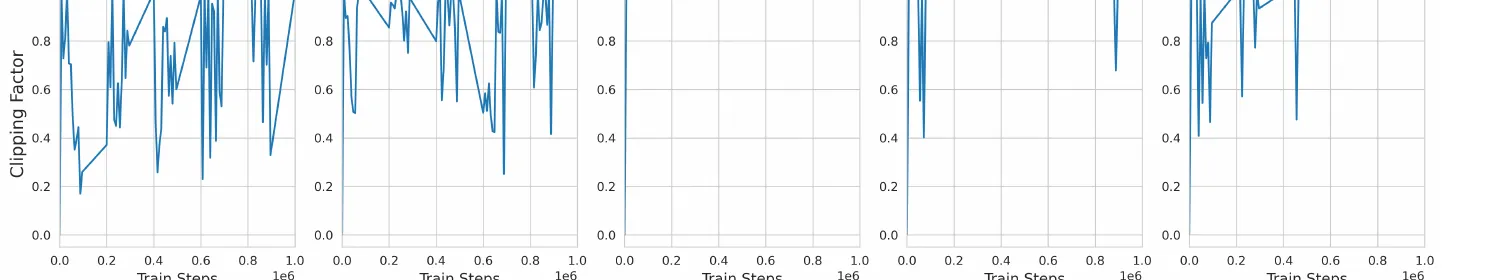
看 Fig. 6 的箱线分布,规律非常鲜明:越靠近输入端的底层共享结构(DCN 权重层与 Bottom Hidden 底层隐藏层),触发的裁剪越频繁、缩放系数也越小;而越靠近输出端的顶层共享层与各任务专属头,裁剪系数大多接近 1.0。
这完全印证了我们在第 1.2 节推导的梯度耦合机理:一方面,底层参数的初始范数通常较小,且直接汇集了全部 6 个任务的回传梯度;另一方面,底层权重的微小抖动会在穿过上层 4096 维宽网络与高阶交叉层时被逐层指数级放大。Clippy 无需任何人工指定层级权重,就自动把防线的火力集中在了最危险的 DCN 层与共享底座上。
为了进一步验证“到底是什么因素把模型推向崩溃”,作者在补充材料 Table 3 中做了一组极具说服力的减法消融实验:故意拿掉所有裁剪保护,把 Large+DCN 的学习率设在临近失稳边界的 0.4x,然后每次只拆掉一个高风险因素,看发散率(Divergence Ratio)怎么变:
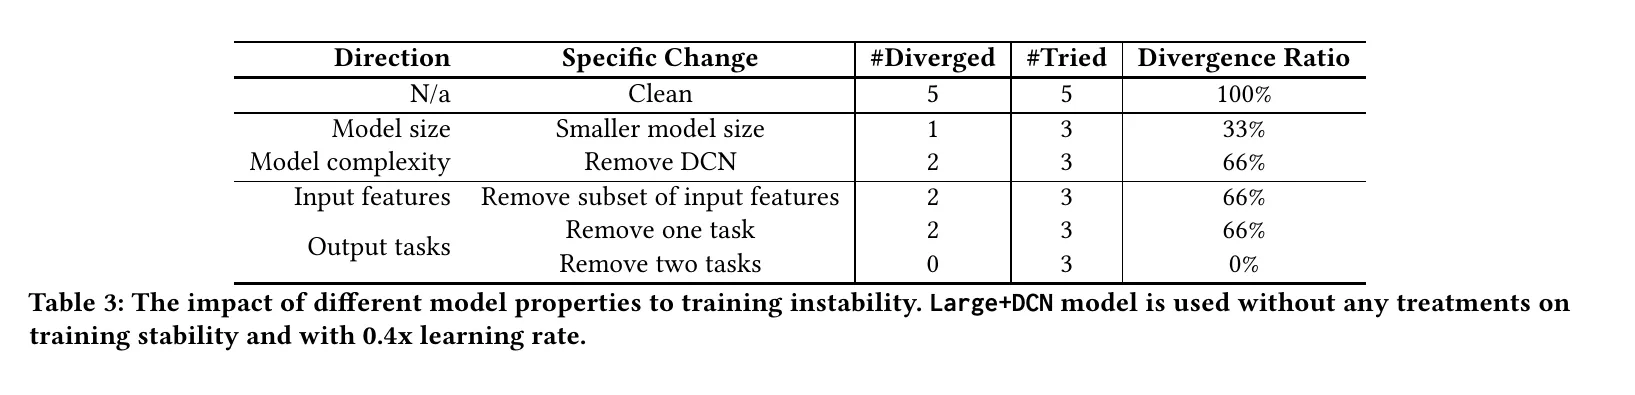
看 Table 3 的数据变化:原始满配的 Large+DCN 跑 5 次崩 5 次(发散率 100%);把模型容量缩小后,发散率立刻降到 1/3 (33%);单独拆掉 DCN 交叉层、单独砍掉一部分输入特征、或者单独拿掉 1 个训练任务,发散率都从 100% 降到了 2/3 (66%);而一旦从 6 个任务里拿掉 2 个任务,3 次训练居然全部安全跑完(发散率直接降为 0%)!这组干净的控制变量实验,把“大容量 + DCN 交叉 + 多特征 + 多任务耦合”共同把模型推过稳定边界的过程抓了个现行。
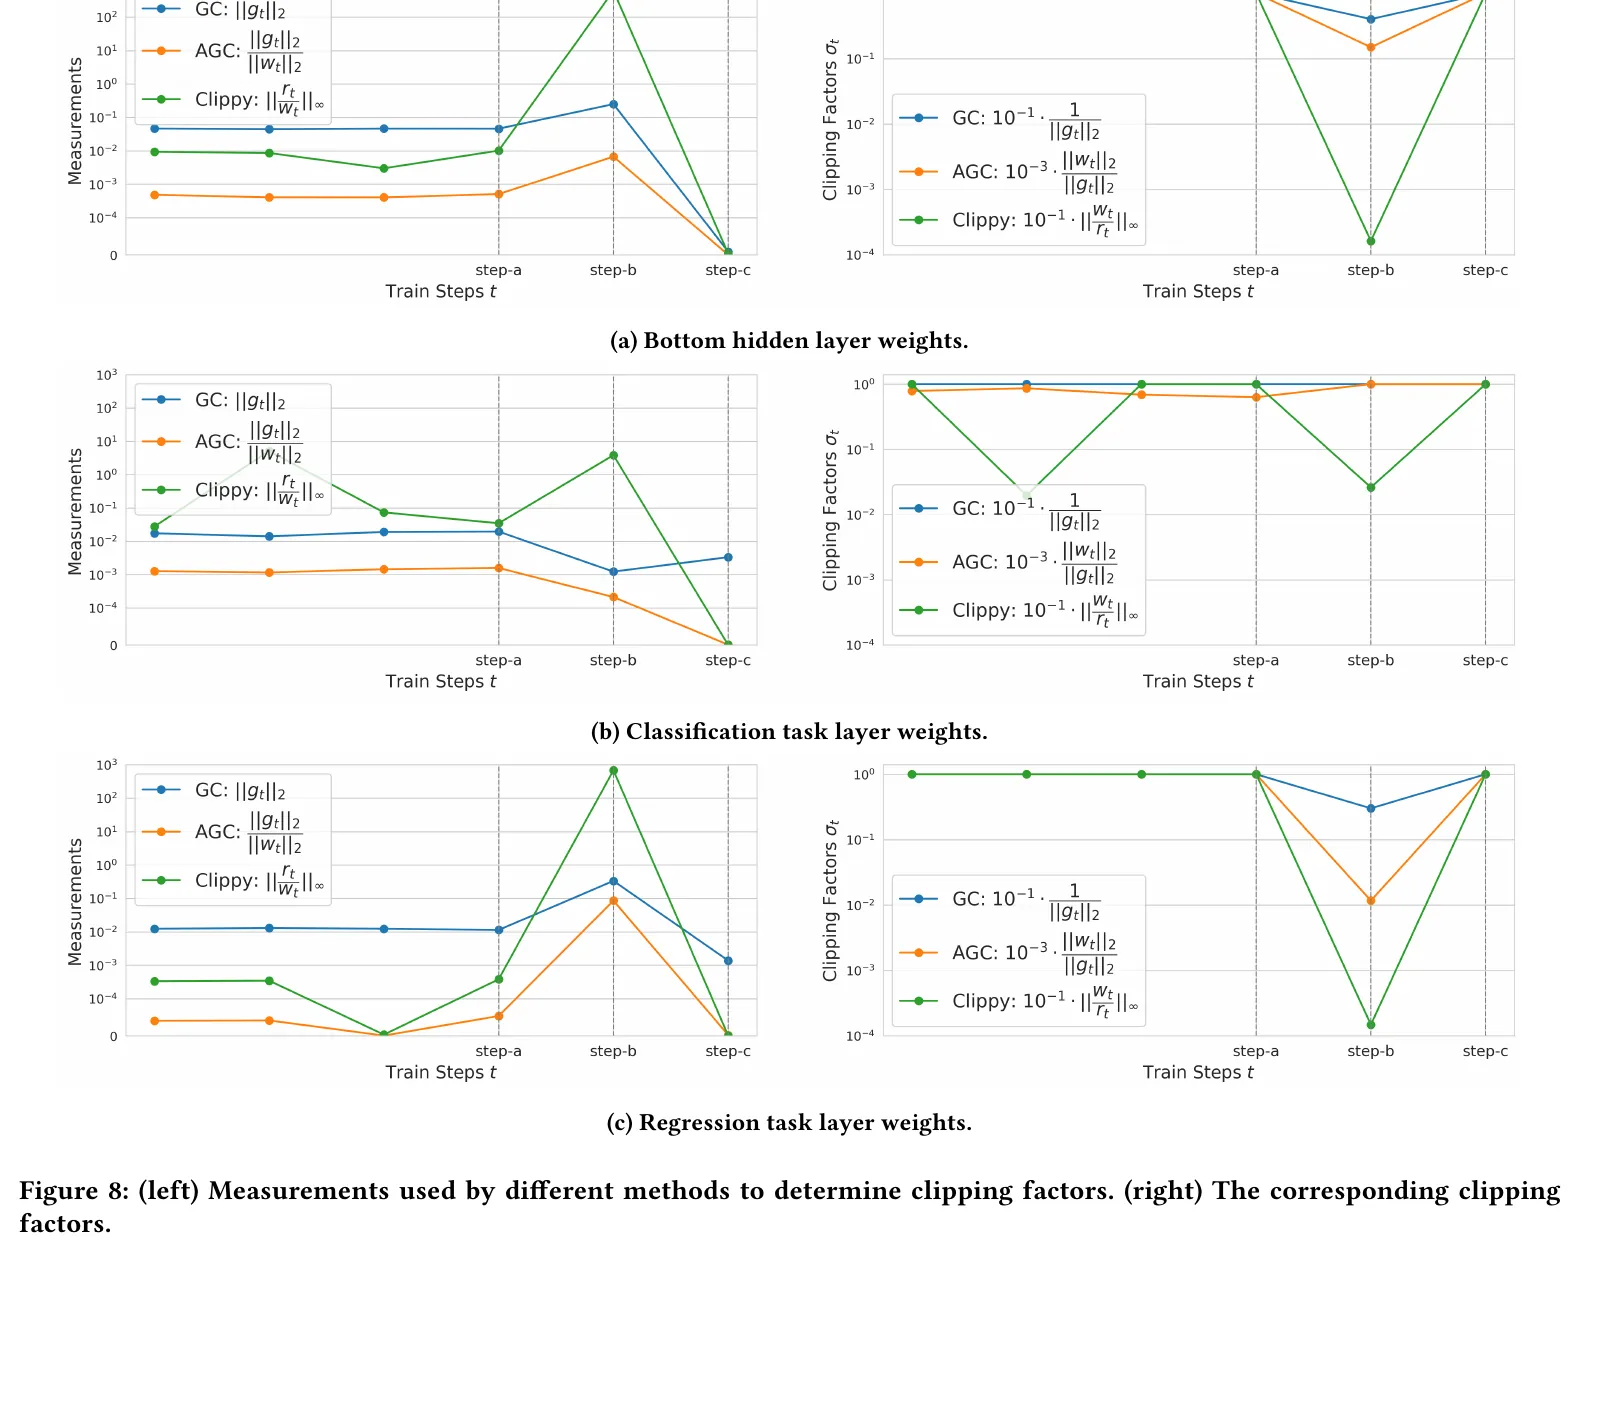
补充材料 Fig. 8 还展示了失稳时刻 step-b 在其余各层上的表现。最抓人眼球的是中间列(Classification Task Layer Weights,二分类任务头):在 step-b 时刻,这一层的全局梯度二范数几乎没有任何起伏,导致 GC 和 AGC 给出的裁剪系数恒等于 1.0(完全躺平未介入);而 Clippy 却依靠逐坐标检查,敏锐抓住了该任务头内部少数坐标上的预条件步长突变,果断将裁剪系数压低到 0.1 以下完成拦截。
4.3 走出推荐系统:Transformer 机器翻译上的边界检验
Clippy 的逐坐标更新裁剪思想能不能搬到推荐系统之外的通用深度学习任务上?作者在 WMT 英德机器翻译基准(translate_wmt 数据集 + xformer_translate Transformer 模型)上做了一组跨界对比(Fig. 7):
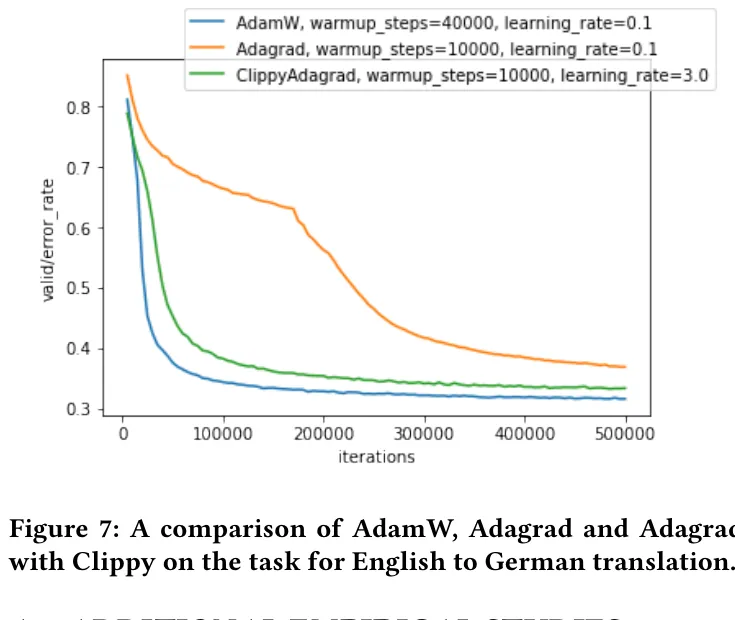
观察 Fig. 7 的学习率扫描曲线(纵轴为验证集错误率,越低越好),我们可以对 Clippy 的能力边界做出非常清醒的判断:
- 对比原生 Adagrad(蓝线 vs 绿线):原生 Adagrad 在训练 Transformer 时极其脆弱,学习率稍微调到 以上就全面崩盘,最佳验证错误率停留在
36.9%;加上 Clippy 后(绿线),不仅能稳稳扛住高達 以上的激进学习率,最佳错误率也大幅压低到了33.4%。 - 对比 NLP 霸主 AdamW(绿线 vs 红线):尽管 Clippy 让 Adagrad 脱胎换骨,但在纯稠密 Transformer 翻译任务上,AdamW 依然以
31.6%的错误率保持领先。这是因为 AdamW 拥有一阶梯度动量(Momentum)与指数移动平均的二阶矩估计,天生更契合纯稠密注意力网络的曲率特性;而在工业推荐系统中,由于百亿级稀疏 Embedding 表无法承受全局动量带来的内存开销与陈旧梯度漂移,系统往往必须绑定 Adagrad——此时,Clippy 就是帮 Adagrad 驯服上层深层交叉网络与注意力模块的最佳搭档。
5. 源码深挖:TFRS ClippyAdagrad 的三处工程改造
在 TensorFlow Recommenders 官方仓库的 clippy_adagrad.py 中,作者将 Clippy 封装为了生产级 Keras 优化器 ClippyAdagrad。细读源码可以发现,相比论文 Algorithm 1 的精简公式,工业级源码为了应对真实生产环境的极端情况,做了三处非常老道的工程升级。
5.1 shrink_by_references 与累加器参考尺度扩展
源码将核心的逐坐标边界计算抽成了一个独立的纯函数 shrink_by_references():给定待裁剪的实际更新张量 tensor(即代码中的 delta = lr * grad * precondition)、一组参考张量列表 references、对应的相对系数列表 relative_factors 以及绝对下界 absolute_factor,寻找满足所有坐标约束的最大标量缩放因子 :
def shrink_by_references(
    tensor: tf.Tensor,
    references: Sequence[tf.Tensor],
    relative_factors: Sequence[float],
    absolute_factor: float,
) -> Tuple[tf.Tensor, tf.Tensor]:
  # 计算每个坐标允许的最大更新量:sum_j (|ref_j| * factor_j) + absolute_factor
  max_delta = tf.reduce_sum(
      [
          tf.math.abs(reference) * relative_factor
          for reference, relative_factor in zip(references, relative_factors)
      ],
      axis=0,
  ) + absolute_factor
  # 算出每个坐标所需的缩放比,当 tensor 坐标为 0 时安全回退为 1.0
  per_element_scale = tf.where(
      tensor == 0.0, 1.0, max_delta / tf.math.abs(tensor)
  )
  # 取全张量所有坐标的最小缩放比,并截断在 1.0 以内
  scale = tf.minimum(1.0, tf.reduce_min(per_element_scale))
  return tensor * scale, scale
看 ClippyAdagrad.update_step() 调用这个函数时的传参,第一处隐藏升级就浮出水面了:论文公式里分子只有权重绝对值 一项参考量,而源码传入的 references 列表里却有两个张量——当前变量值 variable_values(对应 )和 Adagrad 预条件因子 precondition(即 )!
也就是说,源码实际执行的逐坐标安全边界是:
为什么要多加一项累加器参考阈值 (对应初始化参数 accumulator_relative_threshold,默认设为 0.0 以兼容原论文,可按需开启)?因为随着训练步数推进,累加器 单调递增, 会自然衰减。开启这一项后,那些历史梯度较小、累加器还没涨起来的稀疏坐标在训练初期能获得更宽松的探索空间,而在训练后期随着累加器增大则自动收紧边界,实现随特征频次自适应的退火控制。
5.2 延迟累加器更新:防止异常梯度永久污染学习率
在论文 Algorithm 1 中,第 2 步是先把当前梯度平方 加进累加器 ,第 3 步再用新的 算预条件步长 。
但在真实的流式训练中,这样做有一个严重的隐患:万一某一步因为上游日志抽风,爆出了一个比平时大一万倍的极端离群梯度(Outlier Gradient),如果你不管三七二十一先把 (放大一亿倍!)累加进 ,那么哪怕这一步的更新 被 Clippy 成功拦住了,累加器 却已经被这一个异常 batch 永久撑爆了!由于 Adagrad 的累加器只增不减,在此后的几百万步里, 都会趋近于 0,相当于这个参数坐标的有效学习率被永久废掉了。
为了堵住这个漏洞,ClippyAdagrad 在源码中引入了两个精妙的控制开关(默认 use_standard_accumulator_update=False):
- 先用旧累加器算步长并裁剪:在
step开始时,暂不更新累加器,先拿上一步的旧累加器 计算预条件因子(G_{t-1} + epsilon)^{-1/2}与未裁剪步长delta,并调用shrink_by_references算出本步的裁剪系数clipping_factor(即 )。 - 可选用裁剪后的干净梯度更新累加器(
clip_accumulator_update=True):拿到 后,如果开启了clip_accumulator_update,代码会把原始梯度乘上 ,用裁剪后的有效梯度 去更新累加器 !这样一来,极端离群梯度不仅在本步无法踹飞模型权重,更无法污染历史累加器,彻底斩断了异常 batch 的后遗症。
5.3 IndexedSlices 稀疏切片支持与裁剪系数监控导出
在推荐模型中,Embedding 表的梯度在 TensorFlow 里采用稀疏结构 tf.IndexedSlices 表示,仅存储当前 batch 命中 ID 的行索引(indices)与对应梯度值(values),并未展开为完整的稠密张量。如果直接对几百万行的整张 Embedding 表做逐坐标除法,显存和延迟当场就会爆炸。
在 ClippyAdagrad.update_step() 中,源码专门针对 isinstance(gradient, tf.IndexedSlices) 编写了全稀疏路径:先用 tf.gather 仅把当前 batch 命中的那些行的权重切片 variable_values 和累加器切片 accumulator_values 抽出来,仅在这个极小的活跃子集上调用 shrink_by_references() 计算缩放系数,最后通过 scatter_add 与 scatter_sub 原地写回稀疏行。
同时,当开启 export_clipping_factors=True 时,优化器会在内部为每一层权重自动创建一个不可训练的标量状态槽(Slot),每一步通过 self._clipping_factors[idx].assign(clipping_factor) 实时刷写该层的 。工程团队只需把这些槽位挂进 TensorBoard,就能在训练大盘上直接看到类似论文 Fig. 6 的全网各层裁剪热力图——一旦发现某次上线新特征后某个特定层的 突然高频跌穿 0.01,就能在模型崩盘前精准定位出惹祸的特征或任务头。
6. 工业落地指南与推荐架构全景坐标
6.1 在自有精排系统中渐进接入 Clippy 的五步法
如果你所在的推荐或广告团队正在被多任务精排模型的偶发崩溃困扰,建议按照以下五步工程清单稳妥推进:
- 建立分级熔断与案发现场快照:在训练监控中明确区分“微发散(瞬时抖动后自愈)”与“完全发散(核心任务 AUC 跌穿门限且持续 步不恢复)”。一旦触发告警,自动落盘前 10 个 batch 的样本时间戳、各任务独立 Loss、各层梯度范数与激活死区比例。
- 从非 Embedding 稠密层开始灰测:与论文实验保持一致,第一阶段仅对 Shared Bottom、显式交叉层(DCN / AutoInt / MaskNet)及顶部任务塔等稠密参数启用
ClippyAdagrad(初始推荐超参variable_relative_threshold=0.1、absolute_threshold=1e-2),保持底层稀疏 Embedding 表的原有优化器不变,把改造风险压到最低。 - 打开延迟累加器隔离与裁剪监控导出:在生产流式训练中,强烈建议开启
use_standard_accumulator_update=False与clip_accumulator_update=True防御脏日志冲击,并打开export_clipping_factors=True。如果观察到某一层长期处于 的持续重度裁剪状态,说明该层阈值过严(Over-clipping),应适度放宽以免重蹈 LAMB 欠拟合的覆辙。 - 用“复杂结构 × 翻倍学习率”矩阵验真:评估 Clippy 的收益时,绝不能只看原有保守超参下的单次跑分。应当同步测试
1.5x~2x学习率以及此前因频繁发散而被迫放弃的大容量交叉结构,检验它能否帮你把原本跑不通的高收益架构安全训出来。 - 守住线上发布门禁:优化器只能保证模型“沿着你给的目标函数稳定收敛”,但管不住特征穿越(Data Leakage)、曝光选择偏差(Selection Bias)或多目标权重配错。模型稳定训完后,依然必须经过离线校准度核验、Shadow 流量比对与小流量 A/B 护栏验收。
6.2 在推荐系统技术版图中的生态位与总结
把 Clippy 放回本站精读过的工业推荐系统技术版图中,我们可以清晰地看到它与其它核心架构是如何咬合运转的:
- 对比长序列用户兴趣建模 SIM:SIM 通过两阶段搜索(GSU + ESU)把长达 54000 的用户终身行为浓缩进精排模型;当这类包含多头注意力与长短期特征拼接的复杂模块接入多任务精排底座时,损失曲面的局部曲率会进一步变陡,Clippy 正是保障这类复杂特征交互模块在流式训练中不崩盘的底层护航者。
- 对比生成式推荐架构 Generative Recommenders (HSTU):HSTU 致力于将推荐模型从异构 DLRM 推向万亿参数的统一序列转导架构,以吃透算力扩展定律(Scaling Law);而在传统的工业级多任务 DLRM 阵地上,Clippy 则解决了一个最务实的生存问题——当团队不断往共享底座上叠加新特征、新交叉结构与新业务目标时,如何防止模型死在半路上。
归根结底,Clippy 最迷人的地方在于它的极简与克制:它没有去改精排模型的网络结构,也没有引入高昂的二阶曲率近似计算,只是敏锐地看穿了“Adagrad 真正改变参数的是预条件步长 ”以及“大宽层 范数会掩盖局部坐标起跳”这两个物理真相,用一行逐坐标的相对与绝对混合不等式,就在生死攸关的 step-b 窗口为工业级多任务推荐模型装上了最敏锐的自动刹车片。
参考资料
- Jiaxi Tang, Yoel Drori, Daryl Chang, Maheswaran Sathiamoorthy, Justin Gilmer, Li Wei, Xinyang Yi, Lichan Hong, Ed H. Chi, Improving Training Stability for Multitask Ranking Models in Recommender Systems, KDD 2023(arXiv:2302.09178).
- 官方开源实现:TensorFlow Recommenders
clippy_adagrad.py. - 相关核心文献:Edge of Stability (ICLR 2021)、Loss Curvature Perspective on Training Instability、NFNet / Adaptive Gradient Clipping (ICML 2021)、YouTube DNN (RecSys 2016).
comments