大型互联网推荐平台每天实时产生的用户曝光、点击、完播与互动事件动辄以百亿计——单日沉淀的“行为 Token”总量,甚至比训练 GPT-3 或 LLaMA-2 的全部文本语料还要庞大。然而在过去十年里,当自然语言处理与计算机视觉沿着算力扩展定律(Scaling Law)一路狂飙时,工业界深度学习推荐模型(DLRM)却陷入了一个尴尬的怪圈:算法团队长年累月地往模型里塞入成百上千个手工统计特征、时间窗口计数、显式交叉网络(DCN)与业务专属子塔,可一旦试图把训练算力扩大十倍,离线指标却很快撞上天花板,根本跑不出语言模型那样陡峭的幂律增长曲线。
为什么守着全世界最大规模的行为数据流,传统工业推荐模型却吃不到算力扩展的红利?
Meta 团队在 ICML 2024 发表的里程碑论文 Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations(PMLR 论文页、官方代码仓库 meta-recsys/generative-recommenders),给出了一个直击本质的诊断:阻碍推荐系统扩展的罪魁祸首,正是把用户行为拆成碎片化手工特征与孤立模块的 DLRM 范式本身。为此,作者提出了 生成式推荐系统(Generative Recommenders, GRs),将模型规模一举推上 1.5 trillion(1.5 万亿参数),在 8192 序列长度下实现比 FlashAttention-2 快 5.3x~15.2x 的编码效率,并在十亿用户级生产环境的线上 A/B 测试中拿下了 +12.4% 的核心排序指标提升。
如果拨开繁复的实验表格与算子实现,整篇论文的突破建立在四条环环相扣的设计哲学之上:
- 用“内容与动作交错的统一序列转导”终结碎片化特征拼装(Interleaved Content-Action Transduction over Fragmented Feature Engineering):放弃将用户行为切碎成数百个稀疏/稠密特征桶的做法,把用户接触到的内容表征 与产生的反馈动作 按真实时间轴交错排成一条因果序列。在这条统一序列上,预测下一个内容 就是召回(Retrieval),在序列末尾塞入候选内容 预测动作 就是目标感知精排(Target-Aware Ranking)。
- 抛弃行归一化 Softmax 与独立 FFN,用逐点门控注意力保留偏好强度(Pointwise Gated Attention over Normalized Softmax):标准 Transformer 的 Softmax 强制令所有历史位置的注意力权重加和为 ,这在推荐场景下会抹杀一个致命信号——用户对某个候选类目的历史交互总频次与总强度。HSTU 编码器果断用非归一化的逐点激活函数(如 SiLU)替代 Softmax,融入相对时间与位置分桶偏置 ,并通过逐元素门控分支 在单一算子内同时完成序列聚合与高阶特征交叉,一举省去了笨重的独立 FFN 子层。
- 在数据层用幂律随机截断制造稀疏性,破解长序列训练的算力困局(Stochastic Length as Data-Level Sparsification):用户的长周期历史行为存在极高的时间冗余。与其在每个训练步都硬扛 的全长序列开销,或者削足适履只训短序列,随机序列长度采样(Stochastic Length)按幂律分布与特征重要性动态抽稀训练序列——既把长序列训练成本砍掉了大半,又逼着模型学会在跨月度的稀疏历史线索中提取长期偏好。
- 用掩码隔离微批次与编码器缓存,把多候选打分摊销为单次历史编码(Amortize Target-Aware Scoring via M-FALCON):目标感知精排要求每个候选物品都与长达数千步的用户历史做深层自注意力交互。如果对 个候选分别跑一遍前向传播,线上 GPU 瞬间就会瘫痪。M-FALCON 将共享的用户历史前缀只编码 1 次并固化为编码器缓存,随后把 个候选切成微批次(Microbatches)拼在缓存后面并行打分,通过注意力掩码让候选之间彼此不可见——从而让单次理论计算量高出
285 倍的生成式大模型,在线上跑出了反超传统 DLRM 的吞吐量。
下面我们就顺着这四条设计哲学,结合论文推导与开源仓库代码,由浅入深拆解这套万亿参数生成式推荐架构。
1. 为什么传统工业 DLRM 跑不出 Scaling Law?
1.1 训练算力鸿沟与 DLRM 的四大结构性死结
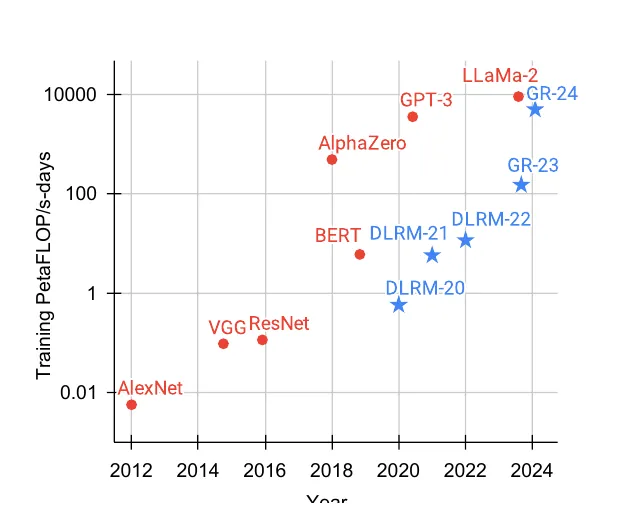
看看上图将工业推荐模型(蓝色星号)与主流语言、视觉基础模型(红色圆点,从 AlexNet、BERT 到 GPT-3、LLaMA-2)放在同一张训练算力坐标轴上的对比:过去十年间,传统工业 DLRM 的训练算力长期徘徊在底部平缓区;直到切换为论文提出的生成式推荐架构(GR-23、GR-24)后,推荐系统的有效训练算力才一跃冲上与 GPT-3 和 LLaMA-2 比肩的量级。
为什么在传统 DLRM 架构下,单纯加机器、加层数换不来持续的精度跃升?根源在于工业推荐场景面临着四道与自然语言截然不同的物理约束:
- 手工异构特征打碎了统一的计算图:工业 DLRM 的输入是由几百位工程师在数年间各自添加的大杂烩——创作者 ID、物品 ID、类目统计率、过去 1 小时/7 天/30 天的滑动窗口计数、多源交叉特征等。为了消化这些特征,DLRM 被迫拆成五花八门的特征提取器、池化层、DCN 交叉层和多任务子塔。计算图高度碎片化,导致绝大部分参数都耗散在浅层稀疏查找上,真正参與深层非线性推理的算力占比极低。
- 十亿级动态高基数词表(High-Cardinality Dynamic Vocabulary):语言模型的词表通常固定在 10 万个静态词元左右;而大型内容与电商平台的物品、视频、创作者规模高达十亿级,且每秒钟都有海量新内容入库、旧内容下架。
- 非平稳流式数据分布:推荐模型面对的是只过一遍(One-pass Streaming)的实时行为流,用户兴趣、社会热点与候选池时刻漂移,无法像静态文本库那样反复全量洗牌(Full-shuffle)训练。
- 目标感知(Target-Aware)的严苛推理延迟红线:在精排阶段,模型必须在几十毫秒内对召回层送来的数千个候选物品逐一打分,而且候选物品的特征必须尽早和用户历史做细粒度交叉。这一硬约束让许多人不敢把重型序列模型直接搬上精排主链路。
2. 核心设计哲学一:把异构特征重构为“内容与动作交错”的序列转导
2.1 从分桶拼装到交错时间流:DLRM 与 GR 的范式分野
怎么把碎片化的 DLRM 改造成像 GPT 一样结构规整、能无限吸收算力的统一架构?Fig. 2 给出了整篇论文最核心的特征重组方案:
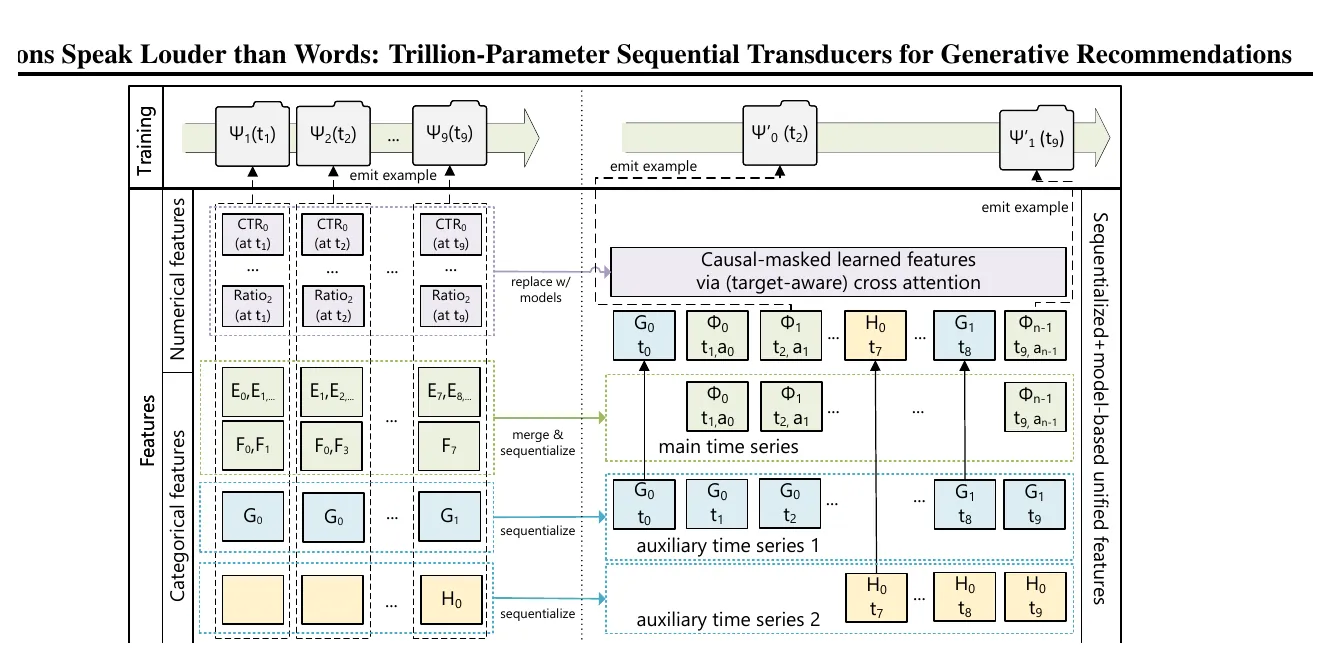
对比左右两侧的数据流向:
- 左侧的传统 DLRM:把用户的历史行为和上下文按特征源拆成
E, F, G, H等离散特征簇与数值特征簇,各自过完 Embedding 和局部池化后,在顶层拼成一个扁平大向量喂给 MLP。在这个过程中,不同行为发生的时间先后顺序与因果链条被彻底揉碎了。 - 右侧的生成式推荐(GR):将散落在各个表里的主时间序列(用户点击/观看流)、辅助时间序列(创作者互动流等)、稀疏类别属性与稠密统计数值,全部按事件发生的真实时间戳合并重排,压平为一条由内容表征 Token 与 用户反馈动作 Token 严格交替排列的单一人格化序列:
其中,那些原本属于静态画像或慢变的稠密统计特征,则被合并编码到对应时间步的内容表征 内部。经过这番改造,原本千奇百怪的异构特征工程,就变成了一个干净利落的序列转导(Sequential Transduction)问题:
| 核心维度 | 传统工业 DLRM 范式 | 生成式推荐(GR)范式 |
|---|---|---|
| 输入表征形态 | 数百个异构特征簇分模块提取、池化与拼接 | 内容 Token 与动作 Token 按时间交错的单一序列 |
| 候选物品交互 | 在精排塔中与压缩后的静态用户向量做交叉 | 作为目标感知条件 Token 直接追加在历史序列末尾 |
| 训练监督效率 | 单次请求仅对末端单次曝光做点式(Pointwise)监督 | 沿整条用户时间轴做因果自回归监督,一步前向同时训练全序列所有步 |
| 算力扩展主轴 | 靠人工堆叠新特征、扩充子塔与显式交叉层 | 直接拉长上下文序列长度 、加深加宽转导网络层数 |
2.2 召回与精排的大一统数学形式
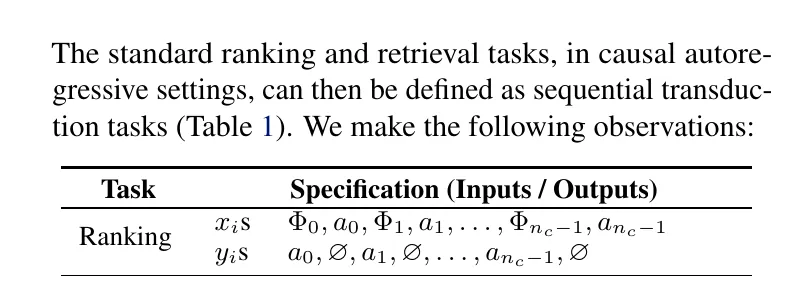
一旦把输入统一成了 ,推荐漏斗里原本割裂的召回(Retrieval)和精排(Ranking)两大核心阶段,就在数学上实现了惊人的统一:
为什么说论文标题里的“Actions Speak Louder than Words(行动胜于雄辩)”抓住了推荐的灵魂?
在早期学术界的序列推荐模型(如 GRU4Rec、SASRec、BERT4Rec)里,序列中只有正向点击过的物品 ID(相当于只有 )。但在真实工业场景中,用户看了一个视频 30 秒并顺手点赞,和看了一眼 0.5 秒就划走甚至点击“不感兴趣”,这两个事件虽然接触的是同一个内容 ,表达的偏好却是南辕北辙的!因此,必须把用户动作 (完播时长、点赞、分享、跳过、举报等多任务反馈的联合嵌入)作为紧跟在 后面的独立 Token 显式喂给模型。
在此基础上,看 Table 1 是如何区分召回与精排的:
- 召回任务(Retrieval)——预测下一个内容 Token:当用户完成了第 次交互并产生动作 后,系统在还没有选定具体候选池时,自回归地生成用户下一个最可能产生正向交互的目标内容表征分布:
在训练时,为了不在曝光未点击的负反馈样本上学习生成废内容,检索分支的监督掩码 仅在 为正向交互时置为 (负向交互时 ,只把它保留在输入上下文里供后续避雷,而不作为生成目标)。
- 目标感知精排(Target-Aware Ranking)——给定候选内容,预测下一个动作 Token:到了精排阶段,上游已经送来了具体的待评候选物品 。此时不能只笼统地预测 ,必须先把候选物品 塞进序列的最后一个位置,让候选物品穿过全部深层自注意力网络、与历史上每一个 充分交互后,再在它头顶上预测多任务动作分布:
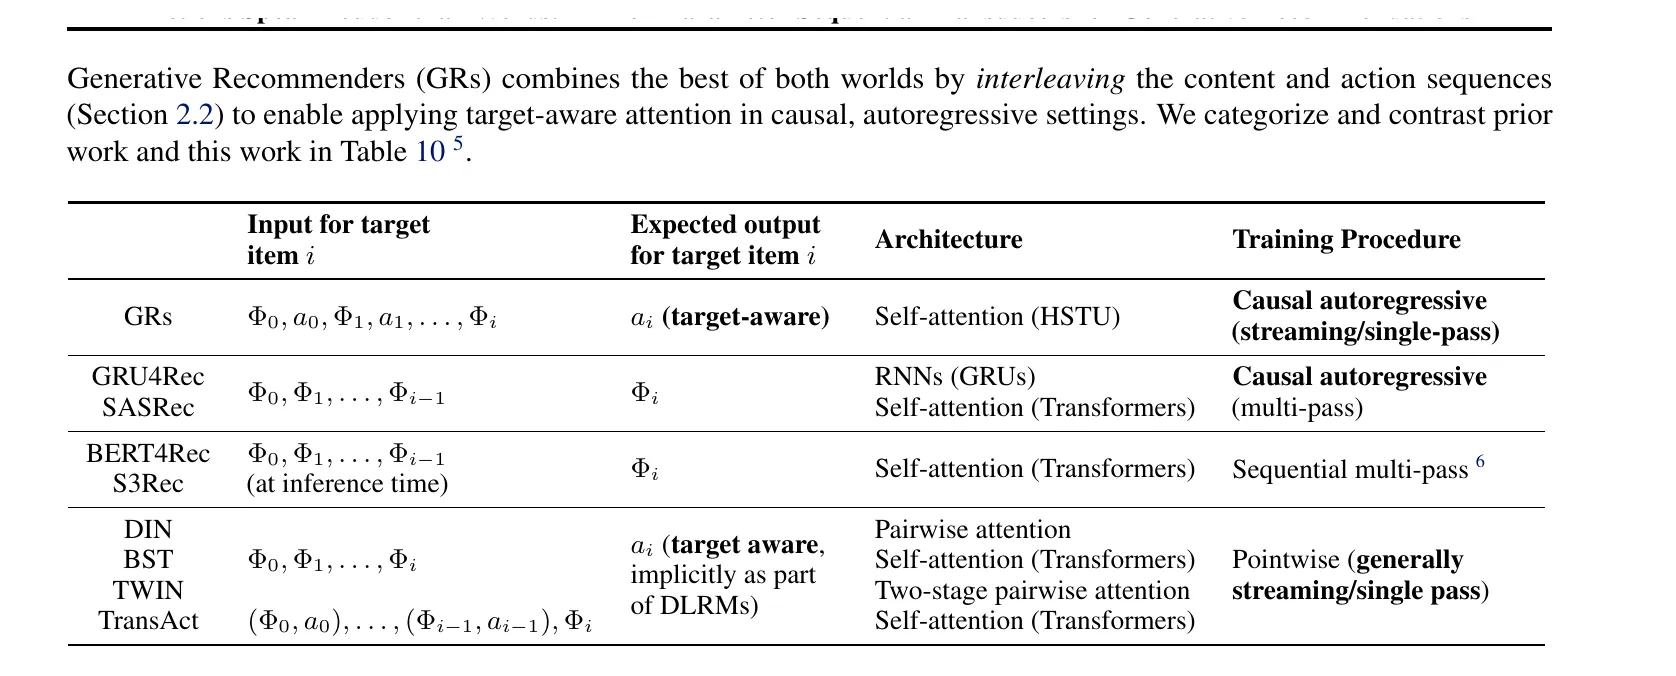
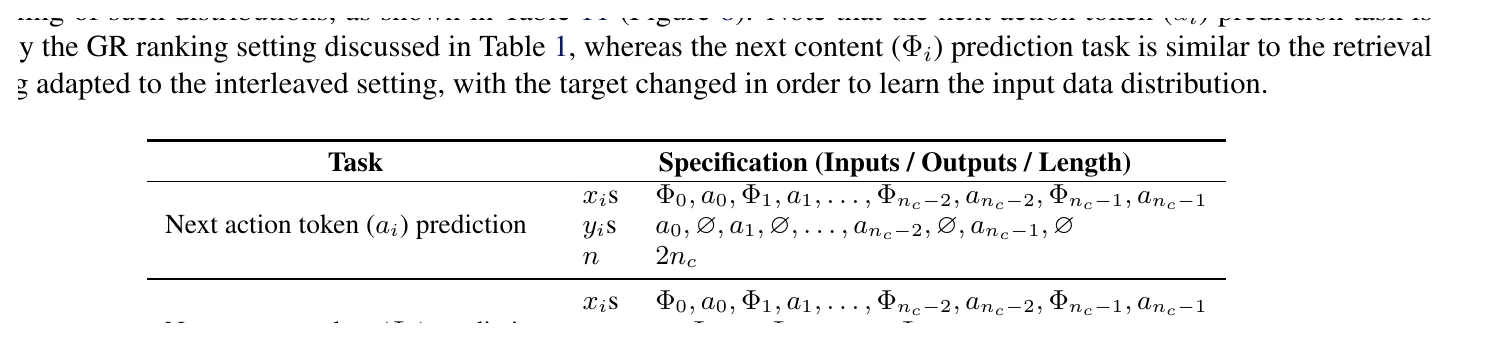
对照附录 Table 10 与 Table 11 的梳理可以看出,这一“内容-动作”双流交错加末端候选注入的设计,让生成式推荐彻底跳出了传统序列推荐只能在小词表上做“下一个物品 ID 分类”的局限,第一次在同一个自回归主干上打通了工业级召回与多目标目标感知精排。
3. 核心设计哲学二:HSTU 编码器——为什么必须干掉 Softmax 和 FFN?
有了统一的序列转导形式,接下来是不是直接拿标准的 GPT(FlashAttention-2 + FFN)往上套就行了?作者试过之后发现:标准 Transformer 在推荐流式长序列上既算得慢,精度也打不过专门设计的编码器。为此,论文提出了 HSTU(Hierarchical Sequential Transduction Unit,层级序列转导单元)。
3.1 逐点门控注意力、相对时空偏置与无 FFN 架构
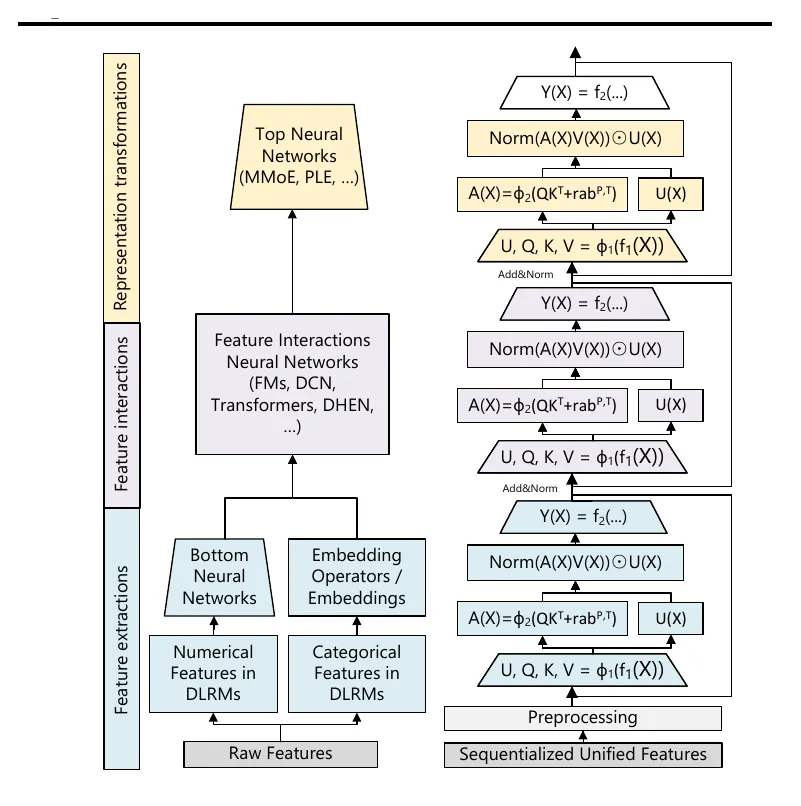
看 Fig. 3 右侧展示的 HSTU 单元结构,它的数学表达式只有三行,却处处透着对推荐数据物理特性的深刻理解:
- 一次投影四路切分:给定输入序列表示 ,先通过一层线性变换 加非线性激活 (SiLU),直接一口气切分出四个分支——门控分支 、值 、查询 与 键 :
- 融合相对时空偏置的非归一化逐点注意力:计算 后,加上同时刻画相对位置差与相对时间差的偏置矩阵 ,然后不用 Softmax,直接套一层逐元素非线性激活函数 (如 SiLU)作为注意力权重矩阵 :
- LayerNorm 后接逐元素门控乘积(省去独立 FFN):将注意力聚合结果 做归一化后,直接与第一步切分出来的门控分支 做逐元素哈达玛积(),最后经线性层 投回输出空间:
这三步改造背后,藏着三个极其硬核的追问:
- 第一问:为什么在推荐系统里必须废掉 Softmax,改用逐点激活 ?
想象这样一个场景:当前候选广告是一双篮球鞋。用户甲是个铁杆篮球迷,过去一周里连续点击、完播了 50 条篮球视频;用户乙是个刚注册的新手,历史序列里只有 1 条不小心误触的篮球视频。
如果你用标准 Transformer 的行归一化 Softmax,因为所有历史位置的注意力权重强制加和为 (),用户甲的 50 条篮球记录每条分到
0.02的权重,加起来是1.0;用户乙的那 1 条篮球记录独自拿到1.0的权重!经过 Softmax 归一化加权求和后,“历史交互了 50 次”和“只交互了 1 次”的偏好强度幅值(Intensity / Magnitude)被彻底抹平了!而在推荐精排中,一个用户在某个目标类目下到底积累了多少次历史正反馈,恰恰是预估点击率与观看时长最强的统计信号。HSTU 改用逐点激活函数 (如 SiLU)并除以序列长度尺度后,50 次匹配就能线性累加出远强于 1 次匹配的激活幅值;同时在硬件执行上,去掉 Softmax 还省掉了长序列下极其耗时的逐行求最大值(Row-max)与指数求和同步开销。 - 第二问:为什么要加相对时间与位置融合偏置 ? 在自然语言里,一句话里两个词隔了 5 个字,不管这句话是昨天写的还是十年前写的,语法关系都不变;但在用户行为序列里,同样是往前数第 5 个点击,发生在“3 分钟前(同一个 Session 内)”和发生在“3 个月前”,其意图相关性天差地别。通过将成对事件的时间戳差值 做对数分桶(Bucketization)并与相对位置偏移 相加構成 ,模型得以直接在注意力打分阶段感知非平稳兴趣的时间衰减。
- 第三问:为什么一个 门控就能干掉占据 Transformer 三分之二算力的独立 FFN? 在传统 DLRM 里,最有效的模块是 DCN 这类显式特征乘积交叉(Feature Interaction,)。HSTU 在最后一步直接将全局上下文聚合特征 与当前局部特征变换分支 做逐元素乘法(),本质上就是在每一层内部原生执行了一次动态门控的二阶特征交叉!这样一来,无需再在注意力层后面挂接笨重的两层宽 FFN(在标准 Transformer 中 FFN 隐藏层通常是 ,吃掉了绝大部分 FLOPs 和显存读写),单层算子变得更加紧凑高效。
3.2 流式合成数据与公开基准上的结构消融
为了证明“去掉 Softmax”和“加入时空偏置 ”绝不是纸上谈兵,作者先构造了一个高度模拟线上分布漂移与类别幂律分布的单遍流式合成测试台(Table 2),随后在 MovieLens 与 Amazon Books 公开数据集上做了逐项拆解消融(Table 5):
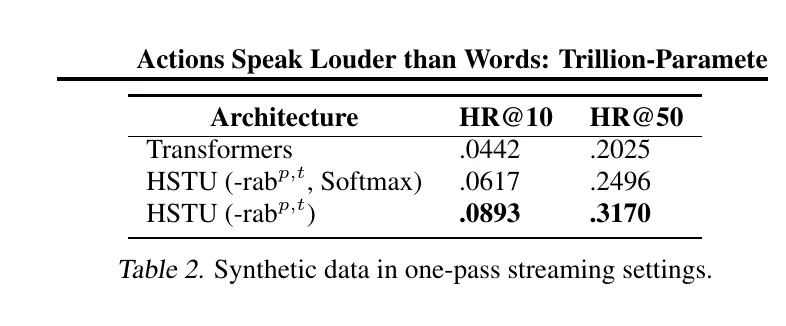
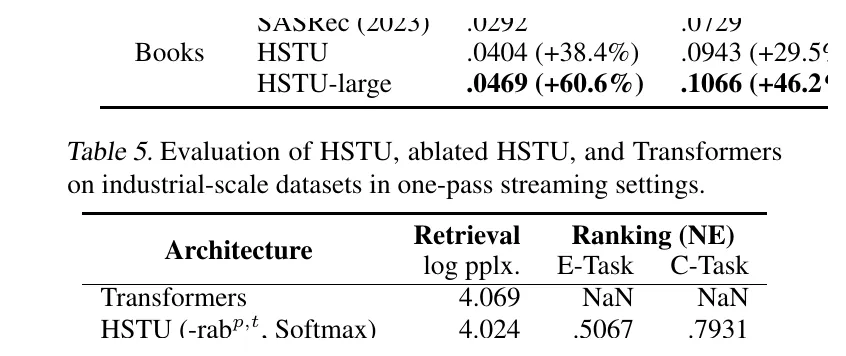
盯着 Table 2 和 Table 5 里的四行配置看,每一个变量的贡献都清清楚楚:
- 把完整版
HSTU里的相对时空偏置拿掉,变成HSTU (-rabp,t),各项 HR 与 NDCG 指标随即出现第一波下滑,印证了显式时间间隔分桶对捕捉兴趣演化的价值; - 更震撼的是对比
HSTU (-rabp,t)与HSTU (-rabp,t, Softmax)——两者结构完全一模一样,仅仅是把逐点激活函数 换回了标准的 Softmax,在 Table 2 流式合成实验以及 Table 5 的 Amazon Books 等长尾稀疏数据集上,指标当场发生断崖式暴跌(几乎退化回普通Transformer基线的水平)!这组铁证直接坐实了前面的理论推导:在推荐序列建模中,打破 Softmax 的行和为 1 束缚、保留历史交互频次的幅值信息,是拉开精度差距的胜负手。
4. 核心设计哲学三:Stochastic Length——用数据层稀疏化破解长序列困局
当把用户历史序列从百级拉长到 2048 甚至 8192 时,哪怕 HSTU 算子再快,如果每个训练样本在每一步都老老实实跑满全长序列的自注意力,训练集群依然吃不消;可如果在训练时为了省钱只截取最近 200 个行为,到了线上推理面对 8000 步的长历史时,模型又会因为没见过长跨度上下文而发生严重的长度外推退化。
怎么既少花训练算力,又让模型学会驾驭万级长序列?论文提出了 Stochastic Length(SL,随机序列长度采样)。
4.1 幂律长度采样与注意力稀疏度收益
Stochastic Length 的物理直觉来自推荐行为的一个天然属性:用户的历史行为在时间上是高度重复且冗余的。一个喜欢看美食视频的用户,过去三个月的 4000 条记录里可能有几百条高度雷同的烹饪短视频。如果我们在训练时,以某个随机采样出的较短长度 从原序列中抽取一个子序列喂给模型,模型依然能从这个稀疏子序列中学到相同的长期偏好,而且还顺带练习了“如何在跨度拉大的稀疏事件之间做长程推理”!
具体而言,给定最大序列长度 和原始序列长度 ,系统通过超参数 控制采样长度分布的偏斜度:当 时,保持原始全长不压缩;当调小 (例如设为 或 )时,绝大多数训练步都会采样出长度远小于 的紧凑子序列,仅以一定幂律长尾概率保留全长序列。
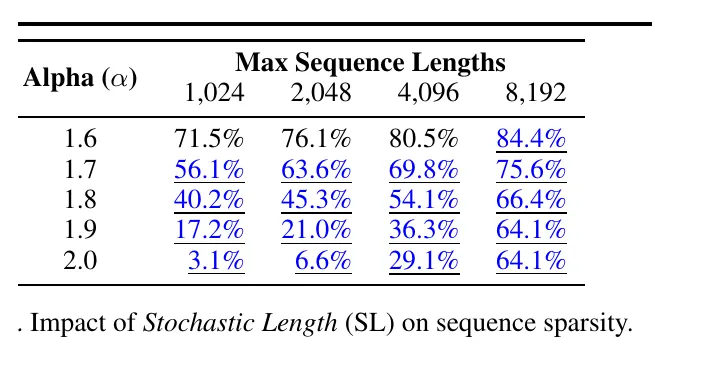
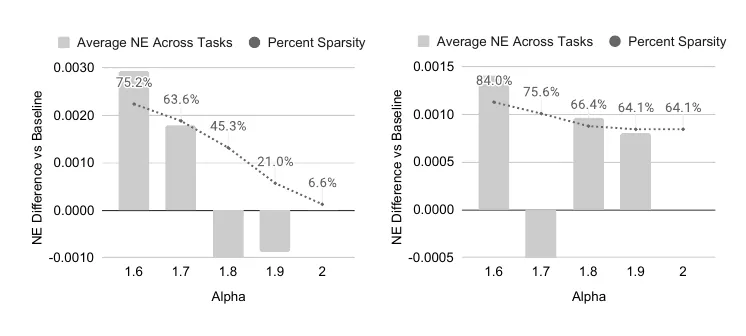
看 Table 3 与 Fig. 4 的实测效果:当最大序列长度设为 4096 或 8192、取 时,序列注意力的计算稀疏度(Sparsity,即省掉的无效计算比例)高达 70%~88% 以上!更妙的是看 Fig. 4 的柱状图(代表离线归一化熵 NE 与全长训练基线的差值):在取得超过 80% 算力节省的同时,模型的离线评估质量几乎没有任何退化(甚至在适度稀疏区间因为滤除了短期高频噪声而比全长硬训略好一点);直到把 压得过低、丢掉了超过 95% 的核心信息时,指标才开始变差。
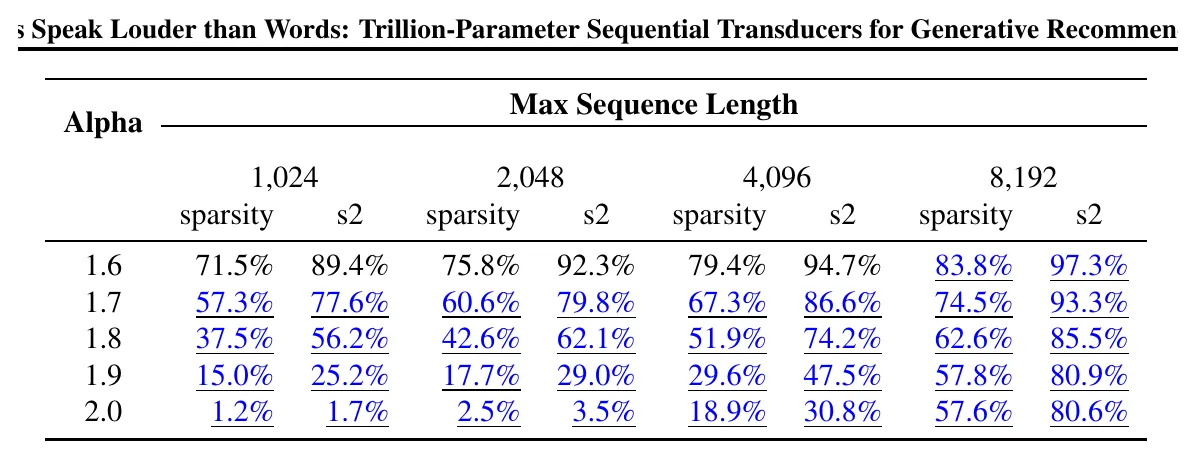
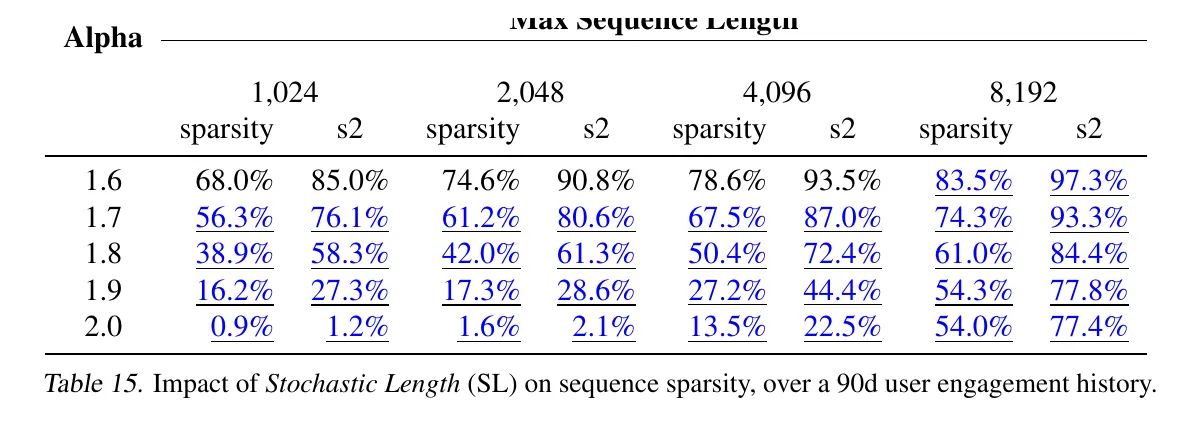
附录 Table 14 与 Table 15 进一步给出了在 60 天和 90 天工业历史窗口下的稀疏度表,随着时间窗口拉长到 90 天,Stochastic Length 在 下能稳定释放超过 84%~96% 的注意力计算冗余。
4.2 为什么它比 NLP 的位置编码长度外推更管用?
有人可能会问:大语言模型里不是有很多现成的长度外推(Length Extrapolation)技巧吗?比如训练时只训 1024 长度,推理时用 RoPE/NTK 缩放位置编码直接外推到 8192,或者在长序列上做少量微调(Fine-tune)?
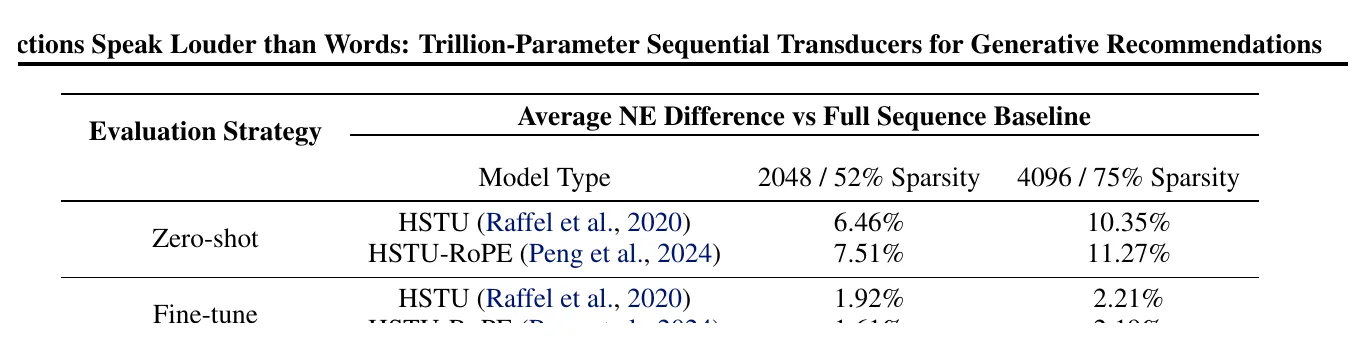
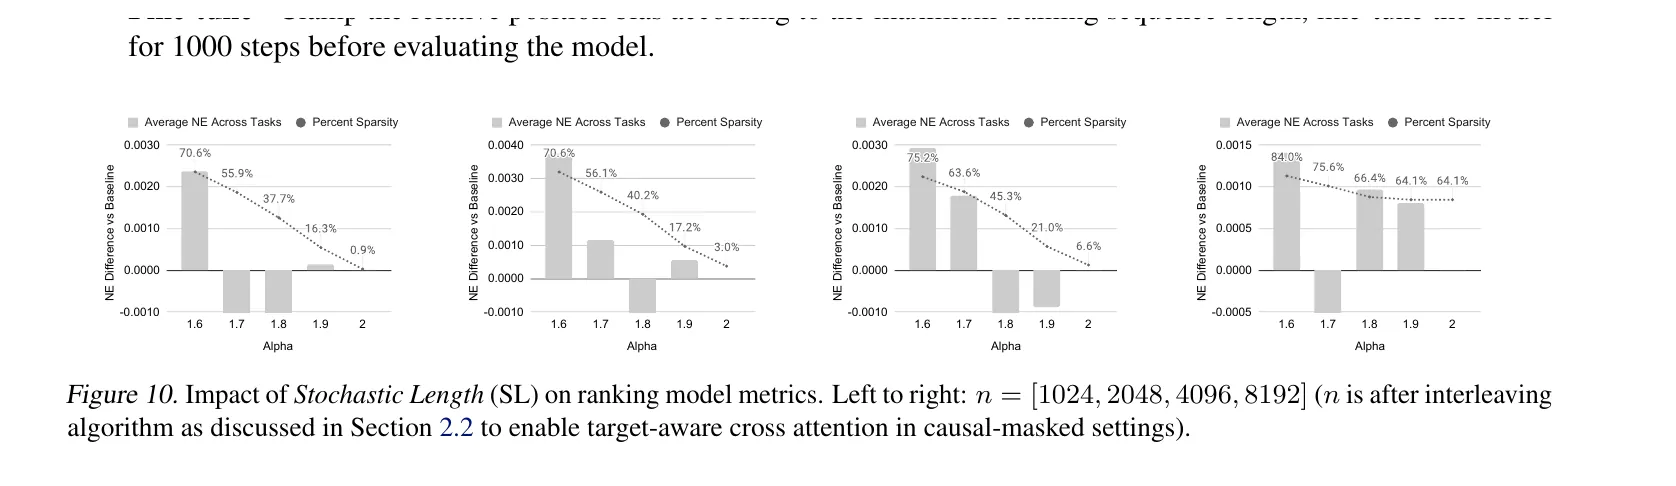
作者在附录 Table 16 与 Fig. 10 中把这些方案拉出来做了正面比拼。结果非常说明问题:只靠短序列训练加零样本外推(Zero-shot)或位置编码插值,在推荐精排指标上明显落后于 Stochastic Length。原因在于,如果训练时只截最近 1000 步,模型在训练期永远只见过“最近几天内的密集行为”,从来没见过“两个月前的稀疏长尾行为与当前候选交互”的时间跨度分布(即 中的大时间桶在训练期根本没被激活过!)。而 Stochastic Length 从长达数月的完整历史中抽稀采样,让模型在省算力的同时,全程都在接触跨月度的真实时间跨度。
5. 核心设计哲学四:M-FALCON——把几千个候选的精排打分压成一次历史编码
现在我们来到了决定生成式推荐生死存亡的在线服务(Serving)关卡。
回顾第 2.2 节的目标感知精排公式 :为了给召回层送来的 个候选物品 打分,我们需要把每个候选放到长度为 的用户历史序列末尾跑自注意力。如果朴素地写一个循环对 个候选分别跑一遍长度为 的 HSTU 前向传播,总计算复杂度将高达 !在 、 的生产规模下,单次请求的计算量会膨胀上千倍,没有任何线上集群能扛得住。
怎么破解这个 的魔咒?论文提出了 M-FALCON(Microbatched-Fast Attention Leveraging Cacheable OperatioNs)。
5.1 掩码合批、微批次切分与跨批编码器缓存
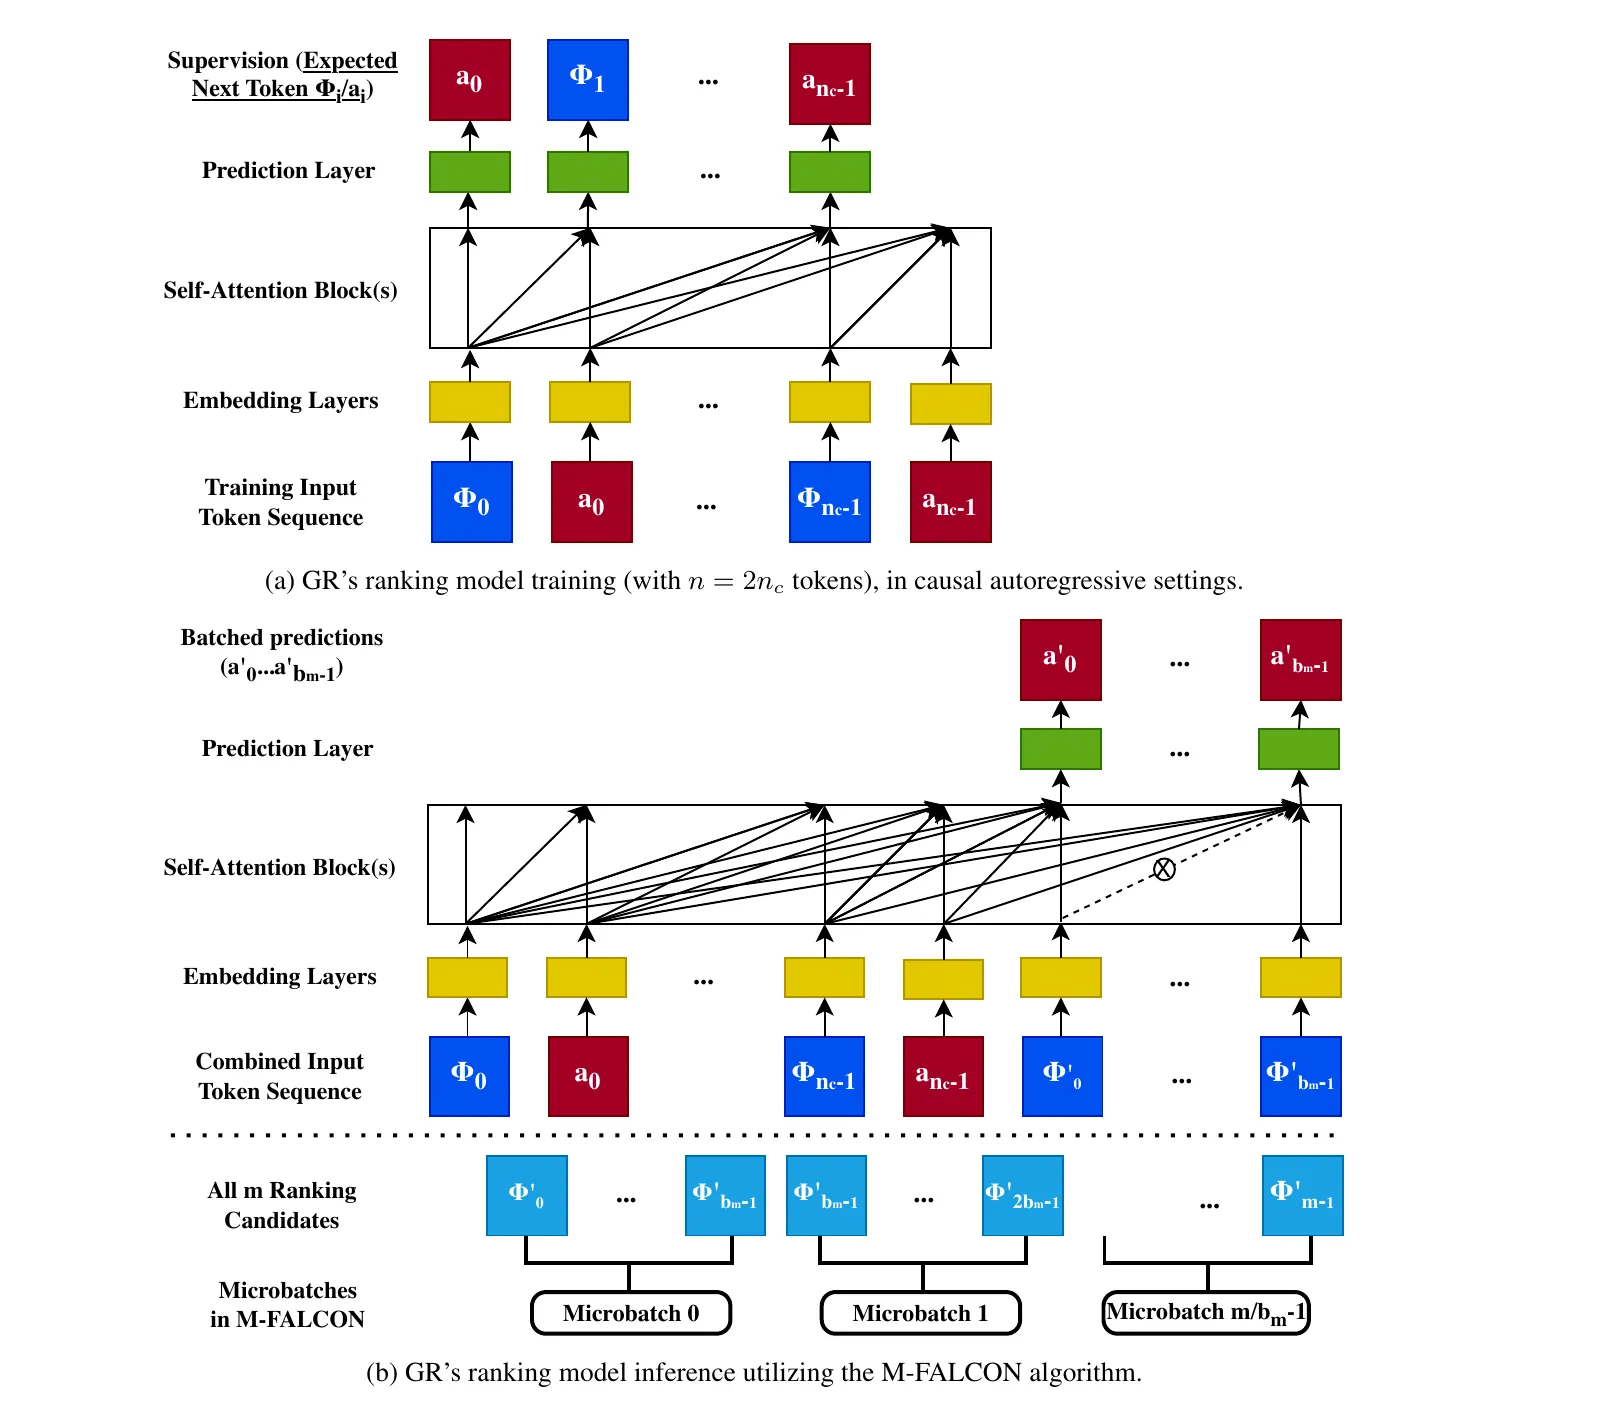
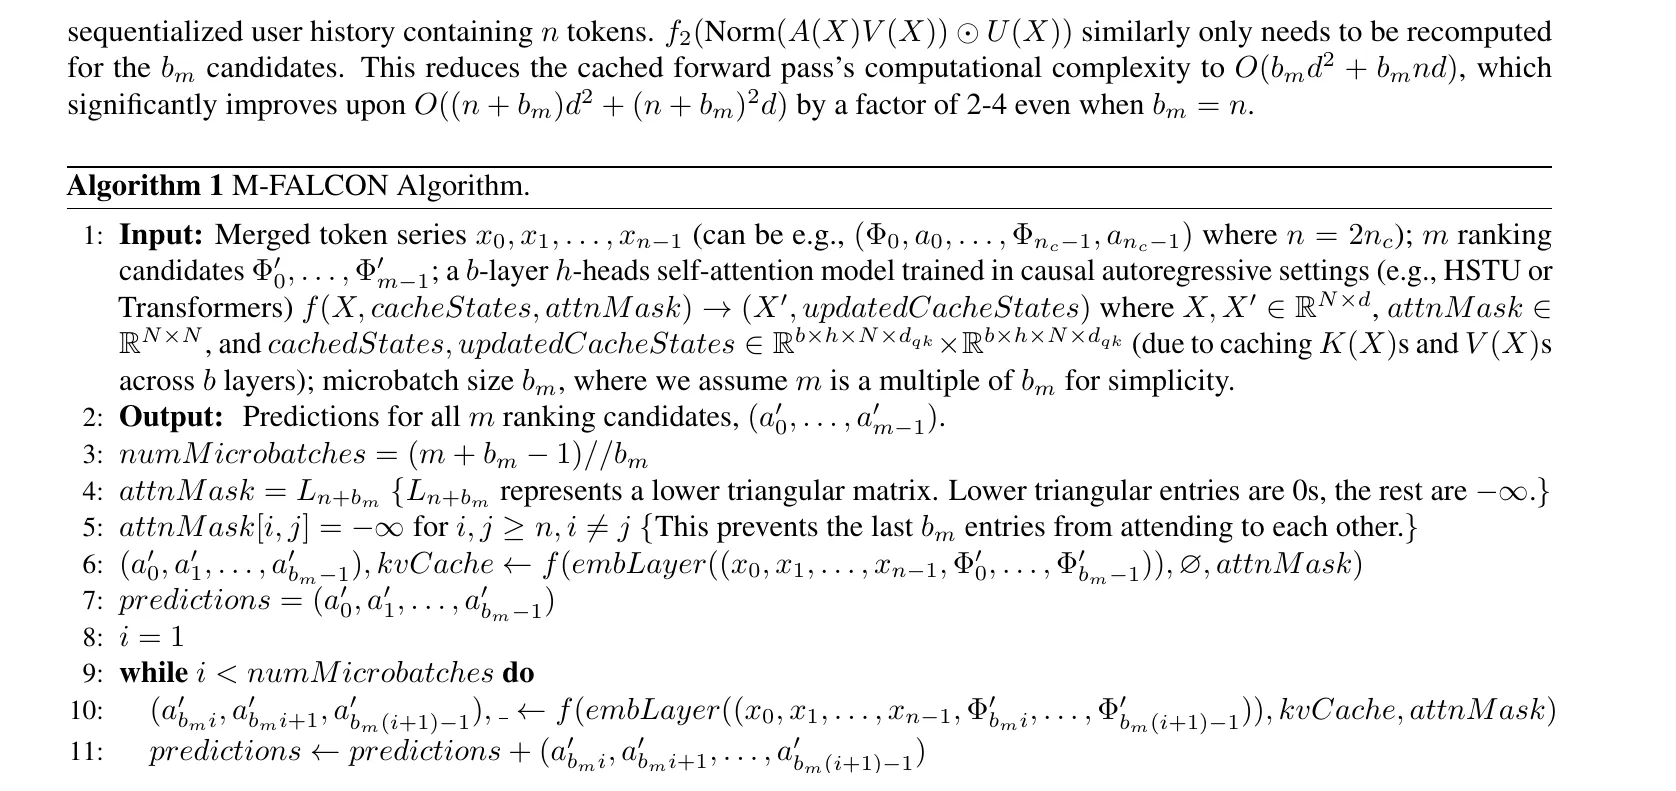
对照 Fig. 11 下半部分的推理示意图与 Algorithm 1 的伪代码,M-FALCON 用三招漂亮的组合拳,把 个候选的打分复杂度从 硬生生削成了 :
- 第一招:带列对角掩码的多候选合批(Masked Batched Inference): 与其每次只拼 1 个候选,不如把多个候选 一次性并排拼在同一条用户历史序列 的屁股后面! 但这里有个致命陷阱:在普通因果掩码(下三角掩码)下,排在第 2 个的候选 会看到排在第 1 个的候选 !这不仅会造成候选间的信息污染,还会让打分结果跟候选的排列顺序强绑定。为此,M-FALCON 专门定制了 Fig. 11 右下角那张特殊的注意力掩码矩阵——左半边对应前 个用户历史位置,全部放行(每个候选都能完整看到全部用户历史);右半边对应追加的 个候选位置,只保留主对角线上的 1,其余位置全部置 0!这样一来,每个候选只能看到用户历史和它自己,候选与候选之间彻底隐身隔离,一次矩阵乘法就能并行算出 个候选的精确目标感知分数。
- 第二招:微批次切分控制显存峰值(Microbatching): 如果单次请求要给 个候选打分,一次性把 2048 个候选全拼在后面,会让序列尾部暴涨,撑爆单卡显存并拉高尾延迟。因此,Algorithm 1 将 个候选切分成 个大小为 的微批次(Microbatches),分批送入模型评分。
- 第三招:跨微批次甚至跨请求的编码器级缓存(Encoder-Level Caching): 既然切成了 个微批次,难道每个微批次都要把前面那 个用户历史 Token 重新算一遍吗?当然不用!因为前 个位置是因果自回归的,它们根本看不见后面的候选 Token,所以在全部微批次里,前 个位置在每一层 HSTU 算出来的 、 和层输出完全一模一样! 如 Algorithm 1 所示,M-FALCON 只在第一个微批次(或请求到达前的预热阶段)对长度为 的用户历史做唯一一次编码,并将每一层 HSTU 的历史键值状态固化到缓存中;随后的所有候选微批次,只需针对新增的那 个候选 Token 计算 ,去和缓存里的历史 做轻量交叉注意力即可!更进一步,如果同一个用户在短时间内连续刷新两次信息流,连这份历史编码缓存都可以直接跨请求复用。
5.2 单模型算力大 285 倍,为什么线上吞吐反而追平甚至反超 DLRM?
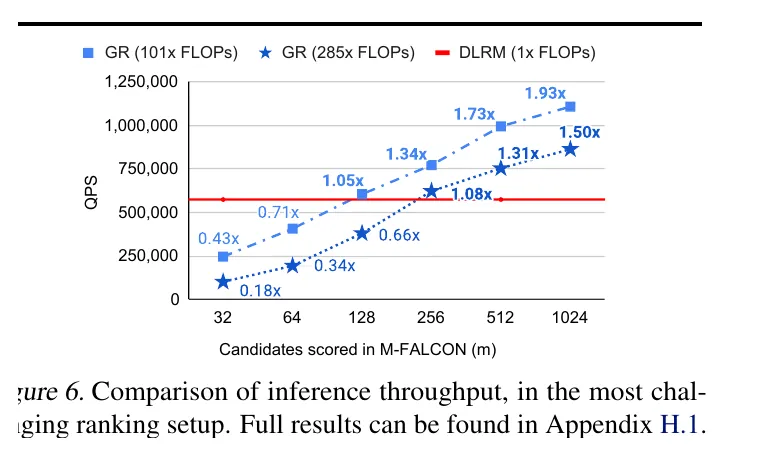
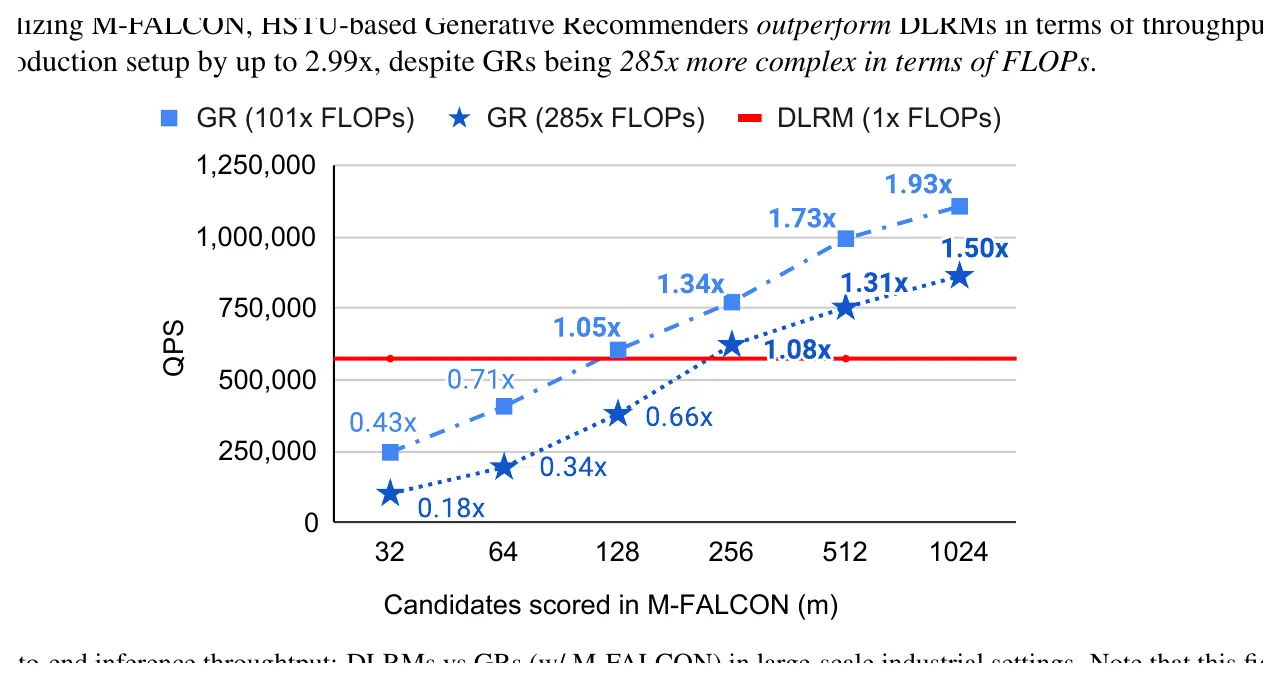
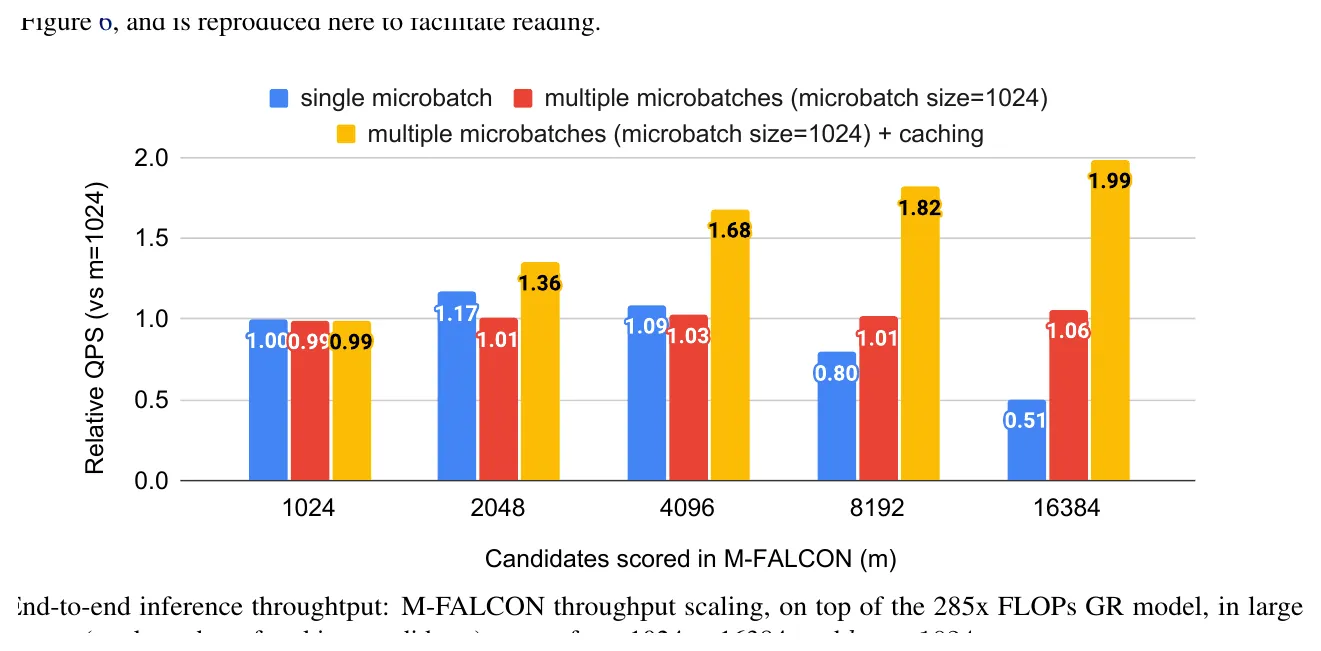
看上面 Fig. 6、Fig. 12 与 Fig. 13 三组实测吞吐曲线,你会看到一个初看极其反直觉的现象:单序列理论计算量高达 285x FLOPs 的生成式推荐模型(GR w/ M-FALCON),在待评候选数 较大时,单卡每秒处理的查询吞吐量(QPS)不仅追上了 1x FLOPs 的传统 DLRM,在许多区间甚至还完成了反超!
为什么会这样?账算得很清楚:
- 传统 DLRM 虽然单次计算量小,但它的顶层 MLP 与交叉模块里揉杂了大量
User × Candidate的耦合特征,当面对 个候选时,很大一部分网络计算必须老老实实重复执行 遍,且访存极其碎片化,GPU Tensor Core 利用率很低; - 而 GR 配合 M-FALCON 后,重头的用户历史编码被鎖死在 次缓存构建上,随候选数 增长的微批次增量计算则是极其规整的稠密矩阵乘法(GEMM),把现代 GPU 的算力密度发挥到了极致。
5.3 HSTU 与 FlashAttention-2 的算子级速度对决
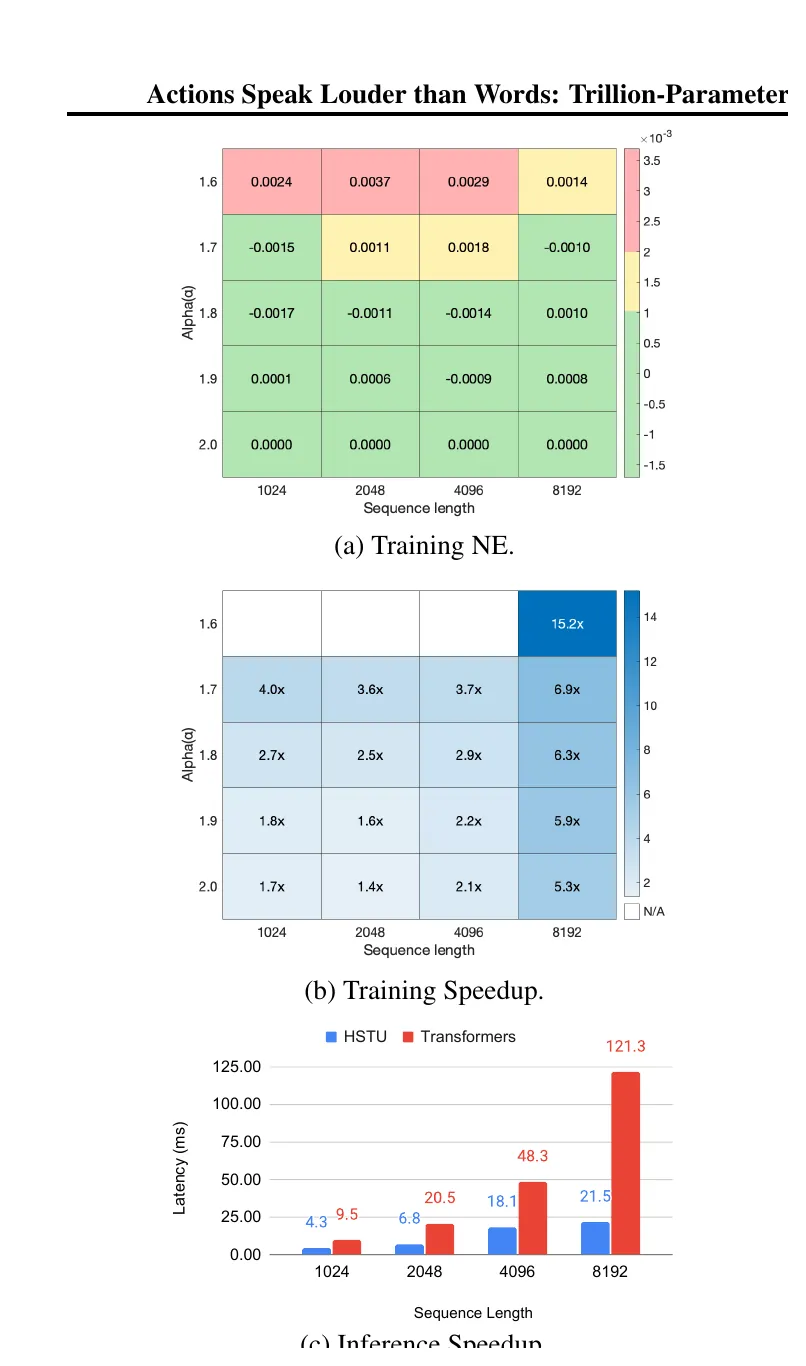
再看 Fig. 5 从编码器算子层面对 HSTU 与基于 FlashAttention-2 的标准 Transformer 所做的硬碰硬对比:在序列长度一路推高到 8192 的过程中,HSTU 在取得更优离线 NE 指标的同时,训练与推理速度比 FlashAttention-2 Transformer 快出了整整 5.3x 至 15.2x!这正是前文剖析的三项设计——砍掉独立 FFN 子层、用逐点激活替代 Softmax 行归约、以及基于 Jagged Tensor 消除变长序列 Padding 浪费——在底层 Triton / CUDA 算子上叠加释放出的惊人威力。
6. 从公开基准到 1.5 万亿参数的工业级 Scaling Law
6.1 公开基准验证与实验细节辨析
在进入内部生产实验前,论文先在学术界通用的公开序列推荐数据集(MovieLens-1M、MovieLens-20M 与 Amazon Books)上检验了 HSTU 的成色(Table 4 与附录 Table 12):
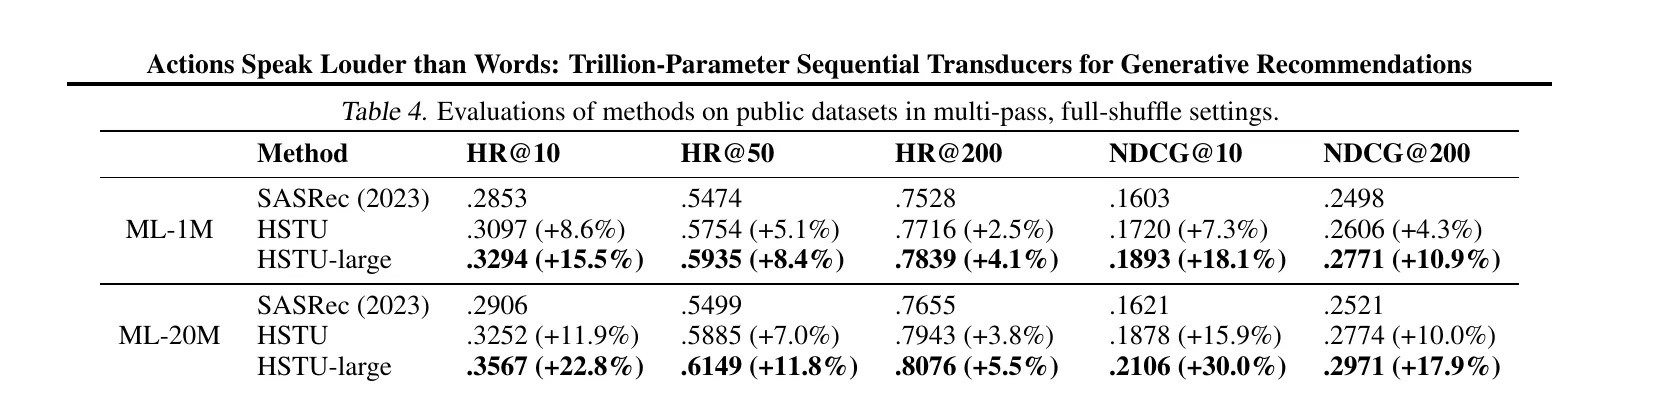
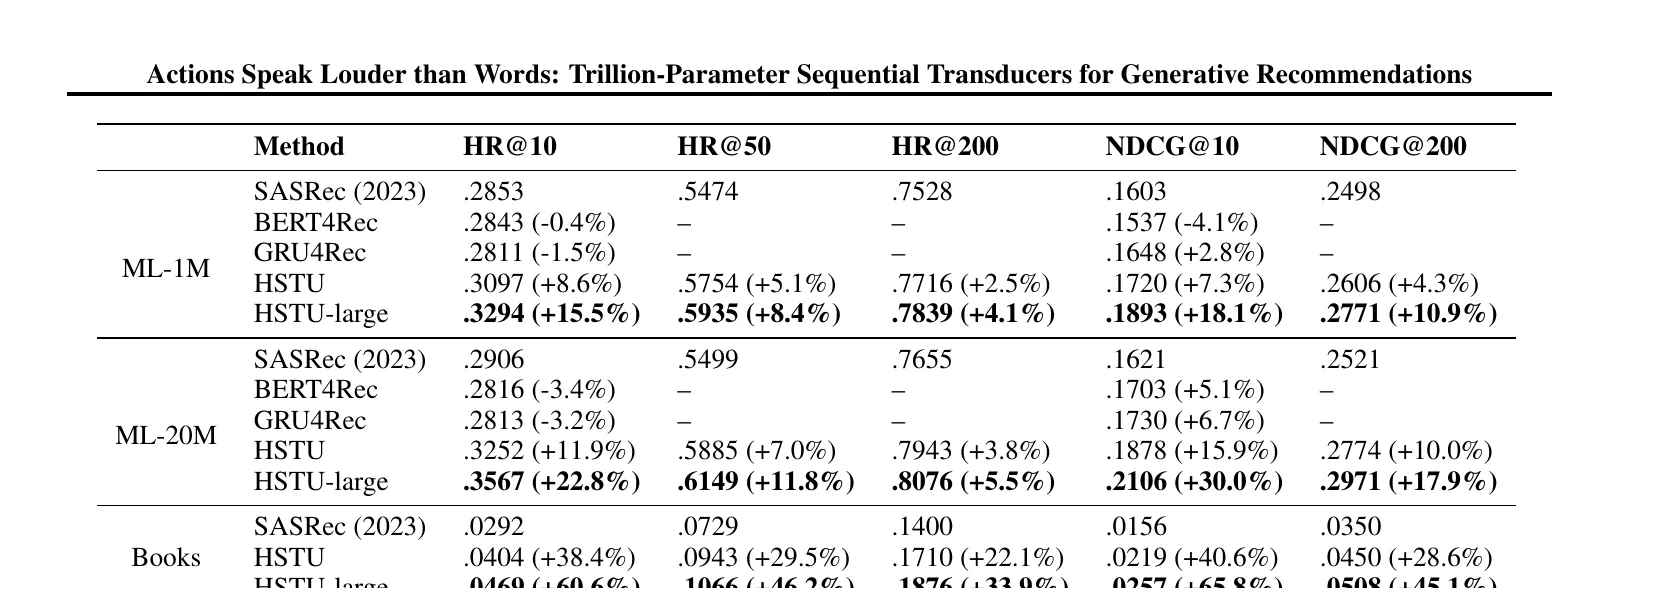
剖析这两张表,有两个必须看懂的技术细节:
- 在完全相同的采样 Softmax 训练管线下,HSTU 全面碾压 SASRec:在 Table 4 中,标准版
HSTU与加深加宽的HSTU-large在全部三个数据集的 HR@10/50/200 与 NDCG@10/50/200 上均大幅抛离 SASRec。特别是在长尾物品极多、序列稀疏的 Amazon Books 上,HSTU-large将 NDCG@10 相比 SASRec 提升了高达65.8%(HR@10 提升+56.7%)。这证明即便在没有复杂多任务动作的小型公开数据集上,HSTU 的架构优势依然扎实,且增大模型容量(从 HSTU 到 HSTU-large)能立竿见影地换来精度提升。 - 读懂 Table 12 中的负采样协议差异:在附录 Table 12 中,官方仓库 README 坦诚注明了一处评测背景——表中的 GRU4Rec 与 BERT4Rec 行直接引用自过往论文,那两行在训练时计算了全词表负样本(Full Negatives);而 SASRec 与 HSTU 行则使用采样负样本(Sampled Negatives,例如每个正样本配 128 或 512 个随机负例)训练。即便在采样负例的近似条件下,HSTU 依然全面超越了全量负例训练的传统基线。
6.2 工业召回与精排的渐进式上线策略
当把舞台切换到日活十亿级的流式生产环境时,Table 6(召回阶段)与 Table 7(精排阶段)展示了 GR 是如何一步步击败千锤百炼的工业级 DLRM 的:
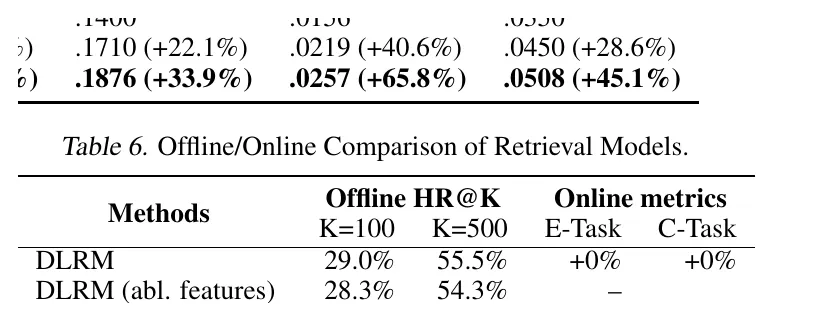
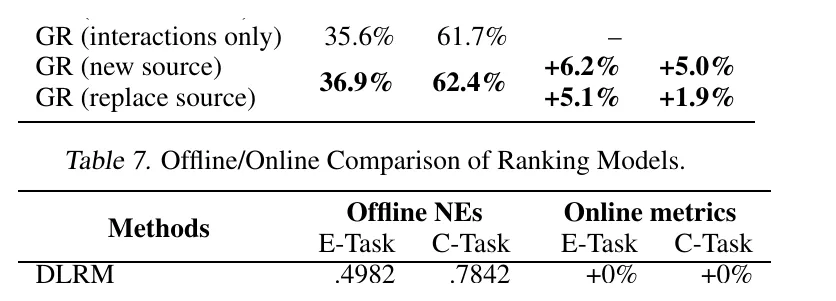
注意看 Table 6 和 Table 7 左列展示的三步渐进式工程演进路线,这对任何想在生产系统落地新范式的团队都极具参考价值:
- 第一步:
GR (interactions only)(纯交互序列裸跑验证):完全扔掉传统 DLRM 里苦心经营多年的几百个手工统计与交叉特征,只给 GR 喂纯粹的“内容 + 动作”历史交互序列。结果令人震惊——光靠一条纯交互序列,GR 在召回和精排上的离线指标就已经反超了挂满全量手工特征的庞大 DLRM 基线! - 第二步:
GR (new source)(作为增量新特征源/新召回源并入):不急着一刀切下掉老模型,先把 GR 作为一个新增的召回通道或精排打分源并入现有系统,与老 DLRM 互补共生,立刻在线上 A/B 测试中拿到了稳健的正向收益(精排线上主指标提升+6.2%)。 - 第三步:
GR (replace source)(彻底接管主路径并融入上下文特征):在验证了线上稳定性与 M-FALCON 推理吞吐后,用 GR 直接替换掉原有的核心 DLRM 路径,最终在生产环境线上 A/B 测试中斩获了召回+4.7%~+6.9%、精排+12.4%的巨幅核心业务指标提升。
6.3 见证 1.5 万亿参数的推荐系统 Scaling Law
整篇论文最激动人心的时刻,定格在 Fig. 7 这张工业级算力扩展曲线上:
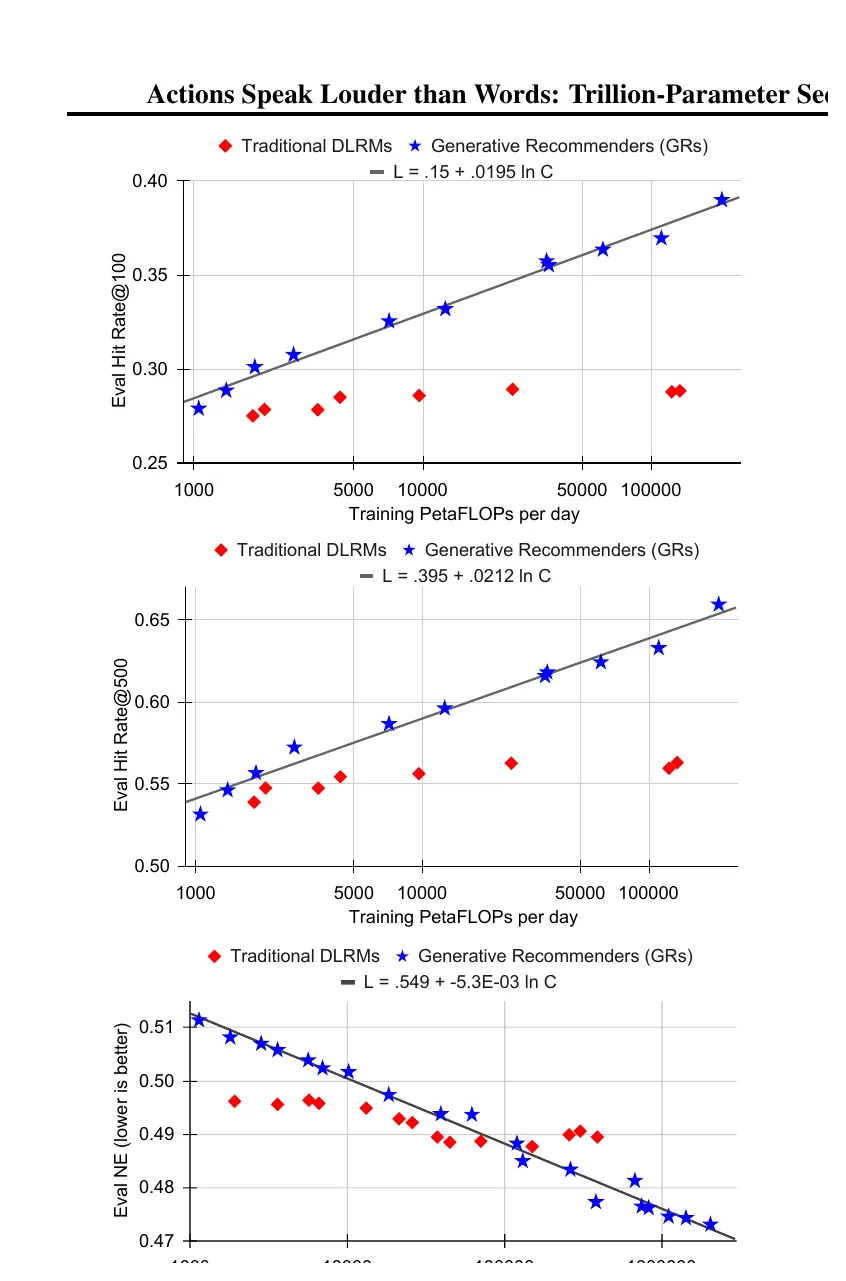
看 Fig. 7 中蓝色曲线(传统 DLRM)与红色/绿色曲线(生成式推荐 GR)的分道扬镳:
- 当横轴的训练算力(综合扩充序列长度至
8192、加深 HSTU 层数至数十层、加宽隐藏维数并将总参数量推至1.5 trillion(1.5 万亿))跨数量级增长时,蓝色 DLRM 曲线很快变成了水平线,继续砸算力根本降不下归一化熵(NE); - 而生成式推荐 GR 的离线损失则像极了 GPT 系列的 Chinchilla Scaling Law,沿着对数坐标轴走出了一条笔直向下的幂律(Power-Law)直线,跨越三个数量级的算力增长依然没有出现丝毫饱和迹象!
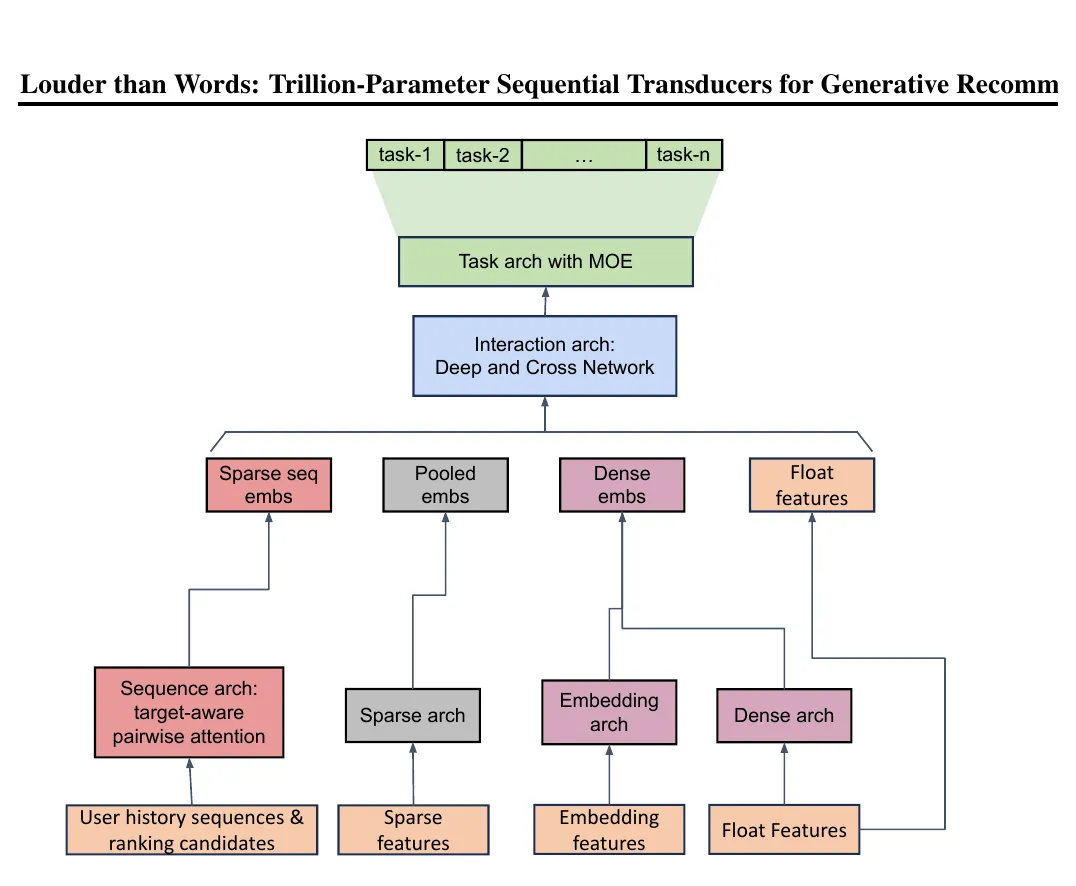
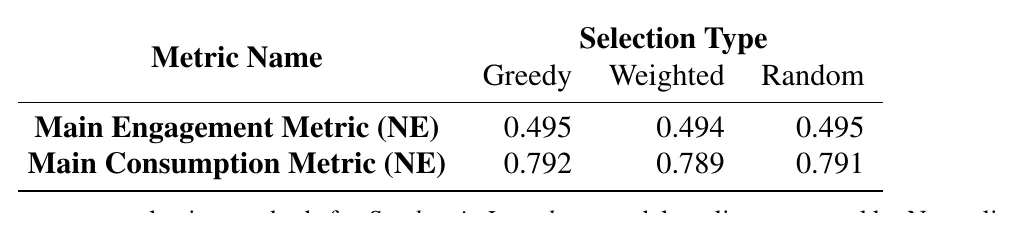
为了让读者确信图中那个被比下去的 DLRM 绝非纸糊的稻草人,作者在附录 Fig. 9 中亮出了该生产级 DLRM 精排基线的真实家底:它完整集成了稀疏序列 Embedding、池化表征、稠密浮点网络、DIN 目标注意力模块以及 DCN 高阶交叉网络,是工业界多年迭代的集大成者。同时,附录 Table 13 还披露了在万亿级训练中配合 Stochastic Length 抽稀子序列的工程细节:对比纯随机丢弃(Random)与贪心截断(Greedy),按特征重要性加权采样(Feature-weighted Selection,优先保留高信息量的关键交互事件)能显著降低归一化熵损耗,让稀疏训练事半功倍。
7. 源码深挖:从 SequentialFeatures 到 Jagged HSTU 与缓存核
打开官方开源仓库 meta-recsys/generative-recommenders,我们可以顺着代码的真实调用链,看清论文里的公式与不规则张量(Jagged Tensor)优化在 PyTorch 与 Triton/C++ 中是如何落地的:
main.py (解析 .gin 配置并 mp.spawn 拉起多卡 DDP)
  -> generative_recommenders/research/trainer/train.py: train_fn()
       -> get_reco_dataset() & movielens_seq_features_from_row()  # 组装 SequentialFeatures
       -> LocalEmbeddingModule() & LearnablePositionalEmbeddingInputFeaturesPreprocessor()
       -> get_sequential_encoder(main_module="HSTU")              # 构建 HSTUJagged 主干
       -> SampledSoftmaxLoss()                                    # 负采样自回归损失
       -> get_top_k_module("MIPSBruteForceTopK")                  # 暴力最大内积评估检索
7.1 统一序列数据契约与 Gin 配置注入
在 generative_recommenders/research/data/features.py 中,全仓库的数据流围绕着一个极简的四元组 SequentialFeatures 运转:
class SequentialFeatures(NamedTuple):
    past_lengths: torch.Tensor                  # [B],每个用户的真实有效历史长度
    past_ids: torch.Tensor                      # [B, N],历史交互物品 ID 序列
    past_embeddings: Optional[torch.Tensor]     # [B, N, D],转换后的稠密表征序列
    past_payloads: Dict[str, torch.Tensor]      # 挂载 timestamps(时间戳)与 ratings(动作/评分)
注意这里的 past_lengths 与 past_payloads:前者专门用来在进入编码器前将二维 Padding 矩阵压平为一维紧凑的 Jagged Tensor(彻底消灭无效零填充位置的计算),后者则把事件时间戳 timestamps 和用户反馈评分/动作 ratings 原封不动地传给预处理器与相对时空偏置模块。
在 configs/ml-1m/hstu-sampled-softmax-n128-large-final.gin 中,我们可以看到跑出 Table 4 中 ML-1M 最优成绩的 HSTU-large 完整超参设定:max_sequence_length = 200,local_batch_size = 128,item_embedding_dim = 50,堆叠 num_blocks = 8 层 HSTU,每层 num_heads = 2、头维度 dqk = 25, dv = 25,配合 num_negatives = 128 的 SampledSoftmaxLoss 训练。
7.2 hstu.py 核心拆解:分桶时空偏置、Jagged 路径与 Cache 状态
进入全仓库最核心的模型文件 generative_recommenders/research/modeling/sequential/hstu.py,论文第 3 节与第 5 节的精髓全部浓缩在以下几个关键类中:
- 对数时间差分桶偏置
RelativeBucketedTimeAndPositionBasedBias: 源码是如何处理跨越几个月的连续时间戳差值的?如果直接拿秒级时间差 建表,几千万秒的跨度根本没法建查找表。源码的做法非常巧妙:先将成对时间戳差值裁剪到正数并除以时间步基本单位(如 60 秒),然后取自然对数再除以步长常数 向下取整,把从几秒钟到几个月的时间跨度平滑映射进有限的num_buckets(默认 128 个桶)内!这样一来,近期几分钟内的时间差拥有极高的分辨率,而几个月前的远期历史则自动归并到大时间桶里,与相对位置偏置RelativePositionalBias相加后直接注入注意力矩阵。 - 一维紧凑的
SequentialTransductionUnitJagged: 在单层 HSTU 的前向传播中,输入x摒弃了形状为[B, N, D]的三维填充稠密张量,直接采用形状为[sum(past_lengths), D]、配有一个偏移量数组x_offsets的二维 Jagged Tensor! 代码首先对x做 LayerNorm 并通过单层线性层self._uvqk一口气算出拼接在一起的u, v, q, k,经F.silu激活后切分开来;随后在_hstu_attention_maybe_from_cache()中计算QK^T + rel_attn_bias,过一层F.silu(qk_attn) / n(这就是废除 Softmax 后的逐点激活注意力!),乘上v后通过torch.ops.fbgemm.dense_to_jagged转回紧凑不规则张量;最后执行最核心的一行门控交叉:
# Norm(A(X)V(X)) 与门控分支 u 做逐元素乘积,再经线性层 _o 投出并加上残差连接
return self._o(
    F.dropout(
        self._norm_attn_output(attn_output) * u,
        p=self._dropout_ratio,
        training=self.training,
    )
) + x- 支撑 M-FALCON 的缓存元组
HSTUCacheState: 在hstu.py顶部,源码显式定义了供增量推理复用的四元组缓存结构:
HSTUCacheState = Tuple[torch.Tensor, torch.Tensor, torch.Tensor, torch.Tensor]它精确保存了每一层前序历史计算出的 (v, padded_q, padded_k, output)。当开启缓存推理时,_hstu_attention_maybe_from_cache() 只对新增的候选差量部分计算查询与键值,直接拼接到缓存里的 padded_k 和 v 后面算注意力,在代码层印证了 M-FALCON 将历史编码成本摊销为 的工程路径。同时,仓库还在 generative_recommenders/ops/triton 与 ops/cpp/hstu_attention 下提供了深度融合的 Triton 与 CUDA C++ 高性能算子,将分桶偏置计算与不规则张量矩阵乘彻底融进单个 GPU Kernel 中。
8. 工程演进蓝图与推荐架构全景坐标
8.1 存量推荐系统向 GR/HSTU 演进的六步路线图
对于绝大多数拥有存量 DLRM 系统的工程团队而言,不可能一夜之间直接去训 1.5 万亿参数的模型。结合论文在 Table 6/7 中验证过的上线策略,最稳妥的渐进式演进路线可以分为六步:
- 第一步:打通“内容 + 多维动作 + 时间戳”的统一序列日志契约:改造样本拼接流,不再只保留用户正向点击过的物品列表,而是将曝光未点击、完播时长、点赞、收藏、购买、负反馈隐藏等全量动作连同精确时间戳、召回源上下文一起按时间轴序列化,并严格做好曝光时刻截断以防特征穿越。
- 第二步:在离线管线用 HSTU 平替传统序列子模块:先不动线上大框架,在内部离线基准上用
HSTU(逐点 SiLU 注意力 + 对数时间差分桶偏置)替换原有的 SASRec 或普通 Transformer 序列编码器,验证非归一化逐点注意力在自有业务数据上的离线增益。 - 第三步:显式注入 Action Token 解锁多动作语义:将用户反馈动作 正式编码为序列中的交错 Token(或通过预处理层与内容 Token 深度融合),检验模型对正负反馈混合历史序列的区分能力。
- 第四步:以
GR (new source)模式小流量挂接目标感知精排:将待评候选 拼在用户序列末端预测动作分布,先作为原 DLRM 精排模型的一路新增特征分数或独立打分通道并入线上,跑通端到端链路。 - 第五步:落地 M-FALCON 历史缓存与微批次掩码打分:当准备扩大模型层数与序列长度时,在推理服务层落地用户历史前缀的
HSTUCacheState缓存与对角掩码微批次切分,把单请求多候选打分的 GPU 延迟压回 SLA 红线以内。 - 第六步:开启特征加权 Stochastic Length 冲击长周期 Scaling:在推理吞吐稳住后,配合按特征重要性加权的 Stochastic Length 采样,将历史行为窗口从百级逐步推向数千步,释放长周期序列与大模型容量的 Scaling Law 红利。
8.2 在推荐系统技术版图中的生态位与总结
把 Generative Recommenders (HSTU) 放进本站精读过的工业推荐系统技术版图中横向对标,可以非常清晰地看懂近十年推荐架构的演进脉络:
- 对比搜索式长序列 CTR 模型 SIM:面对数万步的用户终身历史,阿里 SIM 走的是 “检索降维 + 局部注意力” 路线——在传统 DLRM 框架内,先靠 22TB 的分布式用户行为树(UBT)把 54000 条行为粗筛成 100 条同类目子序列(SBS),再做轻量多头注意力;而 Meta 的 HSTU/GR 走的则是 “统一序列端到端自回归 + 算力硬刚” 路线——彻底革掉异构 DLRM 的命,靠 Stochastic Length、Jagged HSTU 算子与 M-FALCON 缓存,直接在长达 8192 的完整交错序列上跑数十层深层自注意力。在现代工业实践中,这两条路线正在加速合流:先用 SIM 式的快速检索从十万级终身行为里筛出几千条高相关上下文,再喂给 HSTU 式的生成式序列主干做深层转导。
- 对比多任务排序训练稳定性方案 Clippy:当推荐模型无论是沿着 DLRM 叠加交叉层,还是沿着 GR/HSTU 推高深度与算力时,流式非平稳数据下的训练失稳都是绕不开的拦路虎;Clippy 在优化器底层构建的逐坐标预条件步长护栏,与 HSTU 在架构层用逐点激活替代脆弱 Softmax、用 LayerNorm 配合门控抑制数值爆炸的设计,共同构成了超大规模推荐模型稳定收敛的双保险。
回望全文,Actions Speak Louder than Words 最深远的贡献,在于它用极其扎实的数学改造与系统工程(HSTU 编码器、Stochastic Length 稀疏训练、M-FALCON 缓存微批次推理),打破了“推荐系统只能靠堆人力做手工特征、吃不到大模型 Scaling Law”的行业宿命。它证明了:在推荐系统里,用户的每一个动作就是最真实的语言;只要把内容与动作编织成统一的因果序列,并为之打造适配非平稳稀疏分布的转导算子与推理引擎,推荐系统同样能跨入万亿参数的基础模型时代。
参考资料
- Jiaqi Zhai, Lucy Liao, Xing Liu, Yueming Wang, Rui Li, Xuan Cao, Leon Gao, Zhaojie Gong, Fangda Gu, Michael He, Yinghai Lu, Yu Shi, Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, ICML 2024(PMLR Vol. 235).
- 官方开源仓库:meta-recsys/generative-recommenders.
- 相关核心文献:SASRec (ICDM 2018)、BERT4Rec (CIKM 2019)、DLRM (2019)、YouTube DNN (RecSys 2016)、FlashAttention-2 (2023).
comments