设想一个典型的电商推荐场景:一位淘宝用户在入冬前的十月份曾连续两周密集浏览、比价并收藏过多款单板滑雪镜与雪服;而在随后的十一月和十二月里,他的日常高频点击被几百次零食复购、纸巾囤货、手机壳与日用百货填满。当年底大促期间一则高客单价的滑雪场套票或专业雪具广告进入候选池时,在线点击率(CTR)预估引擎面临着一个极其苛刻的工程与算法悖论——如何在每秒超百万次请求(1M+ QPS)、单次响应延迟严格受限于 30ms 的实时计算预算内,穿过近两个月数千条日常杂货交互的掩盖,精准唤醒沉睡在数万步历史之前的“滑雪”兴趣?
如果排序模型只截取用户最近的 100 条行为(如经典的 DIN 与 DIEN),三个月前的滑雪轨迹早已滑出时间窗口,模型只能看到眼前的纸巾与零食;如果试图在异步旁路中把上千条历史行为强行压缩进少数几个固定维度的记忆槽(如前代架构 MIMN),高频的日用百货就会迅速冲刷并占满记忆容量,导致面对“滑雪镜”候选广告时根本无法提取出高信噪比的垂直偏好。
阿里巴巴妈妈团队(Pi Qi、Xiaoqiang Zhu、Guorui Zhou、Yujing Zhang、Zhe Wang、Lejian Ren、Ying Fan 与 Kun Gai)在 CIKM 2020 发表的经典论文 Search-based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction(PDF),为这一工业界难题给出了极具启发性的系统级解法。作者提出了搜索式用户兴趣模型(Search-based Interest Model, SIM),彻底放弃了“将超长历史预压缩为固定向量”的执念,转而将搜索召回的降维思想引入单次 CTR 推理内部:先用低成本的粗粒度检索从长达 54000 的终身行为序列中实时捞出百级候选相关子序列,再交由多头目标注意力网络提取带时间衰减的细粒度兴趣表征。
1. 核心设计哲学:为什么长序列建模必须走向“先搜后算”?
在深入公式与系统架构之前,我们先提炼出 SIM 贯穿算法与基础设施改造的 4 项核心设计哲学:
- 把“全序列记忆压缩”重构为“先搜索降维、再注意精排”的微观漏斗(Search-Then-Attend Micro-Funnel over Sequence Compression):面对数万条异构历史行为,任何试图用单一神经网络算子一次性编码全序列的做法都会同时撞上算力墙与噪声墙。SIM 洞察到:对于某一个具体的候选商品,用户万级历史中真正相关的行为通常不超过百条。因此,最合理的架构应当分为两级流水线——第一阶段用极低成本的通用检索单元(General Search Unit, GSU)剔除
99%的异类噪声、截取出百级子行为序列(Sub user Behavior Sequence, SBS),第二阶段再用高表达力的精确建模单元(Exact Search Unit, ESU)在精品子集上做细粒度注意力加权。 - 放弃候选无关的静态记忆槽,死守目标商品驱动的动态激活(Candidate-Aware Retrieval over Static Memory Slots):为什么前代架构 MIMN 把序列长度推到
1000后就难以为继?从信息论视角看,MIMN 在未知当前待打分候选广告 的前提下,提前将长度为 的序列压缩进固定数量 ()的记忆槽中,这是一种有损且无目标导向的静态压缩。SIM 坚持候选商品 必须从第一阶段起就作为 Query 参与历史筛选:同一个用户在同一次请求中面对“跑鞋”与“咖啡机”两个候选广告时,GSU 会从同一棵终身行为树上检索出两套完全不同的历史子序列,从根源上恢复了 DIN 级别的目标感知能力(Target-Awareness)。 - 用
0.0001的离线 AUC 让步换取零漂移的在线系统确定性(Pragmatic Co-Design: Category Hard-Search over Parameterized MIPS):在第一阶段 GSU 的具体实现上,论文同时探索了基于参数化向量内积的软检索(Soft-search,配合 ALSH/MIPS 向量索引)与基于商品叶子类目匹配的硬检索(Hard-search,配合双层键值索引)。尽管 Soft-search 在百亿样本工业集上离线 AUC 略高0.0001(0.6625vs0.6624),阿里最终推全上线的依然是 Hard-search。因为在线维护十亿级用户的万级动态向量索引,还要应对每日模型参数更新引发的全量向量漂移与重刷,工程代价极其高昂;而利用电商天然完备的类目树构建22TB分布式用户行为树(User Behavior Tree, UBT),仅凭 查表就能覆盖 Soft-search75%以上的召回结果,完美诠释了工业系统“用确定性数据结构换取极致性价比”的权衡艺术。 - 在同质子序列内部显式注入时间间隔,解耦语义相关与时间衰减(Time-Interval Injection within Homogeneous Sub-Sequences):经过 GSU 按类目过滤后,进入 ESU 的百条行为在语义上高度同质(例如全是女装或全是数码配件),但它们发生的时间可能横跨三天前到半年前。为了让模型区分“三天前的密集比价”与“五个月前的偶发浏览”,ESU 将每条行为距当前曝光时刻的时间间隔()离散化编码后与商品表征拼接,在多头目标注意力中联合建模商品属性交叉与跨月度兴趣衰减。
User Lifelong Behaviors B_u (up to 54,000 items over 180 days)
  + Candidate Ad Query a (Leaf Category ID or Projected Embedding)
  ──► Stage 1: General Search Unit (GSU via 22TB UBT Index Lookup)
        Filters 54,000 items down to Top-K (K ~ 100) Sub Behavior Sequence B_u*(a)
  ──► Stage 2: Exact Search Unit (ESU via Time-Interval Multi-Head Target Attention)
        Fuses item embeddings + time deltas Δ_j to produce Long-Term Interest U_lt
  ──► Concatenated with DIEN Short-Term Interest ──► Final CTR Prediction
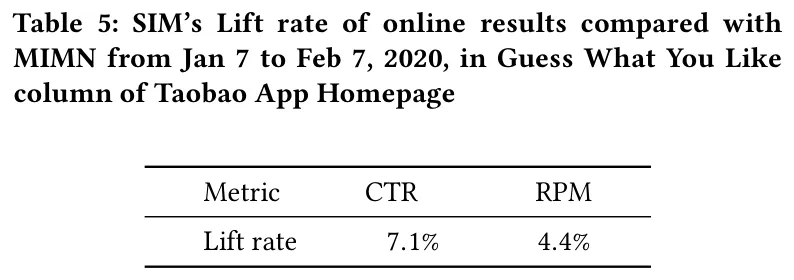
凭借这套算法与系统协同设计(Model-System Co-Design),SIM 自 2019 年起部署于阿里巴巴展示广告主流量,在淘宝首页“猜你喜欢”为期一个月的线上 A/B 测试中,相对上一代 MIMN 取得了 +7.1% CTR 与 +4.4% RPM(千次展示收入) 的显著业务增长,并将单机 500 QPS 高负载下的在线推理延迟稳稳压制在 18.03ms。
2. 工业 CTR 预估的长序列困局与阿里模型演进脉络
2.1 当序列长度突破万级:六个维度的系统与建模碰撞
在工业级推荐与广告排序中,CTR 预估通常形式化为点式(pointwise)二分类概率预估问题。给定用户画像 、候选商品或广告 、上下文环境 以及长度为 的用户历史行为序列 ,模型预测点击概率 ,并通过最小化交叉熵损失进行端到端训练:
在短期会话内,用户兴趣往往集中且单调;但一旦将时间视野拉长到过去 180 天(序列长度 从百级跃升至万级乃至 54000),季节性更替、周期性复购、跨品类品牌偏好等长尾信号才会浮现。然而,在峰值百万 QPS、单次精排打分需同时评估数百个候选广告且总延迟上限仅为 30ms 的严苛约束下,直接拉长 会在六个维度引发连锁崩溃:
- 算力复杂度爆炸:无论是目标注意力(每个候选广告与 条历史做交互,单次请求复杂度 ,其中 为候选广告数)还是循环神经网络(GRU 串行展开 步),耗时都会随 线性甚至超线性飙升;
- 跨节点网络带宽打满:在分布式实时预测系统(RTP)中,特征计算节点与模型推理服务器分离。若每次请求都将用户多达数万条的历史商品 ID、类目、品牌与时间戳原样打包发送给推理节点,网络网卡与序列化开销会瞬间撑爆集群;
- 全量特征存储膨胀:数亿活跃用户各自长达数万条的多属性行为明细,在内存中组织与索引需要数十 TB 的分布式存储底座;
- 尾延迟(P99 RT)失控:重度活跃用户的超长历史极易引发长尾请求超时,直接击穿实时竞价系统的
30ms熔断红线; - 信噪比急剧恶化:当用户累积了
50000条历史点击时,其中99%以上与当前正在打分的特定候选商品毫无关联。如果强行做全序列均值池化或软注意力,海量无关项的微小权重累加起来也会彻底淹没少数几条真正相关的历史信号; - 多峰兴趣相互覆盖:同一个用户既有“母婴用品”偏好又有“机械键盘”爱好,任何脱离当前候选商品的静态单向量表征都无法同时精准刻画这两种截然不同的意图。
2.2 从 DIN、DIEN、MIMN 到 SIM:演进背后的数学本质
把 SIM 放回阿里妈妈 CTR 排序模型的演进谱系中,可以非常清晰地看懂每一代架构究竟在妥协什么、又在拯救什么:
| 模型代际 | 可支撑序列长度 | 核心序列建模算子 | 候选目标感知(Target-Aware) | 为什么在超长序列上触顶? |
|---|---|---|---|---|
| DIN (KDD 2018) | 局部目标注意力 | 强(逐候选动态加权) | 在线需对每个候选广告遍历全序列计算注意力,耗时随 线性增长 | |
| DIEN (AAAI 2019) | 双层 GRU(AIGRU + AUGRU)提取兴趣演化轨迹 | 强(AUGRU 融合目标注意力门控) | GRU 时序递归无法在序列维度并行,在线推理延迟比 DIN 更重 | |
| MIMN (KDD 2019) | 异步旁路 UIC + 神经图灵机固定槽位记忆矩阵 | 弱/丧失(先脱离候选写入固定记忆槽,在线仅读取静态槽) | 将上千条异构行为塞进少数几个候选无关的记忆槽,跨类目噪声严重混叠,序列超过 1000 后 AUC 不再增长 | |
| SIM (CIKM 2020) | 最高 54000 | GSU 粗排检索 Top- 子序列 + ESU 时间多头目标注意力 | 强(检索阶段与注意力阶段双重受候选商品 驱动) | 通过“检索下沉至特征层 + 推理维持百级子序列”彻底解耦序列长度 与在线推理耗时 |
这一演进揭示了一个深刻的教训:MIMN 为了规避在线延迟,把“候选交互”推迟到了“序列压缩”之后(),结果在压缩阶段丢失了最关键的候选先验;而 SIM 把顺序重新反转过来,先用候选商品 去原始行为库里做极速筛选(),既保住了无损的原始行为颗粒度,又把在线神经网络的实际输入长度牢牢锁死在百级常数 。
3. SIM 两阶段建模机制:GSU 粗排检索与 ESU 精排注意力
3.1 整体网络拓扑与两级搜索流水线
下图展示了 SIM 的完整网络架构,由第一阶段的通用检索单元(General Search Unit, GSU)与第二阶段的精确建模单元(Exact Search Unit, ESU)串联构成,并与负责短期行为建模的 DIEN 分支并行汇入顶层 MLP:
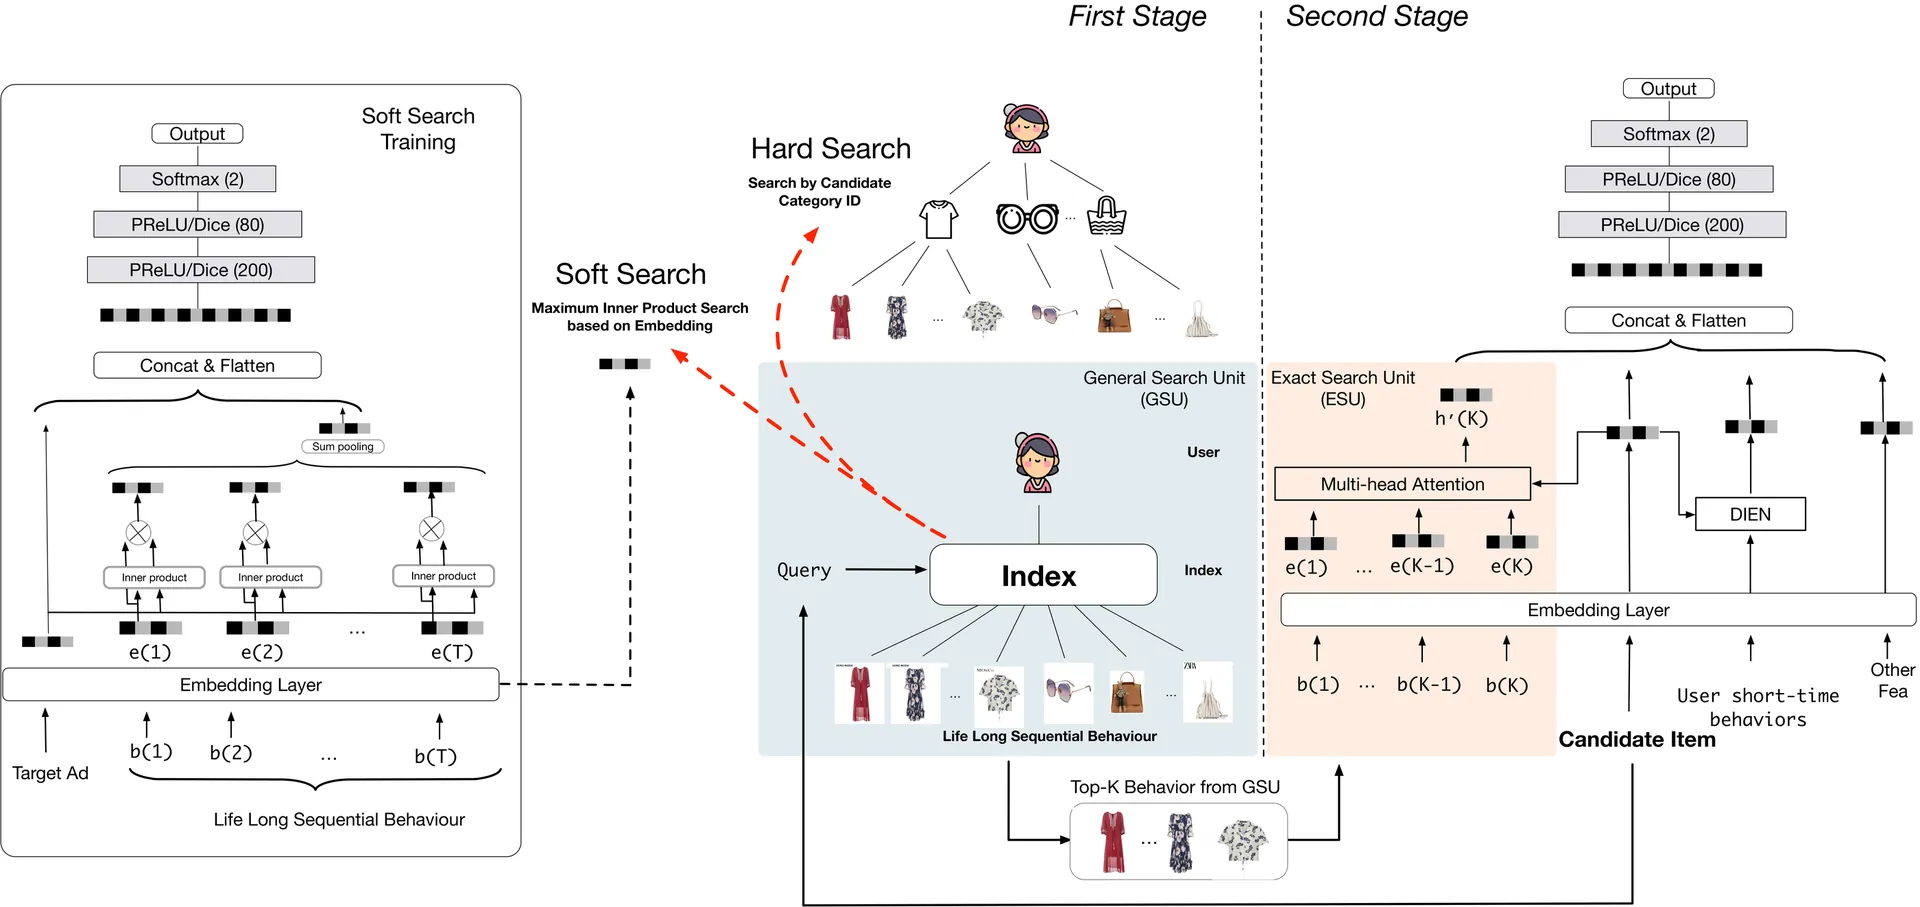
给定用户的终身行为序列 (其中每条行为 包含商品 ID、叶子类目 ID、品牌、价格带及发生时间戳)与当前待评估的候选广告 ,第一阶段 GSU 为每条历史行为计算一个轻量相关性打分 ,并筛选出得分最高的 条行为(,工程上通常取 100~200)组成候选专属的子行为序列(Sub user Behavior Sequence, SBS),记作 :
完成百倍降维后,第二阶段 ESU 将这 条高度相关的历史行为连同它们距离当前曝光时刻的时间间隔(Time Interval)一起编码,通过多头目标注意力(Multi-Head Target Attention)提取长期用户兴趣向量 ,最后与 DIEN 从最近十几天行为中提取的短期演化兴趣拼接,共同驱动最终的点击率预测。
3.2 第一阶段 GSU 的两条路线:Hard-search 与 Soft-search
如何设计相关性打分函数 ,才能在万级序列上实现亚毫秒级过滤?论文设计并对比了非参数化的 Hard-search 与参数化的 Soft-search 两种方案:
1. 非参数化硬检索(Hard-search)
在淘宝、天猫等成熟电商平台中,所有商品与广告都挂载在维护精良的层级类目树(Category Taxonomy)下。Hard-search 直接利用这一强领域先验,判定历史行为 的叶子类目 是否与当前候选商品 的叶子类目 完全一致:
如果同一叶子类目下的历史交互超过上限 ,则按发生时间由近及远截取最近的 条。由于判断条件 完全不依赖任何神经网络参数或浮点矩阵乘法,我们无需在线遍历 条历史,只需在离线/近线阶段将用户的扁平行为流按 (user_id, category_id) 预组织为两级哈希或树形索引,在线检索即可直接退化为 时间复杂度的键值查表。
2. 参数化软检索(Soft-search)
如果业务场景缺乏高质量的商品类目树,或者希望捕捉跨类目的潜在语义关联(例如浏览过“瑜伽垫”的用户对“蛋白粉”广告产生兴趣),就需要引入参数化的 Soft-search。设第 条历史行为的各属性 Embedding 拼接向量为 ,候选商品的 Embedding 向量为 ,Soft-search 通过可学习的投影矩阵 计算两者的内积相关性得分 :
这里隐藏着一个极易被忽视的训练难点:能不能直接拿主 CTR 网络里短期行为训练出的 Embedding 参数,去对长达 54000 的终身行为算内积?答案是不能。因为横跨半年的终身行为分布与最近几天的短期行为分布存在显著的统计偏移(Distribution Shift),且主网络从未在万级噪声背景下优化过粗排区分度。为此,作者专门为 Soft-search 构造了一个辅助 CTR 监督分支:将全量历史行为按相关性得分 做加权求和得到 ,再与 一并送入辅助 MLP 计算二分类交叉熵损失 (训练时若序列过长可做随机子采样)。到了在线推理阶段,固定训练收敛的 与 ,利用基于非对称局部敏感哈希(Asymmetric Locality Sensitive Hashing, ALSH)的最大内积搜索(MIPS)算法,在对数级时间内从用户的行为向量库中召回 Top- 子序列。
3.3 为什么阿里最终全量上线了 Hard-search?
在论文的实验与系统选型中,作者坦诚分享了一个教科书级别的工业界架构取舍:尽管 Soft-search 在算法灵活性与离线指标上略胜一筹,但阿里妈妈最终推全到线上生产环境的版本毫不犹豫地选择了 Hard-search。支撑这一决策的证据链极其扎实:
| 决策评估维度 | Soft-search(参数化向量内积 + ALSH/MIPS) | Hard-search(非参数化叶子类目匹配 + UBT) |
|---|---|---|
| 语义泛化边界 | 支持跨叶子类目的隐式向量相似召回 | 严格对齐叶子类目树,仅召回同类目历史 |
| 召回结果重叠率 | 基准参照集合 | 在阿里工业数据集上,直接覆盖了 Soft-search Top- 召回结果的 75% 以上 |
| 百亿样本工业集 AUC | 0.6625 | 配合时间间隔编码达到 0.6624,仅相差万分之一(0.0001) |
| 模型更新与索引同步 | 运维噩梦:在线流式训练或每日模型更新都会改变 与物品 Embedding,导致十亿用户、数万亿条历史行为向量集体失效,需频繁重算与刷写 MIPS 索引 | 零漂移:商品所属的叶子类目是静态业务属性,与模型权重完全解耦;模型无论怎么迭代,底层的 22TB 行为树索引都无需重算 |
| 在线检索延迟与开销 | 需维护庞大的近似向量检索集群并执行浮点距离计算 | 纯粹的分布式 Key-Key-Value 内存/SSD 查表,耗时极低且结果 100% 确定 |
高达 75% 的召回重叠率道出了电商推荐的领域真相:在拥有十万级细粒度叶子类目的淘宝体系下,用户长期兴趣的延续性绝大多数就发生在“同一叶子类目”内部(例如买过猫粮的人长期关注猫粮,看过机械键盘的人反复对比键帽与轴体)。为了剩下不到 25% 的跨类目模糊相似去背负十亿级动态向量索引刷写的沉重包袱,只换来 0.0001 的离线 AUC 提升,在工程投入产出比上是完全得不偿失的。
3.4 第二阶段 ESU:时间间隔编码与多头目标注意力
当 GSU 从 54000 条历史中捞出百级同类目子序列 后,新的问题随之而来:这 条行为全部属于同一个叶子类目,它们在类目维度上的区分度已经归零;同时,第 1 条行为可能发生在半小时前,而第 条行为可能发生在 170 天前。如果直接照搬普通的目标注意力,模型根本无从判断哪条同类目历史代表近期购买意图、哪条代表半年前早已过期的旧兴趣。
为此,ESU 显式引入了每条被召回行为距当前曝光时刻的时间间隔特征(Time Interval),其中 。将连续的时间差按业务分桶离散化并查表映射为时间间隔 Embedding ,再与行为自身的商品属性 Embedding 拼接,得到第 条子序列行为的联合时空表征 :
在此基础上,ESU 采用 个并行注意力头(Multi-Head Attention),从不同子空间捕获候选商品 与同类目历史行为 之间的细粒度属性交互(如品牌偏好对齐、价格带匹配及时间衰减权重):
将全部 个头的加权输出拼接,即构成最终送入顶层分类器的长期用户兴趣表征:
在训练目标上,SIM 的总体损失函数写为两阶段监督信号的加权组合:
当使用参数化的 Soft-search 时,设 ,让辅助粗排损失 与主网络精排损失 同步反向传播;当线上采用非参数化的 Hard-search 时,由于第一阶段无任何可训练参数,直接令 ,整个模型退化为极度清爽的端到端单目标交叉熵训练。
4. 实时预测系统(RTP)改造与 22TB 用户行为树(UBT)
4.1 为什么光改模型代码无法让万级序列上线?
许多算法工程师在复现长序列论文时容易陷入一个误区:以为在 TensorFlow 或 PyTorch 的 call() 函数里写一行 tf.boolean_mask(history, history_cat == target_cat) 就算实现了 SIM。然而在真实的工业级分布式推荐系统中,真正卡住万级序列咽喉的往往是推理服务之前的特征传输链路。
下图对比了接入 SIM 之前的传统实时预测系统(Real-Time Prediction, RTP)与改造后的 SIM 在线系统架构:
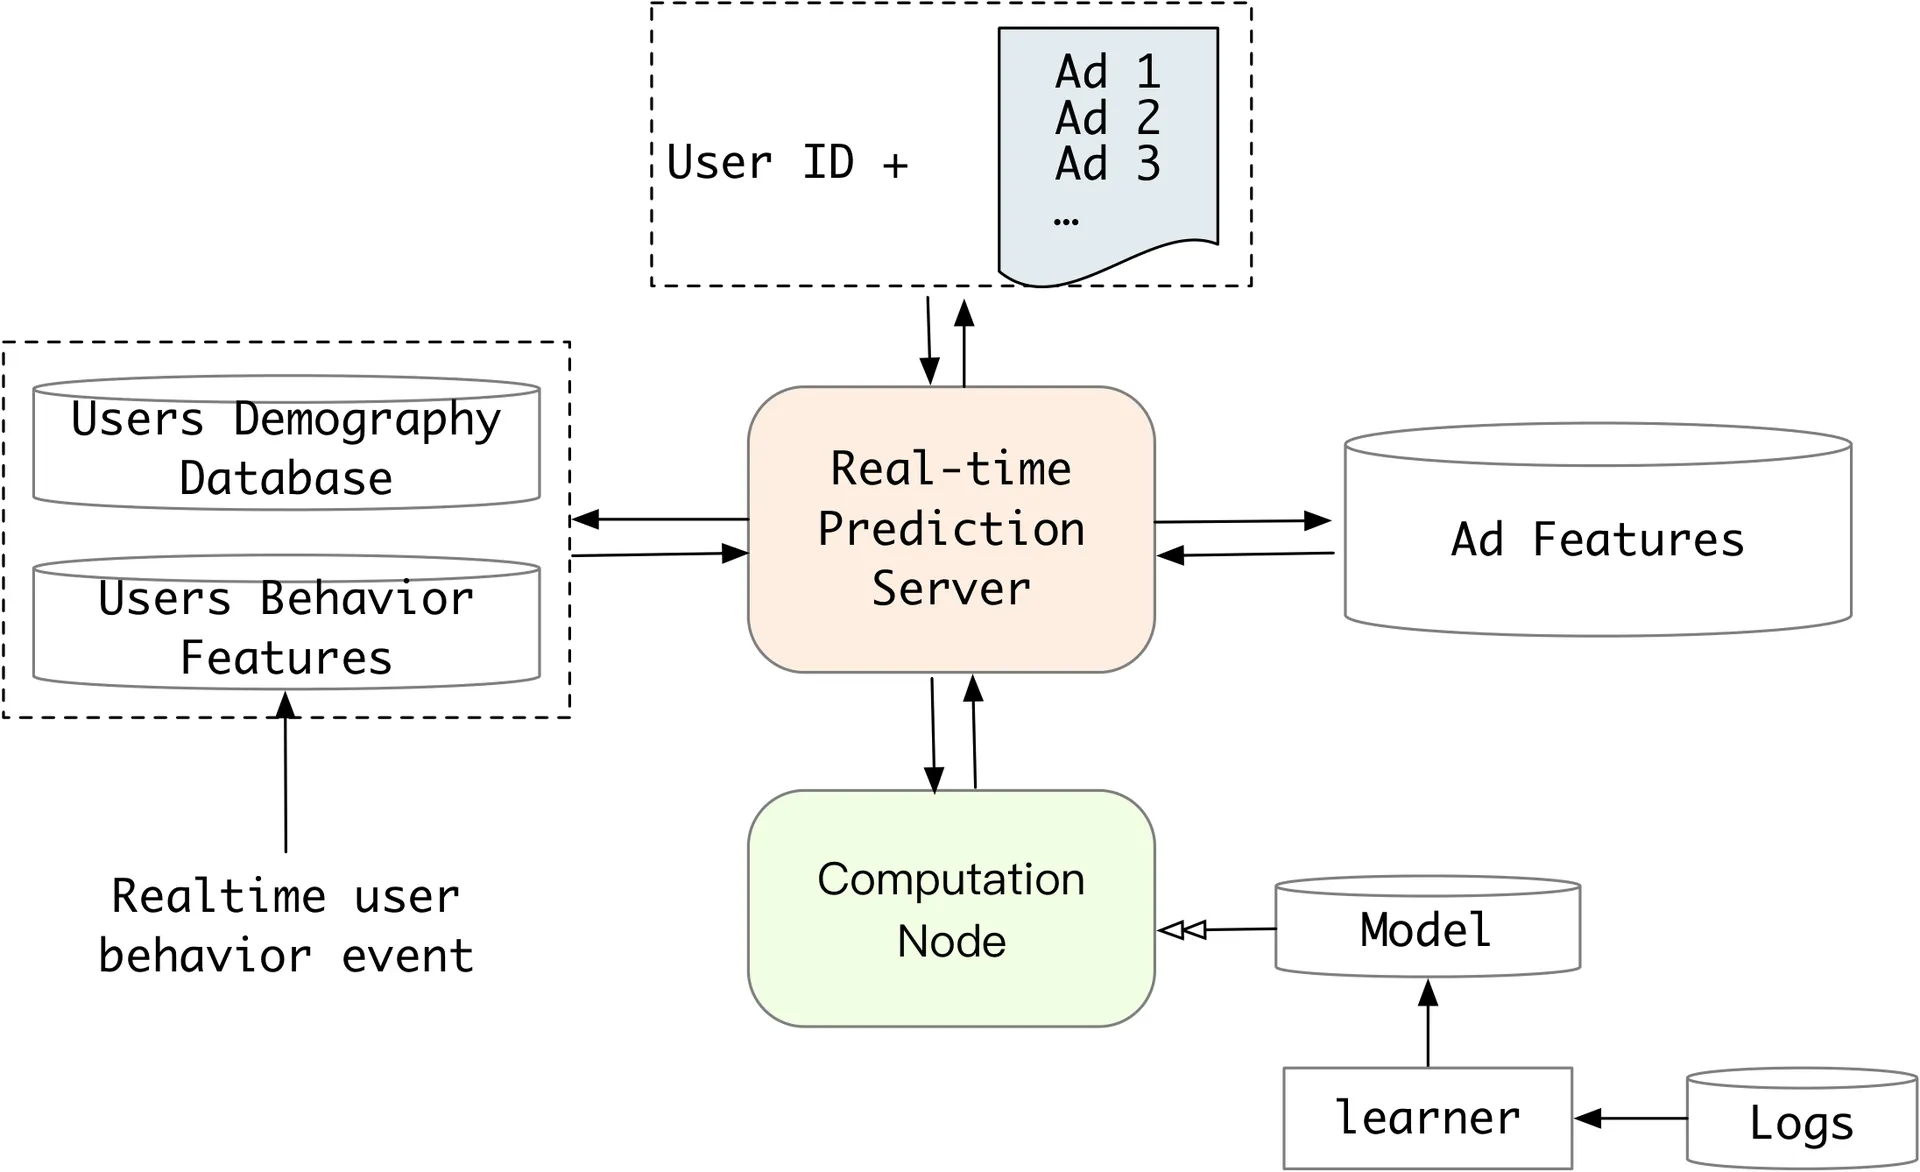
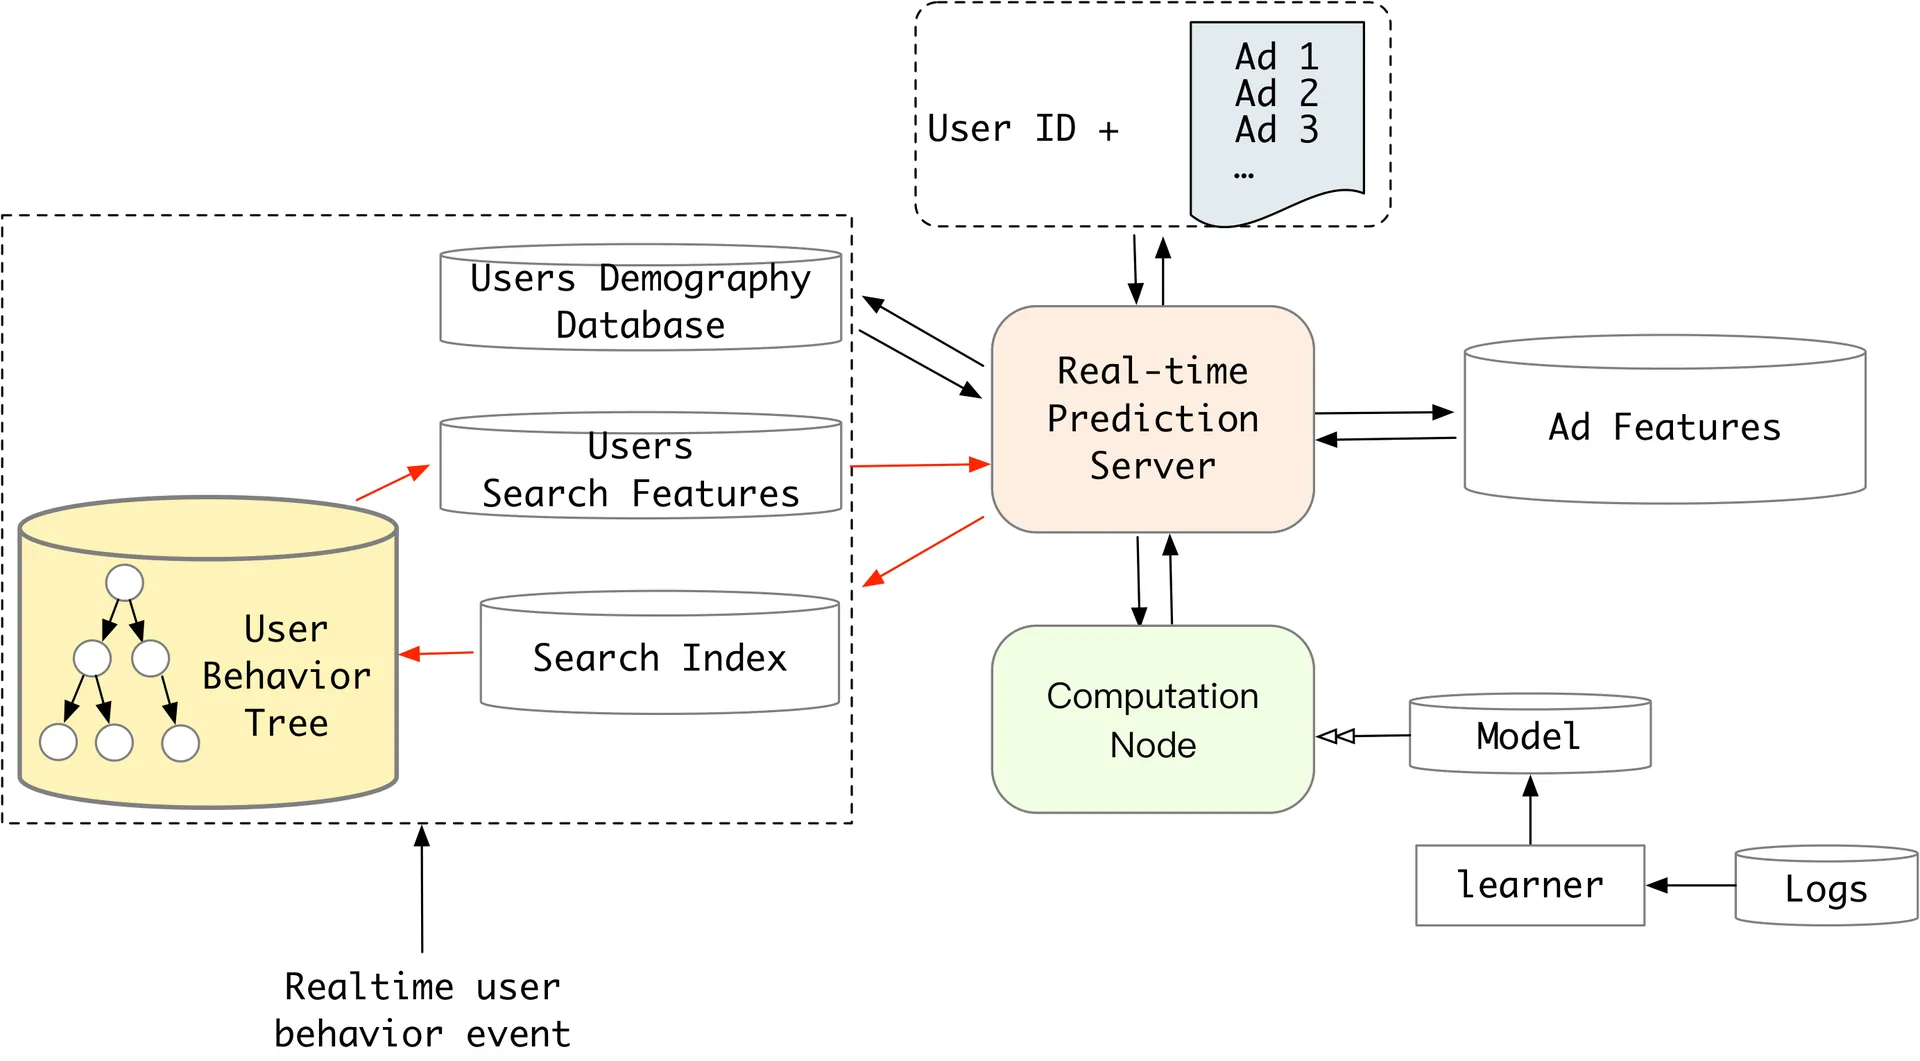
在传统的 RTP 拓扑中,当一次淘宝首页刷新请求到达计算节点(Computation Node)时,计算节点负责从特征存储中拉取当前用户的画像与全量历史行为列表,将其与几百个候选广告的特征拼装序列化后,通过 RPC 网络发送给远端的预测服务器(Prediction Server,运行深度学习推理图)打分。如果把用户历史长度从 100 直接扩充到 54000,哪怕预测服务器内部用掩码瞬间过滤掉了 99% 的商品,计算节点依然要在每次请求中读取、序列化并通过网络跨机房传输 54000 个商品 ID 及附属属性——这会直接引发网卡带宽饱和与序列化 CPU 100% 满载。
4.2 将 GSU 下沉至计算节点:Key-Key-Value 用户行为树
为了从物理链路上消灭万级序列的传输洪峰,阿里团队将第一阶段 GSU 的 Hard-search 逻辑从预测服务器剥离,直接前移下沉到了计算节点侧,并配套构建了总容量高达 22TB 的分布式用户行为树(User Behavior Tree, UBT)。
UBT 本质上是一个针对终身行为按类目预分桶的三层 Key-Key-Value 分布式索引结构:
Level-1 Key: user_id (数亿活跃用户)
  └──► Level-2 Key: category_id (该用户历史交互过的叶子类目集合)
         └──► Value: [item_1, item_2, ..., item_k] (按时间倒序排列的同类目历史行为明细列表)
在这一新架构下,单次在线请求的完整生命周期被重塑为极其轻巧的四步:
- 提取查询类目集:当曝光请求携带候选广告列表到达计算节点时,节点首先提取这批候选广告所覆盖的唯一目标叶子类目集合 ;
- 前置 查表过滤(GSU):计算节点直接以
(user_id, category_id)为复合键查询分布式 UBT 索引,在毫秒内精确取出每个候选类目对应的百级子行为序列 SBS; - 轻量网络传输:计算节点仅将过滤后长度不足百级的 SBS(连同实时计算好的时间间隔分桶 )通过网络发送至预测服务器,跨节点传输的数据量骤降了两个数量级以上;
- GPU/CPU 神经精排(ESU):预测服务器收到的张量形状与处理百级短期序列时别无二致,从容运行多头目标注意力与顶层 MLP 完成点击率预估。
这种“离线预分桶建树 + 计算节点前置粗筛 + 预测节点轻量精排”的职责切分,是 SIM 能够在不扩容推理集群的前提下把建模长度推高 54 倍的真正工程底座。
5. 公开基准、百亿级工业实验与线上业务验证
5.1 数据集规模与工业级终身序列分布
论文在两个广泛使用的公开推荐基准(Amazon Books、Taobao)以及阿里巴巴展示广告生产数据集(Industrial)上进行了全面评测:
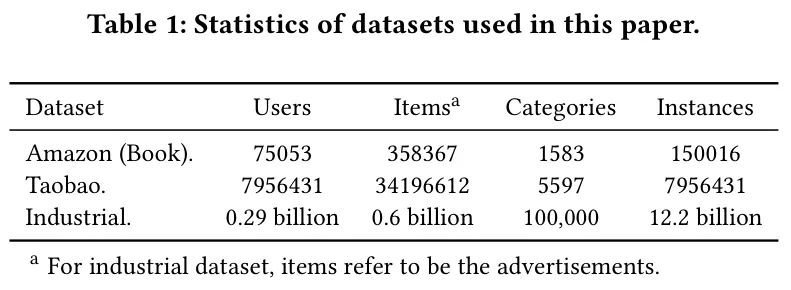
审视这三组数据集的规模跨度,可以清晰看到学术玩具集与真实工业环境的量级鸿沟:Amazon Books 仅有 7.5 万用户、15 万样本,最大行为序列长度截断在 100(前 90 条划为长期,近 10 条划为短期);Taobao 公开集包含约 796 万用户与样本,最大序列长度为 500(前 484 条为长期,近 16 条为短期);而阿里内部 Industrial 工业数据集涵盖了 2.9 亿真实用户、6.0 亿商品、10 万个叶子类目以及 122 亿条曝光训练样本(取过去 49 天日志训练、第 50 天测试)。更重要的是,在工业数据集中,短期行为取用户过去 14 天内的交互,而长期行为回溯过去 180 天的完整历史——其中超过 30% 的样本历史行为长度突破 10000 条,最大序列长度高达 54000 条。
5.2 公开数据集对比与两阶段消融归因
在公开数据集评测与两阶段逐层消融实验中,作者回答了一个核心科学问题:SIM 的性能飞跃,究竟多大程度上归功于第一阶段 GSU 的去噪提纯,又有多大程度归功于第二阶段 ESU 的注意力与时间编码?
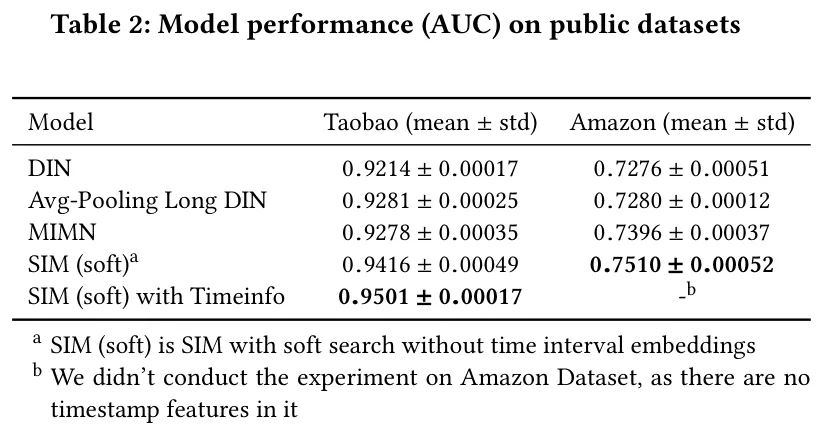
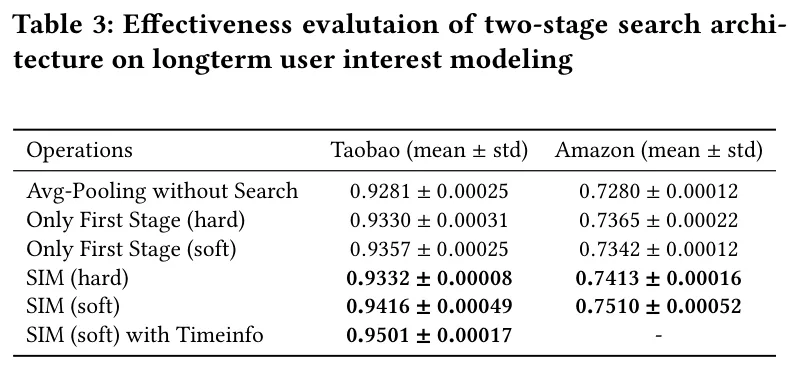
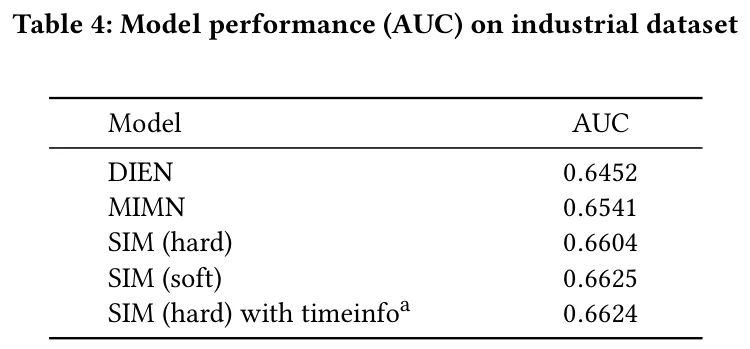
将这三张实验结果表串联分析,可以读出三层极具说服力的归因结论:
- 粗暴池化与静态记忆槽无法释放长序列红利:以行为更丰富的 Taobao 数据集为例,仅建模近 16 条短期行为的 DIN 取得
0.9214;如果把前 484 条长期行为简单做均值池化拼入模型(Avg-Pooling Long DIN),AUC 仅微增至0.9281,而引入复杂神经图灵机读写机制的 MIMN 也不过停留在0.9278(与简单均值池化几乎打平)。这直接印证了前文的理论判断:脱离当前候选商品去强行压缩长序列,绝大部分有效信号都会被跨品类噪声抵消。 - 第一阶段 GSU 搜索去噪贡献了最大头的基座跃升:观察两阶段消融表可以发现,哪怕第二阶段完全不用任何注意力机制、仅仅对第一阶段 GSU 筛出的百级子序列做最朴素的均值池化(
Only First Stage hard / soft),Taobao 数据集上的 AUC 就从无搜索池化的0.9281直接跳升至0.9342(Hard)与0.9370(Soft)!这铁证如山地说明:在超长序列建模中,“做减法”(用高准确率检索剔除 99% 的异类干扰)比“做加法”(在全序列上堆叠复杂算子)更为关键。 - 第二阶段 ESU 与时间编码完成临门一脚:在 GSU 提纯出的高信噪比子序列之上,将均值池化替换为 ESU 多头目标注意力后,
SIM (soft)在 Taobao 上跃升至0.9416;进一步注入时间间隔编码(with Timeinfo)后,指标冲上全表最高点0.9501(比 MIMN 高出惊人的+0.0223)。而在122亿样本的工业数据集上,从 DIEN(0.6452)到 MIMN(0.6541),再到SIM (hard with timeinfo)(0.6624)与SIM (soft)(0.6625),SIM 相对前代线上主力模型 MIMN 取得了+0.0083的离线 AUC 绝对提升——在百亿级工业广告系统中,通常+0.001的离线 AUC 即可转化为显著的线上收入增长,+0.008属于跨代际的巨大突破。
5.3 实证检验:SIM 真的唤醒了数月前的沉睡兴趣吗?
离线 AUC 涨了,线上 CTR 涨了,但怀疑论者依然可以追问:SIM 多赚到的点击,会不会只是把用户最近几天的短期兴趣刻画得更准了,而那长达半年的历史其实只是陪跑?
为了从因果层面彻底证实模型确实捕获了长周期兴趣,作者设计了一个极其巧妙的诊断指标——历史同类目回溯天数 :针对线上真实发生的每一次广告点击事件,回溯该用户历史行为序列中最近一次交互同一叶子类目商品的时刻,计算两次事件相隔的自然日天数(若该用户在历史中从未接触过该类目,则记 )。显然,如果一个点击事件对应的 天,说明该类目在过去两周的短期行为窗口(DIEN 的可见范围)内完全没有出现过,纯粹是靠唤醒两周乃至数月前的长期记忆促成的转化!
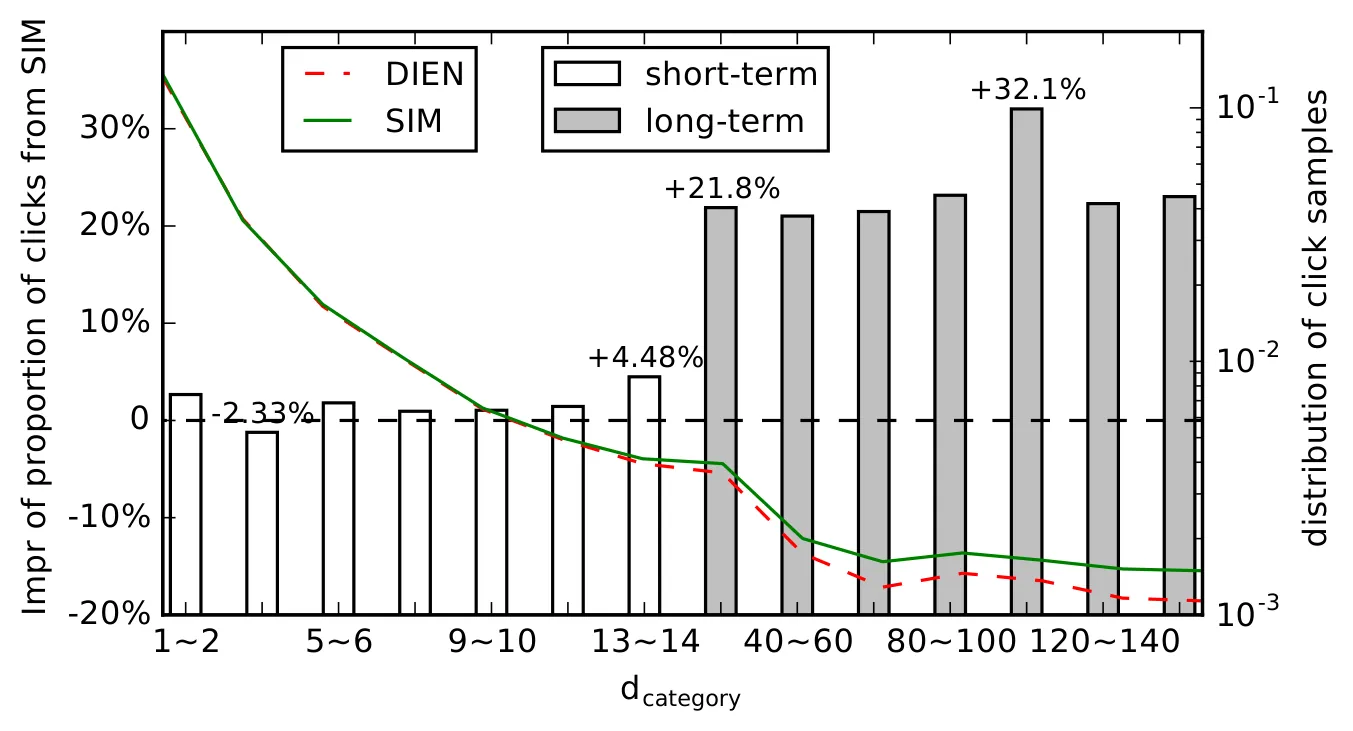
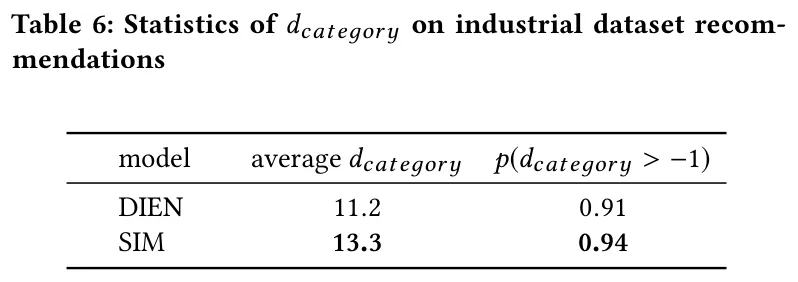
对照点击分布直方图与线上统计指标,证据链严丝合缝:
- 长周期区间点击占比井喷:在短期行为覆盖的近 14 天内(),SIM 与 DIEN 的点击分布难分伯仲;但一旦进入灰色标注的长周期历史深水区( 天),SIM 促成的点击占比相对 DIEN 在
14~30 天区间暴涨了+21.8%,在30 天以上的超远期区间更是暴涨了+32.1%! - 兴趣唤醒半径显著拓宽:全量点击样本中命中用户历史已有类目的概率 从 DIEN 的
0.91提升至0.94,且平均回溯跨度 从11.2天直接拉长至13.3天。 - 兑现为真金白银的线上收益:在 2020 年 1 月 7 日至 2 月 7 日淘宝首页“猜你喜欢”生产流量的严格 A/B 测试中,SIM 相对 MIMN 取得了
+7.1%CTR 与+4.4%RPM 的大幅增长。
5.4 在线吞吐(QPS)与响应延迟(RT)压测边界
最后,我们看一眼决定生死的线上服务性能压测曲线——在真实生产流量下,对比建模 54000 长度的 SIM、强行拉长至 1000 长度的 DIEN,以及建模 1000 长度的 MIMN:
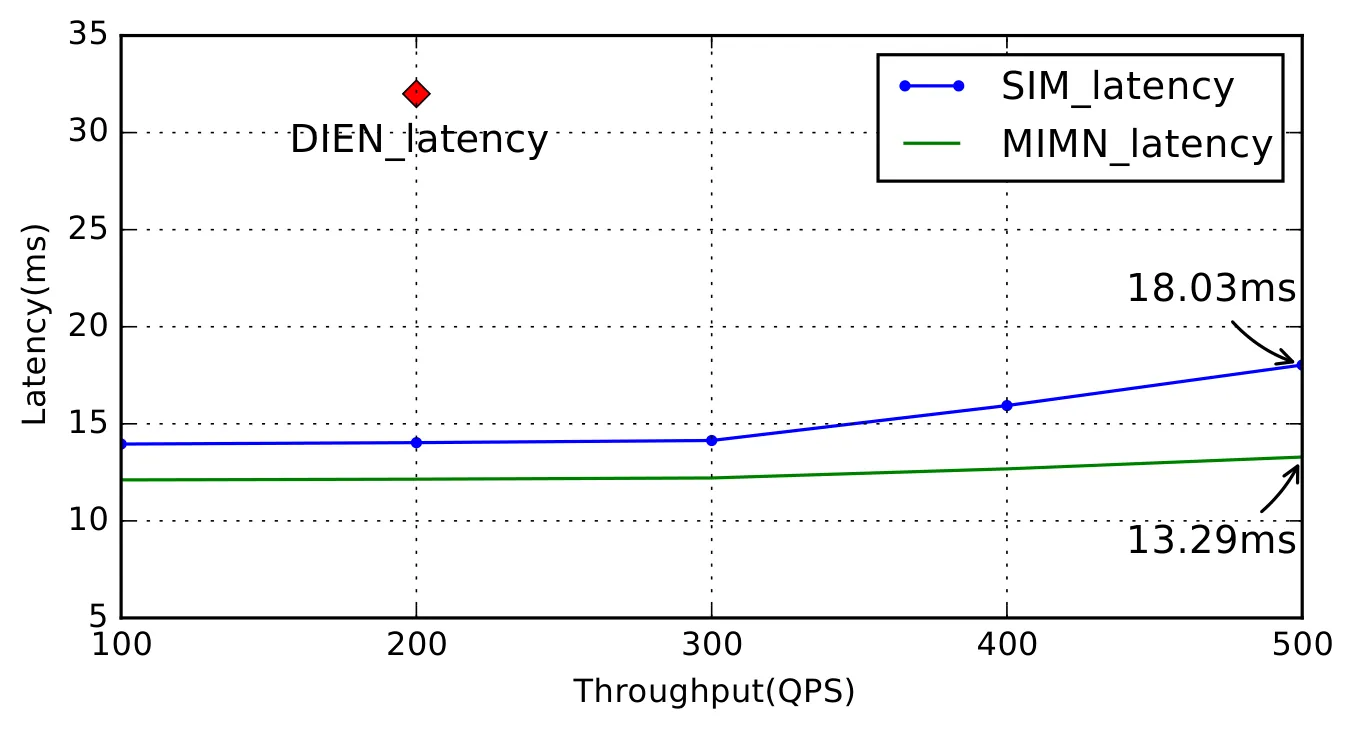
压测曲线直观定格了三代架构的物理极限:
- DIEN (length 1000):由于双层 GRU 的串行递归开销,单机吞吐刚过
200 QPS延迟即垂直起飞突破天际,根本无法在主流量存活; - MIMN (length 1000):依靠异步 UIC 旁路把在线计算简化为静态记忆槽读取,延迟曲线最平缓,但代价是牺牲了目标感知与千级以上的序列扩展性;
- SIM (length up to 54000):在处理长度高达对比基线 54 倍的终身序列时,依靠分布式 UBT 的前置 硬检索与百级 SBS 截断,在单机
500 QPS的满负荷高压下,平均响应延迟依然稳定在18.03ms(仅比 MIMN 多出约5ms的计算节点查表与多头注意力开销),稳稳守在30ms的工业级 SLA 安全线以内。
6. 跨代际横向对比:从 SIM 看现代推荐系统的演进坐标
将 2020 年的 SIM 与推荐系统演进史上的其他里程碑工作(包括经典双塔召回、本博客精读过的 Meta 2024 HSTU / Generative Recommenders 以及 Google 2023 Clippy 多任务训练稳定性方案)横向对照,能帮我们建立更立体的架构视野:
6.1 宏观漏斗(YouTube DNN)与微观特征漏斗(SIM)的同构性
经典的 YouTube DNN 确立了现代推荐系统的宏观服务漏斗:为了在千万级商品库中实现毫秒级推荐,先用低成本的双塔内积检索(ANN)把千万候选压缩至百级,再用重型精排网络(Ranking)对百级商品做多特征交叉。
SIM 的绝妙之处,在于把一模一样的漏斗降维哲学递归地嵌入到了单个候选商品的特征提取内部(微观序列漏斗):为了在单次精排打分中消化单个用户的数万条历史,先用低成本的 GSU(UBT 查表或 MIPS)把万级历史压缩至百级相关子序列 SBS,再用重型 ESU(多头目标注意力)对百级历史做精细加权。宏观召回解决的是“候选物品空间过大”,微观 SIM 解决的是“用户历史时间空间过长”,两者在系统方法论上殊途同归。
6.2 与 Meta HSTU(生成式推荐)及后续长序列演进的路线对比
随着算力基础设施的演进,工业界处理超长用户行为序列衍生出了两条既有差异又高度互补的技术路线:
| 对比维度 | 阿里 SIM 路线(两阶段检索过滤 + 局部注意力) | Meta HSTU / Generative Recommenders 路线(统一生成式序列转导) |
|---|---|---|
| 核心长序列哲学 | 先检索去噪、再局部精排:用 GSU 将 54000 序列裁至百级 SBS,仅对百级子集跑注意力 | 全序列端到端自回归转导:通过去除 Softmax 的点式归一化注意力与 Stochastic Length,直接在长达 8192 的序列上堆叠十余层自注意力 |
| 在推荐栈中的位置 | 作为传统异构 DLRM / CTR 精排模型内部的一个长期兴趣特征子模块 | 将数百个异构特征彻底拉平为单一交错序列 ,用生成式主干统一替代召回与精排 |
| 目标感知实现方式 | 候选商品 同时充当 GSU 的检索 Query 与 ESU 的 Target Attention Query | 候选商品集合作为序列末尾的掩码微批次(M-FALCON),复用共享前缀 KV 缓存并行交叉打分 |
| 基础设施重心 | 维护 22TB 分布式键值索引(UBT)与计算节点前置查表链路,在线算力开销极轻 | 依赖大规模 GPU 推理集群、定制 Jagged Tensor 算子与跨请求 Encoder KV Cache 调度 |
| 后续融合演进 | 启发了 ETA(SimHash 哈希检索)、SDIM(多哈希碰撞直接聚合)、TWIN(共享一二阶段目标注意力参数消除检索-精排目标不一致)等一系列两阶段长序列工作 | 现代超大规模排序正走向“SIM 式十万级前置快搜 + HSTU 式千级深层交叉”的双剑合璧 |
与此同时,当我们在现有 DLRM 精排模型中接入 SIM 长期兴趣分支、将模型总容量与稀疏/稠密特征交互复杂度推高后,如果进一步在顶层挂载点击(CTR)、转化(CVR)、加购、停留时长等多个业务头并尝试调大优化器学习率,往往会在多头共享层与独立塔交界处遭遇剧烈的梯度爆冲与死神经元问题——此时即可配合引入 Google Clippy 的多层梯度能量先验与相对无穷范数裁剪机制,构建“长序列高维特征输入 + 稳定大步长多目标优化”的完整工业排序底座。
7. 工程落地参考实现:UBT 构建、防穿越样本生成与三级合并
对于希望在自有 CTR 预估系统中落地 SIM 架构的工程团队,最核心的实战挑战在于打通“离线/近线 UBT 索引构建 → 防时间穿越训练样本拼接 → 在线三级存储实时检索”的数据闭环。以下给出一套可直接对标落地的参考实现与工程契约。
7.1 UBT 索引构建与严格防时间穿越(Anti-Time-Travel)的样本生成
在工业界落地 SIM 时,排名第一的致命事故是特征时间穿越(Data Leakage / Time Travel):如果在离线回放某次历史曝光日志(例如发生在周三中午 12:00 的曝光)以生成训练样本时,直接去查询了一棵包含了周三下午乃至周五行为的静态全量 UBT 索引,那么 GSU 捞出的子序列 SBS 里就会混入用户在本次曝光之后才发生的同类目点击!模型在训练中一旦偷看到这种未来信号,离线 AUC 会轻松暴涨几个百分点,但一推到线上就会瞬间崩盘。
因此,UBT 索引的每个节点不仅要存储行为明细,还必须保留精确的事件时间戳,并在离线样本生成时严格按每次曝光的物理发生时刻 before_time=exposure.exposed_at 做时间切片截断,现场计算相对时间间隔分桶:
from bisect import bisect_left

class UserBehaviorTreeSnapshot:
    """支持按曝光时刻严格防穿越检索的 UBT 索引参考实现"""
    def __init__(self, per_category_limit: int = 200):
        self.per_category_limit = per_category_limit
        # 结构: user_id -> category_id -> 按时间升序排列的行为列表 (便于二分截断)
        self._tree: dict[str, dict[str, list[dict]]] = {}

    def ingest_behavior(self, event: dict) -> None:
        user_bucket = self._tree.setdefault(event["user_id"], {})
        cat_bucket = user_bucket.setdefault(event["category_id"], [])
        cat_bucket.append({
            "item_id": event["item_id"],
            "category_id": event["category_id"],
            "behavior_type": event["behavior_type"],   # click / cart / pay
            "behavior_time": event["behavior_time"],   # unix timestamp (sec)
            "brand_id": event["brand_id"],
            "price_bucket": event["price_bucket"],
        })

    def finalize_sort(self) -> None:
        for categories in self._tree.values():
            for cat_id, events in categories.items():
                events.sort(key=lambda x: x["behavior_time"])

    def lookup_sbs(
        self,
        user_id: str,
        target_category_id: str,
        as_of_time: int,
        max_sbs_len: int = 100,
    ) -> list[dict]:
        """GSU Hard-search: 仅检索发生在 as_of_time 严格之前的同类目最近 K 条行为"""
        cat_events = self._tree.get(user_id, {}).get(target_category_id, [])
        if not cat_events:
            return []

        # 二分查找严格早于曝光时刻 as_of_time 的右边界,彻底杜绝未来信息穿越
        timestamps = [e["behavior_time"] for e in cat_events]
        cutoff_idx = bisect_left(timestamps, as_of_time)
        start_idx = max(0, cutoff_idx - min(max_sbs_len, self.per_category_limit))

        # 截取最近的 Top-K 条并按时间由近及远倒序返回
        valid_slice = cat_events[start_idx:cutoff_idx][::-1]
        return [
            {
                **b,
                "time_delta_bucket": bucketize_time_delta(as_of_time - b["behavior_time"]),
            }
            for b in valid_slice
        ]


def bucketize_time_delta(delta_seconds: int) -> str:
    """将曝光时刻与历史行为时刻的时间差 Δ_j 离散化为 ESU 时间间隔分桶"""
    if delta_seconds < 3600:
        return "lt_1h"
    if delta_seconds < 86400:
        return "1h_1d"
    if delta_seconds < 3 * 86400:
        return "1d_3d"
    if delta_seconds < 7 * 86400:
        return "3d_7d"
    if delta_seconds < 30 * 86400:
        return "7d_30d"
    return "gt_30d"
7.2 兼顾半年历史深度与分钟级新鲜度的三级 UBT 合并架构
在真实生产环境中,如果 22TB 的 UBT 索引每天只由离线 MapReduce / Spark 批量构建一次快照,那么用户在当天上午刚刚密集点击过的某类目商品,在下午的请求中就无法通过 UBT 被检索出来;反之,如果让十亿用户的 22TB 全量索引直接承受每秒百万级的实时流式随机写入,存储引擎的写放大与锁竞争又会导致查询尾延迟飙升。
成熟的工业落地通常采用三级存储归并架构,并在曝光请求打分时将在线实时检索出的 SBS 特征直接落盘到样本日志(Sample Logging on Serving),从根源上消灭离线与在线的特征不一致(Training-Serving Skew):
| UBT 存储层级 | 覆盖时间窗口 | 底层存储与更新机制 | 在线检索合并职责 |
|---|---|---|---|
| Session Buffer(会话级实时层) | 最近几分钟 ~ 1 小时 | Redis / 内存缓存,由客户端上报或 Flink 流式毫秒级写入 | 捕获当前会话内刚刚发生的同类目点击、加购,保证即时反馈灵敏度 |
| Incremental UBT(近线增量层) | 最近 1 小时 ~ 24 小时 | 小时级微批追加或 LSM-Tree 近线存储 | 填补每日全量离线快照生成完毕后到当前时刻之间的日内空白 |
| Historical UBT(离线全量底座) | 过去 1 天 ~ 180 天 | 每日离线批量构建的只读高压缩 Key-Key-Value 索引(22TB 量级) | 提供高吞吐、低成本、零锁竞争的跨月度终身行为底座 |
当计算节点收到请求时,对三级存储并行发起 (user_id, category_id) 查表,随后在内存中执行保序去重截断:
即可在 2ms~5ms 内拼出既包含三分钟前刚加购的同款、又涵盖五个月前换季收藏记录的完整百级子序列。
7.3 线上常见故障模式与监控大盘设计
将 SIM 推全上线后,工程团队应当在常规 CTR/RPM 业务大盘之外,针对两阶段搜索链路建立专门的健康度监控,重点防范以下四类高频线上故障:
- SBS 空命中率(
empty_sbs_rate)异常飙升:如果大量请求的 GSU 检索返回空列表,ESU 分支将退化为零向量输入。除检查近线 UBT 同步是否断流外,对于叶子类目颗粒度切分过细的长尾冷门商品,工程上可配置层级类目回退策略(Hierarchical Category Fallback)——当叶子类目level_3_cat检索命中不足 5 条时,自动向二级父类目level_2_cat扩召回并补齐。 - 重度用户/爬虫引发的 P99 延迟毛刺:部分批发商账号、比价爬虫或重度购物狂在单一热门大类(如女装连衣裙)下半年内可能累积数千条行为。必须在 UBT 写入端与计算节点读取端双重硬编码
per_category_limit(如严格截断最近100~200条),严禁将无上限列表透传给预测服务器。 - 长期历史喧宾夺主压制近期兴趣转移:当用户刚发生显著的短期意图切换,但推荐结果仍顽固推送数月前高频交互过的老类目时,需重点排查 ESU 中的时间间隔特征
time_delta_bucket是否因特征编号冲突而失效,并检查短期 DIEN 分支与长期 SIM 分支在顶层 MLP 处的梯度范数平衡。 - 第一阶段与第二阶段的相关性目标割裂:在 SIM 的 Soft-search 或多属性检索演进中,由于 GSU 与 ESU 各自维护了一套独立的投影参数,有时会出现“GSU 认为高分召回的行为,到了 ESU 注意力层权重却接近于零”的内耗现象。若在后续迭代中遇到此瓶颈,可进一步参考快手 TWIN(Two-stage Interest Network)的做法,让 GSU 直接复用并共享 ESU 多头目标注意力的投影矩阵与打分逻辑,实现两阶段检索标准与精排标准的完全同构。
8. 总结
回望阿里巴巴 SIM 的设计历程,它之所以能成为工业界超长用户行为序列建模的分水岭之作,核心在于它极其清醒地回答了“什么计算应该交给离线数据结构,什么计算应该留给在线神经网络”。
面对长达 54000 的终身行为序列,SIM 拒绝了用更笨重的循环网络或有损的静态记忆槽去硬吞全量噪声的纯算法执念,通过 GSU(基于 22TB 用户行为树的 类目硬检索) 与 ESU(带显式时间间隔编码的多头目标注意力) 的两级解耦,把万级序列的带宽与算力洪峰消解在了计算节点的查表瞬间,同时将 DIN 级别的目标感知精度毫无妥协地延伸到了半年前的历史深处。这种“先搜索降维提纯、再神经注意力精排”的软硬件协同范式,至今依然是大规模工业推荐系统挖掘用户全生命周期价值最坚实、最具性价比的工程基石。
参考资料
- Search-based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction (arXiv:2006.05639)
- SIM 论文 PDF 原文
- Deep Interest Network for Click-Through Rate Prediction (DIN, KDD 2018)
- Deep Interest Evolution Network for Click-Through Rate Prediction (DIEN, AAAI 2019)
- Practice on Long Sequential User Behavior Modeling for Click-Through Rate Prediction (MIMN, KDD 2019)
- Deep Neural Networks for YouTube Recommendations (RecSys 2016)
- Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations (HSTU, ICML 2024)
comments