在探讨推测解码(Speculative Decoding)时,学术界与工业界长期存在着一道隐秘的鸿沟:学术论文习惯在单请求(batch_size = 1)的空闲显卡上测试,默认“草稿模型单次提议的候选块越长、每轮验证接受的词元越多,推理加速比就越高”;但在真实的大规模在线推理集群(如 DeepSeek-V4 生产服务)中,为什么工程团队最初只敢开启单步多词元预测(MTP-1,即每次只猜 1 个草稿词元),却不敢轻易放开更长的多步草稿?
答案藏在高并发连续批处理(Continuous Batching)的物理边界里。当数十个用户请求在单张 GPU 上合批推理、且同时受制于严苛的单用户交互速率 SLA(例如 80~120 tok/s/user)时,目标模型的验证批处理容量(Target Verification Batch Capacity)是高度稀缺的全局共享资源。如果批内的每个请求都盲目塞入 6~7 个草稿词元,总验证批大小 就会瞬间膨胀数倍,直接把 GPU 从访存受限区(Memory-Bound)推入算力饱和悬崖(Compute-Bound),导致单步前向耗时急剧拉长。更糟糕的是,长草稿末尾往往掺杂着大量注定被拒绝的低置信度后缀(Draft Suffix)——用全批请求共同变慢的沉重代价去验证一堆废片,最终反而会拖垮整个集群的聚合吞吐!
针对这一核心系统矛盾,来自北京大学与 DeepSeek-AI 的研究团队(Xin Cheng、Xingkai Yu、Chenze Shao、Jiashi Li、Yunfan Xiong 等)在 2026 年发布了技术报告 DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation,并同步开源了完整的训练与评测框架 deepseek-ai/DeepSpec(及 Hugging Face 预训练权重如 dspark_qwen3_4b_block7)。DSpark 跳出了单纯比拼离线单步接受长度的局部视角,从草稿生成端(Draft Better)与目标验证端(Verify Smarter)双向重构了高并发推测解码的设计范式。
1. 核心设计哲学:如何同时攻克“后缀衰减”与“批容量膨胀”?
在深入数学推导与 DeepSpec 源码之前,我们先提炼出 DSpark 贯穿模型架构、训练损失与在线调度的 4 项核心设计哲学:
- 并行主干保容量与 延迟,轻量半自回归顺序头治“后缀衰减”(Parallel Backbone + Lightweight Sequential Head for Suffix Consistency):草稿模型设计长期困在“自回归派”与“并行派”的两难中——自回归草稿(如 Eagle3)逐词串行生成,块内前后连贯但耗时呈 增长,迫使网络只能做得很浅(单层),牺牲了最关键的首词预测能力;纯并行草稿(如 DFlash)可以堆叠 5 层深网络并在 步内同时吐出全部候选位置,但由于位置 看不到位置 实际采样出了什么词,遇到多分支语境时极易拼出语法断裂的后缀,导致条件接受率随位置后移陡峭滑坡(即后缀衰减,Suffix Decay)。DSpark 选择在 5 层并行 Transformer 主干之上嫁接一个极轻量的低秩顺序头(Markov / RNN Head):主干一次性并行算出全局隐藏状态与基础 logits,顺序头仅用占总耗时不到
1%的矩阵向量乘逐步注入前序采样词元依赖,以几乎零延迟代价根治了后缀冲突。 - 拒绝“草稿模型自嗨概率”,让置信度头直接拟合分布重叠面积并做后验校准(Predict Distribution Overlap with Post-Hoc Calibration):要裁剪低价值草稿后缀,首先得知道每个位置有多大把握通过目标模型验证。传统做法直接使用草稿模型自身的词表最大概率 ,但小容量的草稿模型极易过度自信。DSpark 从拒绝采样的数学本质出发,让专门的置信度头(Confidence Head)直接拟合草稿分布 与目标分布 的真实重叠面积 ;同时考虑到前缀存活率是逐位置置信度的连乘 ,任何微小的单步偏差都会在连乘中指数级放大,DSpark 引入了针对累积乘积的后验校准(Post-Hoc Calibration),将期望校准误差(ECE)死死压在
1%左右。 - 把目标模型批容量视为稀缺预算,耦合硬件吞吐曲线 做跨请求贪心调度(Hardware-Aware Batch-Global Prefix Scheduling):一个置信度为
0.5的草稿词元到底该不该送去验证?这不存在脱离系统负载的标准答案:当夜间集群空闲(小批大小 )时,多验几个词元几乎不增加目标模型耗时,当然应该激进送验;当高峰期算力饱和(大批大小 )时,每增加一个验证词元都会显著拉低每秒执行步数 。DSpark 将硬件离线压测出的 查找表直接乘入期望接受词元数 ,构造全局聚合吞吐目标 ,并在整个并发批次的所有请求间按前缀存活率 从高到低贪心分配验证配额。 - 用位置指数衰减的 分布对齐损失匹配前缀存活物理定律(Position-Decayed Distribution Alignment):在推测解码验证中,只有从块首开始的连续匹配前缀才会被接受——一旦第 1 个词元被拒,后面第 2 到第 个词元哪怕全猜对也会被整块丢弃。为了匹配这一严酷的物理定律,DSpark 在训练损失中引入位置指数衰减权重 优先保障前排位置梯度,并将优化重心放在直接决定接受率的分布 距离 (权重
0.9)而非传统硬标签交叉熵(权重0.1)上。
Target Anchor Token D + Multi-Layer Target Hidden States
  ──► [Draft Better] 5-Layer Parallel Backbone (O(1) non-causal forward)
        Produces hidden states h_{1:γ} & base logits U_{1:γ}
  ──► Lightweight Sequential Head (VanillaMarkov / GatedMarkov / RNNHead)
        Sequentially updates Ũ_j = U_j + b(x̂_{j-1}, h_j) ──► Samples draft E F G H
  ──► Calibrated Confidence Head ──► Prefix survival probabilities a_{r,j} = ∏_{i≤j} c_{r,i}
  ──► [Verify Smarter] Hardware-Aware Global Scheduler
        Maximizes Θ = τ(ℓ) · SPS(B(ℓ)) across all requests in batch ──► Prunes low-value suffix H
  ──► Target Model Parallel Verification on surviving prefix E F G
2. DSpark 整体架构与半自回归草稿生成机制
2.1 Draft Better + Verify Smarter 的完整解码周期
在标准自回归解码中,每生成一个词元都必须完整搬运一遍目标模型数百 GB 的权重,访存带宽成为制约单用户交互速率(TPS)的刚性瓶颈。推测解码通过“小模型快步提议 + 大模型单步并行验证 + 修正拒绝采样”打破串行依赖,在数学上严格保证输出分布与目标模型 100% 无损一致。
下图展示了 DSpark 在单轮推测解码中的三阶段闭环工作流:
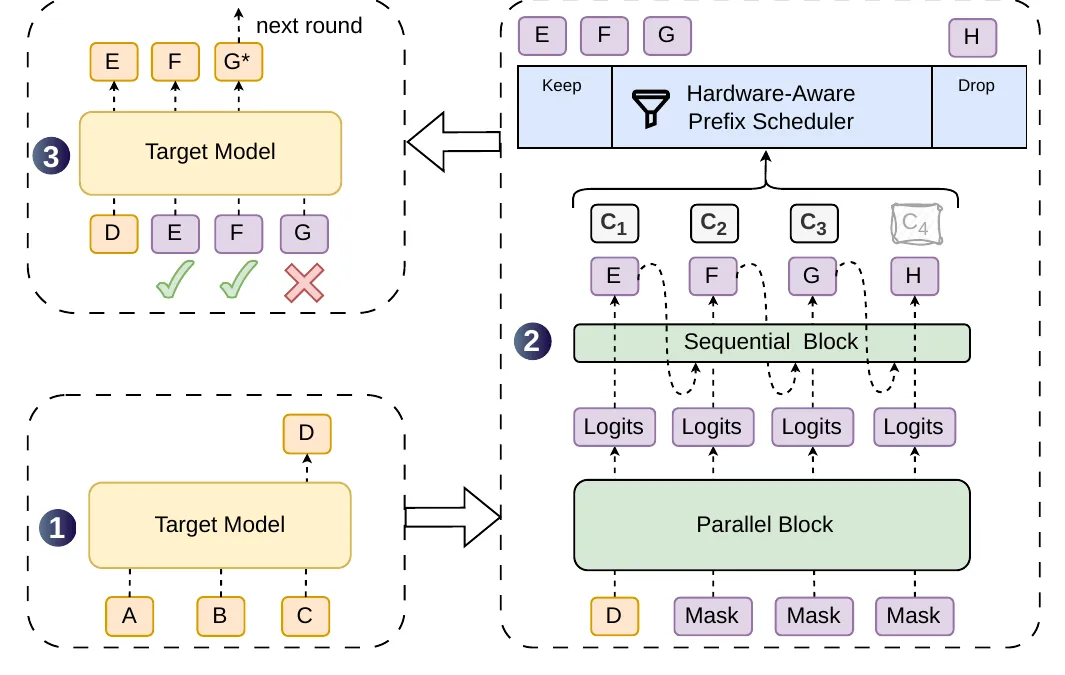
沿着图中的数据流向,单次解码迭代按如下三步推进:
- 目标锚点生成(Anchor Generation):给定上下文
A B C,目标模型在上一轮验证结束时真实推进并采出锚点词元D(同时抽出目标模型内部多个深浅层的隐藏状态特征),作为本轮草稿提议的确定性锚点。 - 半自回归草稿提议(Drafting Phase — Draft Better):将锚点词元
D与代表未知位置的掩码占位词元(Mask Tokens)拼成一个长度为 的块,送入 DSpark 的 5 层并行主干网络(Parallel Block),在单次前向传播中同时算出全部候选位置的隐藏表征 与基础词表对数几率 ;紧接着,极轻量的顺序块(Sequential Block)从左到右依次采样出候选序列E F G H,并由置信度头同步打出每个位置的接受置信度 。 - 硬件感知前缀裁剪与并行验证(Verification Phase — Verify Smarter):全局调度器综合当前并发批次所有请求的置信度序列与硬件吞吐表 ,判定末尾词元
H的预期存活收益抵不上它占用的批容量成本,当场将H裁除,仅把高价值前缀E F G送入目标模型并行验证;最终目标模型验证通过E和F,在第 3 个位置拒绝G并由残差分布重采样出正确词元G*,随即以G*为新锚点进入下一轮循环。
2.2 为什么需要半自回归?从数学分解看后缀衰减的根源
为什么纯并行的草稿模型(如 DFlash)越往后猜准确率掉得越快?我们可以从联合分布的条件分解中一眼看穿症结所在。
假设当前上下文为 ,我们需要提议未来 个候选词元 :
- 自回归草稿(如 Eagle3) 严格遵循链式法则,第 步的预测显式建立在前 步已经采样出的具体词元之上: 这保证了块内词元之间的强语法一致性,但代价是必须串行跑 次完整的前向传播。为了不让草稿耗时反客为主,Eagle3 只能把网络压到极浅(通常仅 1 层),导致决定全块生死的第 1 个位置预测容量不足。
- 纯并行草稿(如 DFlash) 强行做了条件独立假设,用单次前向传播同时预测所有位置的边缘分布: 举例来说,当上文是“这部电影的剧情非常”时,后续既可以接“紧凑”(2 个字)也可以接“扣人心弦”(4 个字)。由于位置 1 和位置 2 在并行采样时互不通气,位置 1 很可能抽中了第一条分支的“紧”,而位置 2 却抽中了第二条分支的“人”,拼出毫无意义的错乱词组“紧人”——这就是并行草稿模型在位置 2 之后条件接受率断崖式下跌(Suffix Decay)的根本原因。
DSpark 的半自回归生成(Semi-Autoregressive Generation)用“重主干并行 + 轻头部串行”巧妙化解了这一矛盾。首先,5 层非因果(is_causal=False)并行 Transformer 主干一次性算出全部 个位置的上下文隐藏表征与基础 logits:
随后,在从第 步到第 步采样块内词元时,引入一个极轻量的局部顺序偏置函数 ,根据前一步刚刚落定的采样词元 实时修正当前步的词表分布:
因为重量级的跨序列注意力计算已经在 ParallelBackbone 中一次性并行完成了,顺序循环里的 只需要做一次嵌入查表与低秩投影(秩 ),既让位置 明确感知到了前序分支选择,又把顺序依赖的额外耗时压制在了微不足道的 0.6%~1.3%。
2.3 DeepSpec 源码剖析:三种顺序修正头的实现细节
在开源仓库 deepspec/modeling/dspark/markov_head.py 中,作者提供了三种复杂度递增的半自回归顺序头实现,分别对应一阶词表转移、上下文门控转移以及块内全前缀循环记忆:
源码类名 (markov_head.py) | 建模依赖范围 | 偏置项 的核心数学形式 | 适用场景与特点 |
|---|---|---|---|
VanillaMarkov | 一阶马尔可夫(仅看 ) | 极简最快(默认配置 markov_rank=256),纯靠查表与两层线性映射修正双词搭配 | |
GatedMarkovHead | 上下文门控一阶转移(结合 与 ) | 利用主干当前隐藏状态 动态门控转移特征,上下文适应性更强 | |
RNNHead | 块内全前缀循环状态(聚合 ) | 维护块内隐状态 ,适合修正在更长草稿块(如 )上的多步长程依赖 |
对照 markov_head.py 与 draft_ops.py 的核心实现,我们可以清楚看到 DSpark 是如何实现“训练时全并行、推理时轻串行”的:
# 提炼自 deepspec/modeling/dspark/markov_head.py
class VanillaMarkov(nn.Module):
    def __init__(self, vocab_size: int, rank: int = 256):
        super().__init__()
        # W_down 充当低秩词元转移嵌入表,W_up 投影回词表空间叠加到 base_logits
        self.down_proj = nn.Embedding(vocab_size, rank)
        self.act = nn.SiLU()
        self.up_proj = nn.Linear(rank, vocab_size, bias=False)

    def apply_block_logits(self, base_logits: torch.Tensor, prev_tokens: torch.Tensor) -> torch.Tensor:
        """训练阶段 (Teacher Forcing):已知真实前序词元 prev_tokens,整块一次性并行计算修正 logits"""
        # base_logits: [B, gamma, V], prev_tokens: [B, gamma]
        low_rank_state = self.act(self.down_proj(prev_tokens))   # [B, gamma, rank]
        delta_logits = self.up_proj(low_rank_state)              # [B, gamma, V]
        return base_logits + delta_logits                        # 位置 0 (锚点后首词) 通常掩码不加偏置

    @torch.inference_mode()
    def sample_block_tokens(self, base_logits: torch.Tensor, temperature: float = 0.0) -> torch.Tensor:
        """推理阶段:在长度为 gamma 的轻量循环内逐位置注入上一步采样结果"""
        bsz, gamma, _ = base_logits.shape
        sampled_tokens = torch.empty((bsz, gamma), dtype=torch.long, device=base_logits.device)

        # 第 0 个候选位置直接由并行主干的 base_logits[:, 0] 采样决定
        sampled_tokens[:, 0] = sample_from_logits(base_logits[:, 0], temperature)

        # 第 1 到 gamma-1 个位置:用刚采出的 sampled_tokens[:, j-1] 修正当前步 logits
        for j in range(1, gamma):
            prev_tok = sampled_tokens[:, j - 1]
            delta_j = self.up_proj(self.act(self.down_proj(prev_tok)))
            adjusted_logits_j = base_logits[:, j, :] + delta_j
            sampled_tokens[:, j] = sample_from_logits(adjusted_logits_j, temperature)

        return sampled_tokens
注意看上面这段代码的精妙之处:在训练阶段,由于真实的目标词元序列是已知的(Teacher Forcing),apply_block_logits() 根本不需要跑循环,直接把整块真实前序词元 prev_tokens 喂给 down_proj,在一个张量算子里并行算出所有位置的修正后分布 ,训练吞吐与纯并行模型完全一致!只有在推理采样阶段,sample_block_tokens() 才执行一个仅包含 Embedding -> SiLU -> Linear 的 步微循环。
3. 置信度预测与硬件感知前缀调度器
3.1 为什么置信度头要直接拟合分布重叠面积?
有了高质量的候选块 ,下一步是决定把前多少个词元送交目标模型验证。如果直接拿草稿模型采样时的最大概率 当作置信度,会遇到两个严重问题:第一,草稿模型容量有限,在知识盲区依然可能输出极尖锐的错误分布(高置信度幻觉);第二,在非零温度采样(temperature > 0)下,即使草稿分布和目标分布都很平坦( 很低),只要两个分布形状完全重合,采样出的词元依然有 100% 的概率被目标模型接受!
回顾推测解码拒绝采样的经典定理:在位置 上,草稿模型按分布 采样出的词元被目标模型(分布为 )无条件接受的期望概率(Expected Acceptance Rate),在数学上严格恒等于两个离散概率分布的重叠面积(即总变差距离 Total Variation Distance 的补集):
因此,在 deepspec/modeling/dspark/loss.py 的 _compute_accept_rate_3d() 中,DSpark 直接用训练时的目标 logits 与草稿修正后 logits 算出真实的分布重叠度 (并通过 .detach() 阻断向草稿主干回传梯度),将其作为软标签来监督专门的二分类置信度预测头:
当开启 confidence_head_with_markov=True 时,置信度头同时接收主干隐藏表征 以及当前步实际采出的词元对 。更进一步,由于目标模型验证只保留从头开始的连续匹配前缀,第 个请求的第 个候选位置最终能够存活下来的连续前缀存活概率(Prefix Survival Probability)是前 步条件接受概率的连乘积:
连乘操作对系统性偏差极度敏感:假设单步置信度存在仅仅 +5% 的乐观高估(例如真实为 0.80,预测为 0.85),到了第 6 个位置,连乘后的预测存活率()就会比真实存活率()虚高整整 44%!为此,deepspec/eval/dspark/confidence_head.py 中的 ConfidenceHeadRecorder 不仅追踪单步误差 confidence_abs_error,还专门监控累积乘积偏差 confidence_cumprod_bias,并在上线前通过温度缩放等后验校准手段将连乘可靠性曲线拉回对角线。
3.2 硬件感知前缀调度算法推导
拿到了当前并发批次内 个活跃请求经过校准的前缀存活率矩阵 (满足单调递减性质 ),调度器该如何在微秒级时间内为每个请求裁定最优的送验前缀长度 ?
下图展示了论文提出的硬件感知前缀调度算法(Hardware-Aware Prefix Scheduler):
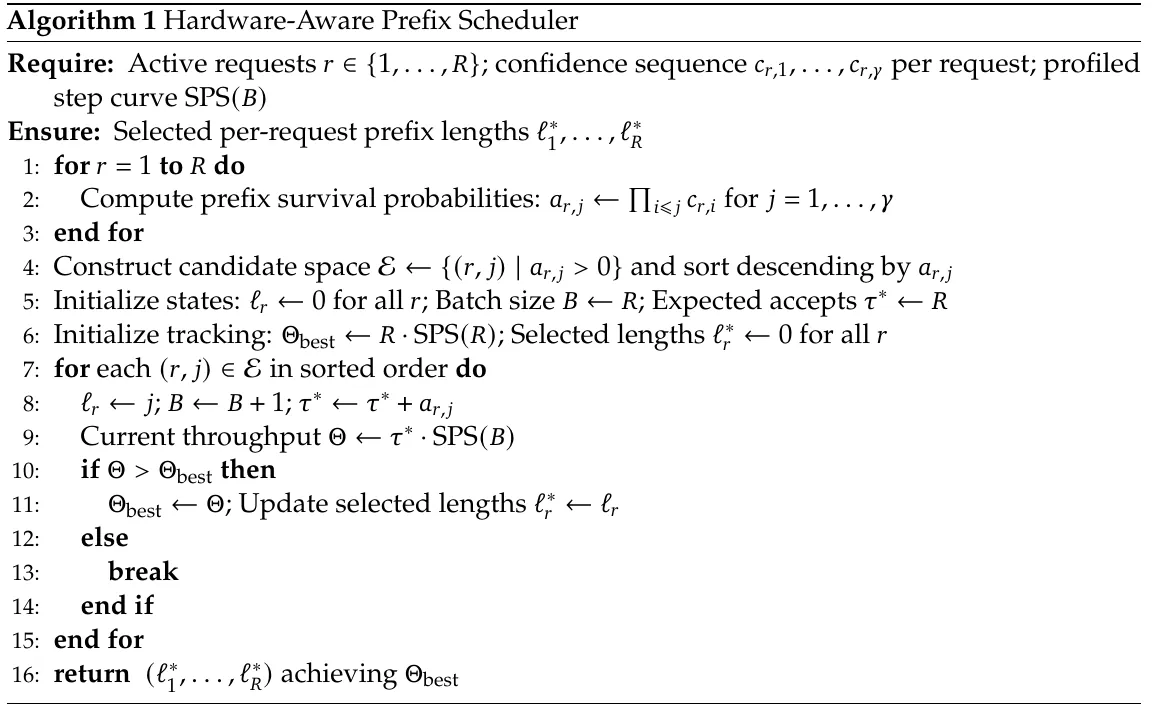
我们来一步步推演这个组合优化算法背后的精妙数学逻辑:
- 定义总验证批大小 (系统成本):如果调度器为第 个请求保留了前 个草稿词元送交目标模型验证,加上每个请求必定携带的 1 个基础锚点词元,目标模型在本轮前向传播中需要并行验证的总词元数(Total Verification Batch Size)为:
- 定义本轮期望产出词元数 (单步收益):根据前缀存活概率 ,第 个请求在本轮验证后期望产出的有效词元数为 (锚点必定产出 1 个新词元,后续第 个位置以概率 贡献 1 个有效词元)。因此,全批请求在本轮验证中的期望总产出词元数为:
- 耦合硬件吞吐曲线 构造全局目标 :设目标模型推理引擎在总词元批大小为 时每秒能够完成的验证步数(Step-Per-Second,由引擎在目标 GPU 上离线压测建表获得)为 。那么,整个服务集群的期望聚合输出吞吐(Expected Aggregate Throughput,单位:有效 tok/s)就是“每步期望产出词元数 ”与“每秒执行步数 ”的乘积:
- 利用单调性将指数级搜索化简为全局排序贪心:要在 种长度组合中找到令 最大的 ,暴力搜索是不可行的。但注意到:每多送验任意一个候选词元 ,总批大小 固定增加 (即硬件减速代价完全相同),而期望产出 则增加 !因此,在任何给定的总验证预算 下,要想让 最大,必然应该优先接纳全批所有请求中 最大的那些位置;又因为每个请求内部的 随位置 天然单调递减,按 从大到小全局贪心挑选时,同一个请求的前序位置 必定会先于后序位置 被选中,自动满足了前缀连续性约束!
于是,整个调度算法被化简为极其优雅的五步线性扫描:
- 初始化每个请求 ,初始总批大小 ,初始期望产出 ,初始最优吞吐 ;
- 将全批所有请求的全部候选位置 按前缀存活率 从高到低全局排序;
- 依次遍历排序后的候选词元 ,试探将其纳入验证集:令 ,,查表算出此时的聚合吞吐 ;
- 记录整个扫描过程中令 取得最大值的截断点,直接返回对应的最优前缀长度向量 。
3.3 动态负载调度为何能碾压静态阈值?
把上述贪心算法放进真实的在线流量潮汐中,就能明白它相比固定阈值截断(例如写死 confidence_threshold = 0.7)的降维打击优势:
| 集群实时并发负载状态 | 硬件曲线 的局部斜率特征 | 多验一个低置信词元的机会成本 | 硬件感知调度器的自适应行为 |
|---|---|---|---|
| 低并发闲时(Memory-Bound 访存受限区) | GPU 算力大量闲置, 从 16 增加到 64 时 几乎持平不降 | 趋近于 0(顺手多算几个词元近乎免费) | 自动放宽准入底线,将低置信度的长草稿后缀也纳入验证,全力拉高单步接受长度 |
| 中等并发平峰(过渡折点区) | 开始随 增大而出现明显斜率下滑 | 中等(需要权衡边际命中率与全批降速) | 跨请求按需调配:把宝贵的验证配额精准倾斜给高确定性的代码/数学请求(如保留 6 个词元),同时果断砍掉闲聊请求的发散后缀(仅保留 1~2 个词元) |
| 高并发早晚高峰(Compute-Bound 算力饱和区) | GPU 算力彻底打满, 每增加一点都会导致 剧烈下跌 | 极高(一个废词元会拖慢同批几十个用户的响应) | 激进收缩全批验证预算,仅放行把握极高(如 )的首词元,平稳退化至类 MTP-1 模式以死保集群总吞吐与 SLA |
4. 联合训练目标与 DeepSpec 工程管线剖析
4.1 位置指数衰减与分布 L1 对齐损失
在训练 DSpark 草稿模型时,应该用什么样的损失函数去引导它的参数更新?如果我们打开 deepspec/modeling/dspark/loss.py 中的 compute_dspark_loss(),会看到一套极具针对性的三元联合损失设计。
对于块内的第 个候选位置(),代码同时计算两项生成损失:
- 词元级硬标签交叉熵损失 ,提供基础的正确词元锚点;
- 全词表概率分布 距离损失 。
为什么要把 的权重设得高达 0.9,而把传统蒸馏最常用的交叉熵 权重压低到仅有 0.1?因为前文公式已经证明,推测解码的期望接受率严格等于 ——最小化草稿分布与目标分布的 距离,在数学上100% 等价于直接最大化推测解码的验证通过率!
不仅如此,由于第 0 个位置一旦被拒,后续第 1 到 个位置的所有努力都会付诸东流,草稿模型有限的参数容量绝不能平均主义地分摊给所有位置,而必须优先确保前排位置极度精准。为此,compute_dspark_loss() 显式引入了位置指数衰减权重(Position-wise Exponential Decay Weight):
对照 config/dspark/dspark_qwen3_4b.py 与 loss.py 的核心实现,我们可以一目了然地把握各超参数的协作关系:
# 提炼自 deepspec/modeling/dspark/loss.py 与 config/dspark/dspark_qwen3_4b.py
def compute_dspark_loss(
    draft_logits: torch.Tensor,      # [B, gamma, V] 经 Markov 头修正后的草稿 logits
    target_logits: torch.Tensor,     # [B, gamma, V] 目标模型真实 logits
    target_tokens: torch.Tensor,     # [B, gamma] 目标模型自举采样的真实 token ID
    conf_logits: torch.Tensor,       # [B, gamma] 置信度头输出的未激活 logit
    ce_loss_alpha: float = 0.1,      # λ_CE = 0.1
    l1_loss_alpha: float = 0.9,      # λ_L1 = 0.9 (主导项:直接最大化接受率 1 - 0.5 * ||p - q||_1)
    confidence_head_alpha: float = 1.0,
    loss_decay_gamma: float = 4.0,   # γ_decay = 4.0:位置越靠前,梯度权重呈指数级放大
) -> dict[str, torch.Tensor]:
    gamma = draft_logits.size(1)
    device = draft_logits.device

    # 1. 计算草稿分布 q 与目标分布 p,以及逐位置真实接受率软标签 α = 1 - 0.5 * ||p - q||_1
    p_probs = F.softmax(target_logits.float(), dim=-1)
    q_probs = F.softmax(draft_logits.float(), dim=-1)
    l1_dist_per_pos = torch.abs(p_probs - q_probs).sum(dim=-1)          # [B, gamma]
    true_accept_rate = (1.0 - 0.5 * l1_dist_per_pos).clamp(0.0, 1.0)    # [B, gamma]

    # 2. 计算逐位置 CE 损失与位置指数衰减权重 w_j = exp(-j / 4.0)
    ce_per_pos = F.cross_entropy(
        draft_logits.transpose(1, 2).float(), target_tokens, reduction="none"
    )                                                                    # [B, gamma]
    pos_indices = torch.arange(gamma, device=device, dtype=torch.float32)
    pos_weights = torch.exp(-pos_indices / loss_decay_gamma)            # [gamma]
    pos_weights = pos_weights / pos_weights.sum()

    # 3. 聚合加权生成损失 + 置信度头 BCE 损失 (使用 detach() 防止置信度头反向干扰草稿分布)
    weighted_ce = (ce_per_pos.mean(dim=0) * pos_weights).sum()
    weighted_l1 = (l1_dist_per_pos.mean(dim=0) * pos_weights).sum()
    conf_loss = F.binary_cross_entropy_with_logits(
        conf_logits.float(), true_accept_rate.detach()
    )

    total_loss = ce_loss_alpha * weighted_ce + l1_loss_alpha * weighted_l1 + confidence_head_alpha * conf_loss
    return {"loss": total_loss, "ce_loss": weighted_ce, "l1_loss": weighted_l1, "conf_loss": conf_loss}
以默认的 loss_decay_gamma = 4.0 计算,块首位置 的权重为 ,而到了第 7 个位置(),权重自然衰减为 ——前排位置获得了超过末尾位置 4.5 倍的梯度优先级。
4.2 DeepSpec 训练管线与多层隐藏状态融合架构
为了喂饱 5 层并行草稿主干,DeepSpec 的模型与数据管线做了两项关键的工程设计:
- 目标模型自举数据生成与多层 Target Cache:如果直接拿开源指令微调数据集里的原始人类回复去训练草稿模型,草稿模型只能拟合“人类离线语料的用词习惯”,无法对齐“目标模型在线解码的真实概率分布”,上线后必然面临严重的分布失配。因此,
scripts/data/管线首先从源数据集(如mlabonne/open-perfectblend)切出提示词,随后拉起 SGLang / vLLM 推理服务,用目标模型自身自举生成全部回复序列,并抽出目标模型在均匀分布的 5 个深浅层(以Qwen/Qwen3-4B配置为例,target_layer_ids = [1, 9, 17, 25, 33])上的隐藏状态落盘构建离线特征库(全量预存约需38TB磁盘空间,这也是官方直接在 Hugging Face 发布训练好权重以方便社区开箱评测的原因)。 - 深浅层隐藏状态特征注入:在
deepspec/modeling/dspark/qwen3/modeling.py中,DSpark 跳出了仅读取目标模型最后一层输出的局限,将抽取出的 5 个深浅层隐藏状态拼接后通过线性层降维融合,作为极强的前置上下文表征注入 5 层并行草稿主干(num_draft_layers = 5,草稿块大小block_size = 7,掩码占位符mask_token_id = 151669),开启bf16混合精度与torch.compile算子融合进行分布式高效训练。
5. 离线实验精读:接受长度、后缀衰减与校准度实证
5.1 四大目标模型、九大基准的无截断主实验对比
为了纯粹检验“Draft Better”(半自回归草稿生成)本身的建模实力,作者在主实验中特意关闭了动态置信度截断,让自回归代表 Eagle3、纯并行代表 DFlash 与半自回归的 DSpark 在完全相同的固定提议长度下,跨越 4 个主流开源目标模型(Qwen3-4B、Qwen3-8B、Qwen3-14B、Gemma4-12B)和 3 大类 9 个评测基准(数学 GSM8K / MATH500 / AIME25、代码 MBPP / HumanEval / LiveCodeBench、开放对话 MT-Bench / Alpaca / Arena-Hard-v2)正面比拼每轮平均接受长度 :
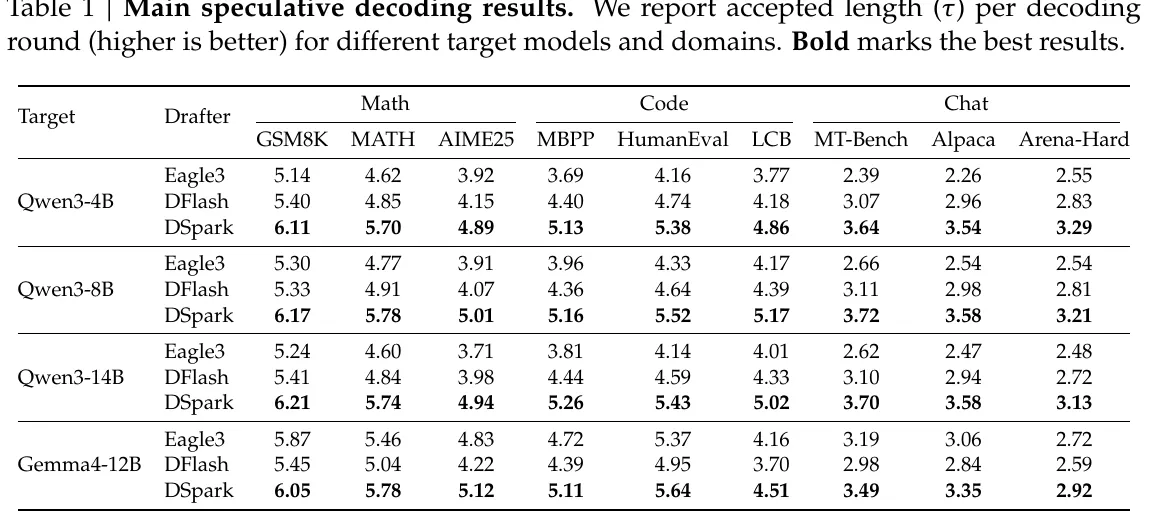
细读这张全景评测表,可以提炼出三条极其清晰的实验规律:
- DSpark 实现全模型、全领域大满贯领跑:在全部 4 个目标模型与全部 9 个评测集上,DSpark 的平均接受长度 无一例外夺冠。例如在
Qwen3-4B的 GSM8K 数学推理上,DSpark 高达6.11(显著甩开 DFlash 的5.40与 Eagle3 的5.14);在更具挑战性的 Alpaca 开放对话上,DSpark 达到3.54(对比 DFlash 的2.96与 Eagle3 的2.26,相对 Eagle3 提升了+56.6%)。 - 下游任务的熵值决定了推测解码的物理天花板:横向对比三大任务领域可以发现,数学(Math)与代码(Code)存在极强的公式推演与语法格式约束,目标分布高度尖锐(低熵),各模型的平均接受长度普遍高达
4.5~6.5;而开放式闲聊(Chat)允许无数种同义句式与发散表达,目标分布平坦(高熵),平均接受长度自然回落至2.2~3.8。这进一步说明了为什么在线服务面对混合流量时,绝不能给代码请求和闲聊请求分配同样长的验证预算! - 半自回归对“浅层自回归”与“纯并行”的双重超越:DSpark 胜过 Eagle3,是因为 5 层并行主干提供了远超浅层自回归网络的特征提取容量;DSpark 胜过同为 5 层主干的 DFlash,则是因为轻量顺序头成功修补了块内多步采样的语义断裂。
5.2 拆解“后缀衰减”:逐位置条件接受率曲线
为了给上述第三点结论提供无可辩驳的微观证据,作者需要将“第 个位置因为自身猜错而被拒”与“第 个位置因为前 个位置先挂了而被连坐作废”剥离开来。为此,下图统计了逐位置条件接受率(Position-wise Conditional Acceptance Rate)——即严格限定在前 个位置全部通过目标模型验证的条件下,单独考察第 个位置被目标模型接受的概率:
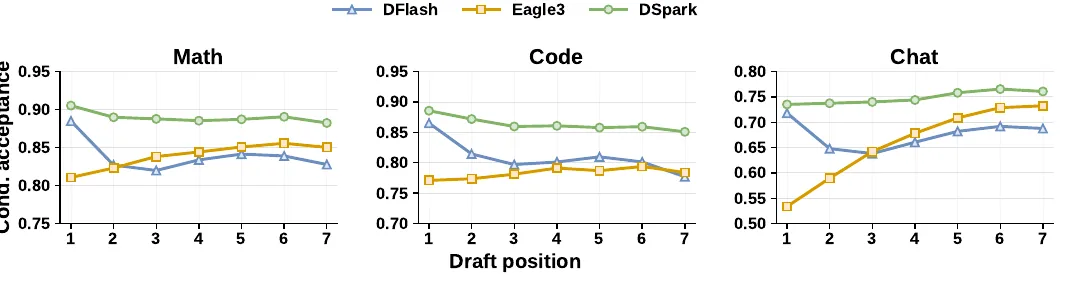
这张图堪称理解草稿模型动力学的最佳切片:
- 看蓝色的 Eagle3(自回归):由于网络太浅,它在决定生死的 Position 1 起点最低;但一旦前面的词元侥幸通过验证,随着已采样前缀不断收窄后续语法分支,它在 Position 2 到 Position 6 的条件接受率非但没有下降,反而稳中有升!
- 看橙色的 DFlash(纯并行):凭借 5 层深主干,它在 Position 1 起点极高,大幅领先 Eagle3;但从 Position 2 开始,由于各位置盲目独立采样、互不知情,条件接受率沿着一条陡峭的下坡路一路狂跌——这就是触目惊心的后缀衰减(Suffix Decay)。
- 看红色的 DSpark(半自回归):它在 Position 1 完美继承了 5 层并行主干的高起点,随后在 Position 2 到 Position 6 依靠轻量顺序头注入局部采样依赖,硬生生把 DFlash 的陡峭衰减斜率拉平,在整条位置轴上形成了对 DFlash 的全方位包络压制!
5.3 主干深度、提议块长度与顺序头延迟开销消融
有人可能会问:既然 DFlash 会出现后缀衰减,我把纯并行网络堆得更深一点,能不能靠蛮力消除后缀衰减?顺序头虽然好,把块拉长到 16 个词元时会不会拖慢速度?接下来的两组消融实验直接给出了定量回答:
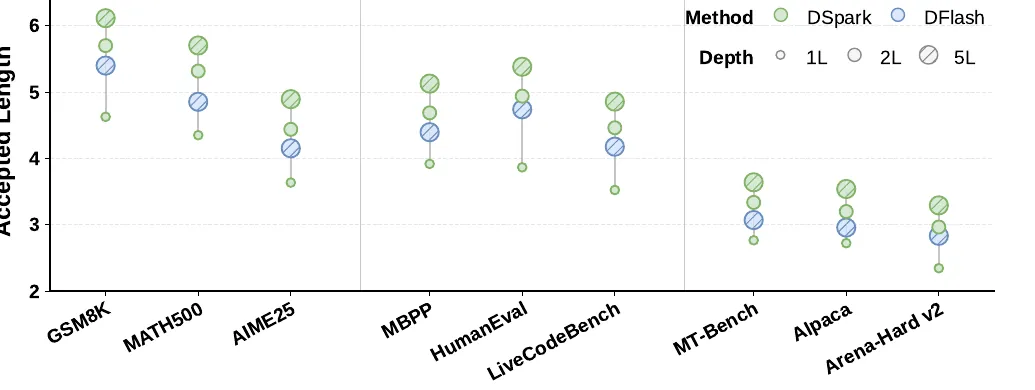
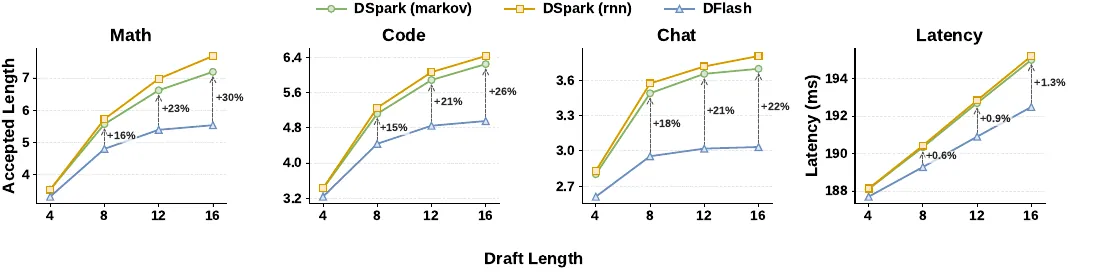
- 结构缺陷无法靠盲目堆层弥补:在深度消融(对比 1 层、2 层与 5 层主干)中,仅仅使用 2 层主干的 DSpark(
DSpark-2),其平均接受长度就已经全面超越了使用 5 层主干的纯并行 DFlash(DFlash-5)!这证明多分支语境下的采样冲突是条件独立假设带来的本质结构缺陷,引入一个几百万参数的低秩 Markov 顺序头,比硬堆三层完整的 Transformer 块还要有效得多。 - 块越长优势越大,且额外延迟不足
1.3%:在提议长度扩展实验中,当草稿块大小从4逐步拉长到16时,纯并行 DFlash 的增长迅速趋于平缓,而 DSpark 凭借块内顺序修正持续拉开身位;同时,最右侧的硬件耗时分解柱状图显示,在块长达 8~16 的情况下,顺序头逐步采样带来的额外延迟开销仅占单轮耗时的0.6%至1.3%,在工程上几乎等同于免费午餐。
5.4 置信度阈值扫描与后验校准可靠性验证
视线转向验证端(Verify Smarter),我们来检验置信度预测头的成色:它能否在不误伤正确词元的前提下精准揪出注定被拒的废词元?校准前后的概率到底准不准?
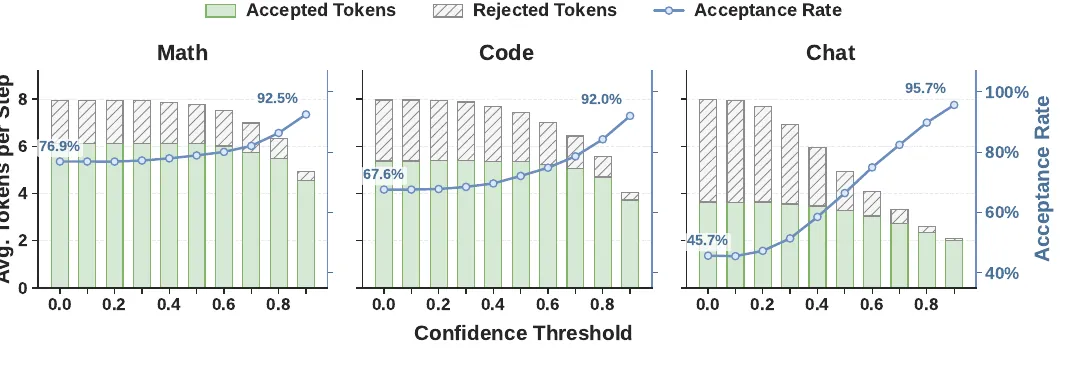
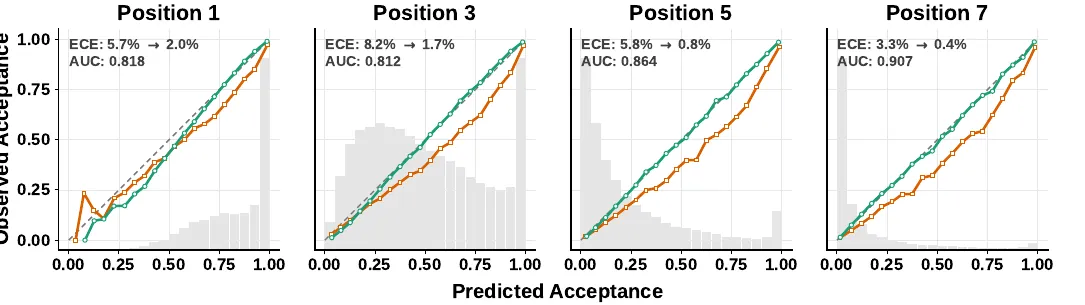
- 精准砍掉橙色废片,保全绿色有效产出:在置信度阈值扫描图中,随着静态截断阈值从
0.0(全量送验)逐步上调至0.7,代表被目标模型拒绝词元数的橙色柱子被削去了大半,而代表实际接受词元数的绿色柱子几乎纹丝不动,使得目标模型的有效验证命中率(Acceptance Rate 折线)一路高歌猛进。 - 后验校准将 ECE 压至
1%级别:在 Alpaca 可靠性图(Reliability Diagram)中,未经校准的原始置信度头(Raw,蓝色曲线)虽然具备优秀的排序区分能力(AUROC 高达0.81~0.90),但整条曲线落在理想对角线下方,存在3%~8%的乐观高估(ECE);经过简单的后验温度校准(Calibrated,红色曲线)后,预测的前缀存活概率与真实经验接受率严丝合缝地贴合在对角线上,ECE 被压降至1%左右,从而确保了贪心调度器在计算 时不会因为概率失真而做出错误的资源分配。
6. DeepSeek-V4 线上生产服务压测:帕累托前沿与负载自适应
6.1 单卡聚合吞吐 vs 单用户 TPS 的帕累托前沿大幅外推
将半自回归草稿模型(5 层主干的 DSpark-5)与硬件感知前缀调度器合体后,作者在 DeepSeek-V4-Flash 与 DeepSeek-V4-Pro(预览版线上生产推理引擎)上接入了真实线上用户流量,与原有的生产级基线 MTP-1(单步多词元预测)进行了端到端的服务压测对比:
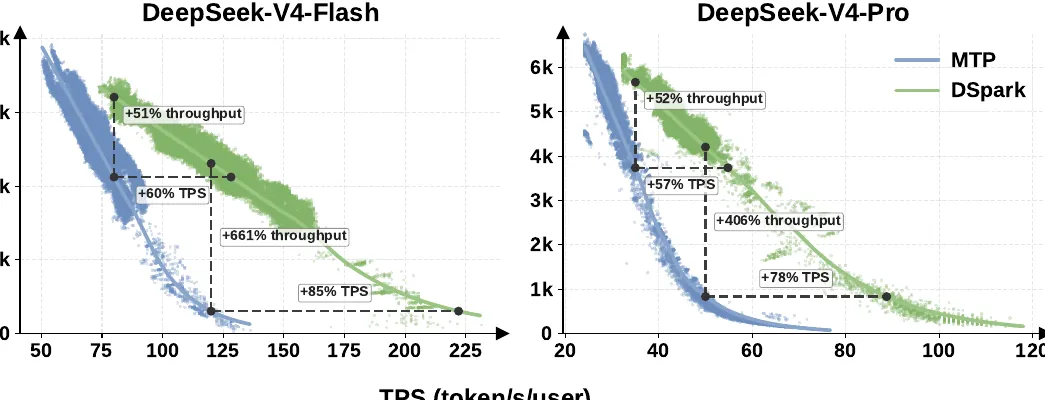
读懂这张“单卡聚合吞吐(Throughput, tok/s/GPU)— 单用户生成速率(TPS, tok/s/user)”帕累托前沿图,就读懂了工业级 LLM 推理服务的全部精髓:
- 在主流高交互 SLA 锚点(
80 tok/s/user)下:接入 DSpark-5 后,DeepSeek-V4-Flash 的单卡聚合吞吐相比 MTP-1 直接跃升了+51%,DeepSeek-V4-Pro 的单卡聚合吞吐跃升了+52%——这意味着在保证用户体感丝滑度完全不变的前提下,同等规模的 GPU 集群可以直接多承接一半以上的线上并发流量! - 在极限低延迟 SLA 锚点(
120 tok/s/user)下:此时原有的 MTP-1 已经撞上了单步串行访存的物理延迟铁壁,只能把并发批大小压到极小才能勉强达标,吞吐近乎归零;而 DSpark 凭借单步多词元跳跃,在此锚点下跑出了相对 MTP-1 高达661%(V4-Flash) 与406%(V4-Pro) 的惊人吞吐倍率,直接开辟出了基线无法触及的极速交互服务区。 - 在同等集群吞吐水位下对比用户体验:固定相同的单卡吞吐负载,DSpark 为 DeepSeek-V4-Flash 带来了
60%~85%的单用户生成速度提升,为 DeepSeek-V4-Pro 带来了57%~78%的单用户提速。
6.2 揭秘线上自适应弹性:并发流量如何动态指挥验证预算?
为什么传统静态长草稿在高并发下会劣化吞吐,而 DSpark 却能在全并发区间稳居帕累托前沿上方?下图展示了随着并发请求数(Concurrency)从低到高攀升,集群总吞吐与调度器分配的每请求平均验证预算(Verification Budget )的实时联动曲线:
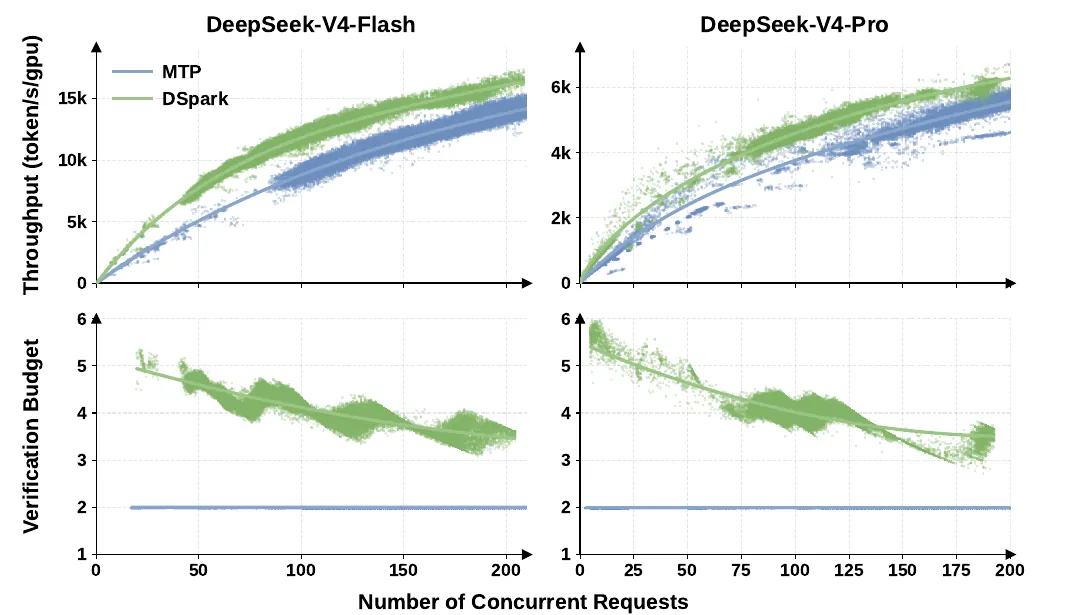
上下两排曲线的对偶变化完美印证了硬件感知调度器的设计初衷:
- 当系统处在低至中等并发(如图左半区)时,GPU 批容量充裕, 曲线平缓,调度器自动放开手脚,为每个请求分配
4~6个词元的宽裕验证预算,最大化榨取多步推测解码的延迟加速红利; - 当流量洪峰到来、并发请求数持续推高(如图右半区)时,目标模型批处理容量逼近算力饱和区,调度器无需任何人工干预,自动依据变陡的 斜率将每请求平均验证预算平滑收紧至
1.5~2.5个高把握词元,把那些极可能被拒的发散后缀统统挡在目标模型大门之外。这种“闲时激进多验抢速度、忙时保守精验保吞吐”的全自动弹性,正是 DSpark 在工业界大规模落地的杀手锏。
7. 技术谱系横向对比与高并发推理系统启示
把 DSpark 放进大模型推测解码的技术演进坐标系中,并与本博客精读过的其他大规模系统优化工作(如 Meta HSTU 的 M-FALCON 微批次掩码推理与 阿里 SIM 的两阶段粗筛降维)做跨领域映照,可以总结出极具价值的系统设计规律:
7.1 推测解码主流流派全景对比
| 推测解码技术流派 | 代表性工作 | 草稿生成复杂度 | 块内前后一致性 | 高并发批预算控制 | 核心局限与 DSpark 的破局点 |
|---|---|---|---|---|---|
| 独立小模型自回归 | Leviathan et al. (标准 SpecDec) | 串行小模型前向 | 强(全自回归) | 无(静态固定块长 ) | 需额外部署维护同词表小模型,KV Cache 双份开销,串行草稿延迟高 |
| 目标模型多头预测 | Medusa / DeepSeek MTP | 并行多头 | 弱(各头条件独立) | 生产中被迫锁死 MTP-1 | 缺乏深层草稿主干与块内依赖,拉长步数后在高并发下严重挤占验证批容量 |
| 浅层特征自回归 | EAGLE / Eagle3 | 串行单层前向 | 强(自回归输入采样词) | 静态阈值或固定树 | 为控制 串行延迟被迫采用极浅网络,限制了首词元预测上限 |
| 深层纯并行块提议 | DFlash | 5 层并行主干 | 弱(严重后缀衰减) | 无硬件感知全局调度 | 位置间缺乏采样协同,后序位置条件接受率断崖下跌 |
| 树状多路径并行验证 | SpecInfer / Medusa Tree | 构造候选词元树 | 靠多分支暴力覆盖 | 极差(批大小成倍膨胀) | 在 batch_size=1 下接受率高,但在高并发连续批处理下树掩码会瞬间撑爆验证批容量 |
| 半自回归 + 置信度调度 | DSpark (DeepSeek) | 5 层主干 + <1.3% 轻量顺序头 | 强(Markov/RNN 局部修正) | 全局贪心优化 | 同时兼顾高容量首词、低衰减长后缀与全并发自适应验证预算分配 |
横向审视可以发现,无论是推荐系统里 阿里 SIM 用 GSU 砍掉 99% 无关历史再去跑 ESU 注意力,还是 Meta HSTU 用 M-FALCON 把复杂交叉摊销到微批次掩码中,抑或是 DSpark 用校准置信度与 砍掉低价值草稿后缀再去跑目标模型验证,顶尖工业系统的底层哲学完全相通——永远不要让昂贵的主干算力去盲目处理未经筛选的低信噪比候选;在进入重型算子之前,必须用轻量、校准过的先验调度器守住批处理预算的闸门。
7.2 工程团队落地 DSpark 范式的四步实战清单
如果您的团队正基于 vLLM、SGLang 或自研引擎构建高并发大模型推理服务,并希望引入 DSpark 的加速范式,建议按以下四步推进工程闭环:
- 自举数据对齐与混合损失蒸馏:切勿直接使用开源静态文本训练草稿头;务必用线上待加速的目标模型对业务真实 Prompt 分布自举采样生成训练语料,抽取均匀分布的 5 个深浅层隐藏状态,并以 联合训练并行主干、Markov 顺序头与置信度头(若不想承担数十 TB 的离线隐藏状态落盘成本,可在训练流水线中双模型同驻显存,在线实时跑目标模型前向提取特征后即刻丢弃)。
- 分位置校准度门禁验收:在模型上线前,必须在涵盖数学、代码与开放闲聊的混合验证集上运行
ConfidenceHeadRecorder,重点检查连乘前缀存活率 的可靠性曲线,拟合并固化后验温度缩放参数,确保各位置的期望校准误差(ECE)严格小于2%。 - 离线测绘目标硬件的 查找表:在目标部署 GPU(如 H800 / H20 / B200)及对应的张量并行(TP)/ 专家并行(EP)配置下,对目标模型执行从 到最大批上限的步进耗时压测,拟合成光滑单调的每秒步数查找表 注入调度器配置。
- 连续批处理调度器集成与安全熔断:在推理引擎的每步 Scheduler 循环中,收集当前批所有请求经
sample_block_tokens()产出的候选词元与校准存活率 ,执行 的全局排序贪心截断;同时配置兜底熔断逻辑——当集群遇到极端突发流量洪峰( 逼近显存上限)或检测到某类新型领域请求置信度分布严重偏移时,平滑将 下调收敛至1(MTP-1)或0(标准自回归),保证线上服务零抖动。
8. 总结
回顾全文,DSpark 之所以能在竞争极其激烈的推测解码赛道中做出让人眼前一亮的系统突破,核心在于它打破了“草稿模型设计”与“在线集群调度”各自为战的壁垒:
- 在生成侧(Draft Better),它看透了纯并行草稿模型因条件独立假设而引发“后缀衰减”的病根,在 5 层高容量并行 Transformer 主干之上点睛般地嵌入了一个耗时占比不足
1.3%的低秩半自回归顺序头(Markov / RNN Head),并配合位置指数衰减的 分布对齐损失,用 的并行开销拿下了超越自回归模型的块内连贯性; - 在验证侧(Verify Smarter),它深刻洞察到目标模型的验证批容量 是高并发服务中最昂贵的共享预算,通过让置信度头直接预测分布重叠面积 、实施连乘后验校准,并将硬件吞吐画像 纳入全局贪心目标 ,在 DeepSeek-V4 线上服务中实现了
+51%~+52%的单卡吞吐跃升与全并发自适应弹性。
这套“半自回归保质量、校准调度控预算”的双轮驱动架构,不仅为 DeepSeek 自身的推理底座提供了强劲引擎,也为整个工业界设计下一代高并发、低延迟大模型推理系统立下了新的标杆。
参考资料
- DeepSeek-AI/DeepSpec 官方开源代码库
- DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation (Technical Report PDF)
- deepseek-ai/dspark_qwen3_4b_block7 Hugging Face 预训练权重
- DFlash: Efficient Speculative Decoding via Dynamic-Length Parallel Drafting (arXiv:2602.06036)
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test (arXiv:2503.01840)
- Fast Inference from Transformers via Speculative Decoding (ICML 2023)
- SGLang: Efficient Execution of Structured Language Model Programs
comments