在学术论文的展示视频里,一尊刚从 Marching Cubes 提取出来、包含 100 万个三角形和密集顶点色的三维网格,转一圈看起来往往细节饱满、光影动人。但如果你把这个网格直接丢给游戏客户端程序员或移动端 AR/VR 引擎,对方多半会当场退货:百万级面数会瞬间拖垮移动端帧率;没有隐藏面剔除的内部空腔白白浪费着光栅化算力;缺少展开好的二维 UV 图集(UV Atlas)导致无法走标准贴图管线;而动辄两三分钟的生成与离线后处理耗时,更是让创作者与智能体(Agentic Asset Creation Loop)的实时交互试错无从谈起。
怎样才能让单图 3D 生成模型产出的结果,真正符合工业级实时渲染引擎的可部署资产契约(Deployable Asset Contract)?
Meta Reality Labs 团队在 AssetGen: Deployable 3D Asset Generation at Interactive Speed(PDF、HTML 全文)中交出了一套极具工程穿透力的系统方案:给定单张参考图,默认 AssetGen 在约 30 秒 内即可交付一个面数严格受控(如 5K~23K 面)、剔除了不可见内面、具备干净 UV 展开、烘焙了切线空间法线贴图(Tangent-Space Normal Map)与 2K 彩色纹理图集的成品三维网格;而面向极速预览与智能体高频迭代的 AssetGen Flash 变体,更是将端到端挂钟延迟压低到了约 14 秒。
深入拆解这篇长达 30 页的系统报告,你会发现 AssetGen 的成功建立在四条鲜明的工程设计哲学之上:
- 用“高模生细节、低模跑渲染、法线做桥梁”的工业契约替代暴力高面数输出:不在生成模型内部纠结怎么直接生出低面数网格,而是让两阶段扩散模型 MeshGen 尽情生成数以十万面计的高精度稠密网格,随后通过二次误差减面将多边形预算砍掉 95% 以上,再将高模与低模之间的几何表面差全部烘焙进一张二维切线空间法线贴图——用极低的光栅化面数代价,在实时引擎里还原出高模级的凹凸光影。
- 当神经网络被蒸馏到 4 秒以内,必须把传统离线图形学后处理全部拉进 GPU 关键路径:过去大家觉得扩散采样要跑一两分钟,调 CPU 跑几秒减面、调 Blender 跑几秒法线烘焙无伤大雅。但当作者用渐进式步数蒸馏与 CFG 折叠把 120 步扩散压到 30 步(耗时从
28.20s骤降至3.78s)后,传统 CPU/离线图形工具瞬间成了拖慢全局的最大瓶颈。AssetGen 为此用CuMesh、并行图块分割xatlas和DRTKGPU 光栅化核函数彻底重写了几何与烘焙管线。 - 顺应相机几何拓扑裁剪多视角注意力,用三维空间邻域替代二维 UV 邻域做空洞修补:在 11 个视图(45,056 个潜空间 Token)的同步纹理扩散中,利用正交环绕相机的物理重叠关系设计稀疏注意力掩码,砍掉 75% 的冗余上下文计算;而在将多视图颜色反投影回 UV 图集时,针对自遮挡死角采用基于三维空间坐标与法线的 KD-Tree 传播,彻底避开了二维 UV 接缝两侧不连续导致的错色污染。
- 用系统级流水线重叠(Overlap)掩蔽非关键路径耗时,一套架构切出双运行档位:将几何服务与纹理服务解耦,在多视角扩散去噪的同时,利用后台工作进程异步预计算反投影映射表与三维 KD-Tree;并通过灵活开关几何精炼阶段与逐视角超分,在同一套底座上同时满足“14 秒极速草稿”与“30 秒精装交付”两类场景。
下面我们就沿着这四条设计哲学,逐层剖析 AssetGen 从数据清洗、几何生成、GPU 图形后处理、多视角纹理合成到全链路延迟优化的技术细节。
1. 什么是“可部署三维资产”?系统契约与双模架构
1.1 学术 Demo 与工业可部署资产的鸿沟
为什么许多在视觉指标上刷出高分的单图 3D 模型,到了游戏美术和客户端工程师手里却寸步难行?对照下面这张工程交付清单就能一目了然:
| 评估维度 | 学术研究 Demo 常见形态 | 实时渲染引擎的可部署资产契约(AssetGen 目标) |
|---|---|---|
| 多边形面数预算 | 50 万~100 万面 Marching Cubes 原始三角网格 | 严格受控于 5K~25K 面,直接适配移动端与 VR 头显帧率预算 |
| 内部冗余几何 | 隐式场提取遗留大量封闭内腔、双层薄壳与自交碎片 | 经隐藏面剔除(Hidden-Face Removal),每一分面数预算都花在可见外表面 |
| 高频几何细节载体 | 靠无限加密顶点硬撑表面褶皱与凹槽 | 低模仅保留大轮廓,高频细节全部编码进切线空间法线贴图(Normal Map) |
| 外观存储方式 | 绑定在百万顶点上的顶点色,或未对齐的多视角渲染图 | 展开无重叠的二维 UV 坐标 + 1K/2K 彩色纹理图集(Color Texture Atlas) |
| 端到端交互延迟 | 数分钟的扩散采样 + 离线 Blender 脚本串行处理 | 14 秒(Flash)/ 30 秒(默认)端到端挂钟耗时,支撑交互式连续修改 |
Fig. 1 展示了 AssetGen 交付的标准资产形态:从单张参考图出发,输出的每一个三维对象都严格包含简化网格 + UV 坐标 + 烘焙法线贴图 + 彩色纹理图集四件套。值得留意的是,2026 版的 AssetGen 专门针对移动端与实时光栅化管线选择了“色彩贴图 + 切线法线贴图”的轻量组合(区别于 2024 年主打重度 PBR 材质分解与重光照的 Meta 3D AssetGen),从而免去了移动端实时计算复杂多通道着色器的负担。
1.2 三阶段流水线与 Default / Flash 双运行档位
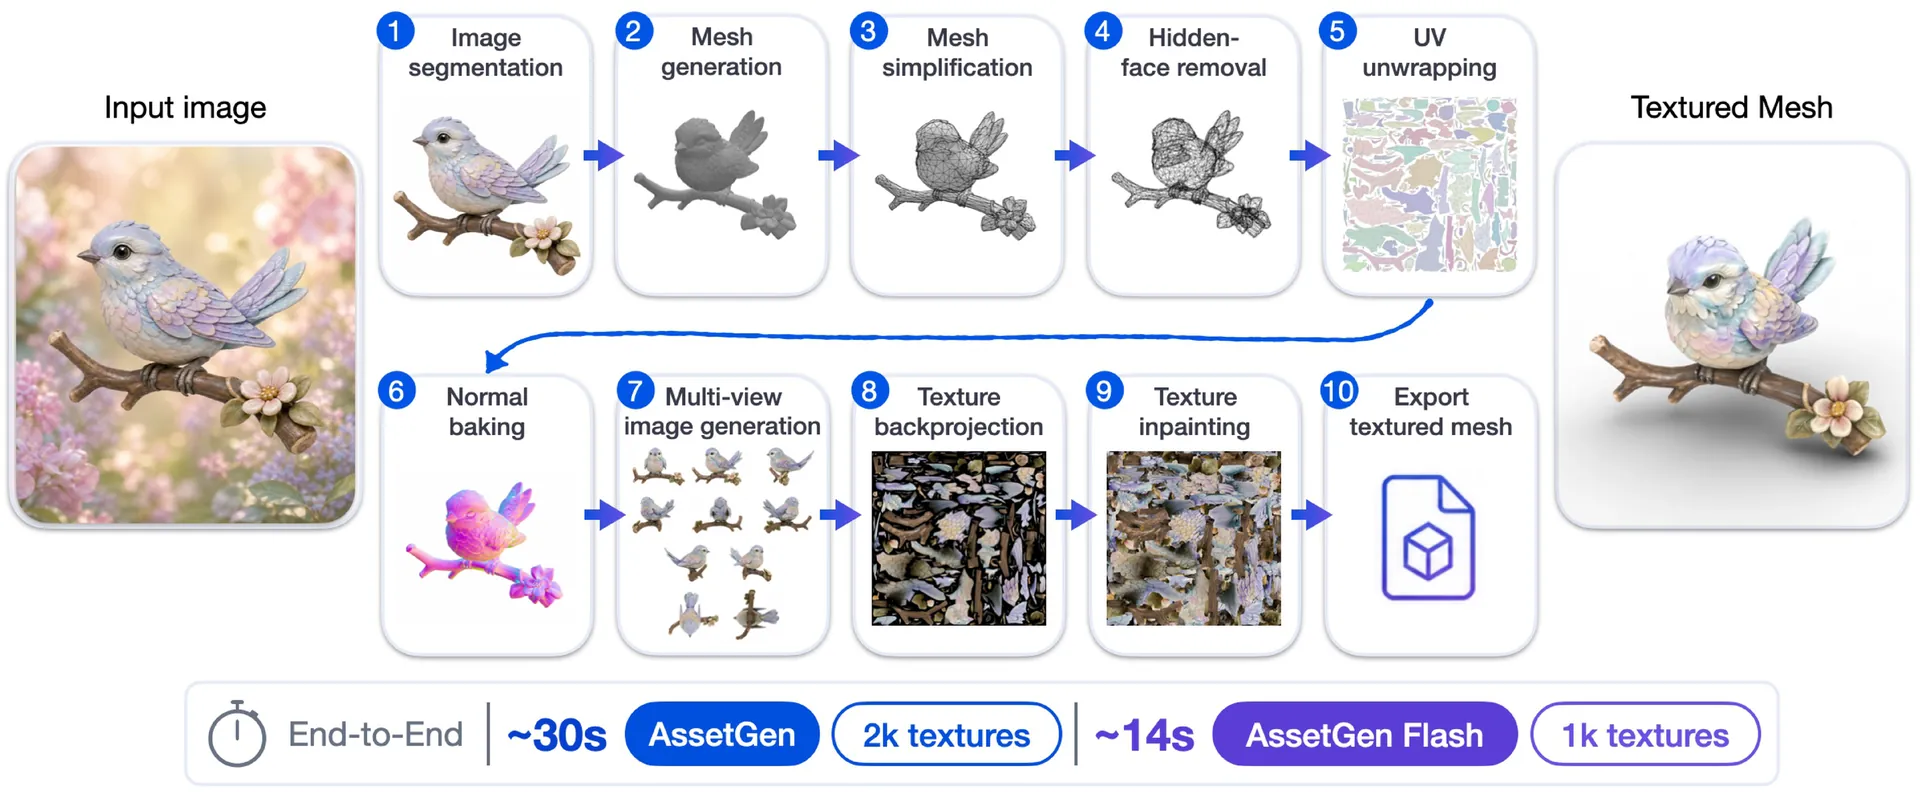
如 Fig. 2 所示,整套系统由 MeshGen(两阶段稠密几何生成)、Geometry Processing(GPU 减面、消隐、UV 展开、法线烘焙)与 TextureGen(10 视角纹理流匹配、UV 反投影融合、三维感知修补)三大阶段串联而成。为了同时服务“快速探索”与“最终导出”,系统在架构内部切出了两个运行档位(Operating Points):
| 核心环节 | AssetGen(默认质量优先模式,~30s) | AssetGen Flash(交互延迟优先模式,~14s) | 为什么这样取舍? |
|---|---|---|---|
| MeshGen 几何生成 | Coarse(4096 tokens, 25 步)+ Refine(16384 tokens, 5 步) | 仅运行 Coarse 阶段(跳过 Refinement) | 粗阶段 25 步已能确立准确的全局拓扑,省去精炼阶段与高模烘焙可立减近 6 秒 |
| TextureGen 扩散采样 | 1024px 分辨率,双卡并行跑推理期双分支 CFG | 768px 分辨率,单卡跑 CFG 蒸馏后的单分支条件模型 | 降低图像潜空间分辨率并折叠 CFG 分支,将纹理扩散耗时压缩一半以上 |
| 超分与导出图集规格 | 启用逐视角超分辨率(Per-view SR),导出 2K 贴图图集 | 跳过超分模块,直接反投影导出 1K 贴图图集 | 1K 贴图完全满足预览与小尺寸道具需求,省去超分与大图光栅化开销 |
2. 数据基石:VLM 多级清洗与防渗漏的泛洪符号距离场构建
2.1 为什么数据脏一点就会毁掉后续的 UV 和法线烘焙?
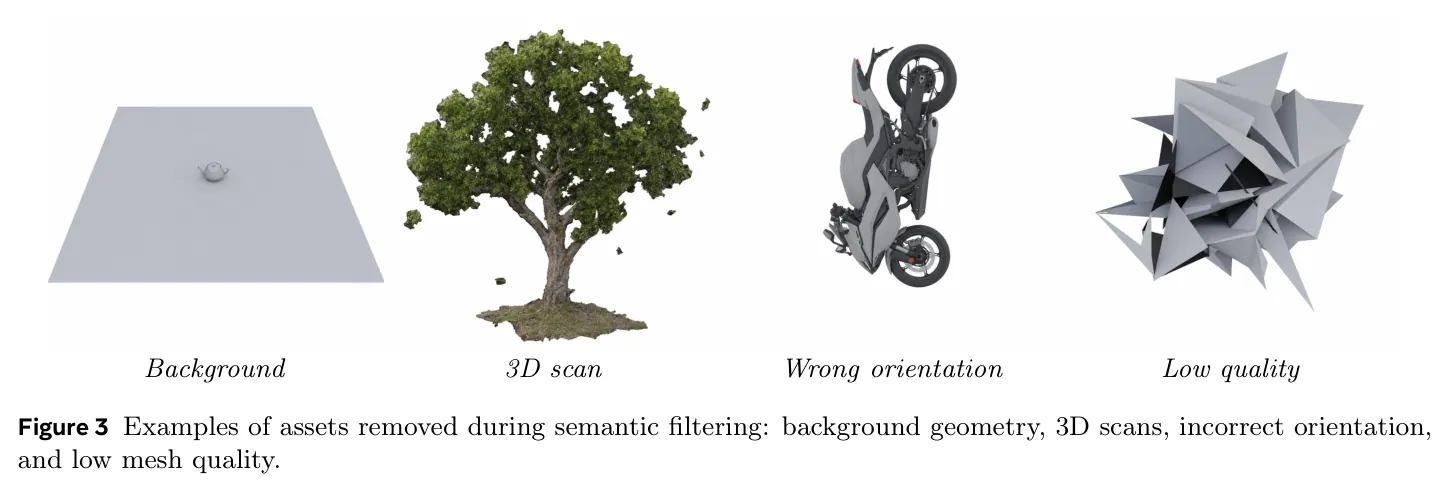
在普通新视角合成任务里,训练模型带一点地面底座或内部碎面,渲染出来的图片依然能看。但在可部署资产管线里,这类脏数据是致命的:一旦生成的网格底下连着一块巨大的阴影地板(Fig. 3 左一),后续做自动减面和 UV 展开时,宝贵的 10K 面数预算和一大半 UV 图集面积就会被这块毫无意义的地板霸占,导致真正的物体本体分不到几个像素!
为此,AssetGen 从内部授权三维资产库出发,设置了四道严密的数据过滤网:
- 重复与几何规模过滤:基于感知哈希与元数据剔除重复资产,过滤顶点数异常(过于简陋或极端庞大)的模型;
- VLM 语义筛查:对每个资产渲染多视角图像,调用视觉语言模型自动识别并剔除连带背景底座(Background Geometry)、残缺不全的三维扫描碎片(3D Scans)以及表面拓扑严重畸变的废模;
- 规范朝向过滤(Orientation Filtering):剔除正立方向颠倒或歪斜的模型,确保所有进入训练集的样本在相机系下拥有一致的重力轴与正背面先验。
2.2 泛洪填充符号估计:如何在破洞网格上算出干净的 SDF?
MeshGen 的底层依赖连续符号距离场(SDF)训练:对于空间中的任意查询点,不仅要知道它离网格表面有多远(无符号距离),还必须准确判断它是在物体内部(负号)还是物体外部(正号)。
如果艺术家建的网格全都是严丝合缝的封闭水密实心体(Watertight),判断内外易如反掌。可现实中的三维资产到处都是开口、细小缝隙、单层面片或法线绕序反装——传统的光线投射奇偶计数法或广义绕数法(Generalized Winding Number)遇到破洞就会把内部误判成外部,导致训出来的 SDF 表面破烂不堪。
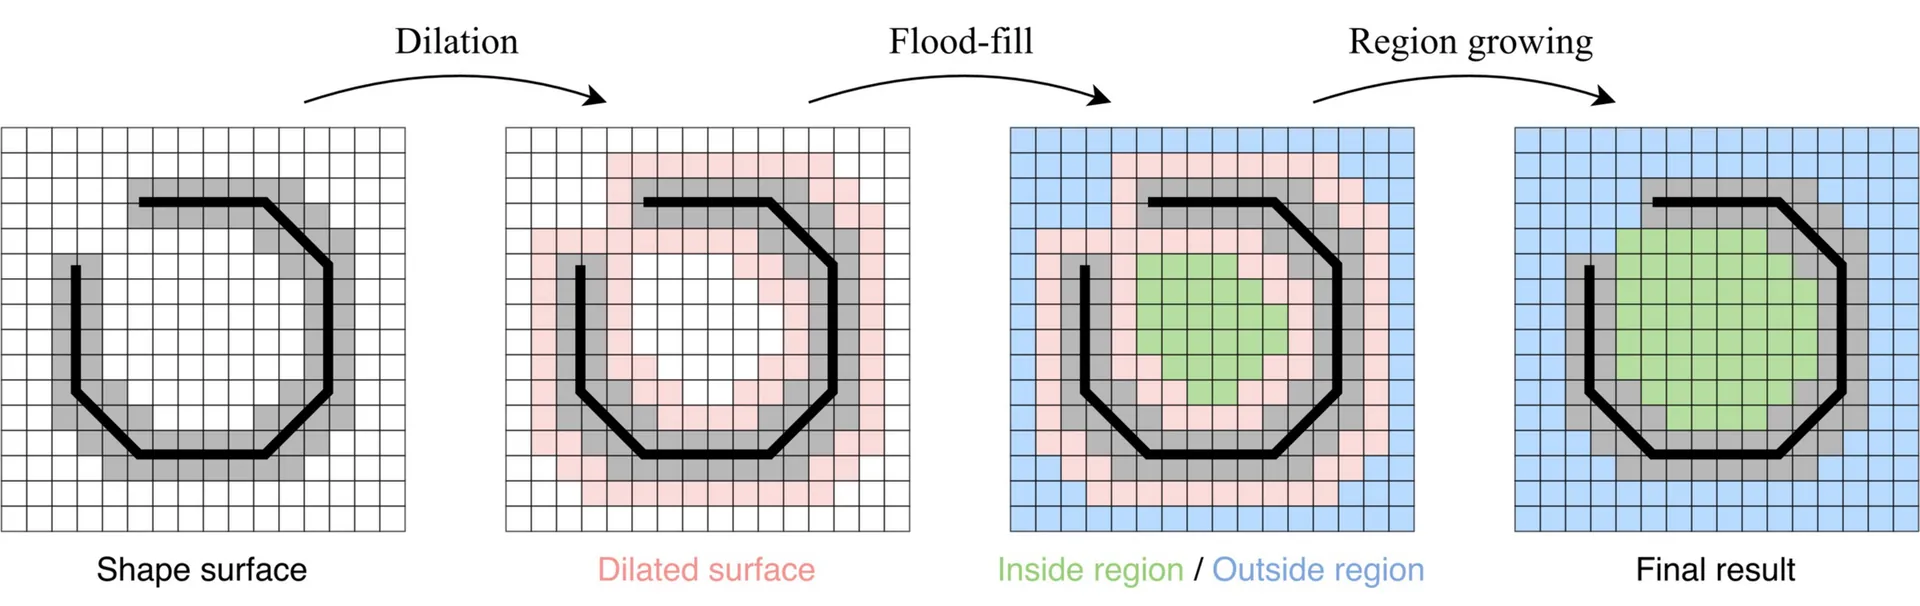
Fig. 4 展示了作者设计的形态学膨胀 + 泛洪填充符号估计算法(Flood-fill-based Voxel Sign Estimation),用极其直观的体素操作解决了破洞渗漏难题:
- 标记表面窄带:在 体素网格上,先把所有距离原始网格表面小于窄带阈值(Surface Band)的体素标为边界墙;
- 形态学膨胀封堵微孔(Dilation):如果网格上有一条细小的接缝破洞,直接从外面灌水(Flood Fill)就会顺着缝隙漏进物体肚子里。因此,算法先对表面窄带执行形态学膨胀,把表面墙体“吹厚”一圈,直接把所有微小缝隙和破洞严严实实地堵死;
- 边界泛洪标定外部空间:从体素网格最外圈的边界出发,向内执行连通域泛洪填充——所有被水漫过的体素标为“外部()”,被膨胀墙体挡住、水进不去的封闭空腔与墙体内部标为“内部()”;
- 形态学腐蚀还原真实厚度(Erosion):最后把第一步因膨胀而多算进来的外扩层通过腐蚀操作剥除,使正负号翻转的零等值面精确贴回原始网格的真实厚度。
3. MeshGen:由粗到精的两阶段 VecSet 扩散与 4 倍步数蒸馏
3.1 为什么分 Coarse 与 Refine 两步走?
MeshGen 采用基于无序点集向量的 VecSet 潜空间表示:先由 VecSet VAE 将三维形状编码为潜变量矩阵 ,解码器则通过交叉注意力支持空间任意三维坐标的 SDF 查询。在潜空间扩散训练中,设干净潜变量为 ,高斯噪声为 ,在时间步 下的加噪状态与 -prediction 目标分别为:
网络 (基于 2.3B 参数的 24 层 DiT,隐藏维数 2048、16 头注意力、SwiGLU 前馈层与 AdaLN 时间步调制)在冻结的 DINOv2 ViT-G/14(with registers)图像 Patch Token 条件 下最小化速度预测均方误差:
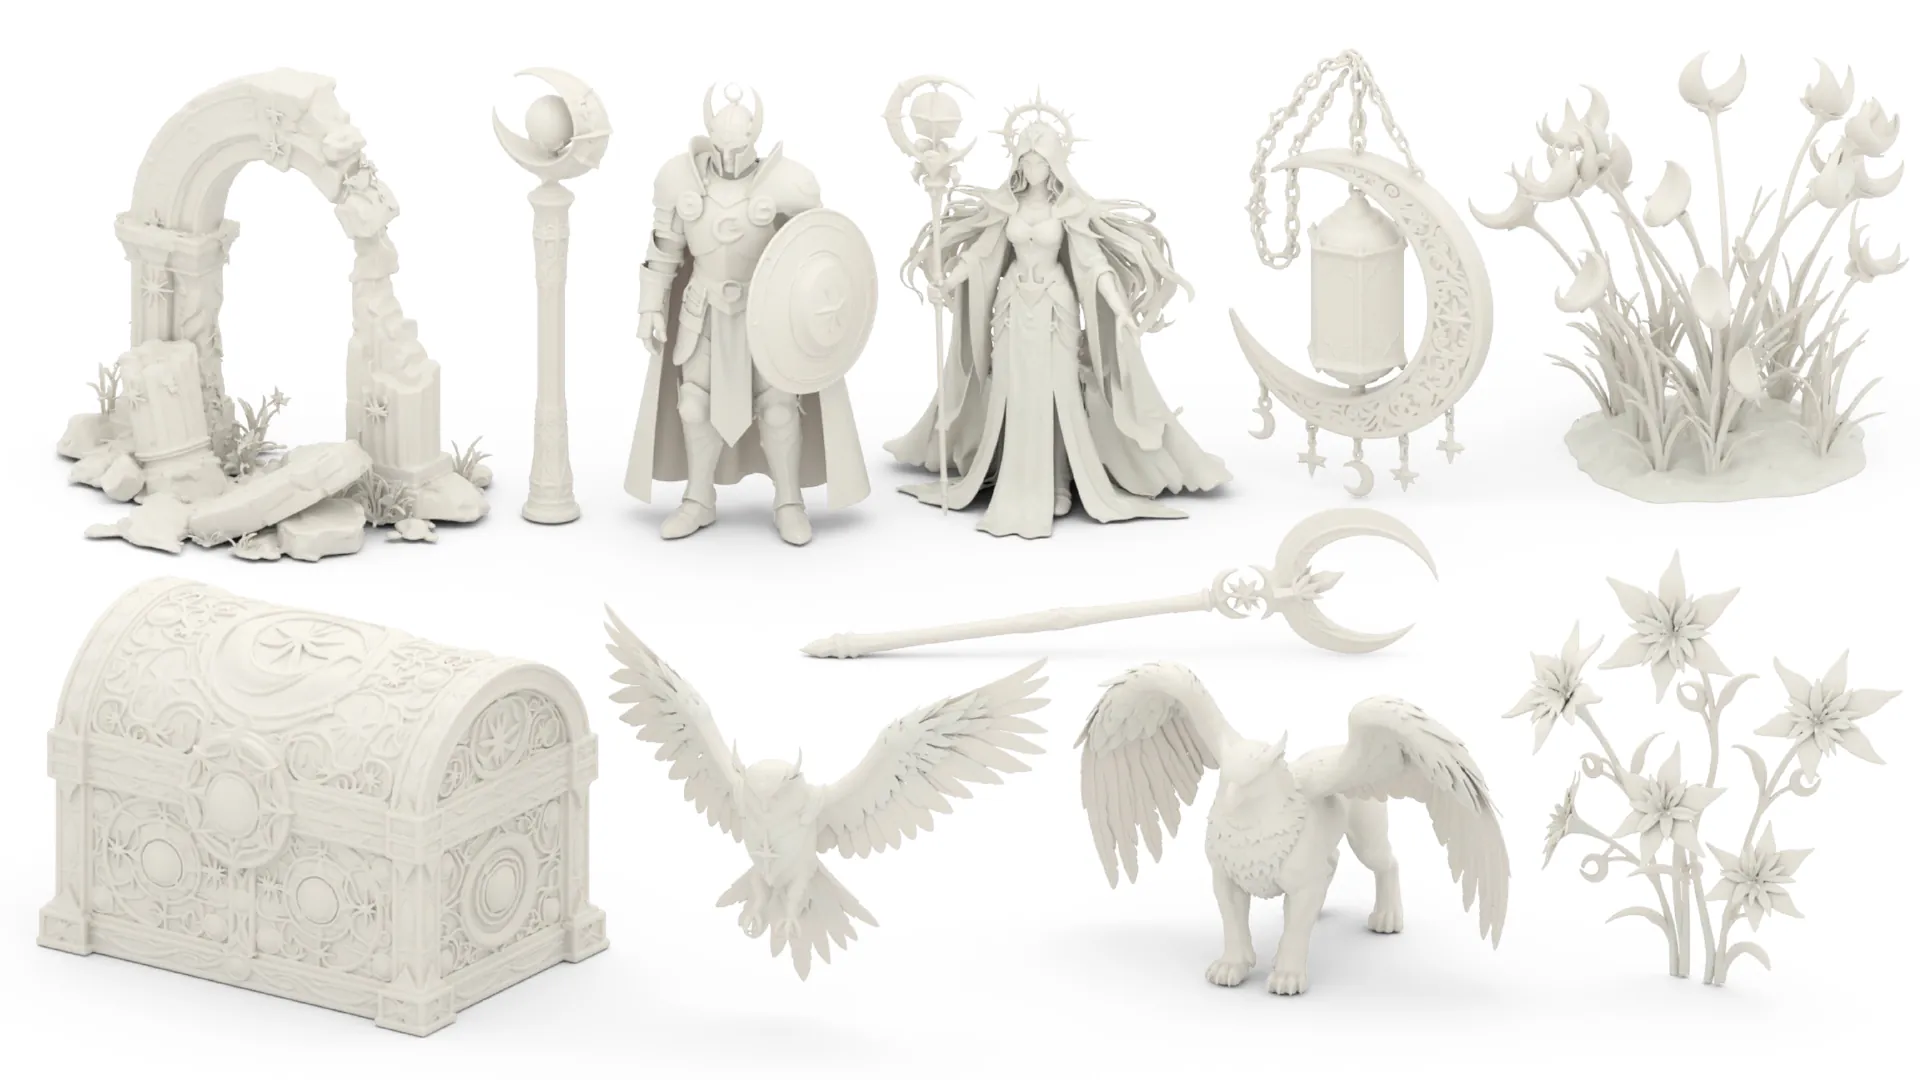
看看 Fig. 5 中 MeshGen 生成的高模网格,连怪兽身上的鳞片褶皱和机械表面的铆钉凹槽都纤毫毕现。如果只用一个阶段的扩散模型,为什么很难兼顾“整体结构不畸变”与“局部鳞片够锐利”?
作者给出了一个非常透彻的两阶段解耦方案:
- 第一阶段(Coarse Stage,全局拓扑确立):使用 个、每个维度 的潜空间 Token,配合 分辨率的 DINOv2 视觉特征。注意,这 4096 个粗阶段 Token 没有任何预设的三维空间坐标锚点,它们在全局自注意力中自由交互,专心把物体的整体比例、对称性与肢体连通拓扑定下来,经 Marching Cubes 提取出粗网格(Coarse Mesh)。
- 第二阶段(Refinement Stage,带空间锚点的局部雕刻):直接在第一阶段生成的粗网格表面采样并体素化,生成 个绑定了明确三维空间坐标锚点的局部 Token,同时将输入给 DINOv2 的参考图分辨率翻倍提升至 (产生的视觉 Patch Token 数量增加 4 倍)。因为每个三维 Token 都明确知道自己守在粗网格表面的哪一块毫米级区域,它只需要通过交叉注意力去 高清特征图上对应的局部位置“抄作业”,就能把五官、手指与衣纹雕刻得刀削斧劈。
3.2 渐进式蒸馏与 CFG 折叠:把 28 秒压缩到 3.78 秒
在标准推理时,为了保证生成的形状紧贴输入图像,必须开启无分类器引导(CFG):
但算一笔时间账:原始教师模型在粗阶段要跑 100 步、精炼阶段要跑 20 步,且每一步 CFG 都要跑条件与无条件两次前向传播(相当于 2.3B 的大模型要串行跑 240 次!),单张 A100 光跑完 MeshGen 去噪就要花掉 28.20 秒,直接把 30 秒的总预算吃光了。
为了把扩散耗时砍下来,作者实施了 渐进式步数蒸馏 + CFG 折叠(Progressive Distillation with CFG Folding):
- 在训练学生网络时,让教师模型从学生时间步出发,开启 CFG 连跑多步确定性 DDIM 更新,算出多步引导后的目标潜变量;
- 让学生网络只做 1 次条件前向传播(无需再跑无条件分支),直接用单步 MSE 损失去逼近教师的多步 CFG 轨迹终点;
- 经过两轮减半蒸馏,粗阶段从 100 步压到 25 步,精炼阶段从 20 步压到 5 步,总前向评估次数从 240 次骤降到 30 次!
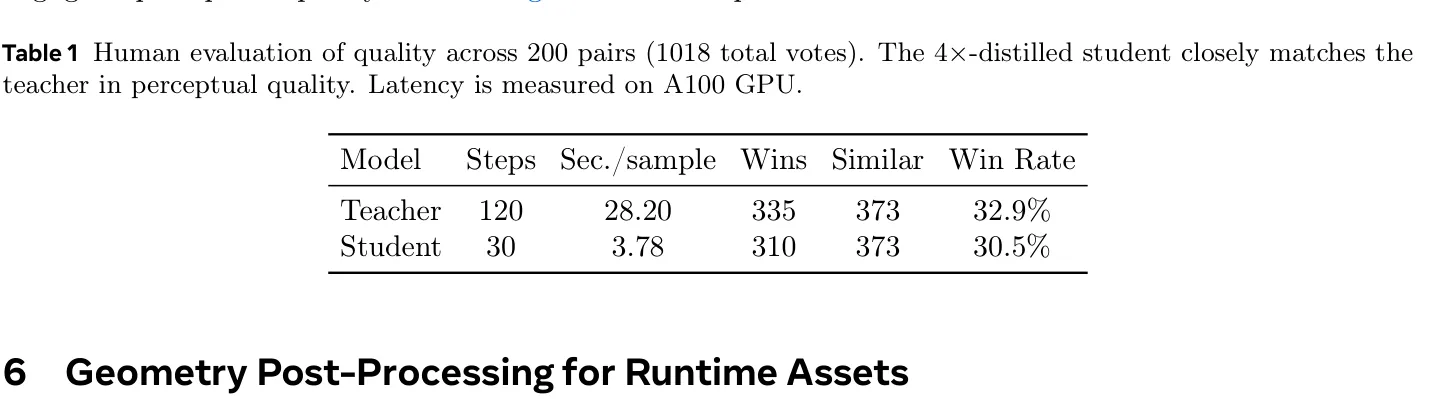
看 Table 1 的盲测验证:在 A100 上,30 步学生模型把耗时从 28.20s 猛压到了 3.78s(提速 7.46 倍);而在人类评测员对几何质量的盲选中,教师胜出占 32.9%、学生胜出占 30.5%、认为两者无差别占 36.6%——以零感知质量折损换回了宝贵的 24 秒预算!
4. GPU 几何后处理管线:当主干只需 4 秒,后处理一毫秒都不能浪费
MeshGen 解码出的高模网格动辄包含数十万个三角形。要把它变成游戏引擎能直接吞进去的运行时资产(Runtime Asset),必须依次走完四道传统图形学工序:
稠密高模 (Dense Mesh) ──> [1] 隐藏面剔除 ──> [2] QEM 减面 ──> [3] 并行 UV 展开 ──> [4] 切线空间法线烘焙4.1 隐藏面剔除与 CuMesh GPU 并行减面
生成式 SDF 提取出的网格内部,经常藏着封闭的内腔气泡或重叠内表面。如果不加清理直接减面,减面算法会傻乎乎地匀出几千个三角形去维持这些永远没人看得见的内部气泡,同时把 UV 图集切得支离破碎。因此,管线第一步先从外围多视角执行可见性测试,将完全不可见的内部隐藏面(Hidden Faces)彻底剔除。
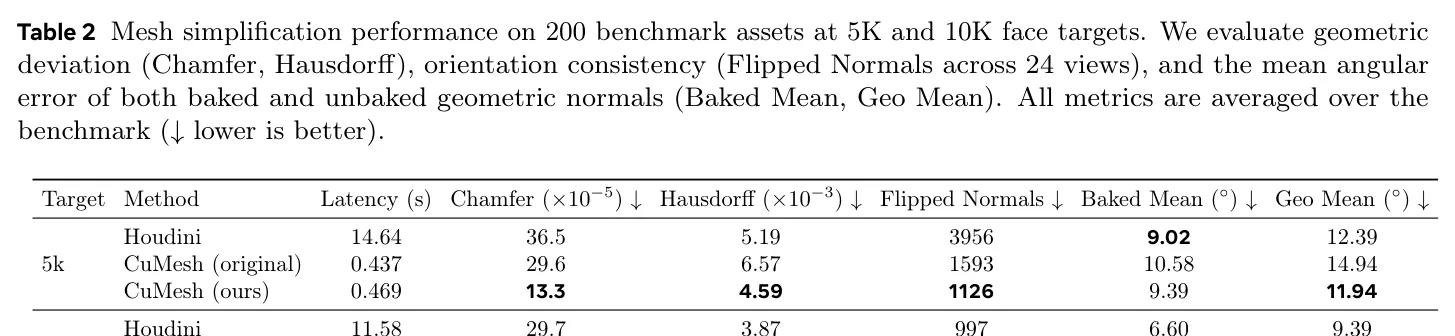
接着进入核心减面环节(Table 2)。作者基于 CuMesh 风格的 GPU 并行边坍缩(Parallel Edge Collapse)与二次误差度量(QEM),在不到 1 秒的时间内将高模快速简化至目标预算(如 5K 或 10K 面)。
仔细观察 Table 2 的评测列,你会发现一个非常内行的指标设计:作者不仅测了简化前后的点集 Chamfer 距离和最坏偏差 Hausdorff 距离,还专门测了 Baked Mean(将高模法线烘焙到简化低模后,渲染出的平均法线角度误差)!为什么这个指标比单纯的几何距离更重要?因为在实时引擎里,玩家看到的明暗细节是由“低模轮廓 + 法线贴图”共同决定的——哪怕低模平直一点,只要它的拓扑没有出现翻转法线(Flipped Normals 压到仅 0.21%),且烘焙上去的法线贴图能把高模的凹凸光影精准还原(10K 面下 Baked Mean 误差仅 5.97°),人眼就几乎看不出减面的痕迹。
4.2 并行图块分割 UV 展开与 271ms 的 GPU 法线烘焙
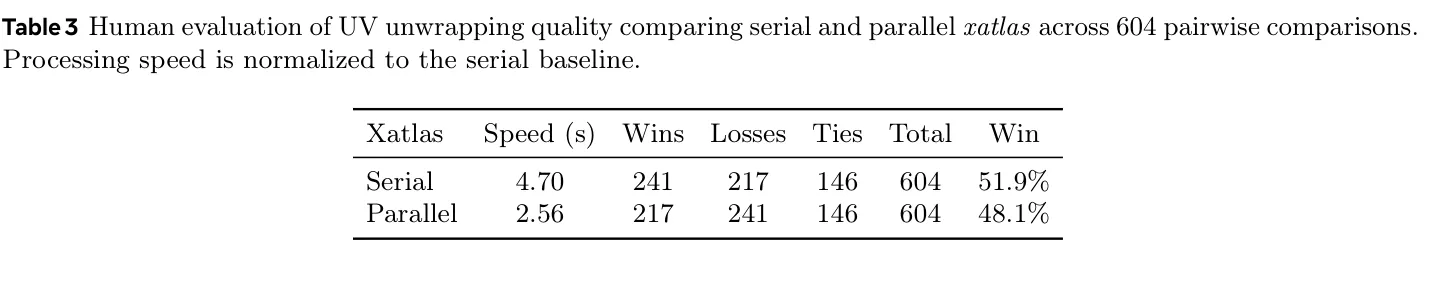
减完面后,需要用 xatlas 为低模展开二维 UV 坐标。原版串行 xatlas 在处理上万面网格时,图块生长(Chart Segmentation)与参数化是单线程瓶颈,平均要跑 4.70 秒。作者将图块分割改造为多线程并行流水线(Parallel UV Unwrapping,见 Table 3),在不损失贴图渲染质量(人评近 80% 样本完全持平)的前提下,将 UV 展开耗时砍到了 2.56 秒。
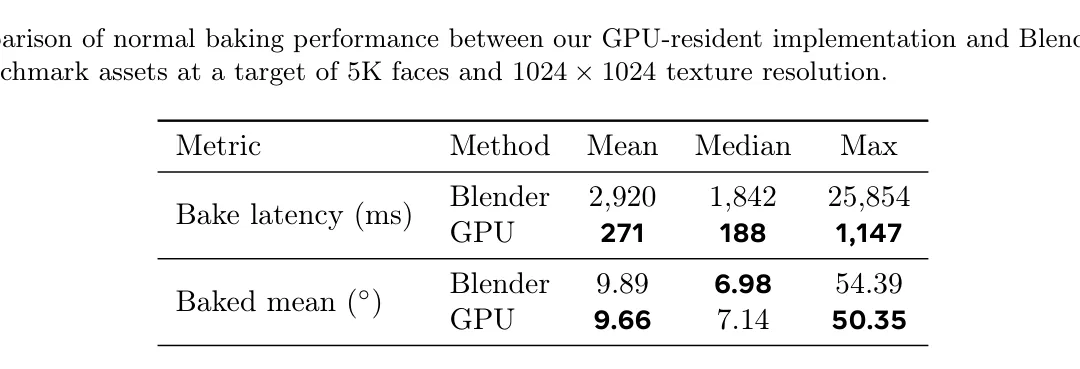
接下来是最见系统功底的一步:切线空间法线烘焙(Tangent-Space Normal Baking)。要把几十万面高模的表面细节转移到低模的二维 UV 贴图上,如果按常规做法拉起无头 Blender 进程跑射线投射烘焙,看 Table 4 第一行:平均耗时高达 2920 ms(近 3 秒),遇到复杂网格最坏甚至卡死 25854 ms(25.8 秒)!
AssetGen 彻底抛弃了 Blender,基于可微光栅化工具包 DRTK 编写了全 GPU 驻留的法线烘焙器:直接在 GPU 上将低模 UV 光栅化为三维表面坐标与切线标架(Tangent Frame),并行查找高模对应表面法线并转换至切线空间,最后在 UV 岛边界执行形态学膨胀填充(Seam Dilation)消除接缝黑线。如 Table 4 第二行所示,GPU 烘焙器将平均耗时压到了惊人的 271 ms(提速超 10 倍,最坏情况也仅需 1147 ms),且烘焙后的法线还原精度(Baked Mean 5.86° vs. Blender 6.07°)反而更胜一筹!
5. TextureGen:结构化多视角流匹配与三维感知贴图融合
5.1 为什么用 10 视角正交投影 + 结构化稀疏注意力?
拿到带 UV 与法线贴图的低模网格 后,TextureGen 负责根据参考图 为其生成无缝的 2K 彩色纹理图集。
首先看视角设计:系统围绕物体布置了 个固定目标相机——8 个水平环绕侧视图(每隔 一个)+ 1 个顶视图 + 1 个底视图,并且全部采用正交投影(Orthographic Projection)以保证物体各部位在贴图采样时具有均匀的像素分辨率。在推理开始前,系统调用 DRTK GPU 光栅化器 在 500 ms 内(比 Blender 渲染快 10 倍)直接渲染出这 10 个视角的法线图 与三维世界坐标位置图 ,全程作为显存张量直接喂给纹理生成网络。
在模型内部,每个 视图经图像 VAE 编码为 的潜变量网格;1 个固定不加噪的参考图槽位(Pinned Reference Slot)与 个加噪目标视角槽位拼成 的潜空间序列 ,采用最优传输条件流匹配(OT-CFM)预测速度场 。
这里同样面临一个算力难题: 个潜空间 Token,如果每一层都做全量 跨视角自注意力,矩阵计算量极其庞大。但仔细想想相机位置就会发现:物体左侧面的纹理,怎么可能需要去跟右侧面直接做注意力交互呢?它们根本没有重叠的可见表面!
据此,作者设计了与相机物理拓扑严密对齐的结构化多视角稀疏注意力(Structured Multi-View Attention):
- 全局外观锚定:所有 10 个目标视图都必须关注第 0 号槽位的参考图(Reference Slot),确保整体配色与材质风格高度统一;
- 正交主视图(前、后、左、右):每个主视图只关注参考图以及与它物理相邻的两个侧视图;
- 四个 斜角视图:只关注参考图以及夹着它的两个正交主视图;
- 顶视图与底视图:只关注参考图以及四个正交主视图。
这一刀切下去,直接把自注意力的上下文窗口缩小了约 4 倍,而相邻视角之间的接缝对齐信息丝毫未损!同时,通过像 MeshGen 一样对 TextureGen 实施渐进蒸馏与双卡 CFG 分支并行切分(Flash 版则直接蒸馏为单分支 768px 模型),多视角纹理采样的耗时从最初的近百秒被压到了 6~12 秒区间。
5.2 入射角加权 UV 反投影与三维 KD-Tree 空洞修补
当 10 个视角的彩色图像 生成完毕后,怎么把它们干净无痕地合成为一张二维 UV 纹理图集 ?
如果采用正向投影(把像素往网格上打),会在离散三角形上留下采样漏洞。AssetGen 采用逆向反投影(Backward Projection):遍历二维 UV 图集上的每一个有效纹素(Texel),先查出它在三维网格表面上的精确坐标与法线,再把它投影回 10 个相机视图中去读取颜色。
为了防止物体轮廓边缘处的背景颜色或深度跳变污染内部表面,系统先利用位置图 的空间邻域梯度构造深度不连续边缘掩码(Edge Mask),并引入各向异性过滤(Anisotropic Filtering)与多级 Mipmap 链解决大斜角下的采样走样。接着,对于同时被多个视角看到的纹素,采用入射角余弦加权融合(Incidence-Weighted Blending):
其中 是第 个视角反投影回来的局部贴图, 是该纹素表面法线与第 个相机视线方向的夹角余弦值(越正对着镜头, 越接近 1;越处于擦边的掠射角, 越接近 0),指数 用于放大正对视角的权重优势,而视角先验权重 则赋予正背面等主视角更高的决策权。
最后还剩下一个棘手问题:如果角色腋下、腿间或机械内部凹槽被自身结构挡住了,10 个相机全都没拍到这块区域(不可见死角),UV 图集上留下了一块黑洞,该怎么补(Inpainting)?
千万不能在二维 UV 贴图上直接拿周围相邻像素的颜色来糊!因为 xatlas 在切分 UV 岛时,二维贴图上紧挨着的两个 UV 岛,在三维模型上可能一个在头顶、一个在脚底,直接在 2D 图集上扩边会把鞋底的黑色涂到鼻尖上。AssetGen 的做法是三维感知纹理修补(3D-Aware Inpainting):将所有已成功着色的纹素按其三维世界坐标与三维表面法线建起一棵 KD-Tree;对于未着色的死角纹素,直接在三维空间里搜索离它最近、且表面朝向一致的邻居纹素把颜色传播过来,从而跨越 UV 岛接缝实现了天衣无缝的修补。
6. 全链路延迟拆解:如何把 220 秒的系统压进 30 秒与 14 秒?
6.1 为什么各模块耗时加起来大于总耗时?关键路径与异步重叠
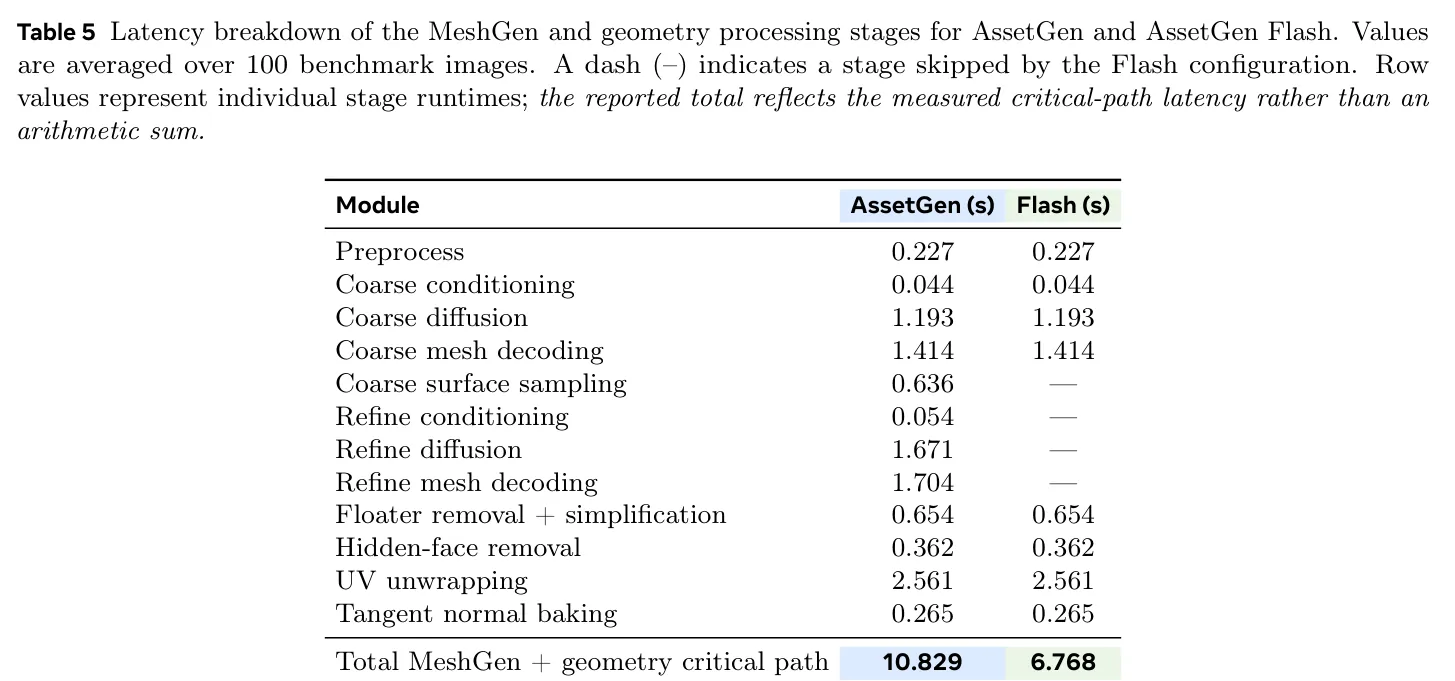
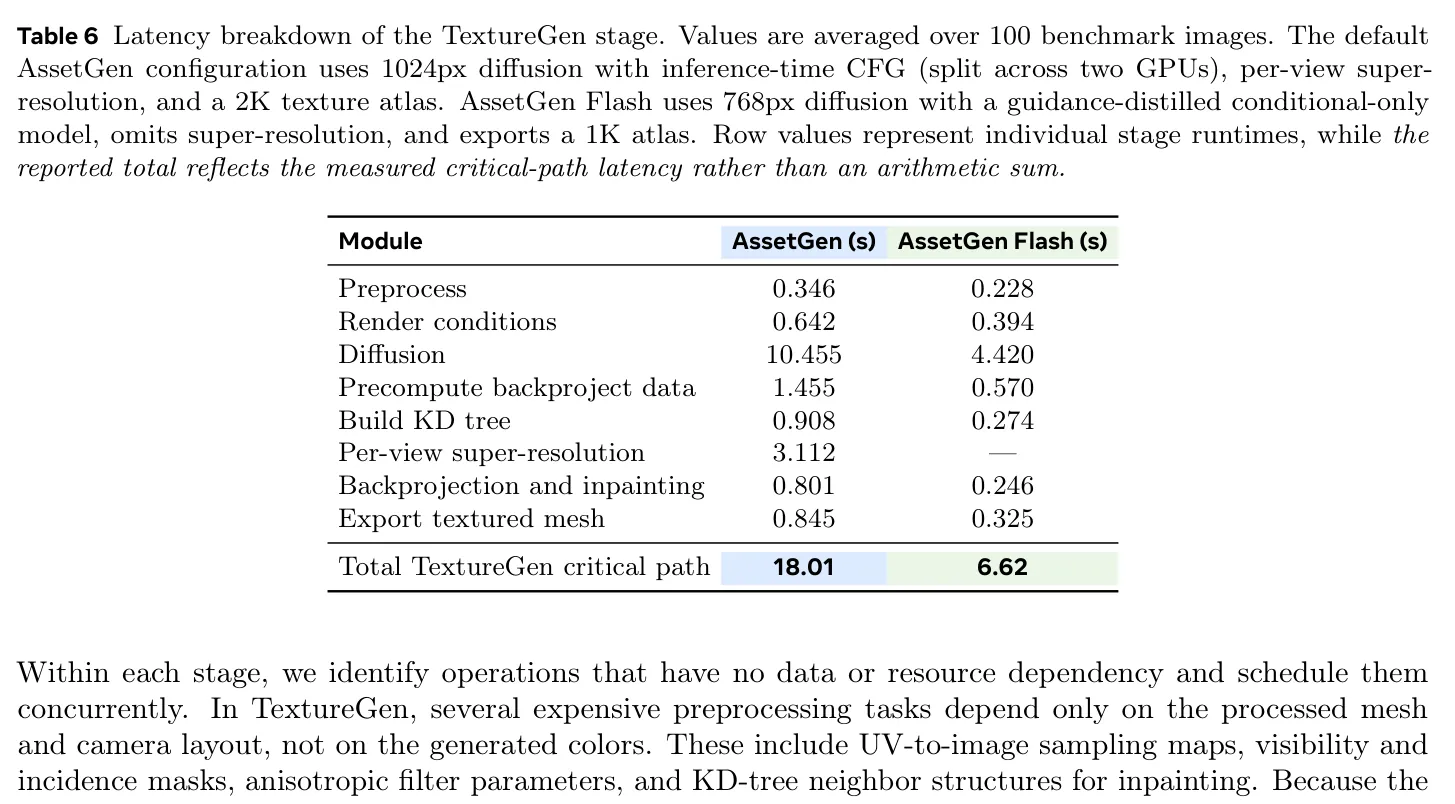
阅读 Table 5(MeshGen + 几何处理耗时表)与 Table 6(TextureGen 耗时表)时,细心的读者会发现一个有趣的现象:如果你把表格里每一行的耗时数字按计算器加起来,会比最底下一行的 Total(12.25s 与 17.85s)要大!
这绝非印刷错误,而是系统工程里最核心的关键路径调度与异步重叠(Critical-Path Scheduling & Work Overlapping):
- 在服务架构上,MeshGen 服务跑在 1 张 H100 上,生成简化网格、UV 和法线贴图后通过共享存储移交给 TextureGen 服务(默认模式用 2 张 H100 分跑 CFG 正负分支,Flash 模式只用 1 张 H100);
- 当 TextureGen 的 GPU 正在全力跑多视角流匹配去噪(耗时
12.63s)的同时,CPU 与辅助 CUDA 流已经在后台并行完成了反投影几何映射表预计算(Precompute backproject data,1.93s)以及三维空间修补所需的 KD-Tree 构建(Build KD tree,0.24s)!等扩散模型和逐视角超分一跑完,反投影和修补数据结构早就严阵以待,只需0.21s就能瞬间合出最终贴图。
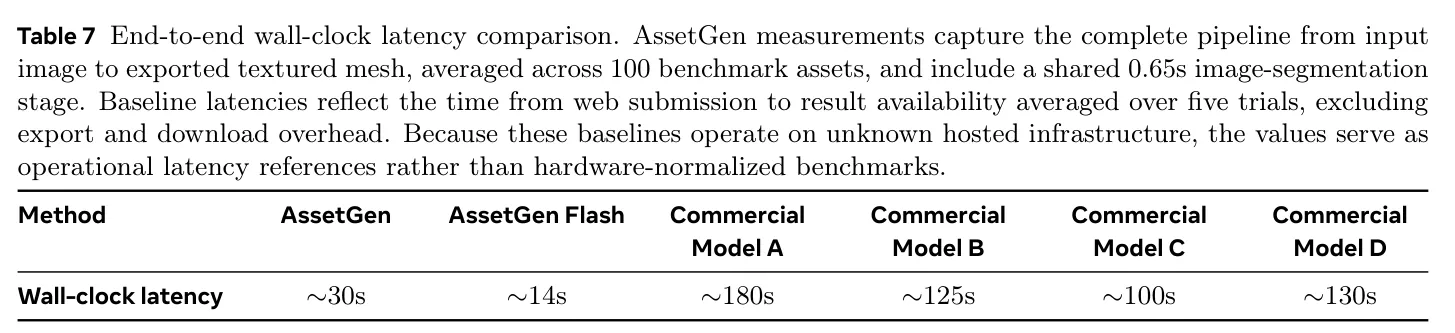
看 Table 7 的端到端挂钟延迟对比(已包含 0.65s 的输入图前景分割耗时):默认 AssetGen 全流程耗时 30.10 秒,AssetGen Flash 耗时 13.95 秒,而四款主流商业 3D 生成服务(Commercial Models A–D)的端到端交付时间均在 55 秒 至 110 秒 之间。
6.2 累进优化阶梯:从 220.83 秒到 30.10 秒的每一步账本
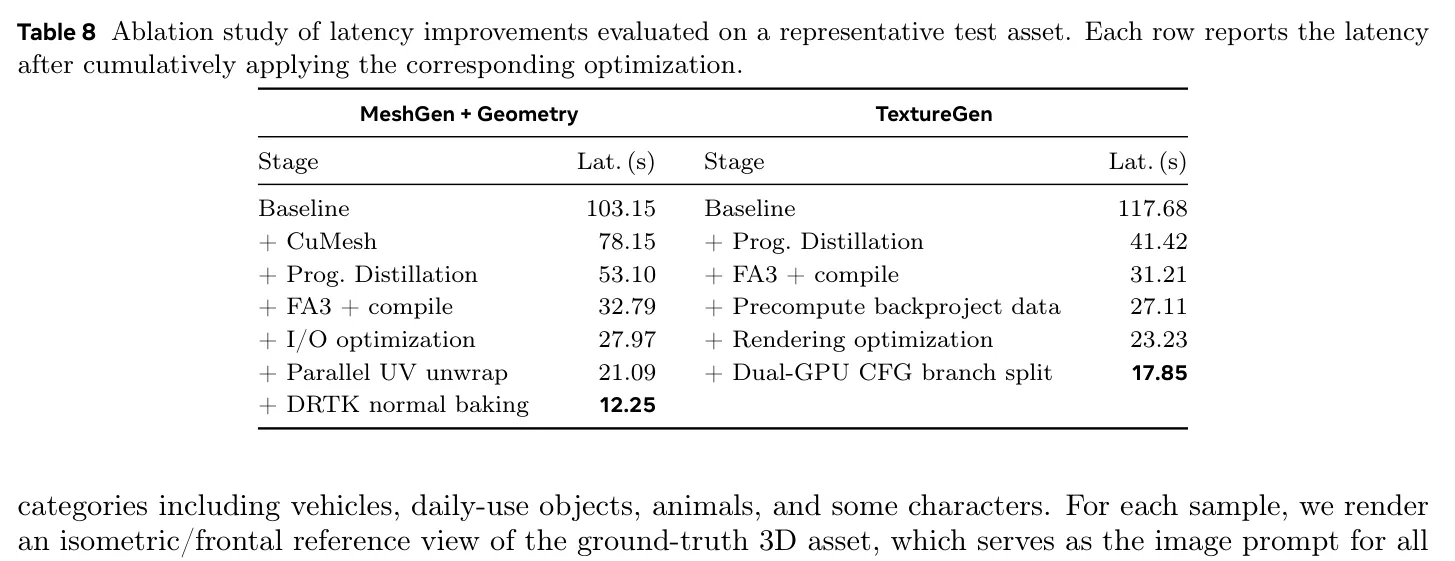
Table 8(Latency Optimization Ladder)是整篇论文含金量最高的一张工程账本——它在一个标准测试资产上,诚实地记录了系统是如何从最初 220.83 秒(103.15s 几何 + 117.68s 纹理)的未优化基线,一步一个脚印砍掉近 86% 延迟的:
- 在 MeshGen + 几何管线侧(
103.15s12.25s):- 把 CPU 减面换成 CuMesh GPU 减面:耗时从
103.15s降至86.10s(省下17.05s); - 引入 渐进式蒸馏 + CFG 折叠(120 步 30 步):耗时断崖式跌至
24.85s(一举省下61.25s!); - 开启 FlashAttention-3 +
torch.compile:降至17.30s(省下7.55s); - 异步 I/O 与驻留内存传输优化:降至
15.20s; - 并行化
xatlasUV 分割:降至13.10s; - 将 Blender 烘焙替换为 DRTK GPU 法线烘焙:最终压至
12.25s。
- 把 CPU 减面换成 CuMesh GPU 减面:耗时从
- 在 TextureGen 管线侧(
117.68s17.85s):- 引入 多视角流模型渐进蒸馏:耗时从
117.68s骤降至37.45s(省下80.23s!); - 开启 FA3 +
torch.compile+ FP8/INT8 选择性量化:降至25.60s(省下11.85s); - 将反投影映射与 KD-Tree 构建移入后台与扩散过程异步重叠:降至
22.15s; - 用 DRTK 替换 Blender 渲染 10 视角条件图并优化 GPU 反投影核函数:降至
19.90s; - 将推理期 CFG 的条件与无条件分支切分到两张 H100 上并行执行(CFG branch split):最终定格于
17.85s。
- 引入 多视角流模型渐进蒸馏:耗时从
这张表给所有生成式 AI 工程师上了一课:算法蒸馏决定了你能不能从“两分钟”进到“三十秒”,而图形算子 GPU 化与流水线重叠则决定了你能不能从“四十秒”真正跨进“十秒级交互”的大门。
7. 实验验证:AssetBench、CharacterBench 与 TRELLIS.2 同台对比
7.1 通用道具与高难度角色基准评测
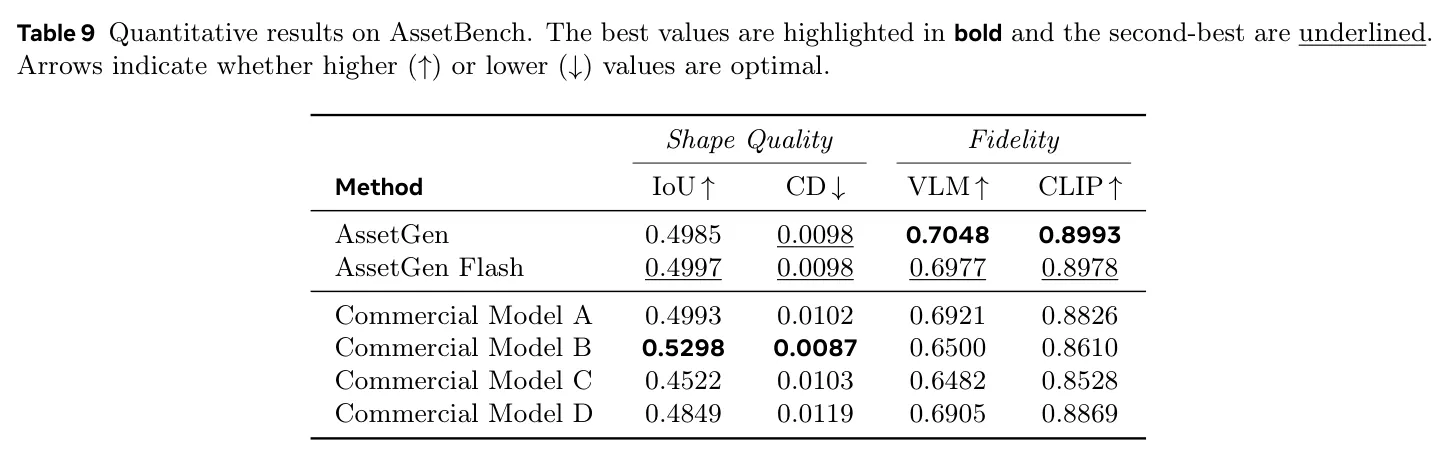
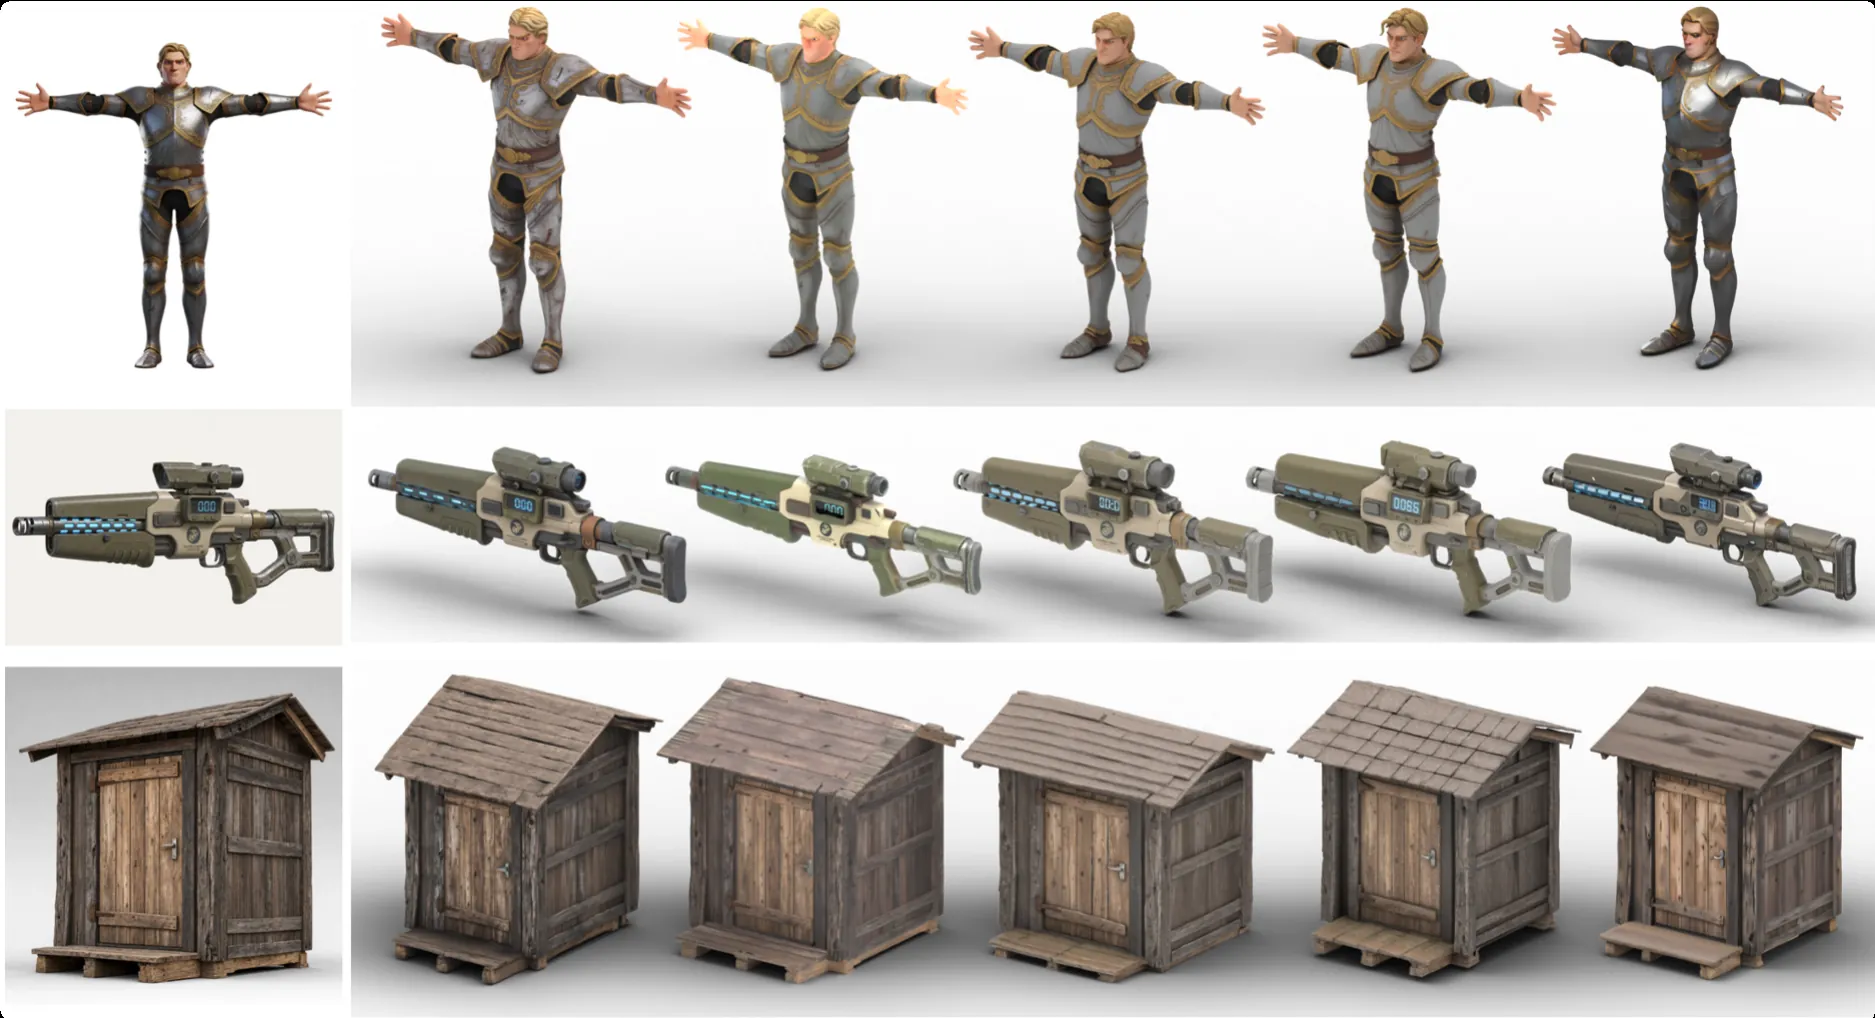
在由技术美术精选的 101 个高质量资产基准 AssetBench(Table 9 与 Fig. 6)上,评测同时考察三维体素重合度(IoU / Chamfer)与参考图对齐保真度(VLM 语义核验与 GT-CLIP 相似度)。结果显示,Commercial Model B 在纯体素几何重叠度上略高,但 AssetGen 在 VLM 语义一致性(88.58)与参考图外观保真度(GT-CLIP 91.61)上拿下全场第一,生成的贴图色彩锐度与细节丰富度明显更加贴合输入原图。
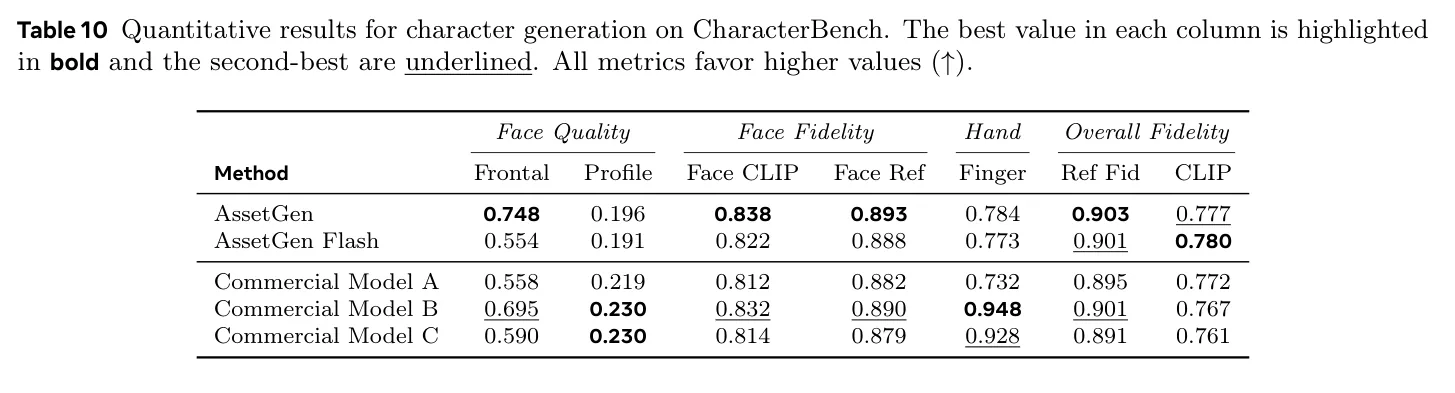
而在专门考验五官、手指与服饰细节的 CharacterBench(Table 10)上,差距进一步拉开:默认 AssetGen 在正脸质量(Frontal Face Quality 3.21)、面部 CLIP 对齐(84.89)、面部参考相似度(85.94)和手指结构还原度(Finger Ref 72.42)上全线夺冠。同时对比 AssetGen 与 AssetGen Flash 可以清晰看到两阶段精炼的价值:跳过 16384-token 几何精炼与 1022px 高清 DINOv2 条件后,Flash 版的正脸几何评分从 3.21 回落到了 2.73——这印证了高密度空间锚点 Token 对雕刻五官等毫米级起伏的决定性作用。
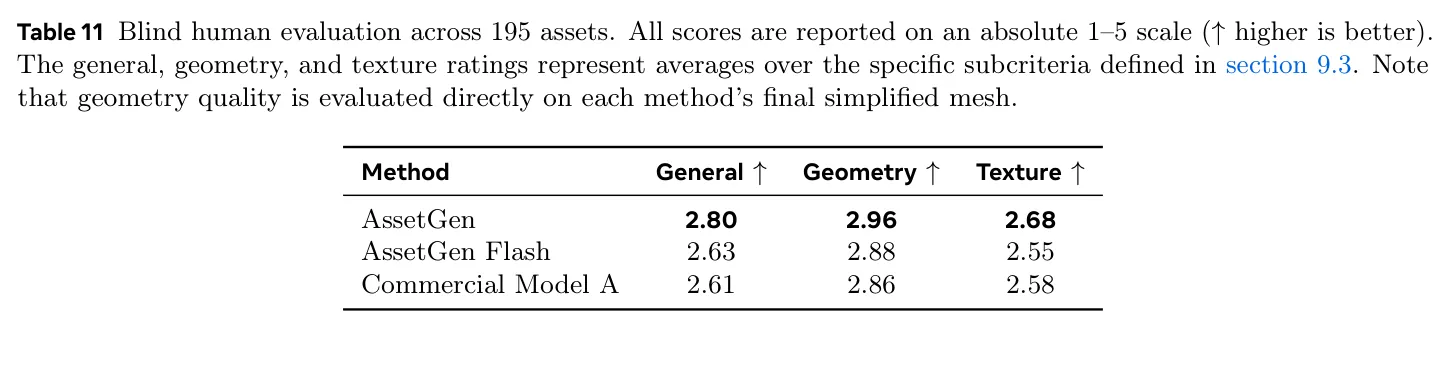
在涵盖 195 个资产的双盲人工主观打分(Table 11,1~5 分制)中,默认 AssetGen 在整体质量(3.45)、几何质量(3.47)和纹理质量(3.35)三个维度上均位列第一,用不到商业模型一半的耗时实现了更优的主观验收品质。
7.2 当 23K 面运行时低模遇上 100 万面 TRELLIS.2 高模
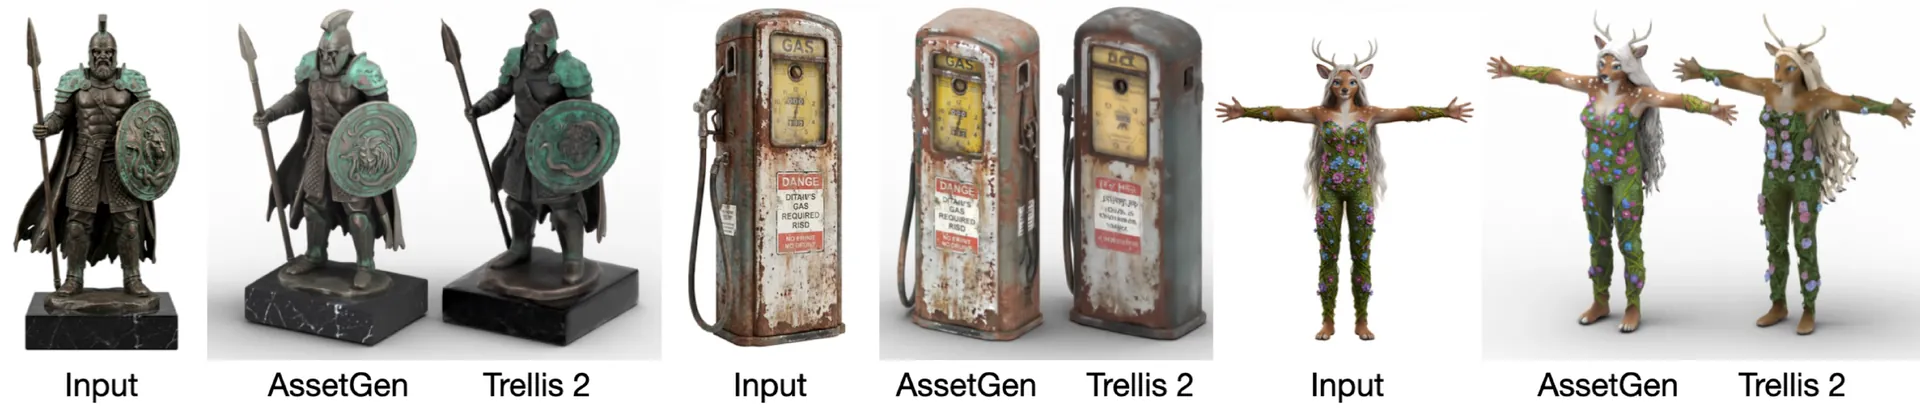
Fig. 7 展示了一组极具代表性的跨路线对决:AssetGen vs. TRELLIS.2。
- 按照 TRELLIS.2 的默认推荐配置,导出的网格保留了约 100 万个多边形面片(1M Polygons)以维持其原生体素细节;
- 而 AssetGen 导出的网格经过 CuMesh QEM 简化,平均只有约 23K 个多边形面片(面数仅为对方的 !),其余细节全部由 271ms 烘焙出的切线空间法线贴图与 2K 彩色贴图承载。
看 Fig. 7 的并排渲染效果:在大幅降低 97% 以上面数开销、且具备可直接导入移动端引擎的干净 UV 图集的前提下,AssetGen 呈现出的视觉锐度与光影立体感完全不输百万面级高模。
7.3 多风格主题画廊与真实世界照片鲁棒性
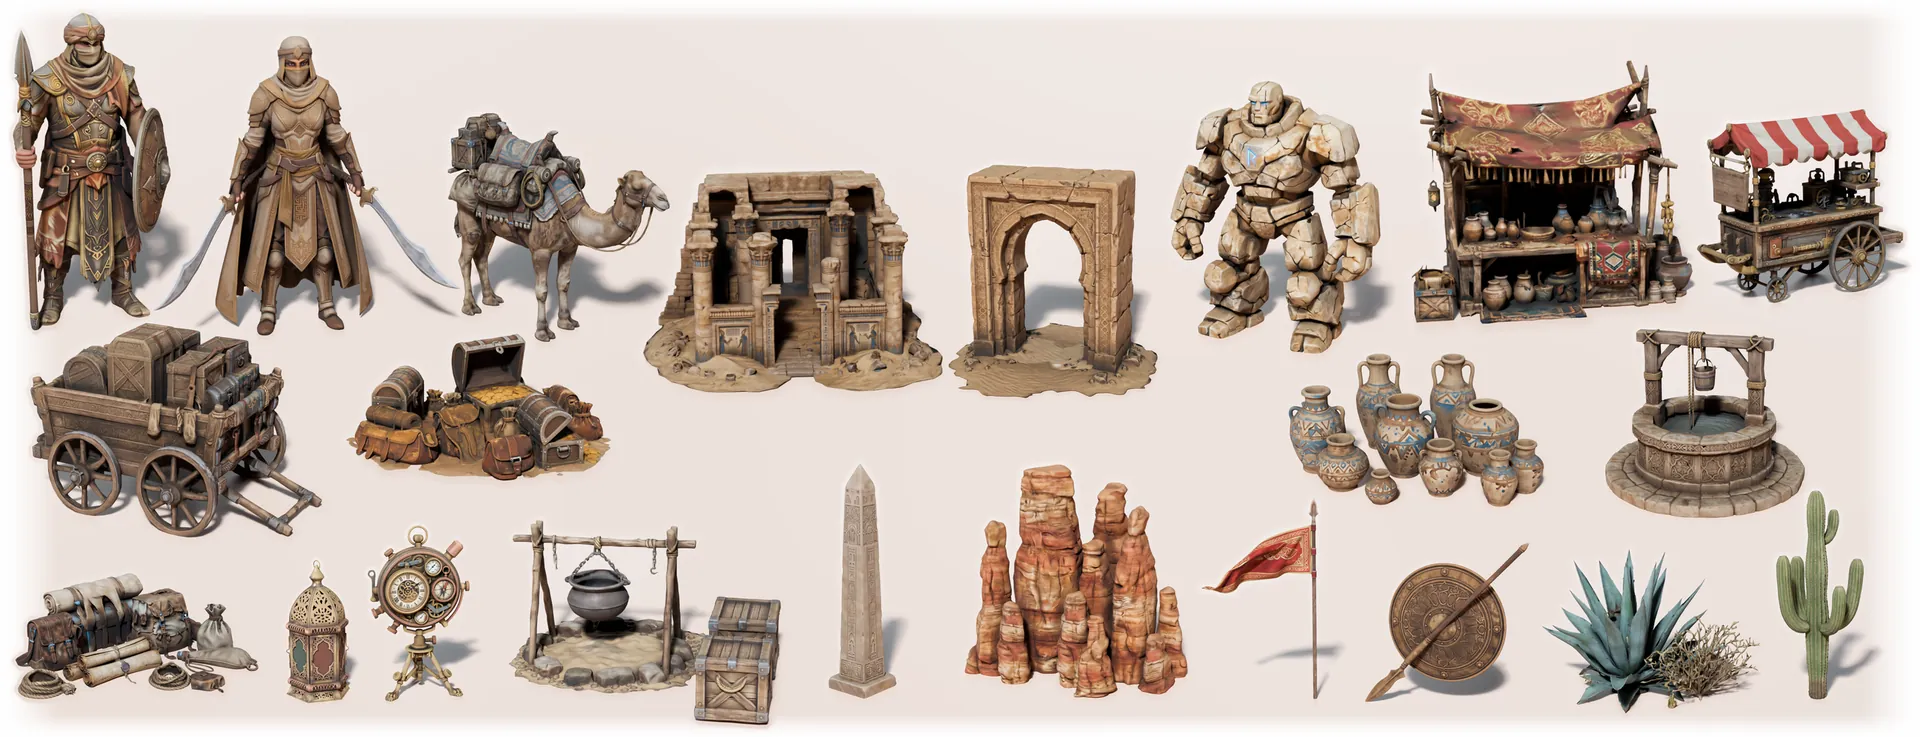
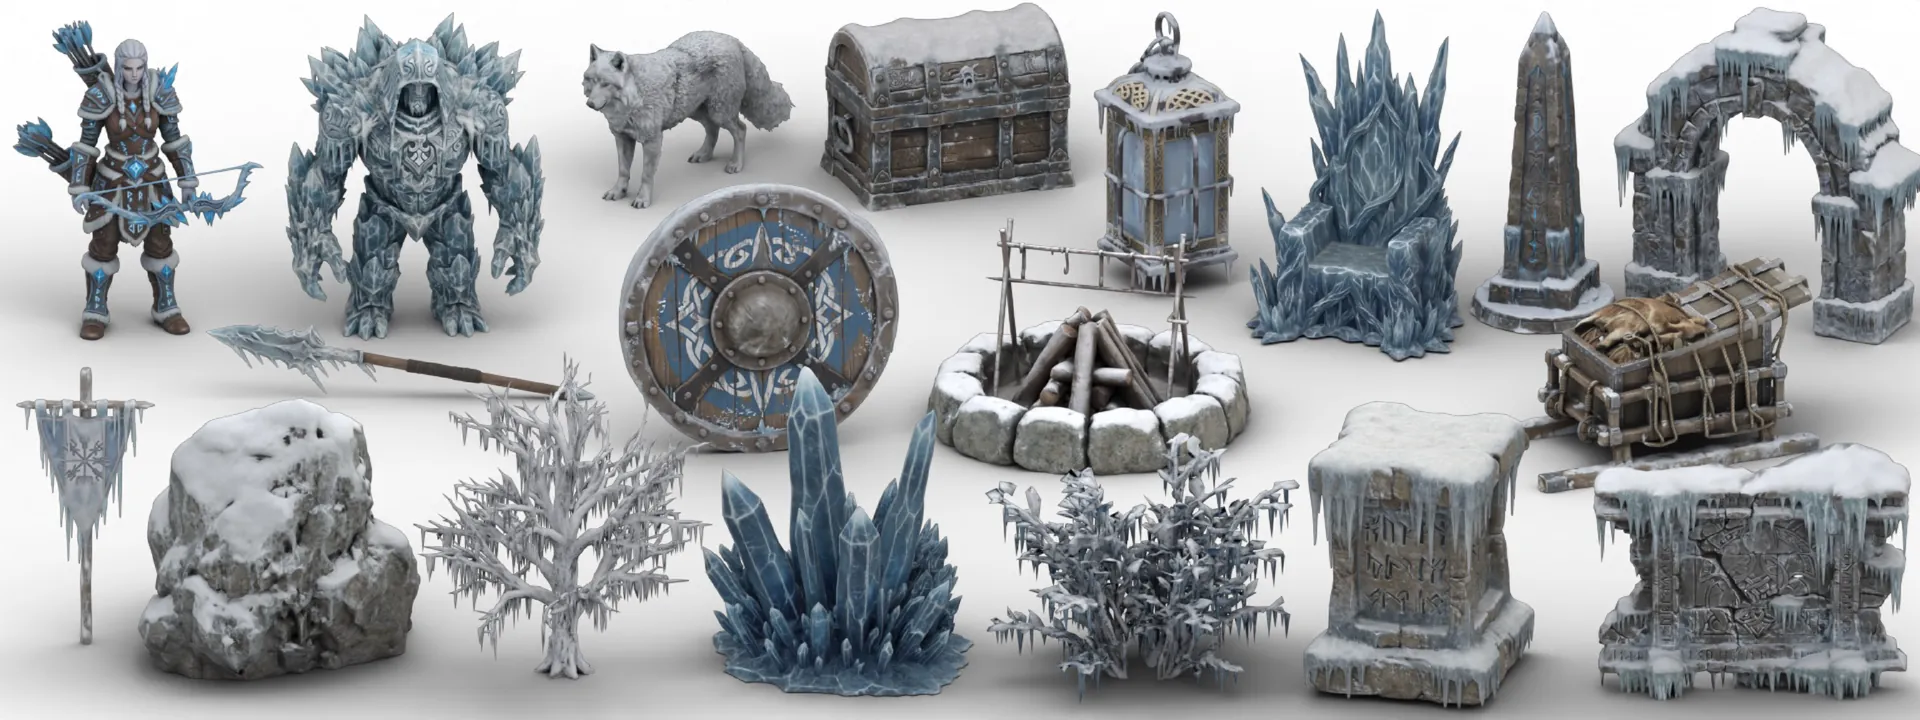
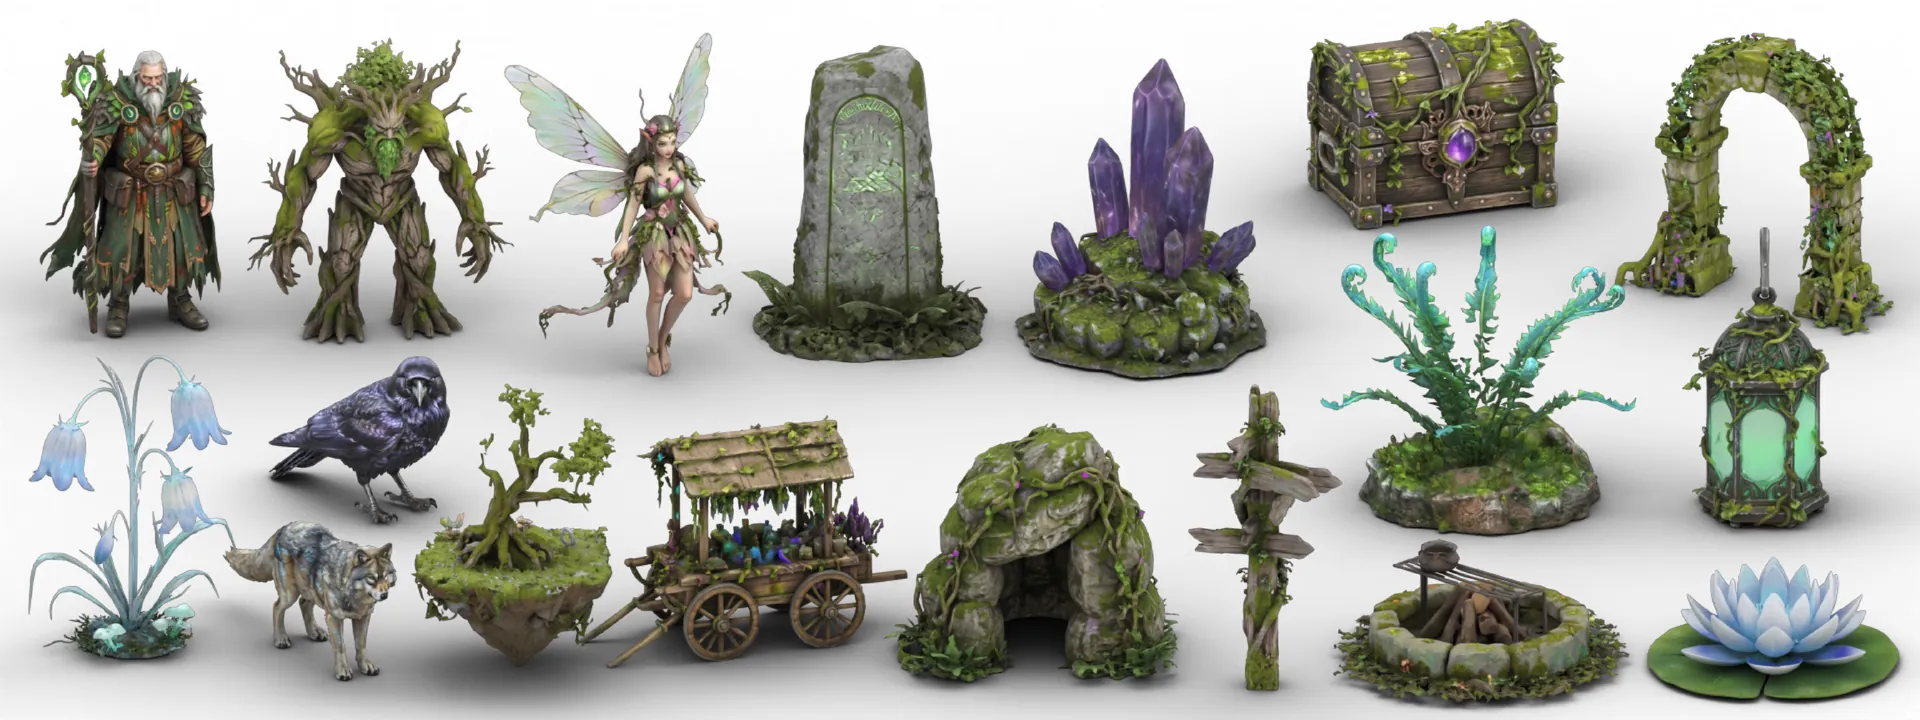
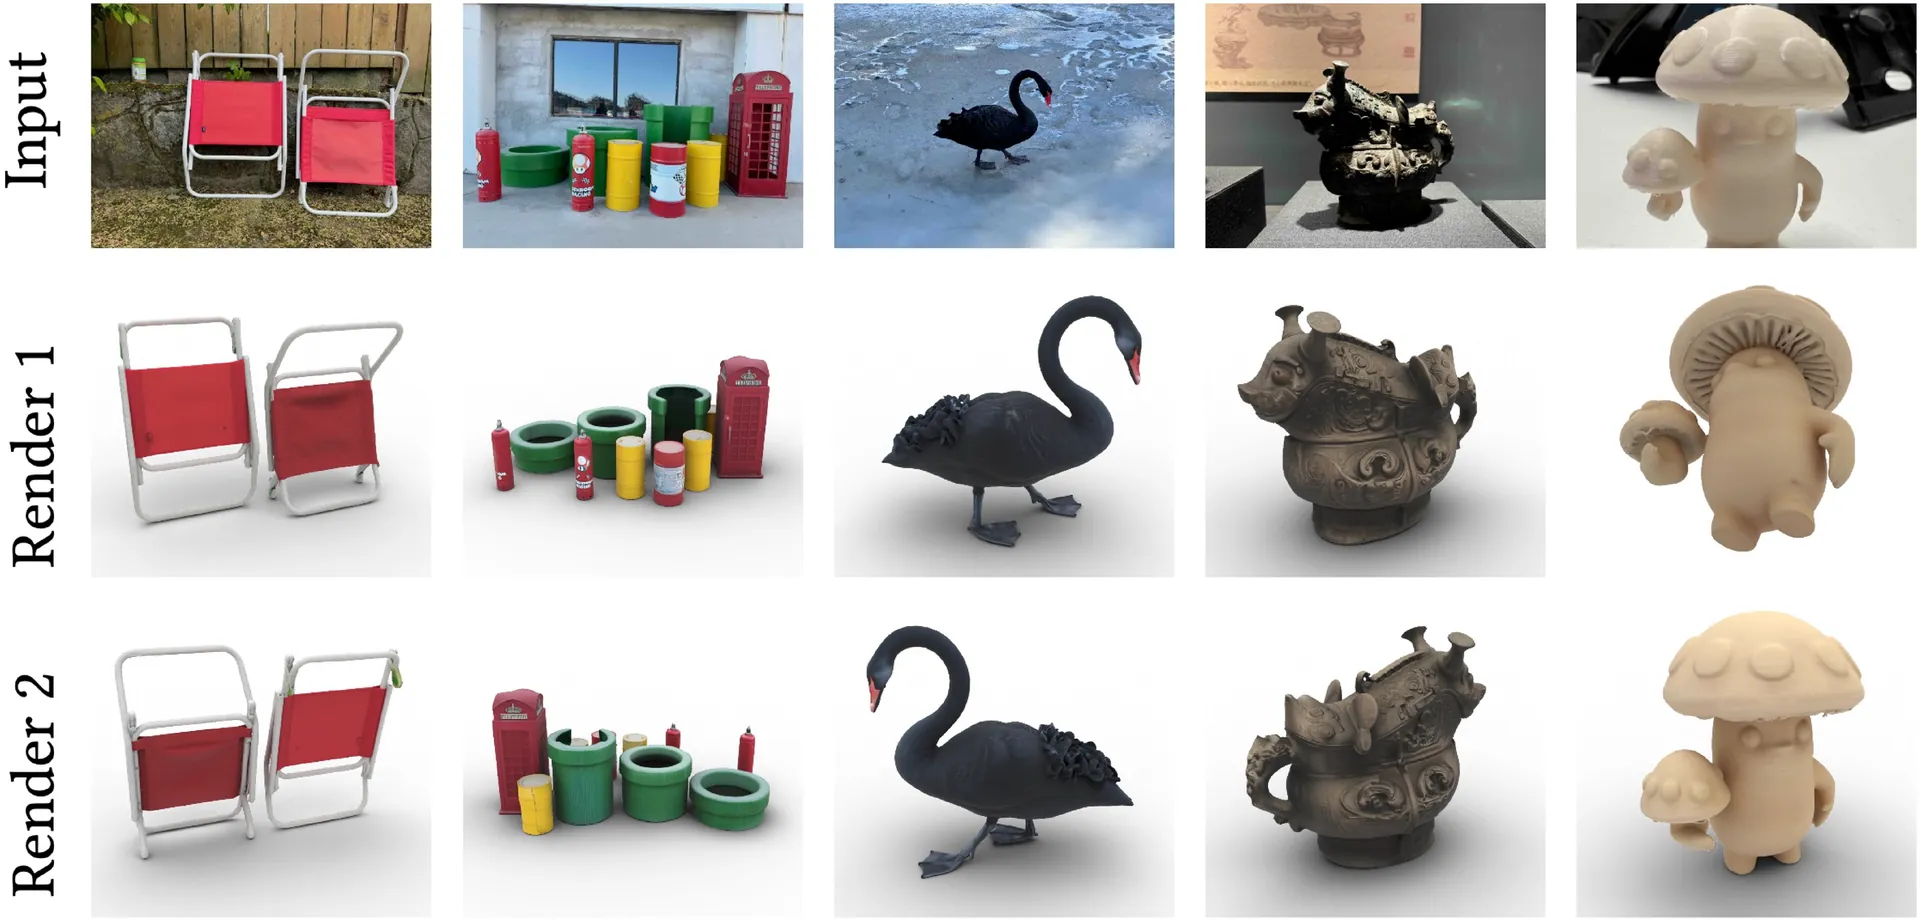
Fig. 8 至 Fig. 11 进一步展示了默认模式生成的沙雕(Sand)、冰雪(Ice)主题画廊、Flash 模式 14 秒生成的魔法森林(Magic Forest)画廊,以及直接输入手机随手拍的真实世界照片(Real-world Inputs,包含复杂环境光、杂乱背景分割毛刺乃至局部遮挡)时的稳健补全效果。
8. 工程局限与横向生态坐标:在 3D 视觉版图中的位置
客观审视 AssetGen 的系统边界,它目前仍有三处尚未跨越的工业门槛:
- 静态渲染低模与骨骼动画拓扑(Animation-Ready Topology)的距离:虽然 CuMesh 减面能够把面数压到 5K~23K 并保住外表面法线,但底层由 Marching Cubes + QEM 坍缩出来的依然是不规则三角网格,缺乏角色美术师手工布设的环状肌肉边流(Edge Flow),关节弯曲变形时容易出现折痕,尚不能直接免拓扑用于角色绑定(Rigging)与蒙皮动画。
- 省略完整 PBR 分解的取舍:为了迁就移动端实时着色的轻量化需求,TextureGen 直接预测合成色彩贴图而未分离金属度与粗糙度贴图;若下游需要在强动态光源变化的次世代主机场景中进行物理重光照,则需参考前作 Meta 3D AssetGen (2024) 或 TRELLIS.2 引入显式的 PBR 材质通道预测。
- 单视角三维欠约束性:当输入图像仅展现物体正面时,背面的非对称机关或复杂文字依然依赖生成先验脑补。
如果把 AssetGen 放进本站精读过的三维生成与场景理解全貌中,四篇单图 3D 资产论文恰好构成了一张清晰的“速度—保真度—可部署性”光谱:
- SF3D(
0.5 秒,前馈重建路线):站在极速端。用单次前向的 DINOv2 + Triplane + DMTet 配合箱体投影快速 UV,在半秒内给出一个带基础粗糙度/金属度与去光照贴图的轻量 GLB,适合超低延迟实时预览,但背后不可见区域与复杂拓扑上限受限于确定性重建。 - TripoSG(数十秒,4B MoE + 2M 清洗数据 SDF 流匹配路线):站在纯几何雕刻端。专注于用连续 SDF + 法线梯度 + Eikonal 混合监督的 VAE 与大规模 Rectified Flow 把单图转白模网格的几何细节推向极致,但不直接负责减面、UV 与法线烘焙。
- TRELLIS.2(
3~60 秒,无场 O-Voxel + 16x SC-VAE 4B 流匹配路线):站在原生表示与物理材质端。从底层推翻水密 SDF 假设,在统一稀疏体素上同时生成开放/非流形几何与四通道 PBR 材质。 - AssetGen(
14 秒 Flash / 30 秒 Default,VecSet 扩散蒸馏 + 全 GPU 图形管线路线):站在工业级实时引擎交付端。它告诉整个社区:要想让 3D 生成大模型真正走进游戏与 XR 生产线,不能只盯着扩散模型本身,必须把减面、消隐、UV 展开、切线法线烘焙、三维感知贴图修补与异步流水线调度当成一个完整的系统工程来打磨。
参考资料
- Dilin Wang, Xiaoyu Xiang, Kihyuk Sohn, Tom Monnier, Yu-Ying Yeh, Thu Nguyen-Phuoc, Jiawen Zhang, Yuchen Fan, Antoine Toisoul, Hyunyoung Jung, Prithviraj Dhar, Michael Bunnell, Nikolaos Sarafianos, Chuhang Zou, Roman Shapovalov, Andrea Vedaldi, Rakesh Ranjan, AssetGen: Deployable 3D Asset Generation at Interactive Speed, arXiv:2605.26137v1(PDF、HTML).
- 前代与对比系统:Meta 3D AssetGen (2024)、TRELLIS.2、3DShape2VecSet (SIGGRAPH 2023)
- 底层几何与系统加速组件:CuMesh、xatlas、DRTK (Differentiable Rasterization Toolkit)、FlashAttention-3
comments