在二维图像与视频生成领域,当研究者把 U-Net 换成 DiT、把弯曲的 DDPM 扩散轨迹换成笔直的流匹配(Rectified Flow),再把训练语料推上亿级规模时,SD3 与 FLUX 立刻展现出了惊人的规模定律(Scaling Law)。然而在很长一段时间里,这套“大力出奇迹”的配方搬到三维形状生成(3D Shape Synthesis)上却频频失灵:直接把 80 万个原始 Objaverse 三维模型喂进更大的扩散 Transformer,生成的网格依然边缘圆钝、孔洞粘连,甚至连椅子腿的朝向都经常拧麻花。
为什么在 2D 领域百试百灵的 Scaling 配方,到了 3D 几何生成里会突然卡壳?
VAST、香港大学、德克萨斯大学奥斯汀分校与上海人工智能实验室团队在 ICML 2025 论文 TripoSG: High-Fidelity 3D Shape Synthesis using Large-Scale Rectified Flow Models(PDF、HTML 全文、项目主页、官方代码 VAST-AI-Research/TripoSG、Hugging Face 权重 VAST-AI/TripoSG)中,用一套极具说服力的系统架构与对照实验揭开了谜底。
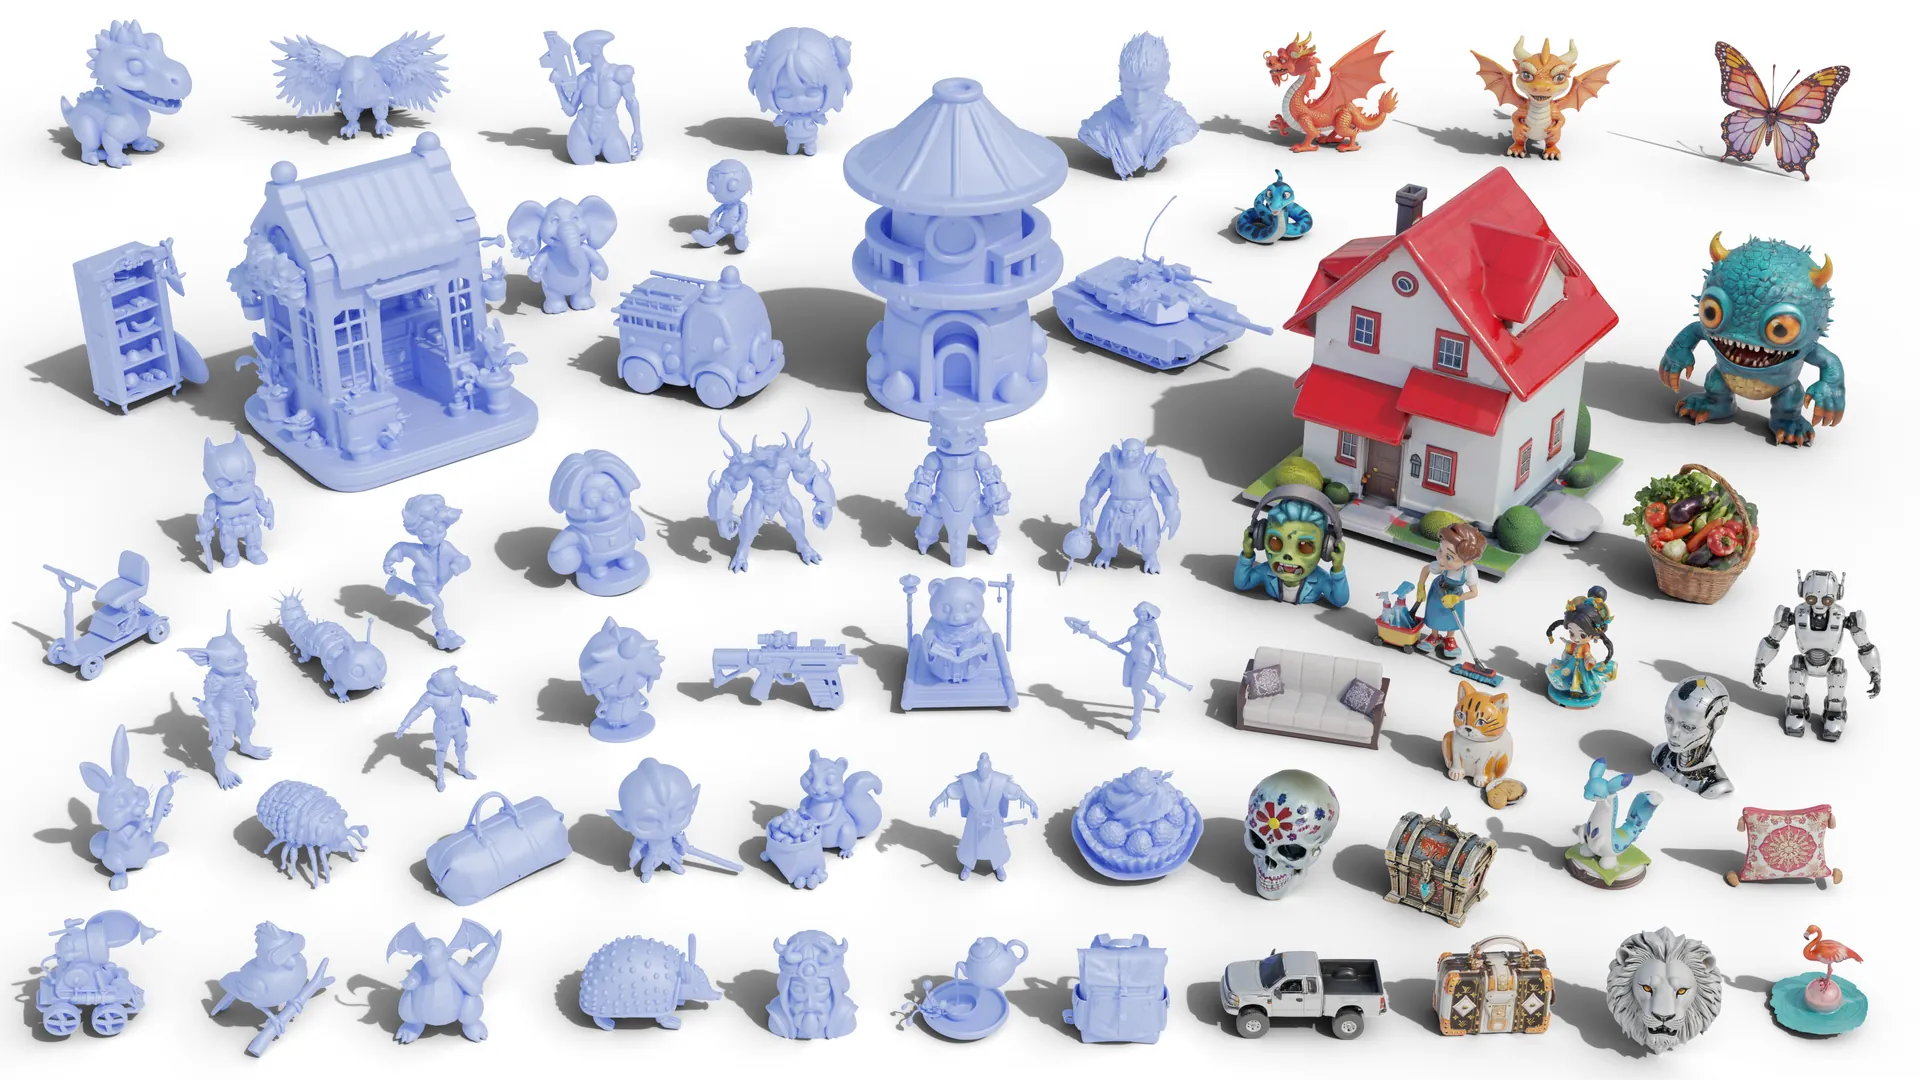
透过 Fig. 1 中那些连昆虫触角、机械齿轮、哥特建筑尖顶与动漫服饰飘带都雕刻得毫发毕现的白模网格,TripoSG 的成功建立在四条环环相扣的设计哲学之上:
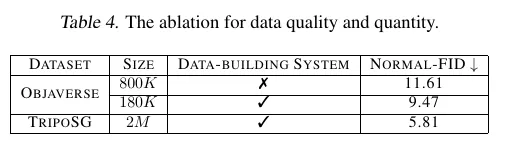
- 三维数据先过“信噪比生死线”,再谈“规模定律”(Data Quality Gate Before Scaling Law):二维互联网图片哪怕构图再差,至少是一张合法的自然光学投影;而原始三维资产库里充斥着法线反装、内部碎面、扫描破洞与朝向错乱的“几何毒药”。实验证明,直接用 80 万未清洗 Objaverse 训练,几何分布误差 Normal-FID 高达
11.61;用自动化评分与过滤管线狠心砍掉 78% 的脏数据、仅保留 18 万高纯度样本训练,Normal-FID 反而骤降至9.47!只有先守住这道几何信噪比底线,再通过修复与多焦距增强将干净样本扩充到 200 万(2M),三维 Scaling Law 才会真正爆发(Normal-FID 断崖式压低至3.36)。 - 同时在“标量值域”与“一阶梯度域”监督 SDF-VAE,用自动微分锁死刀锋折角(Value + Gradient Domain Supervision over Binary Occupancy):二值占用率(Occupancy)分类天然会在曲面上留下等高线台阶;而如果只用 监督连续符号距离场(SDF)的标量值,细小的凹槽和衣纹依然会被平滑吞没。TripoSG 在 VAE 解码器中直接对三维查询点坐标求一阶自动微分 ,用表面法线方向对齐损失雕刻锐利转折,再用 Eikonal 单位梯度模长正则抚平过强法线引导诱发的场震荡。
- 用 U-ViT 长跳跃连接保住浅层几何,用 CLIP + DINOv2 双路交叉注意力兼顾全局语义与毫米级纹理(Long Skip Connections + Dual Global/Local Conditioning):纯堆叠深层 Transformer Block 会让三维局部几何线索在逐层抽象中流失,引入连接对称编码-解码块的 Long Skip Connection 单项改动就能让 Normal-FID 下降近 1 个点;同时每一层并行注入 CLIP 全局语义特征(防类别与朝向错乱)和 DINOv2 局部结构特征(对齐局部褶皱与部件),配合直线轨迹的 Rectified Flow 与对数正态时间步重加权,实现精准的图模对齐。
- 靠无位置编码 FPS 查询直接外推 4096 Token,只在解码器深层挂载 MoE 扩容至 4B(Pos-Encoding-Free Token Extrapolation & Deep-Layer MoE):由于前端点集 VAE 靠最远点采样(FPS)提取查询点,不依赖固定长度的绝对位置编码,因此流模型微调时能丝滑地将潜空间序列从 2048 直接翻倍外推至 4096 Token(开源社区版提供
1.5B / 2048-token权重,论文旗舰版扩展至4B / 4096-token);并且只在专门负责局部高频细节合成的最后 6 层解码器 Block 中将 FFN 替换为 Top-2 + 共享专家的混合专家层(MoE),用极小的推理算力增量换取了 4B 参数的几何容量。
下面我们就顺着这四条设计哲学,结合论文推导与开源仓库源码,逐一拆解 TripoSG 的核心机制。
1. 为什么 3D 形状生成长期落后于 2D 图像?双系统架构总览
回看图像与视频大模型的崛起,它们天然站在三个肩膀上:过硬的训练数据质量、几乎无损的高倍率 VAE 潜空间、以及极具扩展性的 DiT + Flow Matching 主干。而在单图三维形状生成()中,这三根支柱全都需要从头加固:
- 数据层:Objaverse 与 ShapeNet 原生资产存在大量破损拓扑、丢失纹理与随机坐标系,直接训练会让网络把几何缺陷当成物体结构的一部分;
- 表示层:三维网格顶点连接离散,必须先通过三维 VAE 压缩成规整的潜变量序列 ;一旦 VAE 解码器本身存在等值面台阶或抹平了薄壳细节,后端的生成模型再强也越不过 VAE 的天花板;
- 条件生成层:单张输入图片只拍到了物体正面,确定性回归模型(如 LRM / TripoSR)在不可见背面容易产生坍缩伪影,而生成式模型则必须解决单视角条件与三维潜空间之间的细粒度空间对齐。
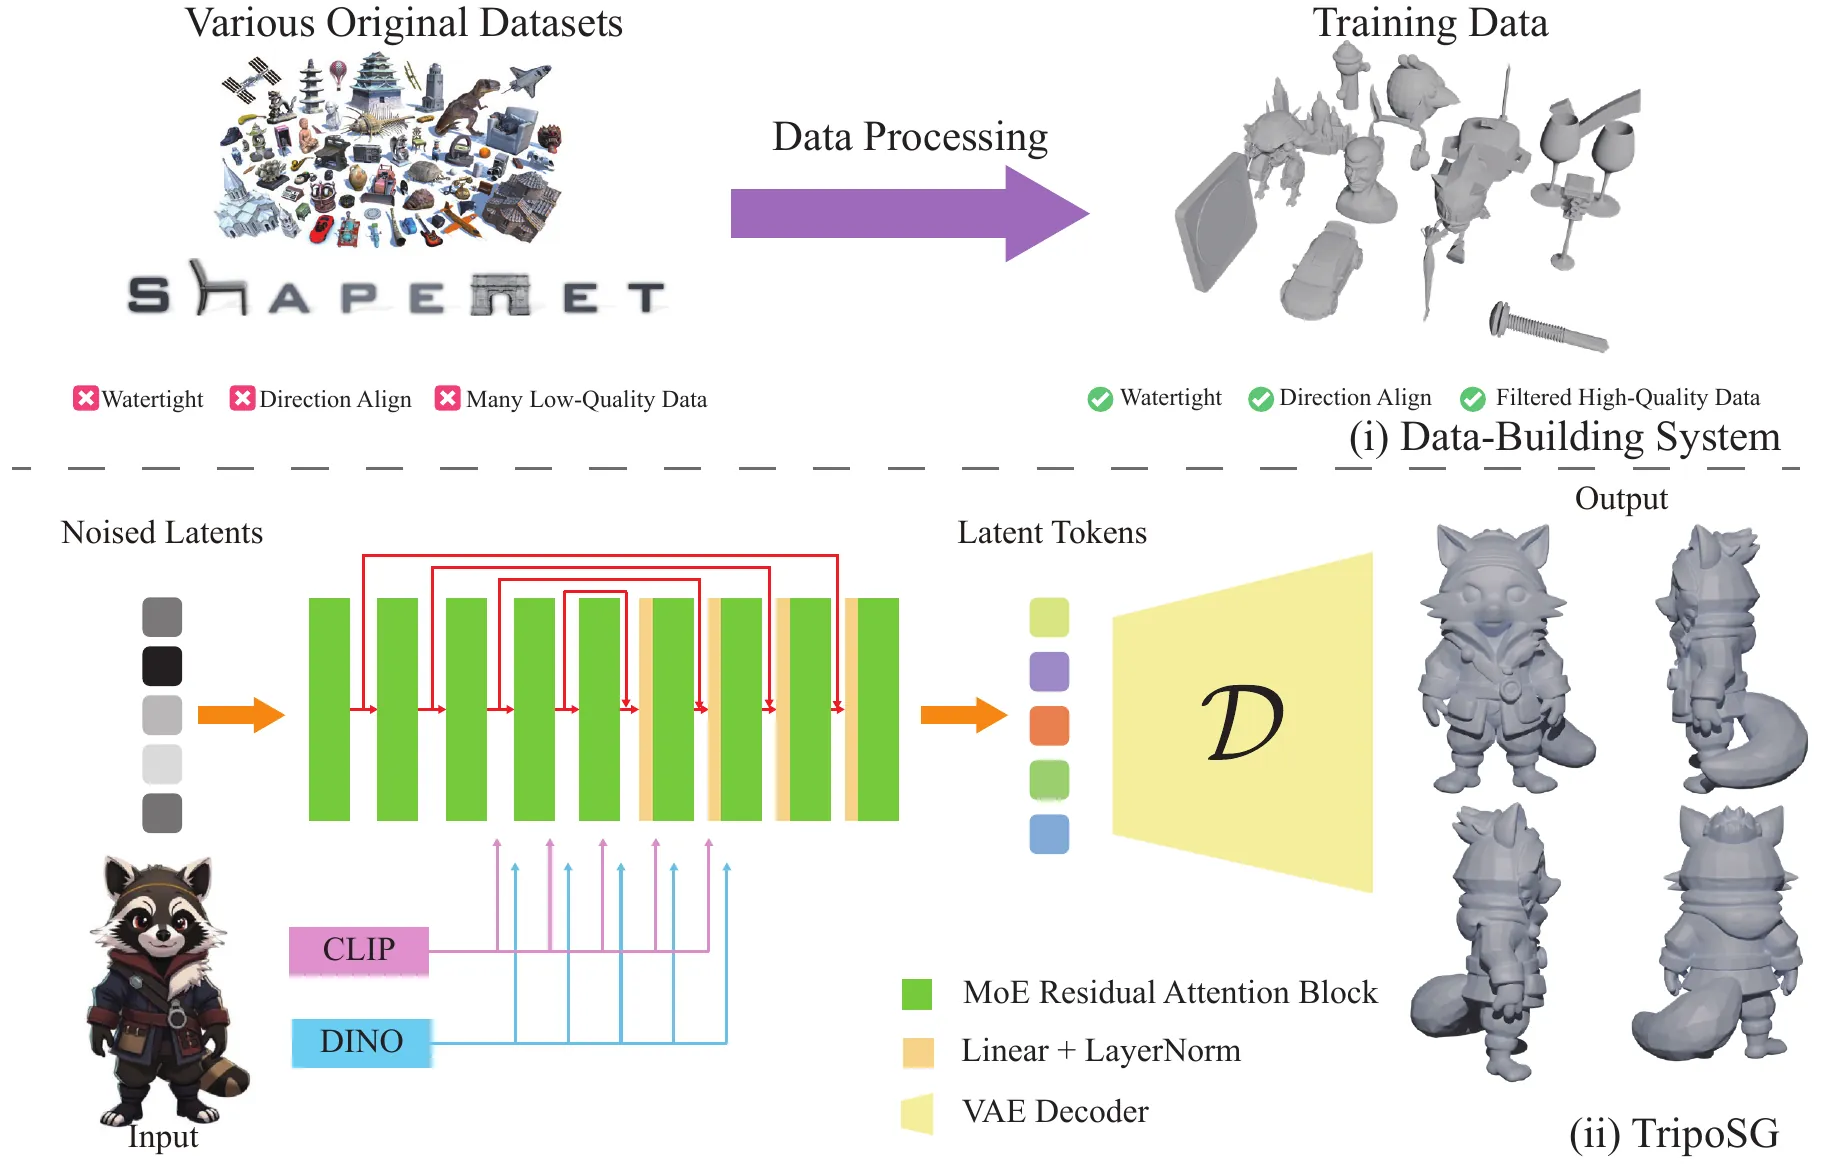
为此,Fig. 2 将 TripoSG 设计为“数据工程”与“模型架构”双轮驱动的系统:
- 上半部分(Data-Building System):从多源原始三维模型出发,依次走过打分(Scoring)、过滤(Filtering)、网格修复与多视角相机增强(Fixing & Augmentation)以及隐式距离场生产(Field Data Production),炼出 200 万对高纯度 Image-SDF 样本;
- 下半部分(TripoSG Model):先训练混合监督的 Transformer SDF-VAE 将三维表面编码为潜空间 Token,再训练融合了 CLIP 与 DINOv2 双条件的 Rectified Flow Transformer 从噪声生成潜变量,最终经八叉树等值面提取输出高精度三角网格。
2. 核心设计哲学一:同时在“值域”与“梯度域”监督的高保真 SDF-VAE
2.1 为什么二值 Occupancy 必然产生台阶,而单靠 SDF 数值回归还不够?
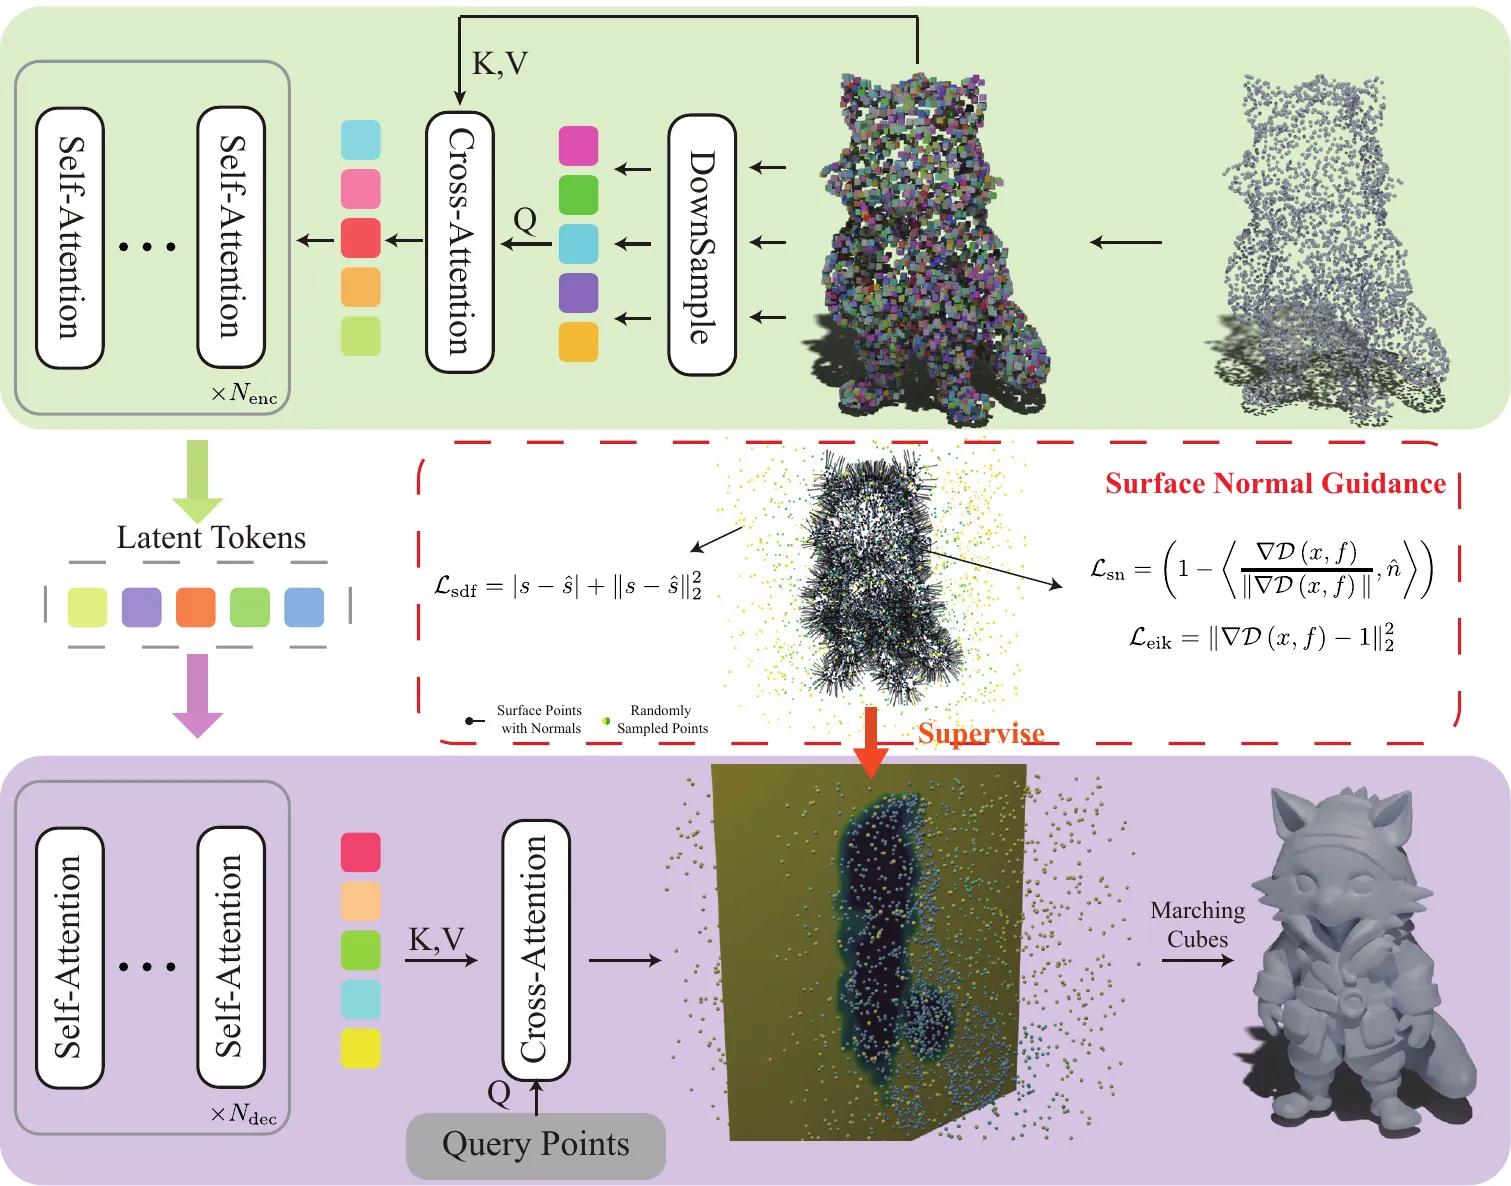
先看前端的压缩基石 SDF-VAE(Fig. 4,注意论文正文中先画了流模型 Fig. 3、再画了 VAE Fig. 4,我们按逻辑依赖关系结合两图一起看)。VAE 编码器从物体表面采样高密度点云(20,480 个点及其表面法线),利用最远点采样(FPS)抽取 个锚点,经交叉注意力与自注意力层编码为通道数 的潜变量分布;解码器 则接收重参数化采样出的潜变量特征 ,并通过交叉注意力回答任意空间三维查询点 的隐式场数值。
这里第一个关键抉择是:解码器到底该预测二值占用率(Occupancy),还是连续符号距离场(SDF)?
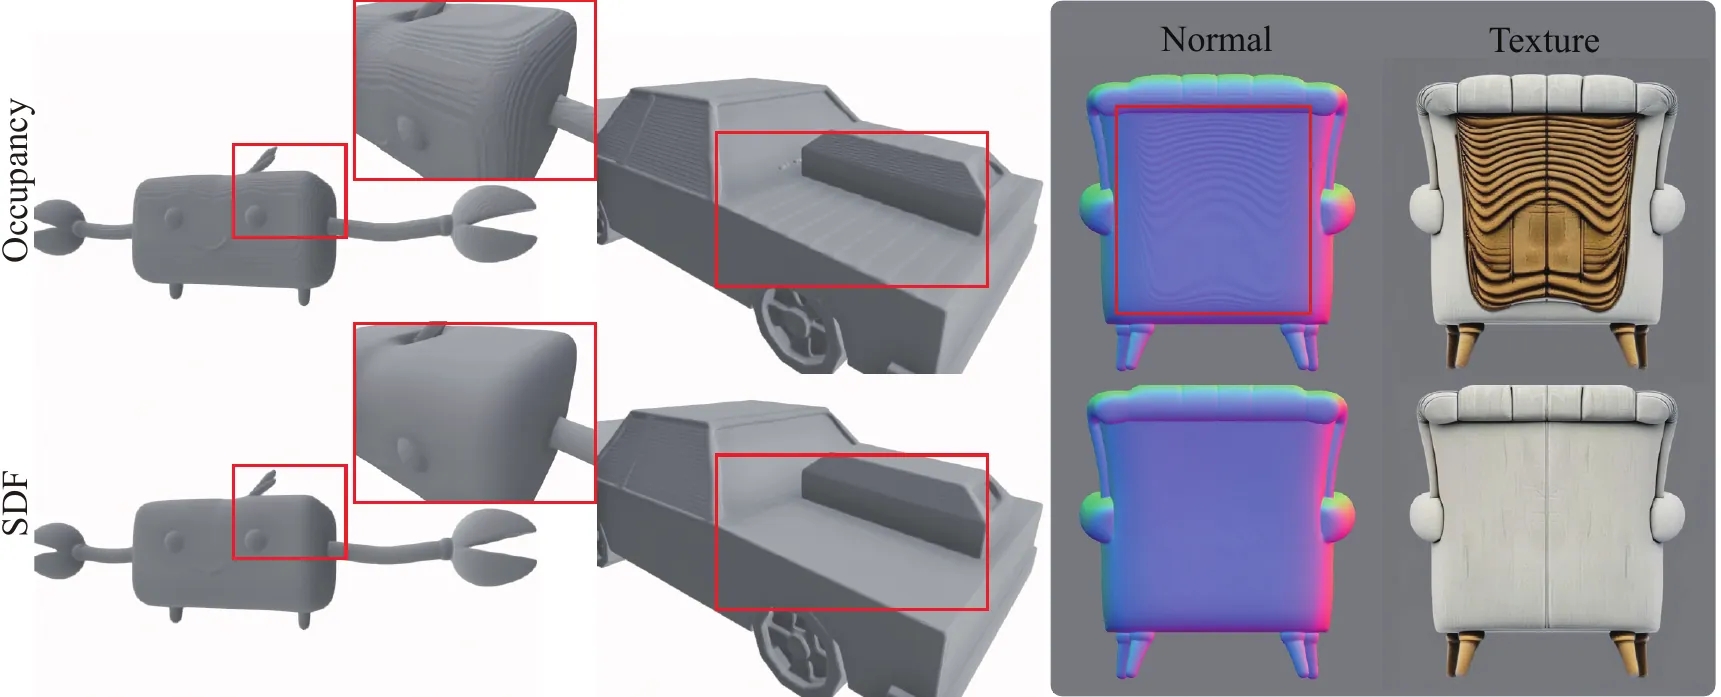
许多早期 3D 潜空间扩散模型(如 3DShape2VecSet、Michelangelo)为了训练省事,把解码器定义成二分类器:预测点 在物体内部()还是外部(),用二元交叉熵 训练。但这在几何上非常粗糙——离表面 0.1 毫米的点和离表面 10 厘米的点,分类标签全都是 ,网络在跨过零等值面的瞬间缺乏连续平滑的距离梯度约束。结果就如 Fig. 5 左列所示:抽出来的网格表面布满了一圈圈难看的等高线阶梯伪影(Staircasing / Aliasing),薄片结构更是直接断裂成悬浮碎块!
改用连续截断符号距离场(TSDF,记为 )并同时施加 与 值域回归损失:
可以立刻消除大面积的阶梯走样(Fig. 5 右列)。但作者敏锐地发现:只管住 SDF 的标量值 依然不够!为什么?因为盔甲上的细微刻痕、嘴唇的折角、衣服的薄褶皱,在 SDF 标量值上的起伏可能只有零点几个毫米,单靠 很容易被网络当成高频噪声平滑抹掉;但这些细微结构在表面朝向(即隐式场对空间坐标的一阶偏导数 )上却有着剧烈的方向转折!
2.2 表面法线梯度引导与 Eikonal 正则化的黄金搭档
为了把毫米级的折角逼出来,TripoSG 直接在 VAE 训练阶段打开了针对三维查询点坐标 的二阶计算图(对照源码 autoencoder_kl_triposg.py 中的 torch.autograd.grad(..., create_graph=self.training)),实时算出解码器输出对输入坐标 的空间梯度向量 ,并施加两项梯度域约束:
- 表面法线梯度引导(Surface Normal Guidance ): 根据隐式曲面定理,SDF 场在零等值面处的梯度方向必然垂直于曲面,即等于该点的单位表面法向量。因此,对于从真实网格表面采样出的点,直接强迫归一化后的场梯度方向与真值表面法线 的余弦内积趋近于 :
- 程函正则化(Eikonal Regularization ): 如果单独把法线损失 的权重开得很大,会发生一个有趣的副作用:网络为了拼命掰正表面那一层点的梯度方向,会让表面附近的梯度模长 忽大忽小剧烈震荡,反而在网格表面诱发出微小的波纹伪影。怎么稳住梯度场?在数学上,任何一个合法的欧氏符号距离场,在空间处处都必须满足程函方程(Eikonal Equation):距离随空间位置的变化率模长恒等于 (即 )。因此加入 Eikonal 正则项:
负责管住梯度的方向以雕刻锐利边缘, 负责锁死梯度的模长以保证距离场均匀平滑,再加上标量值域损失 与潜空间 KL 散度正则,共同构成了 TripoSG 的四合一 VAE 损失:
3. 核心设计哲学二:U-ViT 长跳跃连接、双路视觉注入与 4B MoE 矫正流
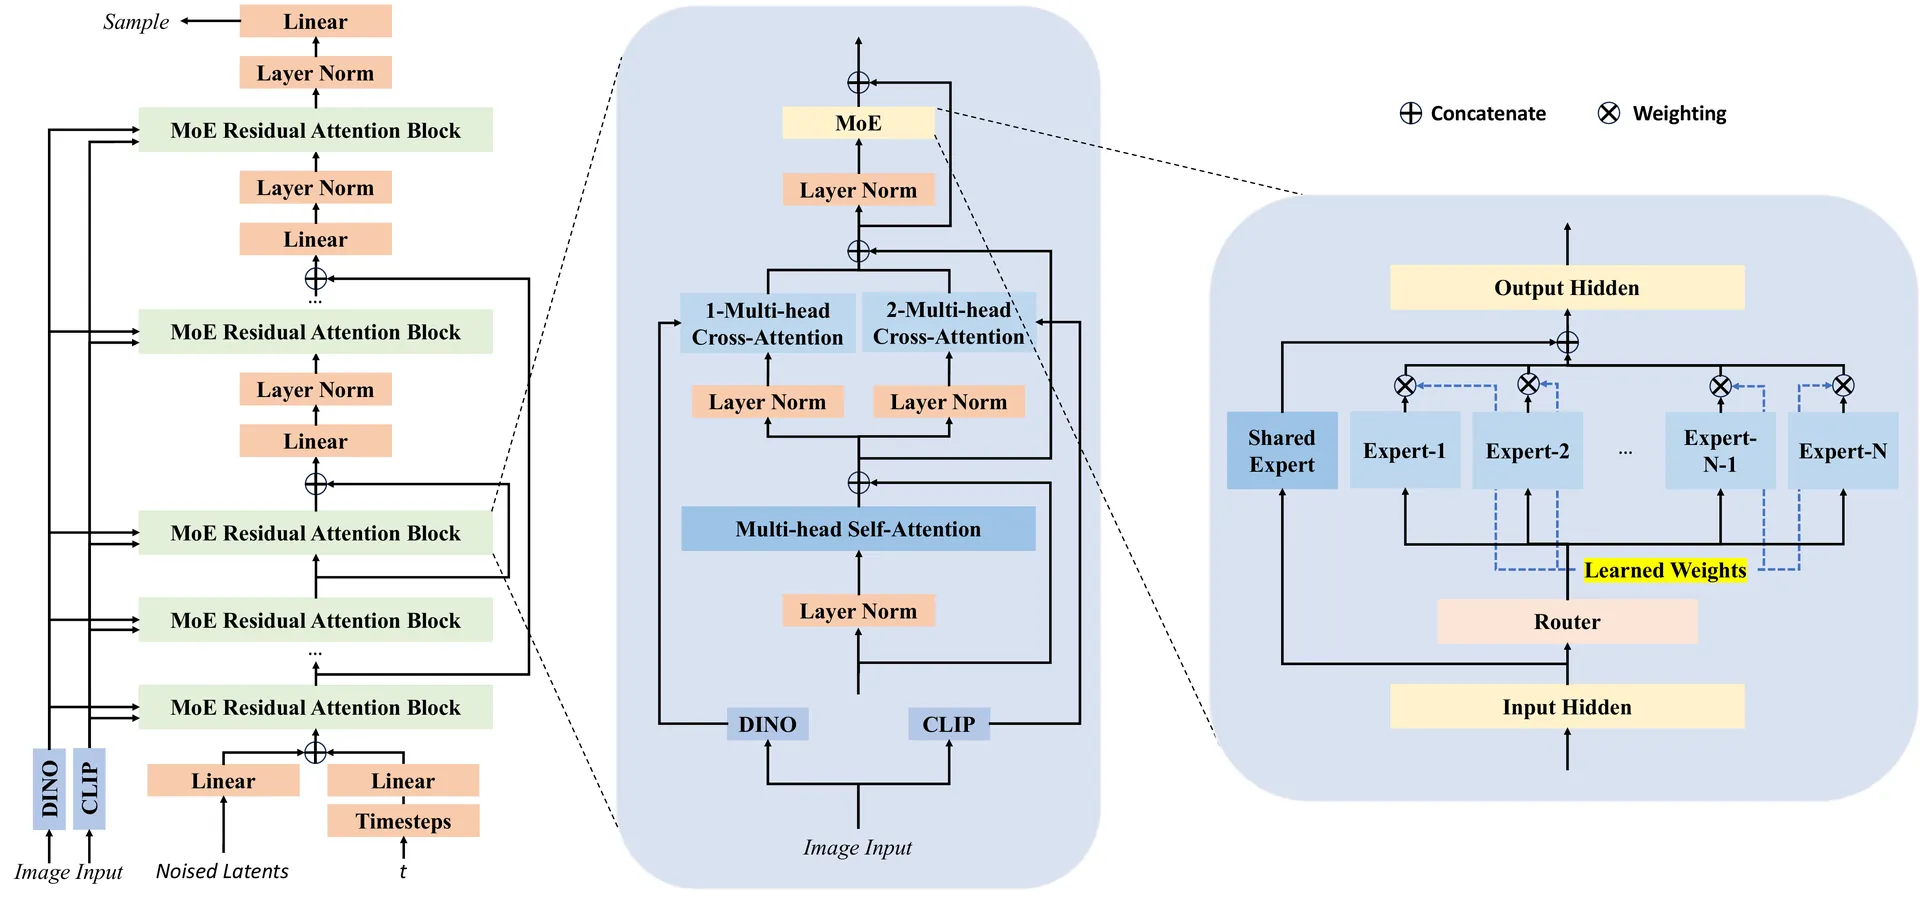
有了高质量的 SDF-VAE 潜空间 后,Fig. 3 展示了后端的 Rectified Flow Transformer 是如何把单张参考图转化为三维潜变量的。
3.1 为什么加一条 U-ViT 长跳跃连接,Normal-FID 就能猛降近 1 个点?
在标准 DiT 中,20 多层 Transformer Block 像一根直筒一样从头叠到尾。这在二维图像生成里问题不大,但在无序点集潜变量(VecSet)上却有个明显的痛点:浅层 Block 好不容易捕捉到的局部高频几何特征,经过十几层全局自注意力的反复混合与抽象后,到了输出端往往变得模糊退化。
为此,TripoSG(基础架构隐藏维度 ,16 个注意力头,共 层)借鉴 U-ViT 与 UNet,将前半截划分为编码器块 ,后半截划分为对称的解码器块 ,并在它们之间架起了长跳跃残差连接(Long Skip Connections):
在源码 triposg_transformer.py 中,解码器块直接把对应浅层编码器块的特征拼接回来再经线性层融合。这条直通车让浅层的局部几何锐度得以绕过深层语义瓶颈直达输出端——后文 Table 1 的消融实验证实,仅仅加上这条长跳跃连接,Normal-FID 就从 10.61 大幅改善至 9.47!
3.2 为什么要同时喂 CLIP 和 DINOv2?
再看 Fig. 3 中间的单个 Transformer Block 内部结构:在自注意力层之后,模型串联了两个独立的交叉注意力层(Cross-Attention),分别接入:
- (由 DINOv2-Large 提取的密集局部 Patch 特征):DINOv2 在自监督像素级对齐上极强,能看清图片里的衣扣位置、盔甲纹路与边缘轮廓;
- (由 CLIP-ViT-L/14 提取的全局语义特征):CLIP 经过海量图文对比训练,擅长把握物体的整体类别概念、三维对称性与不可见背面的语义合理性。
时间步 作为独立 Token 拼入潜变量序列 后,单层更新公式写为:
双剑合璧之下,DINOv2 负责把正面看得见的毫米级褶皱死死钉在对应位置,CLIP 则负责在看不见的背面合理补全符合该物种语义的完整结构。
3.3 Rectified Flow 线性轨迹与时间步重加权/分辨率偏移
在扩散/流匹配轨迹的选择上,传统 DDPM 的 与 EDM 的 走的是弯曲轨迹,采样时步长一大就会偏离流形。TripoSG 采用 Rectified Flow(矫正流),直接在噪声 ()与真实三维潜变量 ()之间拉一条笔直的线性插值轨道:
为了把这条直线轨道训得又快又稳,作者引入了两项精细的调度机制:
- 对数正态时间步采样(Logit-Normal Timestep Sampling): 当 (几乎全是噪声)或 (几乎已经是成品)时,预测速度方向很容易;真正决定三维大结构成败的硬骨头,全集中在 的中间混叠区。因此训练时用对数正态分布 把采样火力集中投向中间时间段:
- 分辨率自适应时间步偏移(Resolution-Dependent Shifting): 当潜变量 Token 数量从基础分辨率 (如 512 或 2048)扩充到高分辨率 (如 4096)时,由于点集变密、空间冗余度增加,原本在低分辨率下足以抹除形状的噪声比例,在高分辨率下却还留着清晰的轮廓残影(信噪比偏高)。为了补偿这一偏移,将时间步按平方根比例映射:
确保模型在扩展到 4096 Token 时依然面对一致的有效信噪比日程。
3.4 零位置编码外推 4096 Token 与解码器深层 MoE
怎么把 1.5B 的基础流模型进一步推向 4B 旗舰规模?TripoSG 走了两条极高性价比的扩展路径:
- 利用无位置编码特性直接外推 Token:回顾第 2.1 节的 SDF-VAE,它的编码器靠最远点采样(FPS)从点云里抽查询点,全程没有使用任何写死序列长度的固定位置编码!这意味着同一个训好的 VAE,天然支持把潜变量 Token 数量从 2048 直接翻倍到 4096,瞬间让三维潜空间能容纳的几何细节翻倍。
- 只在解码器最后 6 层引入混合专家(Deep-Layer MoE,见 Fig. 3 右侧):如果把所有层都粗暴加宽到 4B 参数,训练和推理算力都会翻倍。作者洞察到:网络的前半截编码器主要在处理跨类别共享的粗粒度三维姿态与大轮廓,根本不需要那么多参数;只有到了解码器的最后 6 层,模型才开始分化处理“昆虫翅膀纹路”、“机械齿轮齿牙”或“哥特教堂窗花”等高度特异化的局部细节。因此,TripoSG 仅在最后 6 个 Decoder Block 中将标准 FFN 替换为 8 专家 MoE 层(每次由 Router 动态激活 Top-2 路由专家 + 1 个常驻共享专家,配合负载均衡辅助损失):
这样一来,单次前向推理激活的计算量(FLOPs)几乎保持在 1.5B 模型的水位,却实打实地拥有了 4B 参数的几何细节记忆库!
4. 核心设计哲学三:为什么 18 万干净数据能打赢 80 万原始 Objaverse?
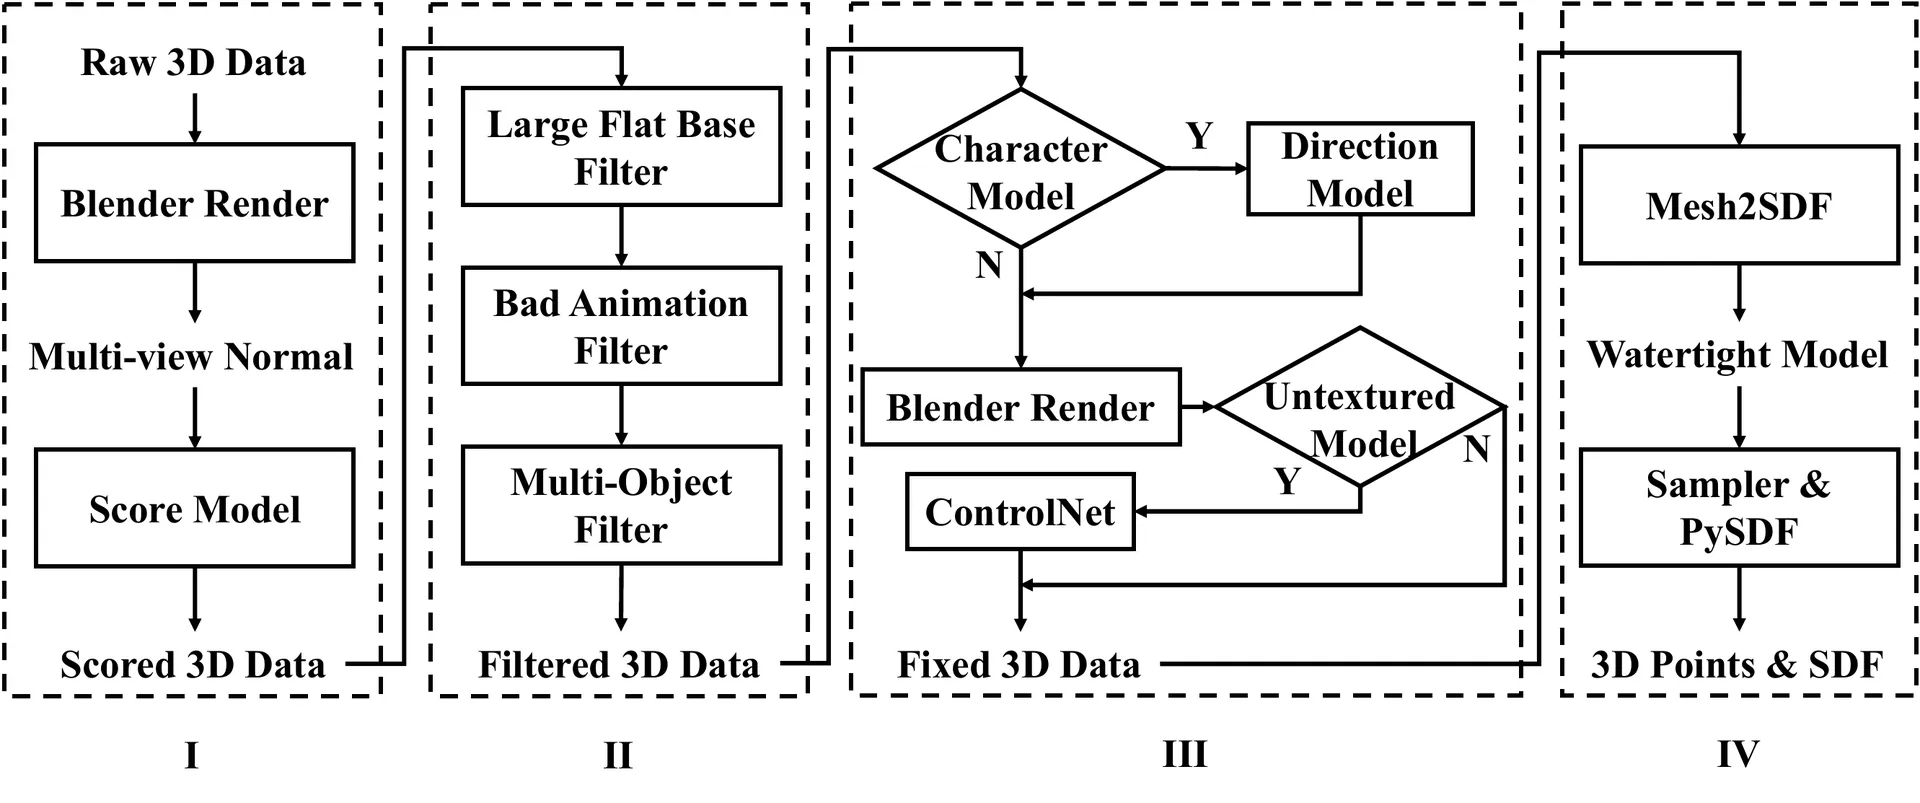
如果说前面两节讲的是“好马配好鞍”,那么第 4 节的 数据构建系统(Data-Building System,见 Fig. 6)就是决定成败的“粮草”。为什么以前大家在 Objaverse 上训不出三维 Scaling Law?因为原始 Objaverse 里的 80 万个模型,有大半根本不适合直接用来训练单图生成!
看看作者是如何用四道流水线把“原始矿石”提炼成 200 万(2M)高纯度 Image-SDF 燃料的:
- 多维渲染打分(Data Scoring): 先对原始库里的每个三维模型渲染多视角图片,训练专门的质量打分器(Scoring Model)与美学评估器,给每个模型的几何精细度、结构完整性与视觉可读性打分——那些只有一个光秃秃立方体的简陋模型、扫了一半缺胳膊少腿的残缺扫描件、以及一团乱麻的废模在第一关就被揪了出来。
- 铁腕清洗过滤(Data Filtering): 结合打分结果与拓扑规则执行硬剔除:砍掉连着巨大地面背景的场景块、砍掉几十个小零件散乱飘在空中的非连通组合、砍掉扁平如纸片的二维图标模型。仅仅这一步,就把 80 万原始 Objaverse 狠心砍掉了近 78%,只留下 18 万(180K)精品子集!
- 朝向矫正、水密修复与多焦距相机增强(Data Fixing & Augmentation):
留下的优质模型依然不能直接用——有的模型正脸朝左、有的肚子里塞满了看不见的内部建辅助面、有的没有材质贴图或是非水密破洞网格。系统先统一矫正物体正视朝向(Orientation Fixing),给白模赋予标准漫反射材质,清理内部冗余面并执行水密化转换(Watertight Conversion)。
在渲染条件输入图像时,作者做了一个非常接地气的增强:围绕物体正面扇区(仰角 、方位角 )随机采样 8 个相机视角,并且从正交投影以及
35mm、50mm、85mm、135mm等一串离散焦距池中随机抽取相机焦距!这让模型在训练时见识了从手机广角近拍(透视畸变强烈)到长焦远拍(接近正交)的各种透视成像,测试时遇到什么照片都不怵。 - 高精度距离场生产(Field Data Production):
最后在修复好的水密网格周围密集采样空间查询点、计算精确的真值 TSDF 与表面法向量,打包成 200 万组标准化的
Image-SDF训练对。
5. 实验验证:四组硬核消融如何拆解出每个模块的真实含金量?
5.1 Normal-FID 与 GPTEval3D 全方位对比
为了公平评价纯几何形状的好坏、不被花哨的贴图颜色遮掩几何缺陷,论文提出了 Normal-FID 指标:先在测试集真值模型上渲染正视图 RGB 与真值法线图;把 RGB 喂给模型生成三维网格后,在完全相同的相机角度下渲染生成网格的法线图(Normal Map),计算生成法线图与真值法线图之间的 FID 分布距离(越低代表几何结构与表面朝向越接近真值)。
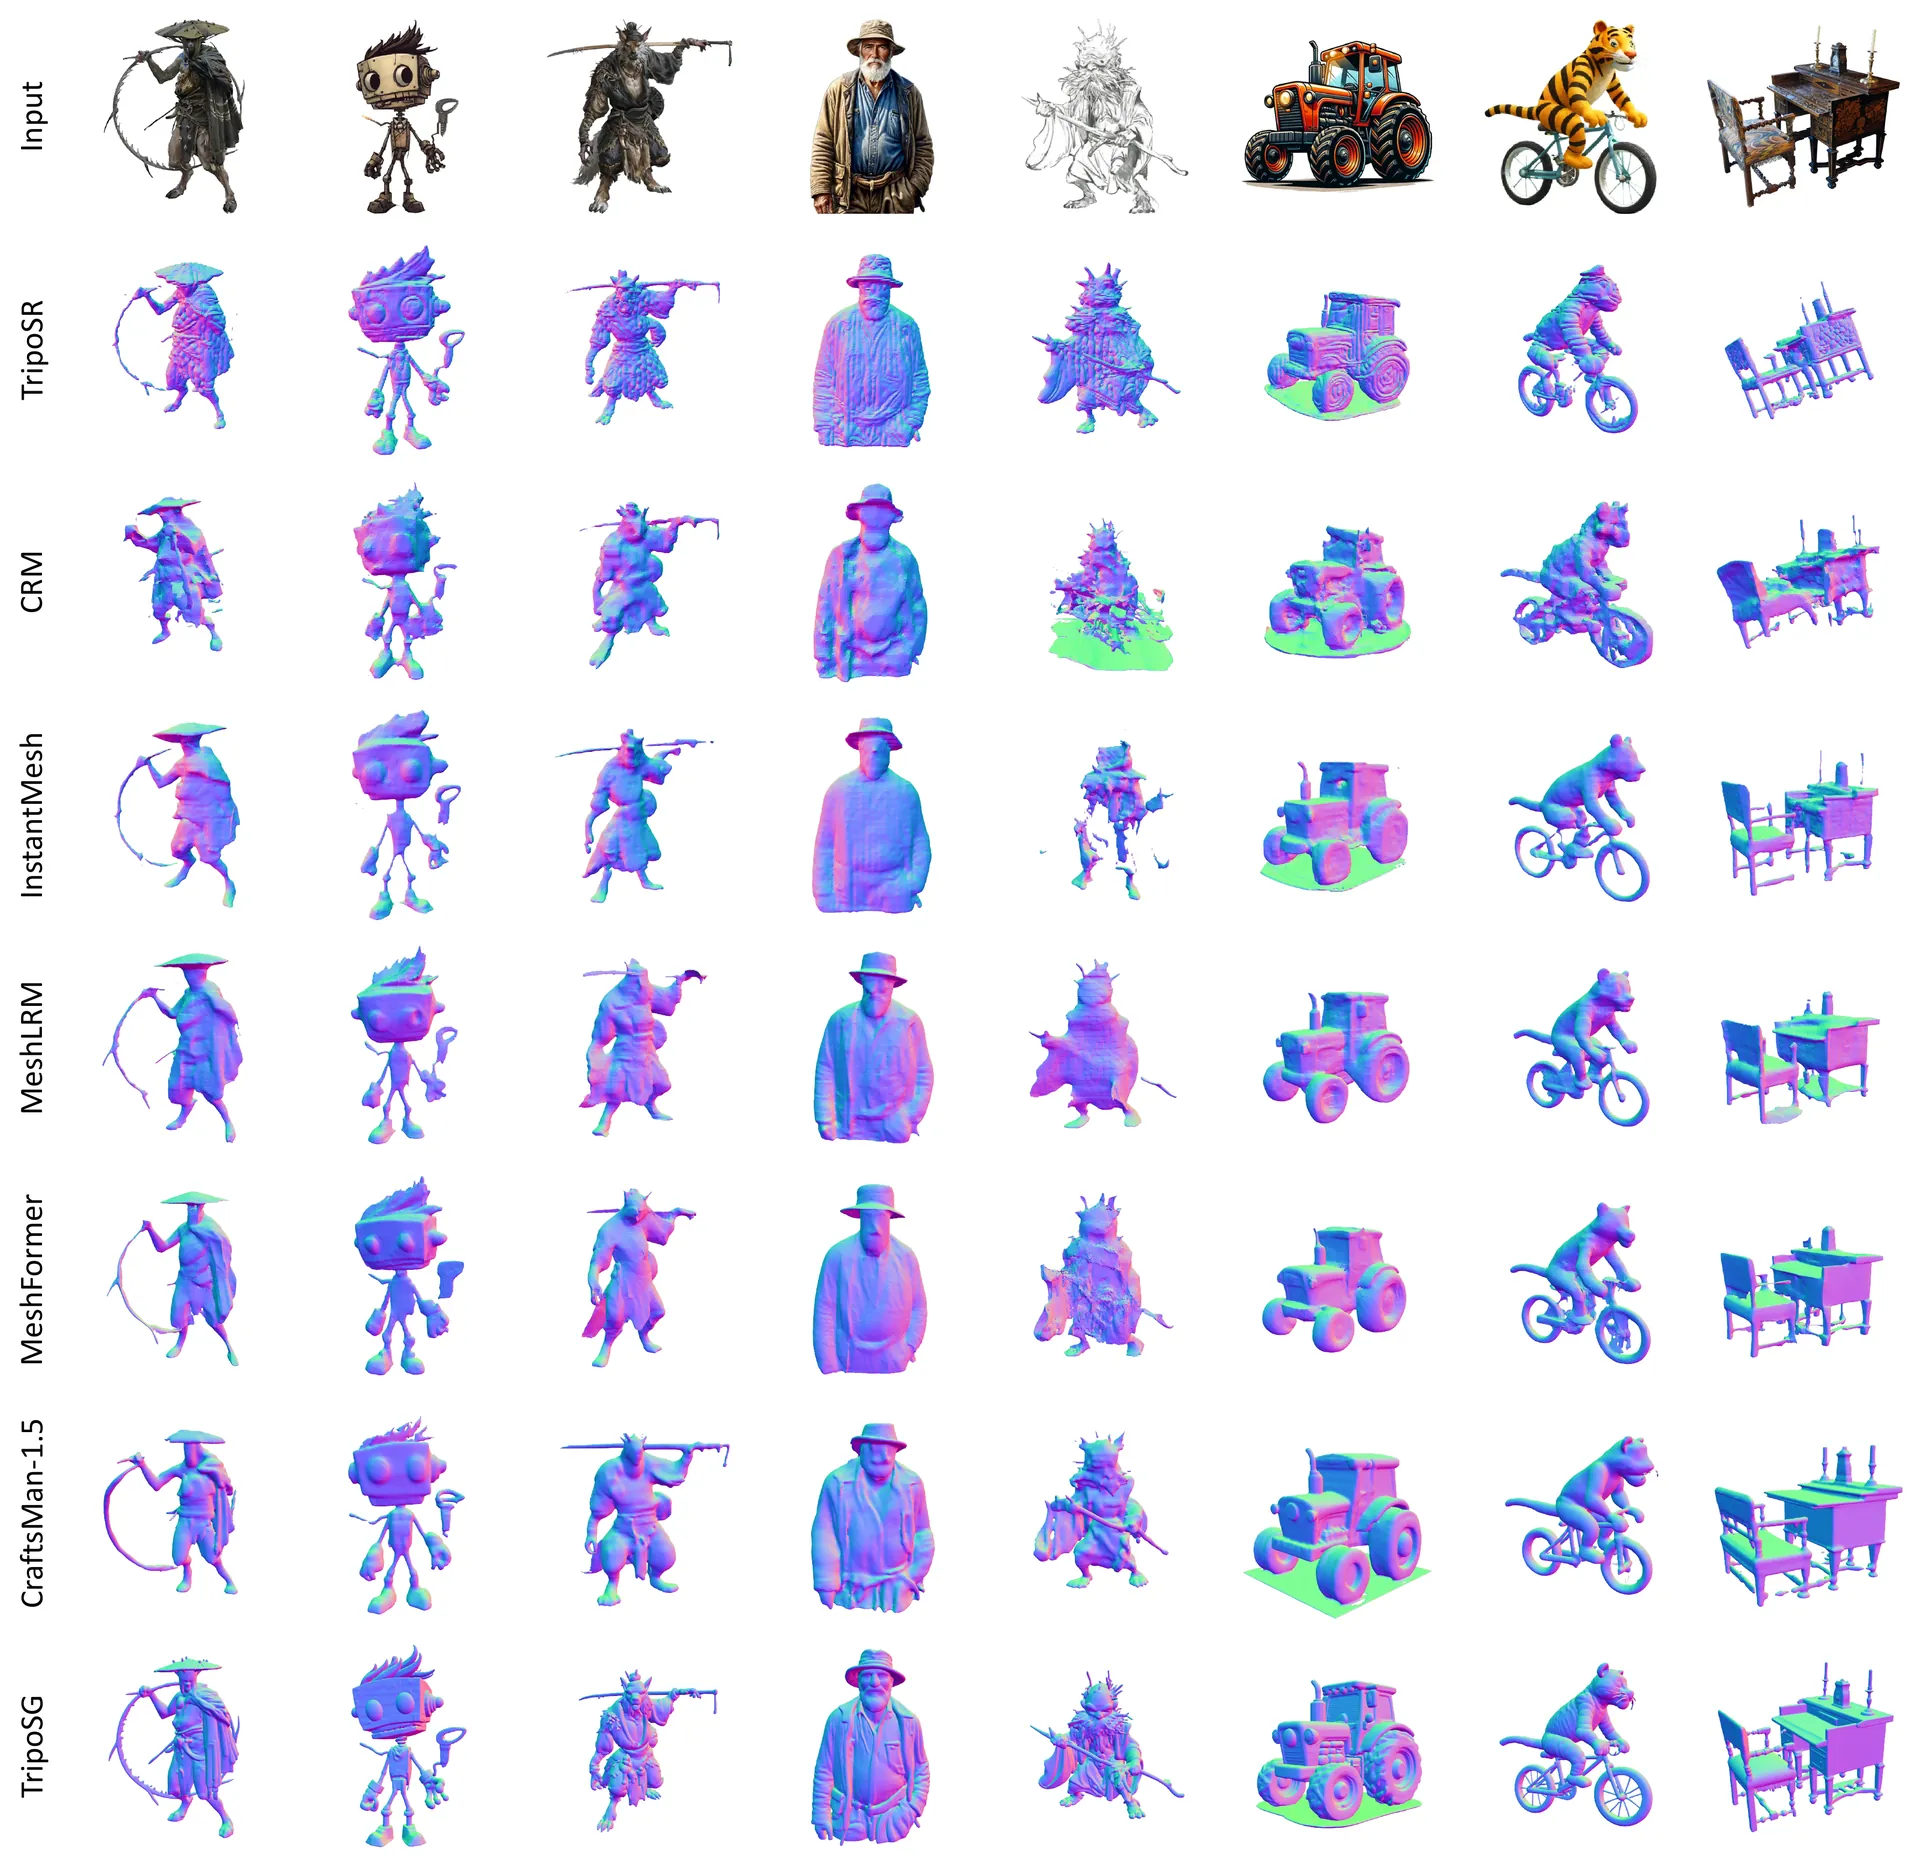
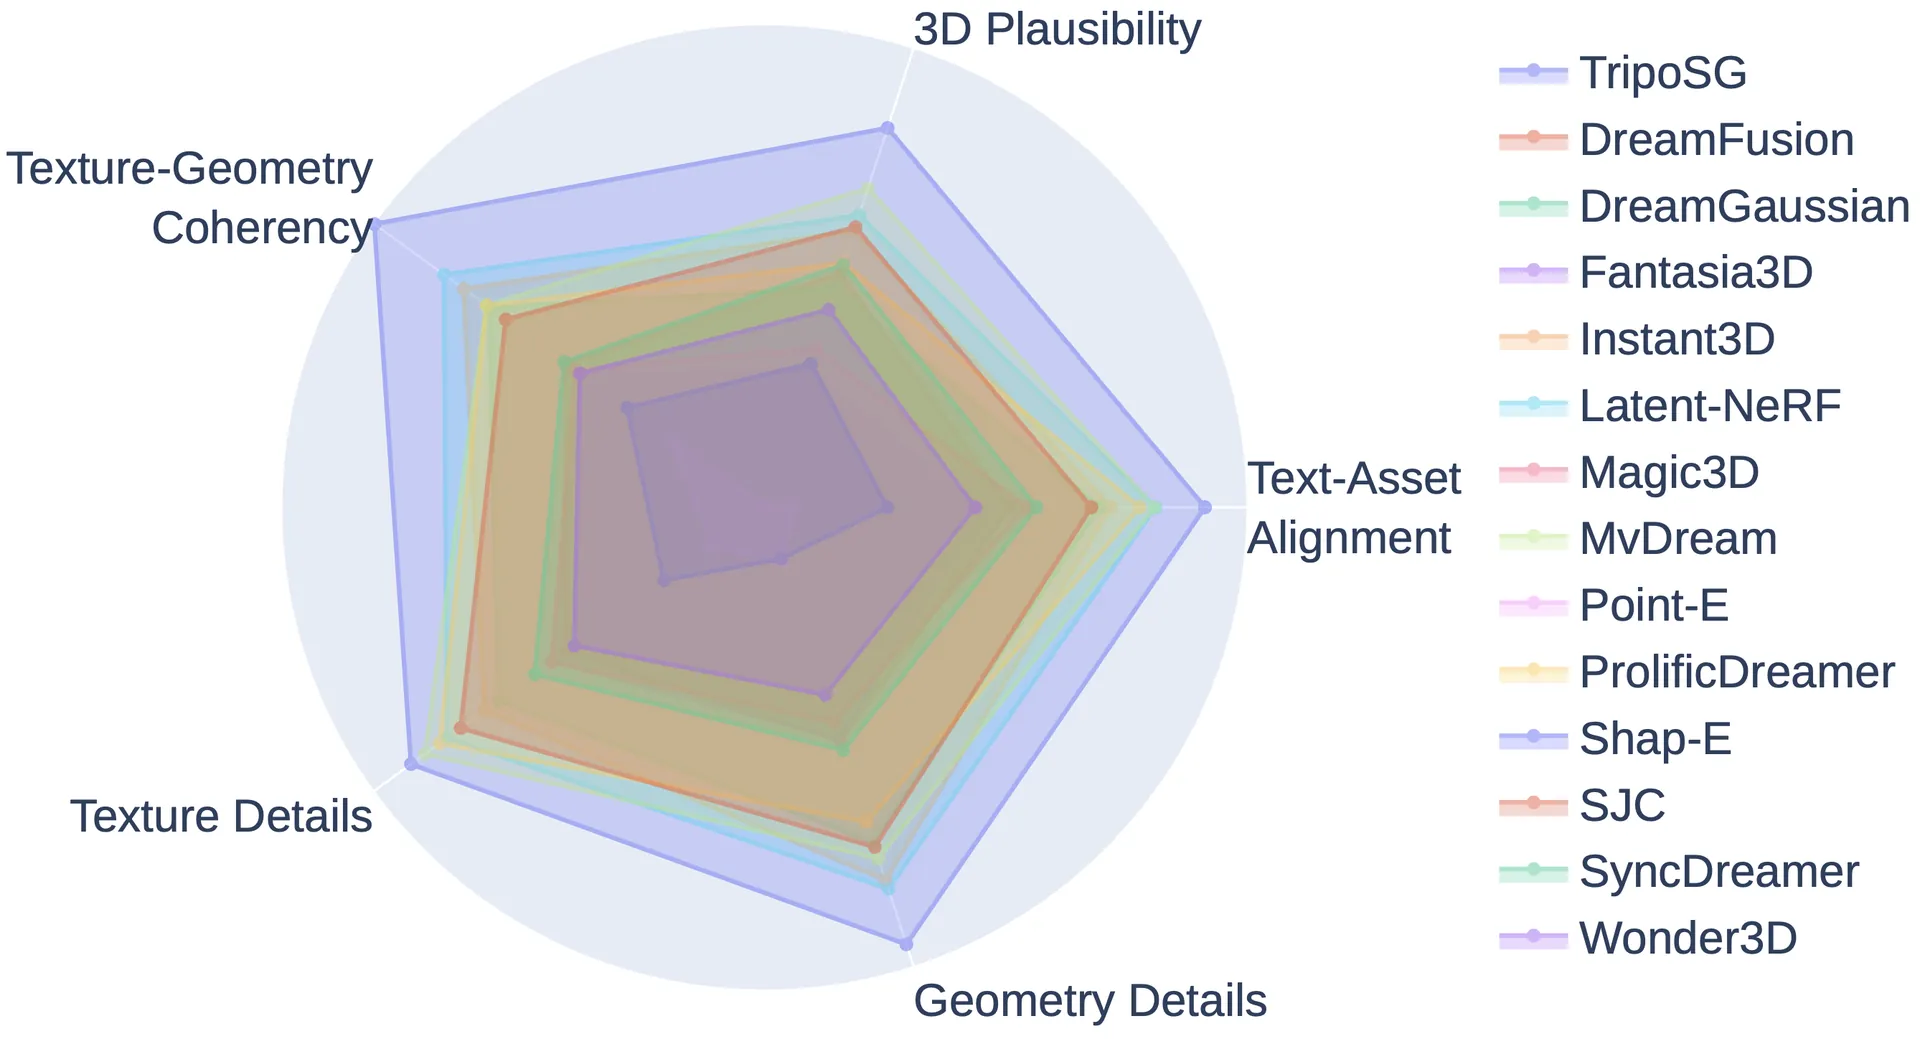
看 Fig. 7 的法线图定性大比拼与 Fig. 8 基于 Claude 3.5 多模态评测的 GPTEval3D 五维雷达图(涵盖三维合理性、图模对齐、几何细节、纹理细节、纹几一致性):面对 TripoSR、MeshLRM、InstantMesh、CRM 与 Craftsman 等一众强敌,TripoSG 在复杂空间镂空结构(如镂空球体与复杂机械架)、跨风格输入(照片、卡通、素描)以及细微服饰配件还原上展现出了代差级的几何锐度,在雷达图的全部五个维度上实现了满圈包络。
5.2 四大核心消融实验深度归因
论文在 32 张 A100 上跑了整整四组控制变量消融(Table 1–4 与 Fig. 9–10),每一张表都对应着一条关键的工程结论:
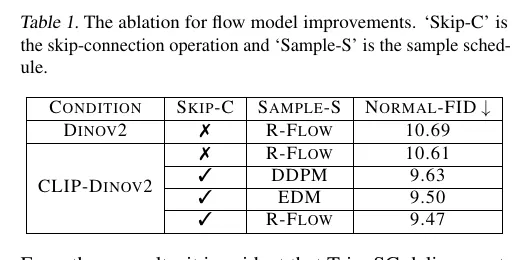
- 消融一:流模型架构与采样轨迹:
在 180K 清洗数据与 512 Token 基准上,单用 DINOv2 条件且无跳跃连接时,Normal-FID 为
10.69;加入 CLIP 组成双条件后微降至10.61;而一旦加上 U-ViT 长跳跃连接(Skip Connection),Normal-FID 立刻大幅跳水至9.47(在 DDPM、EDM、R-Flow 三种轨迹中,直线轨迹的R-Flow 9.47稳居最佳,优于EDM 9.50与DDPM 9.63)。这说明长跳跃连接是保住三维局部高频特征的第一功臣。
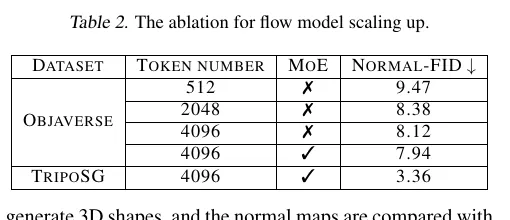
- 消融二:潜空间 Token 扩容、MoE 与 2M 数据规模定律:
顺着 Table 2 从上往下看:把潜空间 Token 数量从
512扩到2048再外推到4096,Normal-FID 从9.47一路稳步降到8.38和8.12;在解码器最后 6 层挂上 MoE 扩到 4B 参数后,进一步压到7.94;而最震撼的一跃发生在最后一行——保持完全相同的 4096 Token + MoE 模型,仅仅把训练集从 180K Objaverse 切换为 2M 高纯度 TripoSG 数据集,Normal-FID 直接从7.94腰斩再腰斩到了3.36!这铁证如山地表明:高容量模型(4096 Token + 4B MoE)只有吃饱了数百万级的高纯度三维数据,才能彻底释放出几何雕刻潜力。
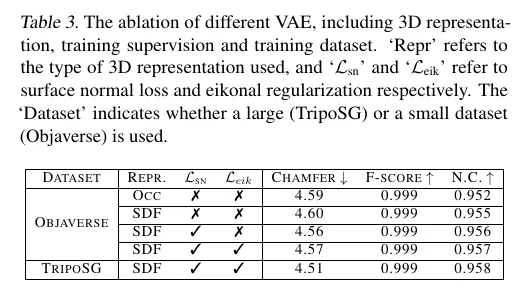
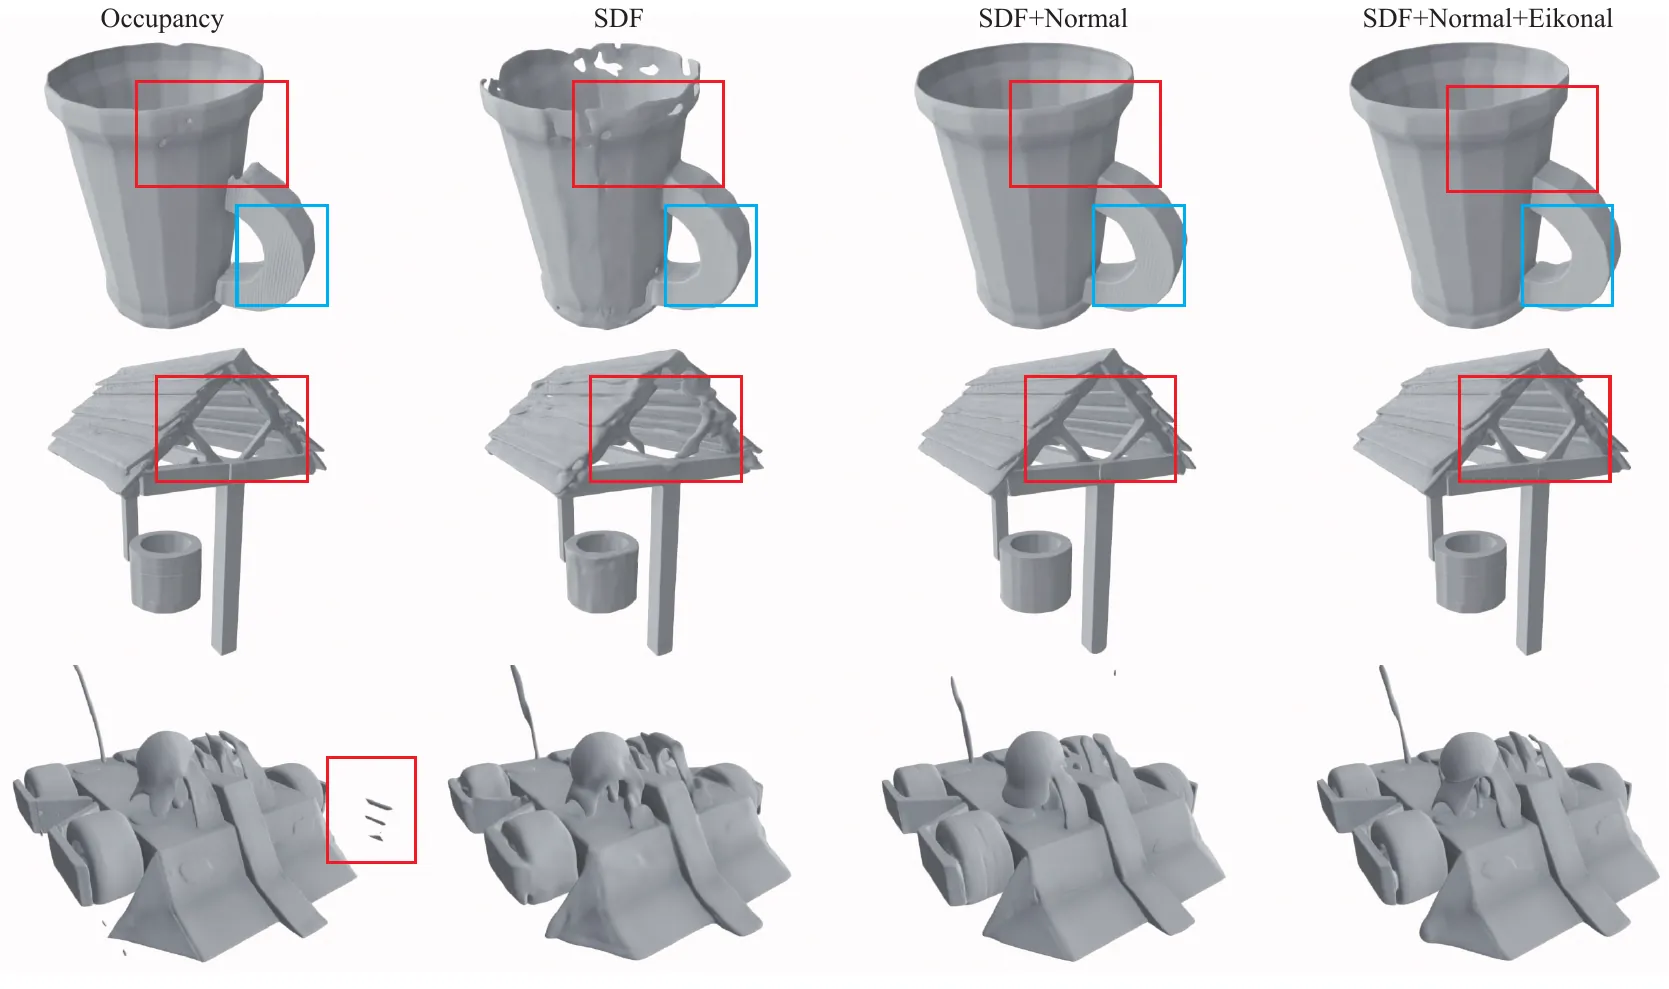
- 消融三:SDF-VAE 梯度域混合监督的威力:
如果只看 Table 3 里的点云 Chamfer 距离,Occupancy(
4.59)和加满全套损失的 SDF(4.51)似乎差得不多;但一旦对照 Fig. 9 的实际重建网格可视化,高下立判:- 第一列 Occupancy 表面全是阶梯波纹,薄片结构直接碎裂;
- 第二列换成纯标量 SDF 后,阶梯波纹没了,但细节轮廓显得圆钝肉感;
- 第三列加上表面法线梯度引导(SDF + Normal)后,羽毛和衣褶瞬间变得刀削般锐利,但放大看平坦区域却浮现出轻微的抖动伪影(因为梯度模长失控);
- 第四列再补上 Eikonal 单位模长正则(SDF + Normal + Eikonal),既完整保留了第三列的刀锋锐度,又把表面抖动抚得平平整整,法线一致性(N.C.)也一路推高到了
0.958!
- 消融四:少而精 vs. 多而脏的正面交锋:
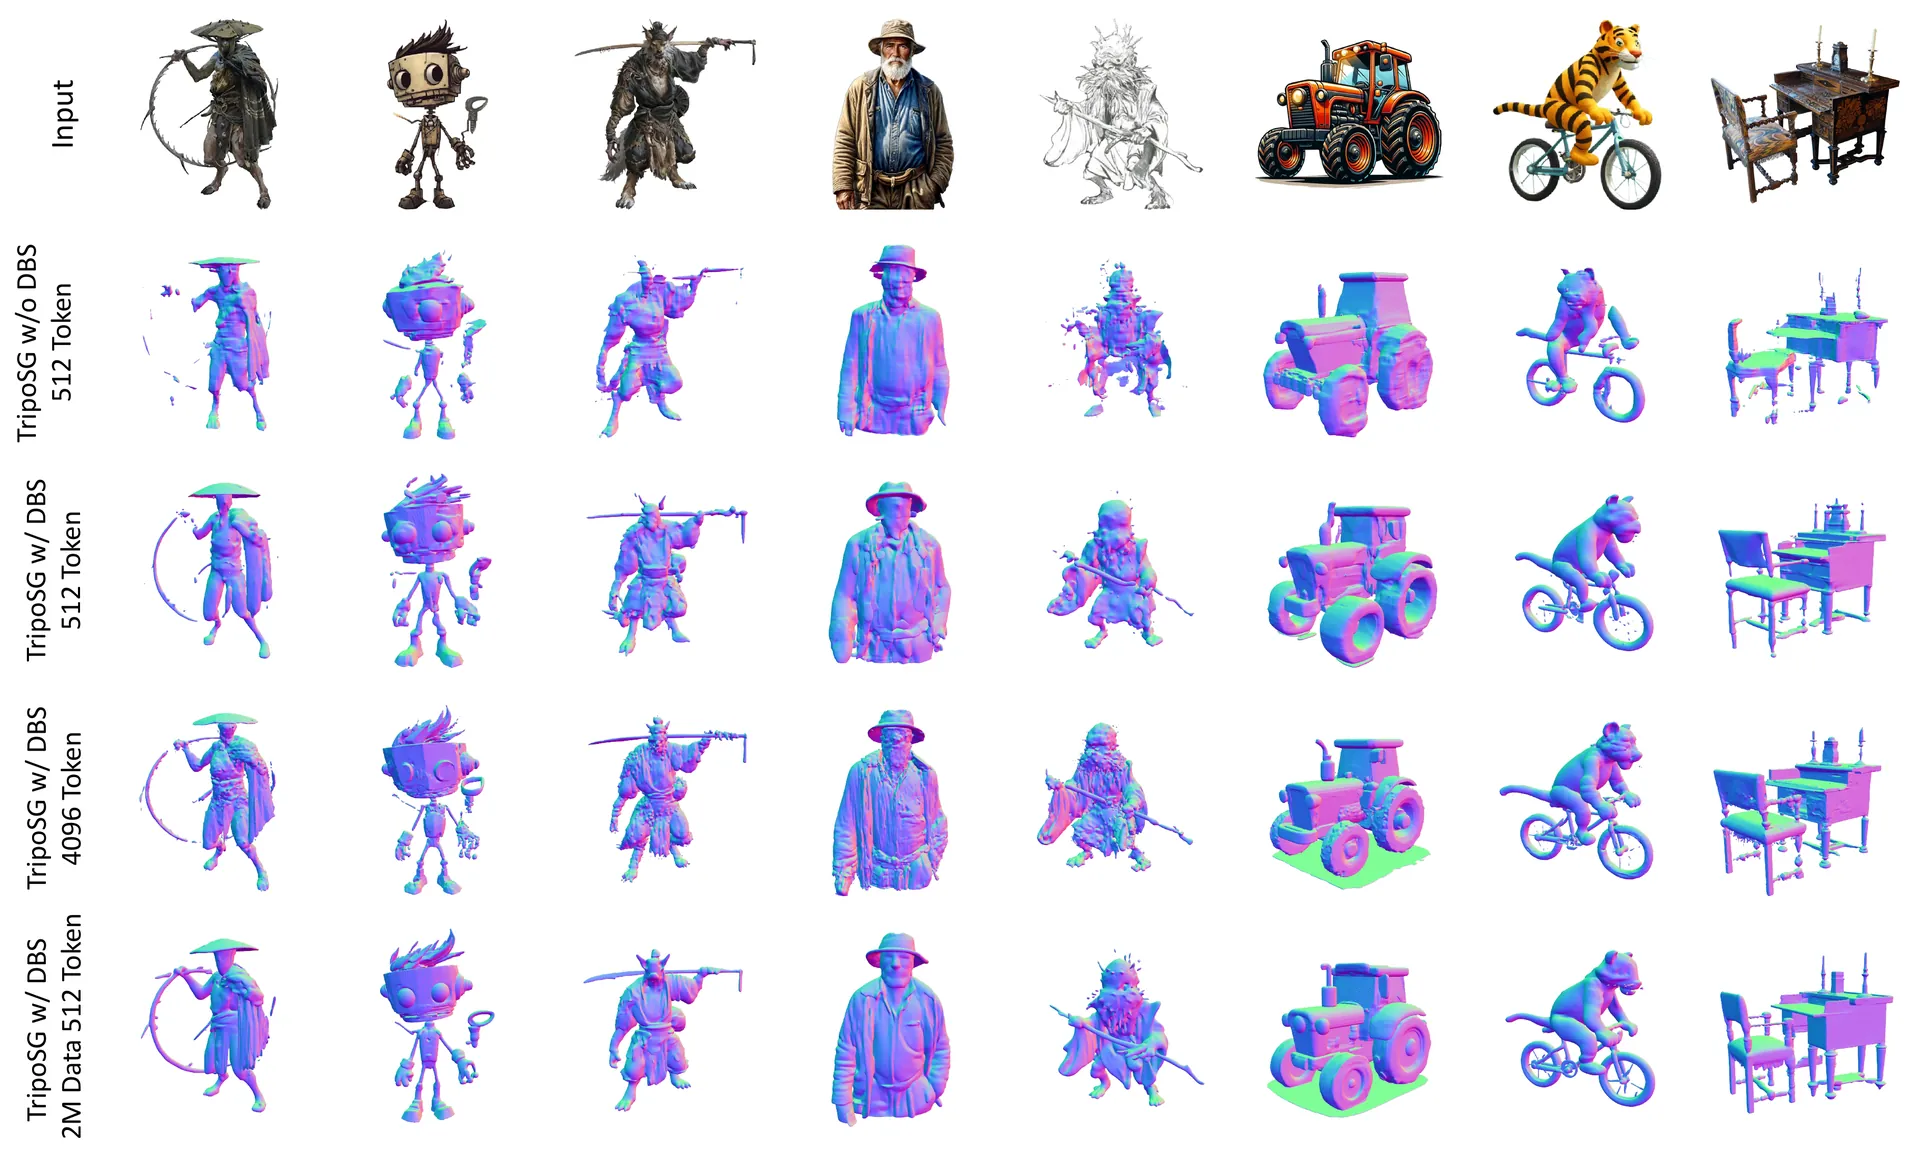
Table 4 把“数据质量先于数量”的定律拍在了桌面上:拿未经清洗的 800K 全量 Objaverse 硬训,Normal-FID 是惨淡的
11.61(对应 Fig. 10 左一,生成的宇航员和椅子结构扭曲破损);而经过数据管线过滤,哪怕只用其中 180K 干净样本(砍掉近四分之三数据),Normal-FID 立刻飞跃到9.47(Fig. 10 左二,结构瞬间端正干净);最后在同样的高标准下把干净数据扩充到 2M,Normal-FID 降到5.81(512 Token 设置下),叠加 4096 Token 与 MoE 后最终定格在完美的3.36(Fig. 10 右一)。
5.3 纯几何白模画廊与外接多视图贴图展示
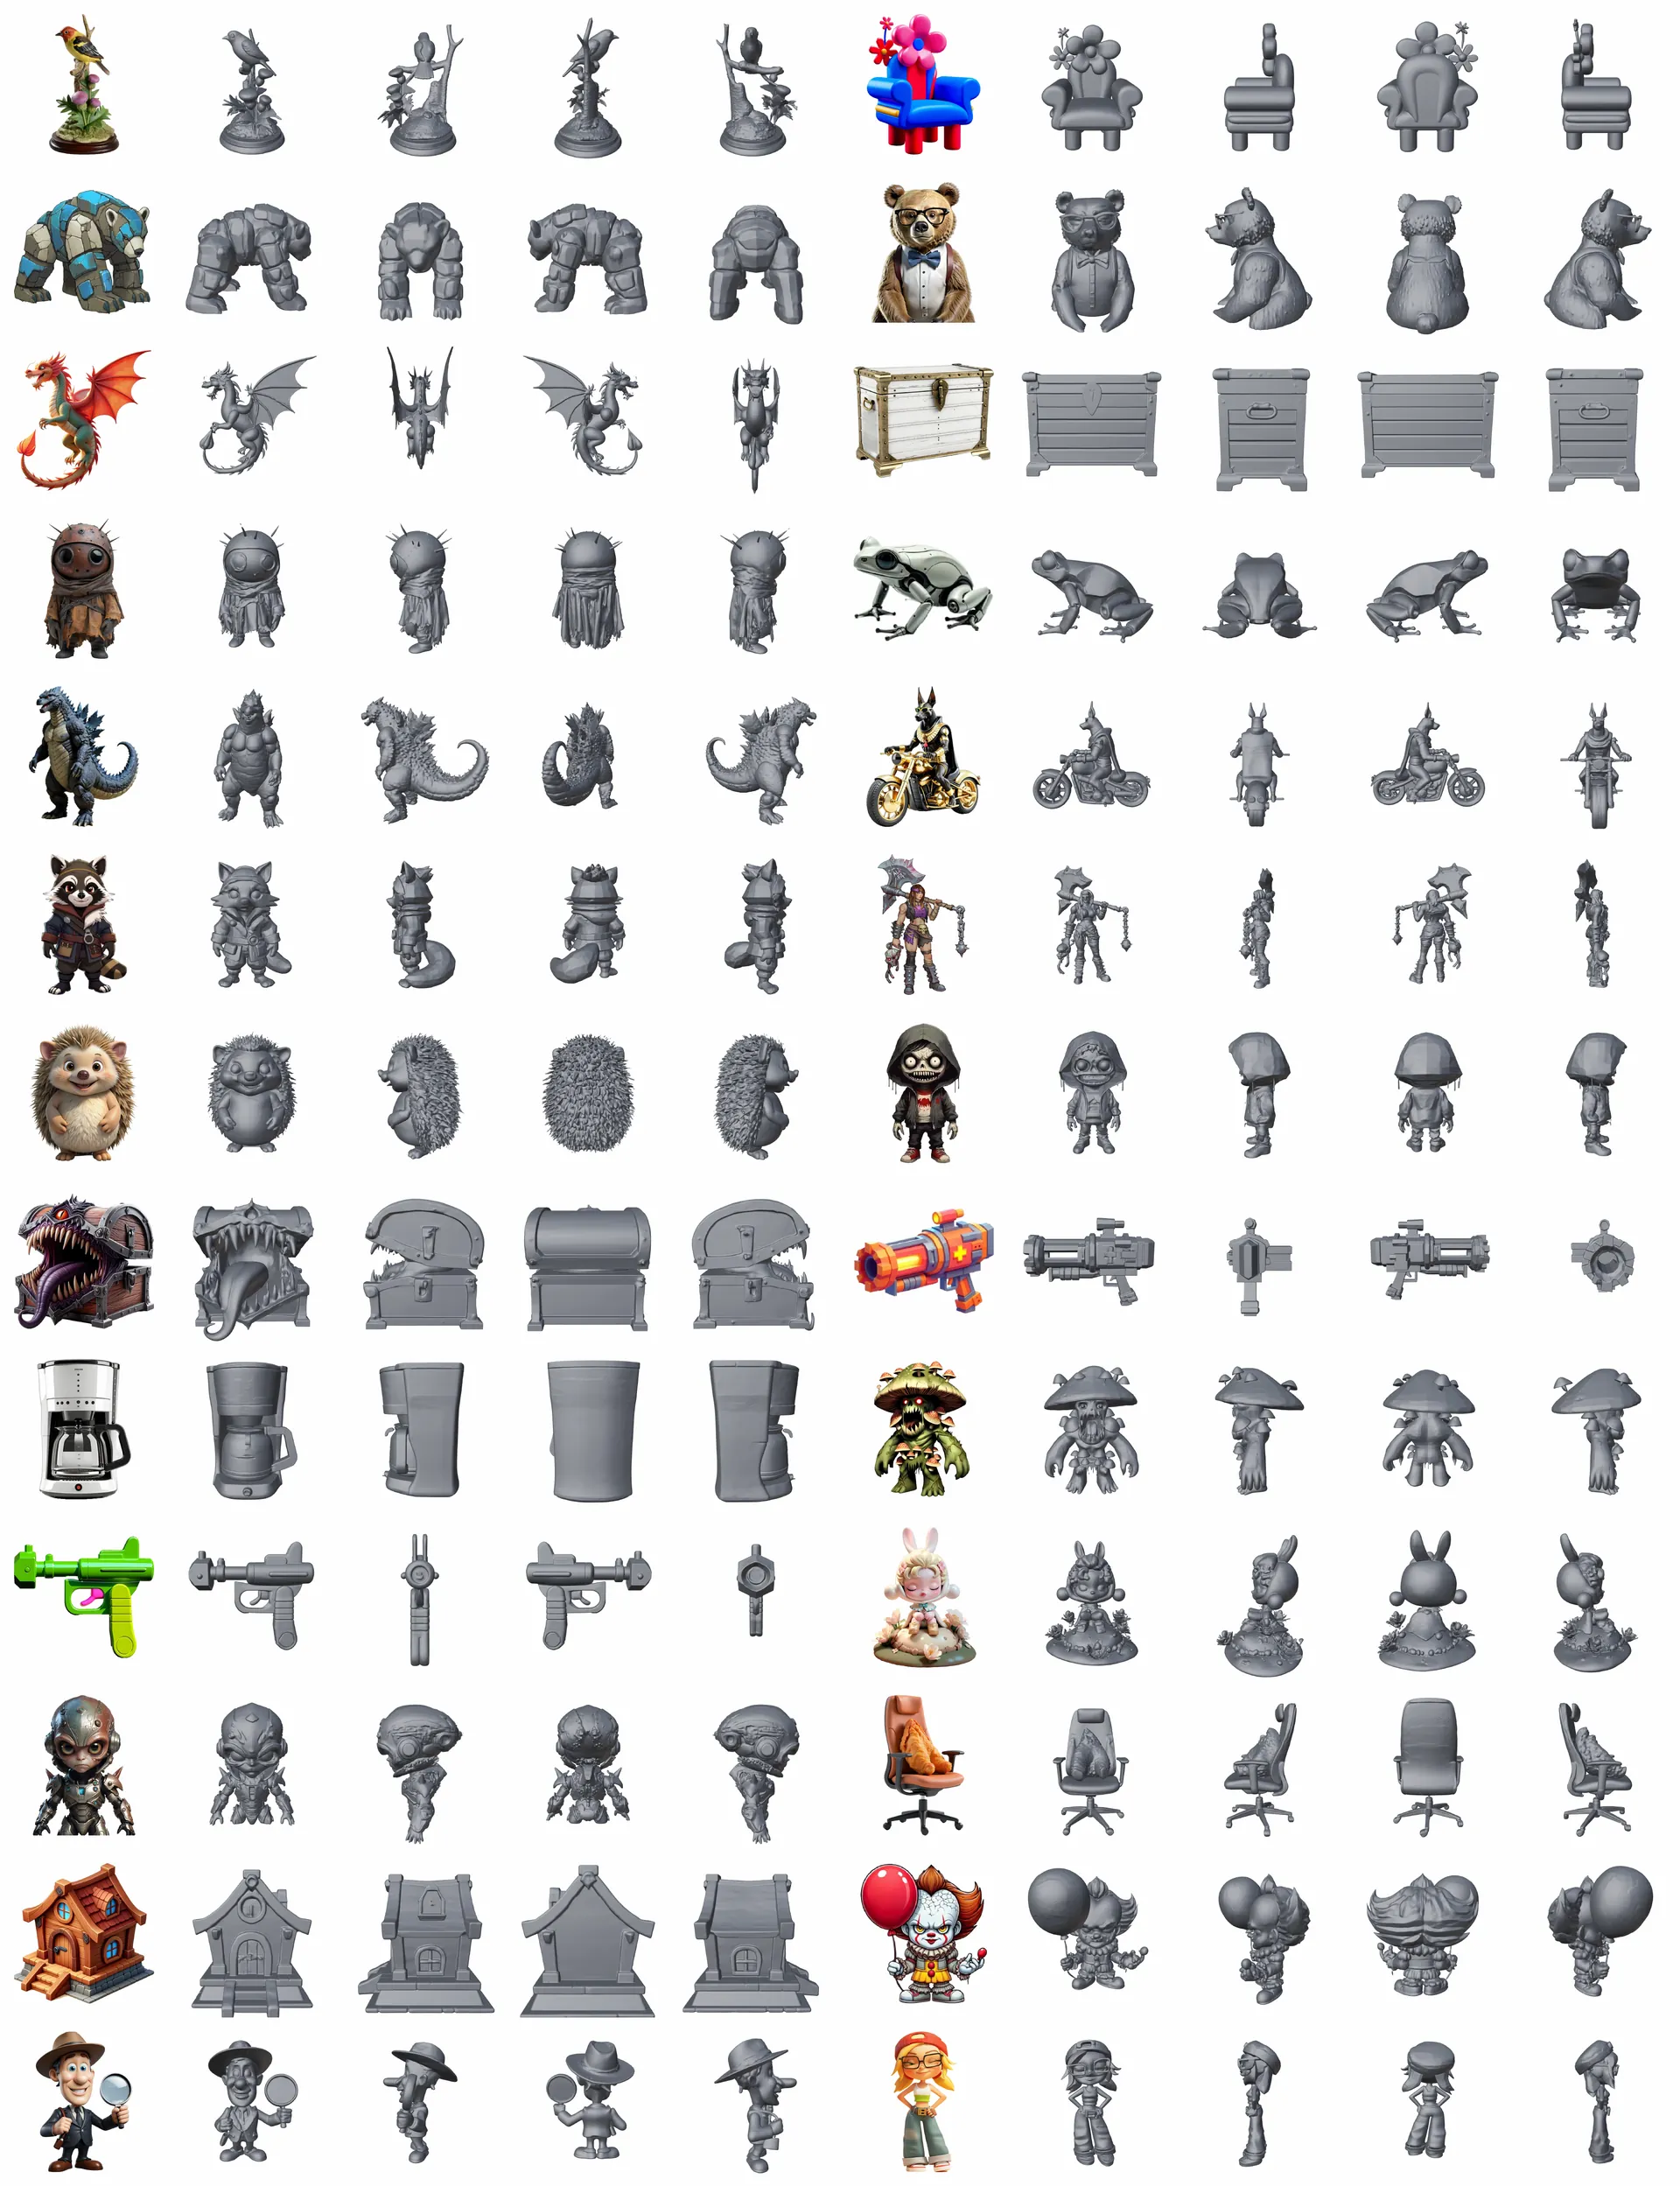
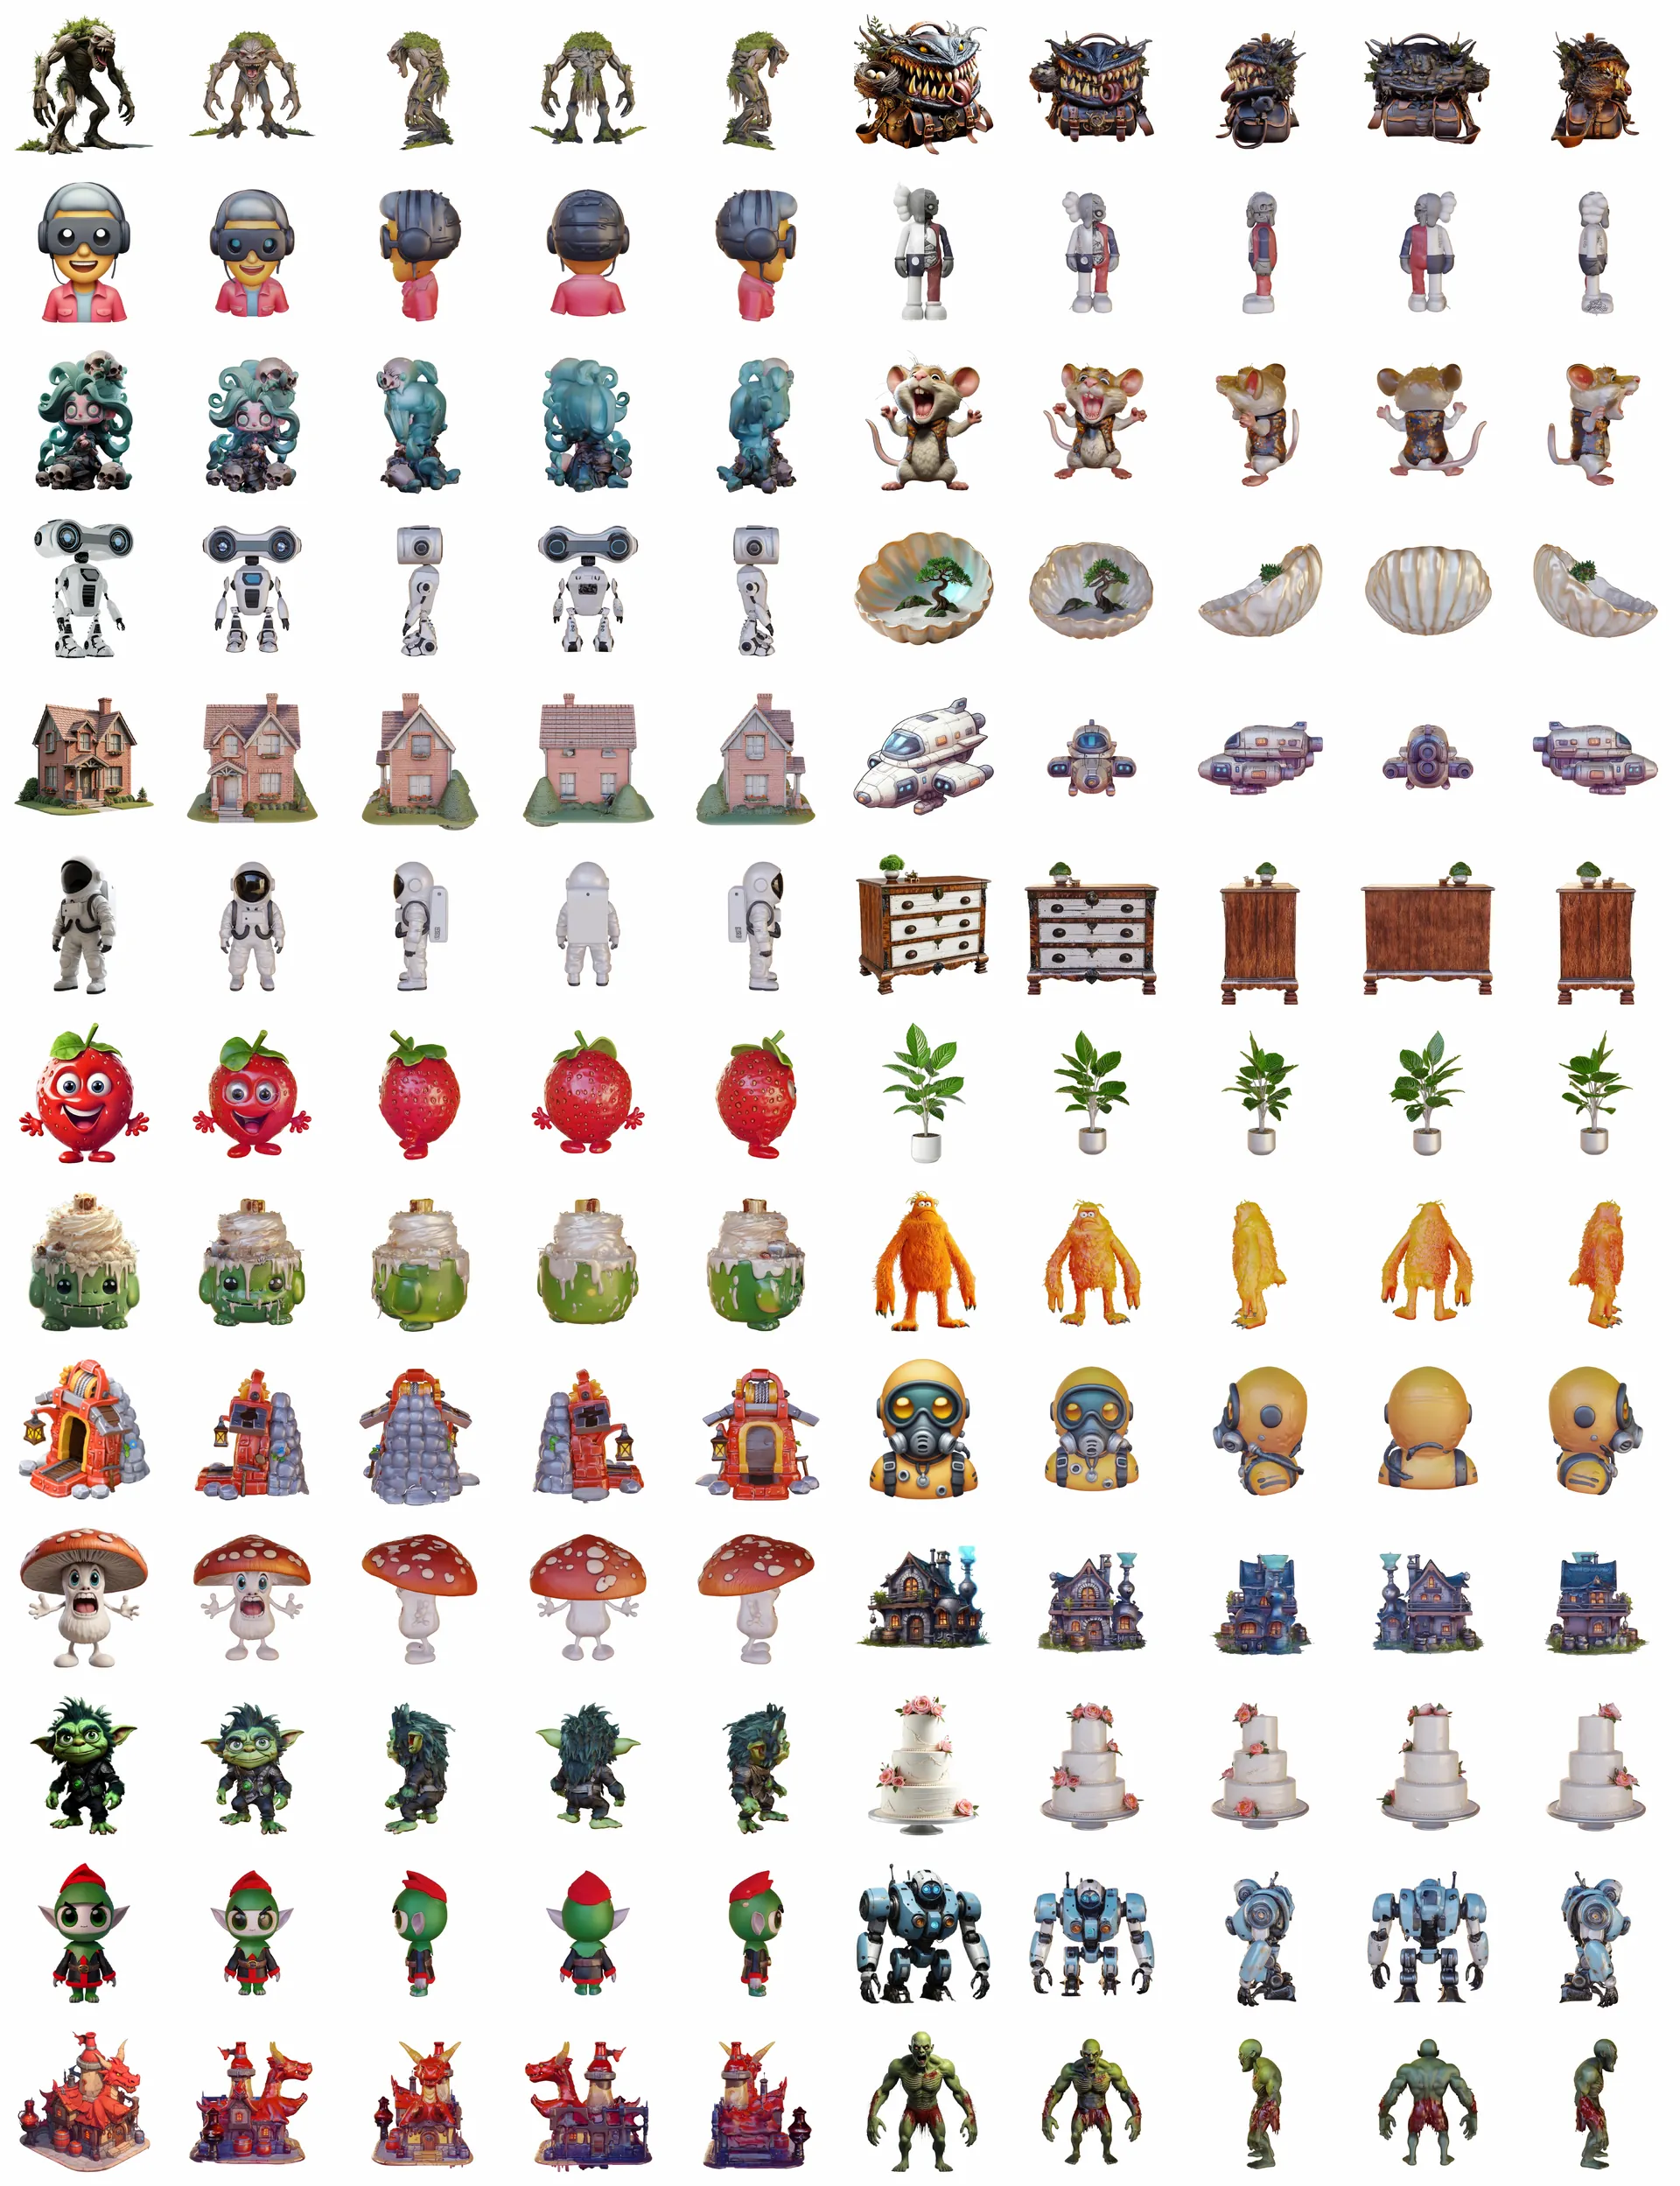
Fig. 11 展示了模型直接输出的纯几何白模(零后处理平滑、零碎块剔除),无论是复杂的多人物互动雕塑还是繁复的机甲零件都干净利落;而如 Fig. 12 所示,正因为底层白模的几何轮廓与表面法线足够精准,哪怕直接拿现成的多视角纹理生成工具以渲染法线图为条件往白模上投射贴图,也能轻松获得严丝合缝的彩色三维模型。
6. 源码深挖:从自动微分法线梯度到由粗到精八叉树提取
对照官方开源仓库 VAST-AI-Research/TripoSG,整套代码基于 diffusers 风格构建,以下三处核心源码实现最值得细读:
6.1 解码器里的一阶自动微分:TripoSGDecoder.query_geometry()
在 triposg/models/autoencoders/autoencoder_kl_triposg.py 中,解码器是如何在训练时算出隐式场梯度 来计算法线损失 和 Eikonal 损失 的?看这段核心实现:
grad_value = torch.autograd.grad(
    res_d,
    [queries_d],
    grad_outputs=torch.ones_like(res_d),
    create_graph=self.training,
)[0]
这里 queries_d 是开启了 requires_grad_(True) 的三维空间查询点坐标 ,res_d 是交叉注意力解码器预测出的 SDF 标量值。通过直接调用 torch.autograd.grad 并设置 create_graph=self.training,PyTorch 会在反向传播图内部解析地求出预测 SDF 对输入坐标 的偏导数向量 grad_value(即 ),并允许外层的法线余弦损失与 Eikonal 范数损失继续对网络权重求二阶导数!而在测试推理时,则完全跳过这段求导分支,只做前向 SDF 数值查询。
6.2 为什么不在 512³ 全空间傻算 SDF?由粗到精八叉树窄带提取
在推理阶段(triposg/pipelines/pipeline_triposg.py),当 50 步 Rectified Flow 去噪结束(由 RectifiedFlowScheduler 驱动 time_shift 与欧拉步更新)、拿到 2048 个三维潜变量 Token 后,我们需要从连续 SDF 场中提取出相当于 分辨率(八叉树深度 hierarchical_octree_depth=9)的精细三角网格。
如果老老实实在 个空间格点上挨个调 Transformer 解码器做交叉注意力查询,单次网格提取就要跑上几分钟!看看 triposg/inference_utils.py 中的 hierarchical_extract_geometry() / flash_extract_geometry() 是如何用由粗到精窄带八叉树(Coarse-to-Fine Octree Band Extraction)巧解这个算力难题的:
xyz_samples, grid_size, length = generate_dense_grid_points_gpu(...)
grid_logits = geometric_func(xyz_samples.unsqueeze(0))
...
edge_coords = find_candidates_band(grid_logits, band_threshold)
expanded_coords = expand_edge_region_fast(edge_coords, grid_size=int(grid_size/2))
...
vertices, faces, normals, _ = measure.marching_cubes(...)- 低分全空间粗筛:先在深度为 7 或 8(如 或 )的低分辨率网格上快速跑一遍全空间 SDF 查询;
- 锁定零等值面窄带(
find_candidates_band):因为物体表面只存在于 SDF 接近 的薄壳处,算法直接丢弃掉远离表面的浩瀚内部与外部空白区域,只挑出绝对值小于band_threshold的边界候选格点; - 膨胀细分查询(
expand_edge_region_fast):将候选窄带向外安全膨胀一圈,只在这些极少数紧贴表面的体素内部细分为 的深度 9()子格点再去调用解码器查询 SDF,最后送入marching_cubes抽出高精度网格!这一招省掉了超过 95% 的空白区域无效注意力查询。
6.3 输入前景居中预处理与 TripoSG-scribble 扩展分支
在推理脚本 scripts/inference_triposg.py 与 scripts/image_process.py 中,系统同样内置了严谨的输入分布对齐:自动调用 briaai/RMBG-1.4 剥离杂乱背景,裁出前景物体的紧致包围盒,四周留白填充为正方形画布并合成纯白背景(bg_color=[1.0, 1.0, 1.0]),还支持通过 --faces 参数调用 pymeshlab 将输出网格简化至指定面数预算。
此外,开源仓库还额外公开了一个有趣的轻量级衍生模型 TripoSG-scribble(入口为 scripts/inference_triposg_scribble.py):这是一个经过 CFG 蒸馏、仅使用 512 个潜空间 Token 的快速原型变体,支持用户随手画几笔二维简笔草图(Scribble)再配上一句文本提示词(Prompt,通过 --scribble-conf 控制草图轮廓约束的强弱),几秒钟内就能把草图变成三维白模。
7. 工程边界与横向生态坐标:在 3D 视觉版图中的位置
客观审视 TripoSG 的定位,有两处边界值得工程团队留意:
- 论文旗舰模型与开源权重的规格梯度:论文主表与 Teaser 展示的极限效果来自 4B MoE / 4096-token 旗舰模型(配合未开源的 2M 清洗数据集);而 Hugging Face 上以 MIT 许可公开的
VAST-AI/TripoSG权重为 1.5B 稠密架构 / 2048-token 版本(且triposg_transformer.py头部注明部分注意力代码改编自 Tencent HunyuanDiT,商用时需同步留意相关衍生声明)。 - 纯几何白模与下游资产化管线的分工:TripoSG 的全部火力都集中在“如何把单图转白模网格的几何细节做到极致”,它本身不内建 UV 展开、切线法线烘焙或原生 PBR 材质预测。
当我们把本站精读过的四篇 3D 资产生成代表作与两篇 3D 场景级配准工作放在一起横向对比时,每篇工作的核心武器与生态位便跃然纸上:
| 代表工作 | 核心技术武器 | 主打优势与适用场景 |
|---|---|---|
| TripoSG(本文) | 2M 严选数据 + SDF/Normal/Eikonal 混合监督 VAE + U-ViT 跳跃连接与 4B MoE Rectified Flow | 单图纯几何白模精度天花板:适合对几何锐度、衣褶细节与复杂空间结构要求极高的三维原型雕刻 |
| TRELLIS.2 | 无场 O-Voxel(对偶网格 + 体素 PBR)+ 16x 全稀疏 SC-VAE + FlexGEMM 算子 + 4B 三阶段流模型 | 非水密开放拓扑 + 原生四通道 PBR 生成:无需水密假设即可处理单层树叶/内部涡轮,且原生同步产出金属度/粗糙度/透明度 |
| AssetGen | 两阶段 VecSet 扩散步数蒸馏 + CuMesh/xatlas/DRTK 全 GPU 减面/UV/法线烘焙 + 10 视角 TextureGen | 14s/30s 工业引擎直接可部署资产:严守 5K–23K 面数预算,自带烘焙法线贴图与三维感知修补的 UV 彩色图集 |
| SF3D | 双流 PixelShuffle 三平面 + DMTet 顶点微调 + 球面高斯去光照 + 毫秒级箱体投影 UV 烘焙 | 0.5 秒极速单次前馈资产化重建:6GB 显存即可在半秒内吐出剥离了阴影、带 UV 与基础 PBR 因子的轻量 GLB |
| SUFLECA / Diorama | 12 数据集 NOC 弱监督特征 + 双向 Top- + 消去旋转的各向异性谱图共识 + SupeRANSAC 9D 配准 | 现成干净 CAD 资产库的零样本场景装配:当手头已有标准 CAD 库时,0.53 秒精准解出 9 自由度位姿摆进真实房间 |
总而言之,TripoSG 用扎实的数据与架构消融证明了:三维生成大模型同样存在强大的 Scaling Law,但开启这扇大门的钥匙,是先用严苛的数据清洗砍掉几何噪声、再用同时监督值域与梯度域的连续 SDF-VAE 筑牢潜空间地基。对于任何致力于训练三维几何基础模型的团队,这套“数据提纯 + 梯度域 VAE + U-ViT/MoE 矫正流”的三位一体范式都提供了极具价值的参考蓝图。
参考资料
- Yangguang Li, Zi-Xin Zou, Zexiang Liu, Dehu Wang, Yuan Liang, Zhipeng Yu, Xingchao Liu, Yuan-Chen Guo, Ding Liang, Wanli Ouyang, Yan-Pei Cao, TripoSG: High-Fidelity 3D Shape Synthesis using Large-Scale Rectified Flow Models, ICML 2025 / arXiv:2502.06608v3(PDF、HTML).
- 官方项目主页、代码与权重:TripoSG Project Page、VAST-AI-Research/TripoSG、Hugging Face Model (VAST-AI/TripoSG)、Hugging Face Space Demo
- 相关基础文献:3DShape2VecSet (SIGGRAPH 2023)、Michelangelo (NeurIPS 2023)、Rectified Flow (ICLR 2023)、Stable Diffusion 3 (ICML 2024)、U-ViT (CVPR 2023)
comments