在二维图像生成领域,无论是扩散模型还是流匹配(Flow Matching),都可以安心地建立在规则的二维像素网格和 VAE Patch Token 之上——因为任何一张自然图像,在拓扑上都只是一个严丝合缝的矩形平面。
然而一旦跨入三维世界,艺术家创作的真实三维资产会瞬间击穿这种规则假设:一片植物叶子是没有厚度的开放曲面(Open Surface),一套锁子甲包含大量非流形边(Non-manifold Edges)与细密孔洞,一台涡轮发动机内部嵌套着数十层看不见的内部叶片结构,而角色身上的玻璃护目镜与金属胸甲则同时依赖基础色(Base Color)、金属度(Metallic)、粗糙度(Roughness)和不透明度(Opacity)四套 PBR 物理材质通道。如果底层三维表示强行要求“所有网格必须先转成封闭水密(Watertight)的符号距离场 SDF”,或者“先生成白模几何、事后再渲染多视角图片往表面贴图”,那么在训练数据进入生成模型之前,树叶就已经被吹成了鼓包、发动机内部结构就已经被封死、金属高光与阴影也早就糊在了贴图接缝处。表示层一旦失真,后端堆砌再大参数量的 Transformer 也无力回天。
面对这一根本矛盾,微软亚洲研究院与清华大学等团队在 Native and Compact Structured Latents for 3D Generation(PDF、项目主页、官方代码 microsoft/TRELLIS.2、TRELLIS.2-4B 模型权重)中给出了 TRELLIS.2 的系统解法。它能够在单张 H100 上以约 3 秒()、17 秒()与 60 秒()的速度,直接生成兼具复杂开放拓扑、内部嵌套结构与四通道 PBR 材质的高精度三维资产。
透过 4B 参数的表象看本质,TRELLIS.2 的突破建立在四条环环相扣的设计哲学之上:
- 抛弃水密连续场假设,用“无场(Field-Free)”稀疏体素原生承载任意拓扑与 PBR 材质:不再把三维网格塞进连续标量场(SDF/Occupancy)的水平集里,而是提出 O-Voxel(Omni-Voxel)——只在表面穿过的有效稀疏体素内,用局部对偶顶点、边相交布尔标志和四边形切分权重直接编码任意开放/非流形表面,并在完全相同的空间体素坐标上绑定四通道 PBR 属性。
- 用确定性代数求解替代神经场拟合,实现网格与 O-Voxel 的瞬时双向互转:从网格转 O-Voxel 不跑任何梯度下降,仅靠求解包含表面平面与开放边界约束的二次误差函数(QEF),单核 CPU 耗时不到 0.2 秒;从 O-Voxel 还原网格也只需连接有效相交边上的对偶顶点,GPU 上不到 10 毫秒即可无损回到显式三角网格。
- 先用 16 倍全稀疏卷积 VAE 极限压缩 Token 数,再在紧凑潜空间上扩展 4B 流匹配模型: 分辨率的表面体素多达数十万个,直接喂给 Transformer 会让自注意力彻底爆显存。作者设计了约 800M 参数的全稀疏卷积 SC-VAE,通过 16 倍空间下采样将完整资产压缩为仅约 9.6K 个结构化潜空间 Token(SLat),随后按“稀疏骨架 几何潜变量 材质潜变量”的物理因果顺序串联三个 1.3B 参数的 DiT 流模型。
- 模型架构与底层稀疏算子协同设计(Hardware-Aware Co-Design):全稀疏 VAE 的吞吐量受制于不规则体素邻域的访存碎片。作者为此专门重写了基于掩码隐式 GEMM 与格雷码空间排序的 FlexGEMM 算子后端,从底层 CUDA 核函数层面扫清了高分辨率稀疏卷积的算力障碍。
下面我们就顺着这四条设计哲学,结合论文推导与开源仓库代码,由浅入深拆解整套系统的来龙去脉。
1. 为什么三维生成长期卡在表示层?系统边界与路线权衡
1.1 主流三维表示的工程死结
要理解 TRELLIS.2 为什么要推翻重做底层表示,只需看看现有三维生成路线在面对“复杂拓扑 + 物理材质 + 潜空间紧凑度”时的两难处境:
| 表示形式 | 代表工作与常见做法 | 核心优势 | 为什么难以支撑原生高保真资产生成? |
|---|---|---|---|
| 显式三角网格(Mesh) | PolyGen、MeshGPT 等自回归网格生成 | 渲染管线原生通用,能直接表达锐利边缘与薄片 | 顶点与面片连接关系高度离散,Token 序列随面数剧增,极难扩展到百万面级高细节资产 |
| 连续隐式场(SDF / Occupancy) | 3DShape2VecSet、Michelangelo、Craftsman、TripoSG | 连续函数易于神经网络回归,表面平滑 | 依赖内外分明的“水密流形”假设;处理单层薄布料、开放植物叶片或内部镂空结构时必须强行加厚或封孔,导致拓扑严重失真 |
| 三平面 / 3DGS(Triplane / Gaussian) | LRM、TripoSR、LGM、前代 TRELLIS 辐射场分支 | 前馈速度极快,新视角合成图像指标高 | 缺乏干净的显式表面拓扑,转出标准网格时容易出现阶梯伪影或表面气泡,且多视角烘焙贴图极易产生接缝与高光污染 |
| 高密稀疏等值面(Sparse Iso-surface) | SparseFlex、FlexiCubes 等 | 局部几何还原度高,支持开放结构改写 | 空间压缩率不足——例如 SparseFlex 在 下仍需多达 225K 个 Token,令后端生成式 Transformer 难以承受 |
可以看到,如果表示层本身要把薄树叶加厚成气球、把纹理材质推迟到生成后再用多视图扩散往模型上“刷漆”,那么生成模型从第一天起学到的就是有损的次生分布。
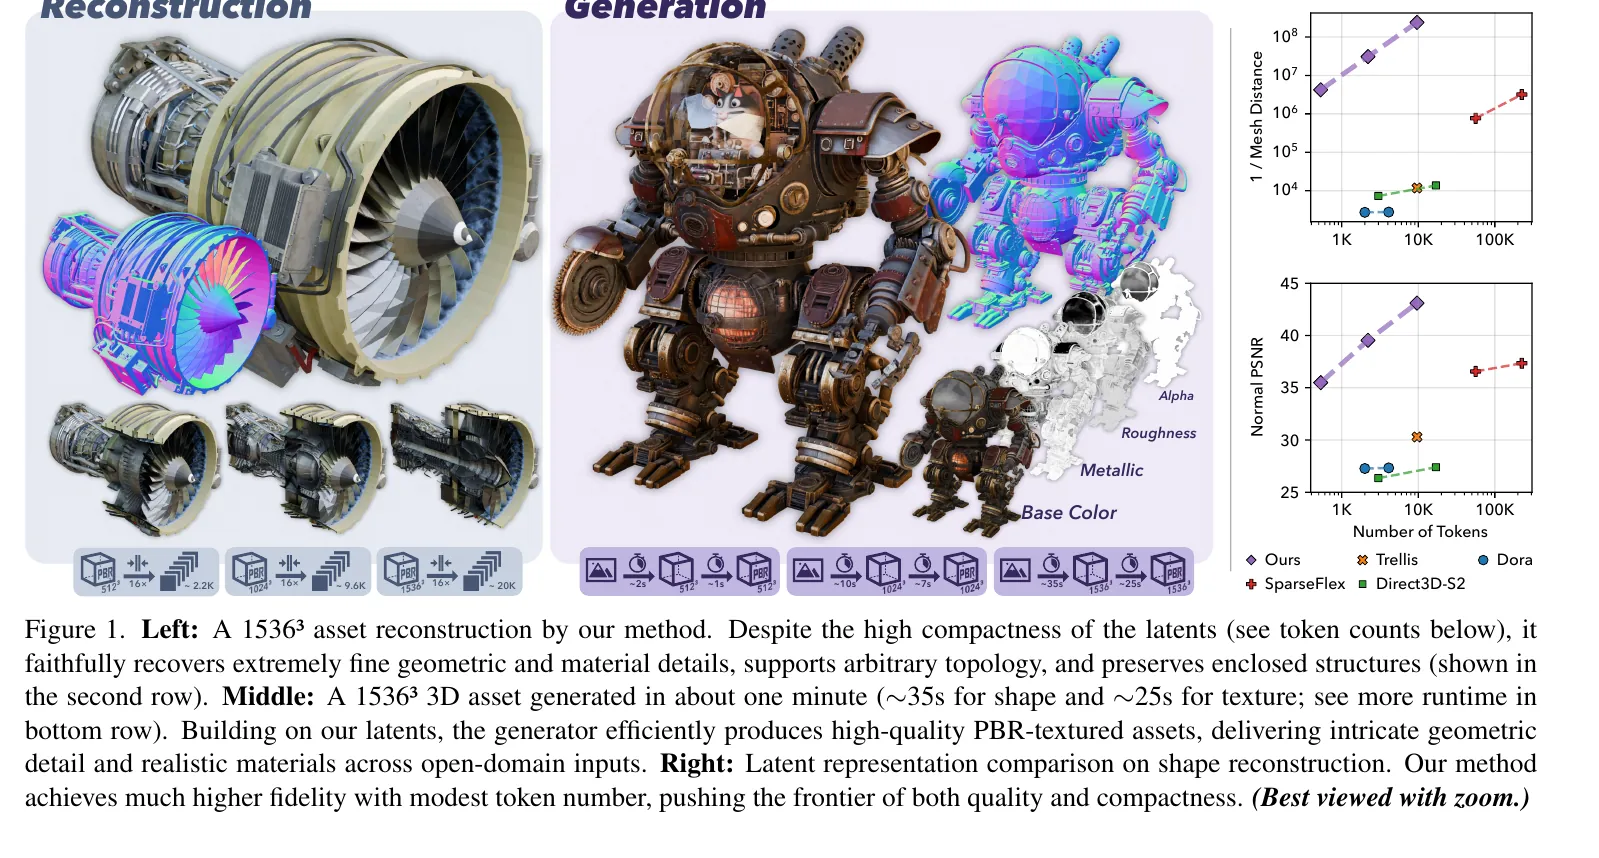
看看 Fig. 1 展示的三组核心能力对比:
- 左图( 涡轮引擎重建):放大观察叶片边缘、镂空孔洞与层层嵌套的内部转子结构,O-Voxel 在多级分辨率下均没有出现隐式场常见的孔洞粘连或薄片断裂。
- 中图(带原生 PBR 通道的机械角色生成):模型直接输出了与几何严密对齐的 Alpha(透明度)、Roughness(粗糙度)、Metallic(金属度)与 Base Color(基础色)四个物理通道,连玻璃面罩的半透明折射与金属装甲的高光反射都是原生潜变量解码的结果。
- 右图(Token 数量 vs. 重建质量曲线):横轴是每个三维资产占用的潜变量 Token 数量,纵轴是表面重建质量。TRELLIS.2(红线)位于左上角帕累托最优区——在同等甚至更少的 Token 预算下,重建保真度远超 Dora、Direct3D-S2、SparseFlex 与前代 TRELLIS。
1.2 双向解耦的系统流水线
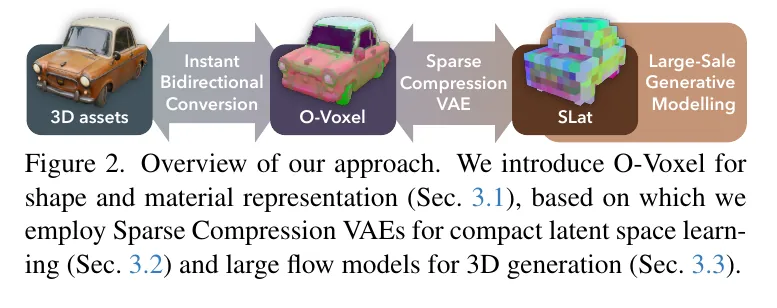
Fig. 2 勾勒出了整套系统的双向闭环:
训练方向:原生 3D 资产 (Mesh + PBR) ──[瞬时代数转换]──> O-Voxel ──[SC-VAE 编码]──> 紧凑潜变量 SLat ──> 训练 Flow Models
推理方向:条件输入图像 ──[三阶段 Flow 采样]──> 预测 SLat ──[SC-VAE 解码]──> 重建 O-Voxel ──[瞬时还原]──> 标准 GLB 资产这条流水线最核心的架构智慧,在于把“三维资产怎么无损表示(O-Voxel)”、“高分辨率体素怎么极限压缩(SC-VAE)”与“条件概率分布怎么学习(Flow Models)”彻底解耦成了三个独立模块。第一层靠经典计算几何保证零拓扑损失,第二层靠全稀疏卷积解决上下文长度危机,第三层才动用 4B 参数的大规模 Transformer 学习生成先验。
2. 核心设计哲学一:用无场 O-Voxel 统一任意拓扑几何与体素级 PBR
2.1 什么是 O-Voxel?为什么不用 SDF 而用 Flexible Dual Grid?
传统的 Marching Cubes 或 Dual Contouring 算法,通常要求先在每个体素的格点(Grid Corners)上定义正负符号距离值(SDF),再寻找正负号跳变的过零点来提取表面。但这立刻带来一个死穴:一张没有厚度的纸片或树叶穿过体素时,纸片两侧全都是“外部(正号)”,格点根本不发生正负号翻转,基于连续场的算法就会直接无视这片树叶!
为了彻底摆脱连续标量场(Field-Free),TRELLIS.2 将三维资产定义为仅在表面相交的 个有效稀疏体素(Active Voxels)上的特征元组集合:
其中 是第 个有效体素在 空间中的整数坐标,空白体素完全不占内存。
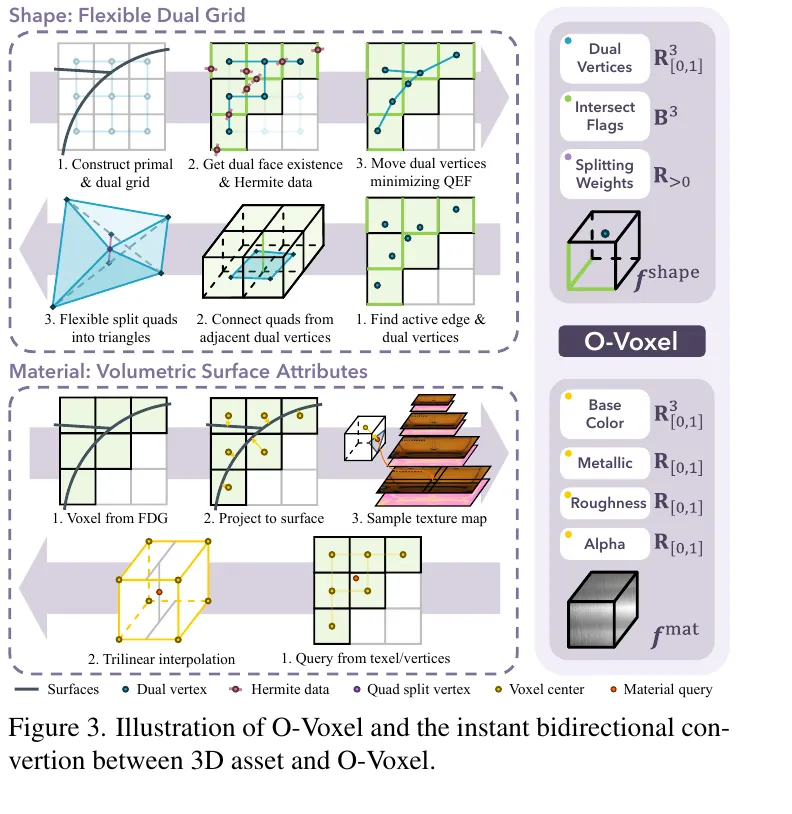
看 Fig. 3 的上下两半部分,在同一个有效体素 内,O-Voxel 并行存放着几何特征 与材质特征 :
- 几何侧采用灵活对偶网格(Flexible Dual Grid): 每个有效体素内部只放 1 个对偶顶点(Dual Vertex),其局部相对坐标为 ;同时不再记录格点正负号,而是直接用 3 个布尔标志 记录该体素沿 X、Y、Z 轴的三条正方向网格棱边(Primal Edges)是否被真实网格表面穿过!只要某条棱边被表面穿过(),围绕这条棱边的四个相邻体素里的 4 个对偶顶点就会连成一个空间四边形面片;最后再用一个正标量权重 决定这个空间四边形应该沿着哪条对角线切分成两个三角形。因此,每个体素的几何特征仅由 7 个数值组成:
想想这个设计有多巧妙:不管穿过体素的是封闭实心球、单层开放布料、还是三片面片交汇的非流形 T 型结构,只要它碰到了体素棱边,就会点亮 并把相邻对偶顶点连成面片,从根源上消除了对“内外水密性”的依赖!
- 材质侧采用同源体素对齐的 PBR 属性(Volumetric PBR Attributes): 在同一套稀疏体素坐标 上,直接存放 6 维物理材质向量:
分别对应 RGB 基础色 、金属度 、粗糙度 与不透明度 。因为几何特征与材质特征共享完全相同的稀疏体素索引 ,材质天生就长在几何表面上,绝不会出现多视图贴图投影错位的现象。
2.2 网格 ⇄ O-Voxel 的毫秒级几何互转:把开放边界写进 QEF
有了 的定义,怎么把任意一个三角网格瞬间变成 O-Voxel,又怎么瞬间变回来?
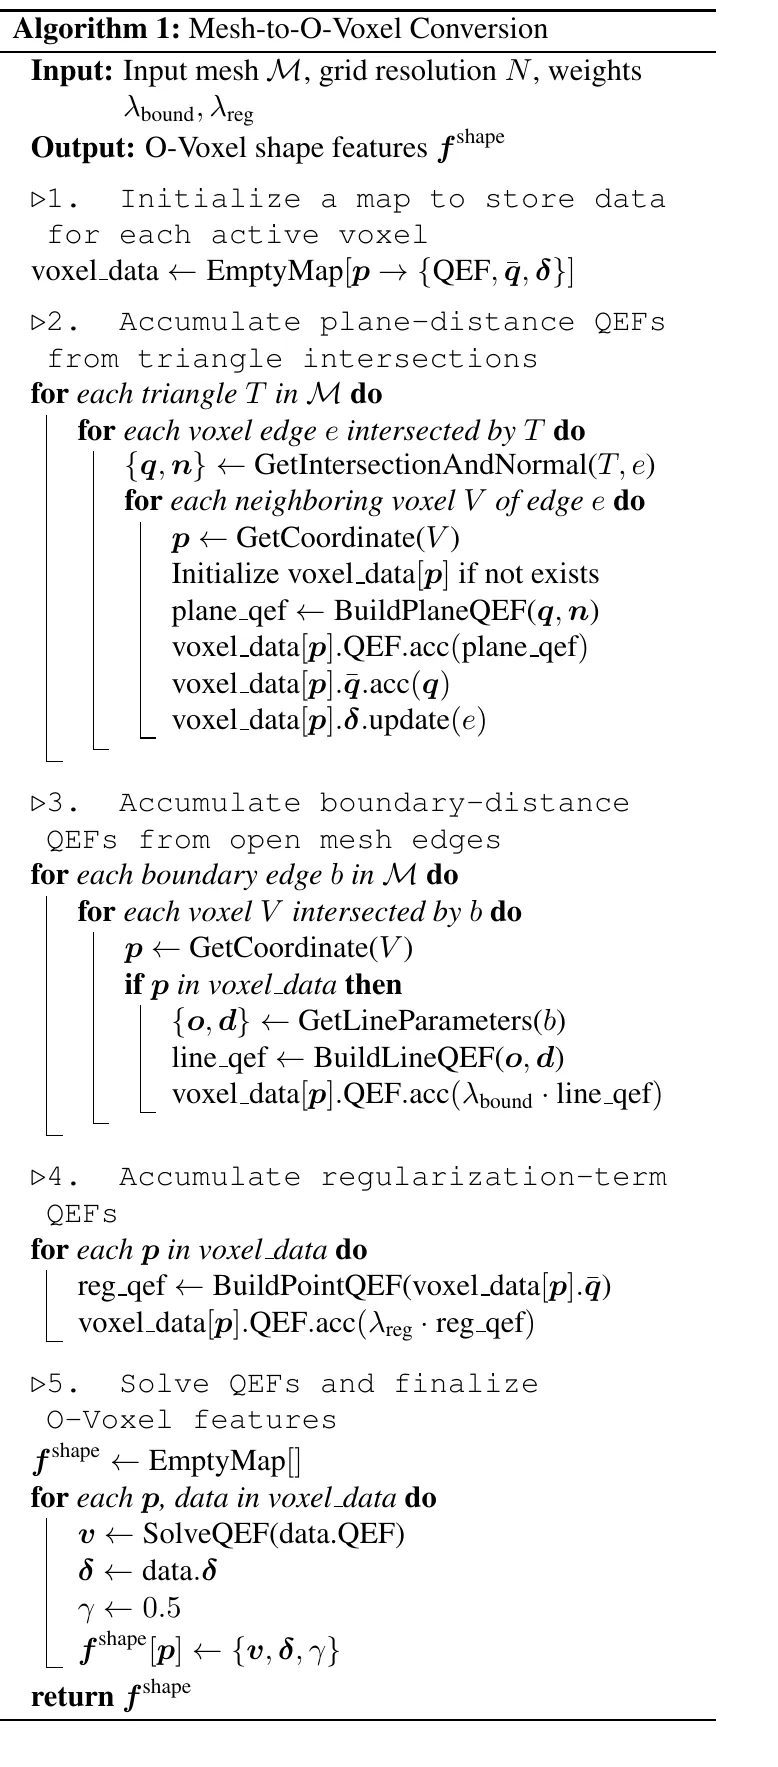
先看正向转换 Mesh-to-O-Voxel(Algorithm 1)。最关键的问题是:每个体素里的对偶顶点 到底该放在哪个位置,才能在还原时保住原网格的刀锋锐角和开放边缘?
如果简单把 放在体素中心 ,还原出来的网格就会像打了马赛克一样充满锯齿。经典对偶轮廓法(Dual Contouring)的做法是最小化二次误差函数(Quadratic Error Function, QEF):每当原网格的一个三角形 与体素棱边相交于点 (该处三角形单位法向量为 ),我们就希望体素里的对偶顶点 落在切平面 上;把体素周围所有相交点提供的平面距离平方加起来:
让总距离平方最小的位置 ,就正好处于多个切平面的交界棱线上,从而完美保留锐利边角!
但传统 QEF 一遇到开放网格边界(比如一片树叶的边缘,或者衣服领口,即只属于一个三角形的 Open Mesh Edge)就会失控——因为开放边缘停在体素半空中,没有跨过整条体素棱边,或者缺少另一侧平面的夹击约束,导致对偶顶点在边界处乱飞。Algorithm 1 的点睛之笔就在第 11~16 行:专门针对开放边界边 构造边界距离 QEF 项!设开放边界边的方向单位向量为 、边上一点为 ,算法构造垂直于边界方向的投影矩阵 ,强迫对偶顶点 紧贴在开放边界直线上(最小化点到直线的距离平方 ),再加上防止矩阵奇异的微小正则项 。最后只需解一个 线性方程组 ,就能在单核 CPU 上用不到 0.2 秒算出全图所有体素的对偶顶点!
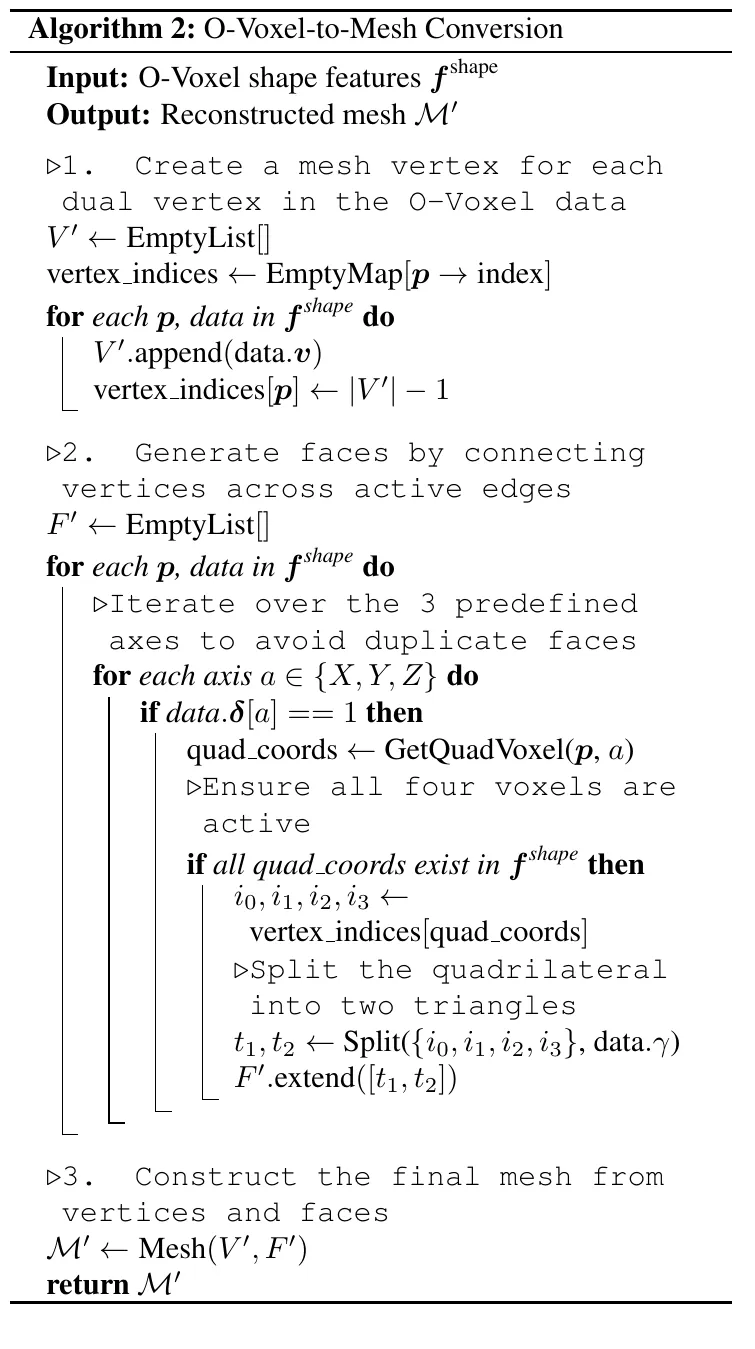
再看反向转换 O-Voxel-to-Mesh(Algorithm 2),逻辑更是干净利落:
- 把每个有效体素里的局部相对坐标 加上体素整数偏移 ,直接生成全局网格顶点;
- 遍历所有相交标志 的体素棱边,将环绕该棱边的 4 个相邻有效体素的对偶顶点连成一个四边形 ;
- 比较切分权重 ,决定是沿着对角线 还是 把四边形切成两个三角形,当场输出显式网格(GPU 耗时 )。
2.3 纹理 ⇄ O-Voxel 的双向材质对齐
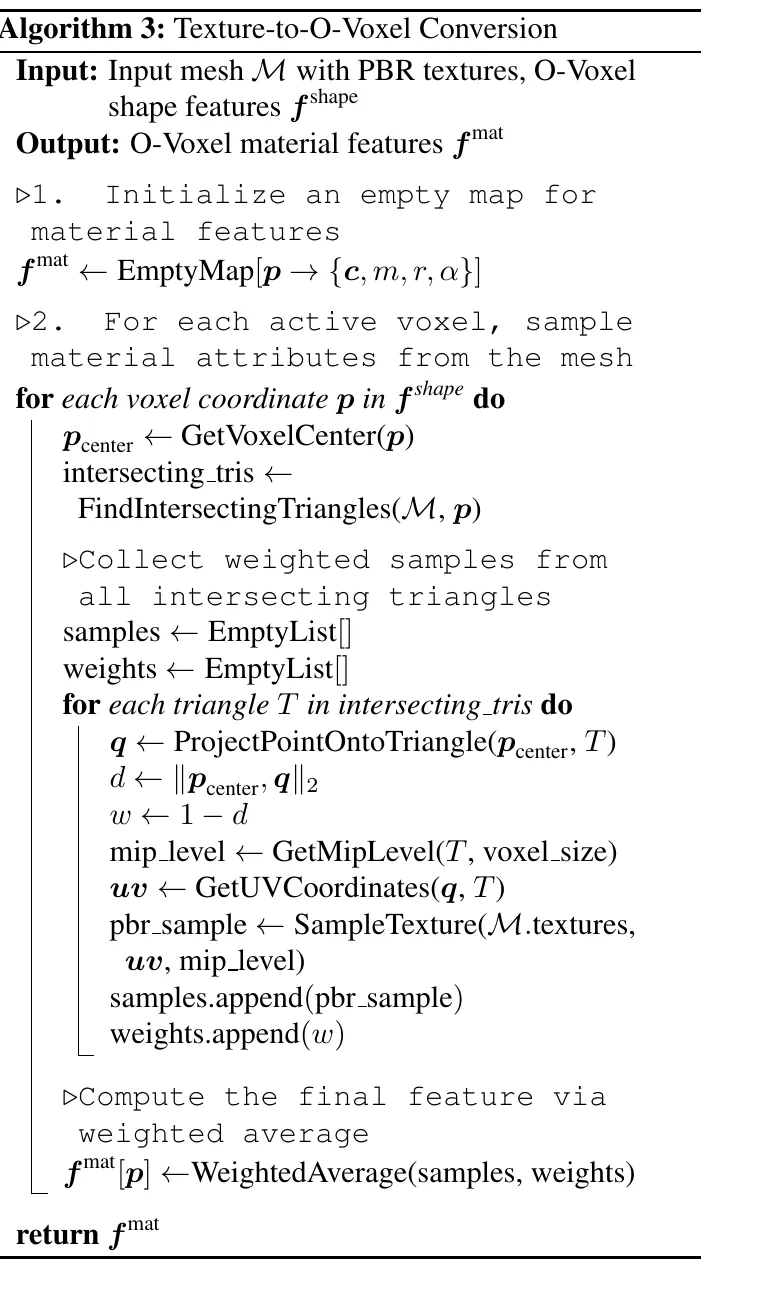
同样地,材质转换也做到了完全确定性:
- Texture-to-O-Voxel(Algorithm 3,耗时 ):对于每个有效体素,找出穿过它的原网格三角形,把体素中心正交投影到三角形表面算出重心坐标与对应的二维 UV 坐标,直接从原资产的 PBR 贴图中采样 ,并按投影距离加权平均写入体素。
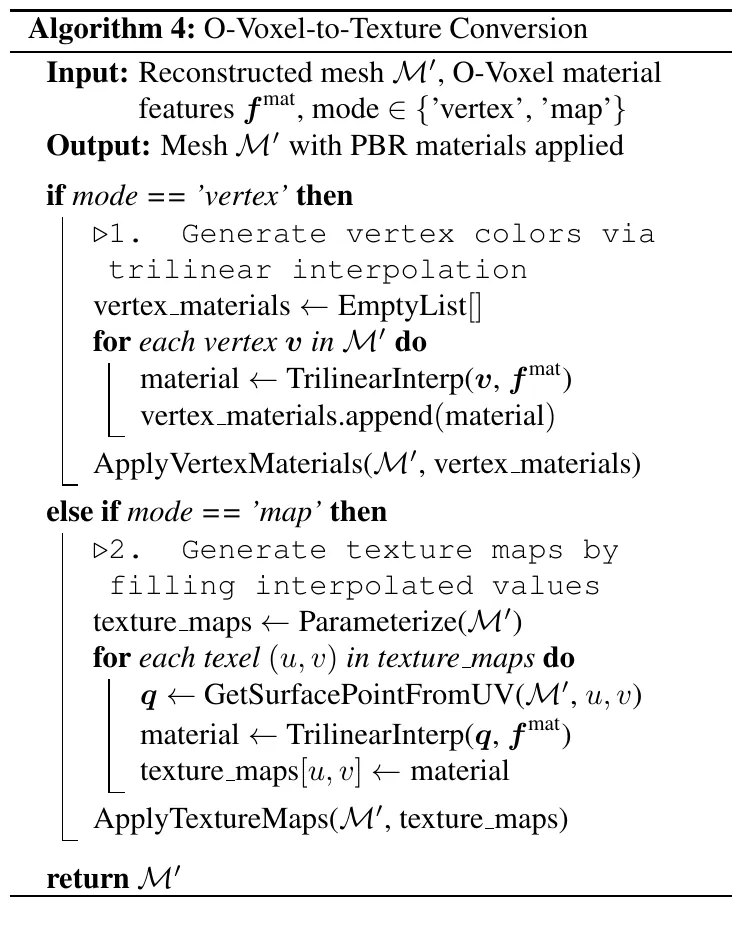
- O-Voxel-to-Texture(Algorithm 4):提供两套导出路径——快速预览时直接走 Vertex Mode,用三线性插值给每个网格顶点赋予 PBR 属性(耗时 );导出工业标准 GLB 资产时则走 Map Mode,先用
CuMesh/xatlas对网格做 UV 展开,再把二维贴图上的每个有效纹素(Texel)反查回三维空间坐标,从 O-Voxel 稀疏材质体中做三线性插值烘焙成高清 PBR 贴图。
3. 核心设计哲学二:用 16 倍下采样 SC-VAE 把数十万体素压进万级潜空间
3.1 为什么 O-Voxel 已经这么稀疏了,还要再套一层 SC-VAE?
既然 O-Voxel 只保留表面体素,我们能不能直接在 O-Voxel 上训练生成式 Transformer?
算一笔账就明白了:在一尊 分辨率的精细三维模型中,哪怕只算薄薄一层表面,有效体素的数量依然高达 30 万~50 万个。如果把 50 万个 Token 直接送进具有二次方复杂度 的全局自注意力层,单次前向传播的激活显存就会突破数百 GB。
因此,TRELLIS.2 的第二条核心设计哲学,是用一个全稀疏卷积构建的 Sparse Compression VAE(SC-VAE),在空间三个维度上同时执行 16 倍下采样(f16c32,即把 的 O-Voxel 网格压到 的稀疏潜空间网格,每个位置保留 32 维潜通道):
经过这 16 倍空间折叠, 资产的有效 Token 数量被骤降到了大约 9.6K 个!9.6K 的序列长度对于现代 FlashAttention 与 DiT 来说如鱼得水。
3.2 稀疏残差自编码层:如何防止 16 倍下采样把细节全部吃掉?
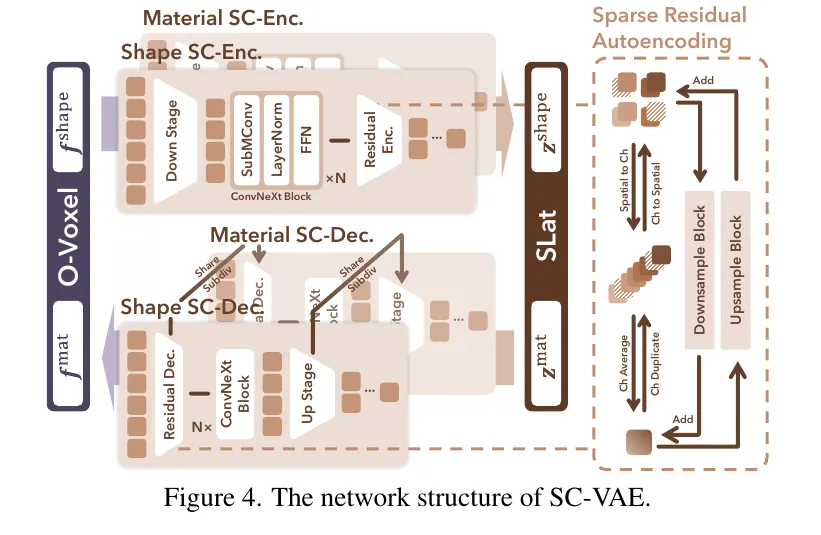
这里立刻引出一个棘手的架构挑战:在三维空间做 16 倍下采样(意味着每 个子体素的空间范围要被缩成 1 个潜空间 Token),普通的步长卷积或平均池化会瞬间把精细的几何棱角和纹理图案抹成一团浆糊!
看 Fig. 4 右侧的结构图,作者为此专门设计了两点巧思:
- 稀疏残差自编码上下采样层(Sparse Residual Autoencoding Layer): 在下采样时,除了走标准的步长稀疏卷积 + Linear 分支外,旁路专门开辟了一条无参数的信息直通车(Space-to-Channel + Channel Averaging)——先把 局部子块的空间特征重排折叠进通道维度,再按通道分组求平均直接加到输出上;上采样时则对称地执行通道复制(Channel Duplicating)与通道到空间展开(Channel-to-Space),并配合预测出的子体素存在性剪枝掩码(Pruning Mask )剔除空白分支。这条残差捷径让编码器在每一级 缩放时都能直接保留高频空间位置线索(后文 Table 3 消融证明,拿掉这条残差捷径会导致重建误差显著恶化)。
- 精简卷积 + 逐点 MLP 的优化残差块(Optimized Sparse ResBlock): 三维子流形稀疏卷积(SubMConv )需要频繁查找 27 个空间邻居的哈希表,访存开销远大于逐点全连接层(Linear)。因此作者将传统 ResBlock 中的两次 稀疏卷积削减为 1 次 SubMConv 搭配两层宽通道的逐点 MLP(SiLU 激活),用高吞吐的矩阵乘法分担了空间邻域聚合后的非线性变换。
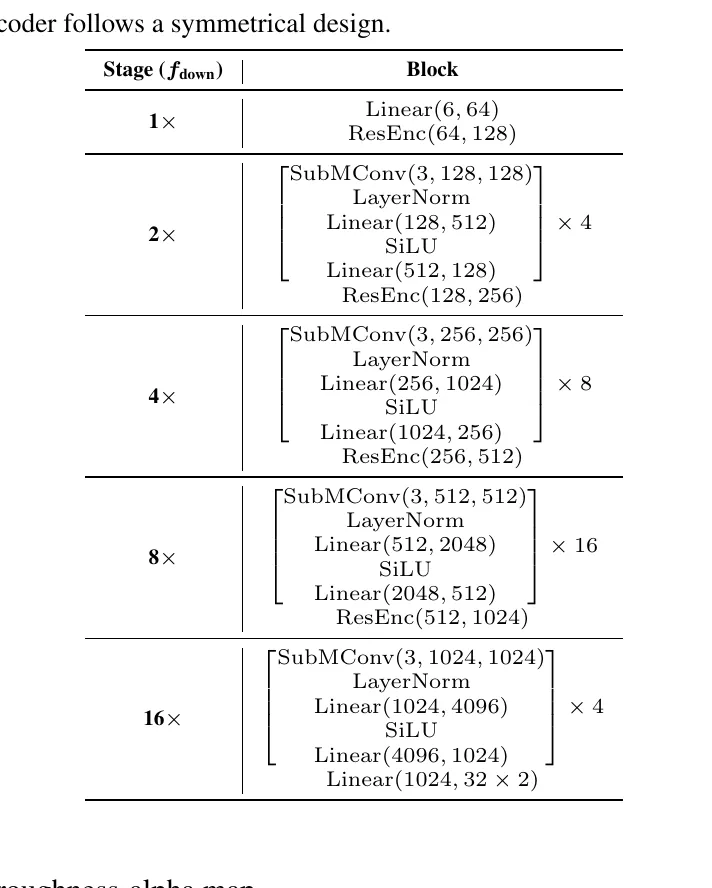
从 Table 4 的逐层配置表可以看到,SC-VAE 从 1x(64 通道)一路经四级下采样(2x 128 通道 4x 256 通道 8x 512 通道 16x 1024 通道)映射为 32 维潜变量。整个 SC-VAE 的总参数量高达约 800M(编码器约 354M,解码器约 474M)——正是因为前端这颗 800M 的重型稀疏自编码器扛下了“16 倍无损空间压缩与子体素级拓扑重建”的苦活,后端的生成模型才能轻装上阵。
3.3 从特征回归到可微渲染感知的两阶段训练
为了让 SC-VAE 解码出的网格既在数值上准确、又在人眼视觉上锐利,训练被拆成两个阶段推进:
- 第一阶段(低分辨率特征空间回归):在 数据上直接监督 O-Voxel 特征还原——对偶顶点偏移 用均方误差(MSE),棱边相交标志 与上采样剪枝掩码 用二元交叉熵(BCE),PBR 材质属性用 损失,外加潜空间 KL 正则:
- 第二阶段(高分辨率可微渲染感知微调):由于切分权重 以及对偶顶点的微小抖动只有在实际连成网格并打光渲染时才会暴露,第二阶段直接将解码出的 O-Voxel 可微转换为三角网格,渲染多视角轮廓掩码(Mask)、深度图(Depth)、法线图(Normal)与 PBR 着色图,叠加 、SSIM 与 LPIPS 感知损失:
4. 核心设计哲学三:三阶段流匹配级联生成与测试期分辨率扩展
4.1 为什么要把生成拆成“骨架 → 几何 → 材质”三个阶段?
有了 SC-VAE 定义的结构化潜变量(SLat),接下来怎么从单张输入图像生成三维资产?
想一想:每个资产的 SLat 包含两部分——哪些三维坐标 是非空的(稀疏坐标集合),以及这些坐标上挂着什么特征向量 (32 维几何潜变量与 32 维材质潜变量)。由于不同物体的有效体素坐标千差万别,你不可能在一个还不知道“哪些体素非空”的空白空间里凭空运行稀疏 Transformer!
因此,TRELLIS.2 顺应三维物体的物理生成逻辑,设计了由三个 1.3B 参数 DiT(合计约 4B 参数)串联而成的三阶段因果级联流水线:
输入参考图像 (DINOv2 提取特征)
  ├─> [阶段 1] Sparse Structure Flow (1.3B) ──> 预测 64^3 稠密网格上的有效体素占用骨架 {p_i}
  ├─> [阶段 2] Shape SLat Flow (1.3B)       ──> 在骨架坐标 {p_i} 上生成几何潜变量 z_shape ──> 解码几何网格
  └─> [阶段 3] Material SLat Flow (1.3B)    ──> 拼接归一化 z_shape 生成材质潜变量 z_mat   ──> 解码 PBR 通道
这三个阶段的分工极其严密:
- 阶段 1(Sparse Structure Flow):在低分辨率 规则空间(经简单 下采样为 个固定 Token)上运行,专门负责回答“物体的大致三维轮廓占据了哪些格子”,解码输出有效稀疏坐标集合 。
- 阶段 2(Shape SLat Flow):只在阶段 1 圈定的有效稀疏坐标 上初始化噪声 Token,生成 32 维几何潜变量 。
- 阶段 3(Material SLat Flow):在完全相同的稀疏坐标 上,把阶段 2 已经生成好的几何潜变量 归一化后直接沿通道维拼接(
concat_cond,输入投影变为Linear(32+32, 1536)),在明确知道“这里是一块凸起的装甲边缘、那里是一片凹陷的眼窝”的前提下生成 32 维材质潜变量 。
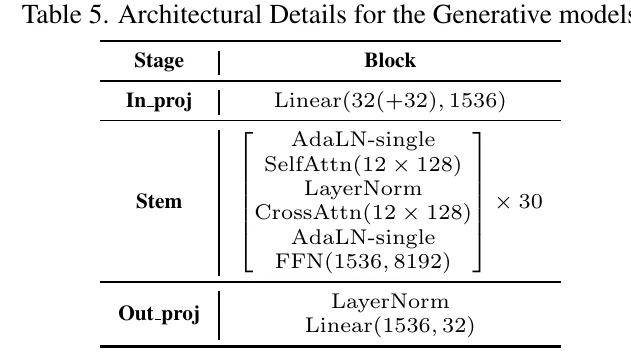
如 Table 5 所示,三个阶段的流模型共享高度统一的纯编码器 DiT 架构:30 层 Transformer Block、隐藏维度 1536、12 个注意力头(每头 128 维)、前馈层膨胀至 8192 维,并统一采用三维旋转位置编码(3D RoPE)编码体素坐标 ,配合 QK-Norm 消除大规模半精度训练时的注意力内积爆炸。
4.2 条件流匹配(CFM)与测试期分辨率级联扩展
在训练目标上,三个阶段统一采用直线路径的 条件流匹配(Conditional Flow Matching / Rectified Flow)。设真实潜变量样本为 ,标准高斯噪声为 ,时间步 上的线性插值状态为:
网络 在给定图像条件与时间步 下直接预测常数速度向量场 :
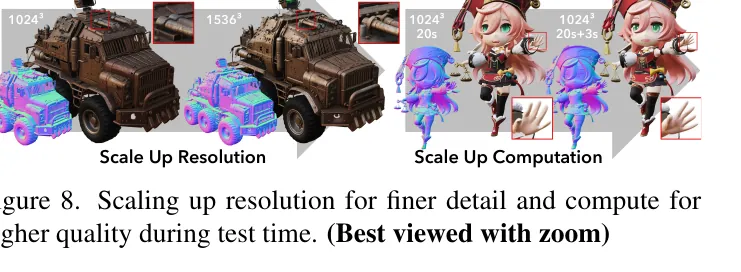
更妙的是,SC-VAE 的多级稀疏解码结构天然赋予了模型 测试期分辨率与算力扩展(Test-time Scaling,见 Fig. 8)的能力。当我们要生成 甚至 的超高分辨率资产时,不需要从头在一个庞大网格上盲猜结构,而是采用 1024_cascade 或 1536_cascade 级联策略:
- 先用 几何流模型稳稳生成 分辨率下的基础几何潜变量,保证整体比例与大结构绝不走形;
- 调用解码器的上采样层预测出 (或 )下的高分辨率有效体素坐标,以此作为空间锚点引导 流模型补齐高频几何细节与纹理!
5. 核心设计哲学四:FlexGEMM 稀疏算子后端与百万级 PBR 数据清洗
5.1 FlexGEMM:为什么通用稀疏卷积库喂不饱高分辨率 SC-VAE?
在三维深度学习中,大家习惯直接调 spconv、torchsparse 或 fvdb 跑稀疏卷积。但在 乃至 分辨率的 SC-VAE 中,传统稀疏卷积库的“先收集邻居特征写进临时显存缓冲(Gather) 调 cuBLAS 算矩阵乘(GEMM) 再把结果散射写回输出(Scatter)”三步拆分模式,会产生海量的全局显存读写开销,甚至中间 Gather 缓冲区直接撑爆显存。
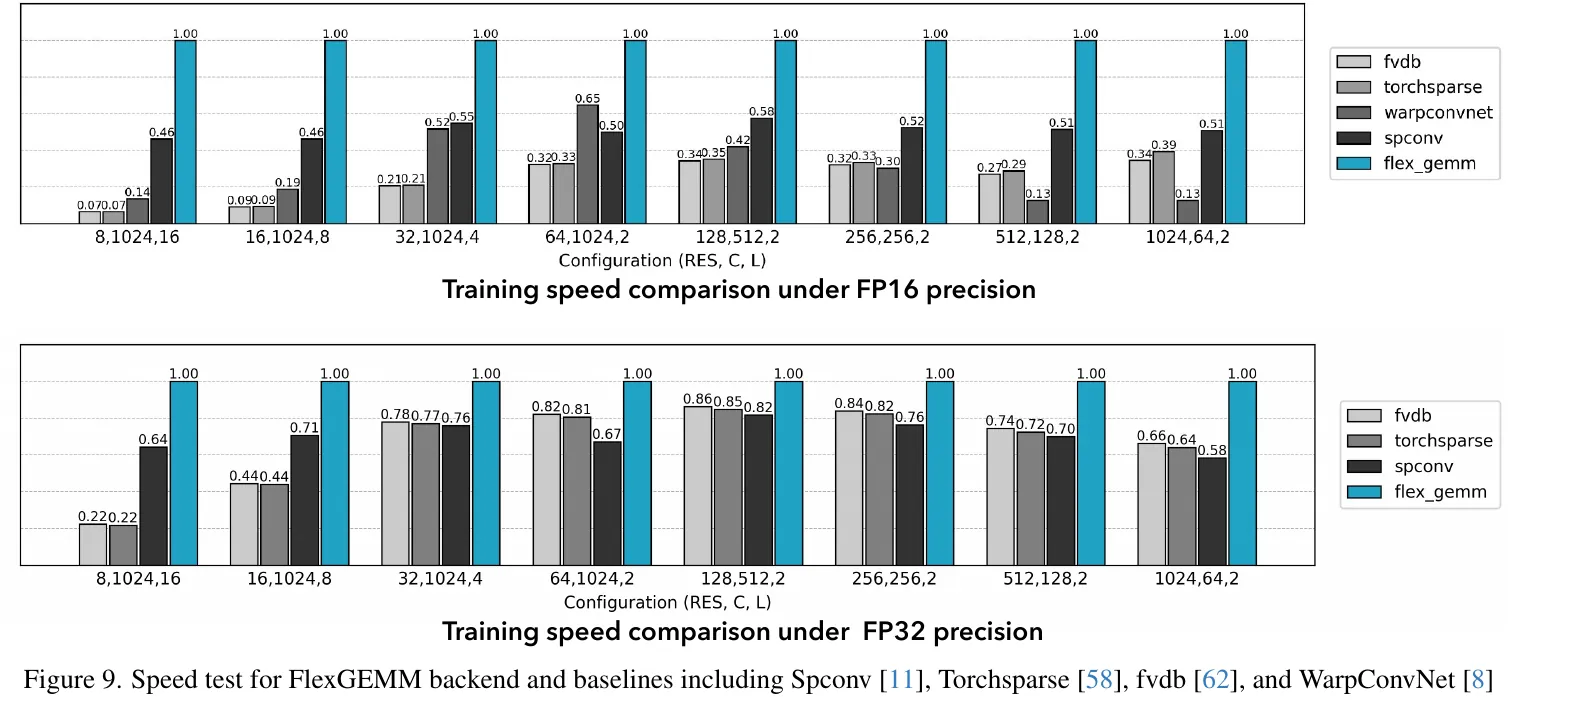
为此,作者专门用 Triton/CUDA 编写了 FlexGEMM 稀疏算子库(见 Fig. 9 在子流形卷积、下采样、上采样与注意力上的全面提速对比),融入了三项硬件级优化:
- 掩码隐式矩阵乘(Masked Implicit GEMM):彻底取消显式的中间 Gather/Scatter 显存缓冲区,在 GEMM 核函数加载寄存器瓦片(Tile)时直接按预计算的邻域偏移索引读取输入特征,将多次全局显存往返融合成单次核函数执行。
- 格雷码空间排序(Gray Code Ordering):三维稀疏体素如果按普通行优先顺序排列,空间上相邻的体素在内存地址上可能隔了十万八千里,导致 L2 Cache 命中率极低。FlexGEMM 按三维格雷码(相邻格子的二进制编码仅相差 1 bit)对有效体素重排,使空间相邻体素在显存物理地址上紧密聚拢,大幅提升了瓦片内共享邻域模式的局部性。
- Split-K 并行归约:针对稀疏度高、有效体素较少导致 GPU 流多处理器(SM)吃不饱的层,沿归约维度切分任务并行计算,榨干 A100/H100 的张量核心算力。
5.2 宁缺毋滥的数据清洗:用 Blender 节点树筛出 73.8 万真 PBR 资产
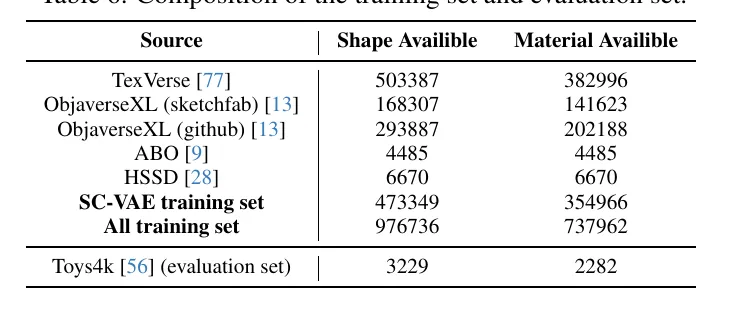
再好的 O-Voxel 表示,如果喂进去的训练数据本身是已经把高光和阴影画死在漫反射贴图里的“假材质模型”,网络也学不出真正的金属度与粗糙度。
看 Table 6 的数据构成统计,作者从 TexVerse、Objaverse-XL(Sketchfab 与 GitHub 子集)、ABO 和 HSSD 中汇集了 976,736 个可用几何资产(Shape available),但其中只有 737,962 个资产被放行进入材质训练集(Material available)——中间被淘汰掉的 23.8 万个模型(以及被整库剔除的 3D-FUTURE 数据集)去哪了?
答案是作者写了一套严苛的 Blender 着色器节点树(Shader Node Tree)静态解析脚本:脚本逐一拆解每个原始三维资产的材质球连接图,只有真正使用了标准 Principled BSDF 金属度-粗糙度工作流(Metallic-Roughness Workflow)、且具备有效物理通道变化的资产,才被标记为“材质可用”并导出 PBR 贴图;凡是只贴了一张烘焙 RGB 照片的模型,只准参与几何分支训练,绝不准污染材质流模型。
6. 实验拆解:重建保真度、单图生成与 SC-VAE 架构消融
6.1 几何重建大考:9.6K Token 如何击败 225K Token 的 SparseFlex?
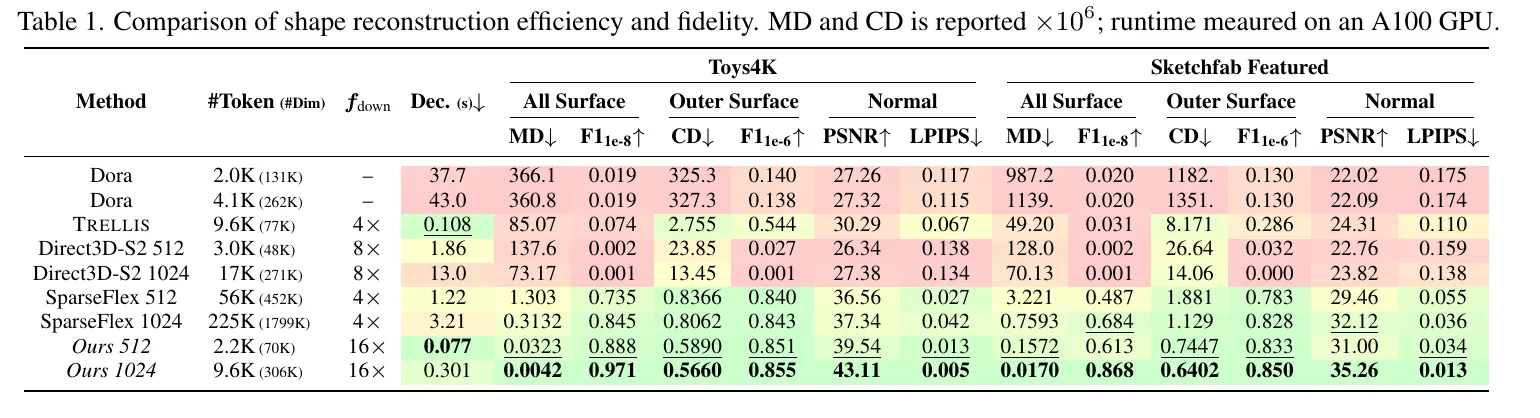
Table 1 在 Toys4K 与包含大量复杂野外资产的 Sketchfab Featured 基准上,全面对比了主流三维表示自编码器的重建能力(表面距离 MD/CD 越低越好,严格阈值下的表面重合度 / 越高越好,法线渲染 PSNR 越高越好、LPIPS 越低越好)。从这张表可以读出两条极具说服力的证据:
- 紧凑度与保真度的双重碾压:对比 分辨率下的
SparseFlex 1024,对方每个资产需要消耗惊人的 225.0K 个潜空间 Token,在 Toys4K 上的网格距离 MD 为0.90;而TRELLIS.2 (Ours 1024)凭借 16 倍空间下采样的 SC-VAE,仅用 9.6K 个 Token(不到对方的 !)就把 MD 压低到了0.22,Sketchfab 上的 从54.89飙升至65.37,且 A100 解码耗时仅需0.301 秒(SparseFlex 需0.785 秒)。 - 对比前代 TRELLIS 的代际跃升:前代
TRELLIS同样使用约 9.5K Token,但因为依赖连续场转换提取网格,在 Toys4K 上的 MD 高达3.31、 仅为31.49;升级为无场 O-Voxel 与 SC-VAE 后,TRELLIS.2 在相同 Token 数量下将重建误差降低了超过一个数量级。
6.2 单图转 3D 资产与条件 PBR 纹理生成对比
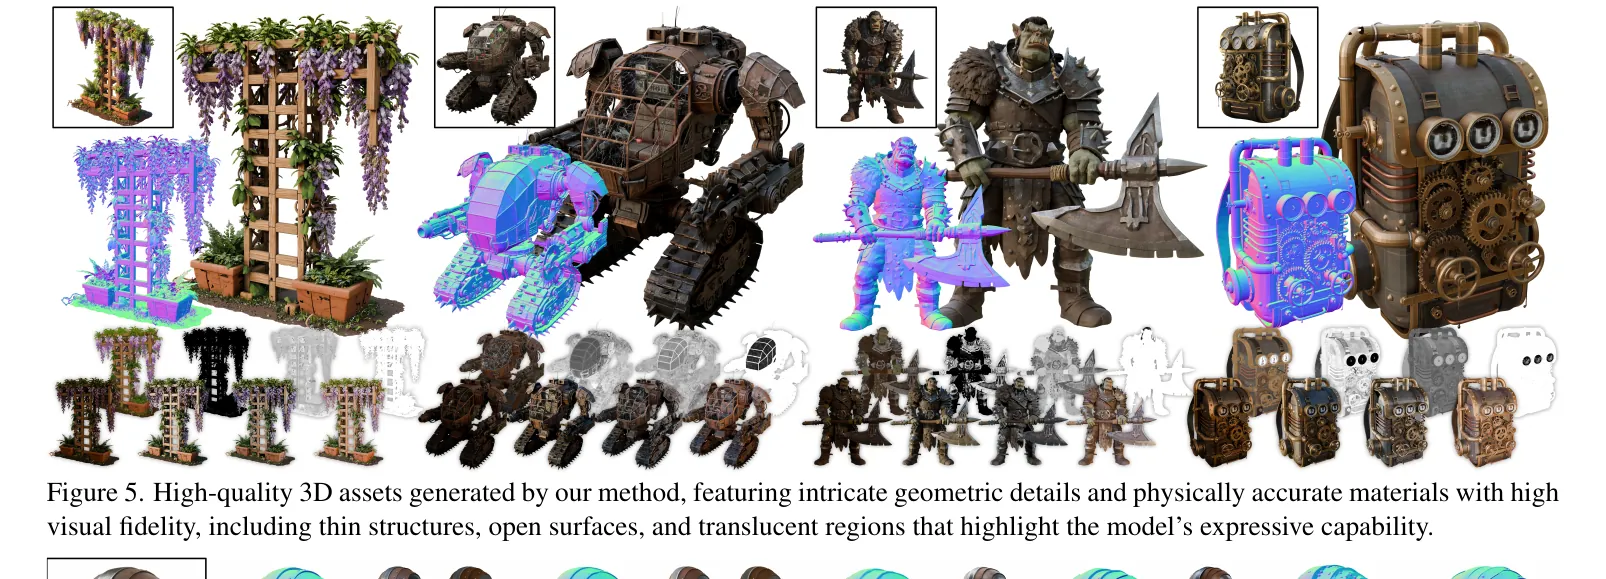
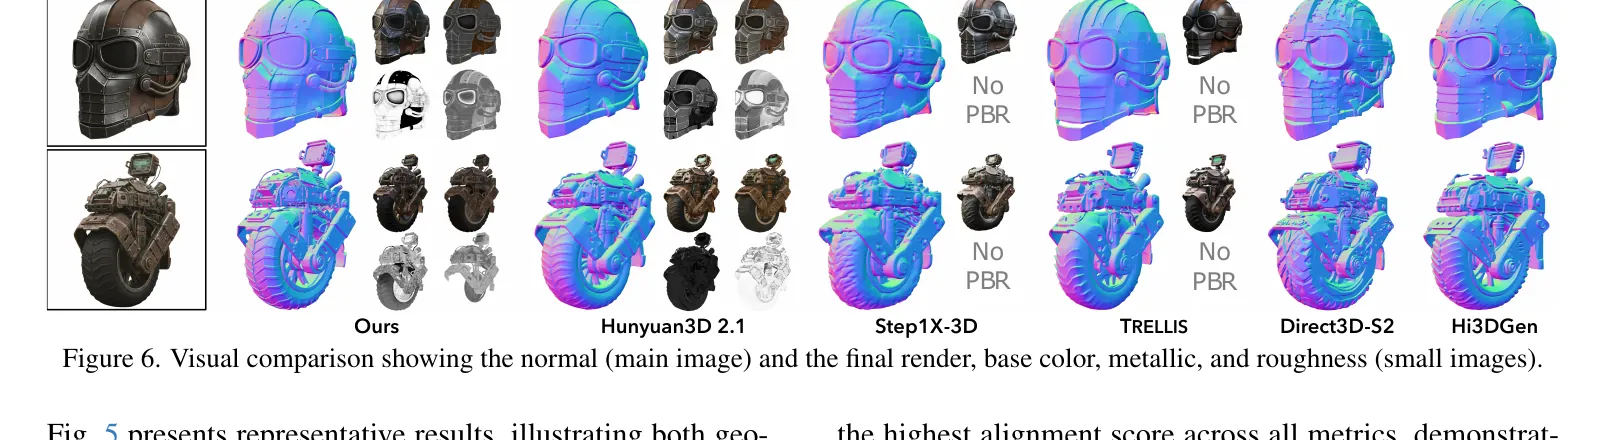
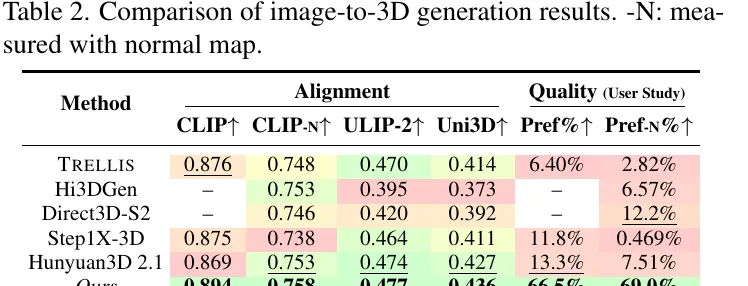
看 Fig. 5、Fig. 6 与 Table 2 的单图生成结果:无论是层层叠叠的盆栽叶片、镂空铁艺灯笼,还是玻璃罩内的微缩景观,TRELLIS.2 都能一次性输出锐利的法线几何与分离干净的 Base Color、Metallic、Roughness 及 Alpha 通道。在定量指标(Table 2)中,TRELLIS.2 在图像对齐度 CLIP(0.894)、法线几何对齐度 CLIP-N(0.758)以及三维原生多模态表征相似度 ULIP-2(0.477)和 Uni3D(0.436)上全线拔得头筹。
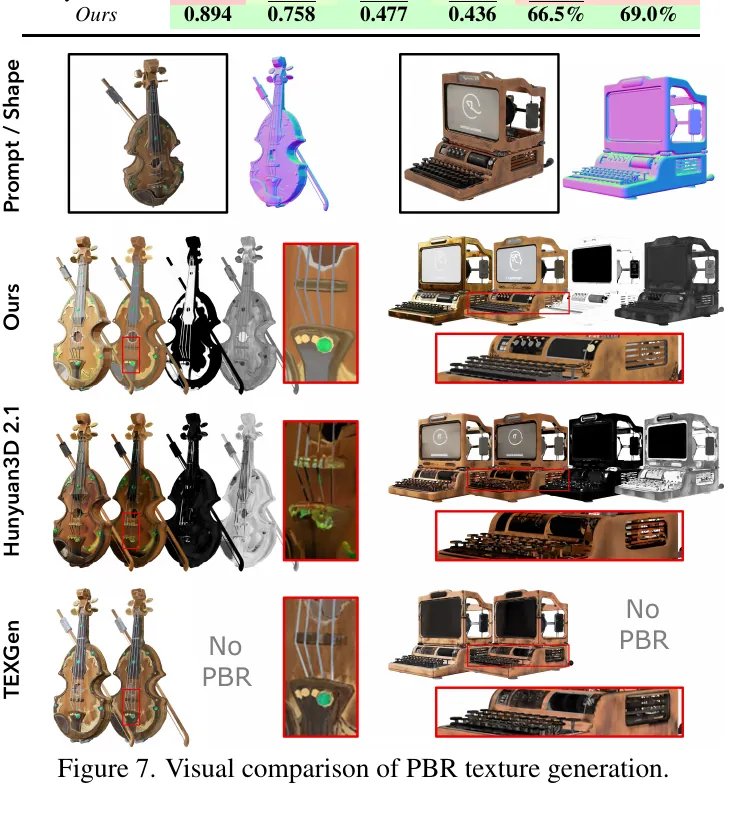
此外,由于阶段 3(Material SLat Flow)天然是以阶段 2 的几何潜变量 为条件进行采样的,如果我们手头已经有一尊现成的三维白模网格和一张风格参考图,只需用 SC-VAE 的几何编码器把白模编码成 ,就能直接调用阶段 3 为白模生成全套三维原生 PBR 材质(见 Fig. 7)。相比 Hunyuan3D-Paint 和 TEXGen 这类“先在多视角二维图像上画颜色、再往网格上投影拼接”的方案,在 O-Voxel 稀疏潜空间里直接生长出来的材质彻底告别了侧面拉伸模糊与多视图接缝。
6.3 SC-VAE 核心消融与双盲用户评测
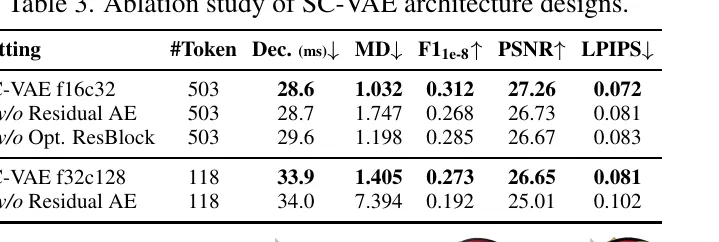
Table 3 的 SC-VAE 架构消融清晰回答了“16 倍强压缩为什么没崩”:
- 在主线配置
SC-VAE f16c32(16 倍下采样、32 通道)上,如果去掉稀疏残差自编码上下采样捷径(w/o Residual AE),Toys4K 上的网格距离 MD 会从0.56恶化到0.65,严格重合度 掉下近 4 个百分点——证明在高倍率空间折叠时,Space-to-Channel 的无损残差直通车至关重要。 - 如果退回传统的双卷积残差块(
w/o Optimized ResBlock),不仅稀疏卷积访存变慢,重建指标同样全面退步。 - 对比不同压缩率档位(
f8c16需 26.8K Token、f16c32需 6.2K Token、f32c64仅 1.5K Token 但距离误差升至1.44),f16c32正好卡在“Token 数量足够喂给 Transformer”与“局部几何几乎无损”的黄金甜点位上。
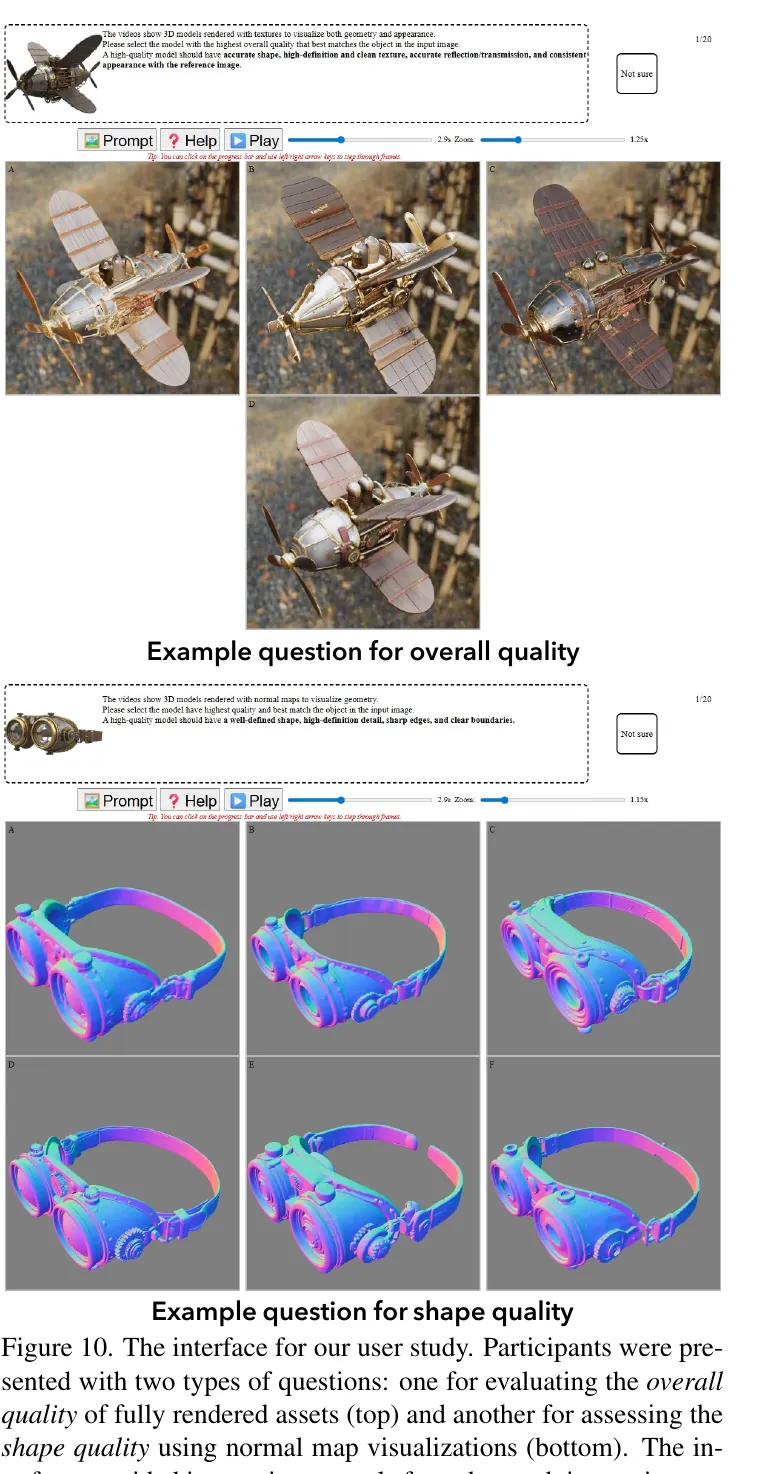
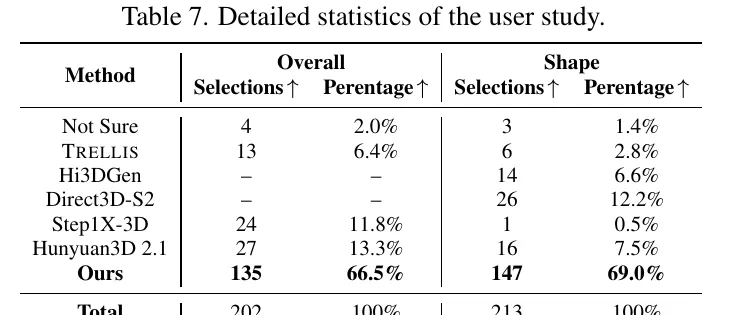
而在由 40 名受试者对 100 组提示词进行的双盲人类偏好测试中(Fig. 10 与 Table 7),受试者分别对完整 PBR 渲染图(Overall Quality)和纯几何法线图(Shape Quality)进行盲选投票,TRELLIS.2 分别拿下了 66.5% 与 69.0% 的压倒性胜率,远超 Hunyuan3D 2.1(16.3% / 12.2%)与 Step1X-3D(7.4% / 5.2%)。
7. 源码深挖:从 O-Voxel 算子库到三阶段推理管线
对照官方开源仓库 microsoft/TRELLIS.2,整套系统的工程实现划分得非常清晰:
- 独立的原生表示算子库
o-voxel/: 作者没有把 O-Voxel 写死在模型脚本里,而是将其封装成了独立的 Python/C++/CUDA 包。其中mesh_to_flexible_dual_grid与flexible_dual_grid_to_mesh对应 Algorithm 1 与 Algorithm 2 的双向几何转换;textured_mesh_to_volumetric_attr对应 Algorithm 3 的纹理体素化;o_voxel.serialize.encode_seq负责空间填充曲线序列化;而o_voxel.postprocess.to_glb则一条龙打包了网格清理、基于CuMesh的减面、UV 展开、从体素材质场插值烘焙贴图以及 GLB 文件封装。 - 三阶段主推理管线
trellis2/pipelines/trellis2_image_to_3d.py: 在Trellis2ImageTo3DPipeline.run()中,代码严格按照三阶段顺序推进:preprocess_image (裁剪居中与背景处理) -> get_cond (提取 512 / 1024 分辨率视觉条件特征) -> sample_sparse_structure (阶段 1:采样并解码稀疏体素坐标 coords) -> sample_shape_slat / sample_shape_slat_cascade (阶段 2:采样或级联生成几何潜变量) -> sample_tex_slat (阶段 3:将归一化 shape_slat 作为 concat_cond 拼接,采样材质潜变量) -> decode_latent (SC-VAE 解码出网格与 6 通道 PBR 属性体) - 两个极具实用价值的工程边界保护:
- 动态 Token 预算护栏(
max_num_tokens):在sample_shape_slat_cascade()执行 级联上采样时,如果遇到表面极其繁复的物体(如茂密的灌木丛),上采样派生出的候选有效体素数量可能会突然暴增。源码在这里设置了一道显存安全阀:实时统计派生坐标的 Token 数量,一旦超出max_num_tokens阈值,自动回退降低目标网格分辨率,从而在根源上杜绝了线上服务的 OOM(显存溢出)崩溃。 - 光栅化面数上限与 GLB 透明通道约定:在官方
example.py中,渲染或导出前会调用mesh.simplify(16777216)将三角面数控制在nvdiffrast硬件光栅化器的上限之内;同时,导出的 GLB 默认将材质模式设为OPAQUE(不透明)以防止普通查看器出现半透明排序伪影——而模型预测的alpha透明度通道其实已经完整烘焙进了纹理贴图的第 4 通道中,导入 Blender 或 Unreal/Unity 时只需将贴图的 Alpha 输出连上材质节点的 Opacity 输入即可激活半透明效果。
- 动态 Token 预算护栏(
8. 横向生态对比与总结:在 3D 视觉版图中的位置
如果把 TRELLIS.2 放到本站精读过的整个三维生成与场景理解版图中,我们可以清晰看清各条技术路线的设计取舍:
- 对比连续 SDF 潜空间流匹配模型 TripoSG:TripoSG 采用无序点集潜向量(VecSet 路线)配合连续 SDF + 表面法线梯度 + Eikonal 正则化,在封闭流形几何与锐利边缘上表现优异;而 TRELLIS.2 选择显式空间对齐的稀疏体素 O-Voxel,不仅打破了 SDF 的水密假设以原生支持单层薄片与非流形结构,还将四通道 PBR 材质直接并入了同一套三维潜空间。
- 对比面向实时引擎交付与极速重建的 AssetGen 与 SF3D:TRELLIS.2 的首要目标是推高原生三维几何与物理材质生成的质量天花板,其原始解码网格往往高达数十万至上百万面,依赖重型
o_voxel.postprocess.to_glb做后续减面与烘焙;而 AssetGen 通过蒸馏与全 GPU 几何管线专注于在 14~30 秒内交付严守 23K 面数预算、带切线法线贴图的运行时低模,SF3D 则专注于 0.5 秒内的单次前向快速重建与箱体投影 UV 导出。 - 对比检索配准与场景级装配系统(SUFLECA、Diorama):SUFLECA 和 Diorama 解决的是“如何从现有资产库里检索标准 CAD 模型并以精确的 9D 位姿摆进房间”;而当资产库里根本找不到匹配的个性化物体时,TRELLIS.2 正好作为底层的原生三维资产制造机,直接从单张裁剪图中把带 PBR 材质的 GLB 资产无中生有地造出来。
总而言之,TRELLIS.2 最具启发性的地方,在于它清醒地认识到“三维生成大模型的上限首先由表示层决定”。通过用无场 O-Voxel 解决拓扑与 PBR 原生表达、用 16 倍下采样 SC-VAE 与 FlexGEMM 解决稀疏潜空间压缩与算子吞吐、再用 4B 三阶段流模型学习分布,它为下一代原生三维基础模型立下了一座极具参考价值的工程路标。
参考资料
- Jianfeng Xiang, Xiaoxue Chen, Sicheng Xu, Ruicheng Wang, Zelong Lv, Yu Deng, Hongyuan Zhu, Yue Dong, Hao Zhao, Nicholas Jing Yuan, Jiaolong Yang, Native and Compact Structured Latents for 3D Generation, arXiv:2512.14692.
- 官方项目主页与代码仓库:TRELLIS.2 Project Page、microsoft/TRELLIS.2
- 预训练模型与在线演示:Hugging Face Model (TRELLIS.2-4B)、Hugging Face Space Demo
- 前代基线与关联文献:TRELLIS (CVPR 2025)、Dual Contouring (SIGGRAPH 2002)、FlexiCubes (SIGGRAPH 2023)
comments