以 LRM 和 TripoSR 为代表的前馈式(Feed-Forward)单图三维重建模型,曾完成了一次漂亮的效率跃迁:不用再像 DreamFusion 那样为每张图片跑几十分钟的 SDS 优化,神经网络只需单次前向推理就能在半秒内吐出一个三维场。
但当你满怀期待地把 TripoSR 导出的网格拖进 Blender 或 Three.js 场景、试着给它换一盏环境光时,四个刺眼的工程缺陷就会立刻暴露出来:原图里的暗部阴影和镜面高光被原封不动地“画”死在了物体表面,新光源从侧面打过去,原本的假阴影纹丝不动;颜色全部绑在网格顶点(Vertex Color)上,一旦为了移动端减面,表面图案瞬间糊成马赛克;从低分辨率隐式场用 Marching Cubes 抽出来的曲面布满了一圈圈等高线式的台阶波纹;而且整个模型没有任何粗糙度(Roughness)或金属度(Metallic)属性,不管是金属水壶还是陶瓷杯子,转起来全都像一块死气沉沉的石膏。
怎样在不牺牲 0.5 秒级 极速前馈体验的前提下,把一个“只能在固定视角下看神经渲染图的隐式场”,彻底改造成一个“带干净 UV 贴图、切线空间法线贴图、PBR 材质参数且剥离了原图阴影”的标准 GLB 资产?
Stability AI 与伊利诺伊大学厄巴纳-香槟分校(UIUC)团队在 SF3D: Stable Fast 3D Mesh Reconstruction with UV-unwrapping and Illumination Disentanglement(PDF、HTML 全文、项目主页、官方代码 Stability-AI/stable-fast-3d、Hugging Face 权重)中给出了教科书级的改造方案。
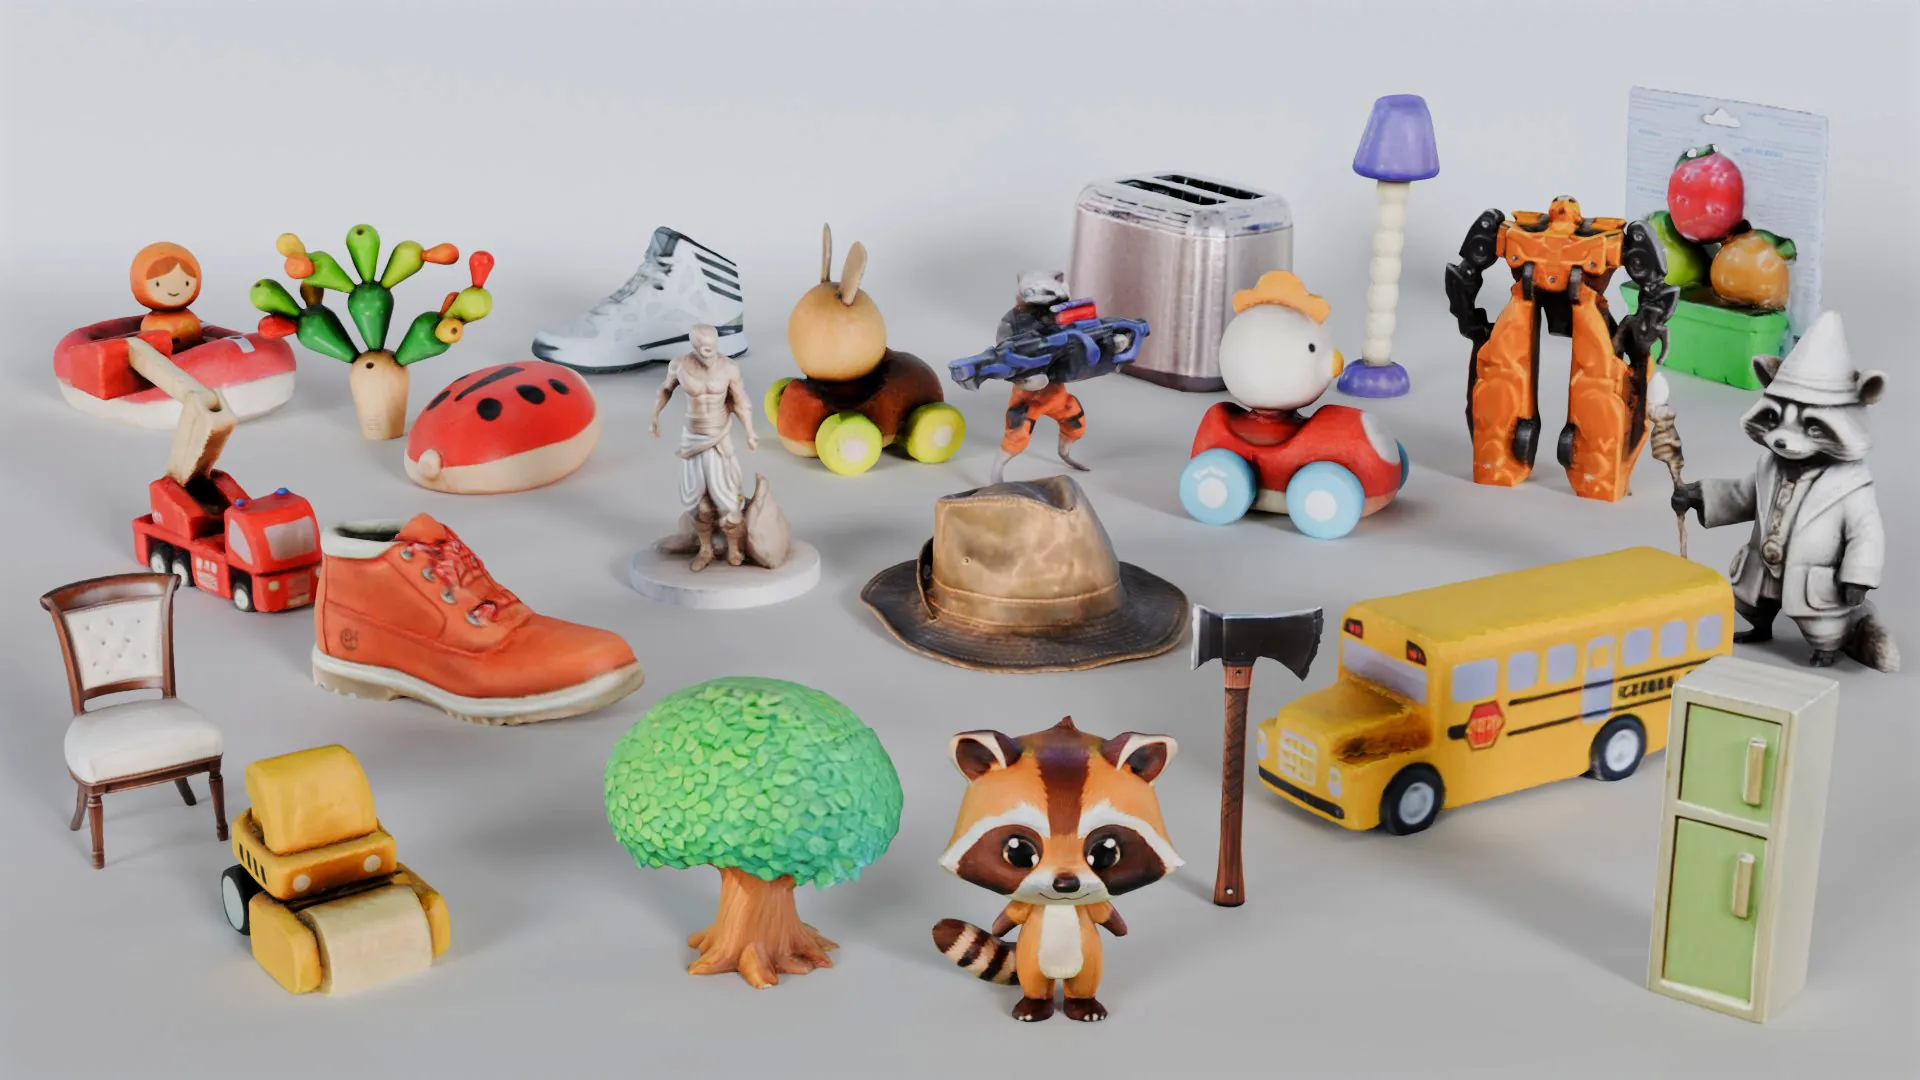
透过具体的网络层与损失项看本质,SF3D 的整套设计建立在四条环环相扣的工程设计哲学之上:
- 用“低维潜流算注意力 + PixelShuffle 升分辨率”突破三平面走样瓶颈,拒绝平方级算力爆炸:低分辨率()三平面是导致纹理模糊和网格锯齿的罪魁祸首,但如果直接把三平面扩到 (多达 44.2 万个 Token)去跑 Transformer 自注意力,计算量会暴增上百倍。SF3D 采用双流解耦架构,让紧凑潜变量流承担核心注意力计算,再通过卷积与子像素重排(PixelShuffle)在末端一次性放大 4 倍空间分辨率至 。
- 把显式网格提取拉进训练闭环,用 DMTet + 顶点偏移 + 法线平滑根治等值面台阶:不再把提取网格当成推理时临时调一下的后处理,而是在 NeRF 体渲染预热后,直接切换为可微四面体网格提取(DMTet)进行端到端网格光栅化训练,允许模型预测局部顶点偏移(Vertex Offset)与高频法线补偿,在 四面体网格上直接捏出顺滑锐利的曲面。
- 用受限球面高斯“吸走”环境阴影,用 Beta 分布众数治愈材质回归的“均值坍缩”:从单张图片同时猜反照率、光照和材质是经典的病态逆问题。作者一边用固定轴向与锐度的球面高斯(Spherical Gaussians)配合白模解调损失把低频明暗阴影单独剥离出来;另一边放弃直接用 MSE 回归粗糙度/金属度标量,改让网络预测 Beta 概率分布的两个形状参数 并取其众数(Mode)输出——彻底解决了网络遇到材质歧义时偷懒输出折中废解(0.5)的顽疾。
- 放弃秒级全局 UV 优化,用 C++/CUDA 箱体投影与光栅化烘焙死守 0.5 秒红线:通用几何库
xatlas展开一个网格动辄耗时数秒,足足比神经网络推理慢十倍。SF3D 编写了专用的 C++ 箱体六面投影与重叠分流 UV 展开器,配合 CUDA/Metal 原生光栅化纹理烘焙核函数,在几十毫秒内完成了从三维三平面场到二维 PBR 贴图的转换。
下面我们就顺着这四条设计哲学,结合论文公式与开源仓库源码,深入拆解 SF3D 的技术内幕。
1. 为什么传统快速单图重建难以入库?四大工程痛点诊断
在 2023–2024 年的单图重建赛道上,LRM、OpenLRM、TripoSR、InstantMesh 与 CRM 等方法证明了从单张图像前馈预测三维场的可行性。然而,这些模型之所以停留在“看视频 Demo 很炫、进引擎管线很难”,是因为它们普遍回避了四个关乎资产可用性的核心痛点:
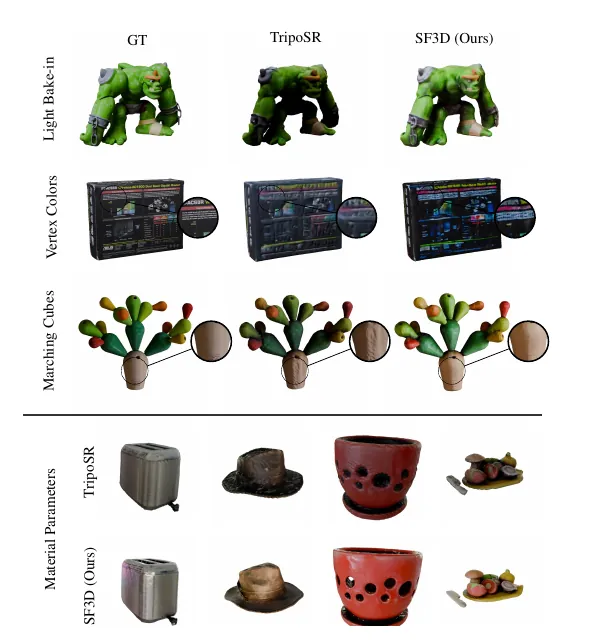
对照 Fig. 2 的四行直观诊断,我们可以看清传统快速重建模型的病灶所在:
| 痛点维度 | 传统快速模型(如 TripoSR)的做法 | 导致什么实际工程后果?(对应 Fig. 2) | SF3D 的针对性解法 |
|---|---|---|---|
| 1. 光照烘焙污染(Light Bake-in) | 直接最小化渲染 RGB 与输入原图的误差,无视原图自带的阴影与高光 | 原图底部的黑影被永久画进贴图(第一行左),进引擎换个光源角度就会出现荒谬的“双层假阴影” | 引入 Light Net 预测球面高斯环境光 + 解调损失,剥离干净的无阴影反照率(Albedo) |
| 2. 顶点色与面数冲突(Vertex Colors) | 不做 UV 展开,直接把 RGB 颜色存放在每个网格顶点上 | 要想保住表面花纹就必须维持极高顶点数;一旦减面,图案立刻崩塌糊掉(第二行左) | 内建极速箱体投影 UV 展开 + GPU 光栅化烘焙,用低模搭配 独立贴图 |
| 3. 等值面阶梯伪影(Marching Cubes) | 在低分三平面上预测密度场,推理时用 Marching Cubes 硬抽等值面 | 曲面上布满一圈圈锯齿状台阶与网格走样波纹(第三行左),打光后惨不忍睹 | 升级 高分三平面 + DMTet 可微四面体提取 + 顶点位移与拉普拉斯平滑 |
| 4. 缺失物理材质(No PBR Material) | 只输出单一 RGB 颜色,默认所有物体均为纯漫反射 | 金属、陶瓷、光滑塑料在动态光照下毫无高光质感差异(第四行左) | 引入 Material Net 预测 Beta 分布参数,输出粗糙度、金属度因子与切线空间法线贴图 |
2. 核心设计哲学一:双流解耦 + PixelShuffle 突破 384×384 三平面瓶颈
2.1 五阶段端到端系统全貌
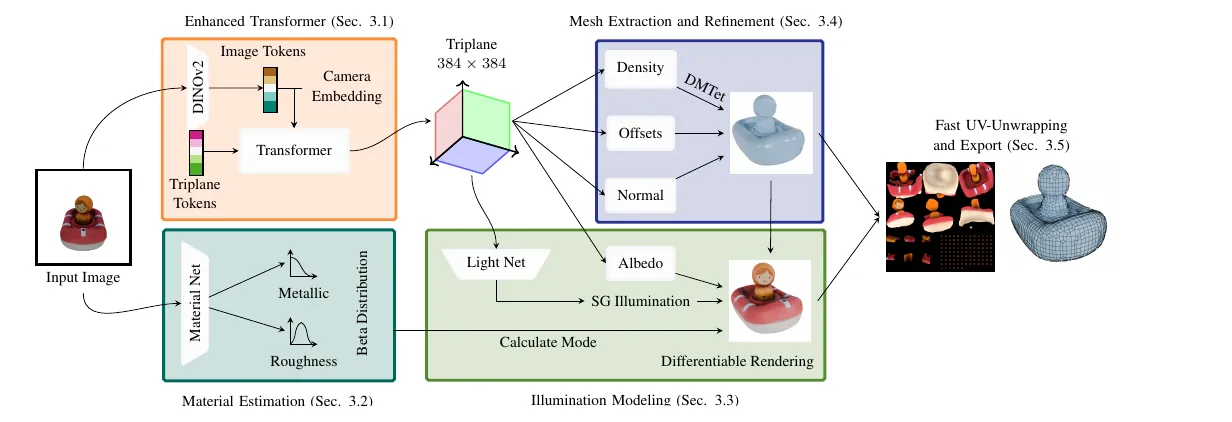
Fig. 3 展示了 SF3D 的五阶段主干链路:
- 图像与相机条件编码:用升级后的 DINOv2 将输入图像编码为高分辨率视觉 Token,同时注入标准正视相机内外参嵌入(Camera Embedding)。
- 增强型双流 Transformer(Enhanced Transformer):融合图像条件与初始三平面查询 Token,输出 的中间特征图,再经 PixelShuffle 上采样为 的高分辨率三平面(Triplane)。
- DMTet 网格提取与精炼:在 四面体网格顶点上查询三平面,解码占用密度与顶点位移向量,提取显式三角网格。
- 球面高斯光照与 Beta 材质估计:并行由 Light Net 估计 24 个球面高斯波瓣照明,由 Material Net 估计全局金属度与粗糙度,支撑训练期的可微延迟 PBR 渲染(Deferred Shading)。
- 极速箱体 UV 展开与贴图烘焙导出:在几十毫秒内完成 UV 展开、三平面属性反查、切线空间法线转换与 GLB 打包。
2.2 为什么三平面必须升到 384×384?双流瓶颈如何规避算力爆炸?
回忆一下三平面(Triplane)表示的工作原理:为了避免三维稠密体素网格 的立方级显存爆炸,我们只维护三个正交的二维特征平面 。对于空间中的任意三维点 ,只需把它分别正交投影到三个平面上做双线性插值,再把采样出的三个特征向量拼起来:
在 TripoSR 中,这三个平面的分辨率只有 。当物体表面有细密文字、条纹或锐利几何转折时,多个相邻的三维网格顶点投影到 平面上会撞进同一个粗大的像素格子里,产生严重的网格状走样伪影(Aliasing Artifacts):
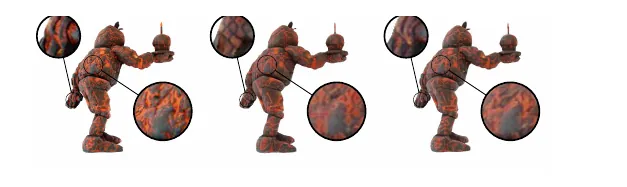
看 Fig. 4 左图的茶壶盖与壶身纹理,低分辨率三平面直接把圆滑的图案切成了锯齿方块;而右图升级到 三平面后,锯齿彻底消失。
但问题来了:如果直接让 Transformer 处理三个 的平面,总 Token 数量高达 个!在 44 万个 Token 上跑全局自注意力,别说 0.5 秒,连单张 H100 的显存都会当场溢出。
SF3D 的解法(对照源码 sf3d/models/transformers/backbone.py 与后文 Fig. A1)是“让低维潜流当大脑,高分三平面当画布”:
- 在 Transformer 内部维护两条流:一条是空间分辨率固定为 的三平面 Token 流,另一条是数量更少的紧凑潜变量流(Latent Stream);
- 在每一层中,先通过
FuseBlock(交叉注意力)把视觉条件与三平面信息汇入紧凑潜变量流,再由ComputeBlock在紧凑潜变量流上执行高维自注意力与前馈计算,随后将更新写回 三平面; - 出了 Transformer 主干后,在
sf3d/models/network.py的PixelShuffleUpsampleNetwork中,先用卷积把通道维扩展为out_channels * 16,再调用nn.PixelShuffle(4)将每个像素的 16 组通道直接重排展开为 的空间子像素块,零注意力开销地将 瞬间推高至 !
3. 核心设计哲学二:DMTet 显式网格闭环、Beta 材质分布与球面高斯去光照
3.1 为什么用 DMTet + 顶点偏移替代 Marching Cubes?
在传统 NeRF/Triplane 模型里,训练时只管用体渲染(Volumetric Ray Marching)算图像颜色损失,模型根本不知道自己最后会被 Marching Cubes 抽成什么样子的网格。结果就是密度场在表面附近软绵绵地过渡,一抽等值面就全是台阶。
SF3D 在经过短期的 NeRF 预训练稳住粗略几何后,果断把训练管线切换为基于 DMTet(Deep Marching Tetrahedra)的可微显式网格光栅化渲染。对照 sf3d/system.py 中的 triplane_to_meshes(),其核心机制仅用五行代码便一目了然:
values = self.query_triplane(grid_vertices, triplane)
decoded = self.decoder(values, include=["vertex_offset", "density"])
sdf = decoded["density"] - self.cfg.isosurface_threshold
deform = decoded["vertex_offset"].squeeze(0)
mesh = self.isosurface_helper(sdf.view(-1, 1), deform.view(-1, 3))
看看这里为什么能消除台阶伪影:
- 模型在预定义的 分辨率四面体网格顶点(
load/tets/160_tets.npz)上查询三平面特征; - 解码器不仅预测标量密度
density(减去阈值isosurface_threshold后转化为符号距离sdf),还同时为每个网格顶点预测了一个三维微调位移向量vertex_offset(deform); - 即使四面体网格本身的格点位置是固定的,有了可学习的
vertex_offset,网格顶点就可以顺着物体表面曲率主动挪动位置去贴合真实边缘;同时模型还额外预测法线补偿贴图,从几何顶点与表面法线双管齐下抹平了离散网格的阶梯感。
3.2 为什么预测粗糙度/金属度不能用 MSE,而要预测 Beta 分布取众数?
为了让导出的 GLB 模型在引擎里拥有金属光泽或哑光质感,Material Net(基于 CLIP 图像编码特征)需要从单张输入图像预测物体的粗糙度 与金属度 。
这里有一个非常隐蔽的机器学习陷阱:在单张照片下,判断一个深色表面到底是“高粗糙度的暗色塑料()”还是“没对准高光角度的低粗糙度金属()”,本身具有极大的多解不确定性。如果你直接拿均方误差(MSE Loss)去强迫网络回归标量真值,根据概率统计基本定理,MSE 的最优解是条件期望(均值)——结果就是网络为了少犯错,不管看到什么物体都一律输出折中均值(比如粗糙度永远猜 0.5,金属度永远猜 0.0),彻底丧失了材质区分度!
怎么打破“均值坍缩”?作者把标量回归改造成了有界区间 上的 Beta 概率分布参数估计:对于材质属性 ,让网络预测 Beta 分布的两个正形状参数 与 :
训练时最大化真值材质的对数似然;而在测试推理时,绝不取均值,直接取概率密度最高峰对应的众数(Mode):
这样一来,哪怕训练数据里存在歧义,Beta 分布也可以通过调节 表达出偏态峰值,推理时取众数就能干脆利落地给出鲜明的金属或粗糙质感,并直接写入导出 GLB 的 PBRMaterial(roughnessFactor=roughness, metallicFactor=metallic) 中。
3.3 球面高斯(SG)环境光与白模解调损失:如何把假阴影从贴图里剥出去?
再看最头疼的光照烘焙污染(Light Bake-in)。一张输入照片上的像素颜色 ,物理上是物体固有反照率(Albedo )与环境光照着色(Shading )的乘积:。如果不给环境光寻找一个合法的出口,三平面解码出的反照率 就会被迫把阴影 一起吞进去。
SF3D 为此引入 Light Net,用 个球面高斯基函数(Spherical Gaussians, SG)来参数化整片环境光球面。单个球面高斯波瓣定义为:
其中 是入射光方向单位向量, 是波瓣中心轴方向, 控制波瓣宽窄锐度, 是波瓣亮度幅值。
但这里同样存在一个逆问题陷阱:如果允许 Light Net 自由预测彩色光照 、任意旋转方向 和任意高频锐度 ,那么当照片里有一个红苹果时,网络完全可以把苹果本身的红色反照率画成纯白色,然后谎称“是环境光恰好往苹果上打了一束红色的聚光灯”!
为了锁死光照分支的自由度、防止它抢走物体本身的固有色和纹理,作者对球面高斯施加了三道极其克制的物理紧箍咒:
- 固定方向与锐度:24 个波瓣的中心轴方向 与锐度 完全固定死,均匀铺满整个球面,只允许表示平滑的低频环境照明;
- 强制灰度照明:幅值 只准预测单通道灰度标量(Grayscale Amplitude),绝不允许环境光改变物体的色相;
- 白模解调损失(Demodulation Loss ):在训练时,专门把提取出的网格变成一个纯白反照率白模(All-white Albedo),放到预测出的球面高斯环境光下渲染出纯光照亮度图,强迫这张亮度图与输入原图经解调分离出的低频明暗分布对齐。
有了这三道约束,原图里柔和的明暗阴影被稳稳地引流到了球面高斯光照分支里,而留在三平面反照率通道里的,就是剥离了环境阴影的干净贴图!
4. 核心设计哲学三:箱体投影 UV 展开与 CUDA/Metal 光栅化烘焙
4.1 为什么不用 xatlas?几十毫秒跑完的箱体投影 UV 算法
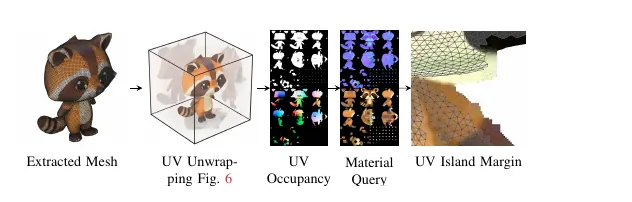
现在模型已经在毫秒级时间内预测出了 三平面特征并由 DMTet 抽出了三角网格。接下来进入 Fig. 5 所示的导出管线(Export Pipeline):要把三维场里的反照率和法线写成一张 的二维贴图,必须先给网格的每个顶点分配二维 UV 坐标。
为什么不能直接调工业界常用的 xatlas 或 geogram?因为这类全局参数化算法为了最小化角度与面积拉伸,需要在整个网格表面反复迭代求解稀疏线性系统或图块生长,单核 CPU 跑一个网格动辄要 3~15 秒——神经网络前向推理才花了 0.3 秒,总不能让用户在导出环节干等 10 秒!
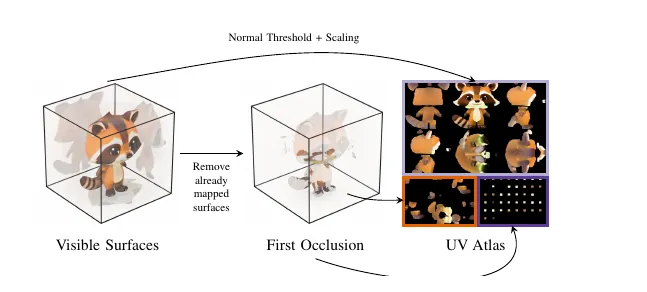
为此,SF3D 在 uv_unwrapper/uv_unwrapper/unwrap.py 与配套 C++ 扩展中,专门实现了一套基于包围盒六面投影与重叠分流的极速 UV 展开算法(Fast Box Projection-Based UV Unwrapping,见 Fig. 6):
输入:网格顶点坐标 V, 三角面片索引 F, 顶点法线 N, 物体轴对齐包围盒 B
1. 法线主轴六面分配 (_box_assign_vertex_to_cube_face):
     对每个三角形面片 f ∈ F,计算面法线 n_f 与包围盒六个主方向 (±X, ±Y, ±Z) 的点积
     直接将面片 f 分配给点积最大(最正对)的那个立方体投影面 c ∈ {0..5}
     取该面片在平面 c 上的二维正交投影坐标 (u, v),线性归一化至 [0, 1]^2
2. 自遮挡重叠检测与三级图集分流 (_assign_faces_uv_to_atlas_index, C++ 算子):
     - 第一级(主图集区):按 3×2 网格排布六个立方体主投影面,直接放入每个方向最外层无遮挡的连通面片
     - 第二级(次级重叠区):若物体有凹槽或多层结构(例如椅子前腿挡住了后腿,投影到同一个 (u,v) 发生重叠),
       将内层被遮挡的重叠连通块平移缩放到图集下方的次级区域
     - 第三级(右下角碎片网格):将零散孤立的细小残余面片紧凑排进图集右下角的备用小格子里
3. 切线空间基向量计算:根据最终 UV 与三维顶点坐标解析算出每个顶点的切线 (Tangent) 与副切线 (Bitangent)
看看 Fig. 6 右下角展开后的 UV 图集:六个主方向的大块表面整整齐齐地排在上方 网格里,被遮挡的内侧面片则井然有序地收容在下方区域。因为每个三角形投影方向的计算完全独立并行,没有任何迭代优化,整套 UV 展开在几十毫秒内就能瞬间跑完!
4.2 光栅化反查烘焙与三合一训练总损失
有了 UV 坐标后,texture_baker 模块(内含 CUDA 与 Apple Metal 原生核函数)按三步把三平面特征烘焙成二维贴图:
- UV 空间光栅化(
baker.rasterize&baker.interpolate):把网格的二维 UV 三角形光栅化到 画布上,用重心坐标插值算出画布上每个有效纹素(Texel)对应的三维世界坐标gb_pos与插值表面法线; - 三平面特征反查与切线空间法线转换:直接拿着每个纹素的三维坐标
gb_pos去 三平面里采样,解码出该点的去光照反照率颜色与世界空间法线微扰 ,再左乘该纹素处的切线标架逆矩阵 转化为标准 GLB 引擎所需的切线空间法线贴图(Tangent-Space Normal Map):
- UV 岛边缘膨胀填充(
dilate_fill):对有效掩码bake_mask外圈的空白背景像素执行形态学外扩填充,防止渲染器在做双线性插值或 Mipmap 缩小时采样到背景黑边而产生接缝裂纹。
在端到端网格训练阶段,SF3D 的总损失函数由图像渲染重建损失 、显式网格正则损失 与着色及去光照解耦损失 三部分协同驱动:
5. 实验验证:重建精度、解渲染重光照与核心消融
5.1 GSO 与 OmniObject3D 定性/定量对比
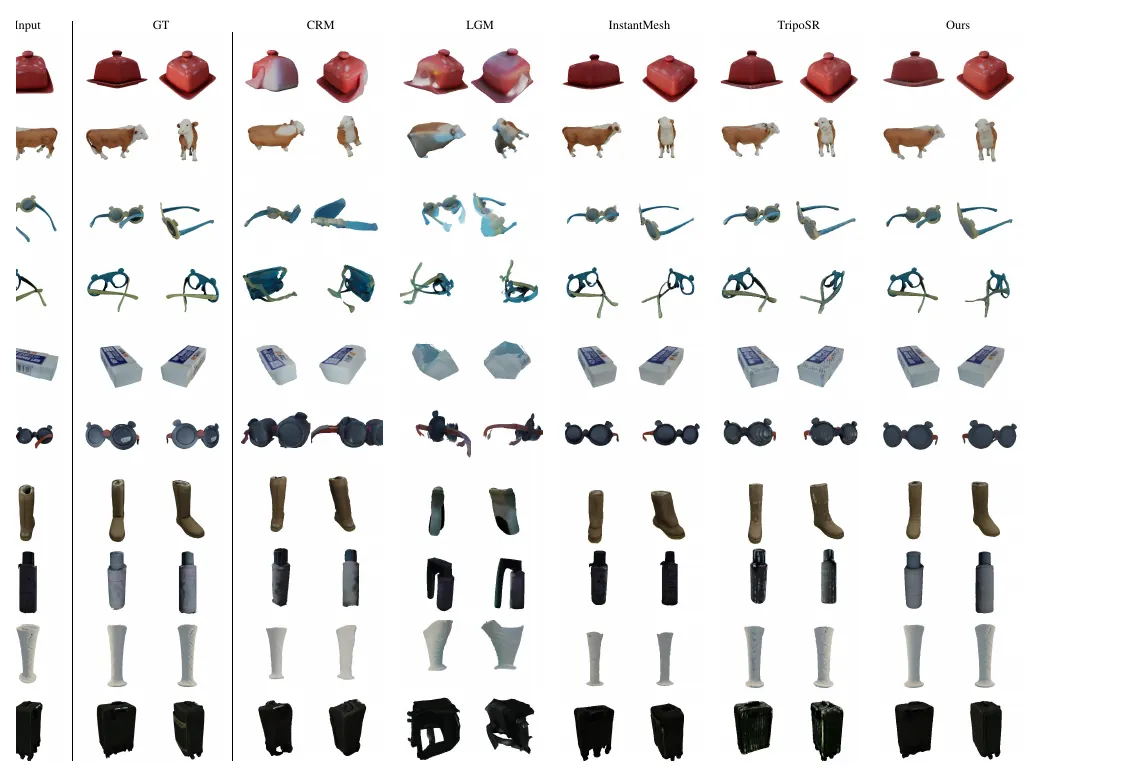
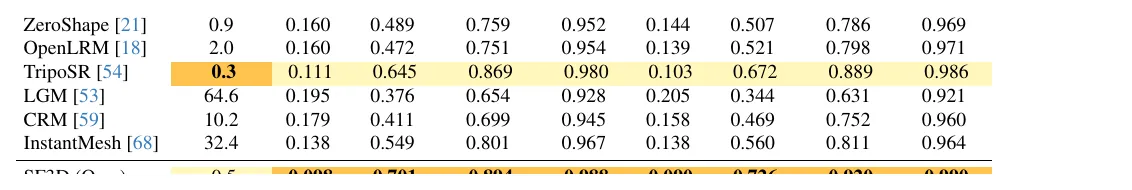
论文在 Google Scanned Objects(GSO)与 OmniObject3D 两大真实扫描物体基准上,与 ZeroShape、OpenLRM、TripoSR、LGM、CRM 和 InstantMesh 进行了系统对比(Fig. 7 与 Table 1)。评价指标采用点集双向 Chamfer 距离:
从实验结果可以清楚看到两点:
- 在亚秒级赛道上的精度统治力:对比同属 0.5 秒级前馈阵营的
TripoSR(0.3s),SF3D(0.5s,且已包含完整 UV 展开与贴图烘焙导出)在 GSO 上的 F-score 从0.735大幅跃升至0.822,Chamfer 距离从0.095压低至0.068;在 OmniObject3D 上的 F-score 同样从0.692涨至0.785。观察 Fig. 7 中的细框眼镜、长筒靴与玩具车,SF3D 彻底消除了 TripoSR 表面坑坑洼洼的阶梯伪影。 - 对比多视角扩散重建模型的速度碾压:像
InstantMesh(21.2s)和CRM(9.7s)需要先跑多步扩散生成 6 张多视角图再重建网格,耗时比 SF3D 慢了 20~40 倍,而 SF3D 单次前向直接推理出的几何精度反而全面胜出。
5.2 解渲染重光照、速度-质量帕累托图与消融分析
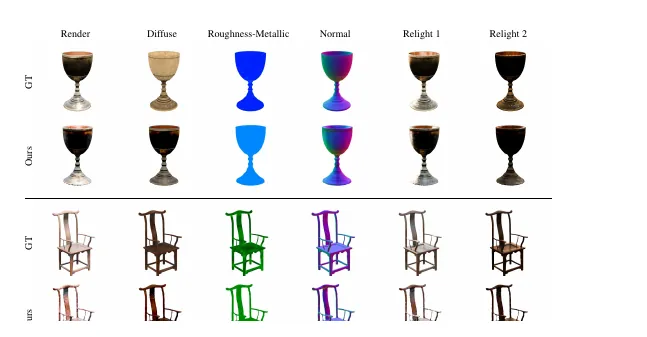
Fig. 8 展示了 SF3D 的解渲染(Derendering)与新环境重光照效果:从左往右依次为合成渲染图、剥离阴影后的漫反射反照率(Diffuse)、粗糙度-金属度可视化、切线法线贴图,以及换用三套全新环境光(Relight 1–3)后的实时渲染表现——由于反照率贴图里没有残留原图的死黑阴影,新光源从任意角度照射都能呈现出干净自然的明暗过渡。
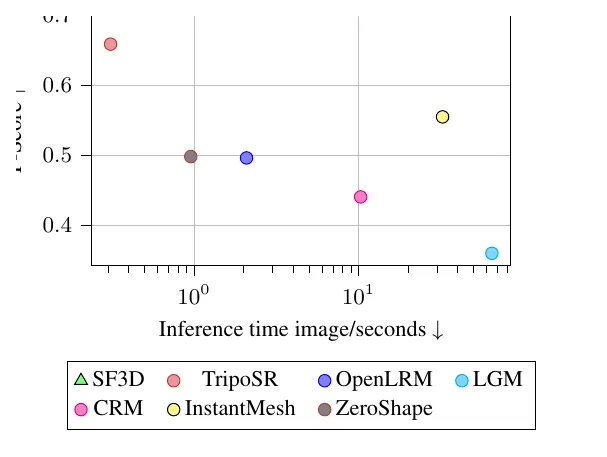
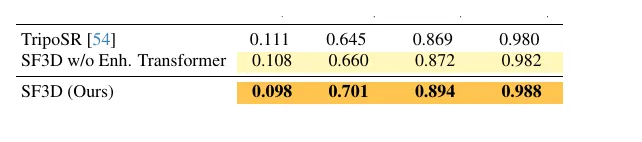
看 Fig. 9 的速度-质量帕累托分布图与 Table 2 的核心模块消融:
- 显式网格训练与去光照的价值:在 Table 2 中,哪怕先不加高分辨率增强主干(
SF3D without enhanced transformer),仅仅把 TripoSR 的后处理 Marching Cubes 换成端到端 DMTet 显式网格训练与球面高斯着色解耦,GSO 上的 F-score 就已经从0.735涨到了0.768; - 增强型双流 Transformer 的贡献:在此基础上换装双流解耦 + PixelShuffle 高分三平面主干(完整
SF3D),F-score 进一步从0.768跃升至0.822,证明高空间分辨率三平面对于雕刻高频几何与消除纹理走样不可或缺。
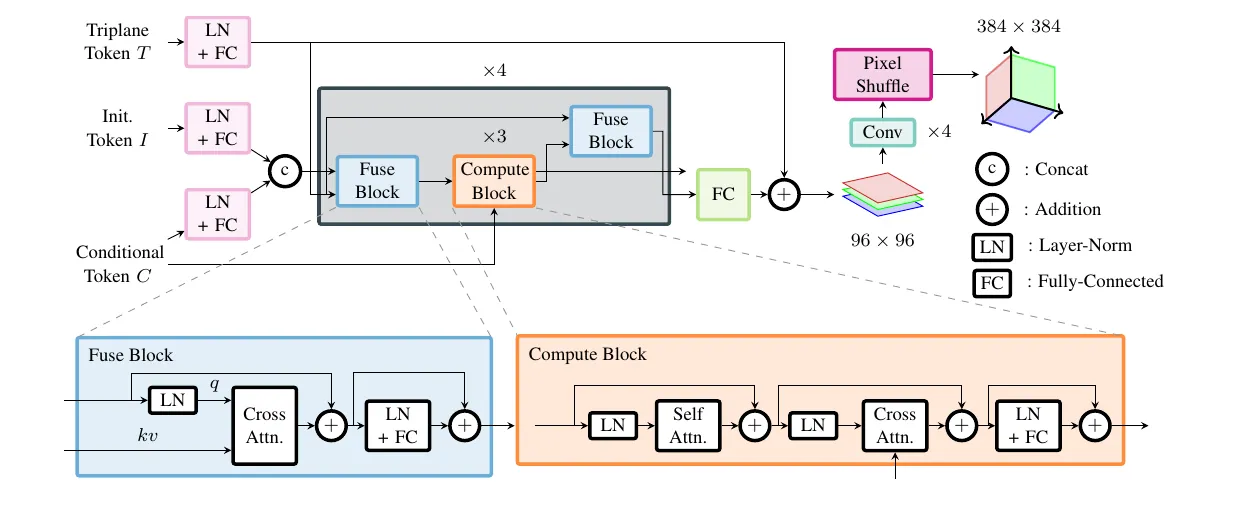
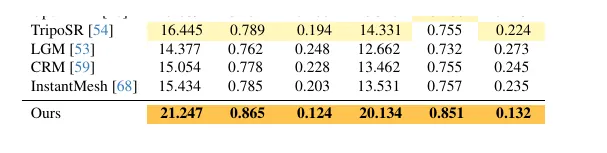
附录 Fig. A1 给出了前文剖析过的双流 Enhanced Transformer(Fuse Block + Compute Block + PixelShuffle)完整框图;而附录 Table A1 的新视角渲染图像指标(PSNR / SSIM / LPIPS)进一步印证,更准的 DMTet 几何与更干净的 UV 贴图直接转化为了全方位领先的多视角视觉保真度。
6. 源码深挖:从 torch.lerp 背景插值到 SF3D.run_image() 全链路
对照官方开源仓库 Stability-AI/stable-fast-3d,从命令行入口 run.py 到核心系统类 sf3d/system.py 的数据流设计得非常紧凑:
输入图片 ──> rembg 去背景 + resize_foreground (默认前景占比 0.85)
  ──> SF3D.prepare_image (用 torch.lerp 将透明背景替换为稳定灰底)
  ──> get_scene_codes (DINOv2 + Enhanced Transformer + PixelShuffle ──> 384×384 Triplane)
  ──> triplane_to_meshes (160^3 四面体顶点查 density & vertex_offset ──> DMTet 提取网格)
  ──> [可选] remesh (triangle / quad CPU 重网格化)
  ──> mesh.unwrap_uv (C++ 箱体六面投影 + 重叠区域三级分流)
  ──> baker.rasterize & interpolate (CUDA/Metal 光栅化 UV 图集,插值三维坐标 gb_pos)
  ──> query_triplane & decoder (在 gb_pos 处解码 albedo, world_normal, roughness, metallic)
  ──> TBN 切线空间法线转换 & dilate_fill 接缝外扩 ──> 封装 PBRMaterial 导出 GLB
细读源码可以发现三个极具启发性的工程细节:
- 为什么前景分割后一定要用
torch.lerp填充固定背景色,而不能直接喂 RGBA 里的 RGB? 在SF3D.prepare_image()中有这样两行关键代码:
许多初学者直接把去背景后的 PNG 图片取前三个通道mask_cond = img_cond[:, :, -1:] rgb_cond = torch.lerp(background_color, img_cond[:, :, :3], mask_cond)img[:, :, :3]喂给视觉编码器,结果生成的三维模型边缘长满奇怪的肉刺。为什么?因为 PNG 图片虽然把背景的 Alpha 通道设成了0(透明),但底下的 RGB 通道里其实还残留着原图杂乱的背景像素(或者是rembg切割边缘处的半透明噪点)!DINOv2 并不看 Alpha 通道,直接取:3等于把未去背景的脏像素原样喂给了网络。通过torch.lerp按软掩码mask_cond将背景平滑过渡到训练期约定的纯灰底色background_color,同时配合resize_foreground(foreground_ratio=0.85)留出 15% 的安全边距防止物体外轮廓被裁断,才能保证 DINOv2 提取出干净稳定的边界 Token。 - 导出阶段为何默认设置
estimate_illumination=False? 在generate_mesh()中,你会看到estimate_illumination参数默认是False。这是因为 Light Net(球面高斯环境光)的核心使命是在训练阶段充当“阴影海绵”,通过可微着色与解调损失逼迫三平面的diffuse分支学会输出不带阴影的干净反照率;一旦训练完成,到了在线导出 GLB 资产时,我们只需要直接从三平面解码出已经洗干净的albedo贴图和image_estimator预测的roughness / metallic因子即可,省去了在线运行 Light Net 的冗余开销。 - 跨平台自定义算子(CUDA 与 Apple Metal 双后端):
为了让这套光栅化烘焙管线不仅能在 Linux 服务器上跑,还能在开发者的 MacBook 上本地跑通,
texture_baker/csrc/目录下除了提供标准的 CUDA 核函数外,还专门用 Objective-C++ 与 Metal Shading Language(.metal)手写了一套 Apple Silicon GPU 光栅化与重心插值核函数,通过torch.ops.texture_baker_cpp统一暴露给 Python 层调用。
7. 工程局限与横向生态坐标:在 3D 视觉版图中的位置
客观审视 SF3D 的技术取舍,它的边界非常清晰:
- 单次前馈重建 vs. 多步生成式先验的上限差异:SF3D 本质上是确定性的单图前馈重建模型(而非扩散或流匹配生成模型)。当输入物体存在大面积自遮挡、复杂内部镂空或背面非对称结构时,三平面回归在不可见背面仍容易产生平滑模糊,其复杂拓扑合成上限不及百步采样的 4B 级流匹配大模型。
- 全局标量材质与箱体投影 UV 的简化代价:Material Net 预测的是整件物体共享的标量粗糙度与金属度因子(而非像素级空间变化的 Roughness/Metallic 贴图),遇到“金属刀身 + 木质刀柄”的复合材质物体时只能取折中质感;同时,几十毫秒跑完的箱体投影 UV 虽然满足了机器自动烘焙需求,但切碎的次级重叠 UV 岛并不适合人类美术师在 Photoshop/Substance Painter 里直接手绘修改。
- 商业授权边界:需留意虽然代码仓库开源,但 Hugging Face 上的模型权重采用 Stability AI Community License(年营收超 100 万美元的商业机构需另行申请企业商用许可)。
如果把 SF3D 放进本站精读过的三维资产生成与场景建模全局版图中,它的坐标一目了然:
- 对比工业级低延迟可部署系统 AssetGen:SF3D 是“单图资产化”方向的先行者,率先在
0.5 秒前馈框架内把 UV 展开、切线法线、材质估计和去光照跑通;而 AssetGen 则将这一理念升级为14~30 秒的重型双阶段扩散生成系统,用 2.3B VecSet 扩散 + 10 视角 TextureGen + CuMesh QEM 减面解决了单次前向模型在背面细节与严苛面数预算上的短板。 - 对比 4B 级潜空间流匹配大模型(TRELLIS.2、TripoSG):TRELLIS.2 与 TripoSG 选择用更重的三维原生潜空间(O-Voxel / 连续 SDF)与数十步 Rectified Flow 采样去冲击几何与逐体素 PBR 的最高质量天花板;而 SF3D 则坚守亚秒级单次前向推理阵地,在仅需约 6GB 显存的轻量开销下提供立等可取的 GLB 原型。
- 对比零样本 CAD 检索配准系统(SUFLECA、Diorama):当场景中的物体属于标准家具且有现成 CAD 库时,用 SUFLECA(
0.53s)做特征匹配与 9D 位姿对齐能获得最干净的工业网格;而当画面中出现非标个性化摆件、玩具或雕像且资产库检索失败时,同样只需0.5s的 SF3D 就是最理想的实时兜底资产生成器。
总而言之,SF3D 给三维视觉社区带来的核心启示是:单图 3D 重建的终点绝非几张漂亮的新视角渲染图,而是能直接拖进图形引擎的标准资产接口。它用双流 PixelShuffle 三平面、DMTet 顶点微调、球面高斯去光照、Beta 众数材质估计与极速箱体 UV 烘焙这五记组合拳,在半秒之内打通了从神经隐式场到显式 PBR 网格的最后一公里。
参考资料
- Mark Boss, Zixuan Huang, Aaryaman Vasishta, Varun Jampani, SF3D: Stable Fast 3D Mesh Reconstruction with UV-unwrapping and Illumination Disentanglement, arXiv:2408.00653v1(PDF、HTML).
- 官方项目主页、代码与权重:SF3D Project Page、Stability-AI/stable-fast-3d、Hugging Face Model (stabilityai/stable-fast-3d)
- 前置与基础工作:TripoSR (arXiv:2403.02151)、LRM (ICLR 2024)、DMTet (NeurIPS 2021)、DINOv2 (TMLR 2024)
comments