假设你手里已经有一个用多视角照片训练好的神经辐射场(NeRF)场景——比如庭院木桌上的花瓶、森林石板上的松果,或者一台精细的乐高推土机。现在你只想做一次局部的“三维微创手术”:在空桌面上凭空插一朵花、把石板上的松果替换成菠萝、让彩色藤蔓缠绕着推土机车轮生长,或者把陶瓷花瓶改造成透明玻璃材质,同时要求目标区域之外的每一片树叶、每一块石板纹理都原封不动。
这件事在二维修图软件里只需要画个选区跑一次局部重绘(Inpainting),但放到三维 NeRF 场景里,却成了困扰早期隐式场编辑的棘手难题。
为什么在现有 NeRF 里做局部语义编辑这么难?因为标准 NeRF 把整个三维世界的几何密度与辐射颜色全部耦合进了同一个多层感知机(MLP)的权重里。第一,网络内部根本没有 object_id=pinecone 这样的显式实例边界,牵一发而动全身,直接用文本损失微调网络权重会让背景跟着一起扭曲退化;第二,零样本视觉语言模型(如 CLIP 或 BLIP)提供的图文余弦相似度监督粒度极粗,如果直接拿去优化三维空间,网络会疯狂钻空子——要么利用周围背景的颜色骗取高分,要么在半空中刷出一层只有正对着看才像目标物体的二维扁平贴纸(Billboard Effect);第三,如果强行用三维包围盒把新旧两个场硬拼在一起,包围盒的六个切面上就会暴露出刀割般的几何断层与色彩接缝。
面对这一连串工程痛点,耶路撒冷希伯来大学团队提出的 Blended-NeRF: Zero-Shot Object Generation and Blending in Existing Neural Radiance Fields(项目主页 / 官方代码)给出了一套干净利落的解法。如果剥开具体的实现细节看骨架,Blended-NeRF 的成功建立在四条核心设计哲学之上:
- 克隆原场景作生成起点,用双分支隔离守护背景保真度(Clone-and-Freeze Dual-Branch Architecture):系统并行维护两个结构完全一致的辐射场——一份彻底冻结的原始分支 用来锁死非编辑区,另一份生成分支 直接从 的收敛权重克隆初始化。继承原场景权重相当于把相机坐标系、空间尺度与局部光照基调直接赋予了生成分支,使其无需从随机噪声摸索整个世界;而在训练期,系统仅对穿过 3D ROI 包围盒的光线片段做积分(ROI-only Rendering),从物理上斩断了语义梯度篡改背景的可能。
- 用三维距离衰减算子替代二维羽化,在光线采样点层消除盒边界接缝(Sample-Level Distance Smoothing over 2D Feathering):摒弃在渲染后的 2D 图像上做图层叠加的思路,将新旧场的混合下沉到三维光线采样点(Ray Sample)层级。通过定义从 ROI 中心向四周指数衰减的距离平滑函数 ,让盒内核心区由生成分支主导、越靠近盒边缘越平滑过渡回原始分支,从而保证从任意 360 度环绕视角观察都不会露出硬切面。
- 把“增量包裹”与“擦除替换”浓缩为激活函数内外的代数位置选择(Pre-Activation vs. Post-Activation Density Algebra):体密度必须经过非负激活函数 才能变成合法的物理不透明度。作者巧妙利用了这一非线性边界:若在激活函数外部将双分支密度相加(),两项均非负,生成分支只能往原空间里加东西,天然对应“藤蔓包裹车轮”的增量共生;若在激活函数内部将预激活 logit 相加(),生成分支就能输出负值 把原物体的正密度抵消归零,天然实现“擦除旧松果、长出新菠萝”的原位替换!
- 用透射率下限与视差方差对抗 CLIP 的“二维贴纸”作弊(Geometric Priors against 2D Adversarial Cheating):为了堵死 CLIP 靠半透明雾气或扁平纸片骗分的漏洞,系统在 ROI 局部渲染之上配套了自适应包围盒尺寸的环绕相机采样、随机背景填充、强迫盒内长出不透明实体的透射率损失(Transmittance Loss),以及强迫局部视差图产生三维起伏的深度方差损失(Depth Variance Loss),逼着二维语义信号凝结成扎实的三维体积。
下面我们就顺着这四条设计哲学,结合论文数学推演与开源 PyTorch 源码,把整套局部编辑与体融合机制拆解清楚。
1. 为什么在现有 NeRF 里做局部“微创手术”这么难?
1.1 全场景耦合场的四大编辑困局
在标准 NeRF 中,一个三维场景被参数化为将空间三维坐标 与观察方向 映射为体密度 和 RGB 颜色 的连续函数:
当相机沿某条视线 发射光线并采集 个离散样本点时,像素最终呈现的颜色由各采样点的颜色按不透明度与累计透射率 加权累加而成:
这套表示在合成新视角时无往不利,但一旦要在已经训好的 上做局部语义修改,立刻会撞上四堵墙:
- 缺乏对象级参数隔离:松果、石板、青苔、阴影和远处背景全部共享同一套 MLP 矩阵权重,修改任意一层权重都会让全场景像素一起跟着变;
- 单视角修改与多视角几何强耦合:三维空间里一个采样点 的密度变化,会同时改变所有穿过该点的相机光线的透射率 ,只盯着单张渲染图优化很容易导致换个角度就穿帮;
- 零样本文本监督的空间失焦:CLIP 只管整张图跟文字像不像,根本不知道你只想改桌子正中央的那一小块空间;
- 严苛的背景非破坏性要求:与从零生成单物体的 Text-to-3D 不同,场景修图要求 ROI 之外的一草一木必须维持原有的重建精度。
1.2 双分支协同训练与体渲染融合全景
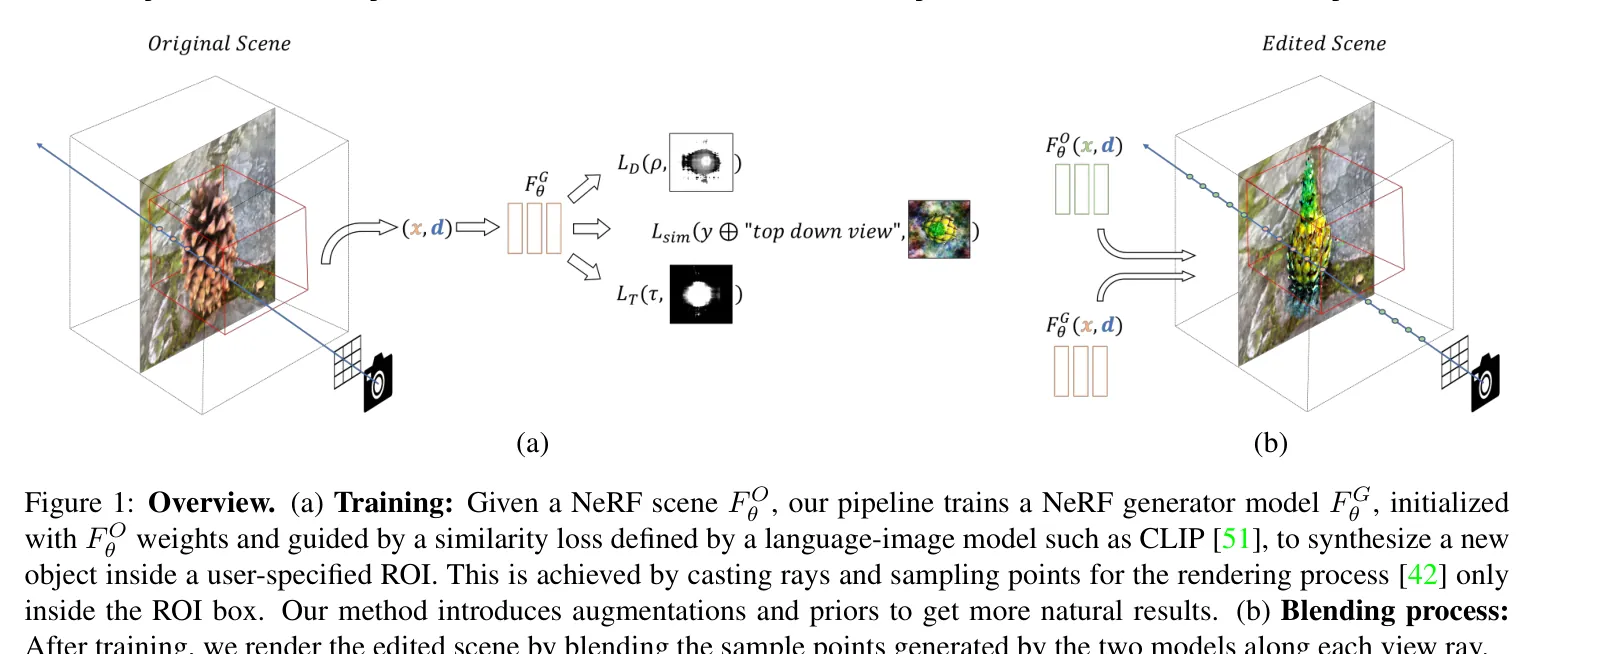
看 Fig. 1 的架构总览,Blended-NeRF 将整个工作流拆成了左右对称的局部靶向训练(Training Phase)与全局体渲染融合(Blending Phase)两个阶段:
在左侧的训练阶段,系统同时持有两个辐射场:一个是完全锁死权重的原始辐射场 (Original NeRF),另一个是由 克隆而来、专门负责在用户指定的绿色三维包围盒(3D ROI Box)内长出新物体的生成辐射场 (Generator NeRF)。训练相机围绕 ROI 采样光线时,只有落入绿色包围盒内部的采样点才会被送进 积分出局部图像(并叠加在随机生成的彩色背景上送给 CLIP 算相似度损失);包围盒外部的采样点全部置零。
到了右侧的推理融合阶段,系统切换回正常全局相机视角发射完整光线,对光线上每一个采样点分情况处理:落在绿色包围盒外面的点,100% 查询冻结的原始场 ;落在绿色包围盒里面的点,同时查询 与训练好的 ,经过距离平滑与双模式密度合成后,统一沿光线积分出最终图像。
1.3 从大范围地貌替换看 3D ROI 的边界效应
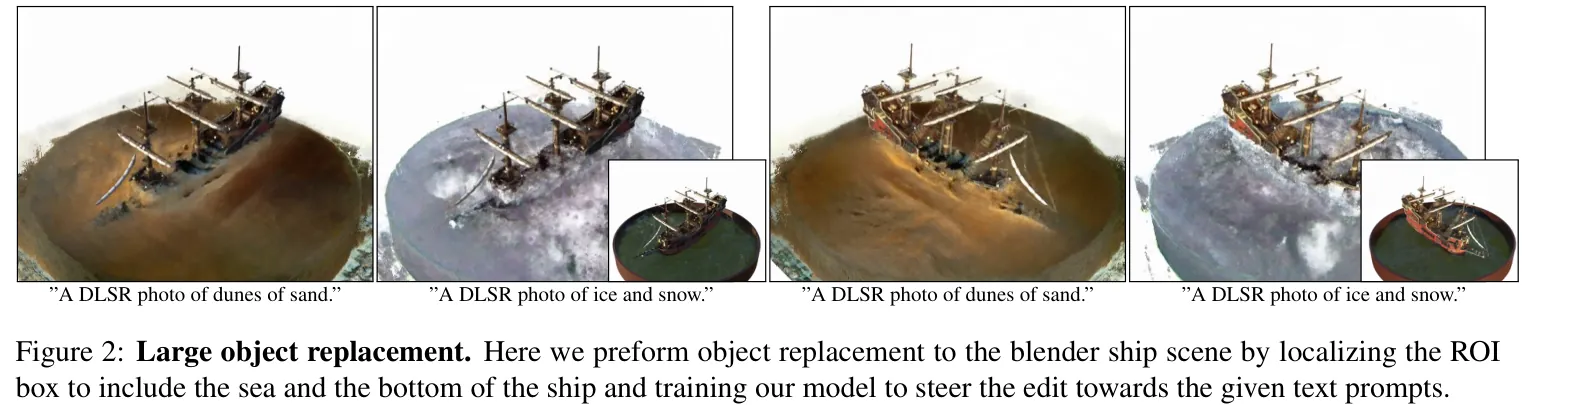
Fig. 2 用 Blender 合成船只场景(Ship Scene)直观展示了这套机制的威力:用户在船底与周围海面区域框定了一个大号 3D ROI 包围盒,分别用文本提示驱动模型把原本的黄沙与海水替换成了冰封雪地、草地或岩石地貌,而船体桅杆与缆绳结构依然完好保留。
这个案例也直观揭示了 3D ROI 包围盒作为交互接口的边界特性(在官方代码中体现为通过 box_points_path 传入的 .pt 顶点文件,例如 box_points/lego_exhaust_box.pt):包围盒划定了生成分支允许动刀的最大物理边界。如果盒子框得太小,新生成的冰面或物体就会在盒壁处被截断;如果盒子框得太大,生成分支就会被允许改动过多原本不该动的船身结构。
2. 核心设计哲学一:原场景克隆初始化与局部 ROI 隔离渲染
2.1 为什么生成分支必须从原场景权重克隆起步?
在底层网络输入上,Blended-NeRF 沿用了标准 NeRF 的高频位置编码(Positional Encoding),将低维坐标 映射为包含 个频段的周期函数特征向量:
在官方源码 BlendedNeRF/run_BlendedNeRF.py 的 create_nerf(args) 函数中,系统实例化了两套完全相同的 coarse-to-fine NeRF 网络:fixed_model(及 fixed_model_fine)对应原始分支 ,model(及 model_fine)对应生成分支 ,并在启动训练前统一加载预先训练好的原场景权重(存放在 base_weights/ 下)。
为什么要大费周章从原场景权重克隆初始化 ,而不干脆新建一个随机初始化的小 NeRF?
想一想两者的处境差异就明白了:如果从随机权重起步,CLIP 损失在训练前几百步面对的是一团混沌的随机噪声,它既不知道当前场景的世界坐标原点在哪、也不知道相机离目标有多远、更没有周围环境的光照色彩基调,优化过程极易发散或陷入奇怪的局部极小值。而在原场景权重之上起步,生成分支从第 0 步开始就已经拥有了正确的三维空间尺度、已有物体的几何骨架(在替换或材质编辑任务中尤为关键)以及与周围环境浑然一体的色彩分布,后续梯度更新只需要专注学习“如何把盒子里现有的东西改造成提示词要求的样子”。论文概念与源码实现的对应关系一目了然:
| 论文核心概念 | 官方源码符号(run_BlendedNeRF.py) | 工程职责与数据流 |
|---|---|---|
| 原始辐射场 | fixed_model, fixed_model_fine | 全程冻结梯度,提供盒外背景与盒内混合基准的原始 density/color |
| 生成辐射场 | model, model_fine | 从原场景 base_weights 克隆初始化,在 ROI 内接受语义与几何损失更新 |
| 3D ROI 包围盒 | box_points_path, render_kwargs_train['box_points'] | 定义三维空间中的轴对齐长方体编辑范围 |
| ROI 局部隔离渲染 | render_in_box_fn | 训练期仅积分盒内采样点,输出局部 RGB、透射率与视差图 |
| 体渲染级融合 | raw2outputsBlend, render_full_frame_fn | 推理期在采样点 raw 输出层混合双分支密度与颜色,渲染完整画面 |
2.2 仅渲染盒内样本:切断背景干扰与守护非编辑区
有了双分支网络,训练阶段怎么确保 CLIP 只盯着盒子里看?论文将训练期的局部隔离渲染(ROI-only Rendering)定义为分段积分:
也就是说,对于任意一条训练光线 ,只有当它的采样点 落在三维包围盒 内部时才计算体渲染积分;盒外的所有采样点一律当作真空(置零)。
这步看似简单的掩码操作,在工程上同时解决了两大难题:
- 杜绝 CLIP 靠背景“吃白食”:假设你想在花坛空地上生成一颗草莓(
"a strawberry"),如果训练时把整张带花盆、绿叶和泥土的大图一起渲染出来喂给 CLIP,CLIP 看到满屏的植物绿叶,不用在盒子里长出草莓就已经给出了不低的图文相似度,导致局部生成动力严重不足。只渲染盒内区域并贴在随机噪声背景上,模型就退无可退,必须在盒子里实打实地长出草莓才能拿到高分。 - 零成本锁死非编辑区:因为盒外采样点在训练期根本不进计算图,生成分支也罢、原始分支也罢,盒外空间在推理时 100% 由冻结的
fixed_model接管,从根源上保证了非编辑区背景的绝对保真。
在 render_rays() 源码中,判断采样点 pts 是否落入包围盒由一段极其高效的张量边界比较完成:
pt_is_in_box = (
    (xmin <= pts[..., 0]) & (pts[..., 0] <= xmax) &
    (ymin <= pts[..., 1]) & (pts[..., 1] <= ymax) &
    (zmin <= pts[..., 2]) & (pts[..., 2] <= zmax)
)
为了帮用户在已有 NeRF 场景中定位这个 3D 包围盒,官方仓库配套提供了三个交互式 Notebook(find_3d_box_blender.ipynb、find_3d_box_llff.ipynb、find_3d_box_llff_360.ipynb),支持从多角度环绕审视原场景并将选定的长方体顶点导出为 .pt 文件。
3. 核心设计哲学二:距离平滑算子与激活函数内外的密度代数
3.1 距离平滑算子:消除三维包围盒的六个硬切面
当生成分支 在盒内训练完毕,准备把它放回原场景渲染完整画面时,最直接的挑战就是边界过渡。如果采取非黑即白的硬切换——盒内采样点全听 的,盒外采样点全听 的——那么生成分支在盒子边缘稍微有一点残余密度或色调偏差,就会在三维空间里切出六个肉眼可见的长方体硬切面。
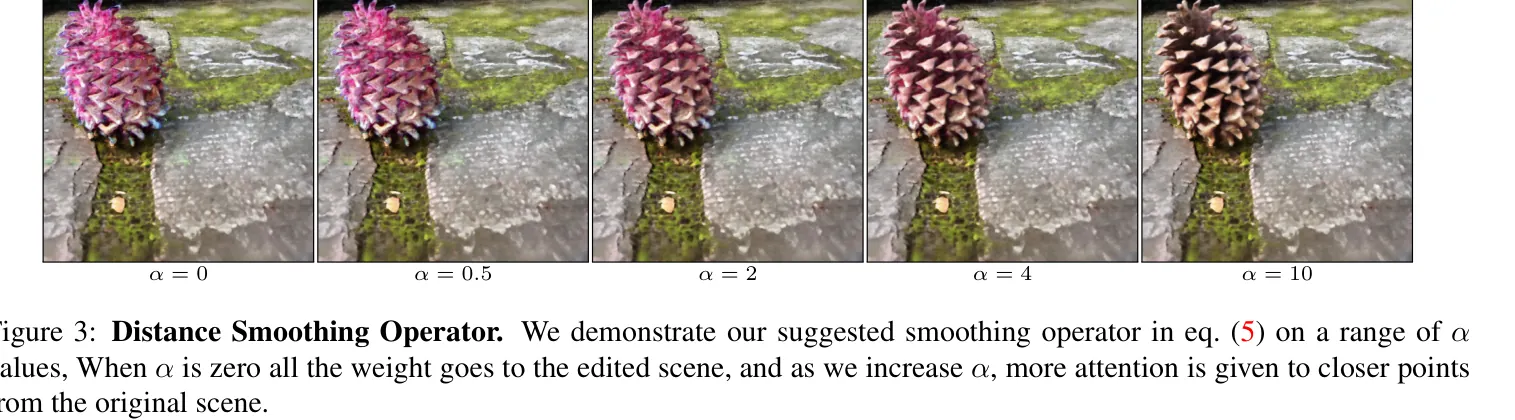
为了消除这圈接缝,作者在 Fig. 3 中引入了距离平滑算子(Distance Smoothing Operator)。设空间采样点 到 ROI 包围盒几何中心的欧氏距离为 ,包围盒的主对角线长度为 ,定义一个随中心距离单调递增的权重函数 :
其中超参数 控制过渡带的陡峭程度。接着,用 在每个盒内采样点上对原始场输出 与生成场输出 做凸组合:
看这个公式的物理直觉:在最核心的 ROI 中心处,,采样点完全采用生成场 的新内容;随着采样点向包围盒四周边界移动, 变大, 平滑趋近于 ,话语权逐渐交还给原始场 。对照 Fig. 3 从左到右变化 的视觉效果: 较小时新生成的金色松果占主导, 增大时原始松果的几何与周围石板色调平滑渗入,边界生硬感随之消失。
3.2 激活函数前相加 vs 激活函数后相加:一行公式统一插入、替换与缠绕
在三维场景编辑中,用户的需求通常分为截然不同的三类:新对象插入(Insertion,在空白处加物体)、原位对象替换(Replacement,把松果换成菠萝)以及几何共生混合(Blending,让花草缠绕着推土机车轮生长)。
怎么在同一套双分支体渲染框架下,同时支持“只加不减的共生缠绕”和“先擦除旧物体再换新物体的替换”?
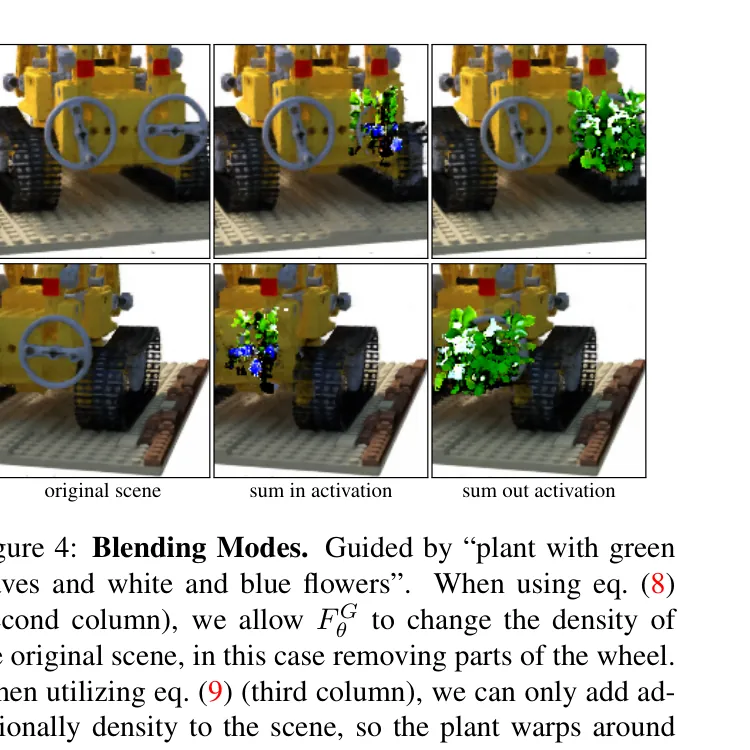
这正是论文最精妙的数学巧思所在(对应 Fig. 4 与源码 raw2outputsBlend())。
在 NeRF 的体渲染管线中,MLP 最后一层直接吐出来的原始密度预测值 是可正可负的实数(即 pre-activation logit),必须先经过一个非负激活函数 (如 ReLU 或 Softplus),才能转化为物理上非负的体密度并算出不透明度权重 与 :
在融合采样点颜色时,两分支的颜色按照各自的不透明度贡献做加权平均(外层套 Sigmoid 函数 与防除零小量 ):
而到了融合体密度 时,作者给出了两种仅差在激活函数 括号位置的代数形式:
- 模式 A:激活函数内部相加(Sum Inside Activation,对应源码
sum_in_act=True):
- 模式 B:激活函数外部相加(Sum Outside Activation,对应源码
sum_in_act=False):
别小看把加号放进 里面和放在外面的区别,它直接决定了生成分支有没有“橡皮擦”的权力!
- 当采用激活函数外相加时,因为 且 ,两个非负数相加永远不可能比原来的 更小。这意味着生成分支只能往空间里增加新物质,绝对擦不掉原场景里的任何既有几何!看 Fig. 4 左下角,乐高推土机的黑色橡胶车轮完好无损,生成的蓝白花朵只能顺着车轮外表面包裹生长。
- 当采用激活函数内相加时,相加发生在截断激活之前。如果原场景某处是实心车轮(),生成分支完全可以在该处输出一个大幅负值(),两者相加得 ,再过 ReLU 激活 ——原有的实心车轮瞬间被擦除成了透明空气! 看 Fig. 4 右下角,生成分支直接啃掉并改写了部分车轮几何,让花丛与车轮发生了深度的结构侵蚀与替换。
这提醒我们在设计上层智能交互系统时,如果要让视觉语言模型(VLM)、多模态大模型或交互式 UI 自动根据用户指令配置渲染管线,核心就是把用户的动词意图("add"、"wrap around" vs. "replace"、"turn into")准确映射到 sum_in_act 这个布尔开关上。
4. 核心设计哲学三:用透射率与视差方差驯服 CLIP 的“贴纸作弊”
4.1 视觉语言余弦损失与六重防退化机制
在局部训练阶段,引导生成分支变形变色的驱动力来自预训练视觉语言模型(默认加载 CLIP ViT-B/32 或 BLIP)。给定 ROI 局部渲染图 与目标文本提示 ,基础语义相似度损失就是最大化图文嵌入向量的余弦内积:
然而,如果只拿 去更新 NeRF,不出几百步就会看到群魔乱舞:网络要么在盒子里刷出一团半透明的彩色烟雾,要么只在正对相机的平面上画一张薄如蝉翼的“二维贴纸”——从正面看 CLIP 分数高得离谱,相机稍微偏转 就变成了一条细线。
为了把二维图文梯度约束成真正的三维实体,Blended-NeRF 在继承 Dream Fields 与 CLIP-NeRF 经验的基础上,组合了六道防退化护栏:
| 防退化机制 | 具体做法 | 解决的作弊漏洞与工程边界 |
|---|---|---|
| 1. 包围盒自适应距离采样 | 根据包围盒最大边长动态计算相机半径并环绕采样 | 保证训练物体在画面中占比适中,打破单视角过拟合 |
| 2. 随机背景合成增强 | 用局部透射率掩码在 ROI 后方叠加随机颜色/纹理棋盘背景 | 杜绝模型利用固定背景色拼凑目标图案骗取 CLIP 高分 |
| 3. 视角方位词注入 | 按相机相对方位在提示词后追加 "front/side/top view" | 辅助二维编码器理解不同相机仰角与方位角下的合理构图 |
| 4. 透射率上限损失() | 惩罚过高的平均光线透射率,逼迫盒内长出不透明实体 | 防止生成缥缈的半透明幽灵雾气;但阈值过严会把整个盒子填满实心块 |
| 5. 深度方差损失() | 鼓励局部视差图(Disparity Map)具备足够大的空间方差 | 专门击碎“二维扁平贴纸”,逼迫物体表面产生前凸后翘的立体纵深 |
| 6. 正则项退火调度(Annealing) | 随训练步数动态调节几何正则权重 | 防止训练初期过强的几何惩罚压垮尚未成形的语义探索 |
来看看其中最核心的三个数学公式。首先是自适应相机采样距离 :设 3D ROI 包围盒的最大边长为 ,相机视场角(AFOV)的一半为 ,为了让包围盒刚好饱满地塞进相机视野而又不被切边,训练相机围绕 ROI 中心采样的基准半径设为:
其次是透射率损失(Transmittance Loss,):设在当前相机位姿 下,穿过包围盒的所有像素的平均累计透射率为 (注意:透射率等于 代表盒子全空全透明,透射率越小代表生成的实体越密实)。为了强迫盒子里至少长出一定比例的实心物体,损失函数写成截断形式:
论文默认将阈值设为 ,一旦平均透射率高于该门限(说明盒子里太稀薄),损失就会施加强烈梯度逼迫生成分支提高体密度。
第三项是专门治“扁平纸片”的深度方差损失(Depth Variance Loss,):如果生成的是真正有厚度的三维物体(比如一颗球或一个甜甜圈),那么物体中心离镜头近、边缘离镜头远,渲染出的局部视差图 在空间像素上的方差 一定很大;反之如果是一张平面贴纸,视差图方差就趋近于零。因此通过最大化截断视差方差即可强迫物体立起来:
汇总这三项,源码 optimization/losses.py 中的 ObjectnessLoss 最终优化的总目标为:
4.2 与体分解基线的正面交锋及深度先验消融
在对象替换主实验中,论文将 Blended-NeRF 与侧重无监督前背景分离的 Volumetric Disentanglement(Benaim et al., ECCV 2022)在 LLFF Fern(蕨类植物)场景中进行了对比(Fig. 5 与 Table 1),任务是将画面中央的棕褐色树干分别替换成“白杨树”(Aspen Tree)和“草莓”(Strawberry)。
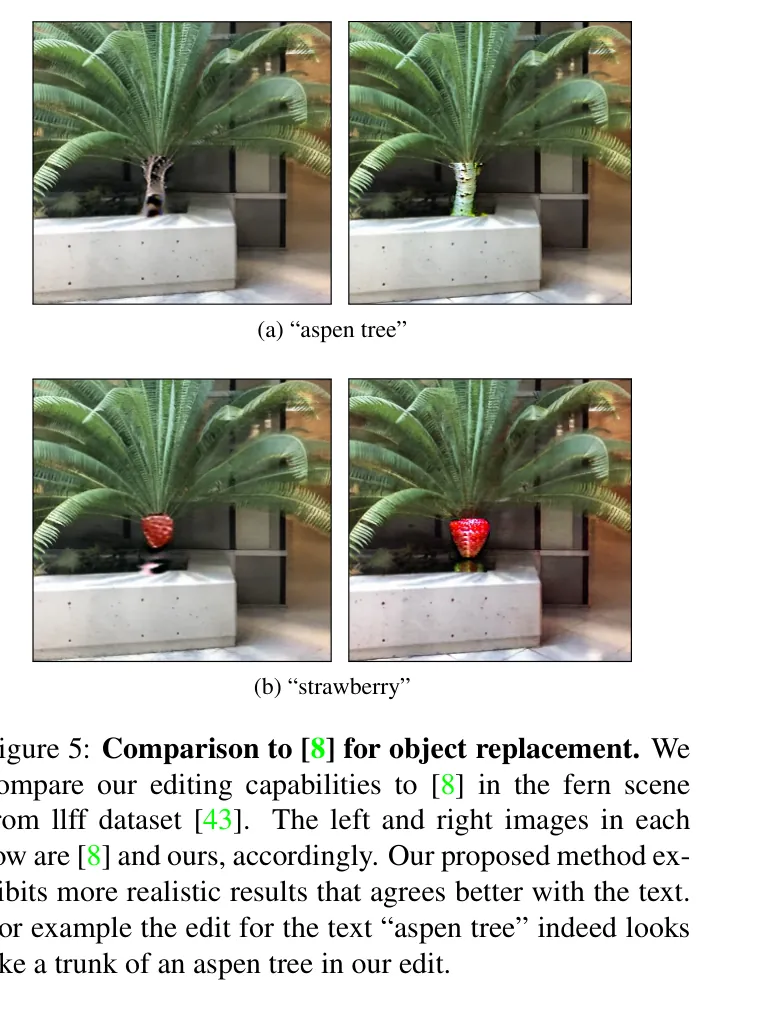
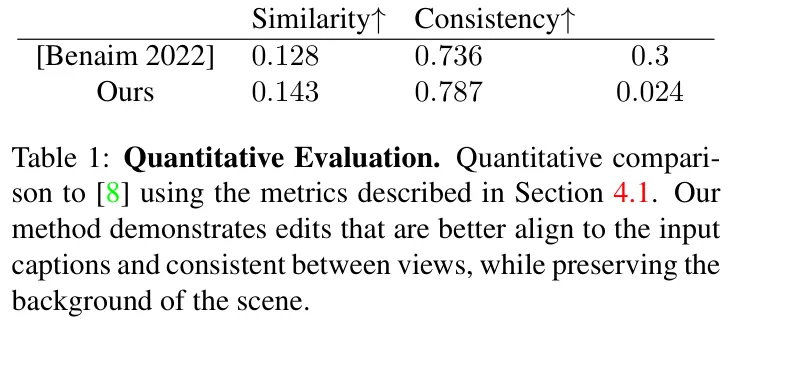
对照 Fig. 5 的视觉效果与 Table 1 的三项指标,胜负手非常清晰:
- Volumetric Disentanglement 缺乏局部三维空间锁与细粒度生成分支,在试图把树干改成草莓时,不仅原来的树干残影没擦干净,连后方的绿色蕨类叶片和砖墙背景都被严重涂抹污染(导致衡量背景失真度的 LPIPS 高达
0.50); - Blended-NeRF 则依靠 ROI 局部训练与激活内密度擦除,干净利落地在原树干位置立起了带黑斑的白杨树干和纹理清晰的红草莓,将背景失真度 LPIPS 猛压到
0.15,同时在衡量图文编辑方向一致性的 CLIP Direction Similarity(0.24vs.0.14)与跨视角稳定性 CLIP Direction Consistency(0.89vs.0.81)上全面胜出。
紧接着,Fig. 6 与 Table 2 检验了前面讲到的深度方差损失 与方向提示词到底有多大作用:
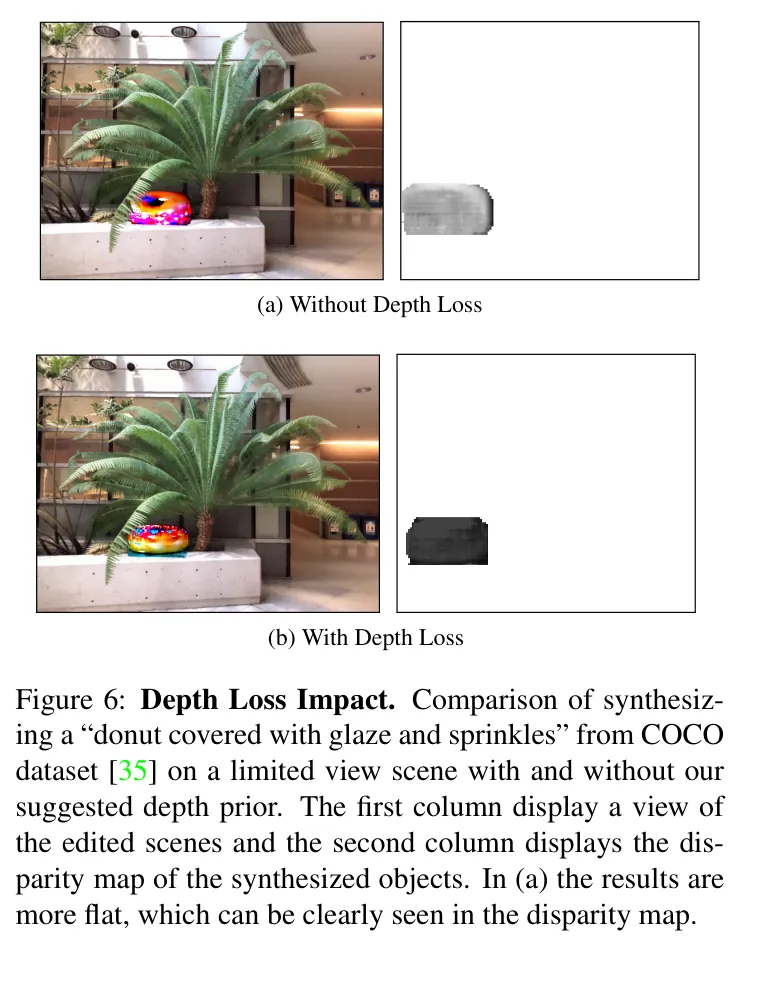
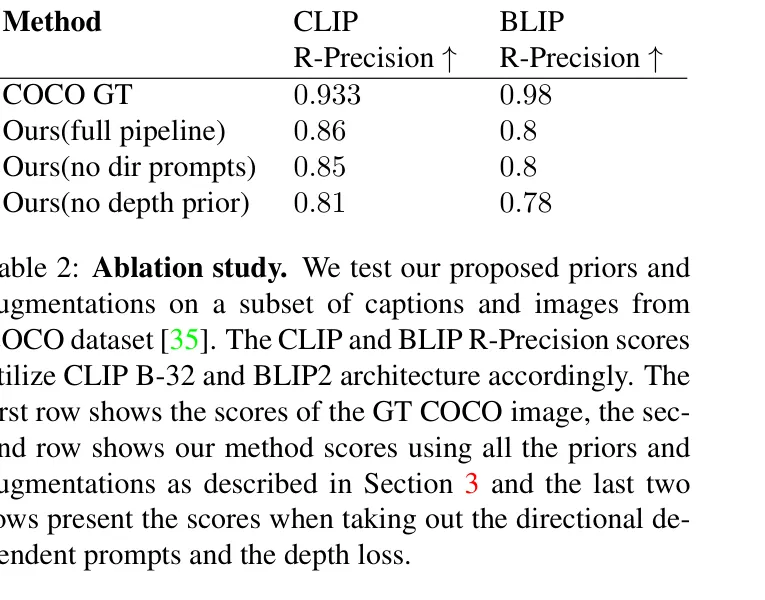
看 Fig. 6 生成甜甜圈(Donut)的彩色图与下方对应的视差深度图(Disparity Map):如果不加深度方差损失 (图左),虽然彩色图勉强画出了甜甜圈的圆环颜色去讨好 CLIP,但底下的视差图一片死灰平坦,说明它在三维空间里只是一层毫无厚度的薄片;一旦加上 (图右),视差图立刻呈现出饱满的环状立体浮雕感。Table 2 的定量检索准确率(CLIP/BLIP R-Precision,以真实照片数据集 COCO GT 作为理想参考)也证实:去掉深度先验(W/O depth prior)会让检索准确率从完整管线的 51.2% / 44.1% 大幅跌落至 43.5% / 37.8%,证明扎实的三维体积感本身就是维持多视角语义不崩塌的基石。
5. 多模态编辑矩阵:从冻结密度的材质转换到真实 360 场景操纵
5.1 锁死几何密度的零样本材质重绘与激活内融合扩展
如果用户觉得场景里现有的松果或花瓶形状挺好,不想改变它的几何轮廓,只想把它的材质换成“熊熊燃烧的炭火”、“冰封状态”、“粉色毛线”或者“透明玻璃/岩石/水彩”,该怎么改?
如果在这种任务里依然放开体密度 的更新,CLIP 的梯度多半会把原本光滑的花瓶表面啃得坑坑洼洼。Blended-NeRF 对此给出了一个极其聪明的简化模式:在生成分支 中彻底冻结所有负责预测体密度 的网络层,只放开末端预测 RGB 颜色 的网络层进行微调!
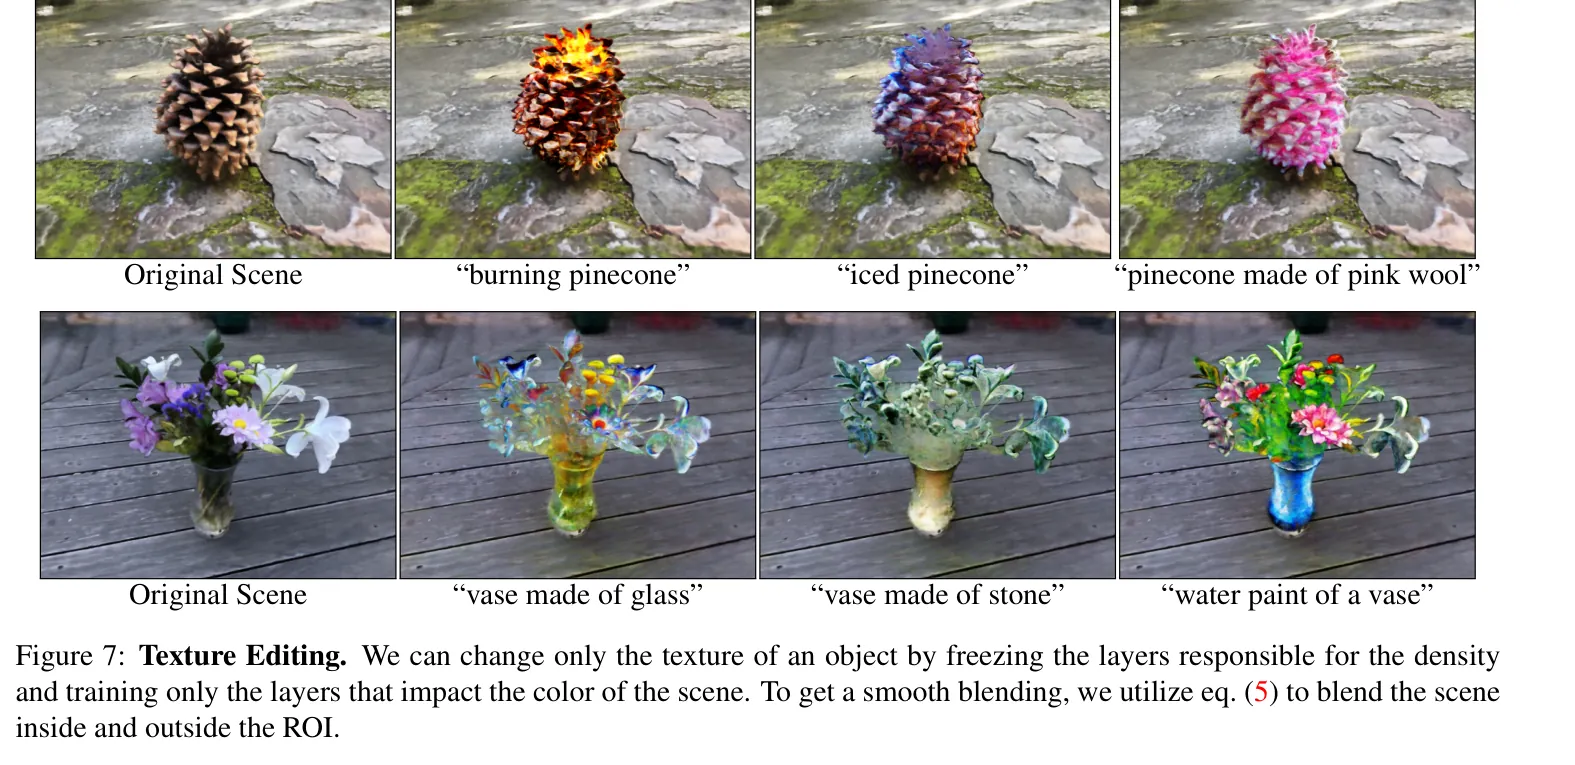
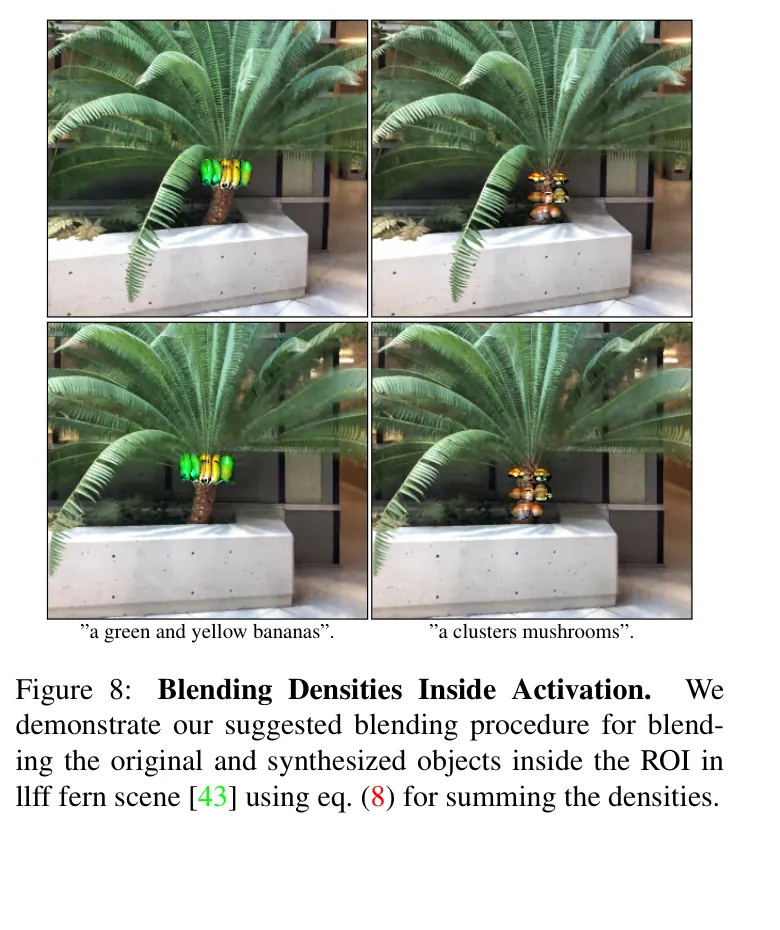
看 Fig. 7 的材质编辑效果:因为原始 NeRF 已经通过多视角照片把松果鳞片和花瓶曲面的三维密度分布死死锁住了,冻结密度层之后,生成分支绝无可能产生漂浮噪点或几何坍塌,CLIP 梯度只能老老实实地在原有三维表面上重新刷漆配色,因此多视角一致性稳如泰山。而紧随其后的 Fig. 8 则展示了当需要改变几何时,在 LLFF Fern 场景中开启激活函数内相加(sum_in_act=True)将五彩花朵与蘑菇深度嵌入蕨类植物丛中的融合表现。
5.2 多视角对象替换与空白区域零样本插入
为了证明这些编辑绝不是“只在一个镜头角度能看”的障眼法,论文在 Fig. 9 中给出了 Fern 场景对象替换的更多大跨度相机视角对比,并在 Fig. 10 中展示了在原本空旷的三维区域无中生有插入新物体(Object Insertion,每列展示同一编辑场景的两个不同视角)的效果:
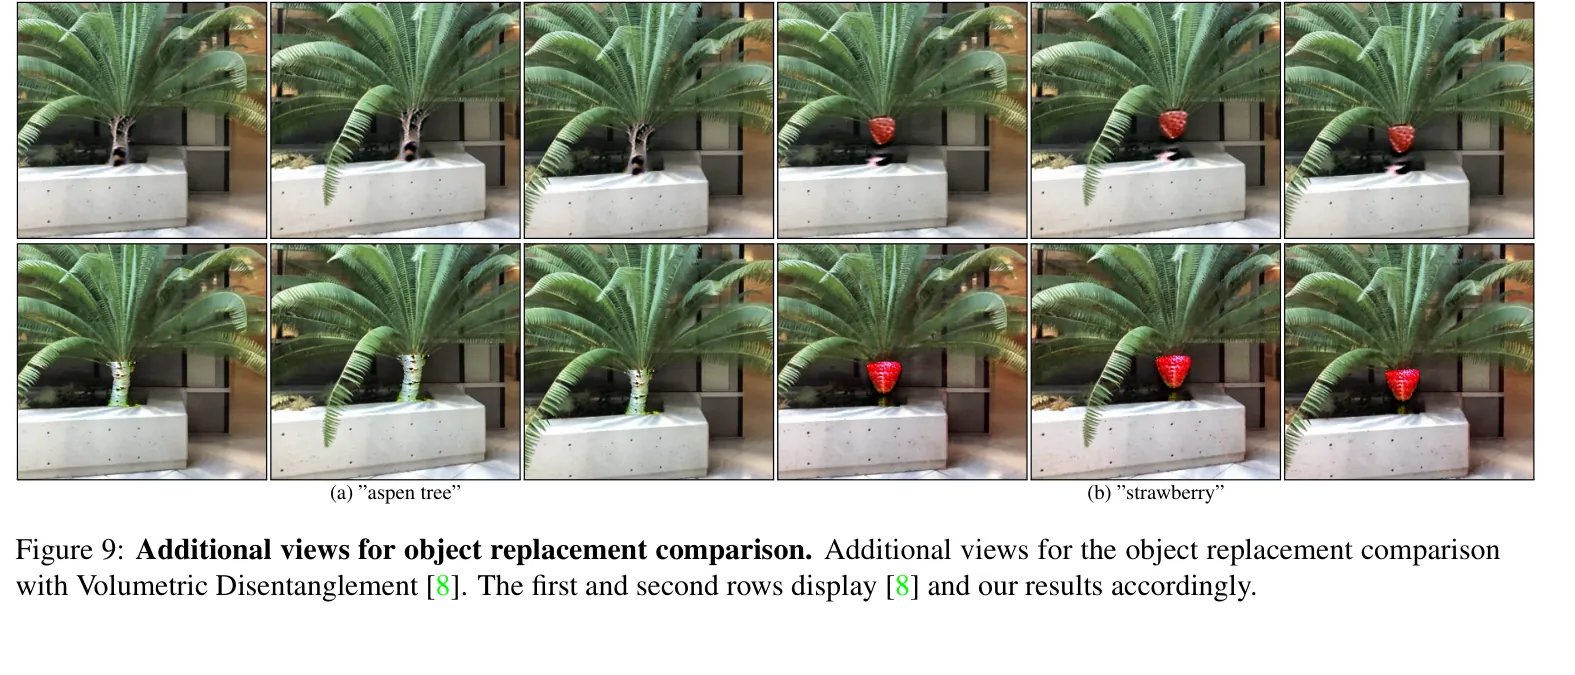
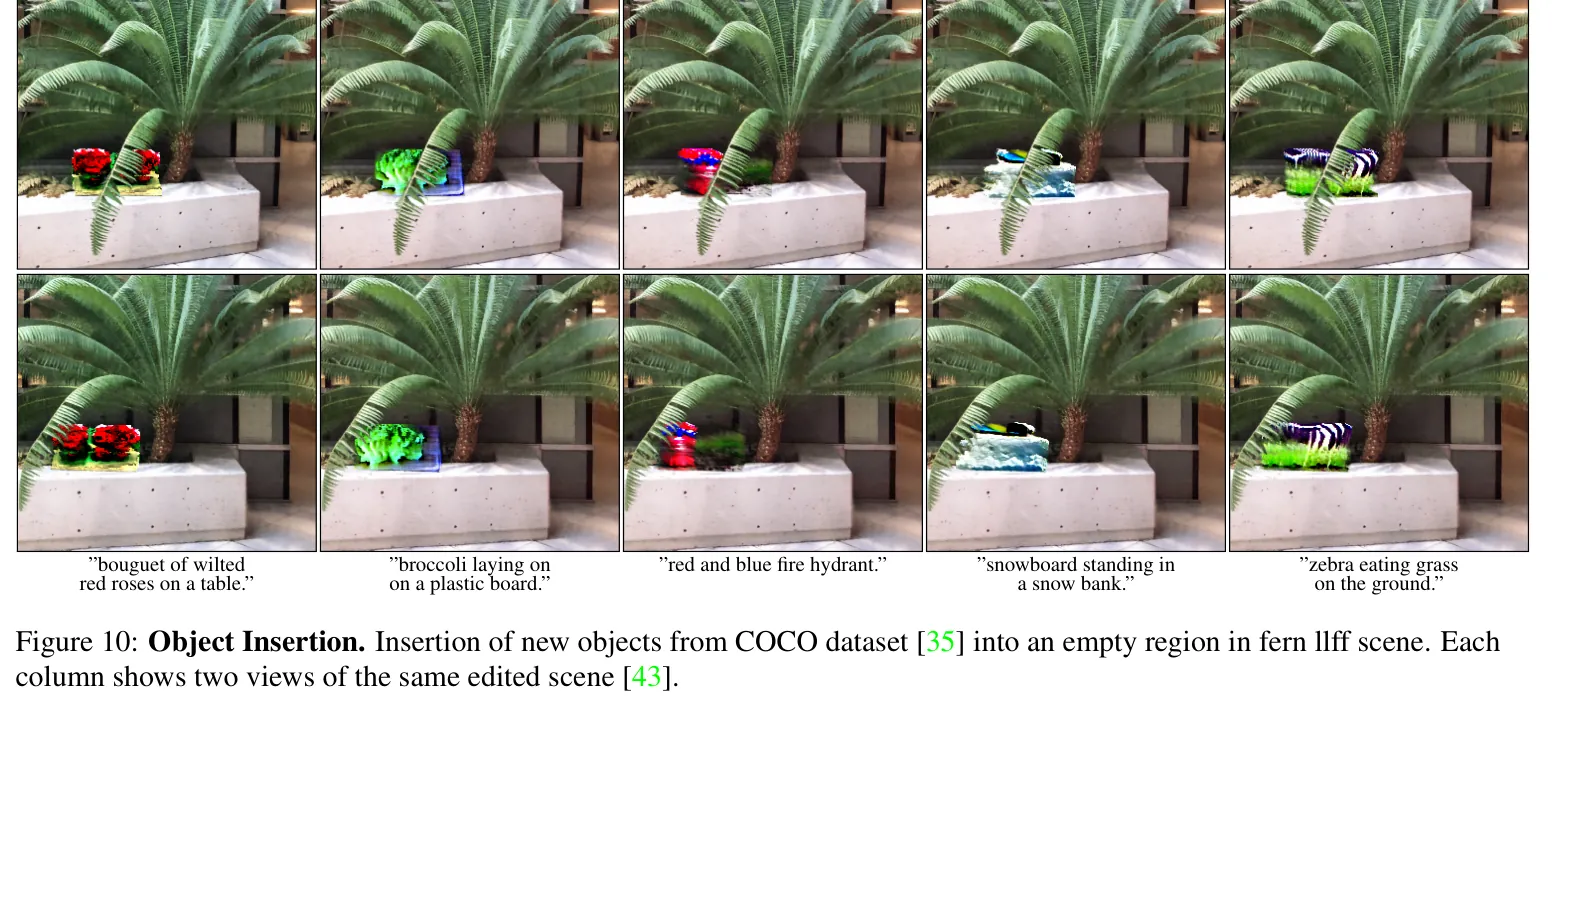
观察 Fig. 9 与 Fig. 10 的双视角对照可以看到:无论相机怎么左右环绕移动,替换进去的白杨树、草莓以及新插入的迷你玩具车、盆栽和玩偶,都能与原场景产生正确的三维视差移动与前后遮挡关系。
5.3 复杂真实 360 环绕场景下的插入、替换与多风格材质转换
相比光照均匀、背景纯净的 Blender 合成数据或仅朝前拍的 LLFF 场景,真正考验 NeRF 编辑算法硬实力的是 Real 360 真实环绕场景(如室外木甲板上的 vasedeck 与森林石板上的 pinecone)。这类场景相机轨迹绕着中心转满 ,背景杂乱且带有真实自然光影。Fig. 11 至 Fig. 14 完整展示了 Blended-NeRF 在这两大真实 360 场景上执行对象插入、原位替换与多材质转换的定性矩阵:
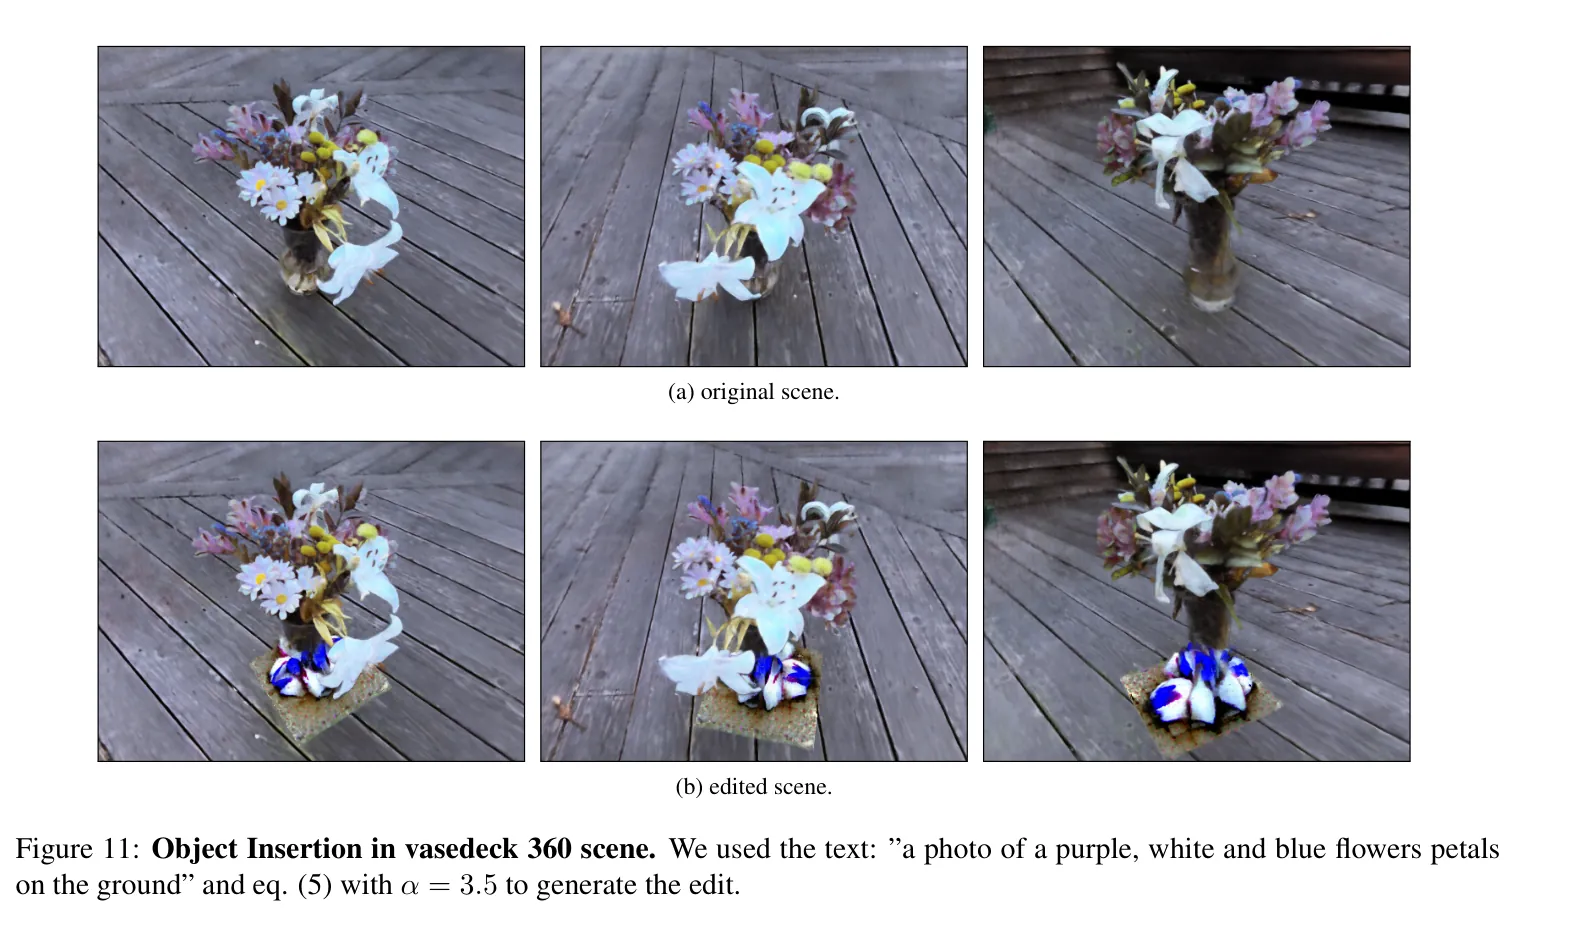
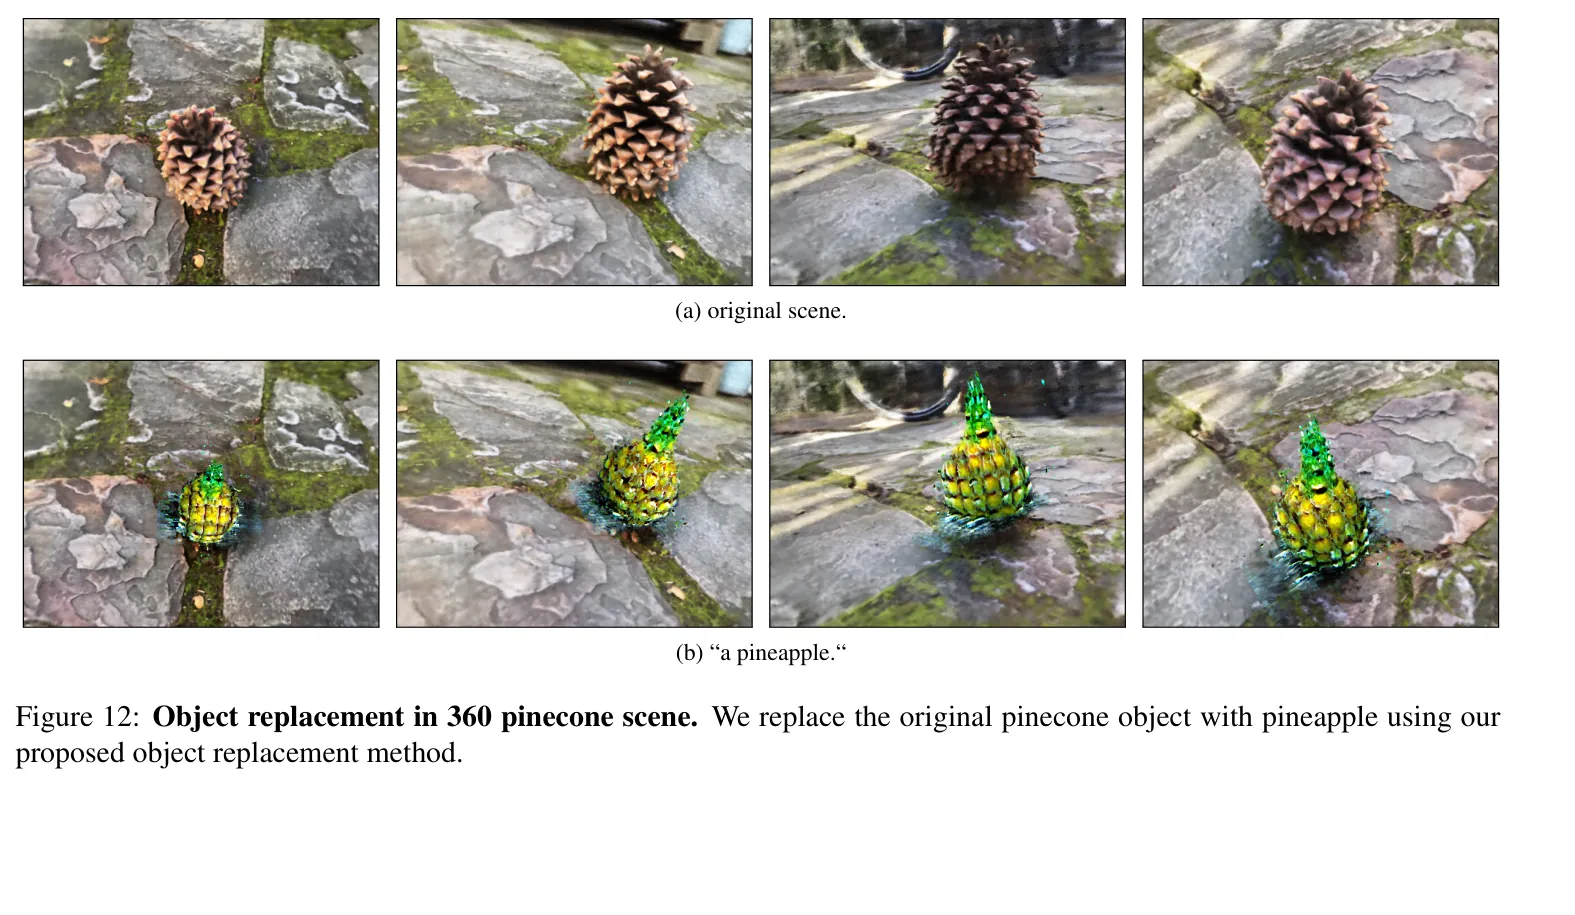
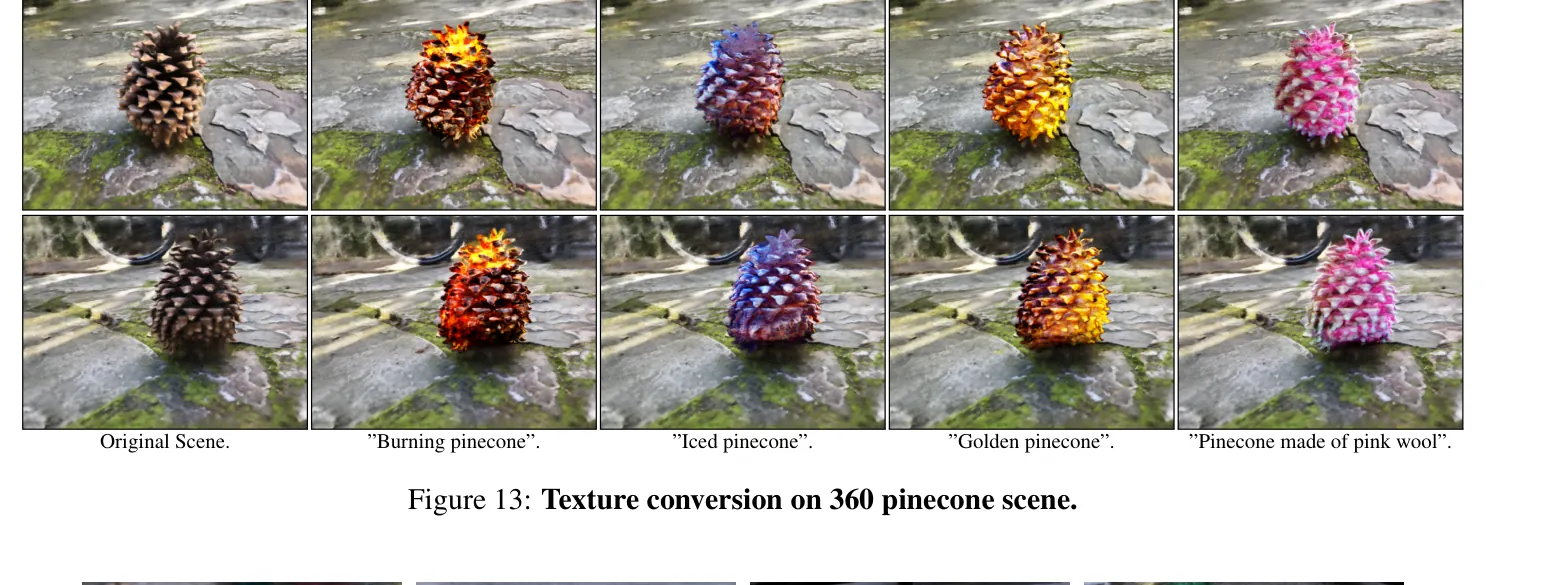
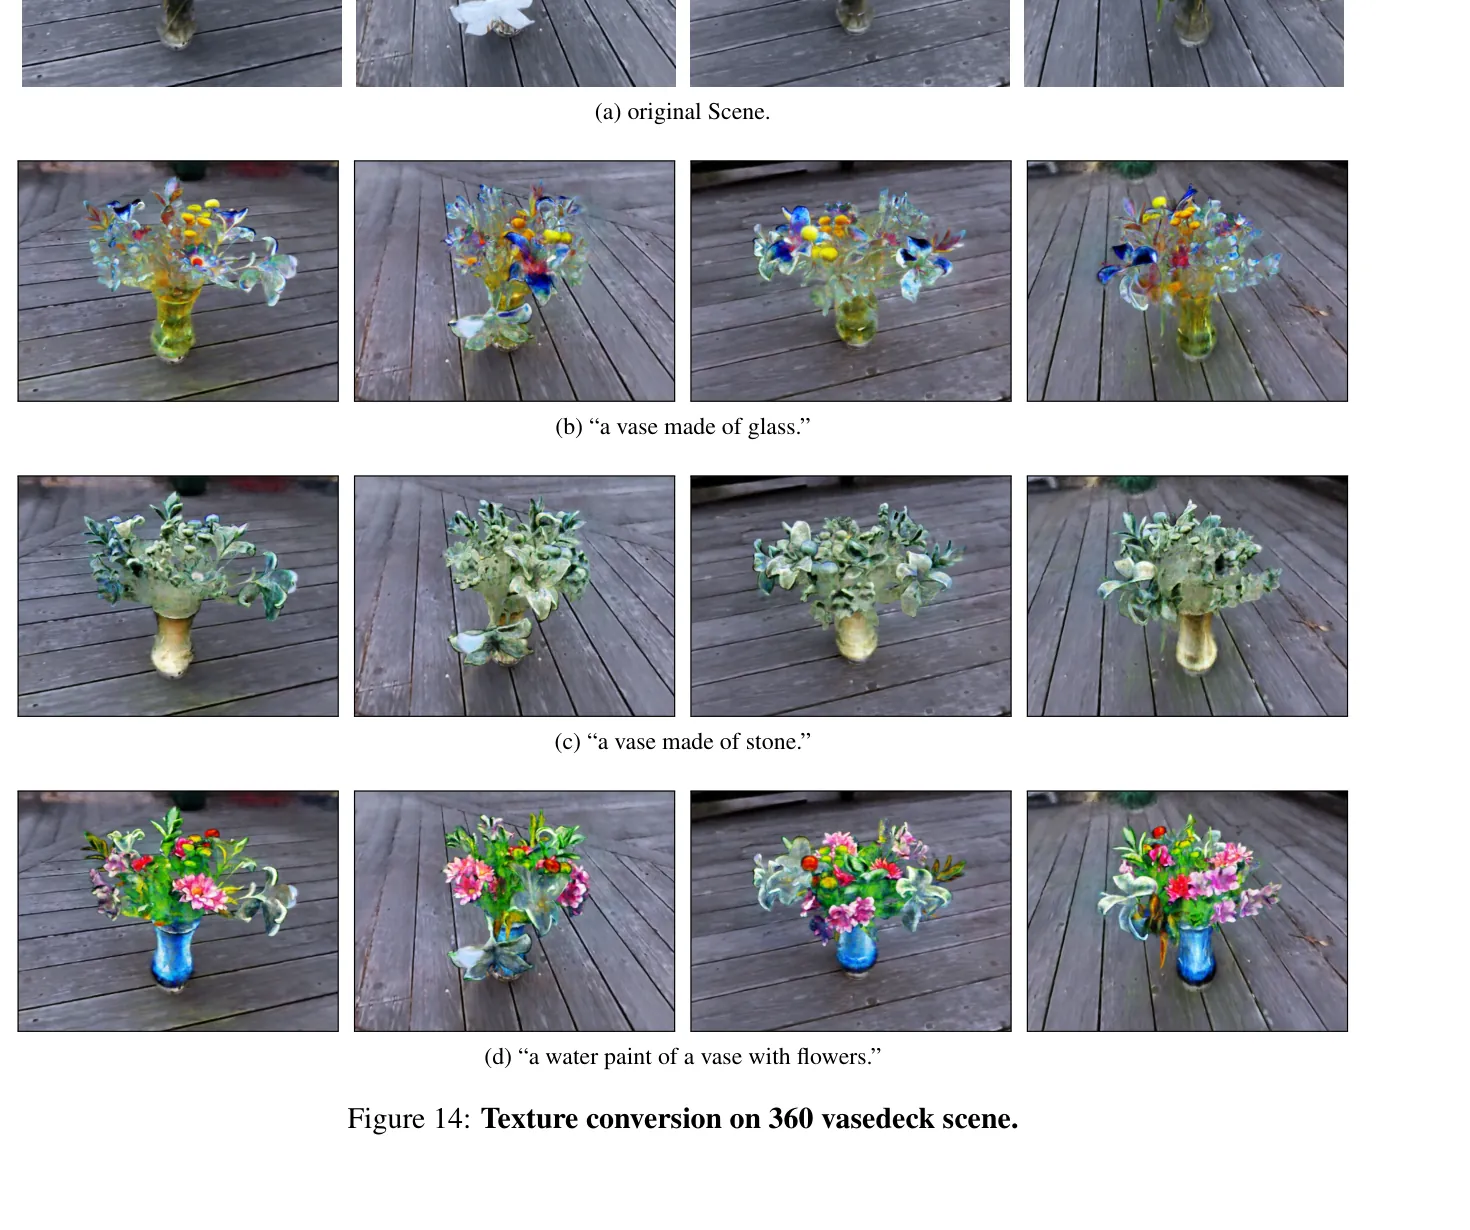
把 Fig. 11–14 放在一起审视,能清楚看到这套双分支体融合架构在真实场景中的优势与物理边界:
- 优势在于无缝的环境融合:无论是在花瓶旁插入花瓣(Fig. 11)、把松果原位替换成一整颗菠萝(Fig. 12),还是把松果和花瓶转换成燃烧、冰封、粉色毛线、岩石、水彩或绿玻璃质感(Fig. 13 & Fig. 14),由于生成分支继承了原场景权重且配合了距离平滑算子 ,周围的石板裂纹、青苔与木甲板背景在 360 度环绕视角下没有受到丝毫破坏。
- 边界在于高频几何与全局光追的缺失:对比 Fig. 12 从零生成几何的“菠萝”与 Fig. 13 冻结几何只改颜色的“冰封松果”,前者的表面细节明显偏软偏卡通(这是 CLIP 低频语义监督的通病);同时,当把花瓶改成透明玻璃或燃烧炭火时,由于原始分支 处于冻结状态,新材质并不会在周围的木桌面上投射出真实的火光照明或焦散折射。
6. 源码链路深挖与工程边界剖析
6.1 从配置文件到采样点融合的源码主干
对照官方开源仓库 orig333/Blended-NeRF,整个系统的工程实现非常精炼。入口文件 main.py 只有短短几行,直接将解析好的参数交给 BlendedNeRF/run_BlendedNeRF.py 中的 train_blended_nerf()。一次完整的编辑运行由三份本地资产驱动:原始多视角数据集(nerf_synthetic、nerf_llff 或 nerf_real_360)、预训练好的原场景底模权重(base_weights/),以及预定位的 3D 包围盒顶点张量(如 configs/lego.txt 中指定的 box_points/lego_exhaust_box.pt)。
沿着 run_BlendedNeRF.py 的调用栈走读,有两处极易在二次开发中踩坑的源码细节值得特别拎出来:
- NDC 归一化设备坐标与世界坐标的包围盒对齐:
在真实前向场景(LLFF)中,NeRF 默认在 NDC(Normalized Device Coordinates)空间里采样光线,而用户在交互式 Notebook 里框选的
box_points往往定义在世界坐标系或相机坐标系。为此,源码在render_rays()内部专门维护了ndc2world转换与box_points_world映射,确保在执行轴对齐入盒测试前,光线采样点pts与包围盒顶点处于严格一致的三维度量空间:
pt_is_in_box = (
    (box_points[:, 0].min() <= pts[..., 0]) &
    (box_points[:, 0].max() >= pts[..., 0]) &
    (box_points[:, 1].min() <= pts[..., 1]) &
    (box_points[:, 1].max() >= pts[..., 1]) &
    (box_points[:, 2].min() <= pts[..., 2]) &
    (box_points[:, 2].max() >= pts[..., 2])
)raw2outputsBlend()中的采样点级融合闭环: 在渲染全图时,render_rays()同时拿到fixed_model的输出raw_fixed与model的输出raw_train,一并传入raw2outputsBlend()。该函数先根据采样点到盒中心的距离除以对角线长度diag算出指数平滑系数 ,接着根据配置项sum_in_act选择在F.relu之前还是之后合并双分支密度,最后统一走标准体渲染的cumprod累计透射率算出像素颜色与深度图。正是因为混合发生在cumprod积分之前,新生成的物体才能正确遮挡住盒内后方的原场景结构,并写出准确的融合深度图。
6.2 真实工程落地的三大瓶颈与横向技术坐标
站在今天三维视觉与场景生成的全局视角回看,Blended-NeRF 既验证了隐式场局部非破坏性修图的可行性,也清晰暴露了这一代方法走向工业级生产工具的三大瓶颈:
- 手工 3D 包围盒的交互负担与形状刚性:用户必须先在三维空间里手动框定轴对齐长方体(AABB)。面对斜向生长的树枝、细长的花瓶瓶颈或环形车轮,方盒子不可避免地会框进大量无关背景空间(论文也坦承对于船只或环形区域,圆柱体或球体 ROI 会比长方体合适得多)。后续工作(如结合三维语义分割场 LERF 或 SA3D)正致力于用“一句话自动分割 3D 掩码”取代手工摆盒子。
- CLIP 监督的几何上限与优化延迟:用 CLIP/BLIP 配合视差方差先验虽然挡住了纸片化退化,但生成的三维几何依然偏平滑色块,远不如扩散模型 SDS(如 DreamFusion / Instruct-NeRF2NeRF)或原生 3D 生成模型细腻;且每次局部编辑仍需单场景迭代训练数千步,无法做到拖拽即所得的实时交互。
- 隐式辐射场与工业网格管线的隔阂:编辑后的产物依然是锁在双分支 NeRF 里的体渲染视图,无法直接一键导出为带干净拓扑、独立 UV 贴图和刚体碰撞盒的工业级 Mesh 资产。
把 Blended-NeRF 放进本站精读过的 3D 场景生成与建模技术谱系中,可以一眼看清它与其他代表性路线的互补关系:
| 系统 / 论文 | 核心任务定位 | 输入前提与控制接口 | 底层表示与核心机制 | 适用场景分野 |
|---|---|---|---|---|
| Blended-NeRF | 已有 NeRF 场景的局部零样本修图 | 已训练原场景 NeRF + 单个 3D ROI Box + 文本/图像提示 | 冻结原始场 + 克隆生成场 + 距离平滑 + 激活函数内外双模式体融合 | 已有重建好的隐式场景,需在局部做插入、替换、缠绕融合或材质改色且严保背景不动 |
| CompoNeRF | 从零组合生成多物体 NeRF 场景 | 多物体全局文本 + 子文本列表 + 多对象 3D Box 布局 | 多个独立局部 Instant-NGP + 跨盒光线深度重排 + 全局密度残差校准 MLP | 无现成底模场景,需按布局从头合成多物体场景并拆解缓存局部组件 |
| Layout2Scene | 3D 语义布局引导的完整室内场景生成 | 房间 3D 语义包围盒布局 + 场景提示词 | 前景对象 2D Gaussians + 背景房间多边形 + 先几何(GSDS)后外观(ISD)两阶段扩散蒸馏 | 需按全屋家具布局生成 30 FPS 实时漫游且几何规整的室内场景 |
| Diorama / SUFLECA | 单张真实照片恢复可编辑 3D CAD 场景 | 单张室内 RGB 图像 + 现成三维 CAD 资产库 | 开放词汇分割 + NOC/DINO 几何特征匹配 + 9-DoF 配准(SupeRANSAC)+ 防穿模优化 | 需要输出拓扑绝对干净、可直接在工业渲染器中挪动编辑的标准 CAD 网格场景 |
| TRELLIS.2 / AssetGen | 单物体高保真 3D 网格与 PBR 资产生成 | 单张参考图或文本提示 | 结构化稀疏体素潜在空间(O-Voxel)前馈生成带完整 PBR 通道的网格 | 需要秒级生成可直接放进游戏引擎的高精度独立 3D 资产 |
总而言之,Blended-NeRF 最值得铭记的工程智慧,在于它用“克隆初始化 + 局部 ROI 渲染隔离 + 距离指数平滑 + 激活函数内外密度代数”这四招极具性价比的组合拳,在不破坏原场景一丝一毫的前提下,赋予了黑盒连续辐射场灵活的局部增删改能力。对于任何需要在隐式神经场或 3D Gaussian Splatting 场景中设计局部非破坏性编辑器的开发者而言,这套采样点层级的双分支混合设计依然是一份教科书级的参考蓝本。
参考资料
- Ori Gordon, Omri Avrahami, Dani Lischinski, Blended-NeRF: Zero-Shot Object Generation and Blending in Existing Neural Radiance Fields, arXiv:2306.12760v2(ICCVW 2023, DOI:
10.1109/ICCVW60793.2023.00316). - 官方项目页:vision.huji.ac.il/blended-nerf;官方开源仓库:orig333/Blended-NeRF.
- 相关核心文献:NeRF (ECCV 2020)、Dream Fields (CVPR 2022)、CLIP-NeRF (CVPR 2022)、Volumetric Disentanglement (ECCV 2022)、DreamFusion (ICLR 2023)、SJC (CVPR 2023).
comments