给你一张日常书房的照片——角落里有斜向交汇的两面墙,书桌上摆着显示器、笔记本电脑、一摞书和马克杯,地上放着双肩包与转椅——怎么把这张扁平的二维图像,变成一个每个物体都能单独拎出来挪动、连被挡住的椅子背面也有完整几何、而且杯子和书本稳稳贴在桌面上的三维可编辑场景?
这件事如果交给传统的单目深度估计或神经表面重建,你只能拿到一层像石膏外壳一样的“2.5D 前表面”:稍微转个视角,书桌背面和被挡住的墙角全是大黑洞,而且所有物体粘成一张大网格,根本没法单独拖动那台笔记本电脑。反过来,如果交给 Scan2CAD、ROCA 这类传统的端到端室内 CAD 对齐网络,它们受限于封闭的训练词表,眼里只有“床、沙发、大桌子”这八九类大件家具,桌上的电脑、书本、台灯和墙上的挂画统统会被当成背景噪点无视掉;更糟糕的是,逐个物体独立预测出的三维位姿一旦拼进同一个房间,立刻会出现桌子悬空、椅子腿插进地板、书本飘在半空的穿模灾难。
面对这一连串棘手的系统级耦合难题,西蒙菲莎大学(SFU)与布朗大学团队提出的 Diorama: Unleashing Zero-shot Single-view 3D Scene Modeling(入选 ICCV 2025 Highlight,项目主页 / 官方代码)交出了一份极具工程穿透力的答卷。透过繁复的六个子模块看本质,Diorama 的整套架构建立在四条核心设计哲学之上:
- 承认单视角欠约束,用“分析即合成”的多假设 CAD 装配替代病态像素重建(Analysis-by-Synthesis with Multi-Hypothesis CAD Assembly):单张照片本质上不可能唯一决定被遮挡背面的真实几何与绝对尺度。Diorama 果断放弃逐像素捏网格的路线,转而将输出契约定义为结构化的
SceneSpec(有界建筑平面 + 带 9-DoF 位姿与支撑父节点的 CAD 资产集合),并保留多个检索候选生成多组合理的场景装配假设(Arrangements)——主动牺牲像素级表面花纹的精确复刻,换取 100% 完整的三维拓扑与开箱即用的对象级交互编辑能力。 - 先擦除家具再拟合房间,用“空房修复 + 法线聚类”攻克非曼哈顿建筑外壳(Foreground Erasing before Plane Fitting in PlainRecon):在塞满家具的室内点云里直接跑平面拟合,大书柜、桌面与墙面的点云法线几乎平行,算法根本分不清哪块是墙、哪块是柜子。PlainRecon 采取了绝妙的逆向拆解:先用高召回率前景分割配合图像修复(Inpainting)把照片里的家具统统“搬空”,还原出干净的毛坯空房图像,再在单目几何上做迭代法线聚类与旋转卡壳边界提取,无需正交长方体(Manhattan)假设即可实现 100% 稳定的房间外壳重建。
- 让多模态大模型推理“谁撑着谁”,让稠密块特征配准“摆在哪儿”(VLM for Topological Support Tree, Patch Correspondence for Metric Pose):严守不同基础模型的能力边界——GPT-4o 直接报三维米制坐标极不靠谱,但配合图像上的数字标签(Set-of-Mark),它极其擅长看图推理出“书本放在书桌上、显示器架在支架上、挂画挂在右墙上”的有向无环支撑树;而定量的 9-DoF 初始位姿,则交给 DINOv2 在 180 个预渲染视图上的双向循环块匹配、Umeyama-RANSAC 与 GigaPose 尺度回归网络协同求解。
- 用四阶段课程优化解开“贴合支撑面”与“防穿模排斥”的梯度死锁(Stage-Wise Curriculum over All-in-One Layout Optimization):如果把法线朝向对齐、贴合支撑面和三维包围盒(OBB)防碰撞损失一锅端同时放开优化(All-in-One),物体还没转正就被非光滑的碰撞排斥梯度推飞了,整体布局合格率只有惨淡的
0.15。Diorama 通过选择性梯度截断(detach),严格按照“先掰正接触面朝向(Orientation) 再垂直拉向支撑平面(Placement) 接着在支撑面内推开穿模物体(Space) 最后回补高度与贴墙粘附(Refinement)”的四步课程推进,将布局合格率一举拉升至0.92。
下面我们就顺着这四条设计哲学,结合论文推导与开源仓库(基线提交 ec54d826)的实现细节,层层剖析这套零样本单图三维场景建模系统。
1. 任务重塑与系统全景:把单图恢复转化为结构化场景装配
1.1 结构化场景契约与三个“零样本”边界
给定单张室内 RGB 图像 ,Diorama 的目标是直接生成一份机器可读、可直接导入三维渲染引擎或编辑器的结构化场景描述(源码中封装为 diorama/scenespec.py 中的 SceneSpec 对象):
{
  "architecture": [
    {"id": "floor", "plane": [0, 1, 0, -1.2], "polygon": "..."},
    {"id": "wall_1", "plane": [0, 0, 1, -3.8], "polygon": "..."}
  ],
  "objects": [
    {
      "id": 7,
      "category": "stack of books",
      "caption": "three books beside the monitor",
      "cad_asset": "asset_id",
      "rotation": "3x3 matrix",
      "translation": [0.3, 1.1, 2.4],
      "scale": [0.24, 0.08, 0.19],
      "supported_by": 4
    }
  ]
}
在进入各模块之前,有必要先厘清论文中频繁出现的三个核心定位词的技术边界:
- 零样本(Zero-shot):指系统从未在目标测试集(如 ScanNet 或自建的 SSDB 基准)上训练过端到端的 Image-to-CAD 映射网络,直接靠通用视觉与语言基础模型的组合完成跨域推理。
- 开放世界(Open-world):彻底打破传统室内三维数据集只有八九类大件家具的紧箍咒,无论是桌面上的笔记本电脑、堆叠书本、水杯,还是墙上的装饰画与地上的背包,统统纳入感知与检索装配范围。
- 免端到端训练(Training-free):指无需联合训练场景级大模型,但在线推理时合理调度了 GPT-4o、OWLv2、SAM / SAM 2.1、Metric3DV2、DINOv2、DuoDuoCLIP、GigaPose 尺度网络与 Inpaint-Anything 等多套预训练权重。
1.2 从多源输入到两段式系统流水线
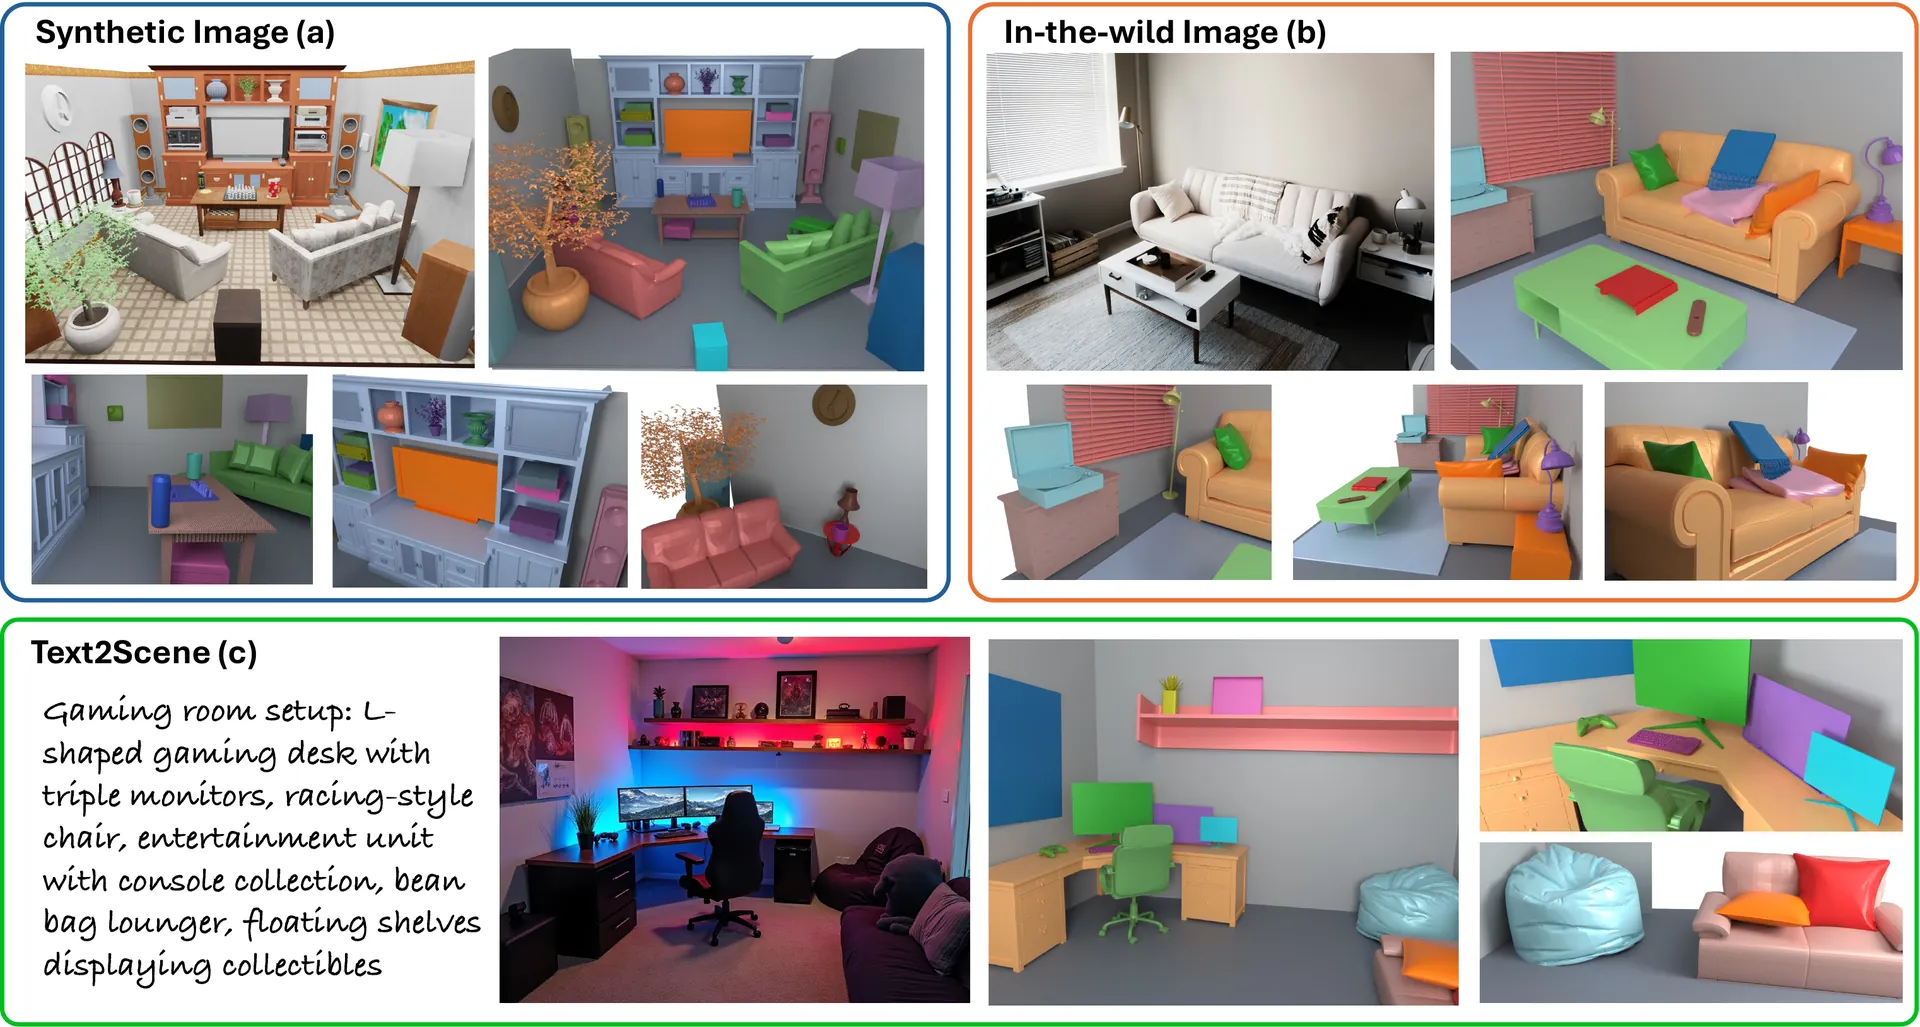
看上面这张开篇全景图(Fig. 1),Diorama 能够通吃三类截然不同的单图输入:SSDB 合成复杂室内图(左)、互联网上随手找来的野生真实室内照片(中),以及由一句文本提示经 Flux-1 生成的二维概念图(右)。哪怕输入照片里的沙发或书桌被挡住了大半截,输出的三维场景依然拥有四面完整的干净 CAD 网格与严丝合缝的墙地平面,支持从任意新视角环绕审视。
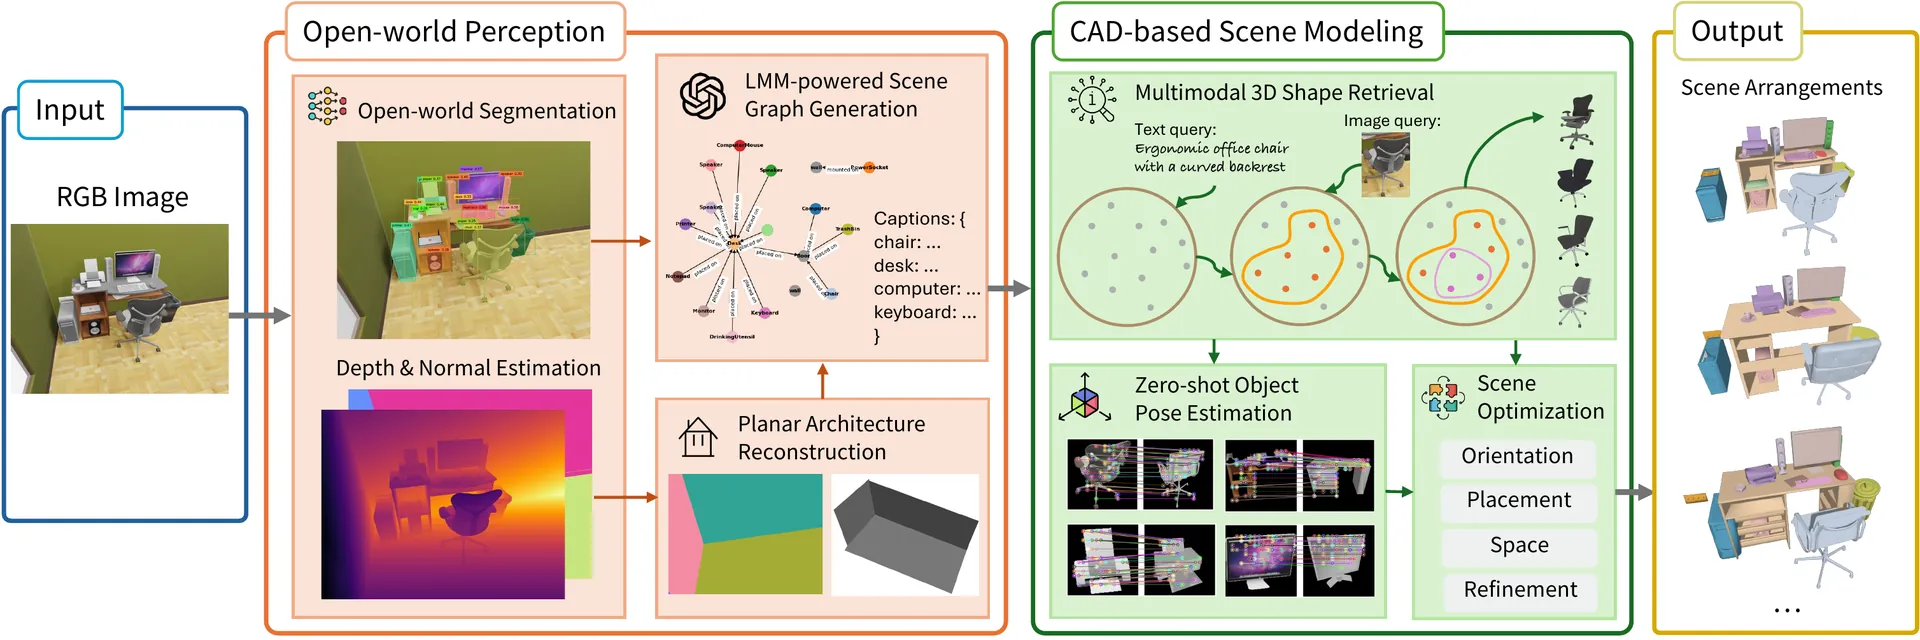
Fig. 2 展示了实现这一能力的两段式系统架构:
- 上半部分为开放世界感知阶段(Open-world Perception,橙色框):从单张图像出发,分三路并进——第一路用 VLM + 开放词汇检测与分割提取所有大小物体的 2D 框与像素掩码;第二路通过 PlainRecon 擦除前景家具、结合 Metric3DV2 预测的度量深度与法线恢复房间墙壁与地板平面;第三路利用带编号标记的图像让 GPT-4o 推理出“谁支撑着谁”的层级场景图(Scene Graph)。
- 下半部分为基于 CAD 的场景建模阶段(CAD-based Scene Modeling,绿色框):拿着感知阶段产出的类别描述、局部裁剪图与反投影点云,先用 DuoDuoCLIP 从跨源资产库(60K+ 模型)中检索出 Top-K 候选 CAD 模型;接着利用 DINOv2 稠密块特征与 180 个预渲染参考视图做双向循环匹配,结合 Umeyama-RANSAC 和 GigaPose 尺度网络解出每个物体的初始 9-DoF 位姿;最后送入四阶段语义布局优化器,在消除碰撞穿模的同时让所有物体稳稳落座,输出多组合理的场景装配方案(Arrangements)。
2. 开放世界感知与 Set-of-Mark 支撑树推理
2.1 开放词汇实例解析与度量深度反投影
为什么不能直接让 GPT-4o 框出图里所有物体的像素坐标?因为多模态大模型虽然语义见识广,但直接输出二维边界框坐标时精度很差,还经常漏掉桌上密密麻麻的小物件。
Diorama 在 diorama/vis_agent.py 中采用了“大模型定词表,专用检测器找坐标”的分工策略:先调 GPT-4o(VLMAgent.understand_scene())扫描全图,列出画面中出现的所有开放词汇类别集合 ;再把这份动态词表喂给开放词汇检测器 OWLv2 定位二维包围框 ,并用 SAM / SAM 2.1(SAM2.1 Hiera Large)抠出精细像素掩码 ,配合类别感知非极大值抑制(Class-aware NMS)滤除重叠冗余框,得到 个物体的二维实例集合:
与此同时,单目几何基座 Metric3DV2 预测整张图的度量深度图 与表面法线图 。结合相机内参反投影函数 ,第 个物体的掩码像素被直接提升为相机坐标系下的局部三维点云:
这团局部点云 在后续管线中身兼重任:它既要给 9-DoF 位姿估计提供三维目标点坐标,又要决定物体的初始平移中心与物理尺度。
2.2 给画面贴上数字牌:基于 Set-of-Mark 的场景图构建
识别出了 20 个物体之后,最关键的结构化问题来了:当单目深度有 15 厘米误差导致杯子在三维空间里悬空时,优化器怎么知道这个杯子到底该往书桌上吸、往书架隔层里放,还是直接掉到地板上?
这就必须靠显式的支撑层级场景图(Support Scene Graph) 来指路。
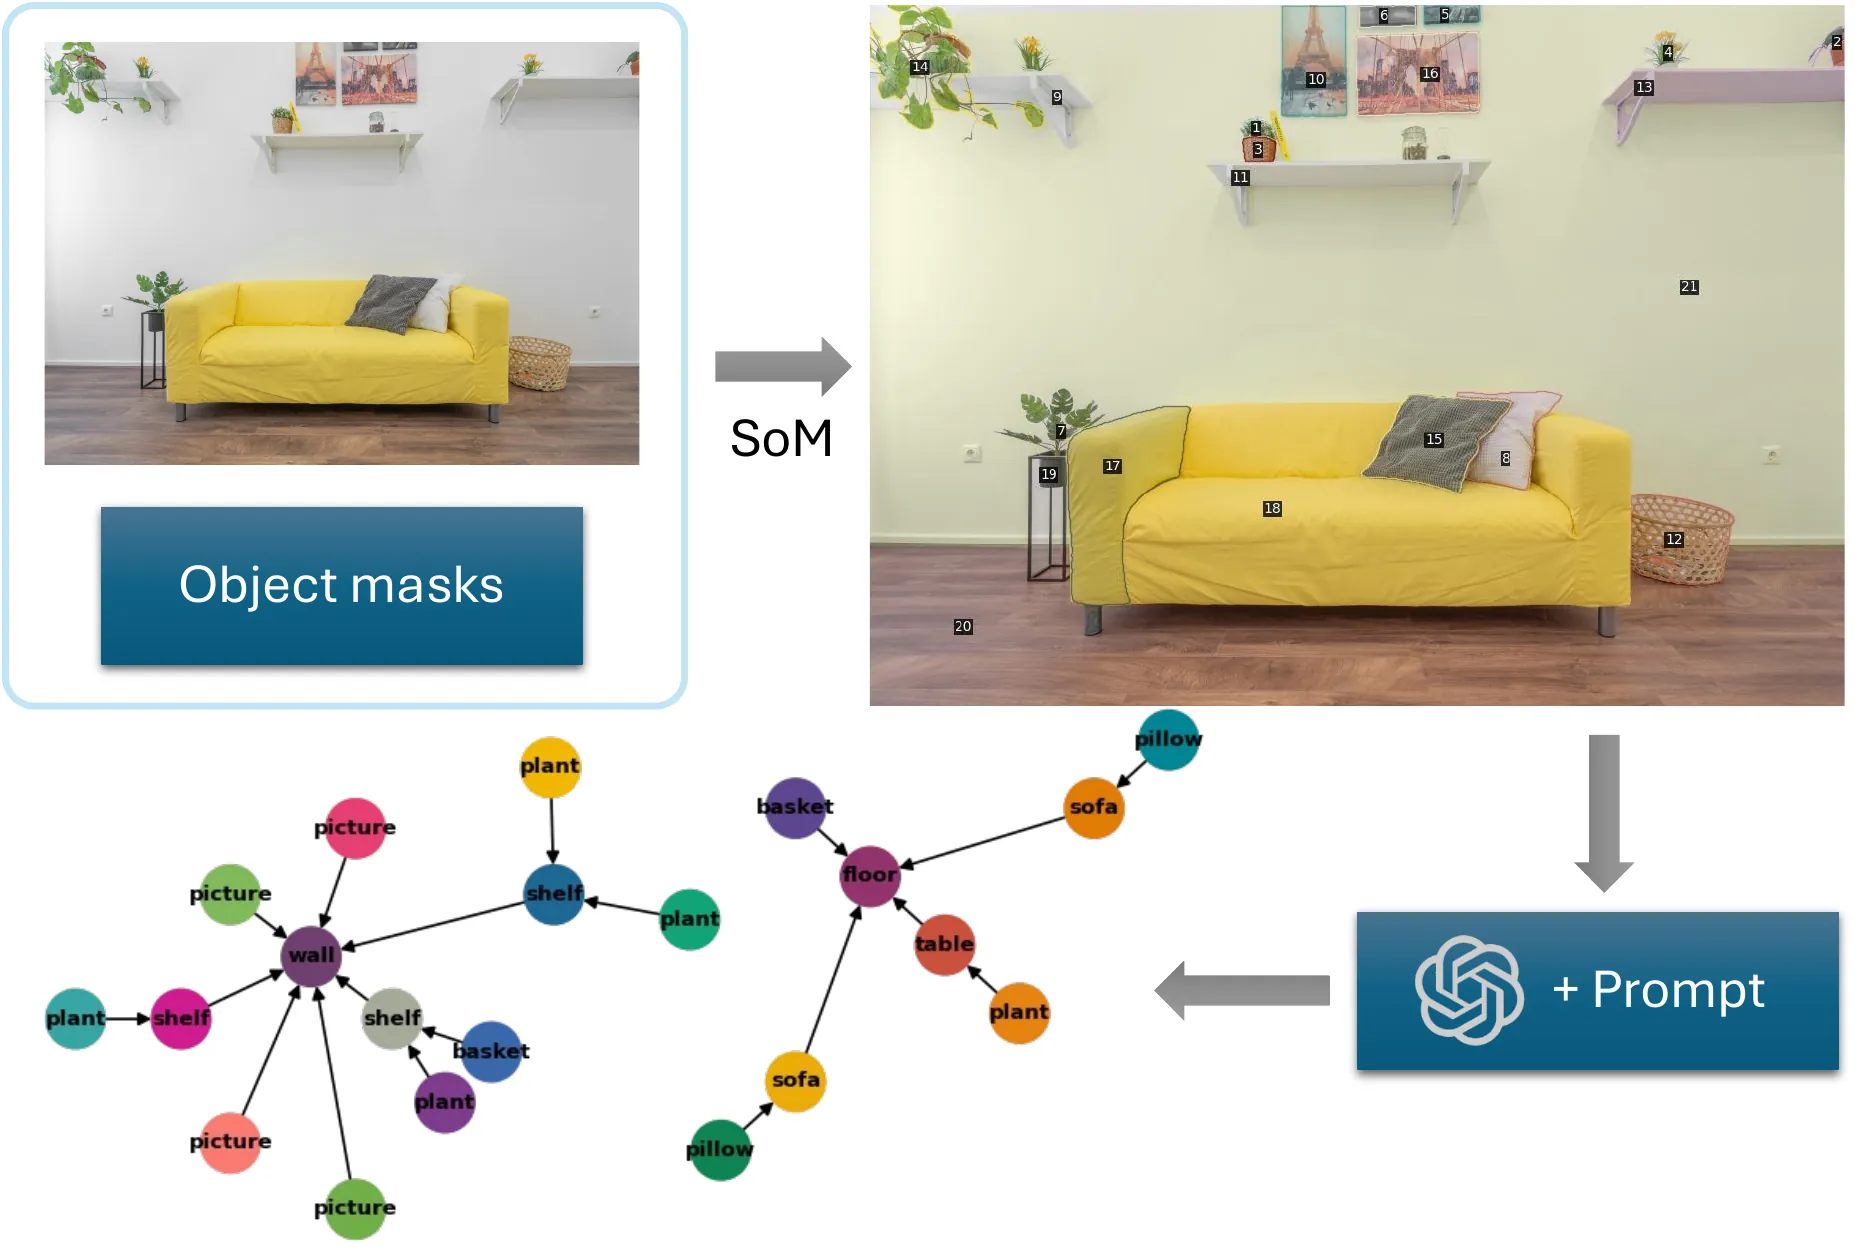
如果只用文字问 GPT-4o:“请问图里左边第二个杯子放在哪张桌子上?”,当桌上摆了好几个杯子和书本时,纯文本指代极其容易张冠李戴。为此,作者在 Fig. 10 中引入了 Set-of-Mark(SoM)视觉提示机制(对应 augment_image_w_marks()):直接把每个实例以及每面墙壁、地板的唯一数字 ID(如 [1], [4], [7])醒目地画在图像对应的分割掩码中心,连同列表喂给 GPT-4o。
模型只需要看着带数字标号的画面做连线填空:
- 为每个节点 生成一句带空间上下文的细粒度外观描述(Caption,例如
"three stacked books beside the monitor",供后续检索模型挑选更贴切的 CAD 资产); - 为每个被支撑物体确定唯一的直接支撑父节点 ,构建有向边 ,并明确区分是平放在水平表面上(
placed on,如显示器放在书桌上)还是挂载在垂直立面上(mounted on,如挂画挂在右墙上)。
因为强制要求每个物体只能认一个直接生父(地面、墙面作为根节点),生成的场景图天然是一棵有向无环支撑树(DAG / Tree)。在源码 SceneSpec.add_support_surf() 中,这棵树直接决定了后续几何优化的物理拓扑:谁的顶面是提供承托的支撑面(Support Surface),谁的底面(或背面)是去贴合别人的接触面(Contact Surface),以及哪些小物件是塞在书架隔板内部(Supporting Volume)的。
3. PlainRecon 建筑恢复:先把家具“搬空”,再给房间量尺寸
3.1 为什么直接拟合点云会失败?去家具修复与法线聚类三步法
要让家具落脚,首先得有地板和墙壁。传统的室内布局方法(如 Scan2CAD 或早期 Room Layout 估计)大多死守曼哈顿世界假设(Manhattan World Assumption),把房间硬塞进一个方方正正的六面体盒子里——一旦遇到带斜角墙面的阁楼、走廊开口或者只拍到两面墙的局部特写,六面体假设就会当场崩溃。
那能不能直接在 Metric3DV2 反投影出来的全图三维点云上跑 RANSAC 拟合平面呢?还是不行!想象一面靠着大衣柜和书桌的墙:衣柜门、桌面和墙面全是平整的大平面,而且法线方向完全正交一致;如果带着家具直接拟平面,RANSAC 算出来的“墙面”和“地面”就会把柜门和桌面一起吞进去,算出的房间边界全乱了套。
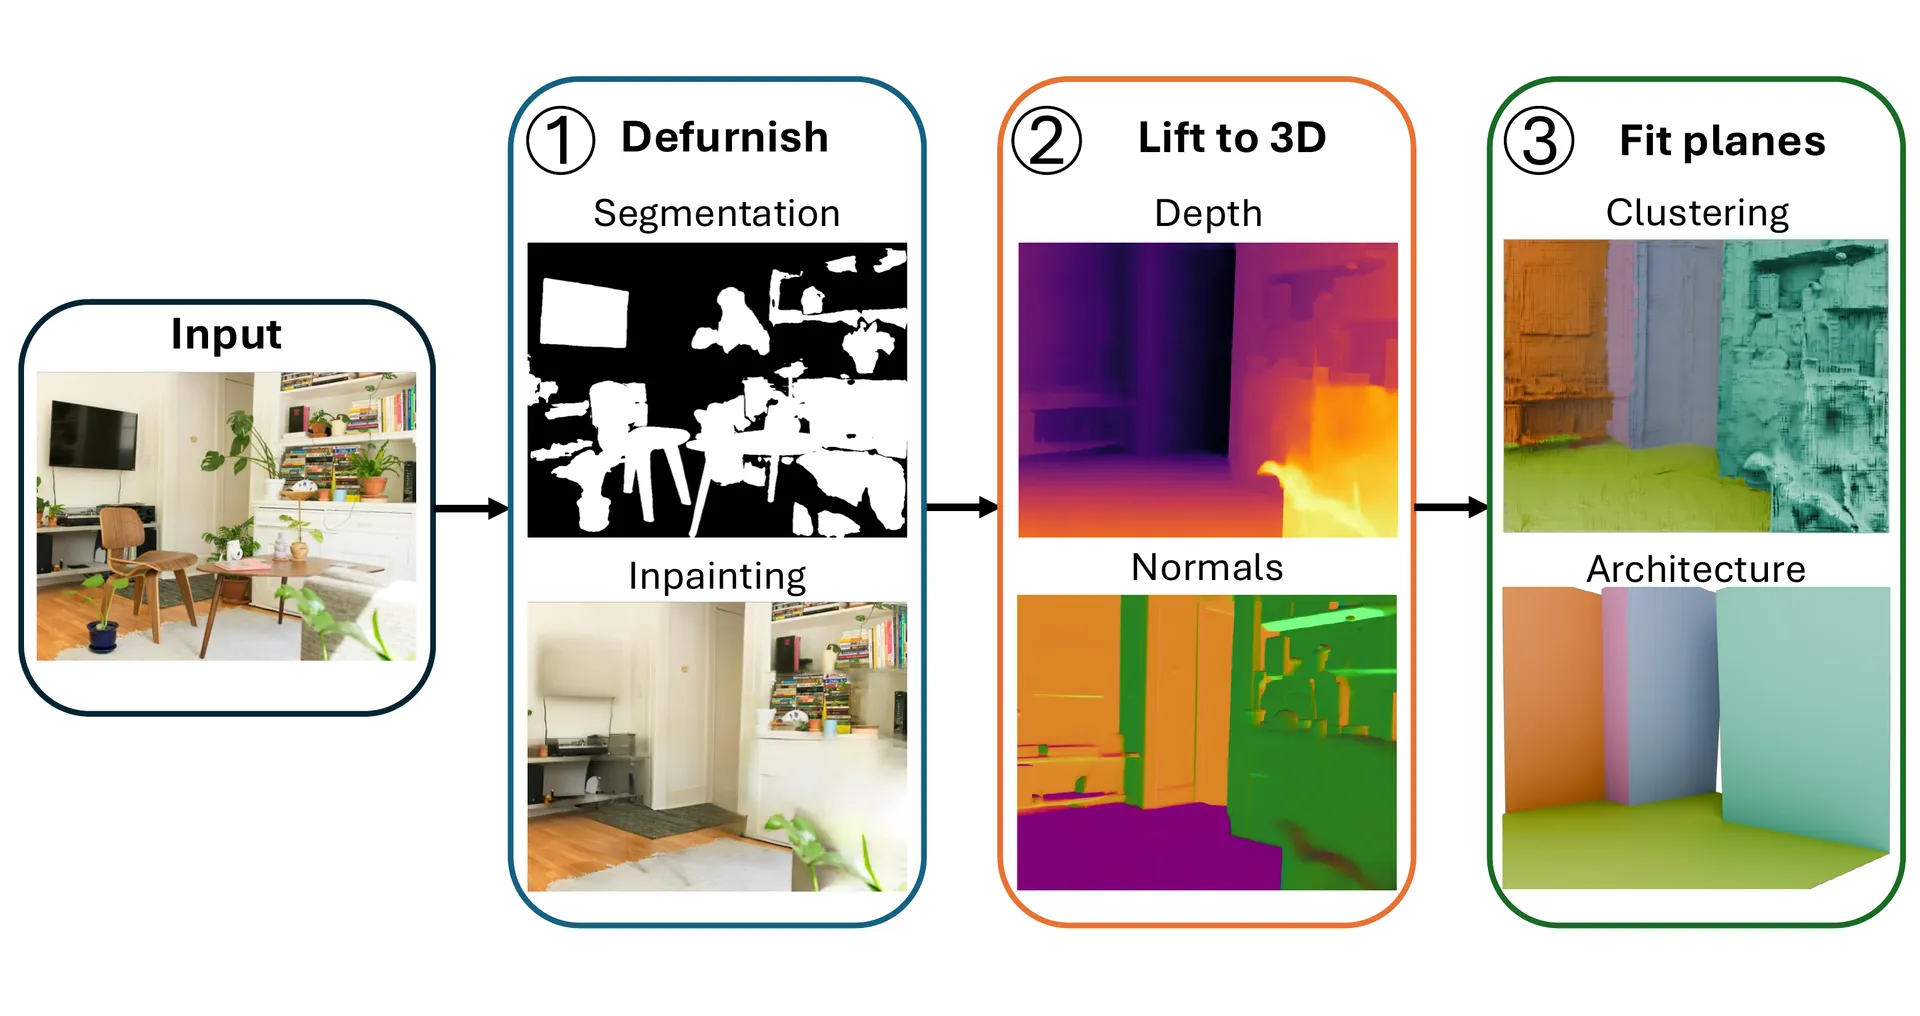
看 Fig. 3 展示的 PlainRecon 流程,作者用“先做减法、再做聚类”的三步巧思干净利落地解决了这个问题:
- 高召回率前景擦除与“毛坯空房”图像修复:既然家具碍事,那就先把家具从照片里抹掉!系统组合了 BiRefNet、MVANet 与 SEEM 等显著性与全景分割模型(
scripts/compute_dichotomous_segmentation.py),宁可稍微多框一点边缘,也要把前景家具 100% 圈出来;随后调用 Inpaint-Anything 把抠掉家具的空白区域顺着周围墙面和地板纹理自然补齐,生成一张干净的“空房间(Empty Room)”图像。 - 为什么按表面法线聚类,而不直接按深度拟合? 对修复后的空房间图跑 Metric3DV2 拿到深度与表面法线后,作者敏锐地注意到一个物理特性:二维图像修复(Inpainting)填补出的像素,其估计出的绝对深度值往往有轻微鼓包起伏,但预测出的表面法线方向(Normal)却高度一致且极其稳健! 因此,系统先在法线空间下手:初始化 12 个 K-means 种子法线,迭代吸收法线夹角小于 的点(直到未归类点少于 200 个);接着针对“左右两面平行墙法线相同但空间不相连”的情况,在三维坐标上跑 DBSCAN 密度聚类将它们拆成独立墙面,并用最近邻()收编剩余零散点。
- RANSAC 平面拟合与旋转卡壳边界提取:对每个聚类出的墙面或地面点集,用 RANSAC 拟合三维无穷平面方程: 最后把该平面上的内点投影到平面自身的二维局部坐标系,先求二维凸包(Convex Hull),再用旋转卡壳法(Rotating Calipers)拟出紧致的有界三维多边形(3D Bounded Planes)。这样无论是三面墙、斜角墙还是走廊局部,都能拿到带精确边界的房间外壳。
3.2 100% 稳定重建:与 RaC 基线的定性与定量交锋
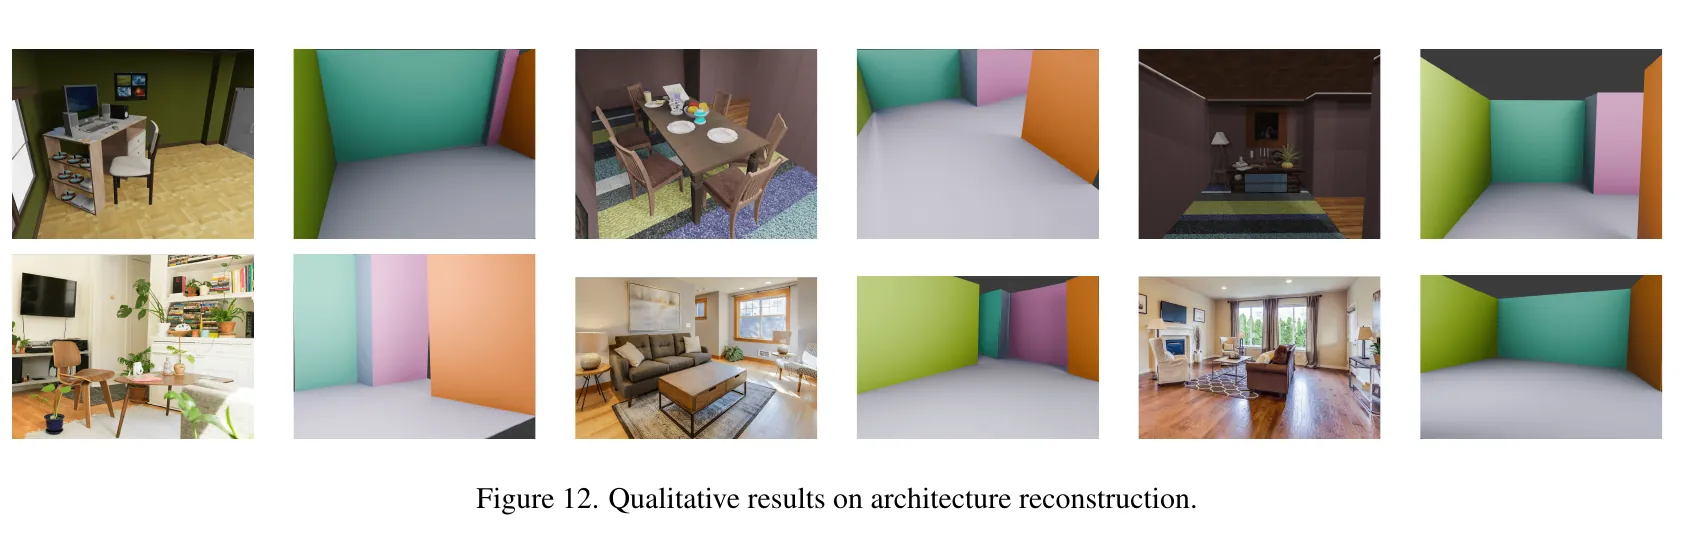
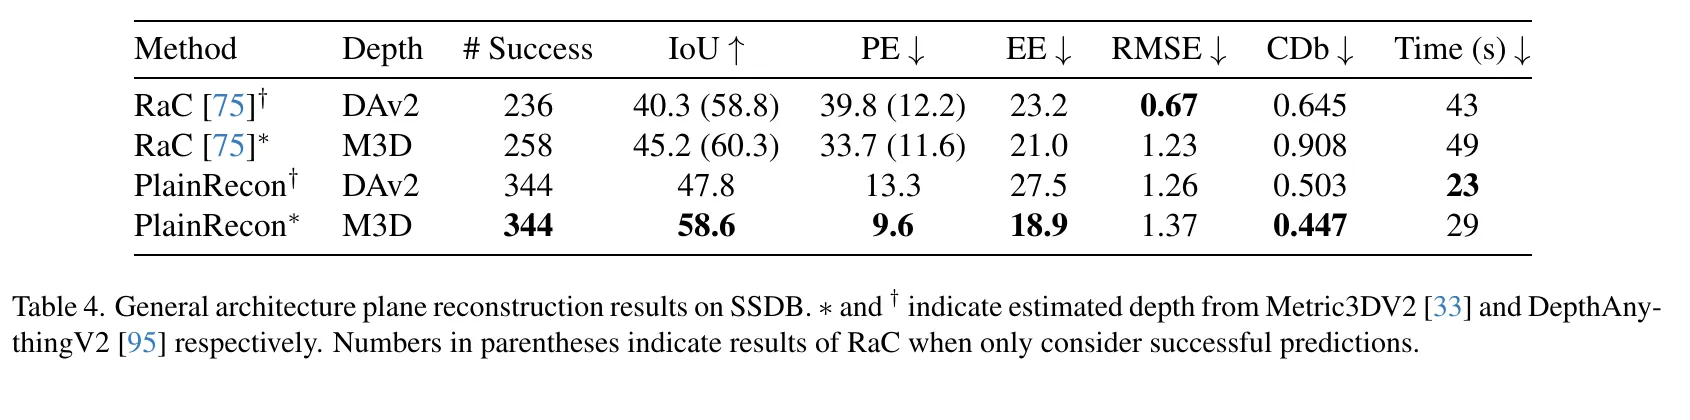
对照 Fig. 12 的可视化与 Table 4 在 SSDB 全部 344 张测试图像上的实测数据,PlainRecon 的工程价值体现得淋漓尽致:
- 从“经常崩盘”到“344/344 零失败”:对比基线 RaC(无论是搭配 Depth Anything V2 还是 Metric3DV2),由于依赖严格的平面交线拓扑求解,在 344 张测试图里竟然有 86~108 张图直接求解崩溃(Success 仅为
236/344与258/344)!而对于下游的家具装配而言,一旦房间地板或墙面重建失败,整张图的场景建模就彻底泡汤。PlainRecon 凭借先擦除家具再法线聚类的稳健设计,在 344 张图上做到了 100% 成功重建。 - 精度与速度双赢:在全集评测下,PlainRecon + Metric3DV2 将平面交并比(IoU)从 RaC 的
45.2大幅推高到58.6,平面法线与偏移误差(PE)从33.7猛压到9.6,边界倒角距离(CDb)压到0.447,同时单图耗时从 49 秒缩短至 29 秒(搭配 DAv2 更是只需 23 秒)。
4. 多模态 CAD 检索与零样本 9-DoF 位姿配准
房间外壳和支撑树就绪后,接下来要把每个物体对应的三维 CAD 模型找出来(Retrieval),并算出它的三维旋转、平移和三轴尺度(9-DoF Pose Estimation)。
4.1 为什么用文本初筛 + 视觉重排?DuoDuoCLIP 分层检索
为了支撑开放世界五花八门的日常物品,Diorama 整合了 ShapeNet、ABO、3D-FUTURE、HSSD 以及 Objaverse LVIS,构建了一个规模高达 60K+ 的跨源三维资产池。面对几万个模型,怎么为图里抠出来的局部物体 挑出最神似的 CAD 资产 ?
如果只用裁剪出来的物体小图去搜视觉相似度,当一张方方正正的“电脑显示器”被挡住底座时,它的二维轮廓跟一扇“正方形窗户”或“相框”几乎一模一样,纯视觉检索极易跨类别乱配;反过来,如果只按文本类别 "chair" 去搜,搜出来的可能是老板转椅,而图里明明是把木头餐椅。
为此,源码 duoduoclip.py 采用了基于多视图 3D 编码器 DuoDuoCLIP 的两级混合检索(Hierarchical Multimodal Retrieval):先用文本嵌入 与 3D 资产嵌入 的余弦相似度做 KNN 初筛(取 Top-50),锁死正确的语义大类;再叠加上物体裁剪图的视觉嵌入 做加权重排(取 Top-5):
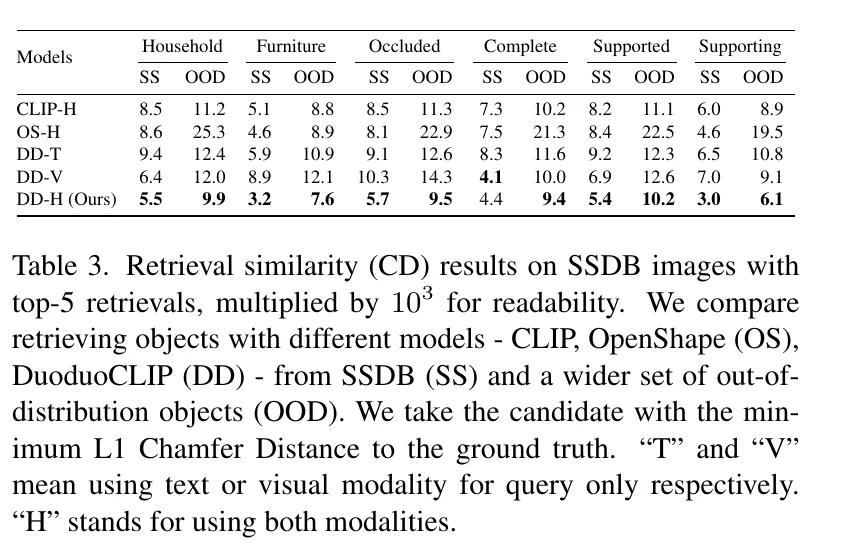
看 Table 3 在同源资产池(SS)与 60K 分布外资产池(OOD)上的几何倒角距离对比(Top-5 候选中与真值模型最小的 L1 Chamfer Distance ,越低代表搜出来的模型形状越接近实物):无论是对比纯 2D 的 CLIP 还是点云编码器 OpenShape,DuoDuoCLIP 的图文混合模式(DD-H)在日常小物件(Household:5.5 / 9.9)、大件家具(Furniture:3.2 / 7.6)以及核心承托物(Supporting:3.0 / 6.1)上全线拿下最低几何误差。
4.2 零样本 9-DoF 位姿估计:180 视图循环块匹配与尺度解耦
拿到了检索出的候选 CAD 模型,怎么在完全没训过目标域位姿回归器的情况下,把它摆进相机三维坐标系?
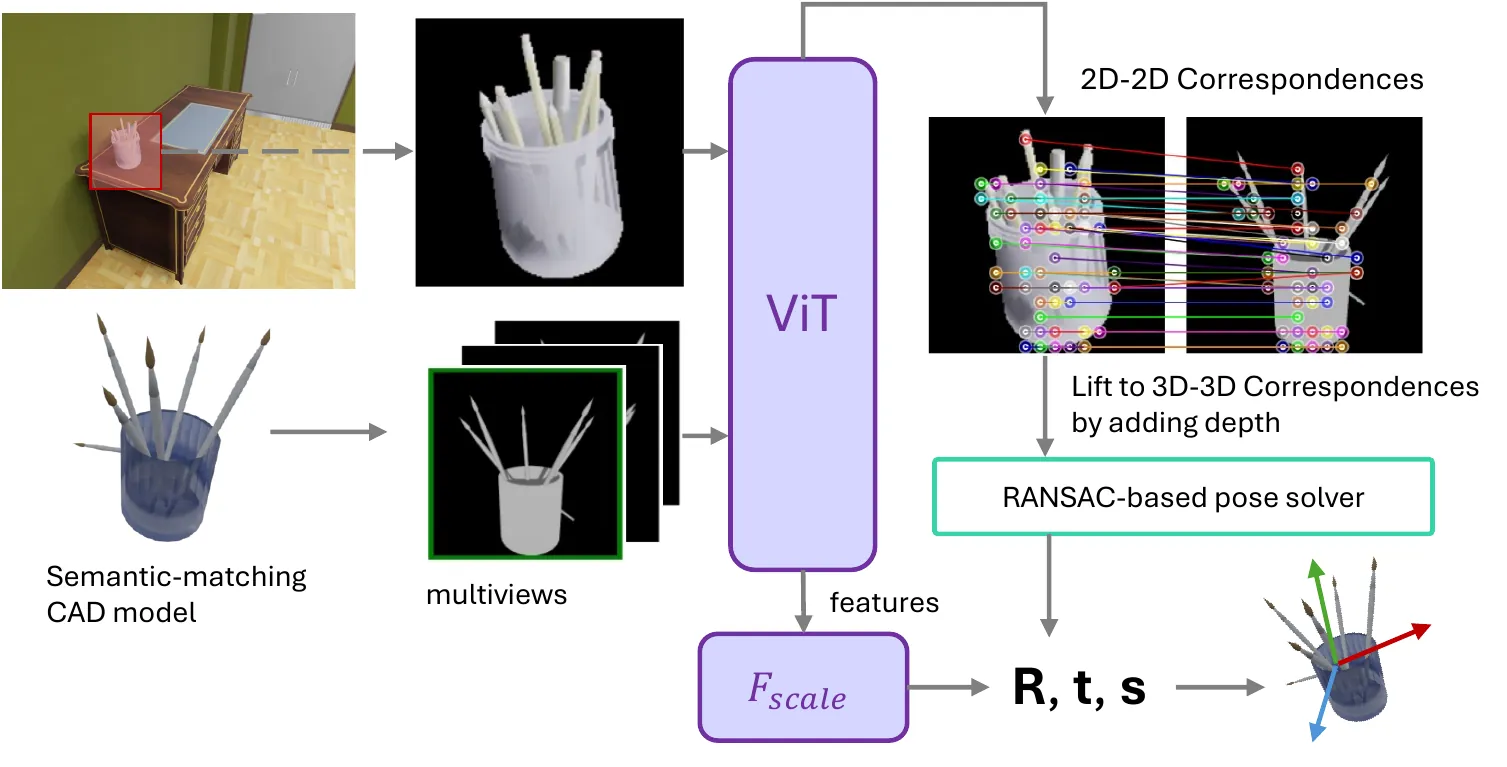
如 Fig. 4 所示,Diorama(对应源码 correspondence.py 与 gigazsp.py)利用微调后的 DINOv2 ViT-L(提取第 17 层的 稠密 Patch Token)在真实照片与无纹理 CAD 渲染图之间的部件同构性,分四步解算初始 9-DoF 位姿:
- 180 视图双向循环一致性匹配(Cyclic Patch Correspondence):系统预先为资产池里的每个 CAD 模型均匀渲染 个参考视图( 灰度图及对应深度图)。对于查询图掩码内的第 个块特征 ,先在某个参考视图掩码内找余弦相似度最高的块 ;再反过来从参考视图的块 出发,回头在查询图里找最相似的块 ,计算一去一回的循环偏移距离 : 如果从 跳到 再跳回来落到了十万八千里的地方( 很大),说明这是一次单向一厢情愿的错配,直接滤除!
- 最佳参考视角锁定:在通过了循环检验与相似度门限(源码配置为
0.5)的干净匹配集 上,计算查询图与 180 个参考视图的平均特征相似度,挑出得分最高的参考视图作为粗旋转视角,并截取前 对高置信度匹配点: - 三维反投影提升与 Umeyama-RANSAC 刚体配准:利用查询图的单目深度将 2D 匹配点提升为相机系三维点 ,利用参考视图的 CAD 渲染深度拿到模型系三维点 ,在 RANSAC 循环中调用经典的闭式 Umeyama 算法(
solve_umeyama_ransac())最小化三维对齐残差,解出旋转矩阵 、平移 与基础尺度 : - 为什么还要外挂一个 GigaPose 尺度网络? 这是一个极其关键的工程补丁:当图里的椅子被挡住一半、或者单目深度在物体边缘发生拖尾畸变时,仅靠稀疏匹配点云算出的尺度 极易忽大忽小。因此,系统在锁定最佳参考视图后,同步调用预训练的 GigaPose 尺度与面内旋转回归网络(
ist_net.py中的ISTNet),直接对比查询图与最佳参考视图的整体二维包络比例,修正三维尺度估计。
4.3 深度误差级联与多检索候选的兜底效应
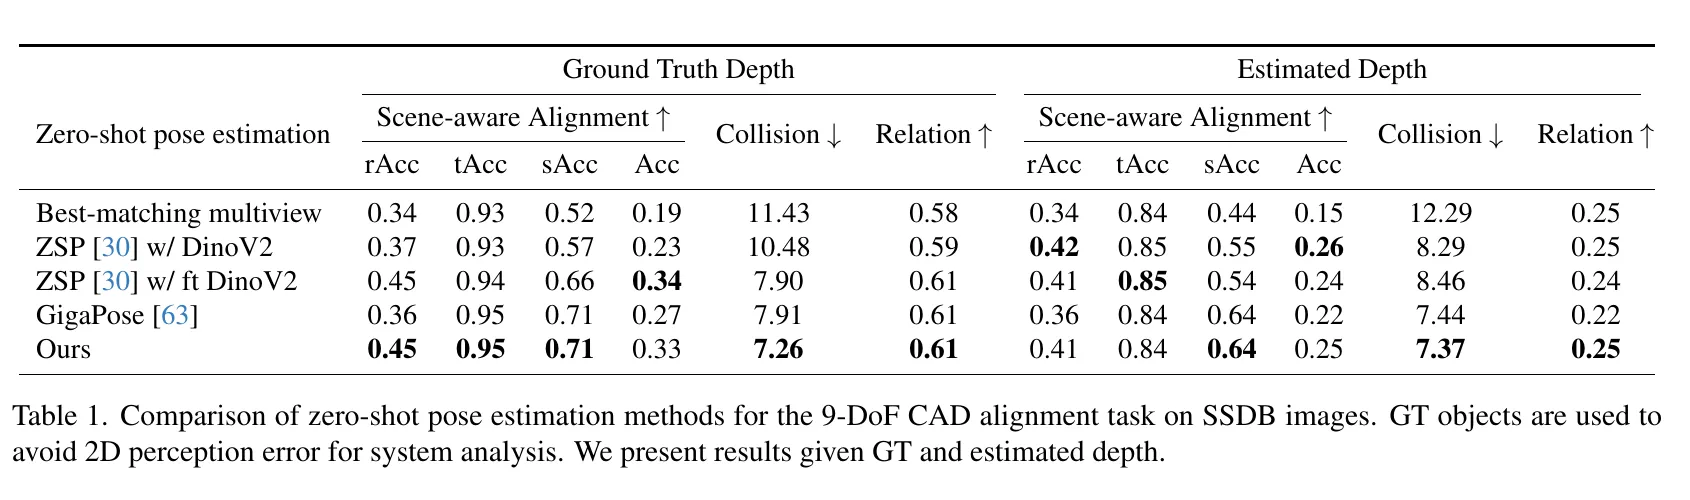
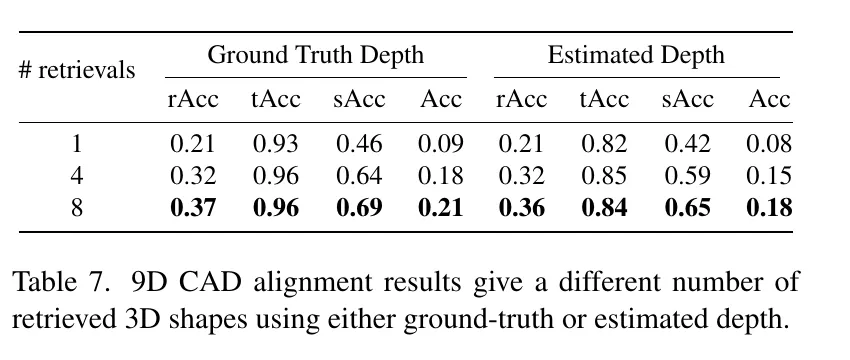
对照 Table 1 与 Table 7 的定量实验,我们可以读出三条关于单图位姿估计的核心规律:
- 特征微调管旋转,GigaPose 管尺度:在 Table 1 中,结合了微调 DINOv2 特征与 GigaPose 尺度网络的 Diorama,在真值深度(GT Depth)下同时拿到了最高的单项旋转准确率(rAcc
0.45)、平移准确率(tAcc0.95)和尺度准确率(sAcc0.71),且将场景级的物理支撑满足率(Support)推高到了0.61(远超未做布局优化的基线0.00)。 - 单目深度是卡住三维绝对位置的咽喉:注意看 Table 1 左右两半表的落差——当把真值深度(GT Depth)换成 Metric3DV2 预测的单目估计深度(Estimated Depth)后,虽然旋转准确率几乎没掉(
0.45 -> 0.41),但因为深度尺度的整体漂移,平移准确率从0.95掉到了0.84,联合对齐准确率从0.33降到了0.25,支撑关系准确率更是从0.61掉到了0.25。这直观说明单目深度的轻微非线性变形,在三维空间里会被放大为十几个厘米的位置错位。 - 多检索候选(Multi-Hypotheses)显著对冲“搜错模型”的风险:看 Table 7,如果每个物体只死磕检索排名第 1 的那个 CAD 模型(# Hypotheses = 1),一旦 Top-1 模型长宽比跟照片里的实物不对付,对齐准确率只有可怜的
0.09(估计深度下0.08);而当保留前 4 个或前 8 个检索候选(# Hypotheses = 4 / 8)并行跑位姿与装配时,准确率直接翻倍跃升至0.18与0.21(估计深度下0.15与0.18)!
5. 核心设计哲学四:为什么布局优化必须拆成四个阶段?
5.1 为什么 All-in-One 联合优化会彻底崩盘?
现在,每个物体都拿到了独立算出的初始 9-DoF 位姿,房间墙壁地板(PlainRecon)和支撑关系树(GPT-4o Scene Graph)也准备好了。但如果你把这些物体直接摆进三维空间,画面简直没法看:杯子悬在书桌上方 10 厘米,显示器底座插进了键盘里,书柜后背穿透了墙壁。
很自然的想法是:我们写一个总损失函数,把“接触面法线对齐”、“拉向支撑平面”、“禁止三维包围盒(OBB)互相穿模”加在一起,用梯度下降一起优化不就行了?
如果真的这样做(即 All-in-One 策略),你会发现优化器不仅消不掉穿模,反而会把整个房间的家具炸得乱七八糟!
为什么?想一想其中的几何梯度冲突就明白了:
- 在初始状态下,书桌上的笔记本电脑可能既是歪斜的(朝向没对齐),又和旁边的显示器发生了轻微交叠(穿模),同时还悬空在桌面上方。
- 基于分离轴定理(Separating Axis Theorem,SAT)计算的 3D OBB 碰撞穿透损失 是一个高度非光滑、分段线性的排斥力。如果此时同时放开旋转、高度平移与防碰撞排斥,碰撞梯度为了最快消除重叠,会顺着歪斜的斜面把笔记本电脑直接往天上顶、或者逼着它发生荒谬的 翻转;而电脑一旦被顶飞,又和“往下拉向桌面”的放置梯度迎头相撞,两股力量在非凸空间里死锁打架!
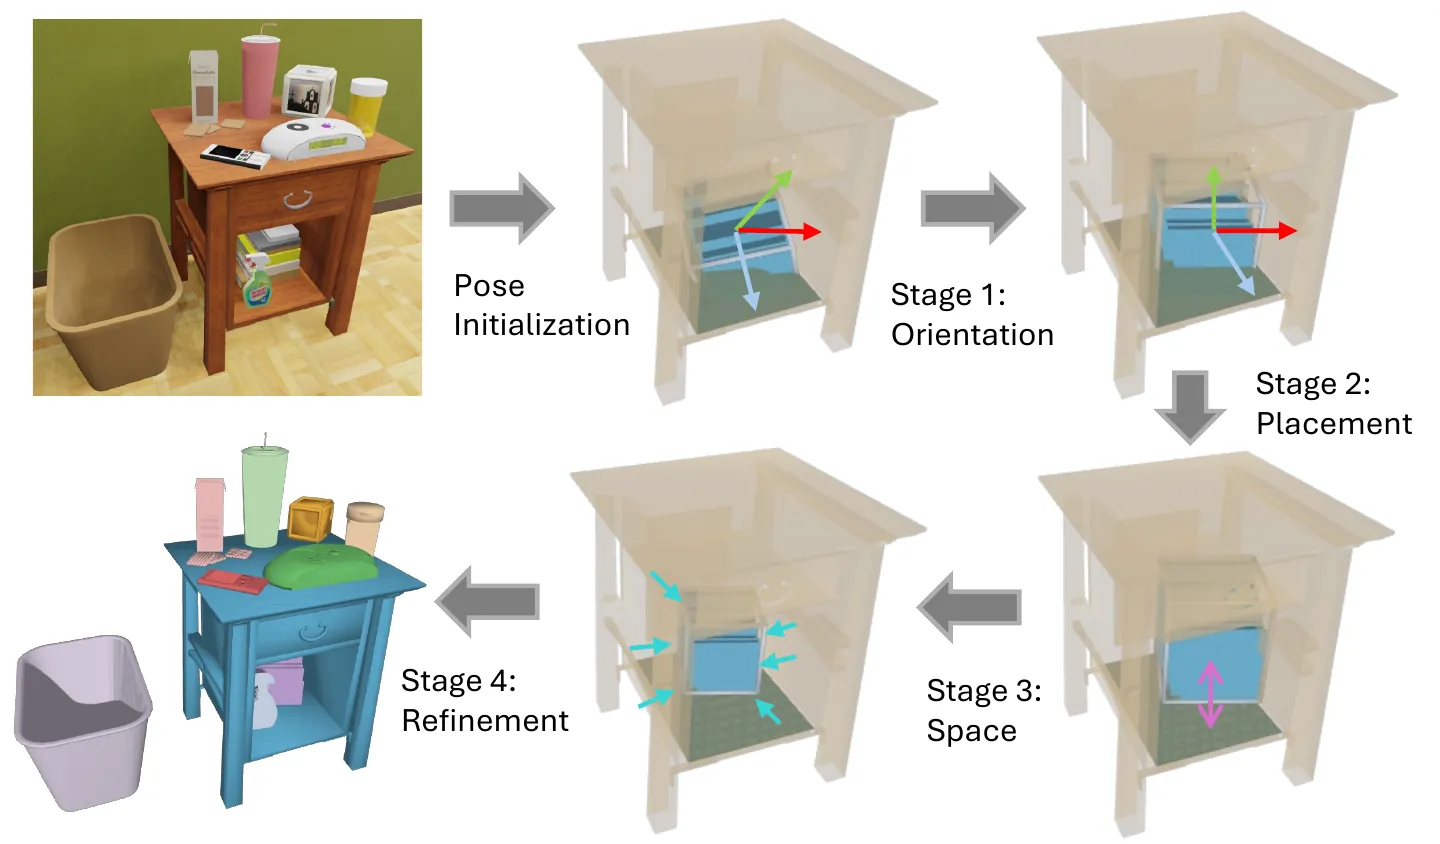
为了解开这个死锁,Diorama 在 diorama/model/layout_optim.py 中设计了 Fig. 5 所示的四阶段课程优化(Stage-wise Curriculum Optimization),在每个阶段通过 PyTorch 的 detach() 严格锁死无关自由度,按物理因果顺序一步一步理顺场景:
第一步:朝向阶段(Orientation Stage —— 先把歪斜的物体掰正)
在还没谈“落座”和“挤位置”之前,必须先把物体的底面(接触面)跟承托它的桌面或地面(支撑面)掰成平行!设场景图 中被支撑物 的接触面法线为 ,父节点支撑物 的支撑面法线为 ,朝向对齐损失强制二者同向平行;同时,为了防止物体在绕着法线轴自由打转时把正面转到背面去,加上一项约束优化后的水平正面朝向 不偏离初始预测朝向 的语义朝向保持损失:
第二步:放置阶段(Placement Stage —— 垂直拉向支撑面,锁住水平相对排布)
物体全部摆正之后,第二步专门消灭“悬空”和“陷入地下”。设物体 接触面的中心为 ,父节点支撑平面 的法线为 、平面上参考点为 ,放置损失 直接把点到平面的垂直距离压向零;与此同时,为了防止同一张书桌上的显示器、键盘和马克杯在移动时乱了原本的左右前后队形,引入成对相对位移保持项 :
第三步:空间阶段(Space Stage —— 在支撑面内推开穿模,严禁出界)
当所有物体都端端正正落到了各自的支撑平面上后,原本悬空交错的物体被拍进了同一个平面层,局部穿模(Collision)此时会集中暴露出来。现在再开启空间排斥损失 ,梯度就只会顺着支撑平面干净利落地把重叠物体向两侧推开:
看这四项的精密配合:
- 基于三维分离轴定理(SAT)计算任意两个 OBB 之间、以及 OBB 与房间墙壁之间的最小穿透深度并把它们推开;
- 但如果只管推开,桌边的水杯很容易被一把推到桌子外面悬空!所以紧跟着 (源码
support_space_loss())专门惩罚超出父节点支撑面二维多边形边界的部分,把水杯死死圈在桌面范围内; - 而对于塞在书架隔板或开放式柜子里面的书本,(源码
support_volume_loss())则构建三维容纳体积约束,严禁柜内物品穿出隔板顶面或侧面。
第四步:精修阶段(Refinement Stage —— 回补接触面与大型家具贴墙粘附)
在第三步推开穿模物体并微调三轴尺度的过程中,部分物体的底面可能会因为尺度缩放而再次轻微脱离支撑面。因此第四步回炉重跑一次放置约束,并额外引入一项非常符合室内设计常识的启发式规则——贴墙粘附(Wall Adherence):凡是离墙面足够近且朝向背对墙壁的落地大件家具(如书柜、床头、衣柜、电视柜),自动将其背面吸附贴紧相邻墙面。四个阶段统一使用带动量的 SGD(动量 0.9,平移/旋转学习率 0.01,尺度学习率 0.001,每阶段跑 200 步且每 50 步衰减 0.1)。
5.2 阶段消融与“先碰撞上升、再全局收敛”的非单调博弈
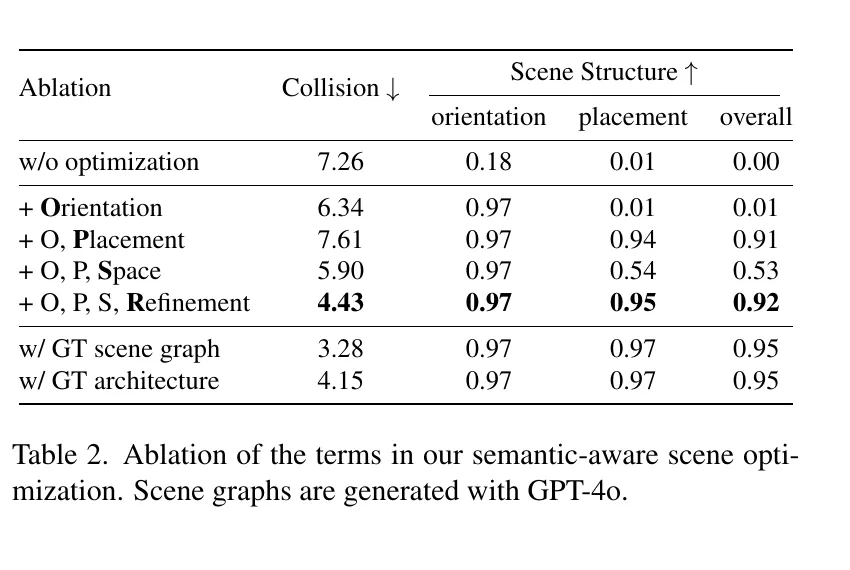
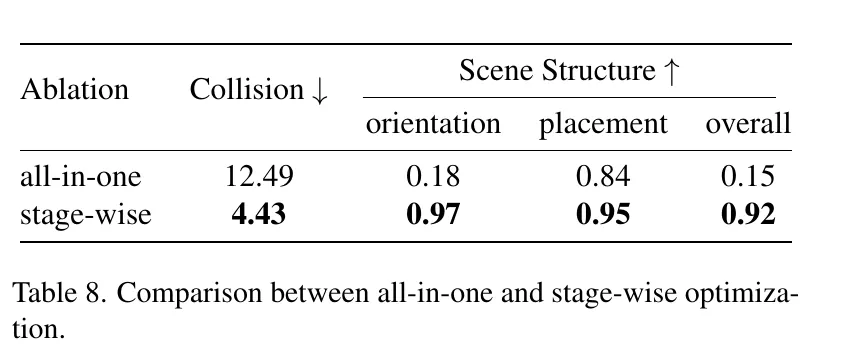
对照 Table 2 与 Table 8 的实验数据,前面分析的物理博弈过程在数字上得到了教科书般的印证:
- 为什么单加 Placement 时碰撞反而变多了? 看 Table 2 前三行:未优化初值(w/o optim)的碰撞指标为
7.26,加上 Orientation 掰正后降为6.34;可紧接着加上 Placement 把悬空物体全部拍回桌面和地面后,因为原本在半空中错开的物体挤到了同一层平面上,碰撞指标短暂反弹到了7.61,而放置合格率则从0.01暴涨到0.94! - 为什么加上 Space 后放置率又掉了一截,非要 Refinement 不可? 看第四行(
+ O, P, S):Space 阶段发力推开重叠物体并微调尺度后,碰撞降到了5.90,但因为尺度收缩导致底面离开桌面,Placement 合格率从0.94滑落到了0.54;直到最后接上第四步 Refinement 重新压实接触面并贴合墙壁,才让 Collision 降到全场最低的4.43,同时 Orientation 达0.97、Placement 达0.95、综合合格率 Overall 飙升至0.92! - All-in-One 的惨败:再看 Table 8,如果把这几项损失一股脑全开(All-in-One),碰撞直接恶化到
12.49(比完全不优化的7.26还糟一倍),综合合格率更是只有0.15。这充分证明在包含非光滑几何碰撞与层级拓扑约束的优化问题中,分阶段解耦课程(Stage-wise Curriculum)是决定收敛生死的胜负手。
6. 全方位实验验证:从密集小物件、ScanNet 到野生图像与交互编辑
6.1 场景感知对齐指标与 SSDB 多假设重建
传统的单物体对齐评测只看每个物体自己跟真值位姿差多少(平移 、旋转 、尺度 )。但在真实房间里,如果书桌和桌上的电脑同时往左偏了 25 厘米,按传统指标算它俩全错,可实际上电脑依然稳稳摆在书桌正中央,场景内部结构完全合理!反之,如果书桌往左偏 12 厘米、电脑往右偏 12 厘米,虽然各自都没超 20 厘米,但电脑已经悬空掉出桌外了。
为此,作者专门定义了场景感知对齐指标(Scene-aware Alignment):一个物体要想被判为对齐成功,除了自身位姿达标外,它相对于场景中所有其他物体 的相对位移、相对旋转与相对尺度误差也必须同时满足容差:
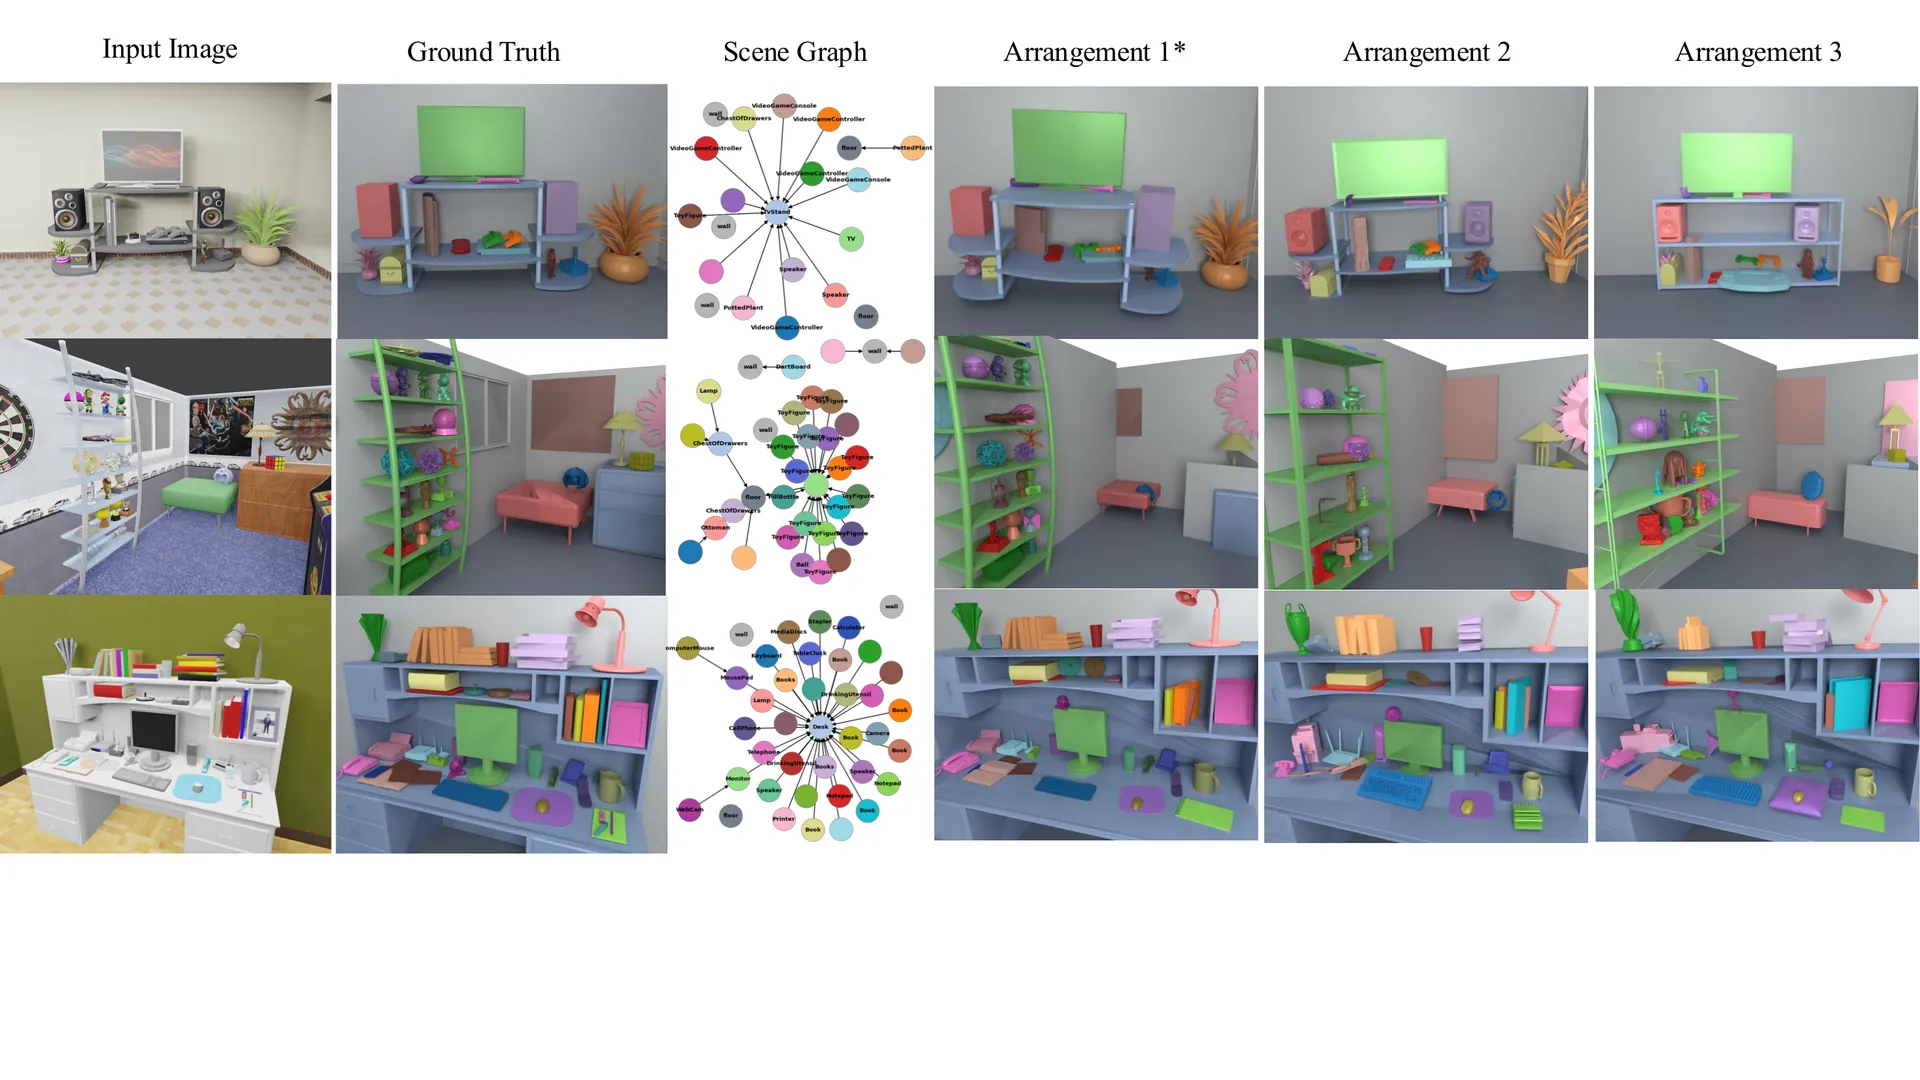
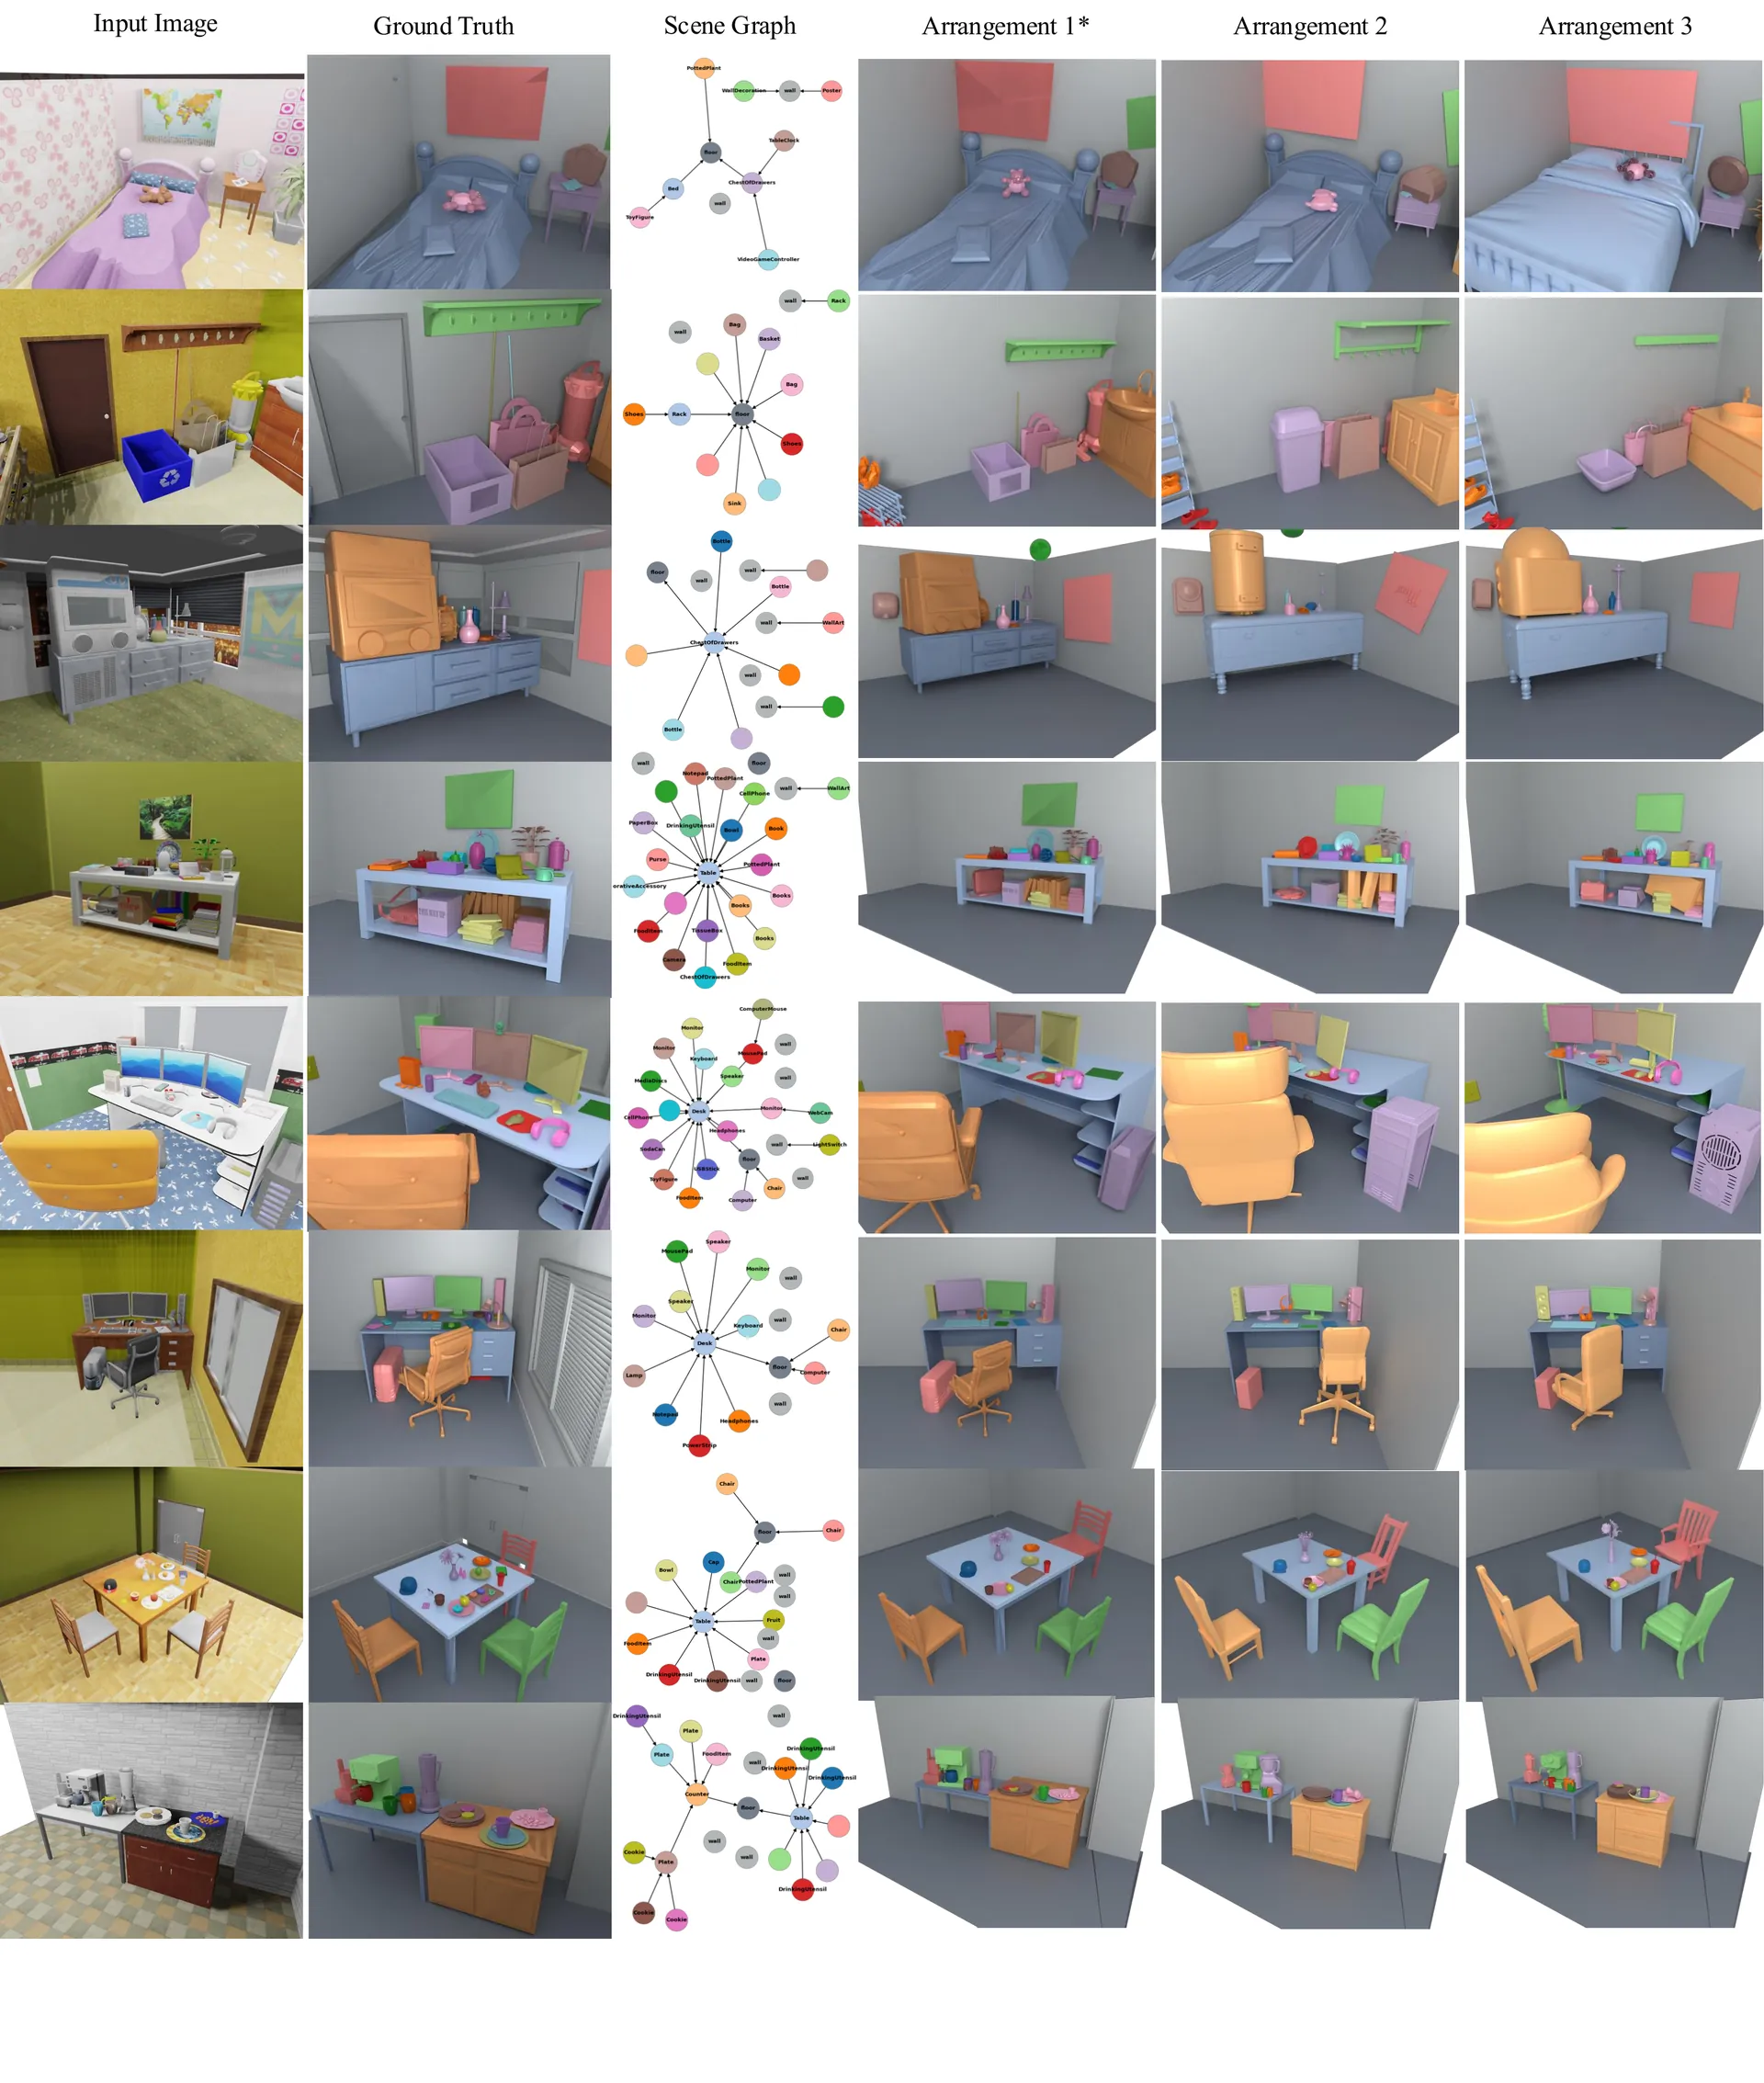
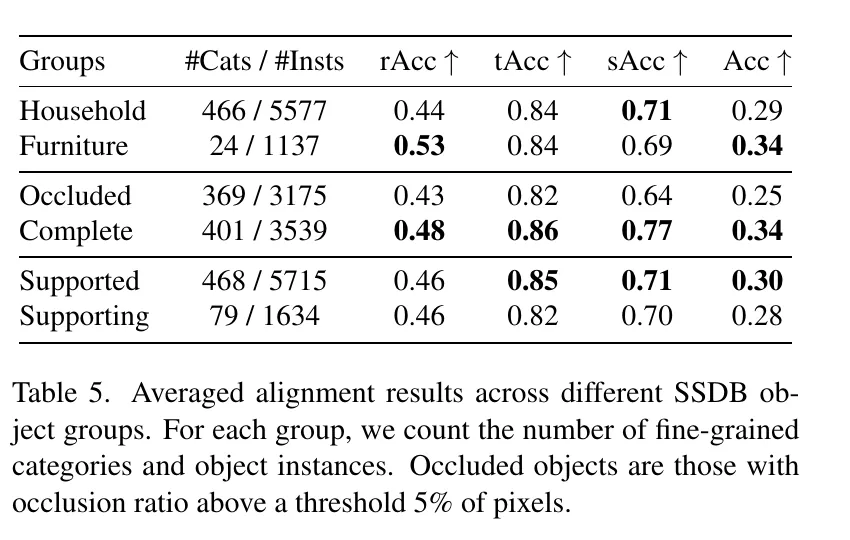
看 Fig. 6 与 Fig. 14 在 SSDB 密集场景(单图包含多达二三十个大小物体,如堆满杂物的书架、书桌与厨房台面)上的表现:图中不仅展示了 GPT-4o 推理出的多层支撑树,还并列给出了使用不同检索候选生成的 Arrangement 1 / 2 / 3。哪怕换用了局部款式略有不同的替代书架或茶几 CAD 模型,分阶段布局优化器依然能把上层的花瓶、书本和显示器严丝合缝地重新安顿在新的支撑面上。而 Table 5 按物体属性拆解的数据也符合直觉:完整可见物体(Complete,Acc 0.34)显著好于重度遮挡物体(Occluded,Acc 0.25),结构特征鲜明的大件家具在旋转估计上(Furniture,rAcc 0.53)明显高于细碎的日常小物件(Household,rAcc 0.44)。
6.2 ScanNet 真实场景对比:封闭域强监督 vs 开放世界零样本
当把零样本的 Diorama 拉到传统室内基准 ScanNet(结合 Scan2CAD 标注)上,跟在 ScanNet 训练集上做过端到端全监督训练的 ROCA 以及概率扩散方法 DiffCAD 同台竞技时,会出现怎样的格局?
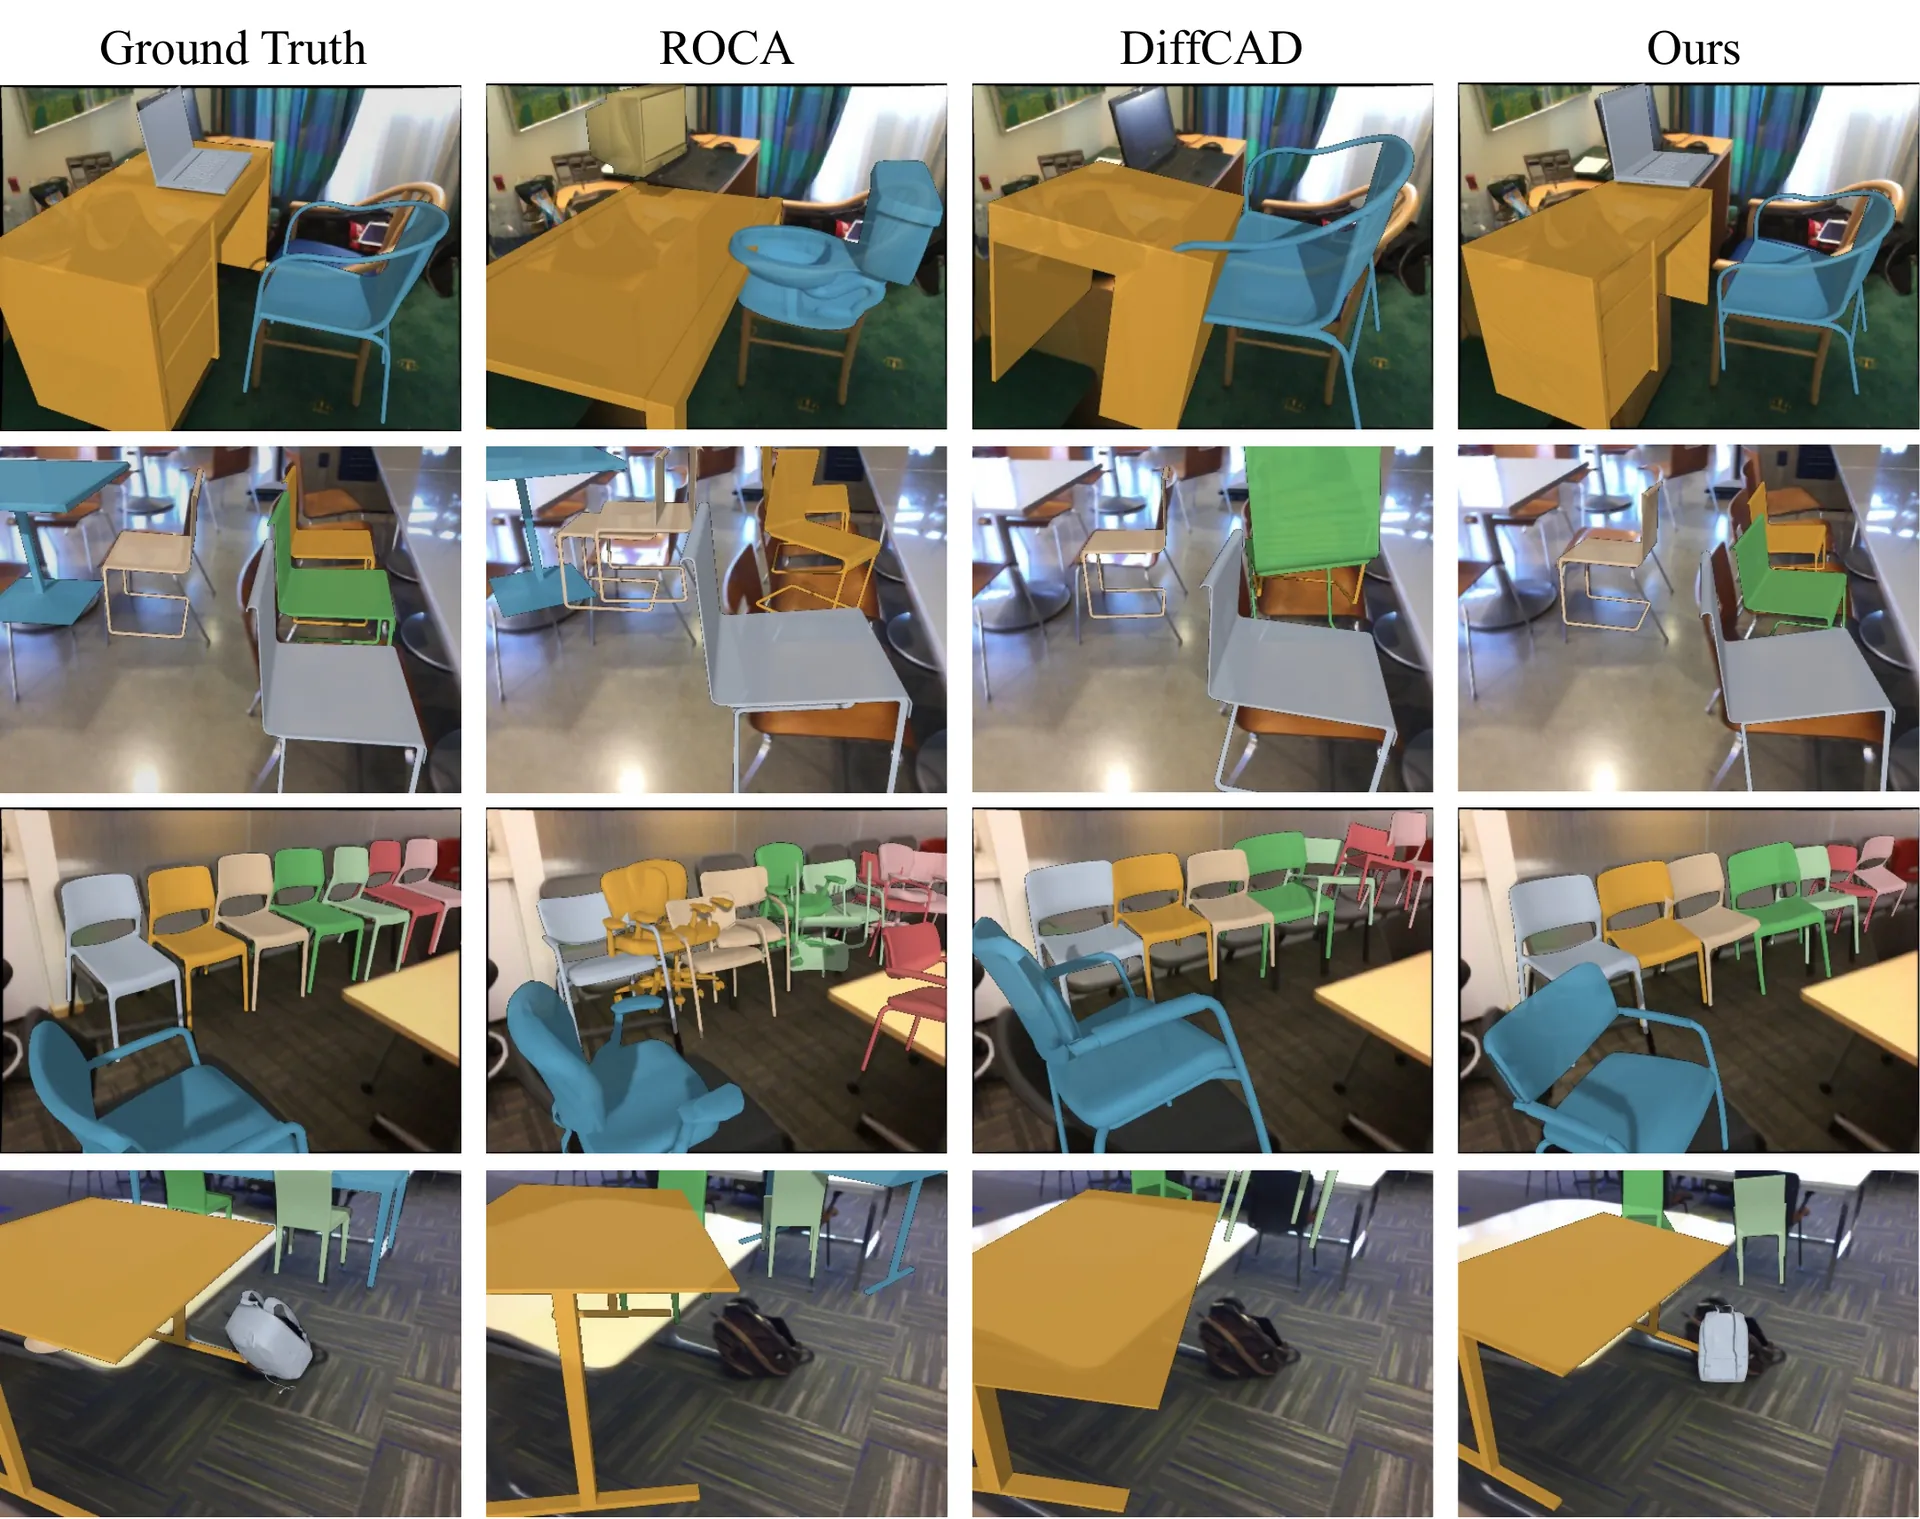
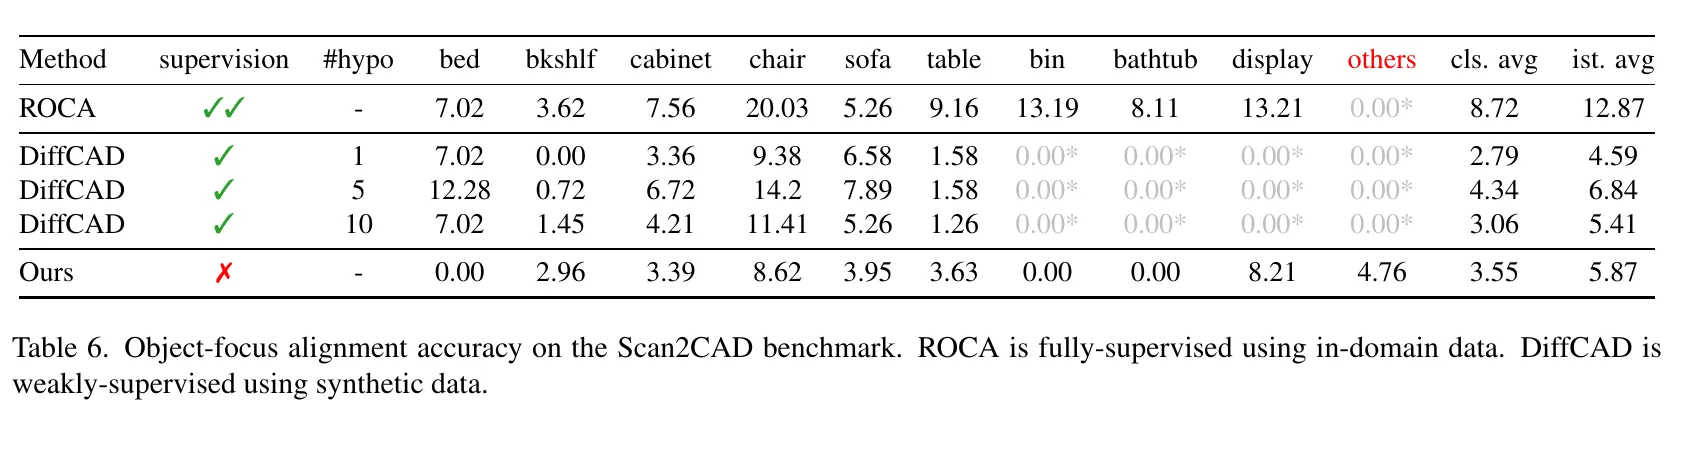
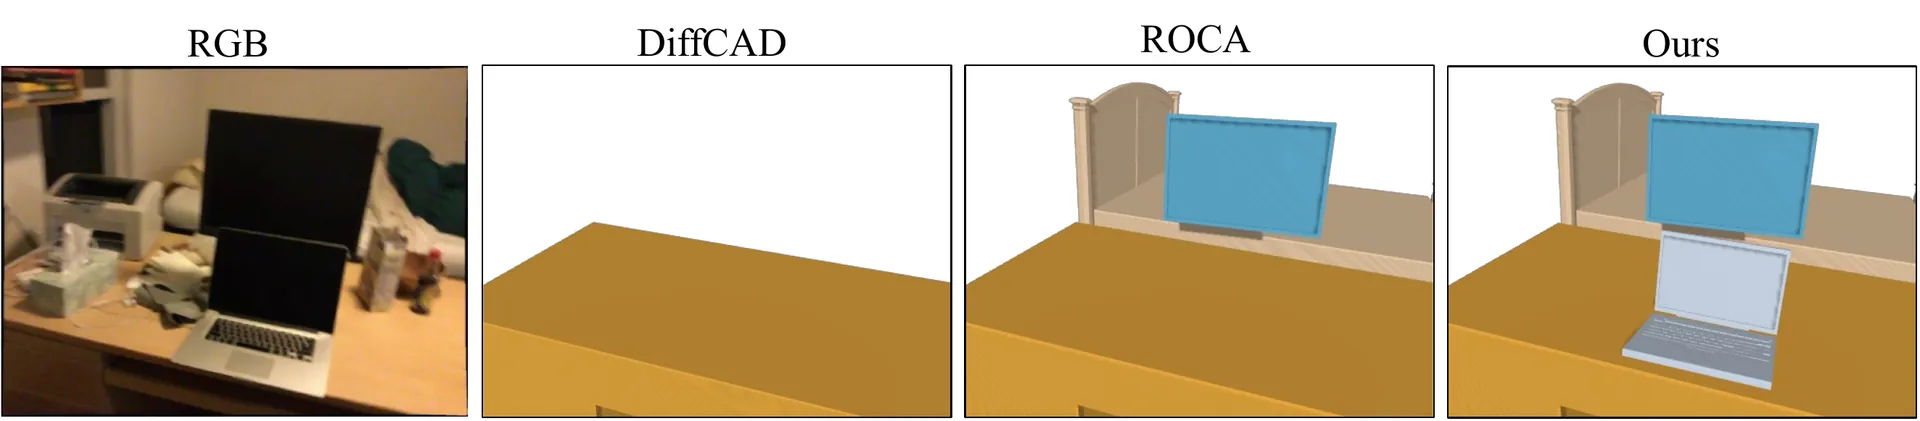
把 Fig. 7、Table 6 与 Fig. 13 对照起来看,非常客观地揭示了“域内强监督专家”与“开放世界零样本通才”之间的真实权衡:
- 在传统封闭大件家具上,域内强监督依然占优:在 Table 6 统计的浴缸、床、垃圾桶、沙发等 9 类常见家具上,背熟了 ScanNet 相机分布与资产库先验的全监督模型 ROCA 拿到了
8.72 / 12.87的类别/实例平均准确率,高于零样本无训练的 Diorama(3.55 / 5.87)。这很大程度上是因为真实 ScanNet 视频帧存在严重的运动模糊与残缺视角,原生 DINOv2 零样本块匹配在模糊大家具上的鲁棒性不如专门在大规模 NOC 数据集上微调过的几何特征(这也正是本系列精读的后续工作 SUFLECA 重点攻克并大幅反超全监督方法的突破口!)。 - 在开放世界小物体与空间物理合理性上,Diorama 降维打击:看 Table 6 的
others(开放长尾类别)一列,受限于封闭分类头的 ROCA 与 DiffCAD 直接交了白卷(-),而 Diorama 稳稳拿下了4.76;再看 Fig. 7 的定性渲染,ROCA 和 DiffCAD 不仅彻底漏掉了办公桌上的两台显示器、键盘和地面杂物,而且预测出的办公椅横七竖八地插在桌子里面;Diorama 则凭借场景图与四阶段优化,把椅子、桌子与桌面双显示器整理得井井有条。
6.3 互联网野生照片、文本生场景与对象级交互编辑
脱离了学术数据集的温室,Diorama 在完全未知相机内参的互联网真实照片(Pixabay / Pexels / Unsplash)以及文生图流水线上表现如何?
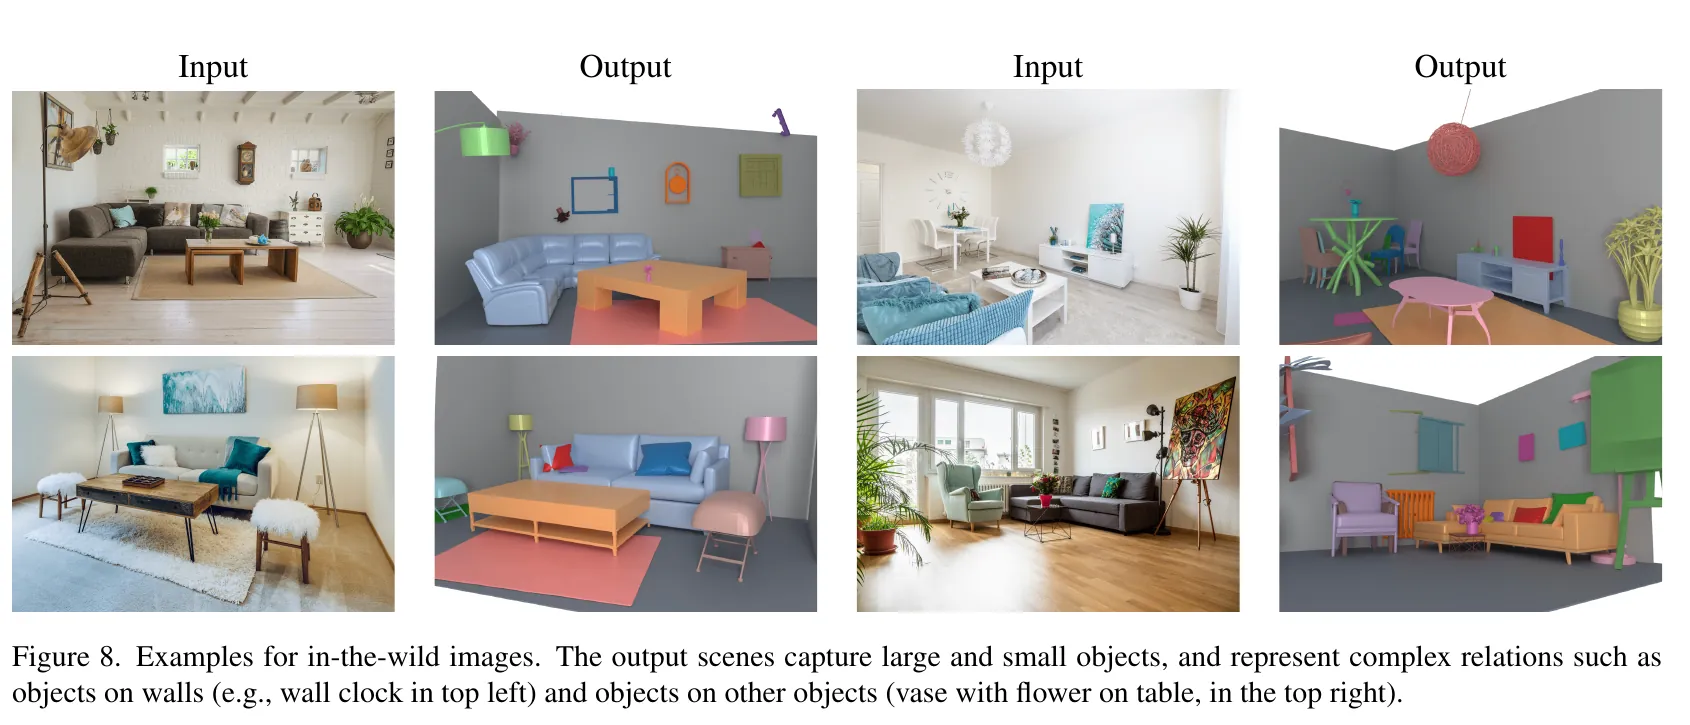
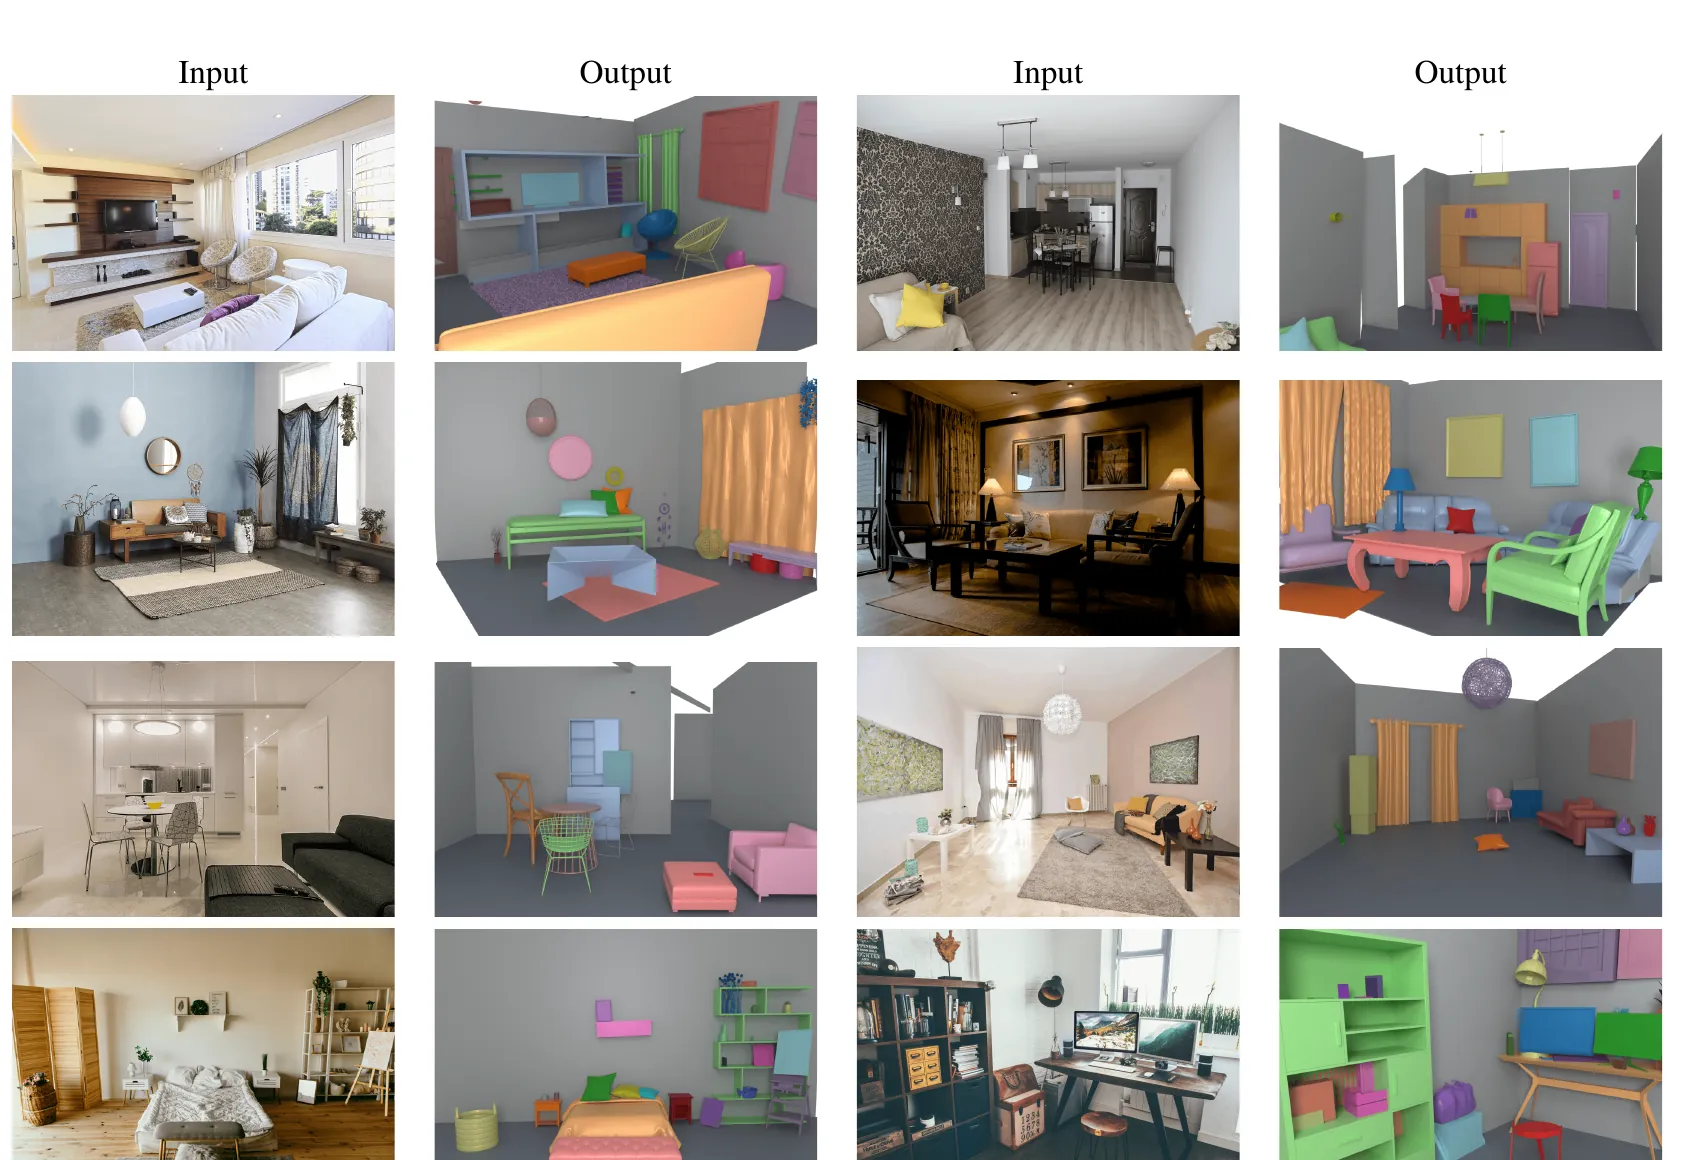
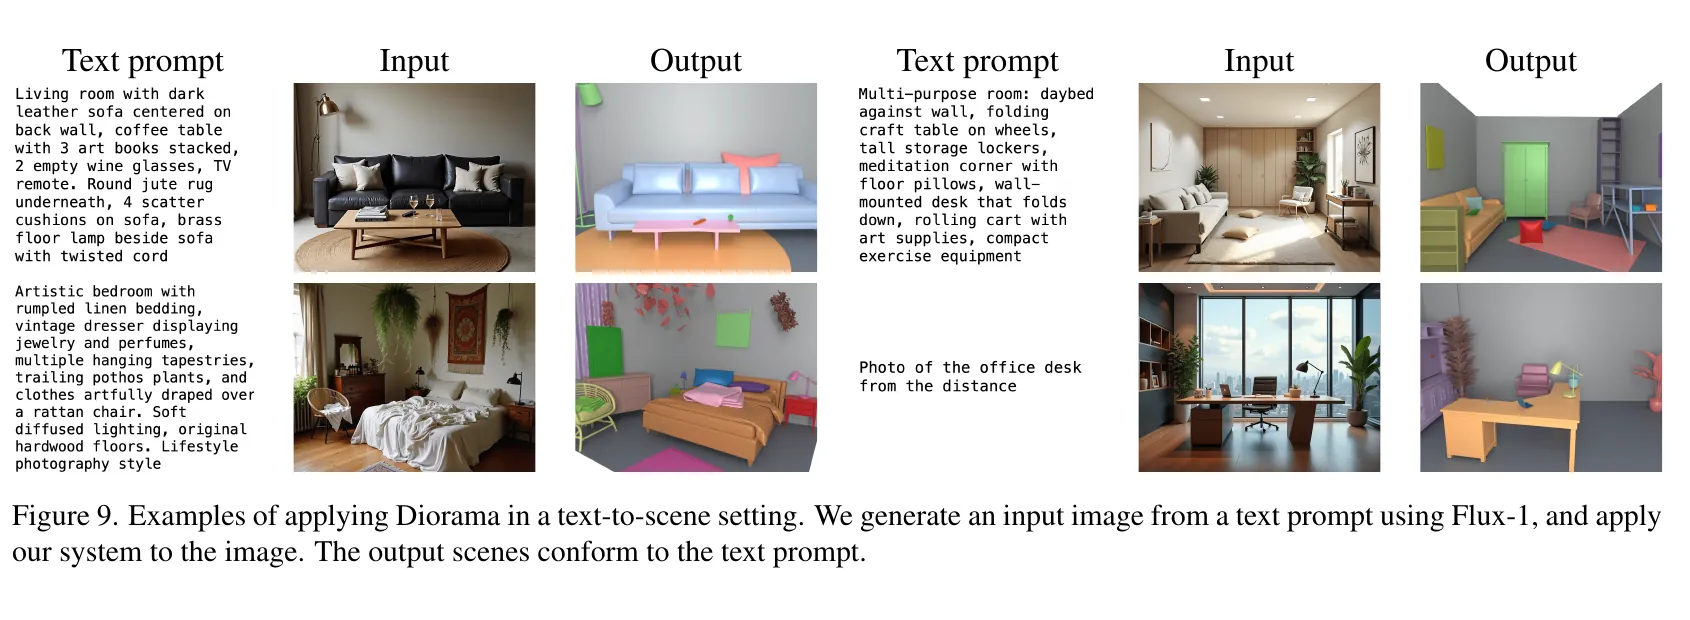
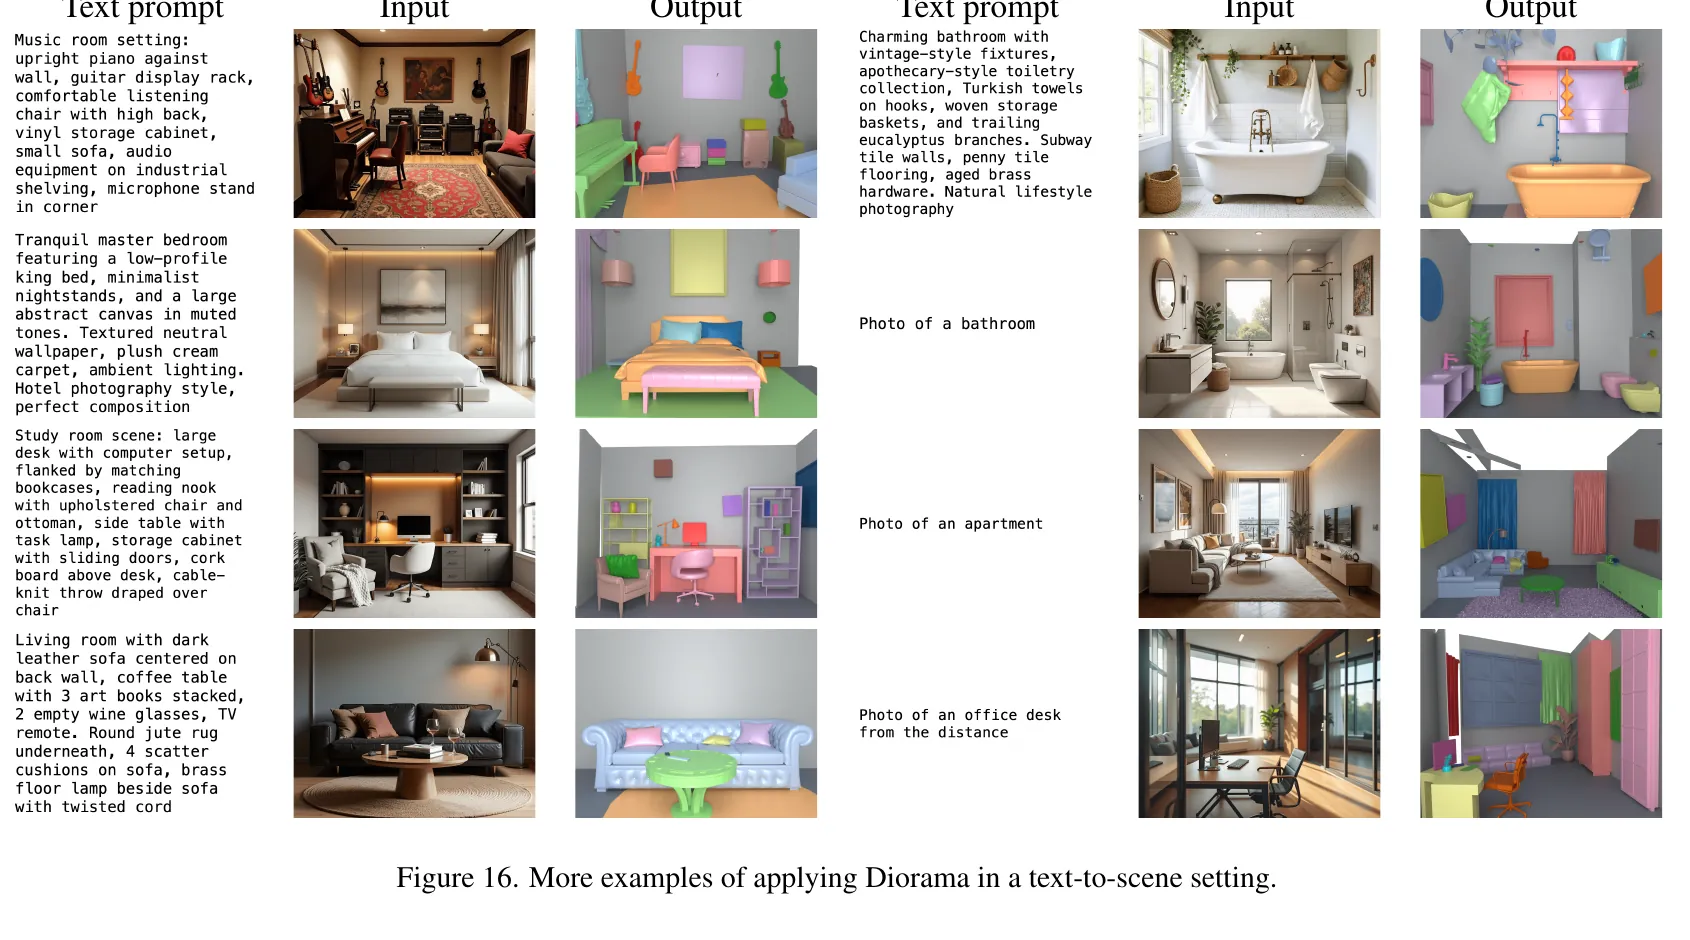
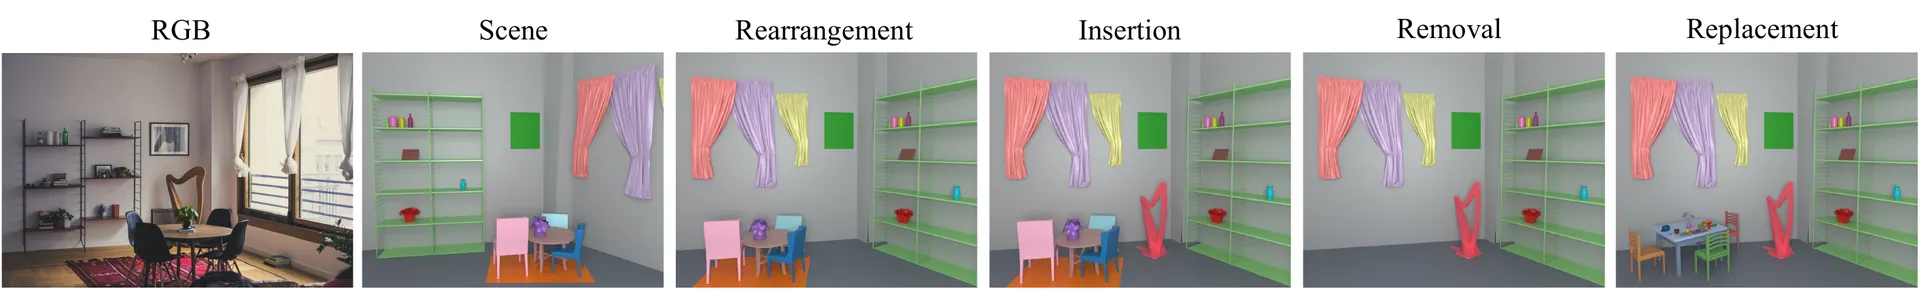
看上面这一组丰富的实测展示(Fig. 8、Fig. 15、Fig. 9、Fig. 16 与 Fig. 11):
- 野生照片与文生图桥接(Fig. 8/15 & Fig. 9/16):无论是互联网上的高清家居摄影,还是先用文本提示驱动 Flux-1 生成一张二维室内概念图、再交给 Diorama 转化为三维场景,系统都能把墙上的多幅装饰画、窗帘、桌面绿植、架子鼓乃至复杂的L型沙发准确拆解还原为三维 CAD 资产组合。这为 Text-to-3D Scene 提供了一条极其实用的捷径:先把最难的审美构图与风格想象交给极其成熟的 2D 扩散大模型(Flux-1),再用 Diorama 把生成的 2D 图纸“编译”成结构化的 3D CAD 场景!
- 牵一发而动全身的支撑树联动编辑(Fig. 11):因为输出的是带支撑树的独立 CAD 资产,用户在后续编辑时,如果拖动或替换了底下的大书桌,场景图里挂在书桌节点下的显示器、书本和台灯可以顺着支撑关系自动跟着一起平移或自适应贴合新桌面,彻底告别了传统网格重建“牵一发而破全身”的窘境。
7. 源码架构深挖与三维坐标系变换避坑指南
7.1 分阶段缓存的源码主干设计
走进官方开源仓库(基线提交 ec54d826),你会发现作者并没有把所有模型塞进一个大脚本里硬跑——因为同时把 OWLv2、SAM 2.1、Metric3DV2、DINOv2-L、DuoDuoCLIP 全加载进一张显卡,显存当场就会爆炸。
源码通过 run.py 与 Hydra 配置文件 config/cfg_wss.yaml 将全流程设计为按阶段懒加载与落盘缓存的架构:
| 阶段模块 | 核心源码文件 | 关键函数与工程容错细节 |
|---|---|---|
| 1. 场景图与 VLM 代理 | diorama/vlm_agent.py | understand_scene()、generate_scene_graph_from_augment();配置 n_trials: 6 自动重试机制,一旦 GPT-4o 返回的 JSON 格式或节点 ID 校验不合法自动重发 |
| 2. 开放词汇感知与点云裁剪 | diorama/vis_agent.py | detect_objects_w_owlv2()、segment_objects()(支持升级版 SAM2.1 Hiera Large)、segment_object_crops_and_pcd()、augment_image_w_marks() |
| 3. PlainRecon 空房平面恢复 | diorama/utils/arch_util.pyscripts/compute_plane_segmentation.py | 独立预处理脚本串联前景分割、Inpaint-Anything 修复、Metric3DV2 反投影、12 种子法线聚类、DBSCAN 与旋转卡壳多边形边界提取 |
| 4. 多模态分层检索 | diorama/model/duoduoclip/duoduoclip.py | 利用预计算的 FAISS 索引执行文本 KNN Top-50 初筛 + 视觉裁剪图 Top-5 重排 |
| 5. 零样本 9-DoF 位姿估计 | diorama/model/gigazsp/correspondence.pydiorama/model/gigazsp/gigazsp.py | dinov2_vitl14(Layer 17,块相似度门限在配置中放宽至 0.5 以提升召回)、180 视图循环匹配取 Top-50 点对、solve_umeyama_ransac() + ISTNet 尺度回归 |
| 6. 四阶段 OBB 布局优化 | diorama/model/layout_optim.py | 基于 SceneSpec 支撑面,串联 place_on_loss()、support_space_loss()、support_volume_loss() 与 SAT OBB 防碰撞算子 |
7.2 极易踩坑的三维坐标系与矩阵乘法次序契约
在把多源视觉模型与多源 CAD 资产库(Objaverse、3D-FUTURE、ABO、ShapeNet)拼成一条三维管线时,90% 的诡异 Bug 都出在坐标系约定与仿射变换顺序上。细读源码,有三条铁律必须在工程实现中严格锁死:
- 9-DoF 变换的矩阵乘法顺序(先缩放、再旋转、最后平移): 对于 CAD 规范空间下的点 ,当存在各向异性三轴缩放对角矩阵 与正交旋转矩阵 时,转换到世界坐标 的顺序必须是先在物体自身主轴下做缩放 ,再左乘旋转矩阵 ,最后加上平移 : 一旦不小心写反成 ,当物体旋转了 后再沿世界坐标轴做非均匀拉伸,原本方正的书桌三维包围盒(OBB)就会发生严重的剪切形变(Shear Distortion),变成斜平行四边形!
- 跨源 CAD 资产的规范朝向对齐(Canonical Up & Front):
不同 3D 数据集的原始模型坐标系五花八门(有的以 为上、有的以 为上;有的正面朝 、有的朝 ;有的原点在几何中心、有的在底面中心)。如果不预先把所有入库资产统一归一化并标定好标准的
canonical_up与canonical_front,第一阶段的语义朝向保持损失 就会拿着错误的正面方向去锁死物体,导致所有椅子统统面朝墙壁。 - 接触面与支撑面法线的同向约定: 在计算朝向对齐损失 时,注意中间是减号!这意味着源码约定被支撑物体底部的“接触面法线” 与下方桌面顶部的“支撑面法线” 必须方向相同(例如统一定义为竖直向上指离支撑表面),千万不能按照封闭网格外法线惯例把物体底面法线设成朝下(否则减号就会逼着杯子底朝天倒扣在桌面上)。
8. 系统瓶颈复盘与三维视觉版图横向坐标
8.1 长链路系统的真实工程边界
客观审视 Diorama 的实验表现与模块化设计,它在展现强大开放世界组装能力的同时,也清晰暴露了长管线系统的固有边界:
- 长链路级联误差(Cascading Errors):从 OWLv2 检测、SAM 2.1 分割、Metric3DV2 深度、PlainRecon 墙面、GPT-4o 支撑边到 DuoDuoCLIP 检索与 DINOv2 位姿,整条管线长达六七个环节。如果上游 Metric3DV2 把远处的地面深度估偏了 20%,或者 GPT-4o 把“挂在墙上的电视”误判成了“立在电视柜上”,下游的布局优化器就会忠实地按照错误的父子关系把电视强行往下拉到电视柜表面。
- 检索式 CAD 表示的“形似而非真身”:用检索出的现成 CAD 模型替代原图物体,虽然换来了干净完整的 3D 网格,但搜出来的沙发在布料褶皱、抱枕花纹和扶手弧度上毕竟跟照片里的实物存在差异,无法满足文物数字化或高精度工业数字孪生对像素级一致性的要求。
- “免训练”背后的重型推理栈:虽然不需要在目标场景上做端到端训练,但跑通一次完整推理需要依次加载七八个视觉大模型、遍历 180 张参考渲染图算块匹配,还要调商业 GPT-4o API,冷启动与单图计算开销依然不轻。
8.2 在 3D 场景建模与生成版图中的位置
如果把 Diorama 放进本站精读过的整个三维视觉技术版图中,你会看到一条非常精彩的互补与进化脉络:
| 系统 / 论文 | 核心任务与输入 | 场景表示与核心机制 | 与 Diorama 的生态互补关系 |
|---|---|---|---|
| Diorama | 单张野生室内图恢复可编辑 3D CAD 场景 | 有界建筑平面(PlainRecon)+ 开放词汇 CAD 检索 + DINOv2 180 视图配准 + 四阶段支撑树布局优化 | 构建了完整的单图开放世界场景拆解与分阶段防穿模装配框架,但单物体原生 DINOv2 配准在模糊真实图上精度有限 |
| SUFLECA | 单图零样本高精度 9D CAD 位姿对齐 | 12 数据集 NOC 弱监督 DPT 特征 + 6 视角缓存 + 双向 Top- + 消去旋转的各向异性谱图共识 + SupeRANSAC | Diorama 最完美的位姿内核升级件:在 ScanNet25k 上,Diorama 的原生 DINOv2 位姿模块仅得 8.7% / 11.3%,而 SUFLECA 以 0.53s 耗时直接飙升至 33.4% / 42.3%,可直接无缝替换 Diorama 的第 5 阶段位姿估计器! |
| TRELLIS.2 / AssetGen / TripoSG | 单图生成高保真 3D 网格与 PBR 资产 | 结构化稀疏体素潜在空间(O-Voxel)/ SDF 前馈生成高质量独立网格 | Diorama 的资产兜底生成器:当遇到造型奇特的定制家具导致 DuoDuoCLIP 检索相似度过低时,可直接调单图 3D 生成模型现场捏一个专属网格放进 Diorama 的布局优化器里 |
| CompoNeRF / Layout2Scene | 3D 布局与文本引导生成神经渲染场景 | 多局部 NeRF / 前景 2D Gaussians + 背景多边形 + 扩散先验蒸馏(SDS / GSDS / ISD) | 面向无参考图纯生成场景,输出神经场或高斯图元;而 Diorama 面向单图逆向解析,输出拓扑干净的标准工业 CAD 网格 |
| Blended-NeRF | 已有 NeRF 场景中的局部 3D ROI 编辑 | 双分支辐射场采样点级距离平滑与激活内外密度混合 | 在隐式辐射场内部做局部增删改;而在 Diorama 生成的显式 CAD 场景中,增删改物体只需直接修改 SceneSpec 的节点与变换矩阵 |
总而言之,Diorama 最令人赞赏的工程贡献,在于它跳出了“单图端到端黑盒重建”的传统套路,用一套极其务实的系统分治哲学——“先擦除家具恢复非曼哈顿空房、用 Set-of-Mark 让大模型搭支撑树、靠多模态检索与块匹配给初值、用四阶段课程优化解耦朝向与碰撞”——把散落在各个领域的视觉基础模型拧成了一股绳。对于任何致力于构建开放世界三维场景理解、机器人室内环境仿真或智能家装三维重建系统的团队而言,这套模块化架构与分阶段课程优化思想都提供了极具价值的工程范本。
参考资料
- Qirui Wu, Denys Iliash, Daniel Ritchie, Manolis Savva, Angel X. Chang, Diorama: Unleashing Zero-shot Single-view 3D Scene Modeling, arXiv:2411.19492v1(ICCV 2025 Highlight: Diorama: Unleashing Zero-shot Single-view 3D Indoor Scene Modeling).
- 官方项目页:3dlg-hcvc.github.io/diorama;官方开源仓库:3dlg-hcvc/diorama(源码分析基线
ec54d826). - 相关核心文献:Scan2CAD (CVPR 2019)、ROCA (CVPR 2022)、DiffCAD (SIGGRAPH Asia 2023)、Set-of-Mark (arXiv 2023)、Metric3D v2 (TPAMI 2024)、DuoDuoCLIP (arXiv 2024)、GigaPose (CVPR 2024).
comments