用 2D 扩散模型通过分数蒸馏采样(Score Distillation Sampling,SDS)生成单个 3D 物体时,输入一句 "a red apple",神经辐射场(NeRF)往往能顺利收敛出一个红苹果。可一旦把提示词换成多物体场景——比如 "a red apple and a yellow banana",或者 "glasses of wine, salad and french bread on a wooden table"——整个三维优化过程就会迅速失控:原本该生成两个独立物体的地方长出了一个红黄相间的畸形混合体,沙拉和法棍融化在了木桌表面,甚至多个核心物体直接人间蒸发。
为什么在 2D 图像生成里早已司空见惯的多物体组合,一搬到 3D NeRF 优化里就会引发灾难性的引导坍缩(Guidance Collapse)?
追根溯源,这是因为传统的单表示 Text-to-3D 框架同时违背了多物体场景的三个物理与语义规律:首先,单片 NeRF 本质上是一个从全空间连续坐标映射到体密度和颜色的黑盒函数 ,内部根本不存在“这块体积属于苹果、那块体积属于香蕉”的天然边界;其次,2D 扩散模型的交叉注意力层(Cross-Attention)在面对包含多个名词和修饰词的长句时,本身就存在严重的属性串位与漏词倾向,把这种模糊的全局梯度原封不动地回传给同一个三维场,只会让不同部位抢夺同一团密度;最后,即便侥幸优化出了包含多个物体的整体辐射场,所有物体也已经死死焊在同一个 MLP 权重里,用户根本无法单独平移一只酒杯、放大一盘沙拉,或者把训练好的物体拆出来复用到新房间里。
为了解开这个死结,香港科技大学(广州)与 OPPO 研究院等团队提出的 CompoNeRF: Text-guided Multi-object Compositional NeRF with Editable 3D Scene Layout(项目主页 / 官方仓库)给出了一套极具代表性的结构化解耦方案。透过具体的公式与实验看本质,CompoNeRF 的架构建立在四条环环相扣的设计哲学之上:
- 用 3D 包围盒给连续辐射场“划定私有领地”,把多物体纠缠拆解为独立局部场(Spatial Disentanglement via 3D Box Slots):放弃用单个大 NeRF 硬扛整场戏的做法,转为按用户给定的 3D 包围盒布局(3D Box Layout),为每个物体分配专属的局部 Instant-NGP 辐射场 。每个局部场只管自己盒子里的物体,从参数源头切断跨物体的几何吞噬,同时让三维包围盒直接充当移动、缩放、删除与重组的交互句柄。
- 局部子文本锁身份,全局长文本管语境,实现监督信号的尺度分治(Dual-Level Text Guidance):将单一的 SDS 损失拆分为各司其职的双层监督——局部 SDS 用纯净的单物体子文本(Subtext,如
"french bread")单独监督各自局部场的独立渲染图,死死锁住物体的类别身份与专属颜色;全局 SDS 则用完整的场景长文本监督多物体合成后的全局视图,专门负责协调物体间的相对比例、桌面承托关系与整体环境氛围。 - 组合发生在三维光线积分层,用体密度残差校准替代二维图层拼贴(3D Ray-Level Density Calibration over 2D Alpha Blending):把多个独立训练的局部 NeRF 摆进同一个坐标系,绝不能简单地各自渲染成 2D 图片再做 Alpha 混合。当一条全局光线穿过多个 3D 包围盒时,来自不同物体的采样点必须按全局深度严格重排,在同一条光线上共同竞争累计透射率(Transmittance);同时引入轻量级全局校准 MLP,以残差形式同时微调体密度 与颜色 ,解决仅改颜色无法处理的接触面几何过渡与遮挡阴影。
- 把一次性场景优化沉淀为可复用的 3D 组件资产(Decompose-and-Recompose Paradigm):per-scene SDS 优化动辄耗时数千步,如果每次微调布局都推倒重来,工程成本根本无法承受。CompoNeRF 支持将训练好的局部 NeRF 组件拆解(Decompose)并缓存至离线库;当切换到新布局或新场景时,直接加载现成组件完成空间初始化,仅需针对全局校准网络做轻量级微调(Recompose)以消化新环境的光影差异。
下面我们就顺着这四条设计哲学,从底层渲染公式、网络架构到消融实验与失败边界,层层拆解这套多物体可组合 NeRF 框架。
1. 为什么多物体 Text-to-3D 容易发生引导坍缩?
1.1 连续场的无边界困境与 SDS 梯度耦合
在标准神经辐射场(NeRF)中,整个三维世界被编码为一个连续的隐式映射函数:
其中 是空间采样点坐标, 是相机视线方向, 是决定该点是否被实体占据的体密度(Volume Density), 是与视角相关的 RGB 辐射颜色。当相机发出一条光线 时,系统沿光线采样 个离散点,通过可微体渲染(Volume Rendering)积分出像素颜色:
其中 是相邻采样点之间的距离, 是光线到达第 个点之前的累计透射率(即光线没被前面物体挡住的概率)。
这套连续场表示在做多视角三维重建时非常优雅,但一旦配合分数蒸馏采样(SDS)做多物体生成,麻烦就接踵而至。回顾 SDS 的梯度更新公式:给定当前相机视角下的渲染图 、加噪时间步 与文本提示 ,预训练 2D 扩散模型 预测噪声残差,直接向三维参数 提供更新方向:
当提示词 里只有一个物体时,整张渲染图的所有像素都在为同一个语义目标服务。但当 变成包含三四个物体的复杂场景描述时,单一全局 SDS 配合单片 NeRF 就会陷入四重困境:
- 数量漏检:扩散模型只要在画面里看到了显著的“红苹果”特征,哪怕“黄香蕉”还没长出来,整体图文匹配分就已经不低了,导致弱势物体直接被梯度忽略;
- 属性串位:扩散模型分不清哪团三维密度对应哪个名词,把原本属于苹果的红色刷到了香蕉上,或者生成出半苹半蕉的嵌合体;
- 空间关系失控:文本里的
"next to"或"on top of"往往只被模型理解成二维画面里的共现关系,无法转化为准确的三维前后支撑; - 零可编辑性:所有物体共享同一套网络参数 ,想把苹果往左挪 10 厘米,除了改提示词重训几千步之外别无他法。
1.2 从任务全景看组合、拆解与重组闭环
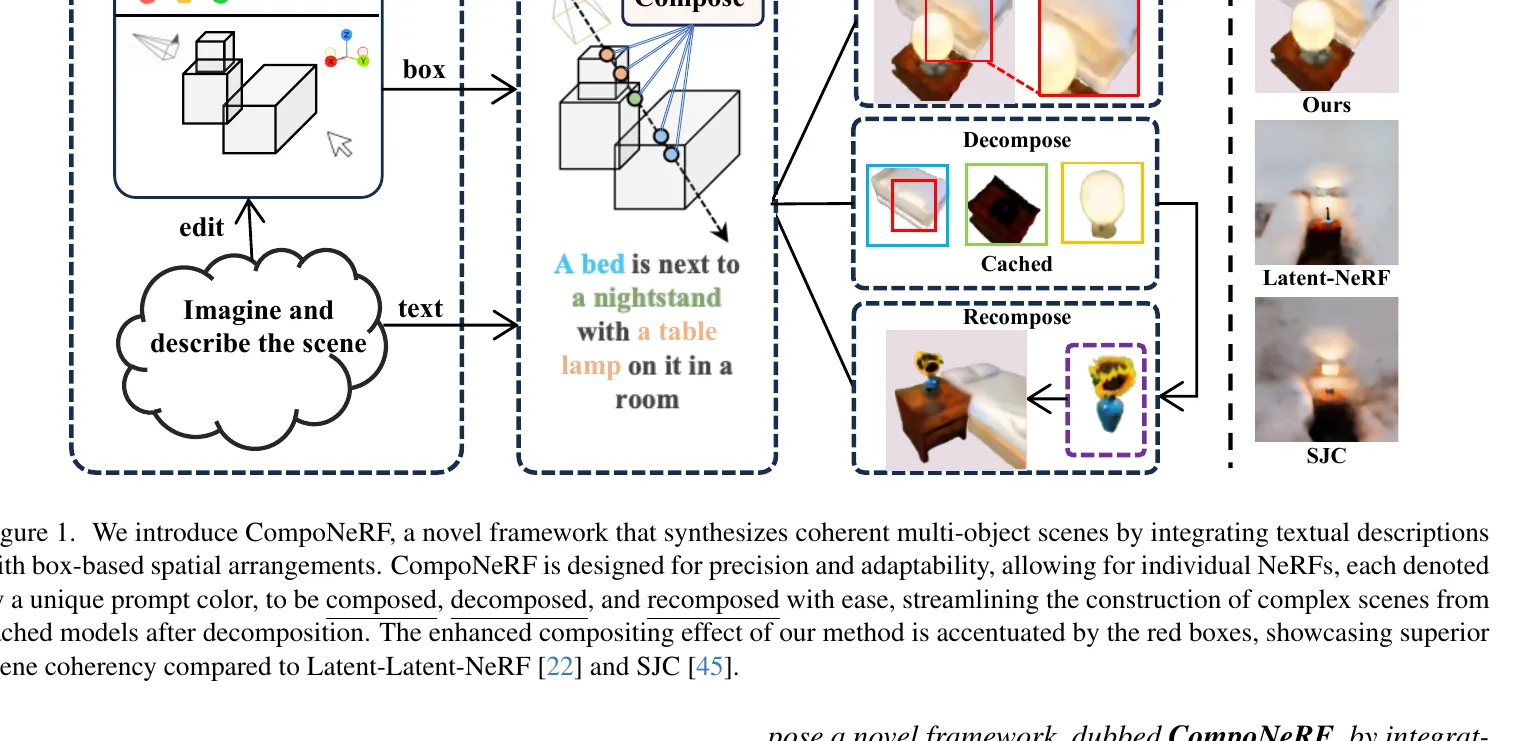
看上面这张系统全景图(Fig. 1),CompoNeRF 的核心思路就是在连续场外面套上一层显式的面向对象空间骨架。
图左侧是系统的输入契约:一段用不同颜色标注了核心名词的场景长文本,配上一组可由用户自由编辑的 3D 包围盒布局(3D Scene Layout)。每个包围盒在三维空间中占好槽位,并精准绑定一个局部物体名称。中间与右侧展示了由此解锁的三大核心能力:
- 组合生成(Compose):将多个局部对象级 NeRF 按照 3D 包围盒放进全局场景坐标系,通过光线求交与组合模块生成前后遮挡正确、风格统一的完整场景(对比右侧底部,Latent-NeRF 与 SJC 在多物体提示下出现了严重的几何粘连与主体丢失)。
- 组件拆解(Decompose):把训练收敛后的每个局部对象 NeRF 单独剥离出来,存入离线组件缓存库。
- 跨场景重组(Recompose):当用户拖动包围盒改变布局、删除某个物体,或者把不同场景里拆出来的局部物体(比如场景 A 的棋盘、场景 B 的酒杯、场景 C 的台灯)拼进一个新布局时,直接复用缓存组件快速合成新场景。
1.3 Guidance Collapse 的四种典型死法与破局路线
为了把“为什么必须同时引入局部子文本与全局校准”讲透,作者在 Fig. 2 中用最简单的双物体案例("a red apple and a yellow banana")做了一次对照诊断。
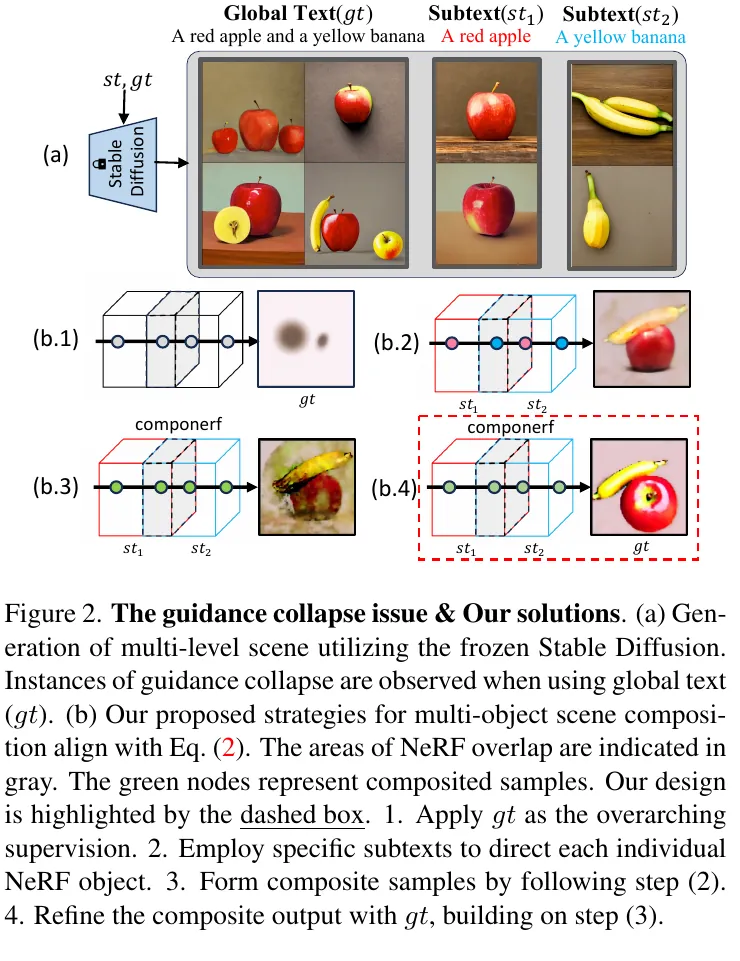
顺着图中的四条演化支路看过去,多物体 3D 优化的失败原因一目了然:
- 死法一(只用全局文本监督各个局部槽位):虽然切分了两个局部 NeRF 槽位,但如果喂给它们的监督信号依然是同一句全局长文本
"a red apple and a yellow banana",局部槽位根本不知道自己该认领苹果还是香蕉,结果两个盒子里都长出了苹果与香蕉的混合怪胎。 - 死法二(只用局部子文本各自独立训练,硬拼输出):给左边的盒子喂
"a red apple"、右边的盒子喂"a yellow banana",每个物体的个体身份保住了,但直接拼进全局空间后,交界处的遮挡关系、表面反光与阴影完全割裂,像两张生硬贴在一起的剪纸。 - 死法三(有局部子文本,但缺少全局残差校准器):即便加上了全局文本损失,如果没有专门的全局校准网络去修正跨盒子的密度与颜色,局部场在自己小天地里学到的辐射分布依然无法适应全局光照与接触上下文,重叠区会出现明显伪影。
- CompoNeRF 破局路线(图右侧虚线框):用对象专属子文本(Object-specific Subtexts)训练各个局部 NeRF 以锁定个体身份,在组合采样点上通过全局校准模块合成全局视图,再用全局长文本(Overarching Global Text)对合成视图施加顶层精炼约束。局部损失保身份,全局损失管融合,各司其职。
1.4 在 Text-to-3D 与场景编辑谱系中的位置
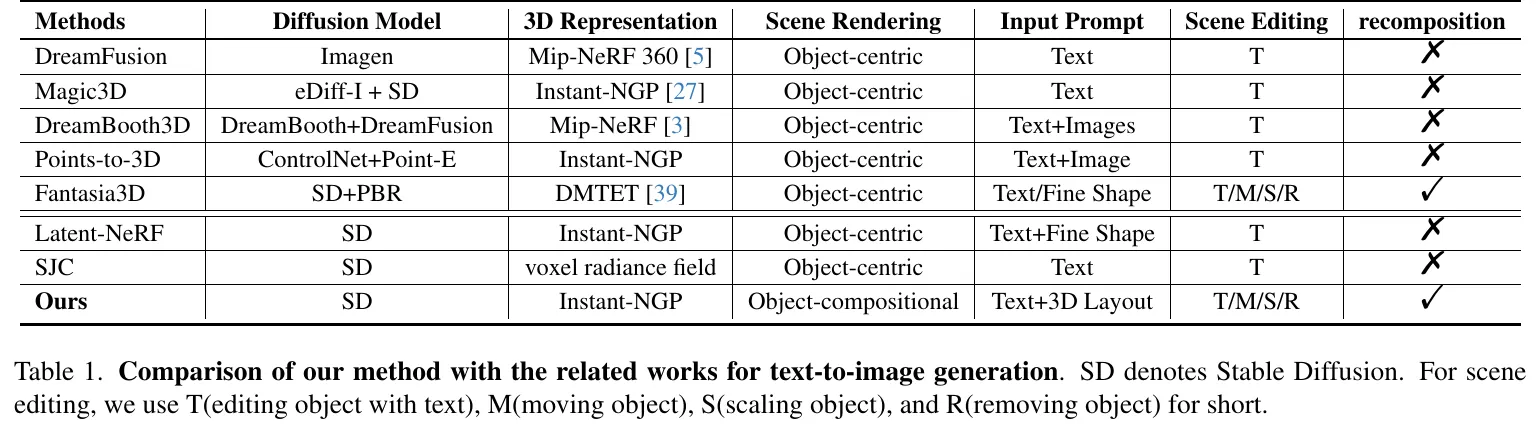
对照上面这张能力矩阵(Table 1),可以清晰看到 CompoNeRF 在早期 Text-to-3D 浪潮中的生态位演进:
DreamFusion(基于 Mip-NeRF 360)、SJC(基于体素辐射场)与 Latent-NeRF(基于 Instant-NGP 并在 Stable Diffusion 潜在空间优化)本质上都是以单物体为中心(Object-centric)的生成器,面对多物体提示词时既没有显式空间句柄,也无法拆解缓存。而 CompoNeRF 同样以高效的 Instant-NGP 哈希网格作为每个局部 NeRF 的底层表示,通过引入 3D Box 布局接口,一次性打通了表中所列的文本修改(Text)、平移(Move)、缩放(Scale)、删除(Remove)以及跨场景组件重组(Recomposition)。
2. 空间解耦与跨坐标系光线求交:用 3D Box 组织局部辐射场
2.1 三阶段系统流水线设计
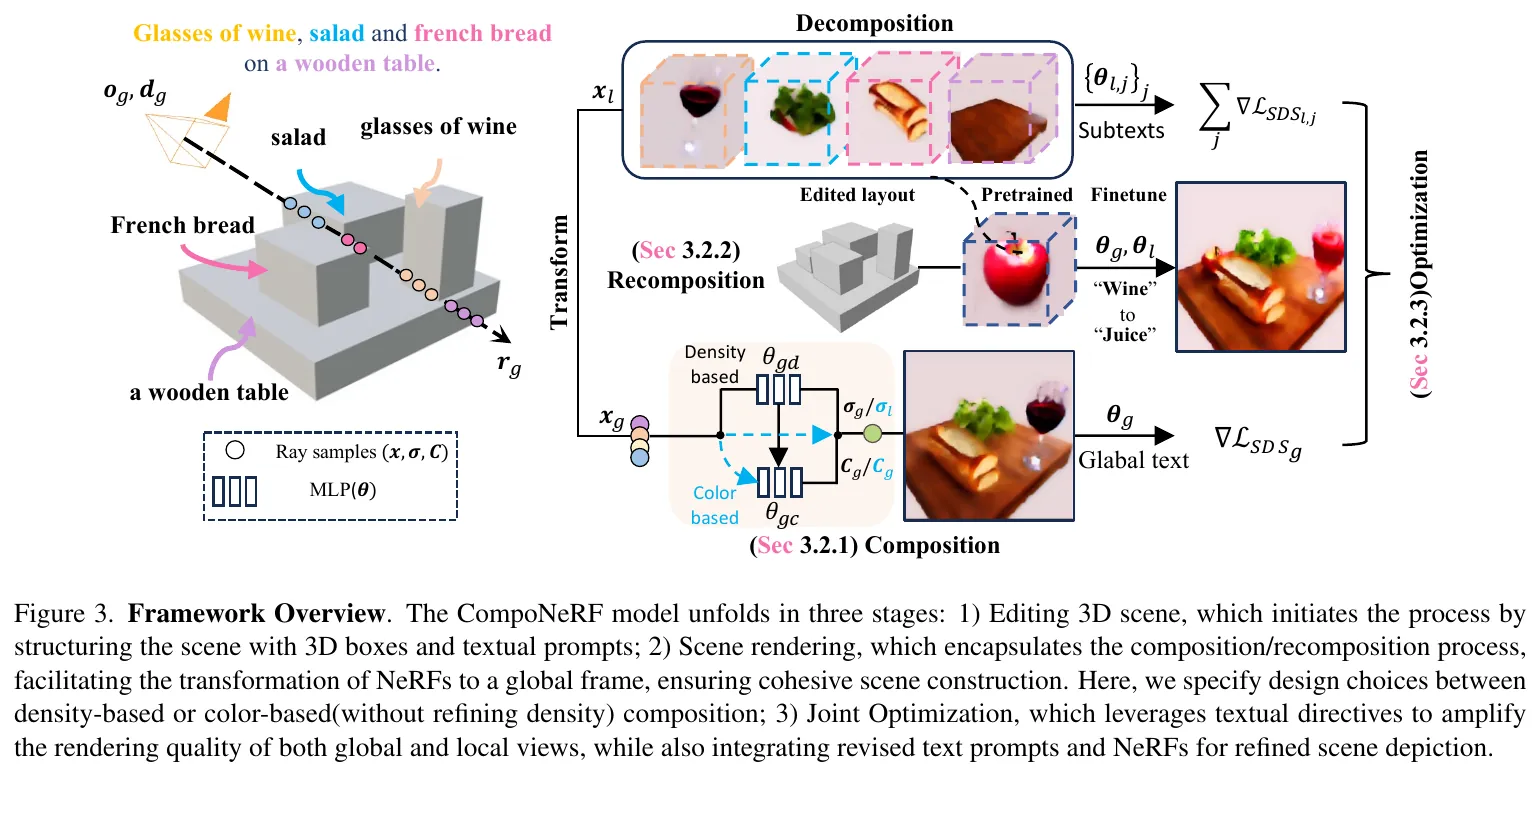
如 Fig. 3 所示,CompoNeRF 的单场景生成由三个紧密咬合的阶段构成:
- 三维场景布局定义(Editing 3D Scene):系统接收全局提示词 (如
"glasses of wine, salad and french bread on a wooden table"),以及拆解好的 个对象元组——每个元组包含一个子文本 (如"wine"、"salad"、"french bread"、"wooden table")和一个定义在全局场景坐标系下的 3D 包围盒 。这里体现了清晰的职责边界:CompoNeRF 并不包含从自然语言自动推理家具摆放坐标的布局生成网络,而是将 3D 包围盒定性为用户或上游规划器传入的显式控制接口。 - 跨坐标系组合渲染(Scene Rendering):系统同时维护两套坐标系——每个物体独享的局部坐标系(Local Frame)与所有物体共处的全局场景坐标系(Global Frame)。一条全局相机光线发出后,先与所有 3D 包围盒做求交测试;凡是被光线击中的盒子,就把交集段内的采样点从全局坐标变换到该盒子的局部坐标,查询对应的局部 NeRF 拿到局部密度 与颜色 ;随后送入全局组合模块(Composition Module)校准出全局密度 与颜色 ,最终沿光线按深度积分成全局图像。
- 局部与全局联合优化(Joint Optimization):在单步迭代中,优化器同时拿局部独立渲染图算 Local SDS、拿全局合成渲染图算 Global SDS,并附加工业级 NeRF 常用的二元熵稀疏正则项(Sparse Regularization),联合更新所有局部 NeRF 参数 与全局校准 MLP 参数 。
2.2 3D 包围盒控制句柄与全局到局部的仿射映射
把这个跨坐标系查询过程写成数学形式,一个包含 个对象的可编辑场景可以紧凑地定义为元组集合:
其中全局场景空间被归一化在以世界原点为中心的立方体 内,而每个局部辐射场 也定义在各自独立的标准局部归一化空间中。在工程实现上,局部 NeRF 除了预测局部密度 和颜色 外,还会向后输出一维中间几何/外观特征向量 供全局校准器使用:
当从全局相机位置 沿方向 发射一条全局光线 时,渲染器首先执行高速的轴对齐包围盒(AABB)光线求交算法,筛出这条光线穿过的所有对象包围盒索引集合:
对于每一个被命中的对象 ,我们在光线穿过该盒子的区间 内均匀采样 个点。设某个采样点的全局三维坐标为 ,该包围盒在全局坐标系下的中心平移为 、三轴缩放尺度为 ,则全局点映射回第 个局部 NeRF 内部坐标系的仿射变换 为:
如果进一步允许包围盒带有三维旋转矩阵 ,则只需在缩放平移基础上左乘逆旋转矩阵:
你看,这套坐标映射最大的妙处在于:当用户在编辑器里拖动或缩放第 个物体的包围盒时,局部 NeRF 的权重 一行都不用改,只需要改外面的 ,空间里的光线采样点就会自动映射到新的位置去查询该物体!
2.3 局部独立积分与全局深度重排透射率竞争
在训练过程中,每个局部对象需要单独渲染出局部视图去接受子文本 的监督。此时,局部光线 只穿过第 个物体自己的局部空间,采样 个点即可按标准体渲染积分出局部像素颜色:
而在渲染全局组合视图时,一条全局光线 最多可能先后穿透全部 个对象的包围盒(或者穿过两个相互嵌套/交叠的包围盒,比如摆在木桌包围盒上方的沙拉碗包围盒),汇总产生最多 个采样点。全局像素颜色由所有命中点的全局校准值 积分而成:
千万别把上面这个公式简单看成“把求和上限从 改成 ”。在三维渲染底层,它包含了一步决定遮挡关系成败的核心操作:跨盒子采样点的全局深度重排(Global Depth Sorting)。
当一条全局光线先后穿过“红酒杯”和后方的“沙拉碗”,甚至同时处于“木桌”与“面包”两个包围盒的交叠区域时,来自不同局部 NeRF 的采样点映射回全局光线 后,必须严格按照它们离相机原点的真实深度参数 ()从小到大重新排队!排队之后,相邻点间距重新计算为 ,而第 个采样点的全局累计透射率 则由排在它前面的所有采样点(不管来自哪个物体)共同决定:
这正是“三维空间组合”与“二维图像拼接”的分水岭:多个物体在同一条三维光线上按照真实物理深度竞争可见性——如果前面的红酒杯在某处体密度 很高,透射率 就会迅速衰减,自然遮挡住后面的沙拉;如果是半透明玻璃杯,后面的沙拉颜色则能按剩余透射率自然透出来。
3. 全局残差校准:为什么必须同时修正体密度与颜色?
3.1 基于密度的残差校准模块架构
现在考虑一个更深入的问题:既然已经有了跨盒子的全局深度重排和透射率竞争,如果直接令全局密度等于局部密度()、全局颜色等于局部颜色(),把各个局部 NeRF 原封不动地塞进全局光线里积分,行不行?
答案是不行。因为每个局部 NeRF 在局部视图下训练时,只知道“我自己长什么样”,完全不知道“我被摆在了一张反光的木桌上”或者“我旁边紧挨着另一个物体”。直接硬塞会产生两个严重断层:一是两个包围盒接触或交叠的地方(比如面包贴着桌面、棋子落在棋盘上)会出现生硬的几何穿插或悬空缝隙;二是缺乏跨物体的环境光反射、接触面阴影(Ambient Occlusion)与全局色调统一。
为此,CompoNeRF 设计了 Fig. 5 所示的基于密度的组合校准模块(Density-based Composition Module)。
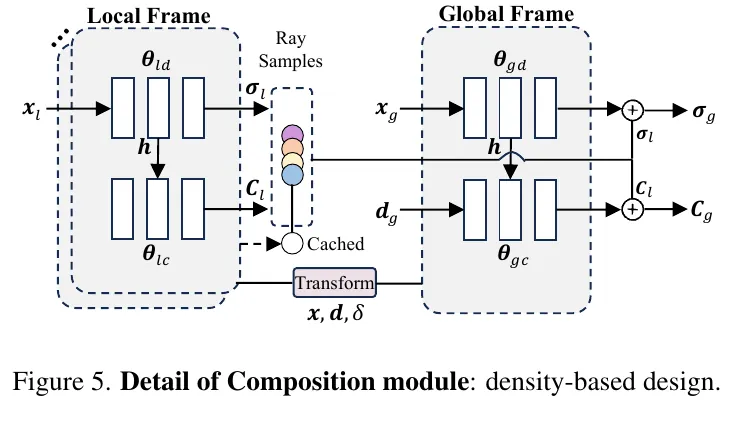
看图中的双路数据流:局部 NeRF 查询出的原始输出 一路直接送去算局部渲染(保证局部身份不受干扰);另一路在进入全局渲染前,经过两个由 4~6 层全连接层(隐藏层宽度 64)构成的轻量级全局校准网络——密度校准器 与颜色校准器 ,以残差加成(Residual Calibration)的形式算出全局密度与全局颜色:
仔细推敲这两个公式的输入变量,能看出作者非常老道的架构考量:
- 为什么采用残差结构()? 因为局部 NeRF 已经把物体 90% 的主体几何与基础颜色学出来了,全局 MLP 的定位是“微调修补匠”,只需在全局坐标 和全局观察方向 的指引下,补偿物体交界处的接触过渡、桌面倒影和全局色调偏差,大大减轻了全局网络的收敛负担。
- 为什么密度校准器只输入 ,而颜色校准器输入 ? 因为在物理世界中,某一点“有没有实体物质占据”(体密度 )只取决于它的三维空间位置 ,绝不应该随着相机观察角度 的改变而忽隐忽现;而表面呈现出什么高光、反射与阴影颜色(),则既依赖局部材质特征 ,又强烈依赖全局视线方向 。
3.2 仅校准颜色为什么会在接触面与近景翻车?
你可能会问:让全局 MLP 去改体密度 ,万一它把原本局部物体的几何形状改坏了怎么办?为什么不干脆锁死几何密度(令 ),只让全局网络去修正表面颜色呢?
为了回答这个疑问,作者专门实现了一版仅校准颜色(Color-based Design)的变体:
并在 Fig. 4 中将它与完整的 Density-based 方案做了近景与收敛过程的正面对比。
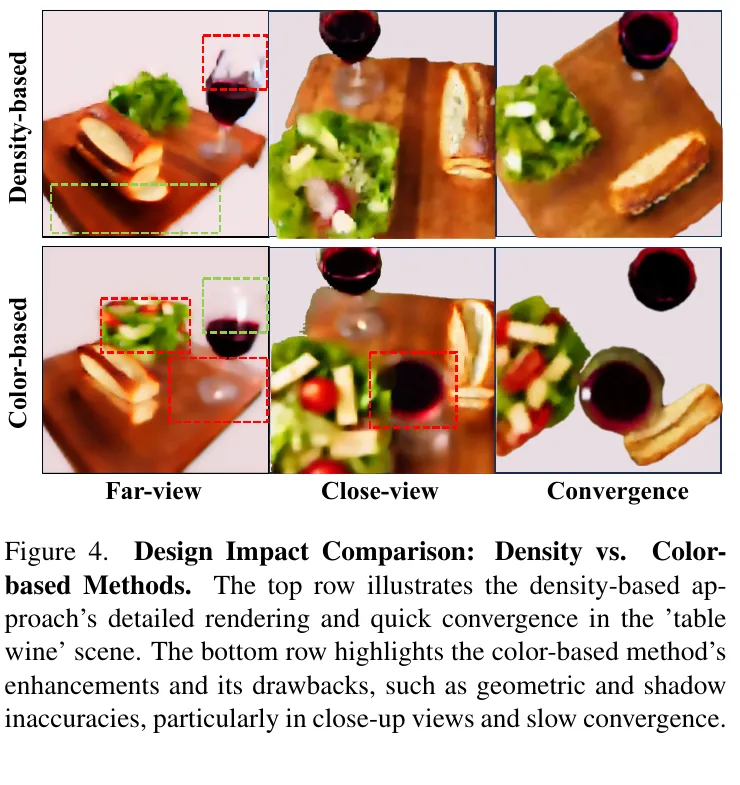
看 Fig. 4 的对比图像:Color-based 方案在远景猛一看似乎色彩挺鲜艳(甚至能在桌面上刷出夸张的彩色反光),但一旦拉近镜头看局部(Close-ups)或者观察训练收敛过程(Convergence),物体与桌面的接触边缘到处是破碎的伪影和半透明鬼影。
为什么只改颜色救不了多物体组合?回到前面的全局体渲染公式就能瞬间想通:颜色 对最终像素的贡献,是被前面的体密度不透明度 死死乘住的!
- 如果两个物体接触的地方在局部场里留下了一道空白缝隙,那里局部密度 ,那么 ——此时哪怕颜色校准器 算出了再完美的过渡颜色,乘上 之后对画面的贡献也是零,缝隙依然是缝隙!
- 反过来,如果两个包围盒重叠区多出了一团不该有的局部边缘毛刺(),如果不允许全局密度校准器输出负残差把这团密度消掉,只靠涂改表面颜色,那团多出来的几何肿块永远杵在那里挡住后面的视线。
因此,多物体融入同一场景,本质上是三维空间占据率(Occupancy)与表面外观的协同重塑,放开体密度残差校准是消除拼接断层的必经之路。
4. 双层文本引导与联合优化算法剖析
4.1 局部 SDS、全局 SDS 与二元熵稀疏正则的协同博弈
把空间表示和组合渲染搭好后,CompoNeRF 的总体优化目标由三项损失加权构成:
其中 是全局组合渲染图像, 是第 个局部对象在各自局部相机视角下的独立渲染图像, 是针对局部体密度的二元熵稀疏正则项(Binary Entropy Sparse Regularization,逼迫采样点密度要么趋近于 0 完全透明,要么趋近于高密度实心表面,严厉惩罚半空中的雾状半透明漂浮物)。这三股力量在训练中形成了一套精密的动态制衡:
| 损失项与默认权重 | 直接作用的渲染图与参数 | 解决的核心痛点 | 权重失衡时的退化后果 |
|---|---|---|---|
| Local SDS() | 局部独立视图 仅更新第 个局部场 | 隔离跨物体干扰,确保每个包围盒内长出准确对应的物体几何与专属属性 | 过大时各个物体固执己见,抗拒全局环境协调,组合处生硬割裂 |
| Global SDS() | 全局合成视图 同时更新全局校准器 与局部场 | 提供跨物体空间关系、桌面/地面承托上下文、全局统一光照与接触阴影 | 过大时全局长文本语义会反噬局部槽位,在局部盒子里长出背景杂物或引发物体融合 |
| Sparse Loss() | 局部体密度场 更新局部场 | 清扫包围盒边角处的雾状漂浮伪影(Floaters),防止多盒叠加时雾气累加挡死视线 | 过大时会过度削蚀物体体积,把高脚杯细杆、沙拉叶片或玻璃球等精细半透明结构一并抹除 |
4.2 训练主循环与跨盒采样伪代码推演
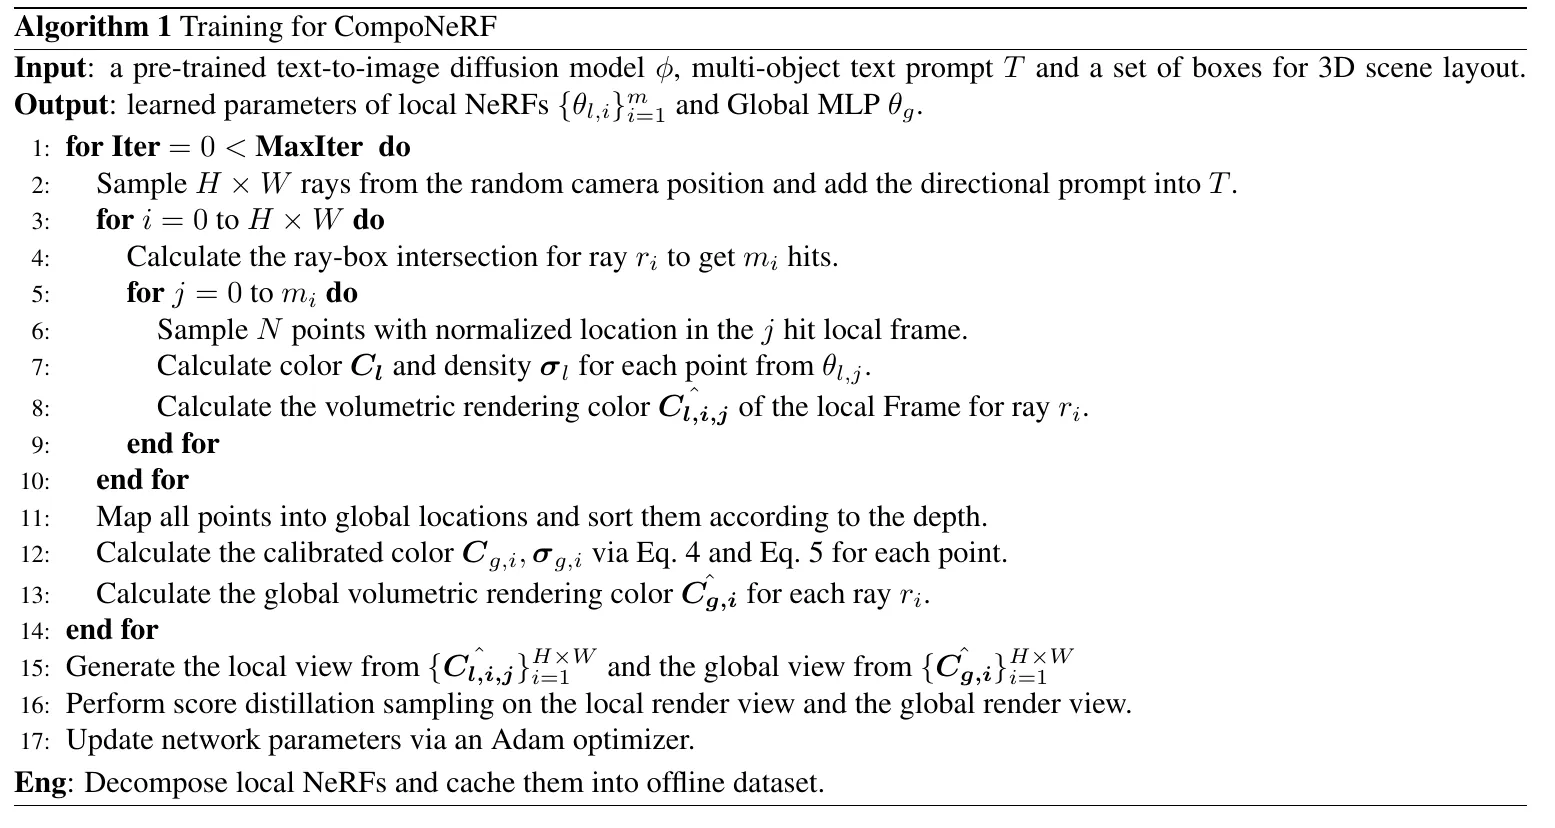
对照论文附录给出的 Algorithm 1,我们可以把单次训练迭代的完整数据流梳成一段清晰的工程逻辑:
- 半球面相机与动态 FOV 采样(第 1–2 行):在以原点为中心的归一化全局空间外,从上半球面随机采样相机位置(半径在 之间随机抖动,训练期视场角 FOV 在 之间随机采样以兼顾全局远景与局部特写,测试期固定为 ),生成 条全局光线,并根据相机方位角在文本后追加
"front view"、"side view"等方向提示词(Directional Prompt)。 - 批量光线-包围盒求交与局部查询(第 3–8 行):对每条全局光线计算其命中的包围盒序列(共 个命中盒)。对第 个命中盒,将交集区间变换到该物体的局部坐标系,采样 个点查询局部 Instant-NGP 网络,既算出用于局部监督的局部体渲染颜色,又保留原始 。
- 全局深度排序与残差校准积分(第 11–13 行):将所有命中盒子的采样点映射回全局坐标系,按全局光线深度统一升序排列,调用全局校准 MLP 算出 后执行全局体渲染积分。
- 双层 SDS 回传与组件拆解缓存(第 15–17 行及末尾行):将积分出的局部视图列表与全局合成视图送入冻结的 Stable Diffusion v1-4(配合 SJC 的 Perturb-and-Average 多步扰动平均梯度策略提升稳定性),用 Adam 优化器(Batch Size = 1)更新参数。在单张 NVIDIA RTX 3090 上,简单多物体场景约迭代 5,000 步,复杂组合场景约迭代 8,000 步;训练结束后即可将 拆解序列化为离线组件。
写成可直接对照实现的 Python 风格主循环如下:
for step in range(max_steps):
    # 1. 采样随机半球相机与方向提示词 (半径 1.0~1.5, FOV 40~70度)
    cam_pose, dir_prompt = sample_hemisphere_camera(radius_range=(1.0, 1.5), fov_range=(40, 70))
    global_rays = generate_global_rays(cam_pose)

    global_samples = []
    # 2. 跨包围盒求交、局部查询与全局残差校准
    for ray in global_rays:
        hits = intersect_aabb_boxes(ray, boxes)
        for hit in hits:
            pts_global, depths = sample_along_segment(ray, hit.t_near, hit.t_far, num_samples=N)
            pts_local, dir_local = transform_global_to_local(pts_global, ray.dir, hit.box)

            sigma_l, color_l, feat_h = local_nerfs[hit.obj_id](pts_local, dir_local)
            sigma_g = sigma_l + alpha_d * global_mlp_density(pts_global)
            color_g = color_l + alpha_c * global_mlp_color(feat_h, ray.dir)
            global_samples.append((depths, sigma_g, color_g))

    # 3. 按全局深度严格重排并积分全局视图,同时独立渲染各局部视图
    global_view = volume_render_sorted(sort_by_depth(global_samples))
    local_views = [render_local_object(nerf_j, cam_pose) for nerf_j in local_nerfs]

    # 4. 计算双层 SDS 损失与局部稀疏正则
    loss_g = alpha_g * sds_loss(sd_model, global_view, global_prompt + dir_prompt)
    loss_l = alpha_l * sum(
        sds_loss(sd_model, view_j, subtext_j + dir_prompt)
        for view_j, subtext_j in zip(local_views, subtexts)
    )
    loss_sparse = beta * sum(binary_entropy_density_reg(nerf_j) for nerf_j in local_nerfs)

    optimizer.zero_grad()
    (loss_g + loss_l + loss_sparse).backward()
    optimizer.step()
5. 多物体生成实测与跨场景组件重组
5.1 八大复杂场景定性对比:数量、属性绑定与局部解耦
为了验证这套架构能否真正根治 Guidance Collapse,作者在对齐相同骨干网(Instant-NGP)、相同扩散权重(SD v1-4)与相同提示词的前提下,将 CompoNeRF 与 Latent-NeRF 及 SJC 在 8 个难度递增的多物体场景上做了正面交锋(Fig. 6)。
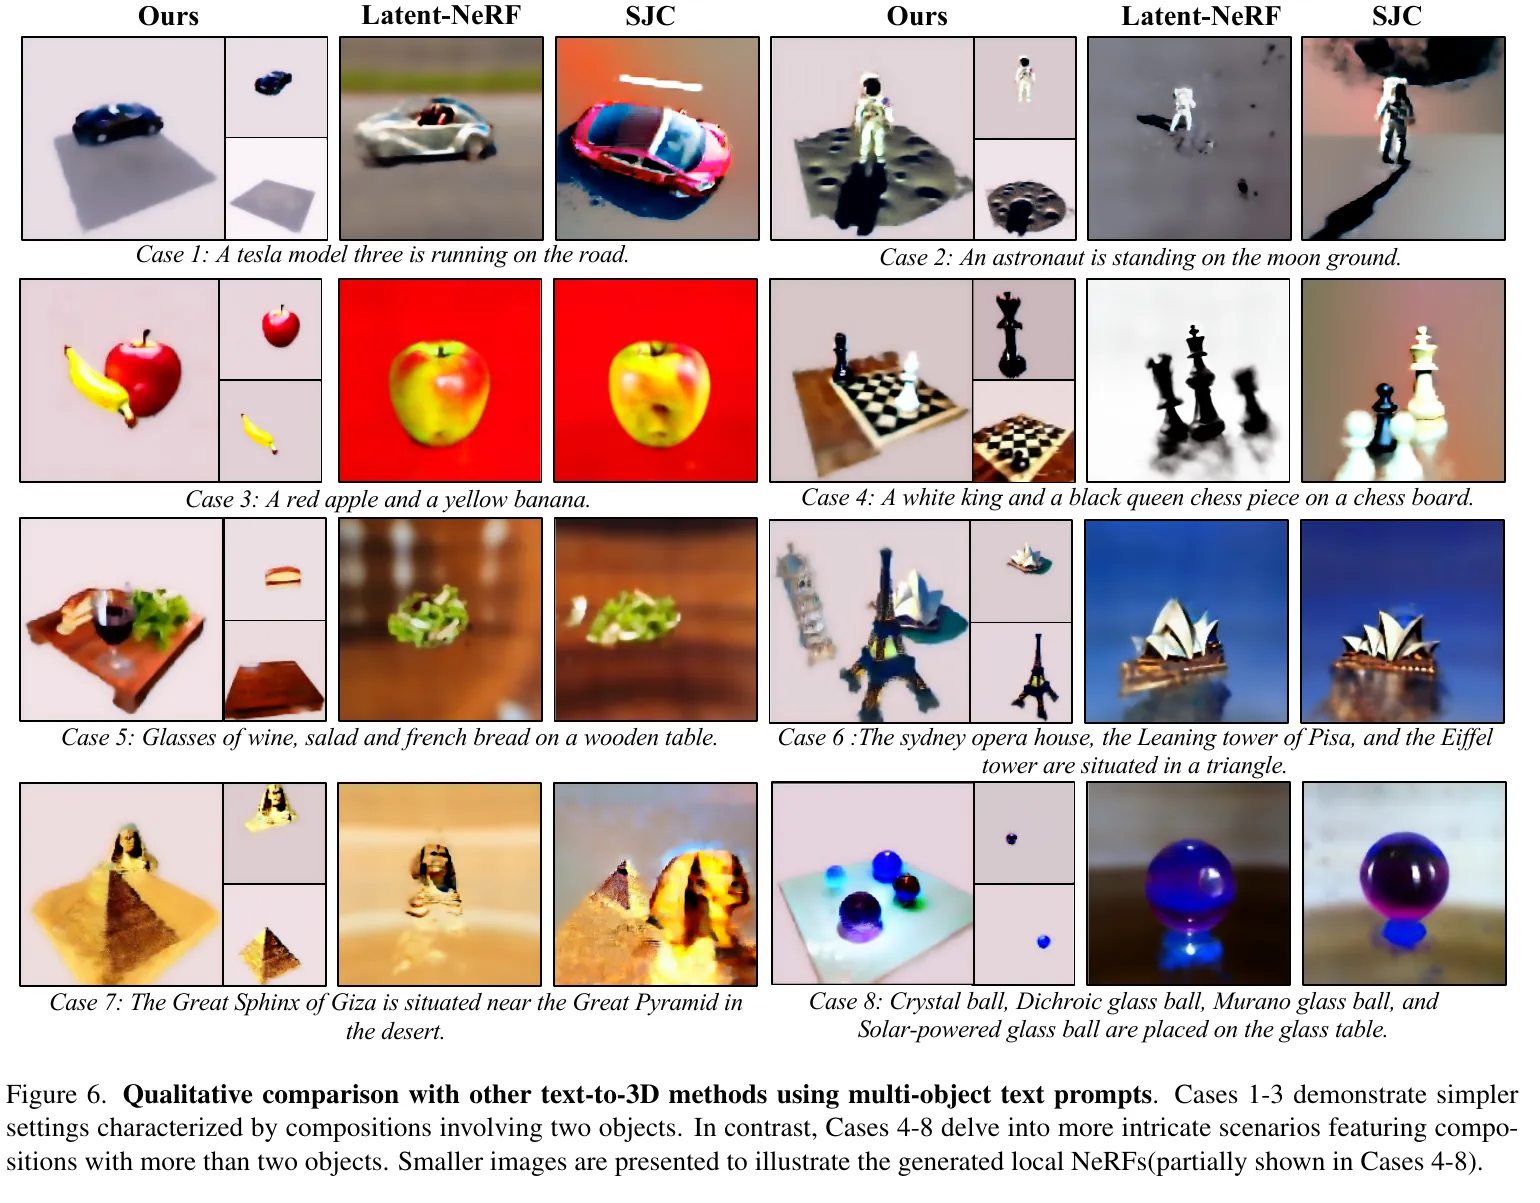
仔细对比 Fig. 6 中的前 3 个双主体场景(公路汽车、月面宇航员、红苹果与黄香蕉)和后 5 个多主体复杂交互场景(国际象棋棋盘与棋子、木桌上的红酒/沙拉/法棍、三大微缩地标建筑、沙漠多植物景观、多色玻璃球组合),可以看到四个非常硬核的改进:
- 彻底告别漏生成:在 Case 3(红苹果与黄香蕉)和 Case 6(埃菲尔铁塔、比萨斜塔与金字塔)中,Latent-NeRF 与 SJC 要么只生成了一个红苹果而把香蕉彻底吃掉,要么只建出了单座塔状物;CompoNeRF 则因为每个物体都有专属的 3D Box 槽位兜底,一个不落地把所有主体全部立了起来。
- 严防颜色与材质串位:在多色玻璃球(Case 8)与果盘场景中,基线方法的颜色糊成一团,而 CompoNeRF 依靠局部子文本一对一监督,让每个局部场准确守住了自己的色彩属性。
- 局部组件干净可拆:注意看 CompoNeRF 每张结果图右侧附带的带色框小图——那是把对应的局部 NeRF 单独拎出来渲染的结果!小图里干净独立的汽车、宇航员、法棍和铁塔证明,模型摒弃了靠背景涂抹凑数的投机做法,真正在每个三维槽位里学到了解耦的 3D 实体。
- 全局语境自然融合:在 Case 5 的餐桌场景中,红酒杯、沙拉、法棍彻底摆脱了剪贴画式的悬浮感,经过全局校准网络微调后,稳稳融入了同一张木桌的表面纹理与阴影语境中。
5.2 多视角 CLIP 语义对齐度与评测指标边界
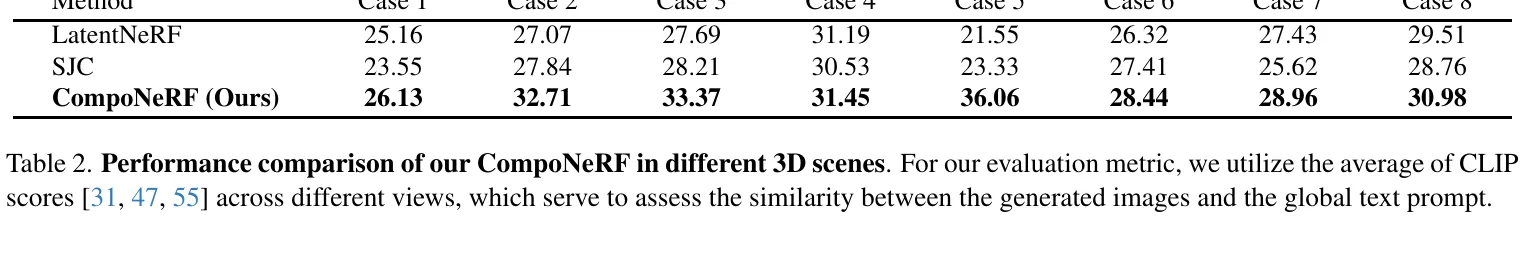
看 Table 2 统计的多视角渲染图像与全局文本之间的平均 CLIP Score:CompoNeRF 在全部 8 个场景中全线领跑,尤其是在包含 4 个紧耦合交互对象的 Case 5(餐桌食物组合)上,将分数从 Latent-NeRF 的 28.59 和 SJC 的 26.90 大幅拉升到了 31.95。这组数据印证了一个规律:提示词里的名词槽位越多、空间遮挡关系越复杂,单一全局 SDS 的坍缩就越剧烈,局部/全局双层解耦带来的收益也就越显著。
当然,从严谨的工程视角审视,CLIP Score 只是一个衡量“二维渲染图在语义上像不像提示词”的高层代理指标——它对细粒度三维网格拓扑是否光滑、环绕视角是否绝对一致以及物体底部是否严丝合缝贴合桌面并不敏感,这也是我们必须结合后续多视角消融图做进一步检验的原因。
5.3 拆解缓存与跨场景重组微调机制
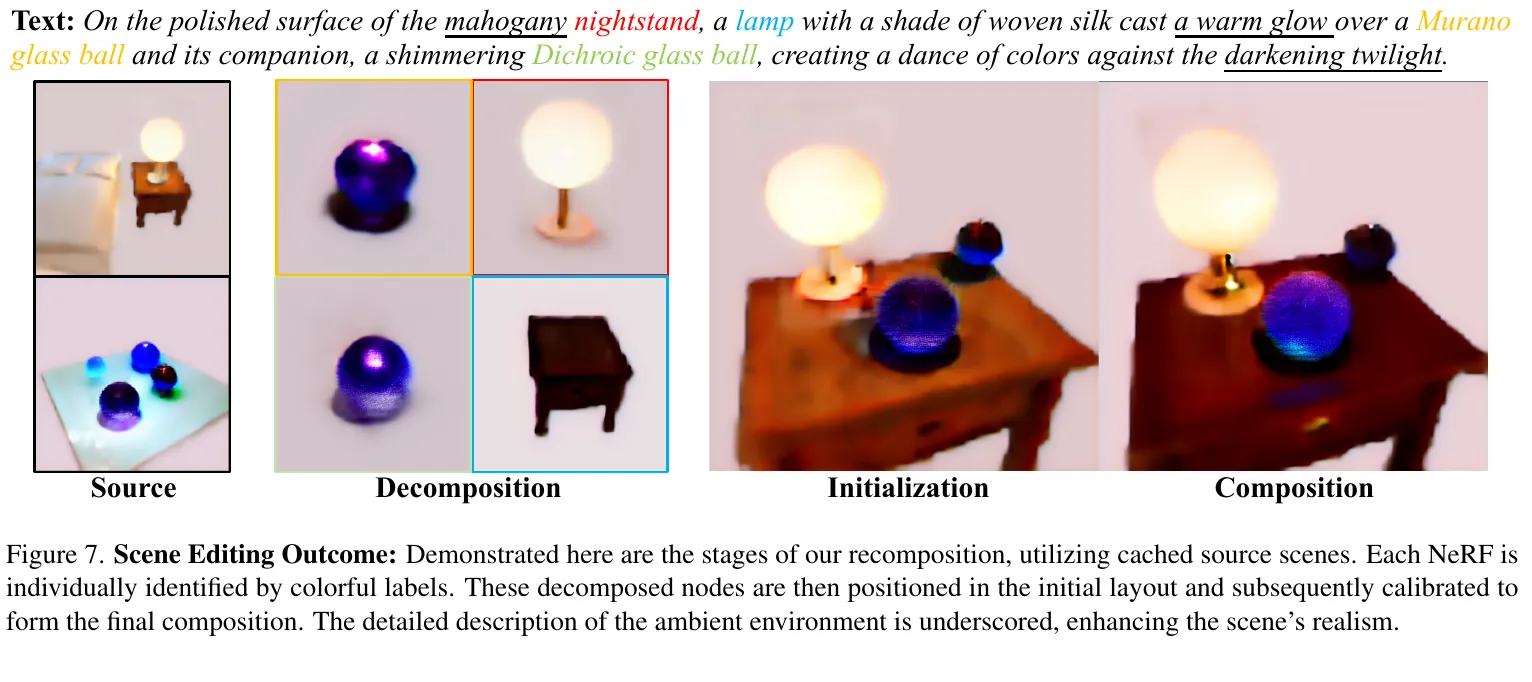
Fig. 7 展示了 CompoNeRF 最具实用价值的杀手锏——跨场景组件拆解与重组(Scene Editing & Recomposition)。
看看图中的流水线是怎么玩的:系统先从三个已经训练好的不同源场景(Source Scenes)中,把局部物体拆解(Decompose)出来——比如从餐桌场景拆出木桌、酒杯和法棍,从卧室场景拆出台灯,从棋局场景拆出棋盘和棋子。接着,用户在新的全局空间里摆好新的 3D Box 布局(Initialization),把这些现成的局部 NeRF 组件直接填进新盒子里;最后启动重组校准微调(Calibration),合成出一个“木桌上同时摆着国际象棋、红酒杯与卧室台灯”的全新 3D 场景。
这里有一个值得深思的工程问题:既然局部 NeRF 组件是现成的,为什么摆进新布局后不能直接零成本渲染,还非要做几千步重组微调(Finetuning)?
原因在于上下文残留与光照重配。当“法棍”或“棋盘”在原来的源场景里联合训练时,全局 SDS 梯度其实也流过了局部 NeRF,导致局部物体的底部边缘往往残留着旧桌面的阴影颜色或接触面几何;而且进入新场景后,它旁边的邻居变了(比如棋盘旁边突然多了一盏发光的台灯),遮挡关系和全局相机视野占比也全变了。如果不做重组微调,直接拼出来的画面就会带着旧场景的阴影残渣。而通过重组微调,系统省去了从随机噪声捏出棋盘和台灯几何的最漫长过程,只需集中算力洗掉旧场景的边缘残留、把新邻居之间的光影和接触密度重新校准对齐即可。
6. 消融实验与失败模式深度复盘
6.1 全局校准、全局文本与多视角几何一致性验证
如果把 CompoNeRF 的某个核心模块拆掉,画面会退化成什么样?Fig. 8 在卧室组合场景(床、床头柜、台灯)上给出了四组消融对比,Fig. 9 则展示了多视角旋转渲染结果。
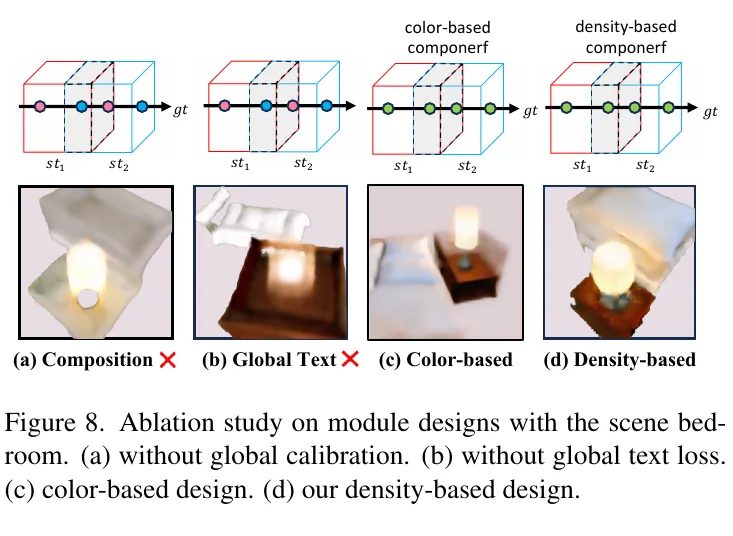
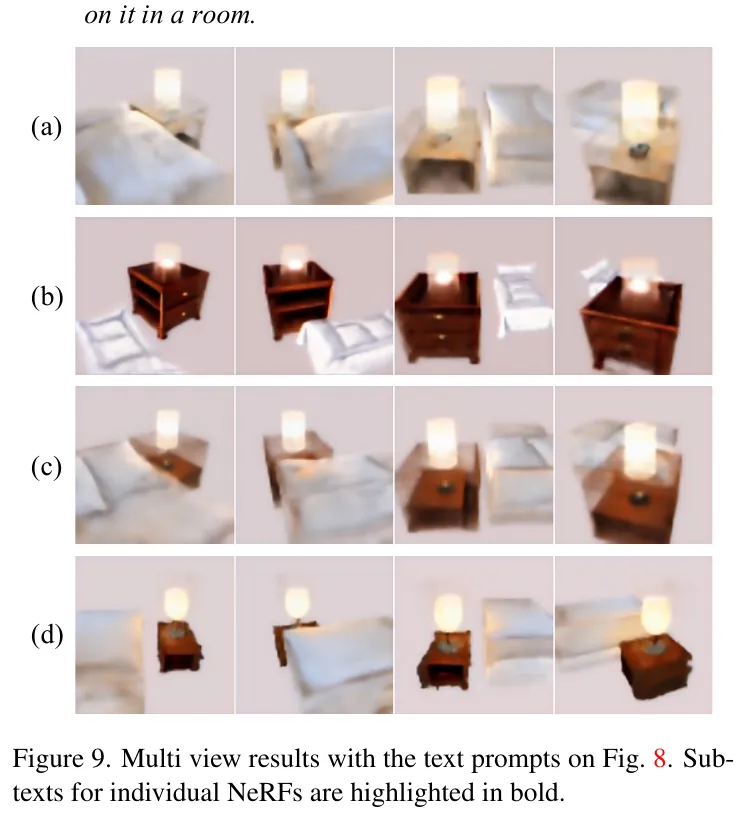
把这两张图对照着看,每个模块存在的必要性一清二楚:
- 去掉全局校准器(Without Global Calibration):床、床头柜和台灯虽然各自待在盒子里,但床单纹理与周围地面毫无过渡,整体画面干瘪且缺乏统一的环境光感。
- 去掉全局文本损失(Without Global Text Loss):每个局部物体只听自己子文本的话,虽然长出了床和柜子,但丢失了
"bedroom"的整体氛围与家具之间的协调比例。 - 只校准颜色(Color-based Design):床尾与地面的交界处出现了怪异的块状几何截断与阴影污染。
- 完整密度校准方案(Density-based Design):不仅单视角下家具接触自然、光影柔和,而且在 Fig. 9 的连续环绕多视角下,依然稳稳保持住了三维空间结构的一致性。
6.2 梯度有效分辨率、重组微调步数与校准网络容量权衡
在真正动手调参时,有三个决定成败的工程旋钮分别体现在 Fig. 10、Fig. 11 与 Fig. 12 中:
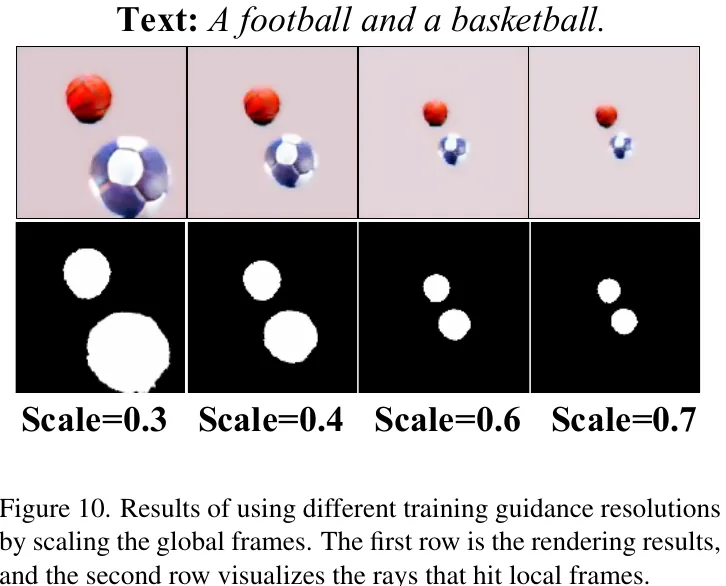
- 全局缩放尺度与像素梯度饥饿(Fig. 10):在多物体大场景里,如果相机拉得太远(例如全局缩放尺度 Scale = 0.3),像远处的金字塔或小摆件在全局渲染图里只占寥寥十几个像素(看第二行可视化的光线命中区域)。这么小的像素面积投射到 Stable Diffusion 的 潜在特征图上,连两个格子都占不满,拿到的 SDS 梯度微乎其微,导致物体长成一团模糊的泥巴。把全局尺度放大到 0.5~0.7,让物体充分填满视野,几何细节立刻清晰起来;但若放得过大,相机又会频繁截断场景边缘,破坏全局布局感。
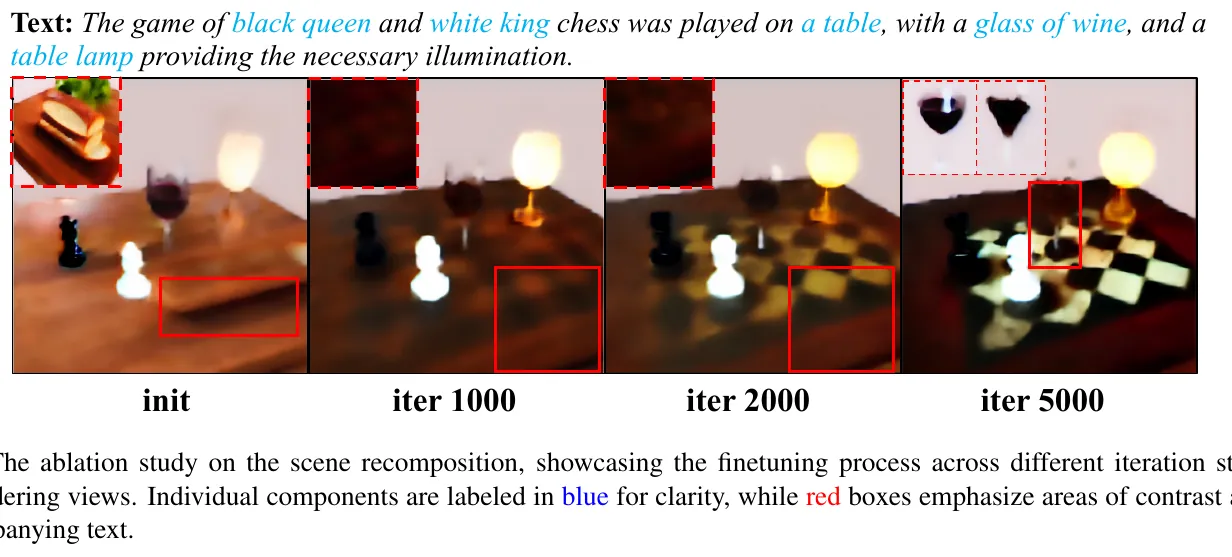
- 重组微调步数的“欠消化”与“过拟合”权衡(Fig. 11):看跨场景重组从
Init到Iter 1000、2000直至5000的演化过程。在刚拼进去的Init阶段,酒杯、台灯和棋盘只是生硬地摆在木桌上;随着微调推进到 2000~5000 步,木桌纹理自然延伸并与上方物体产生了协调的阴影交互。但这同样是一把双刃剑:如果对一个现实中罕见的怪异组合微调太久,强势的全局 SDS 梯度反而会逐渐腐蚀掉局部组件原本干净的几何轮廓,实践中必须配合早停(Early Stopping)机制。
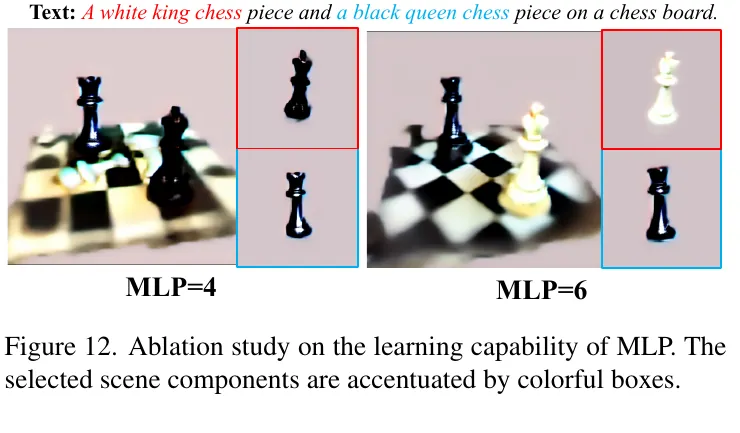
- 全局校准 MLP 的容量边界(Fig. 12):对比 4 层与 6 层 Global MLP 可以看到,面对棋盘格纹理加多枚棋子这类高频复杂交互时,4 层浅网络表达能力捉襟见肘,棋盘表面糊成一片;升级到 6 层后才稳稳撑住局部身份与全局纹理。但全局校准器绝不能无限制加深变宽——它本质上只是一个残差修正层,一旦容量大到足以喧宾夺主,它就会绕过局部 NeRF 直接在全局空间里乱长几何,彻底摧毁组件解耦性。
6.3 Janus 多正面畸变与包围盒悬空漂浮的物理边界
CompoNeRF 并没有掩饰优化式 Text-to-3D 的结构性软肋,Fig. 13 与 Fig. 14 坦诚展示了两类最典型的翻车现场:
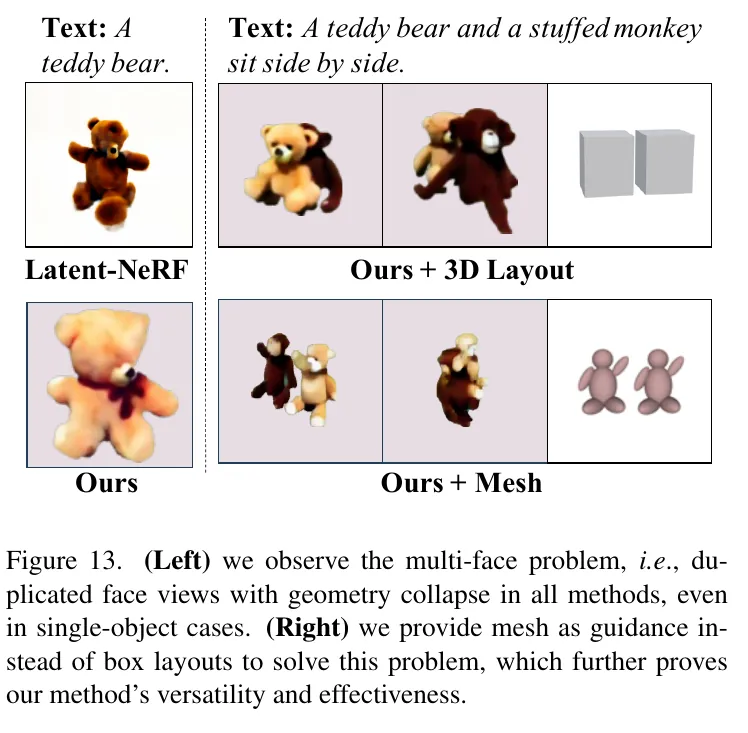
- Janus 多正面问题与网格先验拯救(Fig. 13):由于底层的 Stable Diffusion v1-4 只是个单视角 2D 模型,缺乏原生 3D 多视角几何概念,当相机转到汽车侧面或背面时,SDS 依然倾向于逼迫 NeRF 渲染出最具辨识度的“汽车前脸”或对称车头,导致一辆车长出好几个车头(图左)。图右侧展示了一个直接的补救手段:如果在局部包围盒内引入粗糙的三维网格引导(Mesh Guidance)锁死拓扑朝向,多正面畸变就能被有效扼杀——代价则是牺牲了纯文本无中生有的自由度。
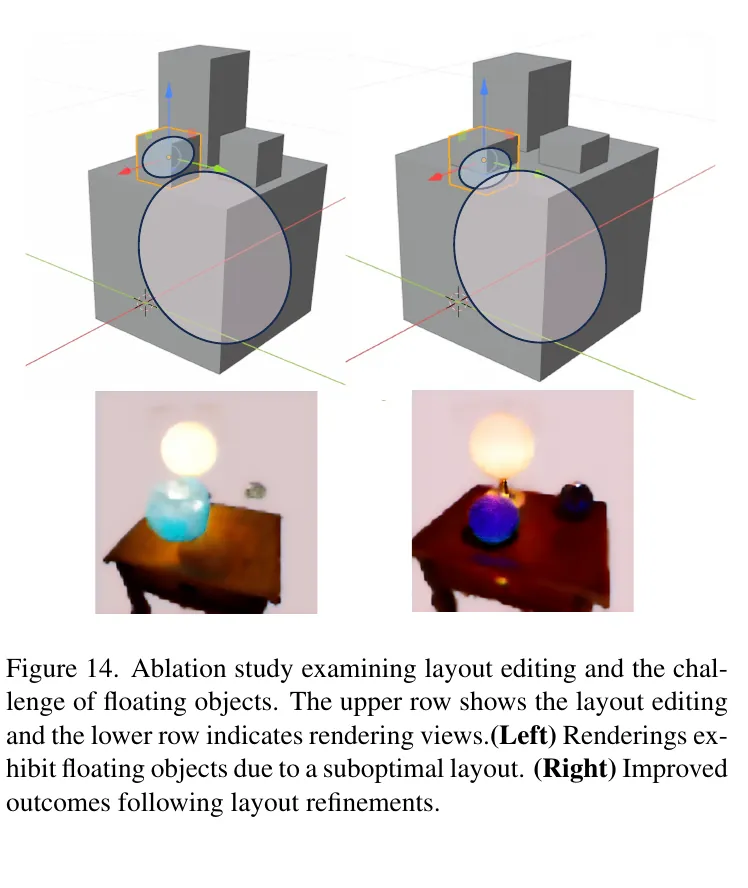
- 包围盒间隙引发的悬空漂浮物(Fig. 14):CompoNeRF 的 3D Box 布局只是一个空间采样窗口,背后既没有刚体碰撞检测,也没有重力下沉仿真。看图左侧:如果用户在摆放包围盒时,让上方物体的盒子与下方基座的盒子之间留出了一道空隙(或者接触面太小),由于包围盒外的空白区域根本不参与局部查询,全局校准器也无法凭空跨过真空地带捏造出支撑结构,最终渲染出来就是物体尴尬地悬浮在半空中!只有像图右侧那样,在编辑布局时人为让上下两个包围盒产生适度交叠(Overlap),增加跨盒子的光线采样交互,才能让两个物体真正长在一起。
6.4 局部身份保持与全局语境融合的权重拉锯战
最后,Fig. 15、Fig. 16 与跨页大图 Fig. 17 展示了极端语义组合下的失败案例、局部/全局权重的拉锯张力以及全量多物体分解效果。
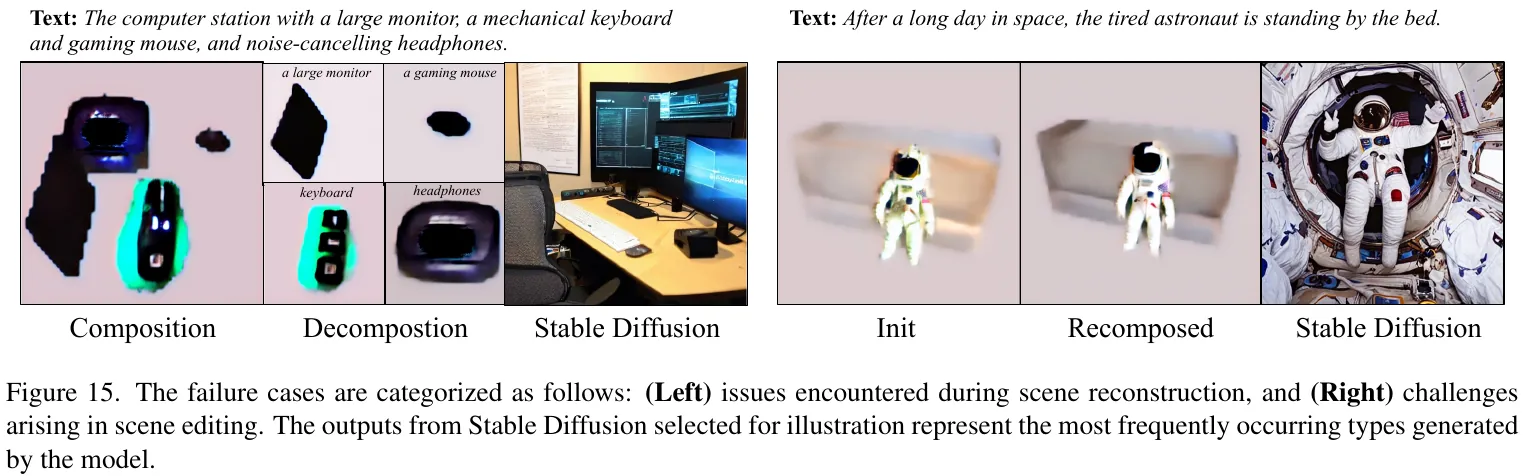
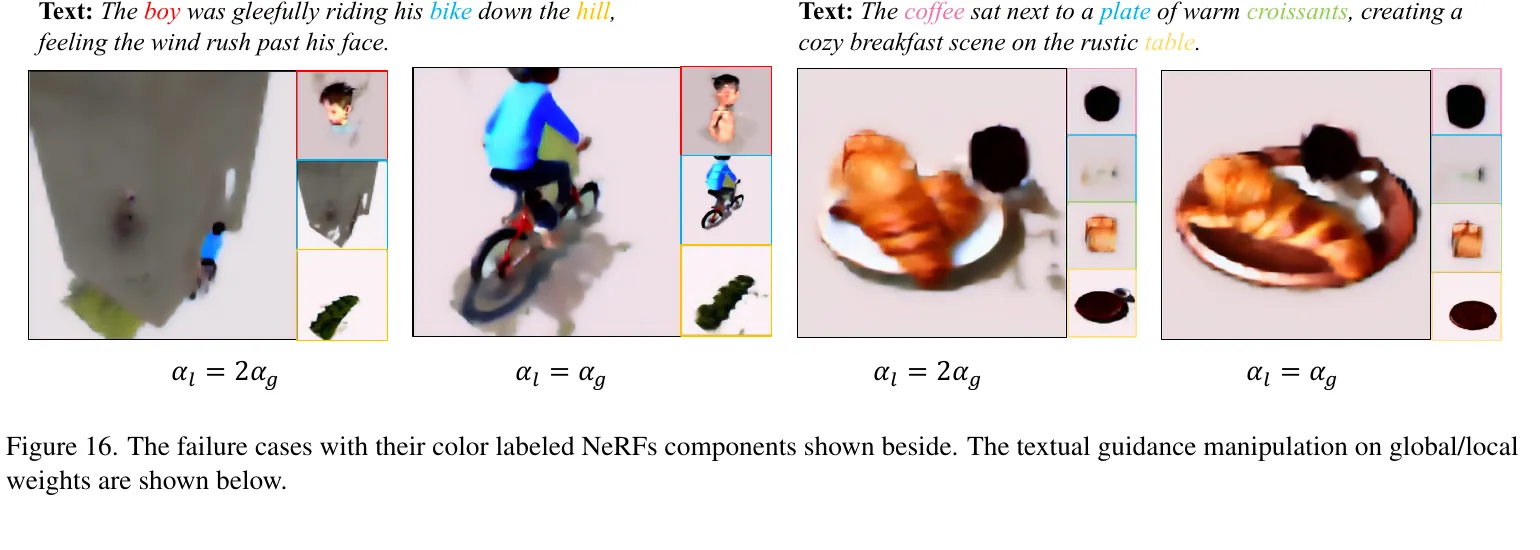
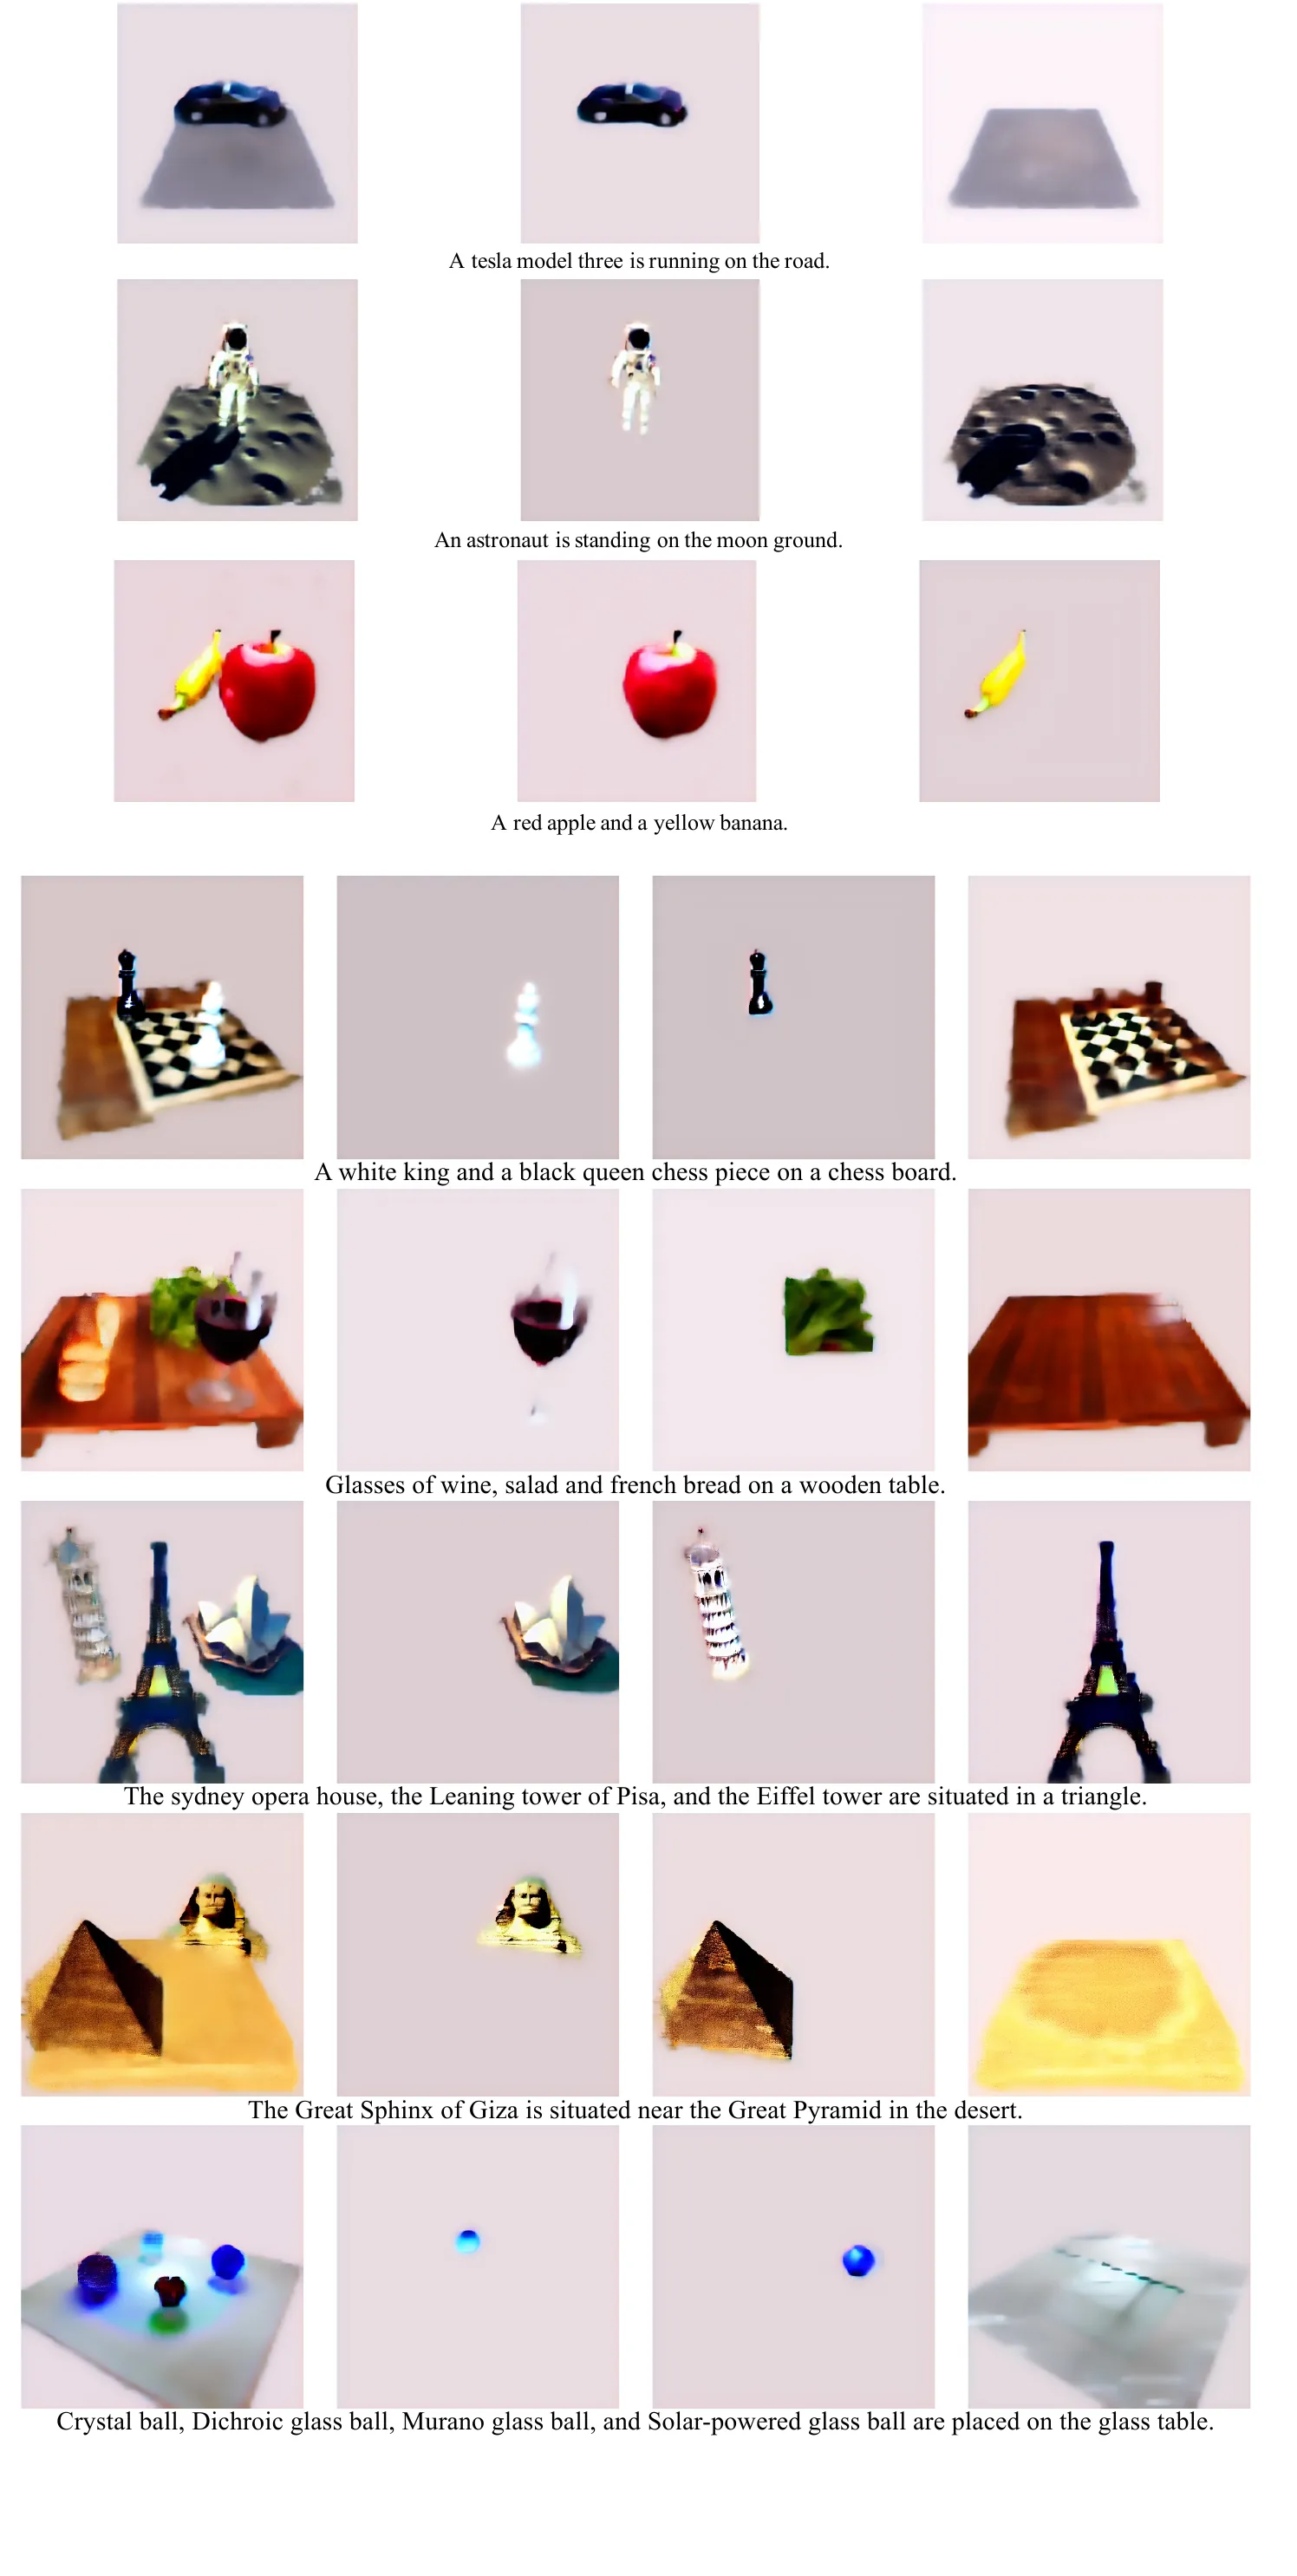
这三张图把整套方法最底层的训练张力摆在了台面上:
- 当 2D 扩散先验自身失灵时(Fig. 15):在左侧包含显示器、主机、键盘、鼠标等细碎部件的电脑桌场景中,许多小部件在全局视图里分辨率过低而发育不全;而在右侧“把宇航员重组到卧室床上”的反常组合里,连 Stable Diffusion 自己在生成 2D 图片时都会把宇航员和床单画崩,依赖它提供梯度的 3D 优化自然也独木难支。
- 当 与 比例失调时(Fig. 16):对比不同权重配比下的局部颜色标签组件图可以看到,如果局部权重 太弱、全局权重 太强,全局长文本就会强行入侵局部包围盒,逼着某个局部 NeRF 在自己的盒子里把周围的桌面甚至邻居物体也长出来,导致拆解出来的局部组件拖泥带水;反之若 独大,各个组件虽然干净独立,合在一起却格格不入。
7. 横向技术坐标与总结:在 3D 场景生成版图中的位置
如果把 CompoNeRF 放到本站精读过的整个三维场景生成与建模版图中做横向对比,可以非常清晰地看清技术演进的脉络与不同路线的取舍:
| 系统 / 论文 | 核心任务与输入 | 底层三维表示 | 组合与优化机制 | 相比 CompoNeRF 的核心取舍 |
|---|---|---|---|---|
| CompoNeRF | 文本 + 3D Box 布局生成可重组多物体场景 | 多个局部 Instant-NGP + 全局校准 MLP | 跨盒光线求交深度重排 + 密度残差校准 + 局部/全局双层 SDS | 开创了局部 NeRF 组件拆解与重组,但受限于早期 SD v1-4 SDS 优化耗时久、几何表面偏模糊 |
| Blended-NeRF | 在已训练好的现有 NeRF 场景中做局部 ROI 编辑 | 冻结的原场景 NeRF + 克隆的可训练生成分支 | 采样点级距离平滑算子 + 激活函数内/外双模式密度混合 + CLIP/BLIP 引导 | 专注于已有隐式场的局部“非破坏性修图”(插入/替换/改材质),而非从布局搭建全新的多物体场景 |
| Layout2Scene | 3D 语义布局 + 场景提示词生成室内场景 | 前景对象 2D Gaussians + 背景房间多边形(Polygons) | 先用语义几何扩散(GSDS)修法线/深度,再用三路条件扩散(ISD)刷外观 | 将表示升级为 30 FPS 实时渲染的 2DGS + 显式墙面多边形,并拆分为先几何后外观两阶段,大幅改善了房间结构规整度 |
| CasLayout | 从户型图与关系约束自动生成 3D 室内布局 | 家具三维有向包围盒(3D OBB)参数 | 四阶段级联扩散 + 关系潜在空间建模 | 专门解决 CompoNeRF 留白的“上游 3D 包围盒布局怎么自动生成”,可直接作为 CompoNeRF 的前置规划器 |
| Imaginarium / Diorama / SUFLECA | 单图或文本驱动构建工业级可编辑 3D 场景 | 现成干净的离散三维 CAD / Mesh 资产库 | 视觉解析 + 多模态 CAD 检索 + 9-DoF 几何配准 + 防穿模物理优化 | 放弃从零蒸馏隐式辐射场,直接检索并摆放高质量现成网格资产,拓扑干净且秒级可用,但受限于资产库覆盖度 |
| TRELLIS.2 / AssetGen | 单物体高保真 3D 网格与 PBR 材质生成 | 结构化稀疏体素潜在空间(O-Voxel)/ SDF | 原生三维流匹配(Flow Matching)前馈生成 | 用秒级前馈生成带完整 PBR 贴图的高清网格,彻底取代了耗时数十分钟的单物体 SDS 迭代优化 |
回望 CompoNeRF 的整套设计,尽管早期基于单视角 2D 扩散先验的 SDS 优化在几何锐利度、优化耗时和物理支撑约束上有着明显的时代局限,但它所提炼出的核心架构思想——“用显式三维空间槽位隔离个体参数、用局部与全局双层语义信号分治身份与语境、在三维光线积分层校准接触密度、将一次性场景拆解为可复用三维组件”——依然是今天构建一切组合式 3D Gaussian Splatting 场景生成与交互式三维编辑系统的经典设计范式。
参考资料
- Haotian Bai, Yuanhuiyi Lyu, Lutao Jiang, Sijia Li, Haonan Lu, Xiaodong Lin, Lin Wang, CompoNeRF: Text-guided Multi-object Compositional NeRF with Editable 3D Scene Layout, arXiv:2303.13843v3.
- 官方项目页:vlislab22.github.io/componerf;官方仓库:hbai98/Componerf.
- 相关核心文献:DreamFusion (ICLR 2023)、SJC (CVPR 2023)、Latent-NeRF (CVPR 2023)、Magic3D (CVPR 2023)、Set-the-Scene (ICCV 2023)、Text2Room (ICCV 2023).
comments